Claude 3 model kartını incele: Görsel yapay zekâ açısından ne anlama geliyor?
Claude 3 model kartını ve Vision AI geliştirme üzerindeki etkisini keşfet.
Son yıllarda görsel yapay zekâ, sağlık hizmetlerinden perakendeye kadar çeşitli sektörlerde önemli ilerlemeler kaydederek dönüşüm yarattı. Bu gelişmelerden etkili biçimde yararlanmak için temel modelleri ve modellerin belgelerini anlamak çok önemlidir. Yapay zekâ (AI) geliştiricilerinin araç kutusundaki temel araçlardan biri, yapay zekâ modelinin özelliklerine ve performansına kapsamlı bir genel bakış sunan model kartıdır.
Bu makalede, Anthropic tarafından geliştirilen Claude 3 model kartını ve bu kartın görsel yapay zekâ geliştirme üzerindeki etkilerini inceleyeceğiz. Claude 3, üç çeşitten oluşan yeni bir büyük çok modlu model ailesidir: en yetenekli model Claude 3 Opus; performans ile hızı dengeleyen Claude 3 Sonnet ve en hızlı, en uygun maliyetli seçenek Claude 3 Haiku. Her model artık görüntü verilerini işleyip analiz etmelerini sağlayan görme yeteneklerine sahip.
Claude 3 model kartına genel bakış#
Model kartı tam olarak nedir? Model kartı, bir makine öğrenmesi modelinin geliştirilmesi, eğitimi ve değerlendirilmesi hakkında bilgi veren ayrıntılı bir belgedir. Modelin işlevselliği, amaçlanan kullanım senaryoları ve olası sınırlamaları hakkında açık bilgiler sunarak yapay zekânın şeffaf, hesap verebilir ve etik biçimde kullanılmasını teşvik etmeyi amaçlar. Bunun için modelin değerlendirme ölçütleri ve önceki modellerle, ayrıca rakiplerle karşılaştırmaları gibi daha ayrıntılı veriler sunulabilir.
Değerlendirme ölçütleri#
Değerlendirme ölçütleri, model performansını değerlendirmek açısından kritik öneme sahiptir. Claude 3 model kartında doğruluk, kesinlik, duyarlılık ve F1 puanı gibi ölçütler listelenerek modelin güçlü yönleri ve geliştirilebilecek alanları açıkça gösterilir. Bu ölçütler sektör standartlarına göre kıyaslanır ve Claude 3'ün rekabetçi performansını ortaya koyar.
Ayrıca Claude 3, önceki modellerinin güçlü yönlerini temel alarak mimari ve eğitim tekniklerindeki gelişmeleri bünyesine katar. Model kartı, Claude 3'ü önceki sürümlerle karşılaştırıp doğruluk, verimlilik ve yeni kullanım senaryolarına uygulanabilirlik konularındaki iyileştirmeleri vurgular.
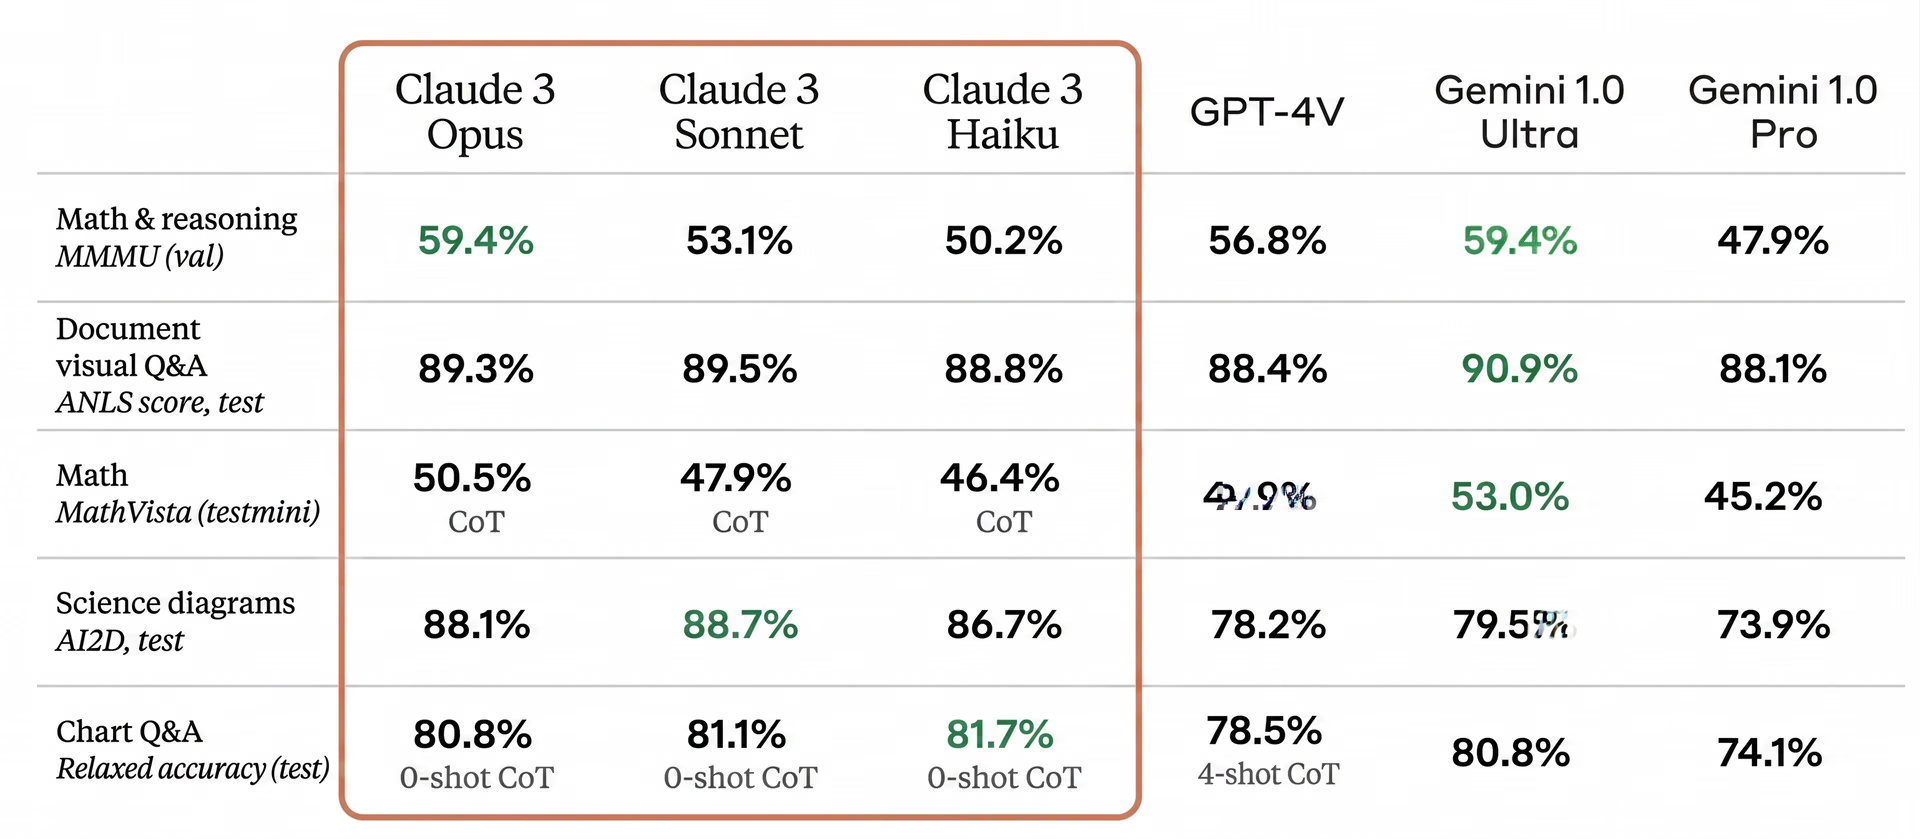
Şekil 1. Claude 3 modellerini çeşitli görevlerdeki diğer modellerle karşılaştıran tablo.
Claude 3, görsel yapay zekâ gelişimini nasıl etkiliyor?#
Claude 3'ün mimarisi ve eğitim süreci, çeşitli doğal dil işleme (NLP) ve görsel görevlerde güvenilir performans sunmasını sağlar. Kıyaslama testlerinde sürekli güçlü sonuçlar elde ederek karmaşık dil analizlerini etkili biçimde yapabildiğini gösterir.
Claude 3'ün çeşitli veri kümeleri üzerinde eğitilmesi ve veri artırma tekniklerinin kullanılması, modelin sağlamlığını ve farklı senaryolara genelleme yapma yeteneğini güvence altına alır. Bu da modeli çok çeşitli uygulamalarda esnek ve etkili kılar.
Kayda değer sonuçlarına rağmen Claude 3, özünde bir büyük dil modelidir (LLM). Claude 3 gibi LLM'ler çeşitli bilgisayarlı görü görevlerini yerine getirebilse de nesne algılama, sınır kutusu oluşturma ve görüntü segmentasyonu gibi görevler için özel olarak tasarlanmamıştır. Bu nedenle bu alanlardaki doğrulukları, Ultralytics YOLOv8 gibi bilgisayarlı görü için özel olarak geliştirilen modellerle aynı düzeyde olmayabilir. Buna rağmen LLM'ler başka alanlarda, özellikle de Claude 3'ün basit görsel görevleri insan muhakemesiyle birleştirerek önemli ölçüde başarılı olduğu doğal dil işleme (NLP) alanında öne çıkar.
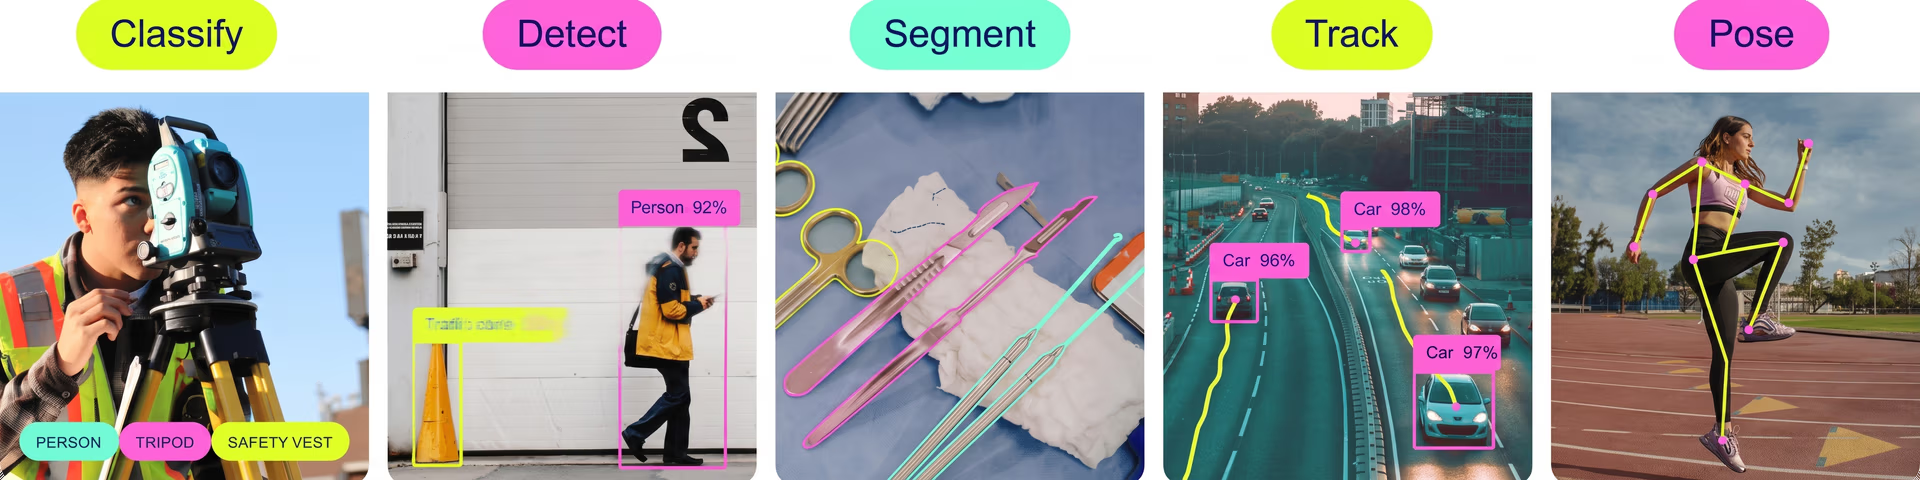
Şekil 2. Ultralytics YOLOv8 ile nesne sınıflandırma, algılama, segmentasyon, izleme ve poz tahminine genel bakış.
NLP yetenekleri, bir yapay zekâ modelinin insan dilini anlama ve bu dile yanıt verme kabiliyetini ifade eder. Bu yetenek, Claude 3'ün görsel alandaki uygulamalarında yoğun biçimde kullanılır; modelin bağlam açısından zengin açıklamalar sunmasını, karmaşık görsel verileri yorumlamasını ve görsel yapay zekâ görevlerindeki genel performansını geliştirmesini sağlar.
Görüntüyü metne dönüştürme#
Claude 3'ün, özellikle görsel yapay zekâ görevlerinde kullanıldığında etkileyici olan yeteneklerinden biri, okunması zor el yazıları içeren düşük kaliteli görüntüleri işleyip metne dönüştürebilmesidir. Bu özellik, modelin gelişmiş işlem gücünü ve çok modlu akıl yürütme yeteneklerini ortaya koyar. Bu bölümde Claude 3'ün bu görevi nasıl yerine getirdiğini inceleyecek, temel mekanizmaları ve görsel yapay zekâ geliştirme üzerindeki etkilerini ele alacağız.
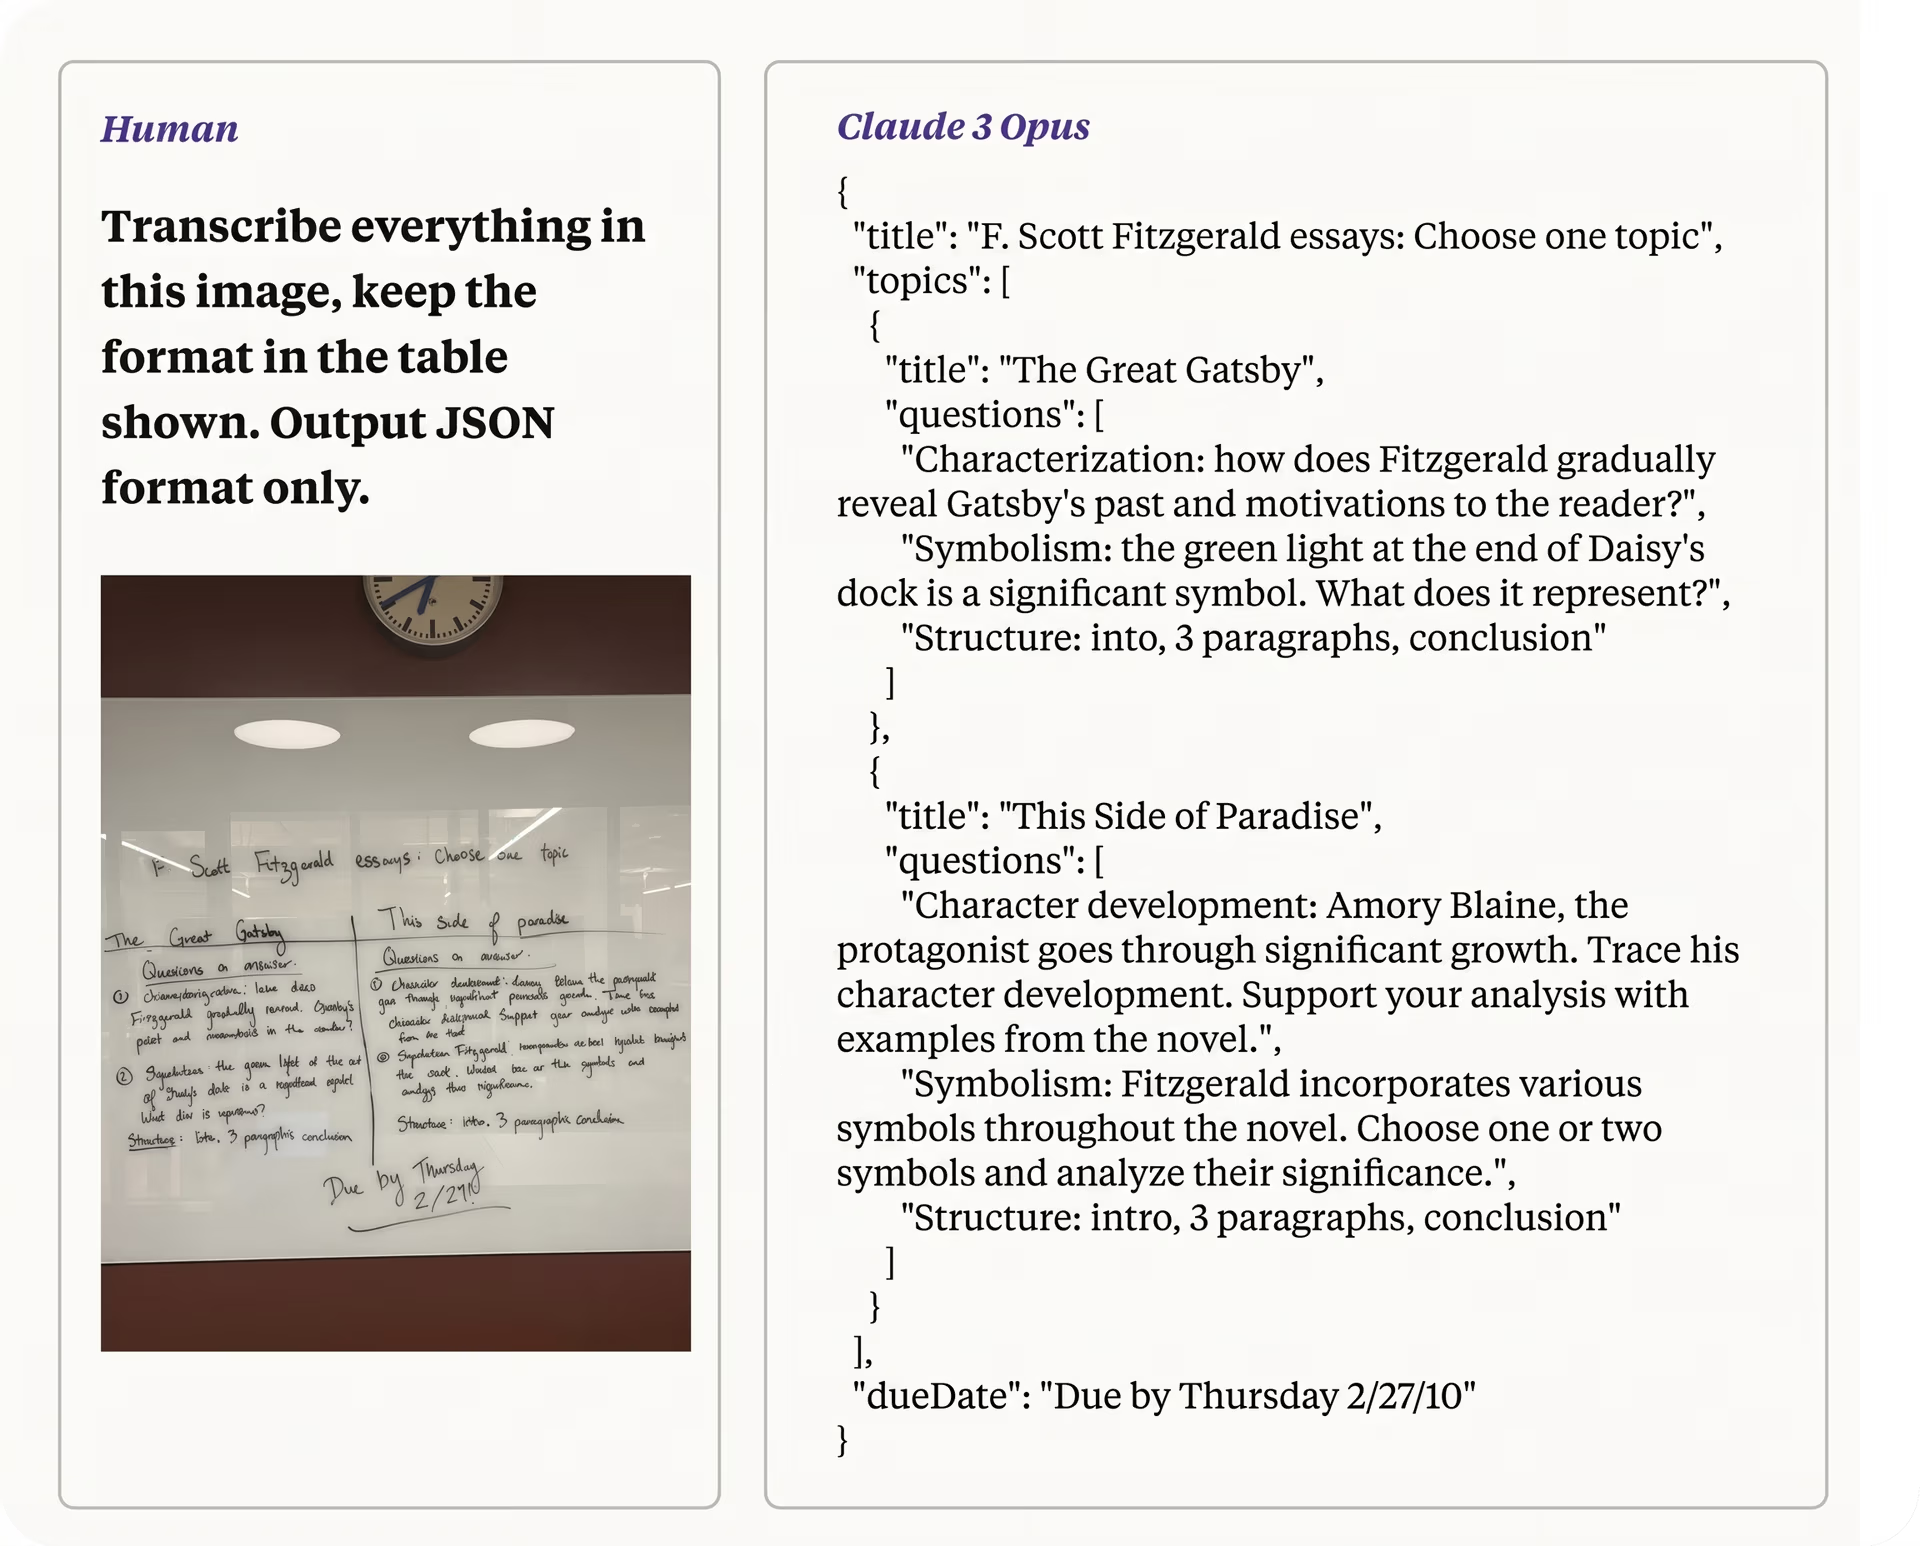
Şekil 3. Claude 3 Opus, okunması zor bir el yazısı içeren düşük kaliteli fotoğrafı metne dönüştürüyor.
Zorluğu anlama#
Okunması zor bir el yazısı içeren düşük kaliteli bir fotoğrafı metne dönüştürmek, çeşitli zorlukları kapsayan karmaşık bir görevdir:
- Görüntü Kalitesi: Düşük çözünürlük, parazit ve yetersiz aydınlatma koşulları görüntüdeki ayrıntıları belirsizleştirebilir.
- El Yazısı Değişkenliği: El yazısı biçimleri kişiden kişiye önemli ölçüde değiştiğinden modellerin metni tanıması ve yorumlaması zorlaşır.
- Bağlamı Anlama: El yazısını doğru biçimde metne dönüştürmek, yazıdaki belirsizlikleri gidermek için bağlamı anlamayı gerektirir.
Daha önce belirtildiği gibi, Claude 3 modelleri bu zorlukların üstesinden bilgisayarlı görü ve doğal dil işleme (NLP) alanlarındaki gelişmiş teknikleri bir arada kullanarak gelir.
Görseller üzerinden akıl yürütme (çok modlu)#
Claude 3'ün mimarisi, görsel girdileri kullanarak karmaşık akıl yürütme görevlerini gerçekleştirmesini sağlar. Örneğin model, Şekil 1'de gösterildiği gibi internet kullanımıyla ilgili bir grafikte G7 ülkelerini belirleyebilir, ilgili verileri çıkarabilir ve eğilimleri analiz etmek için hesaplamalar yapabilir. Yaş grupları arasındaki internet kullanım farklarını hesaplamak gibi bu çok adımlı akıl yürütme, modelin doğruluğunu ve gerçek dünya uygulamalarındaki yararını artırır.
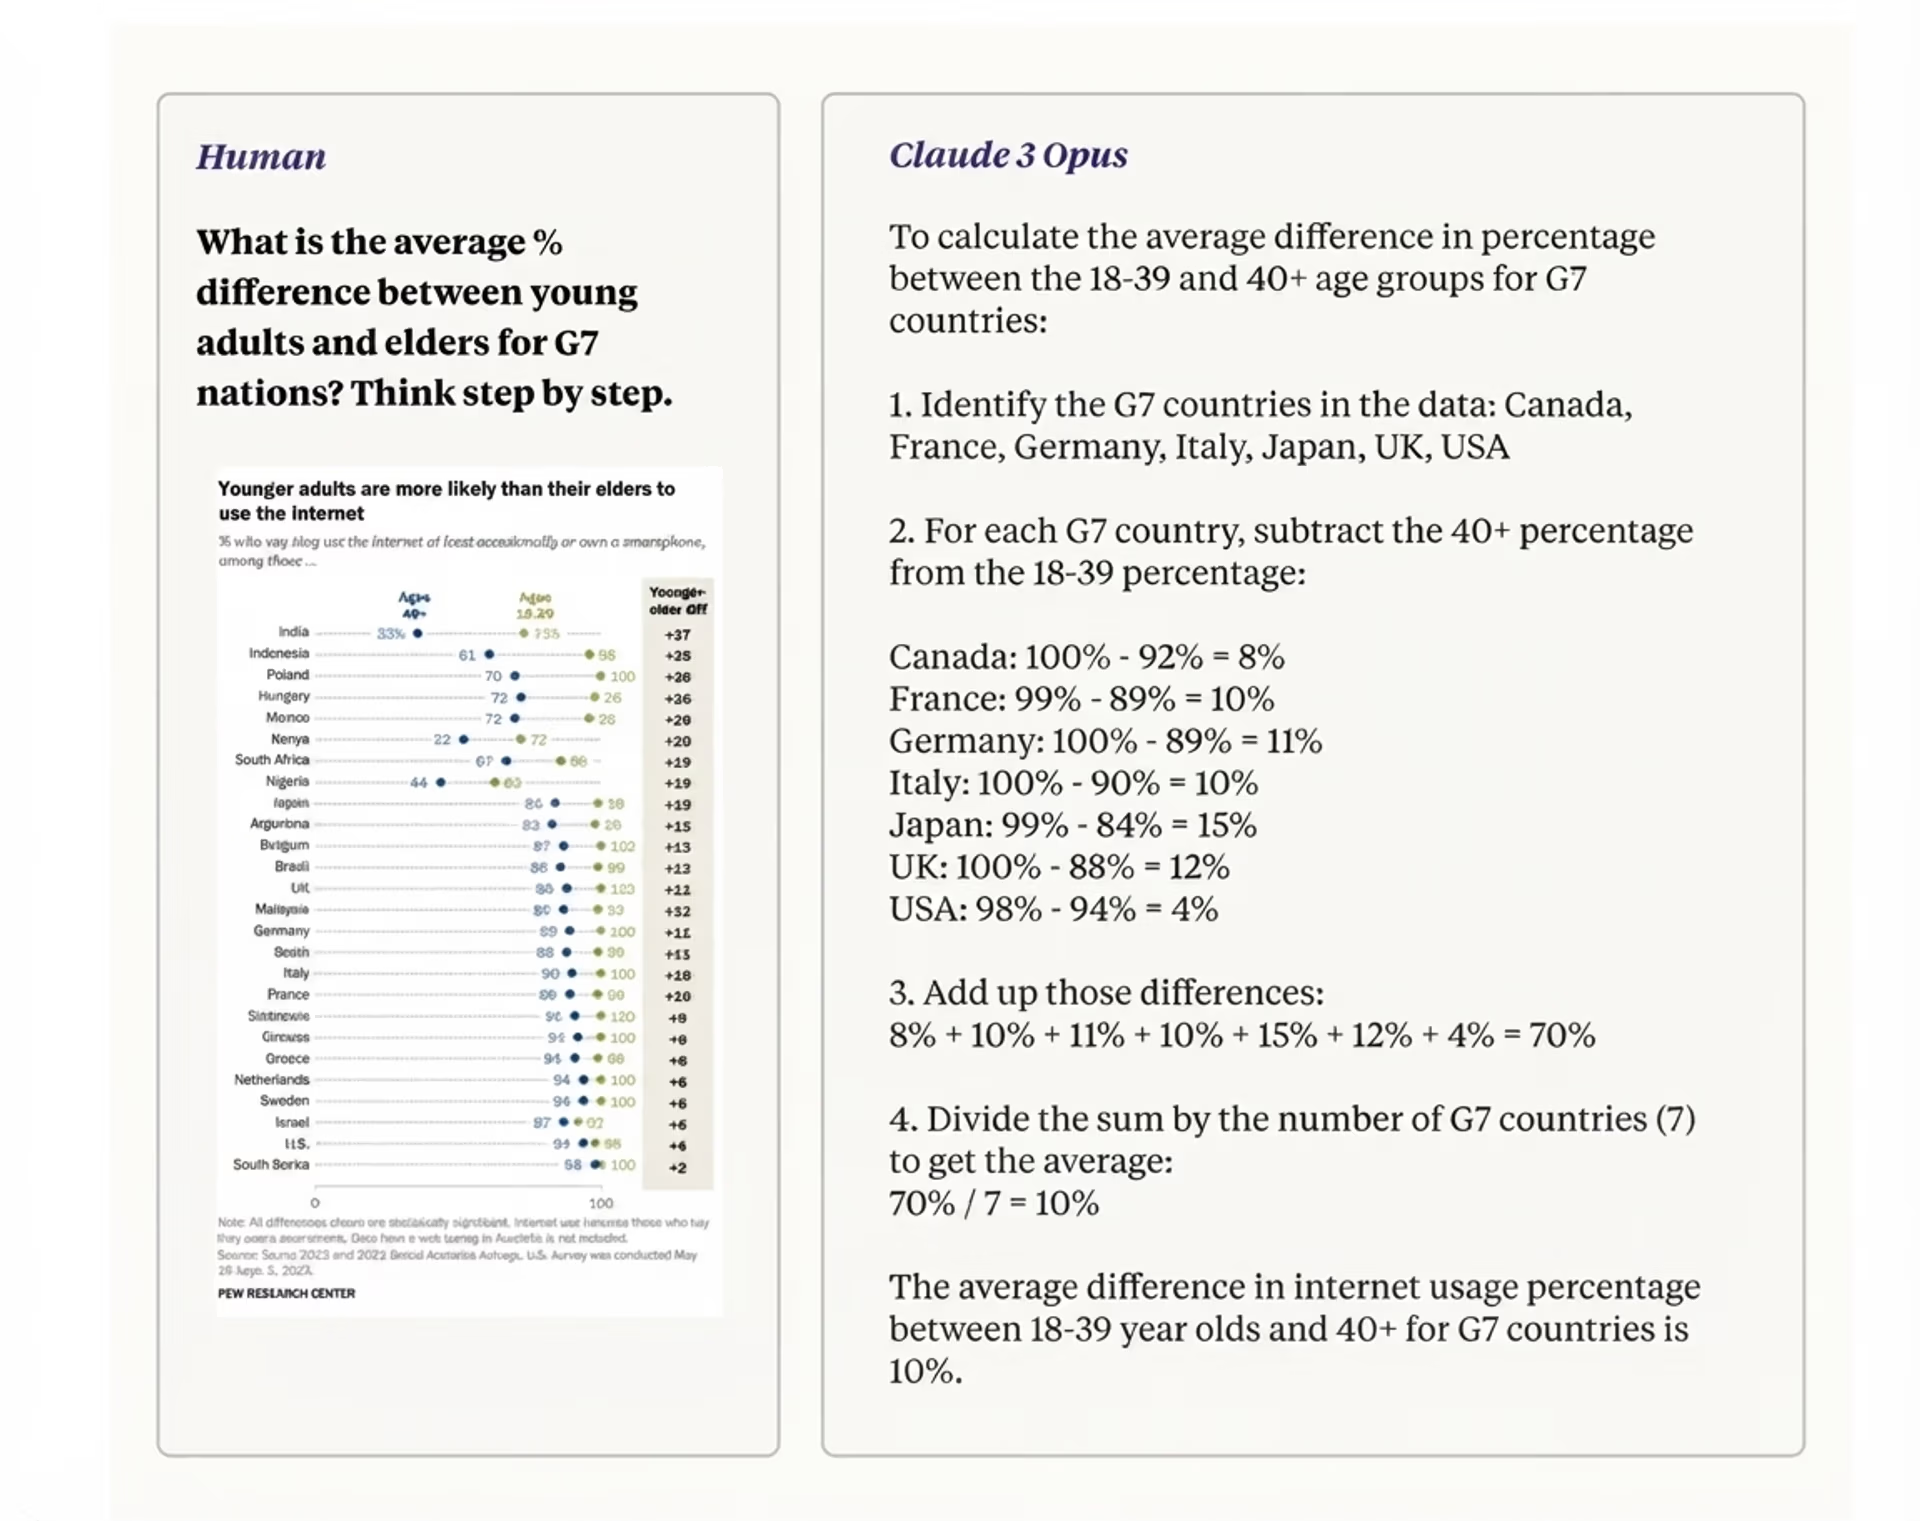
Şekil 4. Claude 3 Opus, görsel bir grafik üzerinde çok adımlı akıl yürütme görevleri gerçekleştiriyor.
Görüntüleri açıklama#
Claude 3, görüntüleri ayrıntılı açıklamalara dönüştürme konusunda başarılıdır ve hem bilgisayarlı görü hem de doğal dil işleme alanlarındaki güçlü yeteneklerini ortaya koyar. Bir görüntü verildiğinde Claude 3, görsel verideki temel özellikleri çıkarmak ve nesneleri, örüntüleri ve bağlamsal öğeleri belirlemek için önce evrişimli sinir ağlarından (CNNs) yararlanır.
Ardından Transformer katmanları, görüntüdeki farklı öğeler arasındaki ilişkileri ve bağlamı anlamak için dikkat mekanizmalarından yararlanarak bu özellikleri analiz eder. Bu çok modlu yaklaşım, Claude 3'ün yalnızca nesneleri belirlemekle kalmayıp sahnedeki etkileşimlerini ve önemlerini de anlayarak doğru ve bağlam açısından zengin açıklamalar üretmesini sağlar.
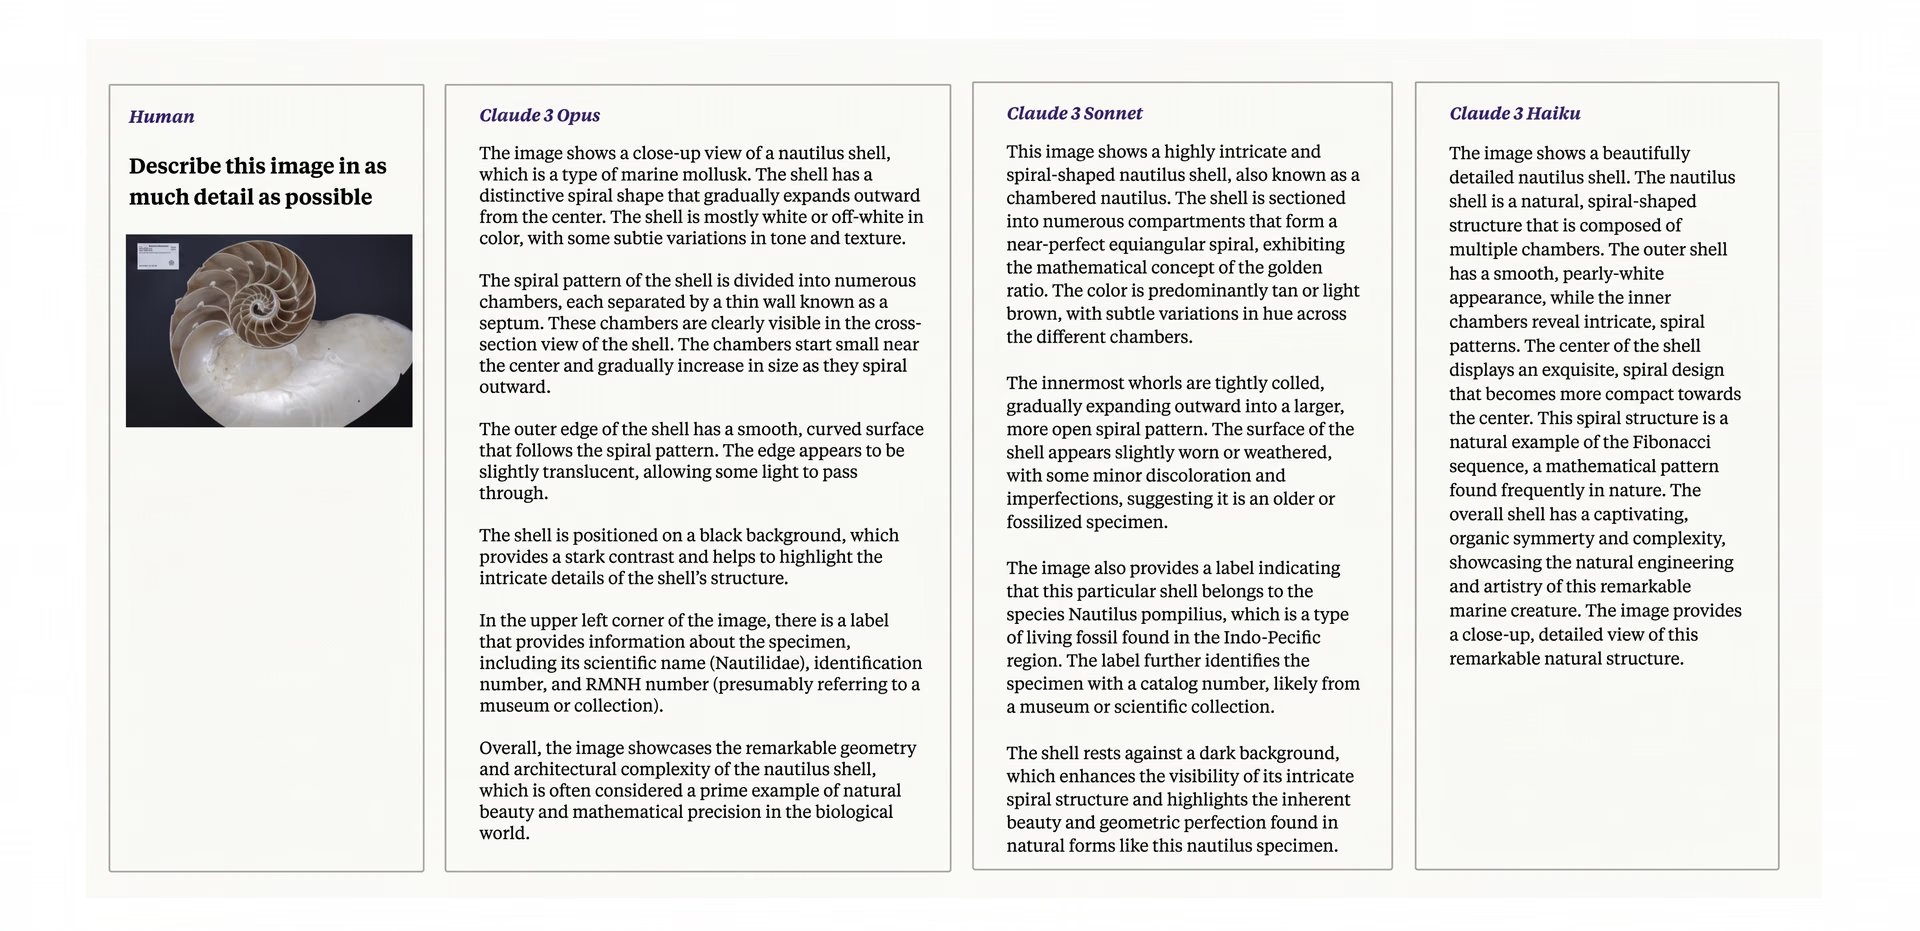
Şekil 5. Claude 3 modelleri, görüntüdeki görsel nesneleri anlayıp bunları insanların anlayabileceği bir dille açıklıyor.
Claude 3 modellerinin bilgisayarlı görü alanındaki zorlukları ve aksaklıkları#
Bilgisayarlı görü odaklı olmaması#
Claude 3 gibi büyük dil modelleri (LLM'ler), bilgisayarlı görüde değil, doğal dil işlemede başarılıdır. Görüntüleri açıklayabilseler de nesne algılama ve görüntü segmentasyonu gibi görevler, Ultralytics YOLOv8 gibi görme odaklı modellerle daha iyi gerçekleştirilir. Bu özel modeller görsel görevler için optimize edilmiştir ve görüntüleri analiz ederken daha iyi performans sunar. Ayrıca model, sınırlayıcı kutu oluşturma gibi görevleri gerçekleştiremez.
Entegrasyon karmaşıklığı#
Claude 3'ü bilgisayarlı görü sistemleriyle birleştirmek karmaşık olabilir ve metin ile görsel veriler arasındaki boşluğu kapatmak için ek işleme adımları gerektirebilir.
Eğitim verilerinin sınırlılıkları#
Claude 3 öncelikle büyük miktarda metin verisiyle eğitilmiştir; bu da bilgisayarlı görü görevlerinde yüksek performans elde etmek için gereken kapsamlı görsel veri kümelerine sahip olmadığı anlamına gelir. Sonuç olarak Claude 3, metni anlama ve üretmede başarılı olsa da görsel veriler için özel olarak tasarlanmış modellerde bulunan yeterlilik düzeyinde görüntüleri analiz etme becerisine sahip değildir. Bu sınırlama, görsel içeriğin yorumlanmasını veya oluşturulmasını gerektiren uygulamalardaki etkinliğini azaltır.
Claude 3'ün görsel yapay zekâ alanındaki gelecekteki potansiyeli#
Diğer büyük dil modelleri gibi Claude 3 de sürekli gelişmeye hazırlanıyor. Gelecekteki iyileştirmelerin, görüntü algılama ve nesne tanıma gibi görsel görevlerin yanı sıra doğal dil işleme görevlerindeki ilerlemelere odaklanması muhtemel. Bu, benzer görevlerin yanı sıra nesne ve sahnelerin daha doğru ve ayrıntılı açıklanmasını sağlayacak.
Son olarak, Claude 3 üzerindeki devam eden araştırmalar yorumlanabilirliği artırmaya, önyargıyı azaltmaya ve çeşitli veri kümelerinde genelleme kabiliyetini geliştirmeye öncelik verecek. Bu çalışmalar, modelin çeşitli uygulamalardaki sağlam performansını güvence altına alacak ve çıktılarının güvenilirliğini destekleyecek.
Son düşünceler#
Claude 3 model kartı; modelin mimarisi, performansı ve etik değerlendirmeleri hakkında ayrıntılı bilgiler sunarak görsel yapay zekâ alanındaki geliştiriciler ve paydaşlar için değerli bir kaynaktır. Şeffaflığı ve hesap verebilirliği teşvik ederek yapay zekâ teknolojilerinin sorumlu ve etkili kullanımını güvence altına almaya yardımcı olur. Görsel yapay zekâ gelişmeye devam ederken Claude 3'ünki gibi model kartları, geliştirme çalışmalarına yön vermede ve yapay zekâ sistemlerine duyulan güveni güçlendirmede kritik rol oynayacak.
Ultralytics olarak yapay zekâ teknolojisini ilerletme konusunda tutkuluyuz. Yapay zekâ çözümlerimizi keşfetmek ve en yeni yeniliklerimizden haberdar olmak için GitHub depomuzu ziyaret et. Discord topluluğumuza katıl ve Otonom Araçlar ve üretim gibi sektörleri nasıl dönüştürdüğümüzü keşfet! 🚀









