Bilgisayarlı görmede aşırı öğrenme nedir ve nasıl önlenir?
Bilgisayarlı görmede aşırı öğrenmenin ne olduğunu ve veri artırma, düzenlileştirme ve önceden eğitilmiş modeller kullanarak bunu nasıl önleyebileceğini öğren.
Bilgisayarlı görü modelleri; kalıpları tanımak, nesneleri tespit etmek ve görüntüleri analiz etmek için tasarlanır. Ancak performansları, görülmemiş verilere ne kadar iyi genelleme yaptıklarına bağlıdır. Genelleme, modelin yalnızca üzerinde eğitildiği görüntülerde değil, yeni görüntülerde de iyi çalışabilmesidir. Bu modellerin eğitiminde yaygın bir sorun, modelin anlamlı kalıpları belirlemek yerine gereksiz gürültü de dahil olmak üzere eğitim verilerinden aşırı miktarda öğrenmesiyle ortaya çıkan aşırı öğrenmedir.
Bu olduğunda model, eğitim verilerinde iyi performans gösterir ancak yeni görüntülerde zorlanır. Örneğin, yalnızca yüksek çözünürlüklü ve iyi aydınlatılmış görüntülerle eğitilen bir nesne tespit modeli, gerçek dünya koşullarında bulanık veya gölgeli görüntülerle karşılaştığında başarısız olabilir. Aşırı öğrenme, modelin uyarlanabilirliğini sınırlar ve otonom sürüş, tıbbi görüntüleme ve güvenlik sistemleri gibi gerçek dünya uygulamalarındaki kullanımını kısıtlar.
Bu makalede aşırı öğrenmenin ne olduğunu, neden gerçekleştiğini ve nasıl önlenebileceğini inceleyeceğiz. Ayrıca Ultralytics YOLO11 gibi bilgisayarlı görü modellerinin aşırı öğrenmeyi azaltmaya ve genellemeyi iyileştirmeye nasıl yardımcı olduğuna bakacağız.
Aşırı öğrenme nedir?#
Aşırı öğrenme, bir modelin yeni girdilere genel olarak uygulanabilecek kalıpları öğrenmek yerine eğitim verilerini ezberlemesiyle ortaya çıkar. Model eğitim verilerine aşırı odaklandığı için daha önce görmediği yeni görüntülerde veya durumlarda zorlanır.
Bilgisayarlı görüde aşırı öğrenme, farklı görevleri etkileyebilir. Yalnızca parlak ve net görüntülerle eğitilen bir sınıflandırma modeli, düşük ışık koşullarında zorlanabilir. Kusursuz görüntülerden öğrenen bir nesne tespit modeli, kalabalık veya karmaşık sahnelerde başarısız olabilir. Benzer şekilde, örnek bölütleme modeli kontrollü ortamlarda iyi çalışırken gölgeler veya üst üste binen nesneler karşısında zorlanabilir.
Bu durum, modellerin kontrollü eğitim koşullarının ötesinde genelleme yapabilmesi gereken gerçek dünya yapay zekâ uygulamalarında sorun oluşturur. Örneğin otonom araçlar; farklı aydınlatma koşullarında, hava durumlarında ve ortamlarda yayaları tespit edebilmelidir. Eğitim kümesine aşırı uyum sağlayan bir model, bu öngörülemeyen senaryolarda güvenilir performans gösteremez.
Aşırı öğrenme ne zaman ve neden gerçekleşir?#
Aşırı öğrenme genellikle dengesiz veri kümeleri, aşırı model karmaşıklığı ve fazla eğitim nedeniyle oluşur. Başlıca nedenler şunlardır:
- Sınırlı eğitim verisi: Küçük veri kümeleri, modellerin kalıpları genellemek yerine ezberlemesine neden olur. Yalnızca 50 kuş görüntüsüyle eğitilen bir model, bu veri kümesinin dışındaki kuş türlerini tespit etmekte zorlanabilir.
- Çok fazla parametreye sahip karmaşık modeller: Aşırı sayıda katmana ve nörona sahip derin ağlar, temel özelliklere odaklanmak yerine ince ayrıntıları ezberleme eğilimindedir.
- Veri artırmanın olmaması: Kırpma, çevirme veya döndürme gibi dönüşümler olmadan model yalnızca tam olarak eğitimde kullanılan görüntülerden öğrenebilir.
- Uzun süreli eğitim: Bir model, epoch olarak bilinen eğitim verisi geçişlerini çok fazla kez gerçekleştirirse genel kalıpları öğrenmek yerine ayrıntıları ezberler ve daha az uyarlanabilir hâle gelir.
- Tutarsız veya gürültülü etiketler: Yanlış etiketlenmiş veriler, modelin yanlış kalıpları öğrenmesine neden olur. Bu durum, elle etiketlenmiş veri kümelerinde yaygındır.
Model karmaşıklığı, veri kümesi kalitesi ve eğitim teknikleri arasında iyi dengelenmiş bir yaklaşım, daha iyi genelleme sağlar.
Aşırı öğrenme ve yetersiz öğrenme#
Aşırı öğrenme ve yetersiz öğrenme, derin öğrenmedeki birbirinin tamamen zıttı iki sorundur.
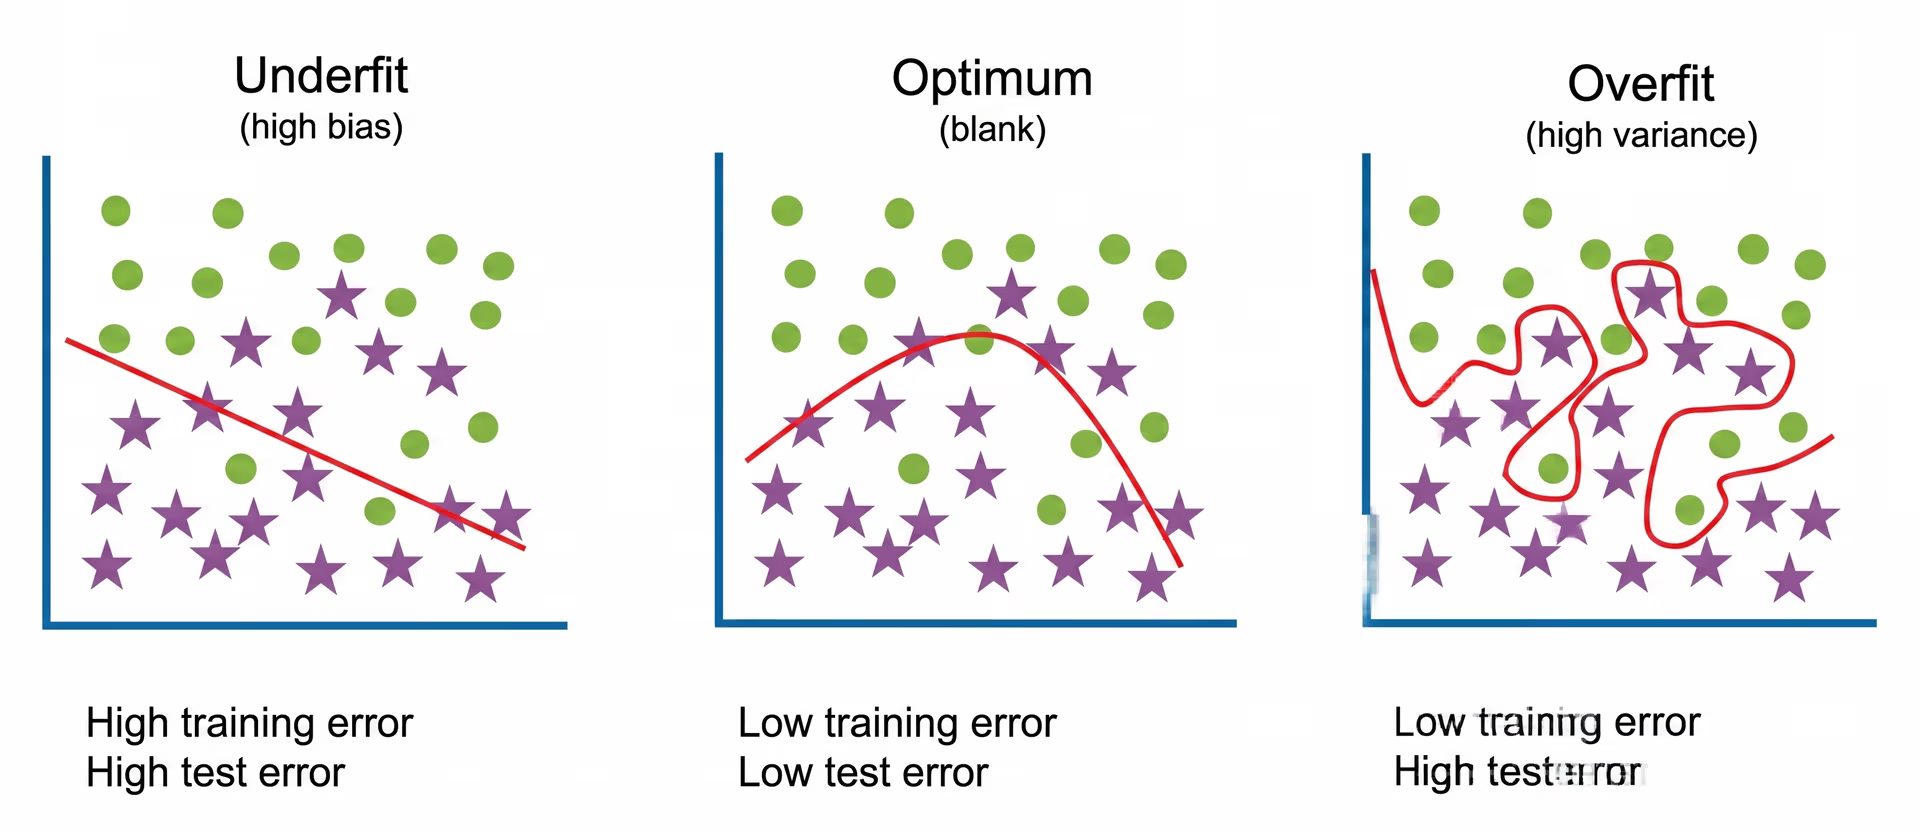
Şekil 1. Bilgisayarlı görü modellerinde yetersiz öğrenme, optimum öğrenme ve aşırı öğrenmenin karşılaştırması.
Aşırı öğrenme, bir modelin fazla karmaşık olması ve eğitim verilerine aşırı odaklanmasıyla ortaya çıkar. Model genel kalıpları öğrenmek yerine, arka plan gürültüsü gibi ilgisiz olanlar da dahil olmak üzere küçük ayrıntıları ezberler. Bu durum, modelin eğitim verilerinde iyi performans gösterirken yeni görüntülerde zorlanmasına neden olur; yani farklı durumlarda geçerli olan kalıpları nasıl tanıyacağını gerçekten öğrenmemiştir.
Yetersiz öğrenme, bir modelin fazla basit olması ve verilerdeki önemli kalıpları gözden kaçırmasıyla ortaya çıkar. Bu durum, modelde çok az katman bulunması, eğitim süresinin yetersiz olması veya verilerin sınırlı olması nedeniyle gerçekleşebilir. Sonuç olarak model, önemli kalıpları tanıyamaz ve hatalı tahminler yapar. Model görevi doğru şekilde anlayacak kadar öğrenmediği için bu durum hem eğitim hem de test verilerinde düşük performansa yol açar.
İyi eğitilmiş bir model, karmaşıklık ve genelleme arasında denge kurar. İlgili kalıpları öğrenecek kadar karmaşık olmalı, ancak verileri temel ilişkileri tanımak yerine ezberleyecek kadar karmaşık olmamalıdır.
Aşırı öğrenme nasıl tespit edilir?#
Bir modelin aşırı öğrendiğini gösteren bazı işaretler şunlardır:
- Eğitim doğruluğu doğrulama doğruluğundan önemli ölçüde yüksekse model büyük olasılıkla aşırı öğreniyordur.
- Eğitim kaybı ile doğrulama kaybı arasındaki farkın açılması da güçlü bir göstergedir.
- Model yanlış yanıtlarda aşırı kendine güveniyor; bu da kalıpları anlamak yerine ayrıntıları ezberlediğini gösteriyor.
Bir modelin iyi genelleme yaptığından emin olmak için gerçek dünya koşullarını yansıtan çeşitli veri kümeleri üzerinde test edilmesi gerekir.
Bilgisayarlı görüde aşırı öğrenme nasıl önlenir?#
Aşırı öğrenme kaçınılmaz değildir ve önlenebilir. Doğru tekniklerle bilgisayarlı görü modelleri eğitim verilerini ezberlemek yerine genel kalıpları öğrenebilir ve böylece gerçek dünya uygulamalarında daha güvenilir hâle gelebilir.
Bilgisayarlı görüde aşırı öğrenmeyi önlemek için beş temel stratejiyi burada bulabilirsin.
Veri artırma ve sentetik verilerle veri çeşitliliğini artır#
Bir modelin yeni verilerde iyi çalışmasına yardımcı olmanın en iyi yolu, veri artırma ve sentetik veri kullanarak veri kümesini genişletmektir. Sentetik veriler, gerçek dünya görüntülerinden toplanmak yerine bilgisayar tarafından oluşturulur. Yeterli gerçek veri olmadığında oluşan boşlukların doldurulmasına yardımcı olur.
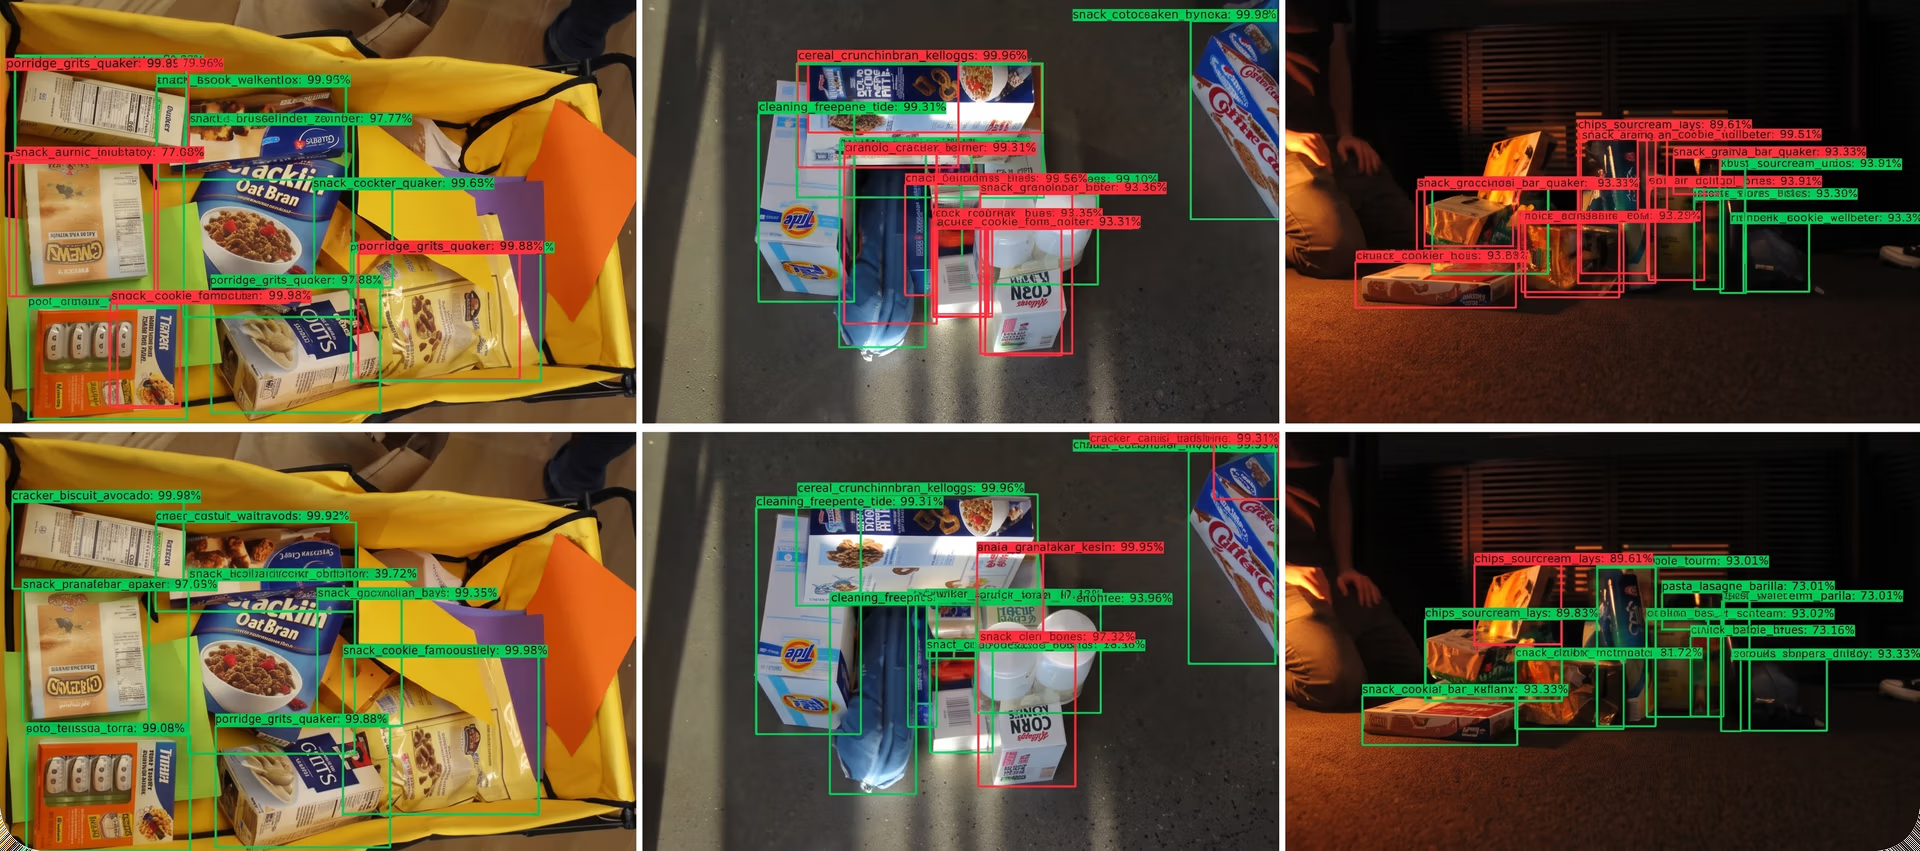
Şekil 2. Gerçek dünya verileriyle sentetik verilerin birleştirilmesi, aşırı öğrenmeyi azaltır ve nesne tespit doğruluğunu iyileştirir.
Veri artırma; görüntüleri çevirerek, döndürerek, kırparak veya parlaklıklarını ayarlayarak mevcut görüntüleri küçük ölçüde değiştirir. Böylece model yalnızca ayrıntıları ezberlemek yerine nesneleri farklı durumlarda tanımayı öğrenir.
Sentetik veriler, gerçek görüntülerin elde edilmesinin zor olduğu durumlarda kullanışlıdır. Örneğin otonom araç modelleri, farklı hava ve aydınlatma koşullarında nesneleri nasıl tespit edeceğini öğrenmek için bilgisayar tarafından oluşturulan yol sahneleriyle eğitilebilir. Bu, binlerce gerçek dünya görüntüsüne ihtiyaç duymadan modeli daha esnek ve güvenilir hâle getirir.
Model karmaşıklığını ve mimarisini optimize et#
Tek bir katman yerine verileri işleyen çok sayıda katmana sahip bir makine öğrenmesi modeli türü olan derin bir sinir ağı her zaman daha iyi değildir. Bir modelde çok fazla katman veya parametre olduğunda model, daha geniş kalıpları tanımak yerine eğitim verilerini ezberler. Gereksiz karmaşıklığı azaltmak, aşırı öğrenmeyi önlemeye yardımcı olabilir.
Bunu sağlamak için bir yaklaşım, gereksiz nöronları ve bağlantıları kaldırarak modeli daha yalın ve verimli hâle getiren budamadır.
Bir diğer yaklaşım ise katman veya nöron sayısını azaltarak mimariyi basitleştirmektir. Ultralytics YOLO11 gibi önceden eğitilmiş modeller, daha az parametreyle görevler arasında iyi genelleme yapacak şekilde tasarlanır. Bu da onları derin bir modeli sıfırdan eğitmeye kıyasla aşırı öğrenmeye daha dirençli hâle getirir.
Model derinliği ile verimlilik arasında doğru dengeyi bulmak, modelin eğitim verilerini yalnızca ezberlemeden faydalı kalıpları öğrenmesine yardımcı olur.
Düzenlileştirme tekniklerini uygula#
Düzenlileştirme teknikleri, modellerin eğitim verilerindeki belirli özelliklere aşırı bağımlı hâle gelmesini önler. Yaygın olarak kullanılan birkaç teknik şunlardır:
- Dropout, eğitim sırasında modelin rastgele bölümlerini devre dışı bırakarak birkaç özelliğe aşırı güvenmek yerine farklı kalıpları tanımayı öğrenmesini sağlar.
- Ağırlık çürümesi (L2 düzenlileştirme), aşırı ağırlık değerlerini caydırarak modelin karmaşıklığını kontrol altında tutar.
- Batch normalization, modelin veri kümesindeki değişikliklere daha az duyarlı olmasını sağlayarak eğitimin kararlı hâle gelmesine yardımcı olur.
Bu teknikler, doğruluğu korurken modelin esnekliğini ve uyarlanabilirliğini sürdürmesine yardımcı olur ve aşırı öğrenme riskini azaltır.
Eğitimi doğrulama ve erken durdurma ile izle#
Aşırı öğrenmeyi önlemek için modelin nasıl öğrendiğini takip etmek ve yeni verilere iyi genelleme yaptığından emin olmak önemlidir. Buna yardımcı olacak birkaç teknik şunlardır:
- Erken durdurma: Modelin gelişimi durduğunda eğitimi otomatik olarak sonlandırır ve gereksiz ayrıntıları öğrenmeye devam etmesini önler.
- Çapraz doğrulama: Verileri parçalara böler ve modeli her parça üzerinde eğitir. Bu, modelin belirli görüntüleri ezberlemek yerine kalıpları öğrenmesine yardımcı olur.
Bu teknikler, modelin yalnızca eğitim verilerine aşırı odaklanmadan doğru sonuç verecek kadar öğrenmesini sağlayarak dengeli kalmasına yardımcı olur.
Önceden eğitilmiş modeller kullan ve veri kümesi etiketlemesini iyileştir#
Sıfırdan eğitim yapmak yerine Ultralytics YOLO11 gibi önceden eğitilmiş modelleri kullanmak aşırı öğrenmeyi azaltabilir. YOLO11, büyük ölçekli veri kümeleri üzerinde eğitildiği için farklı koşullarda iyi genelleme yapabilir.
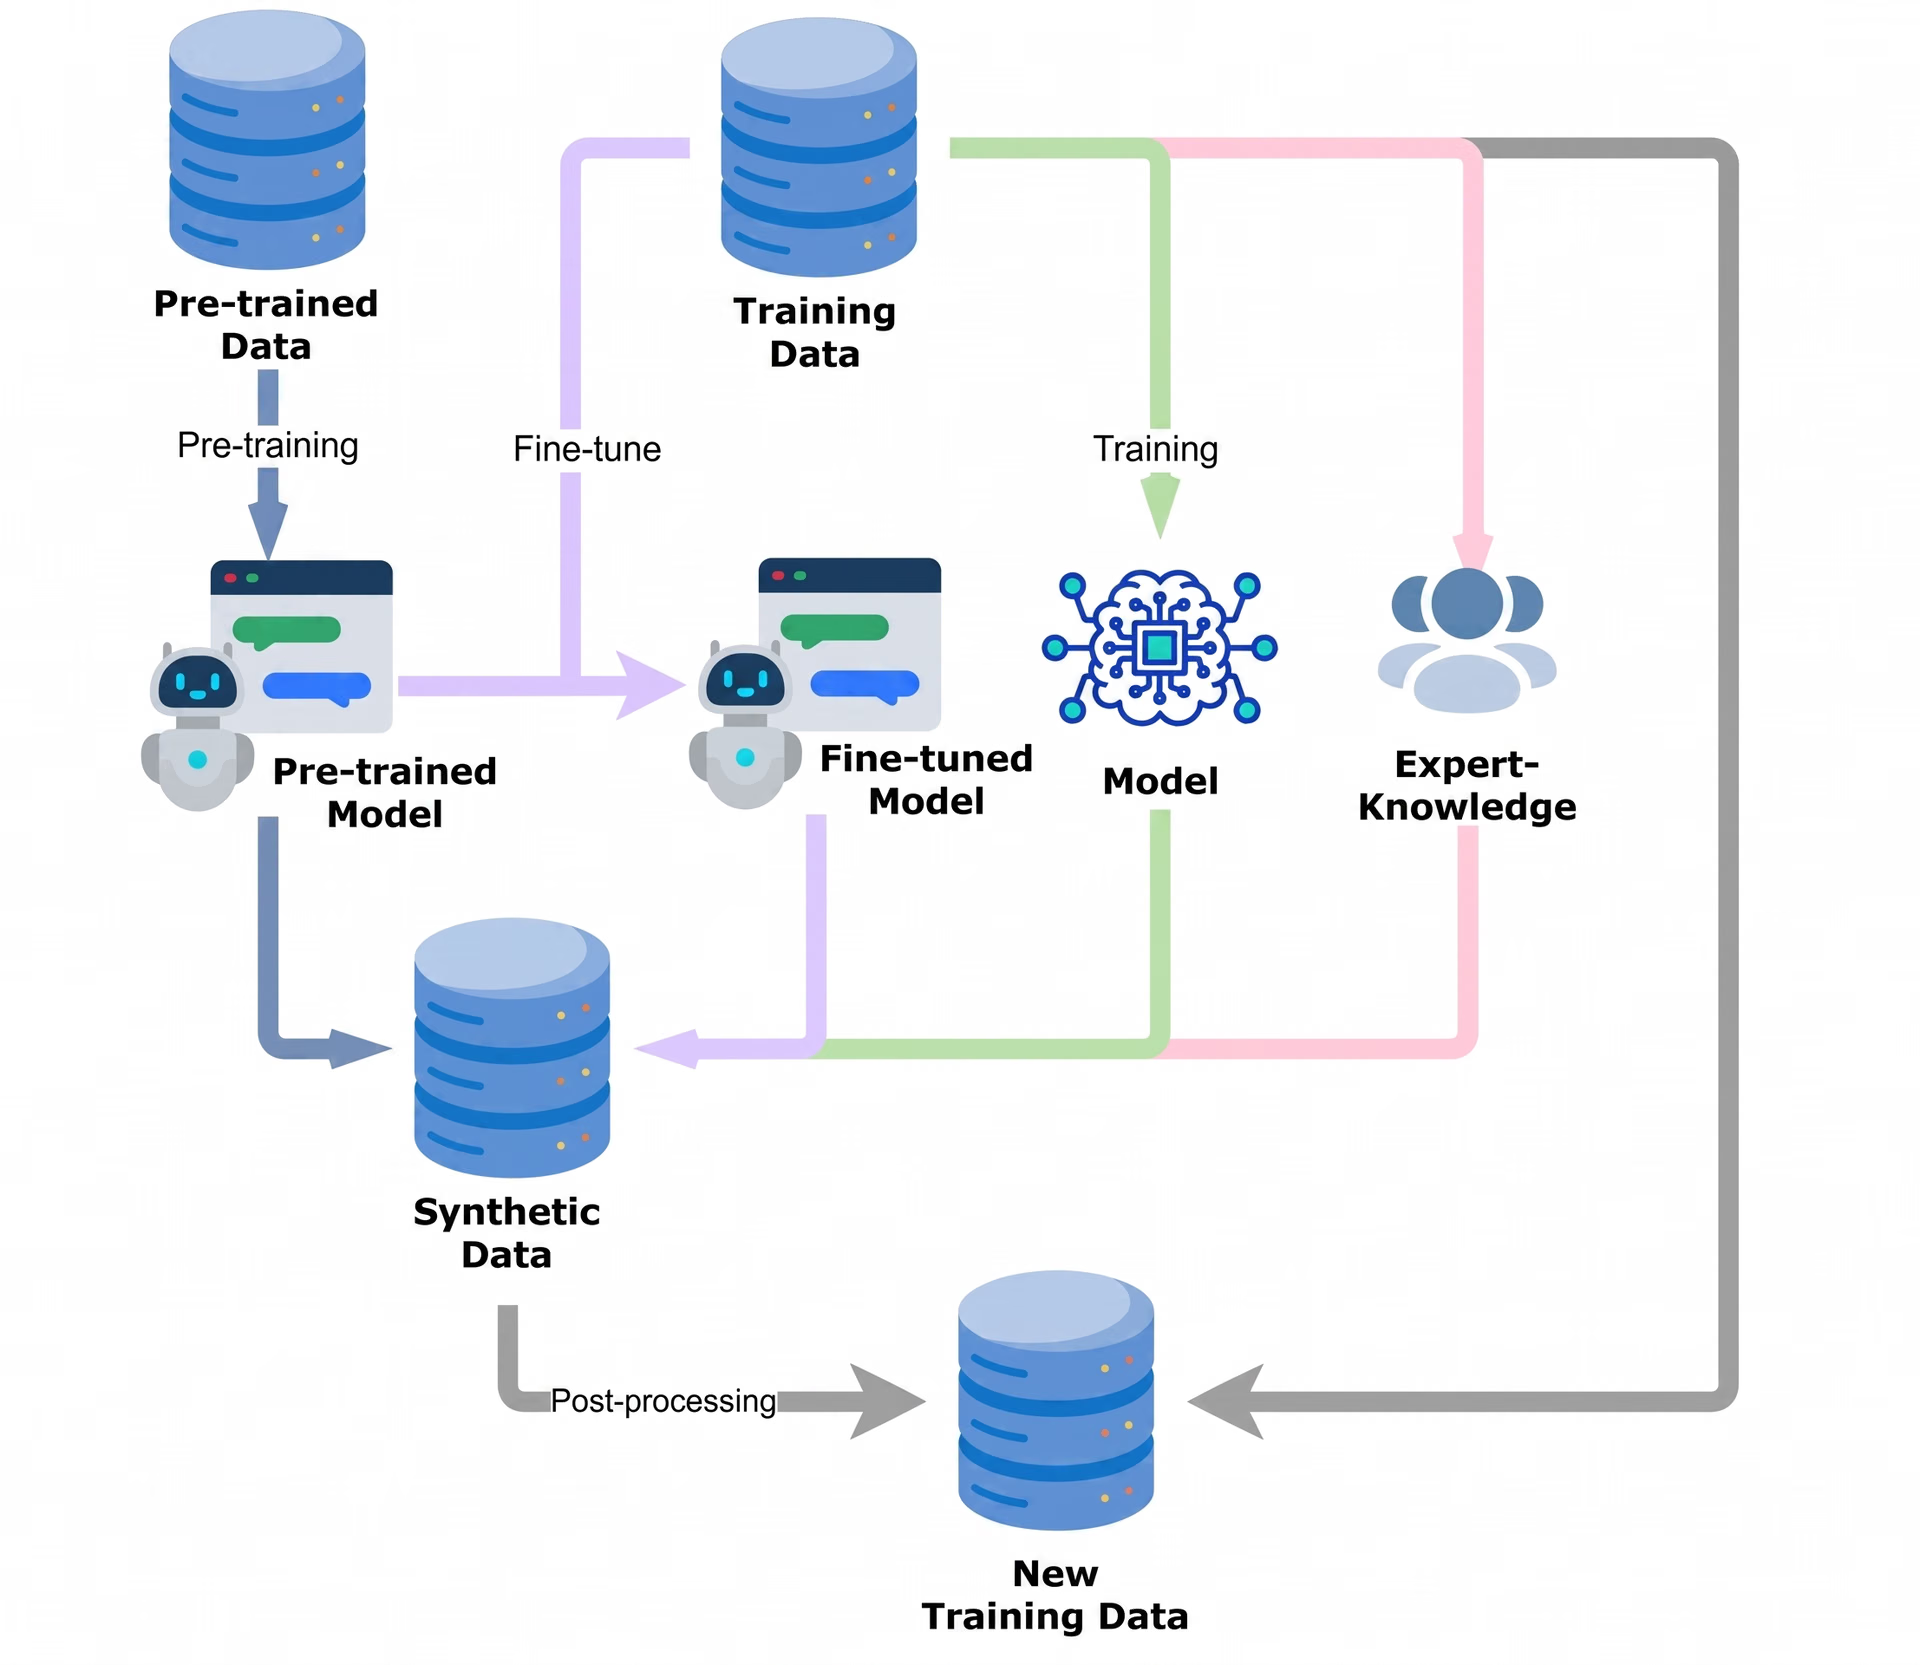
Şekil 3. Önceden eğitilmiş bilgisayarlı görü modelleri doğruluğu artırır ve aşırı öğrenmeyi önler.
Önceden eğitilmiş bir modelin ince ayarını yapmak, yeni görevleri öğrenirken zaten bildiklerini korumasına yardımcı olur; böylece model yalnızca eğitim verilerini ezberlemez.
Ayrıca veri kümesinin yüksek kaliteli şekilde etiketlendiğinden emin olmak da önemlidir. Yanlış etiketlenmiş veya dengesiz veriler, modelleri yanlış kalıpları öğrenmeye yönlendirebilir. Veri kümelerini temizlemek, yanlış etiketlenmiş görüntüleri düzeltmek ve sınıfları dengelemek doğruluğu artırır ve aşırı öğrenme riskini azaltır. Bir diğer etkili yaklaşım, modelin sınırlarını test etmek amacıyla tasarlanmış, biraz değiştirilmiş veya daha zorlu örneklere maruz bırakıldığı düşmanca eğitimdir.
Önemli çıkarımlar#
Aşırı öğrenme, bilgisayarlı görüde yaygın bir sorundur. Bir model eğitim verilerinde iyi çalışabilir ancak gerçek dünya görüntülerinde zorlanabilir. Bunu önlemek için veri artırma, düzenlileştirme ve Ultralytics YOLO11 gibi önceden eğitilmiş modellerin kullanılması doğruluğu ve uyarlanabilirliği artırmaya yardımcı olur.
Bu yöntemleri uygulayarak yapay zekâ modelleri güvenilir kalabilir ve farklı ortamlarda iyi performans gösterebilir. Derin öğrenme geliştikçe modellerin doğru şekilde genelleme yaptığından emin olmak, gerçek dünya yapay zekâ başarısının anahtarı olacaktır.
Büyüyen topluluğumuza katıl! Yapay zekâ hakkında daha fazla bilgi edinmek için GitHub depomuzu incele. Kendi bilgisayarlı görü projelerine başlamaya hazır mısın? Lisanslama seçeneklerimize göz at. Çözümler sayfalarımızı ziyaret ederek otonom araçlarda görü yapay zekâsını ve sağlık hizmetlerinde yapay zekâyı keşfet!








