视觉模型的发展历程
探索视觉模型的历史、成就、挑战和未来发展方向。
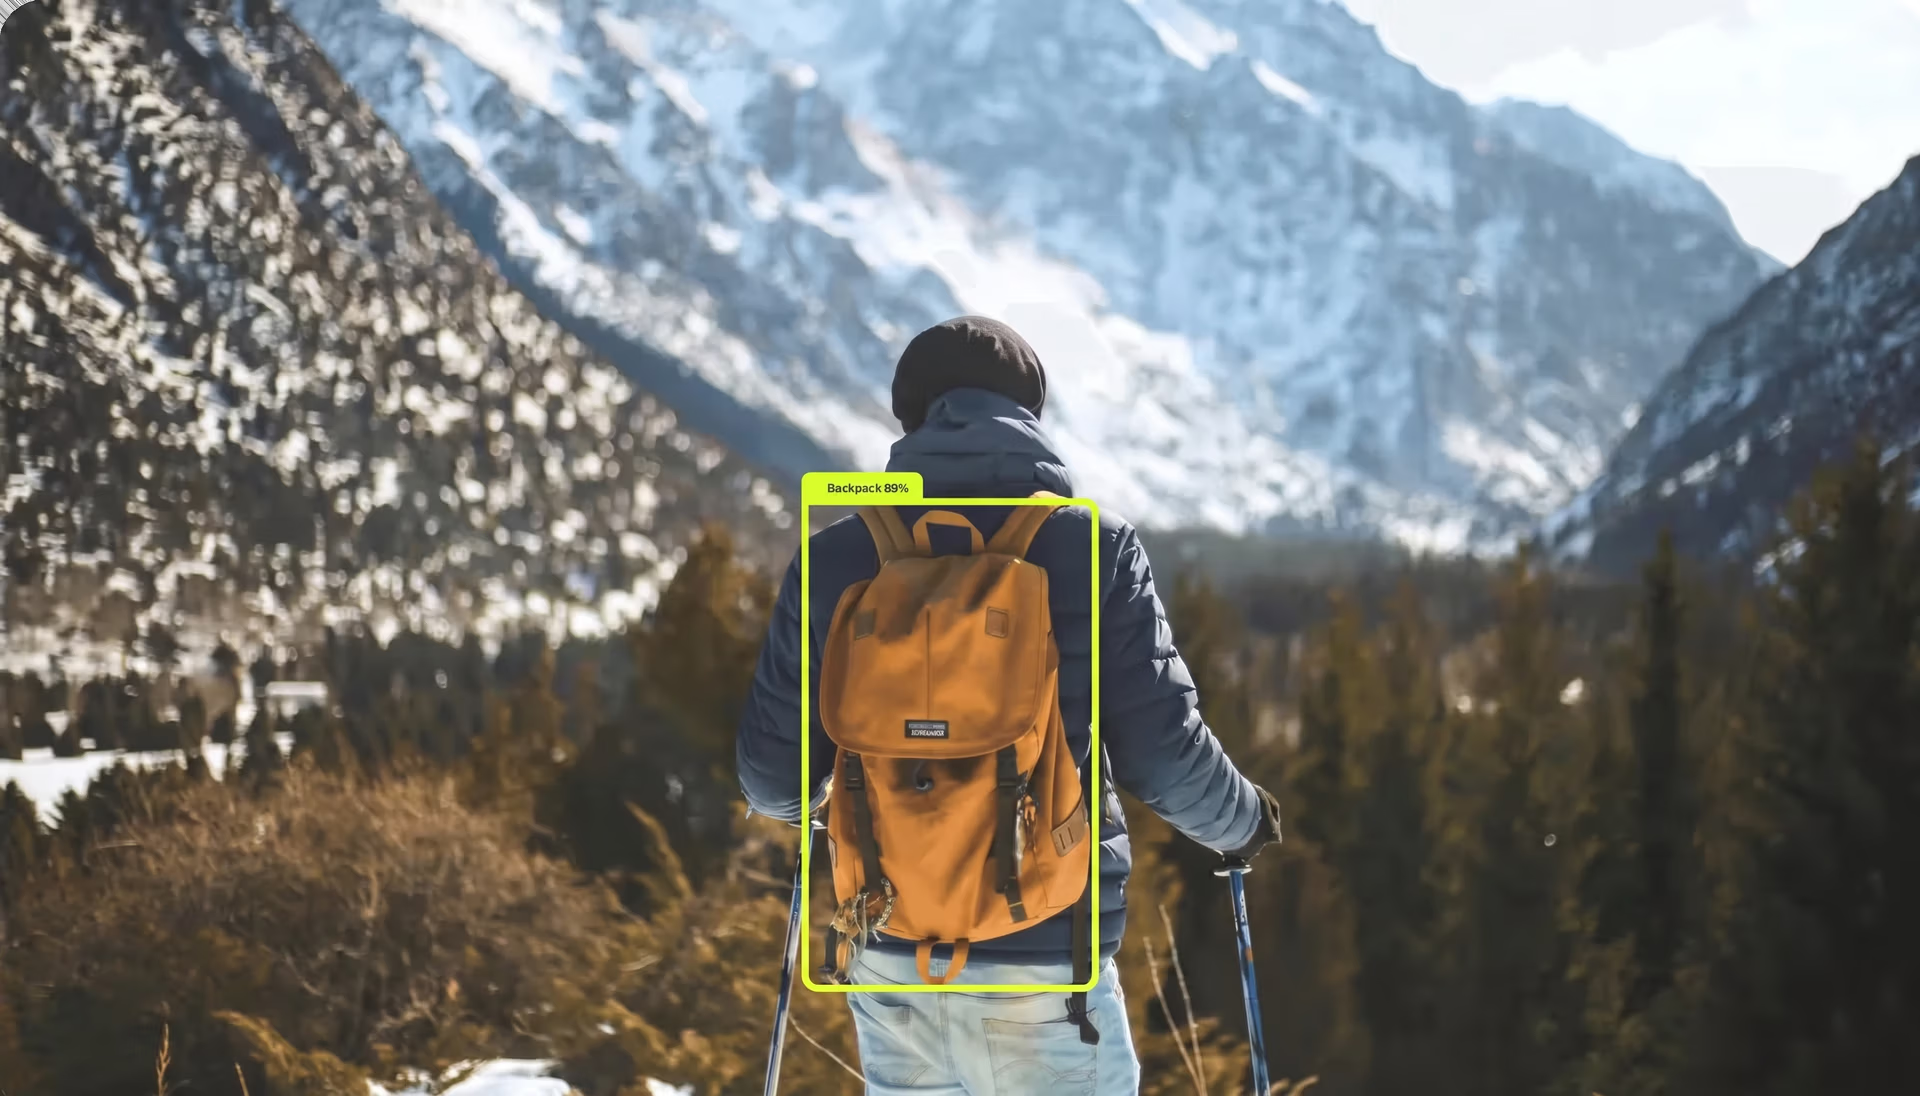
什么是计算机视觉#
想象一下,你走进一家商店,摄像头识别出你的面部、分析你的情绪,并实时推荐符合你偏好的商品。这不是科幻,而是现代视觉模型实现的现实。据 Fortune Business Insight 的一份报告显示,全球计算机视觉市场在 2023 年的估值为 203.1 亿美元,预计将从 2024 年的 254.1 亿美元增长至 2032 年的 1,757.2 亿美元,这反映了该技术在各行业快速发展并日益普及。
计算机视觉领域让计算机能够检测、识别和分析图像中的物体。与其他 AI 相关领域类似,计算机视觉在过去几十年里迅速发展,取得了显著进步。
计算机视觉的发展历史悠久。在早期,计算机视觉模型只能检测简单的形状和边缘,通常仅限于识别几何图案或区分明暗区域等基础任务。然而,如今的模型能够执行复杂任务,例如实时目标检测、人脸识别,甚至以极高的准确性和效率根据面部表情解读情绪。这一巨大进步凸显了计算能力、算法复杂度以及可用于训练的海量数据方面取得的惊人发展。
本文将探讨计算机视觉发展过程中的重要里程碑。我们将回顾计算机视觉的早期发展,深入了解卷积神经网络(CNNs)带来的变革性影响,并探讨此后取得的重要进展。
计算机视觉的早期发展#
与其他 AI 领域一样,计算机视觉的早期发展始于基础研究和理论工作。一个重要里程碑是 Lawrence G. Roberts 关于三维物体识别的开创性研究,该研究记录在他于 20 世纪 60 年代初完成的论文《三维实体的机器感知》中。他的贡献为该领域未来的发展奠定了基础。
首批算法——边缘检测#
早期计算机视觉研究侧重于图像处理技术,例如边缘检测和特征提取。20 世纪 60 年代末开发的 Sobel 算子等算法,是最早通过计算图像强度梯度来检测边缘的方法之一。
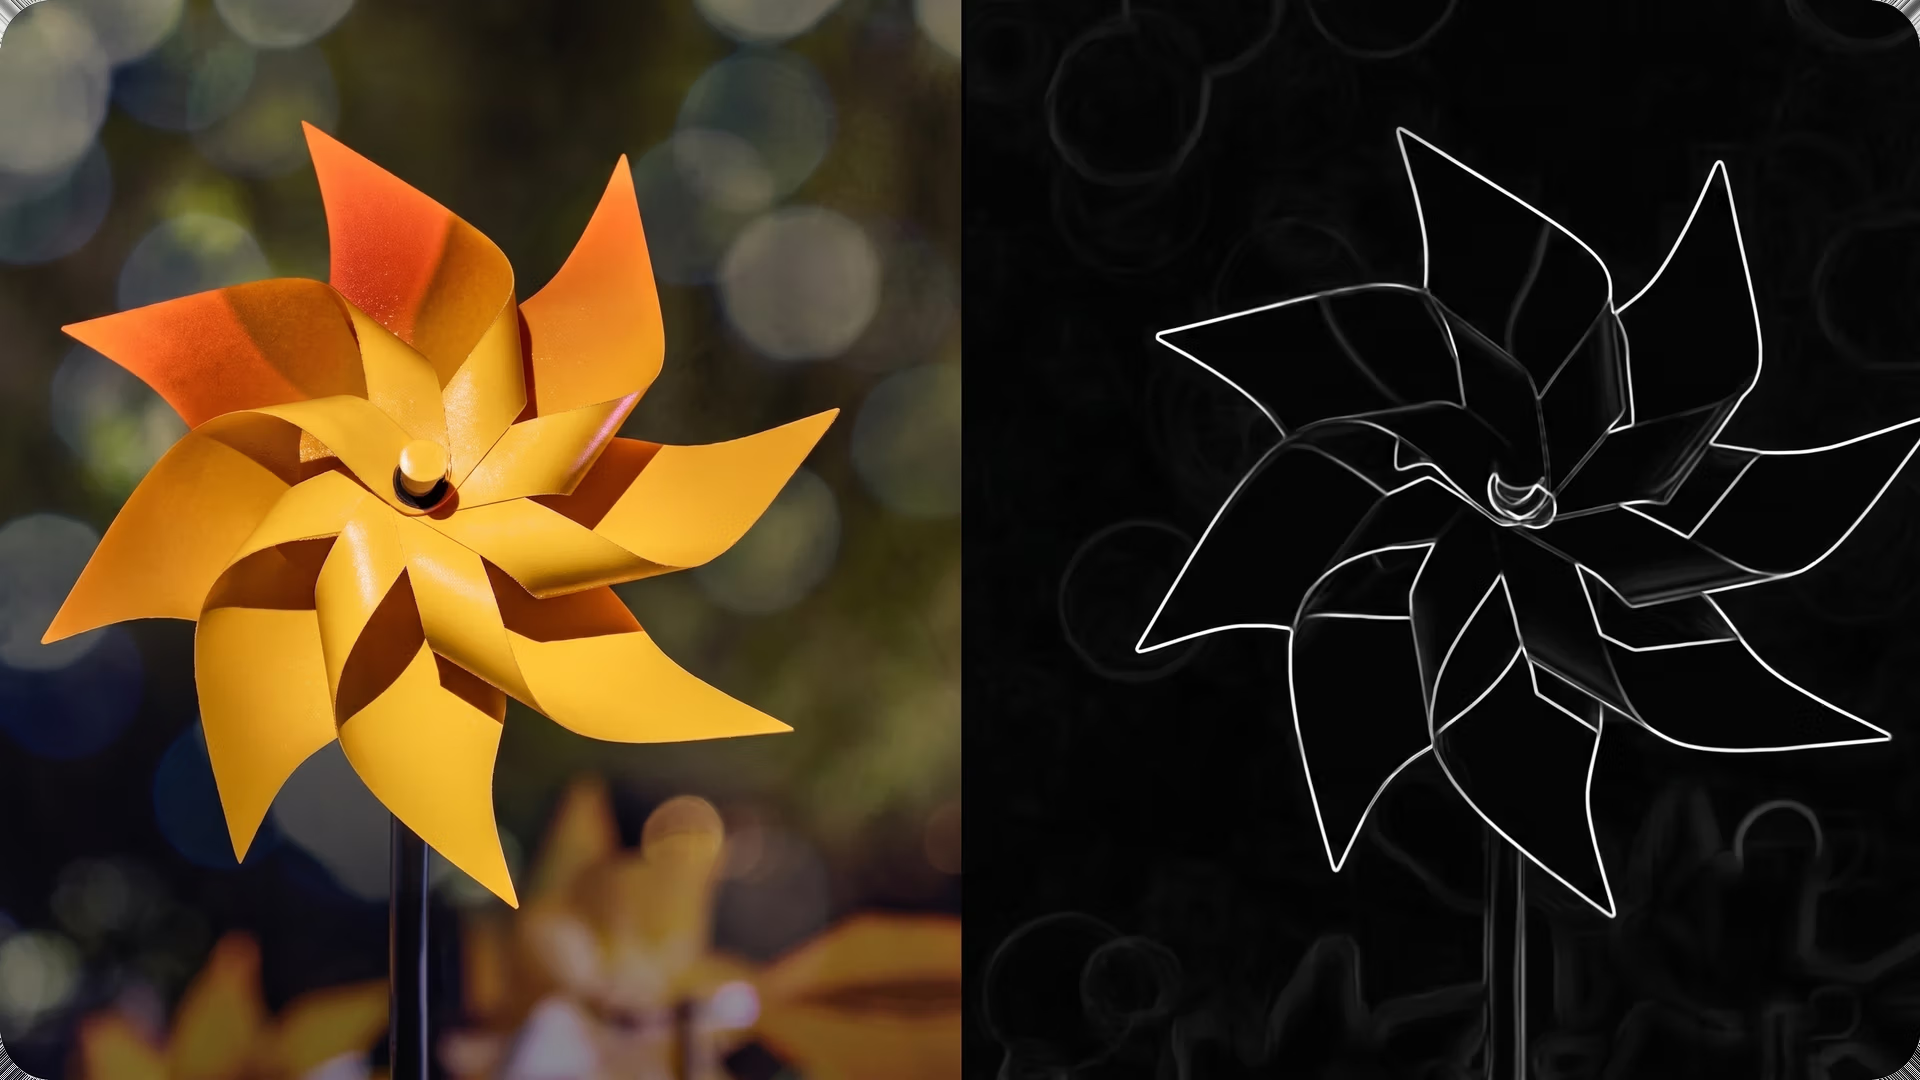
图 1。一张展示边缘检测的图像,左侧是原始物体,右侧是经过边缘检测的版本。
Sobel 和 Canny 等边缘检测技术在识别图像中的边界方面发挥了关键作用,而识别边界对于识别物体和理解场景至关重要。
机器学习与计算机视觉#
模式识别#
20 世纪 70 年代,模式识别成为计算机视觉的一个重要研究方向。研究人员开发了识别图像中形状、纹理和物体的方法,为更复杂的视觉任务铺平了道路。
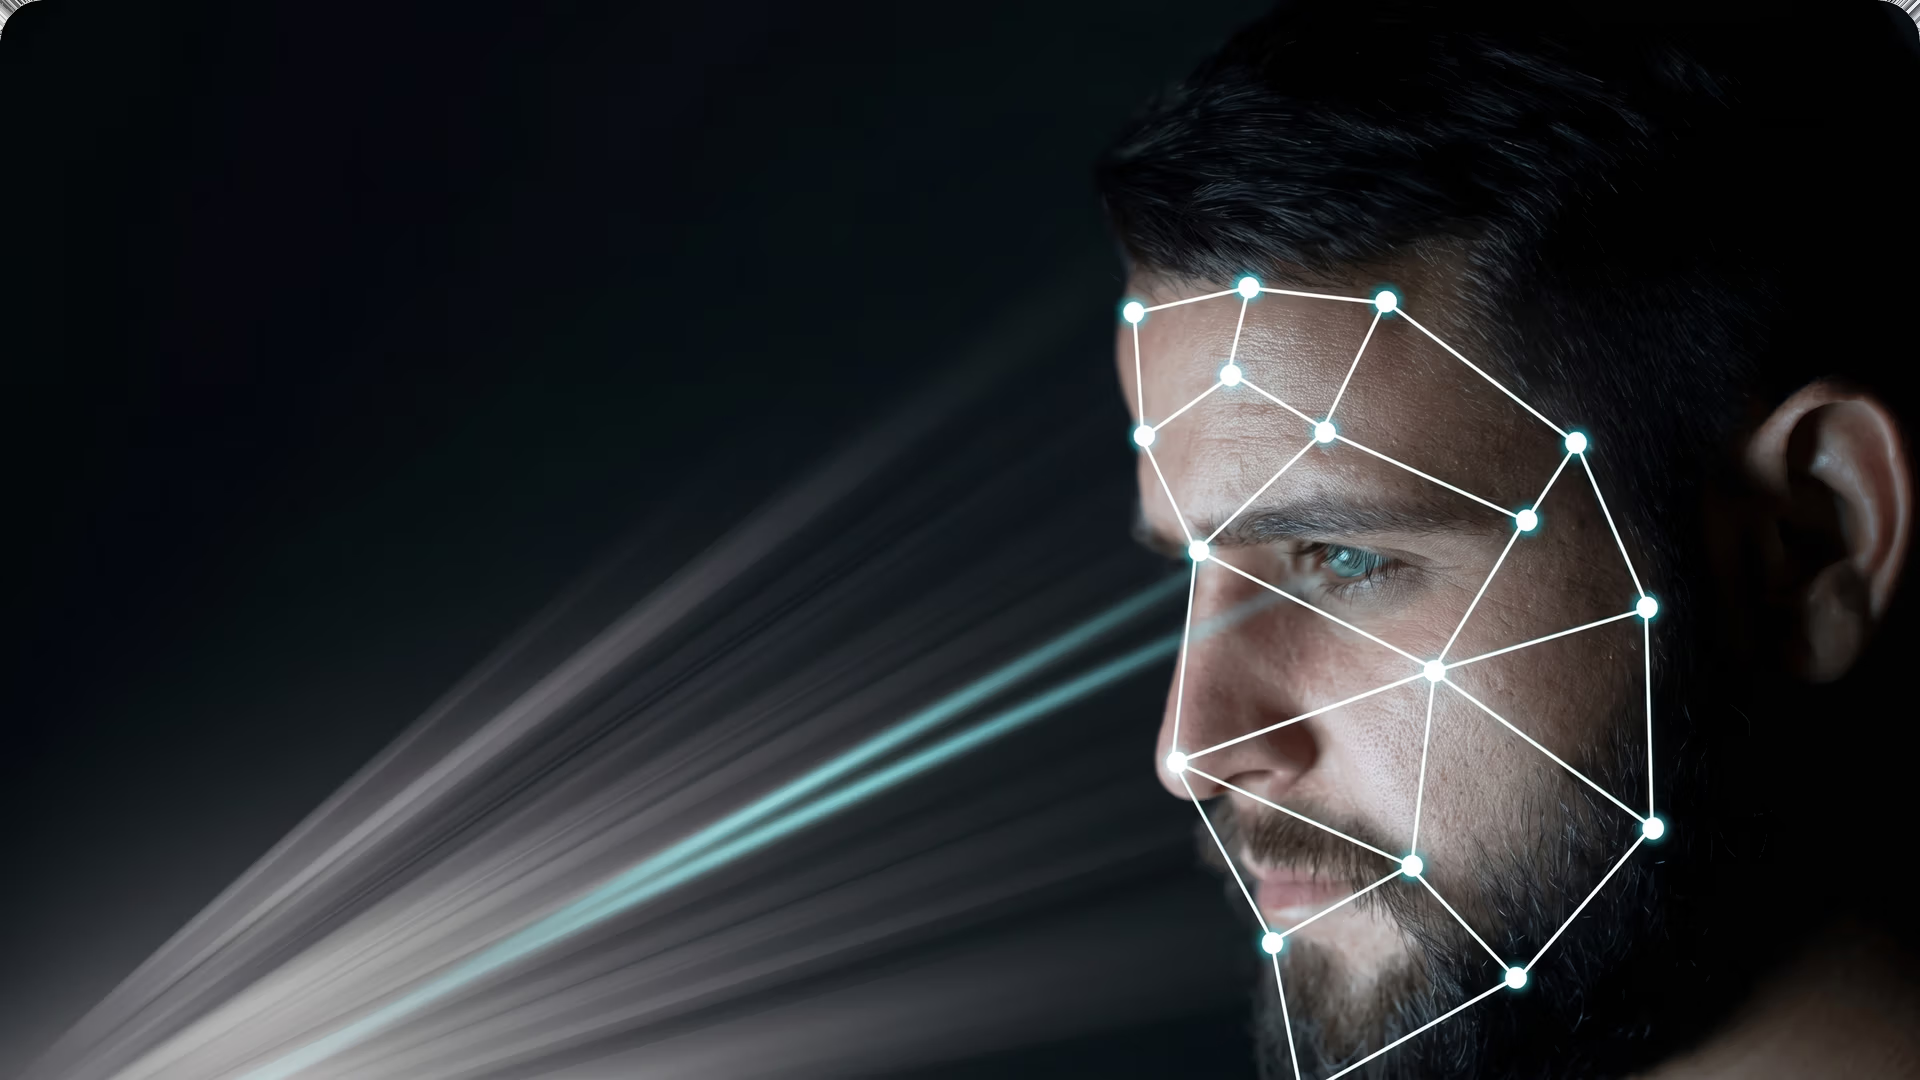
图 2. 模式识别。
早期的一种模式识别方法是模板匹配,即将图像与一组模板进行比较,以找出最佳匹配。该方法容易受到尺度、旋转和噪声变化的影响,因此存在局限。
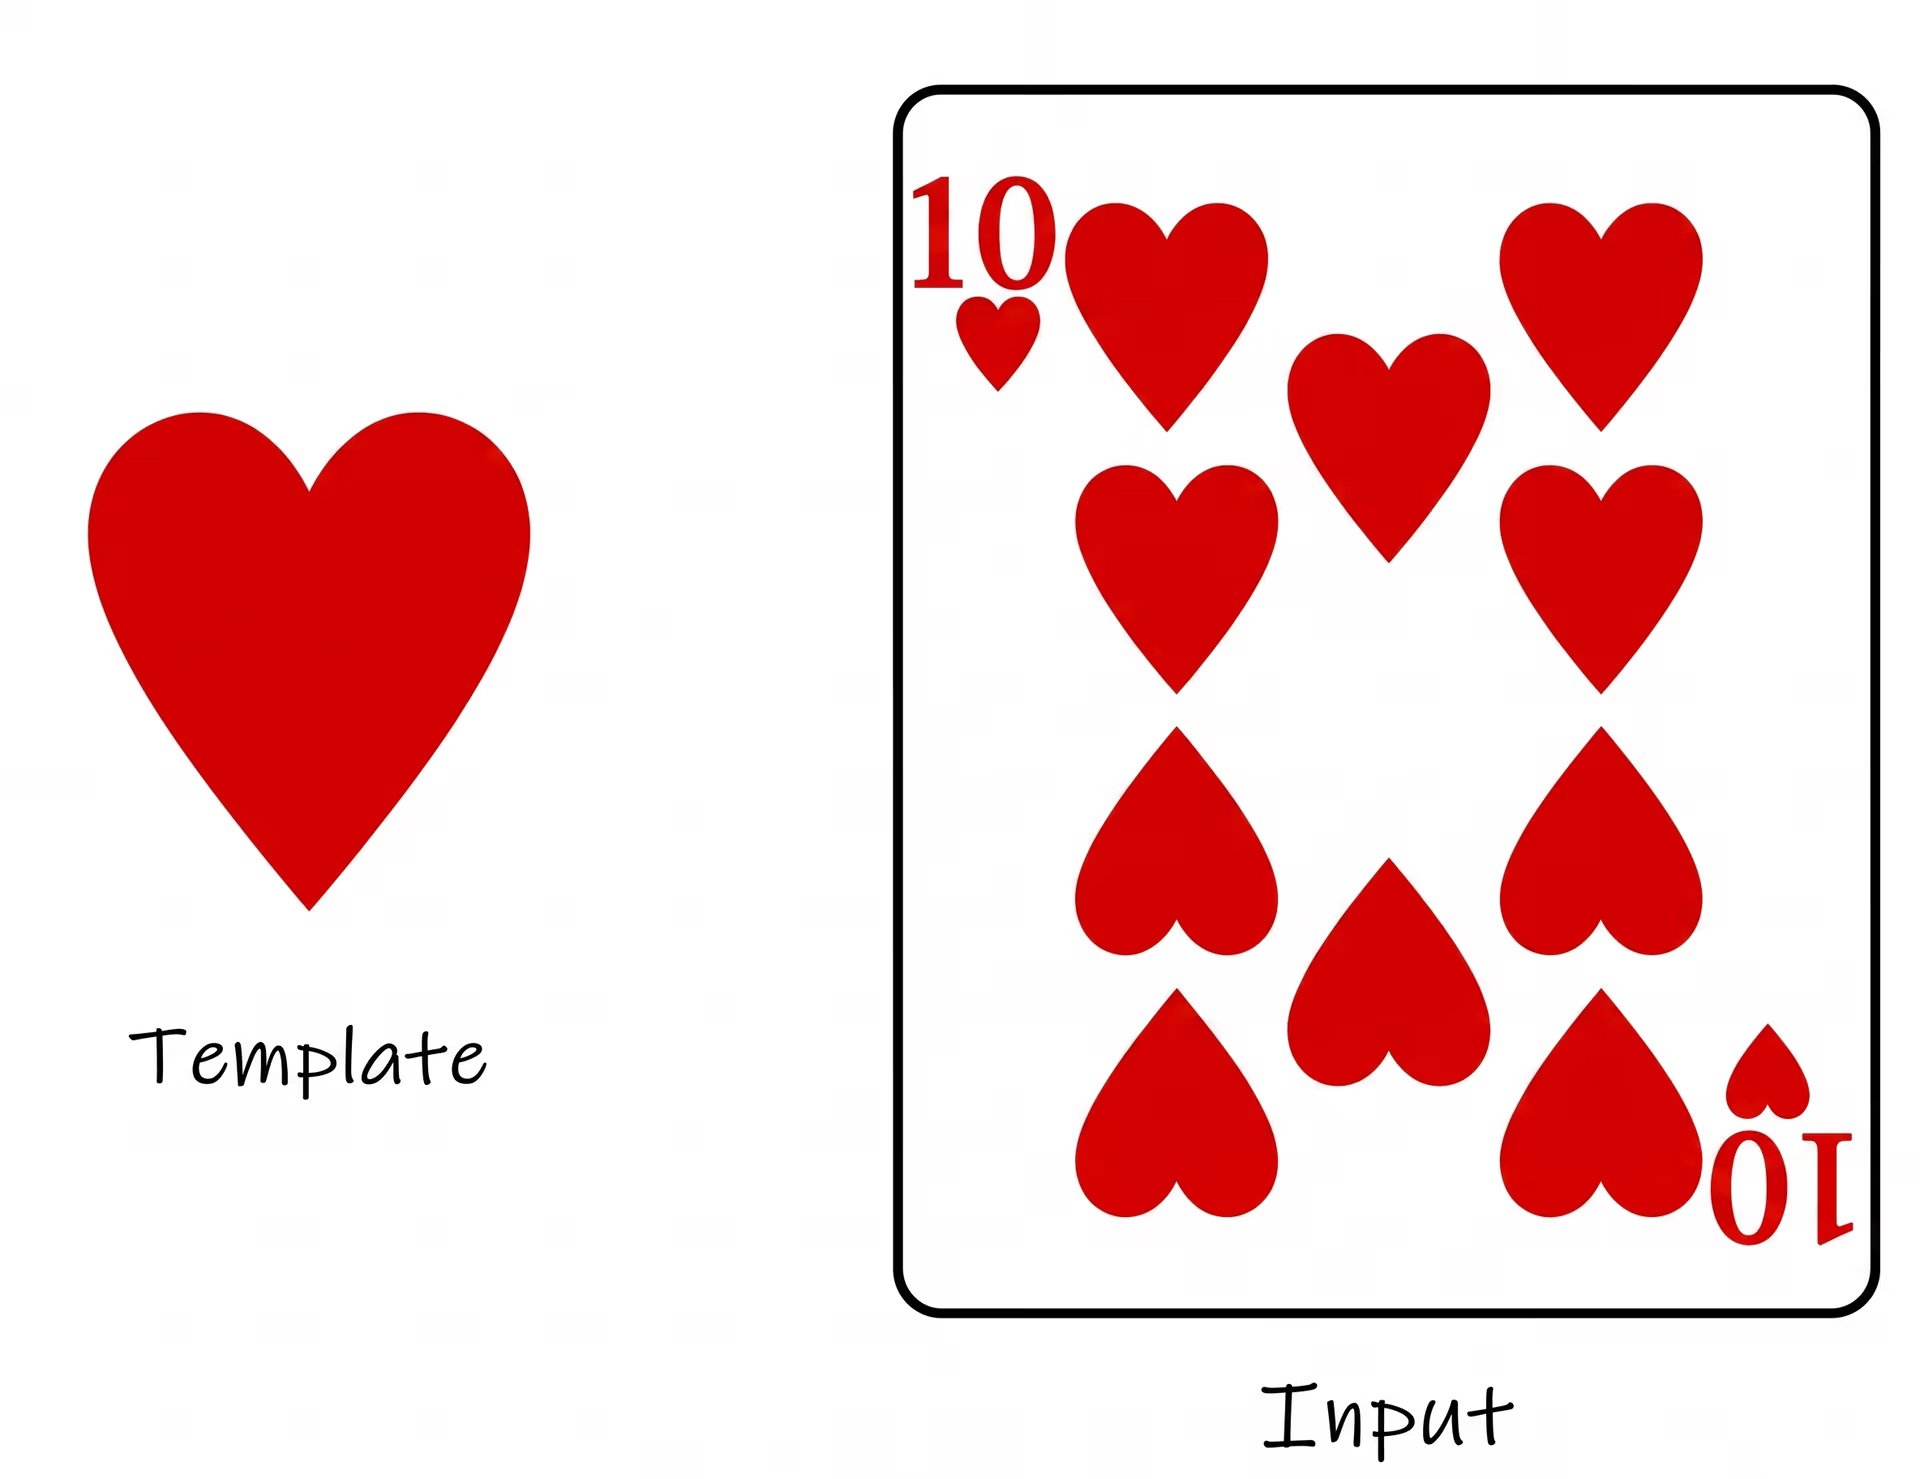
图 3。左侧的模板在右侧图像中找到匹配内容。
早期计算机视觉系统受限于当时有限的计算能力。20 世纪 60 年代和 70 年代的计算机体积庞大、价格昂贵,处理能力也有限。
深度学习带来的变革#
深度学习与卷积神经网络#
深度学习和卷积神经网络(CNNs)标志着计算机视觉领域的一个关键转折点。这些进步彻底改变了计算机理解和分析视觉数据的方式,使许多过去被认为不可能的应用成为现实。
CNN 如何工作?#
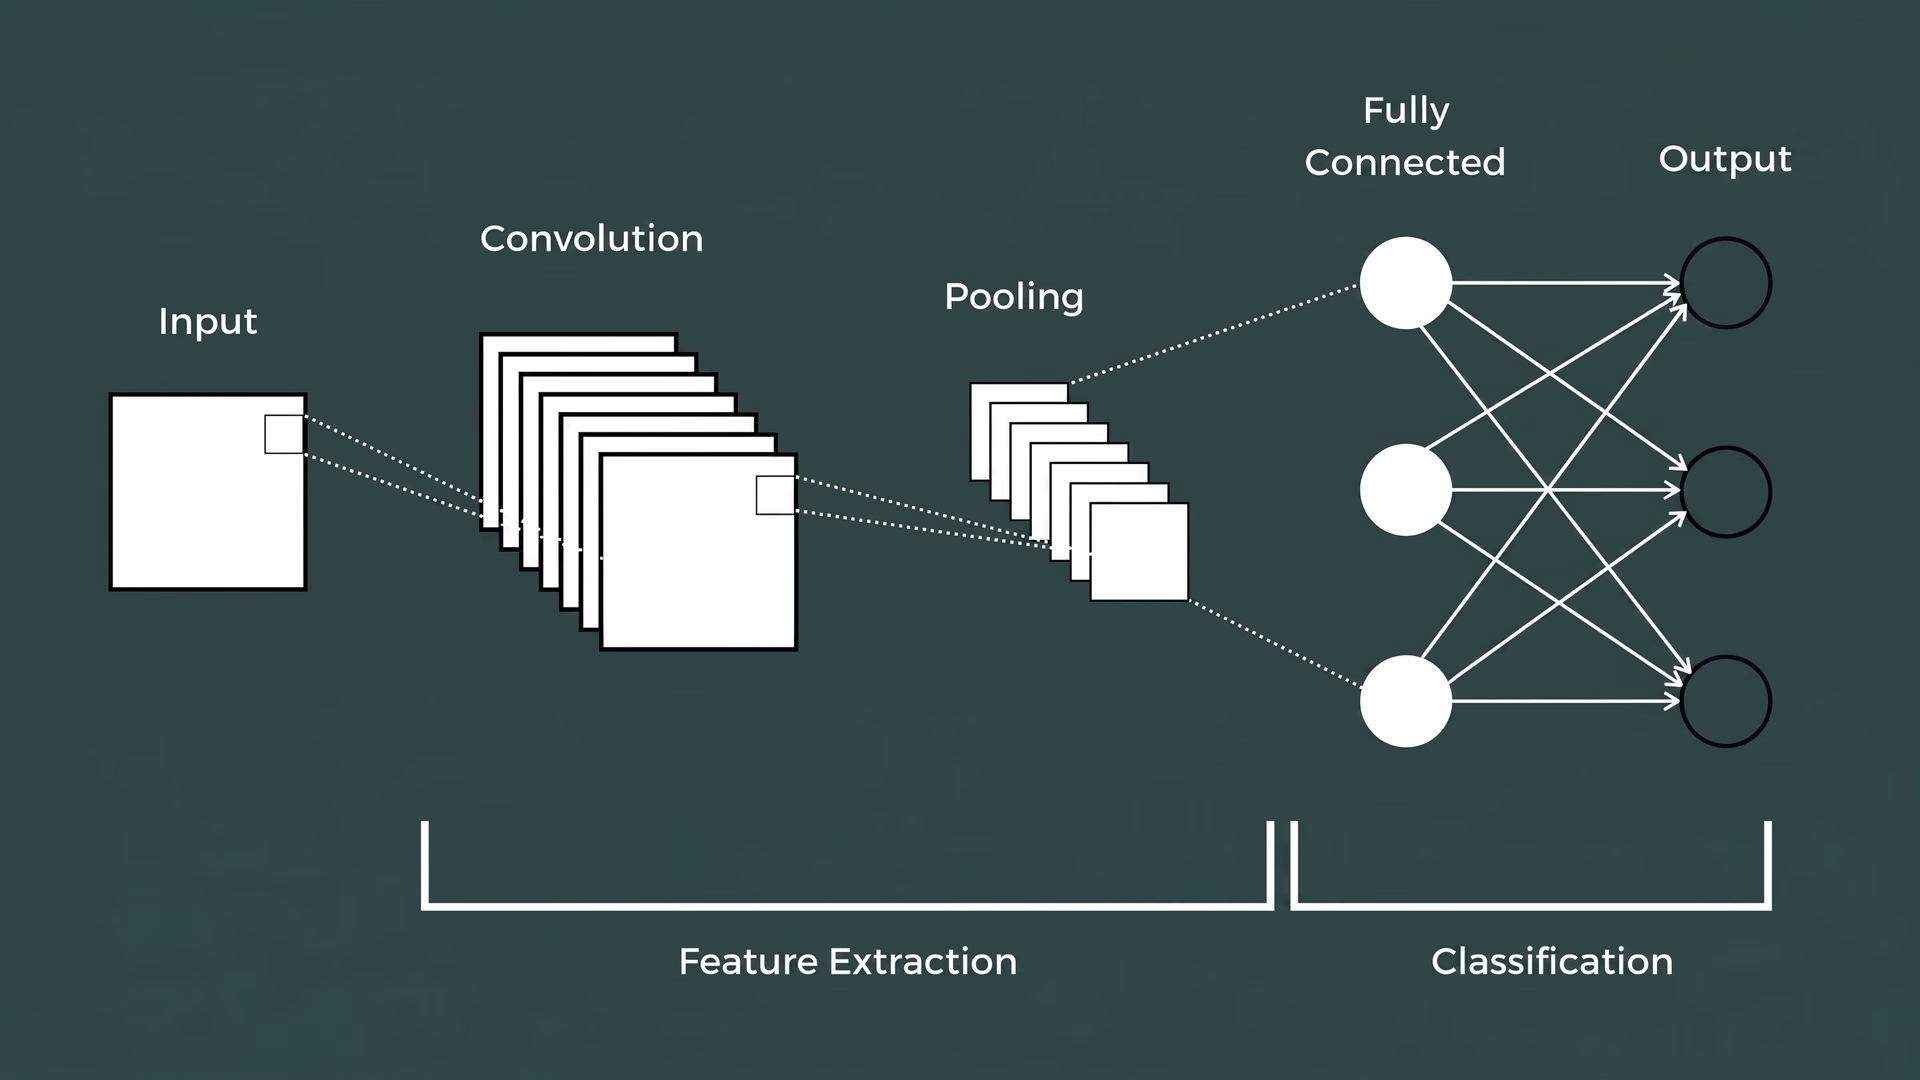
图 4。卷积神经网络(CNN)的架构。
- 卷积层:CNN 使用卷积层。卷积层是一种深度学习模型,专为处理图像或序列等结构化网格数据而设计,能够自动学习层次化模式。它通过滤波器或卷积核扫描图像。滤波器在图像上滑动并计算点积,从而检测边缘、纹理和颜色等各种特征。每个滤波器都会激活图像中的特定模式,使模型能够学习层次化特征。
- 激活函数:卷积之后会使用激活函数,例如 ReLU(修正线性单元)。ReLU 是一种常用的深度学习激活函数:输入为正时直接输出输入值,否则输出零,从而帮助神经网络高效地学习数据中的非线性关系。这有助于网络学习复杂模式和表征。
- 池化层:池化层会对特征图进行下采样,以降低其维度。这有助于提取最相关的特征,同时减少计算开销和过拟合。
- 全连接层:CNN 的最后几层是全连接层,用于解读卷积层和池化层提取的特征并做出预测。这些层与传统神经网络中的层类似。
CNN 视觉模型的发展历程#
视觉模型的发展历程十分丰富,其中一些模型尤为突出:
-
LeNet(1989 年):LeNet 是最早的 CNN 架构之一,主要用于识别手写支票上的数字。它的成功为更复杂的 CNN 奠定了基础,证明了深度学习在图像处理领域的潜力。
-
AlexNet(2012 年):AlexNet 在 ImageNet 竞赛中显著超越了现有模型,展现了深度学习的强大能力。该模型采用了 ReLU 激活、dropout 和数据增强,在图像分类领域创下新纪录,并引发了人们对 CNN 的广泛关注。
-
VGGNet(2014 年):VGGNet 使用较小的卷积滤波器(3x3),在图像分类任务中取得了出色的结果,进一步证明了网络深度对于提升准确性的重要性。
-
ResNet(2015 年):ResNet 通过引入残差学习,解决了深层网络中的退化问题。这项创新使训练更深层的网络成为可能,并让 ResNet 在各种计算机视觉任务中取得了最先进的性能。
-
YOLO(只看一次):YOLO 将目标检测构建为单个回归问题,从整幅图像中一次性预测边界框和类别概率,彻底革新了目标检测。这种方法以前所未有的速度和准确性实现了实时目标检测,因此适用于需要即时处理的应用,例如自动驾驶和监控。
计算机视觉的应用#
医疗健康#
计算机视觉的用途十分广泛。例如,Ultralytics YOLOv8等视觉模型被用于医学影像,以检测癌症和糖尿病视网膜病变等疾病。它们能够高精度地分析 X 光片、MRI 和 CT 扫描图像,及早发现异常。这种早期检测能力有助于及时干预并改善患者的治疗效果。
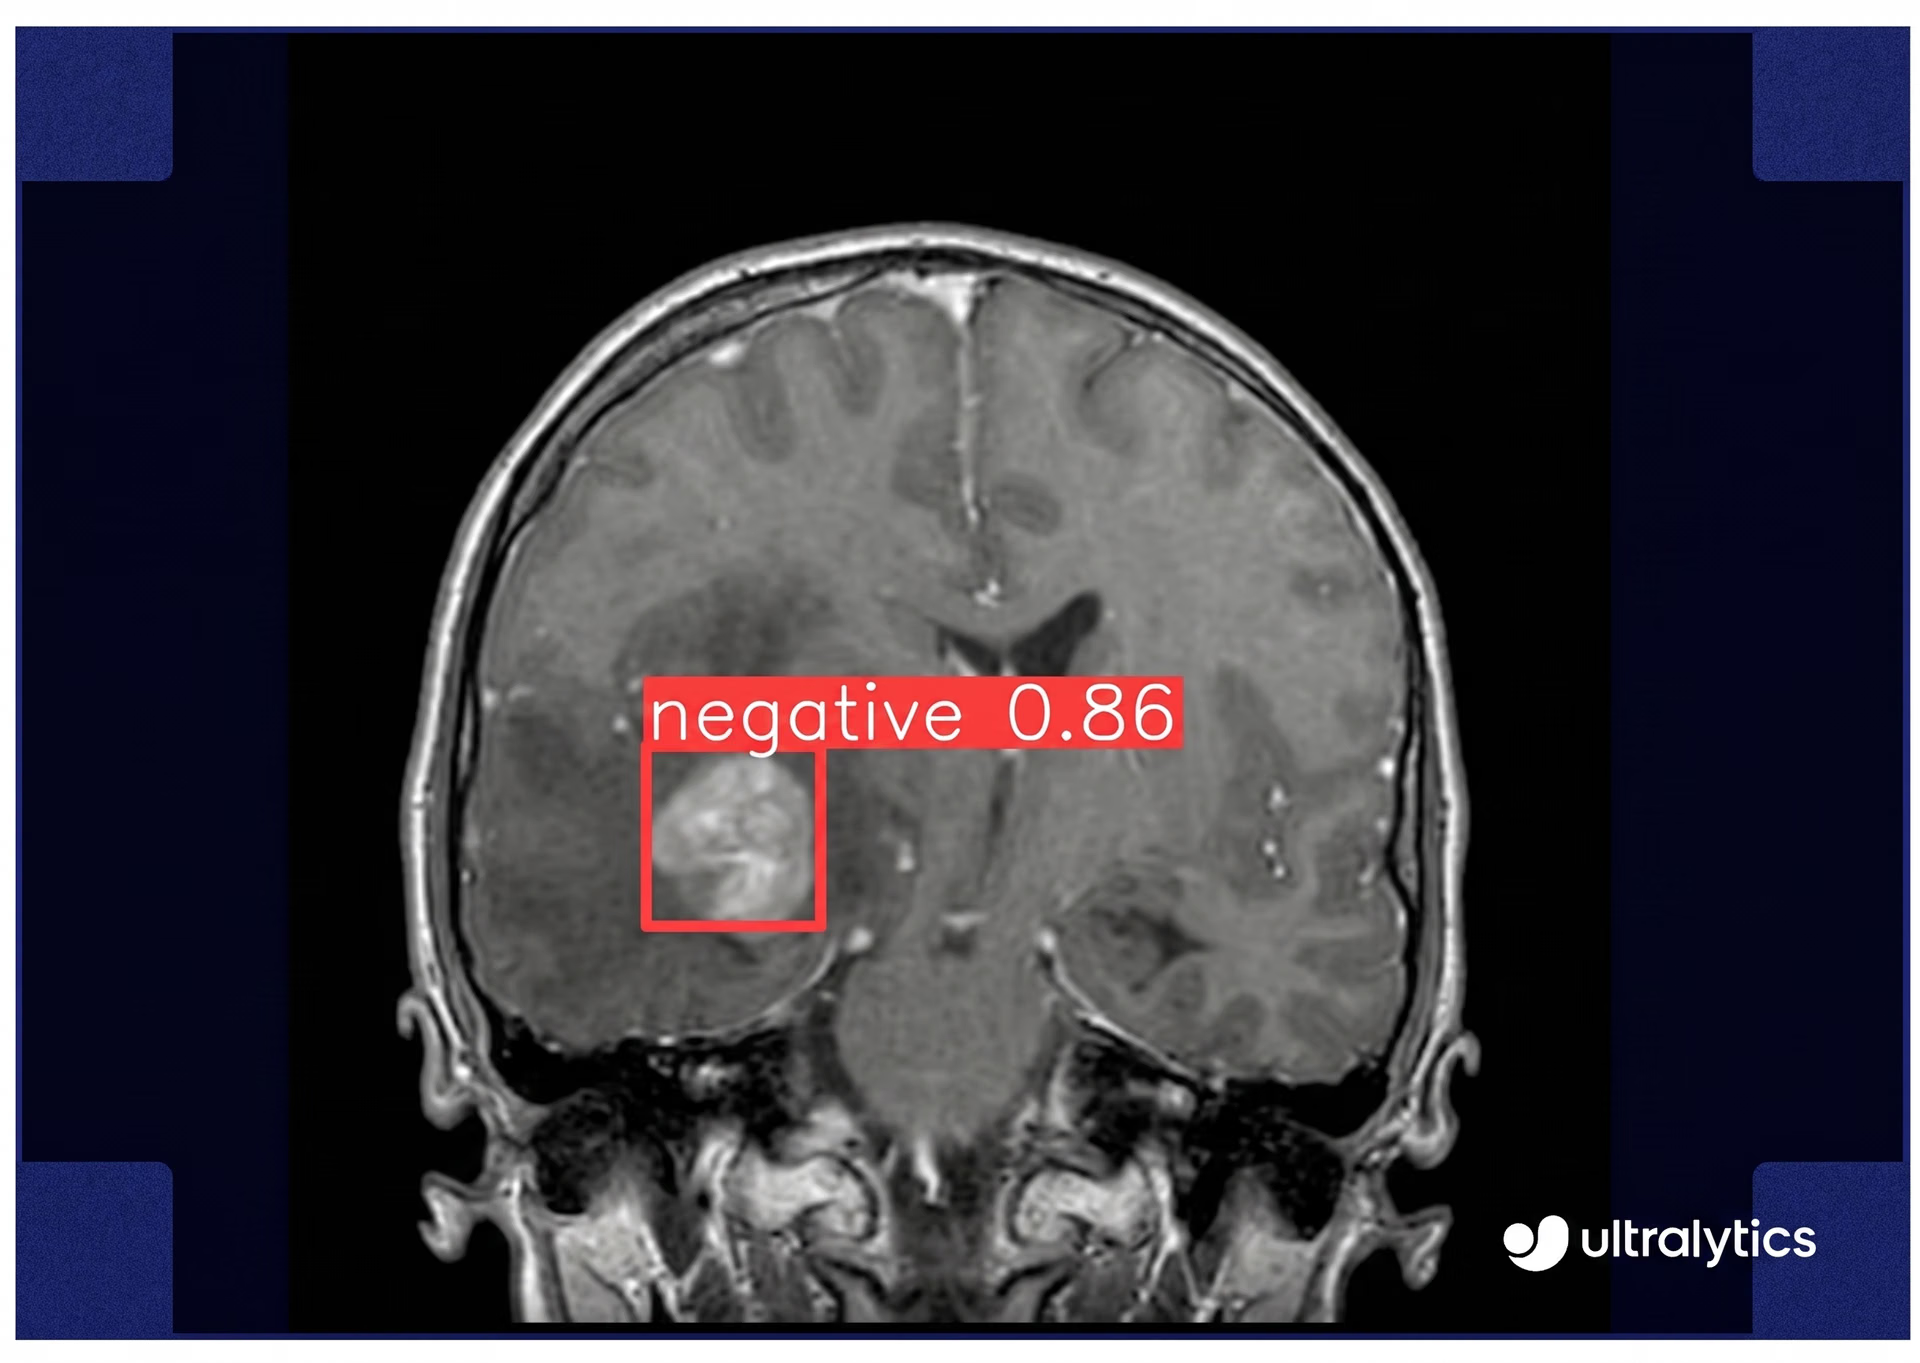
图 5. 使用 Ultralytics YOLOv8检测脑肿瘤。
环境保护#
计算机视觉模型通过分析野生动物栖息地的图像和视频,帮助监测和保护濒危物种。模型能够识别并追踪动物的行为,提供有关动物种群和活动的数据。这项技术有助于制定保护策略和政策决策,以保护老虎和大象等物种。
借助视觉 AI,还可以监测野火和森林砍伐等其他环境威胁,确保地方当局能够迅速响应。
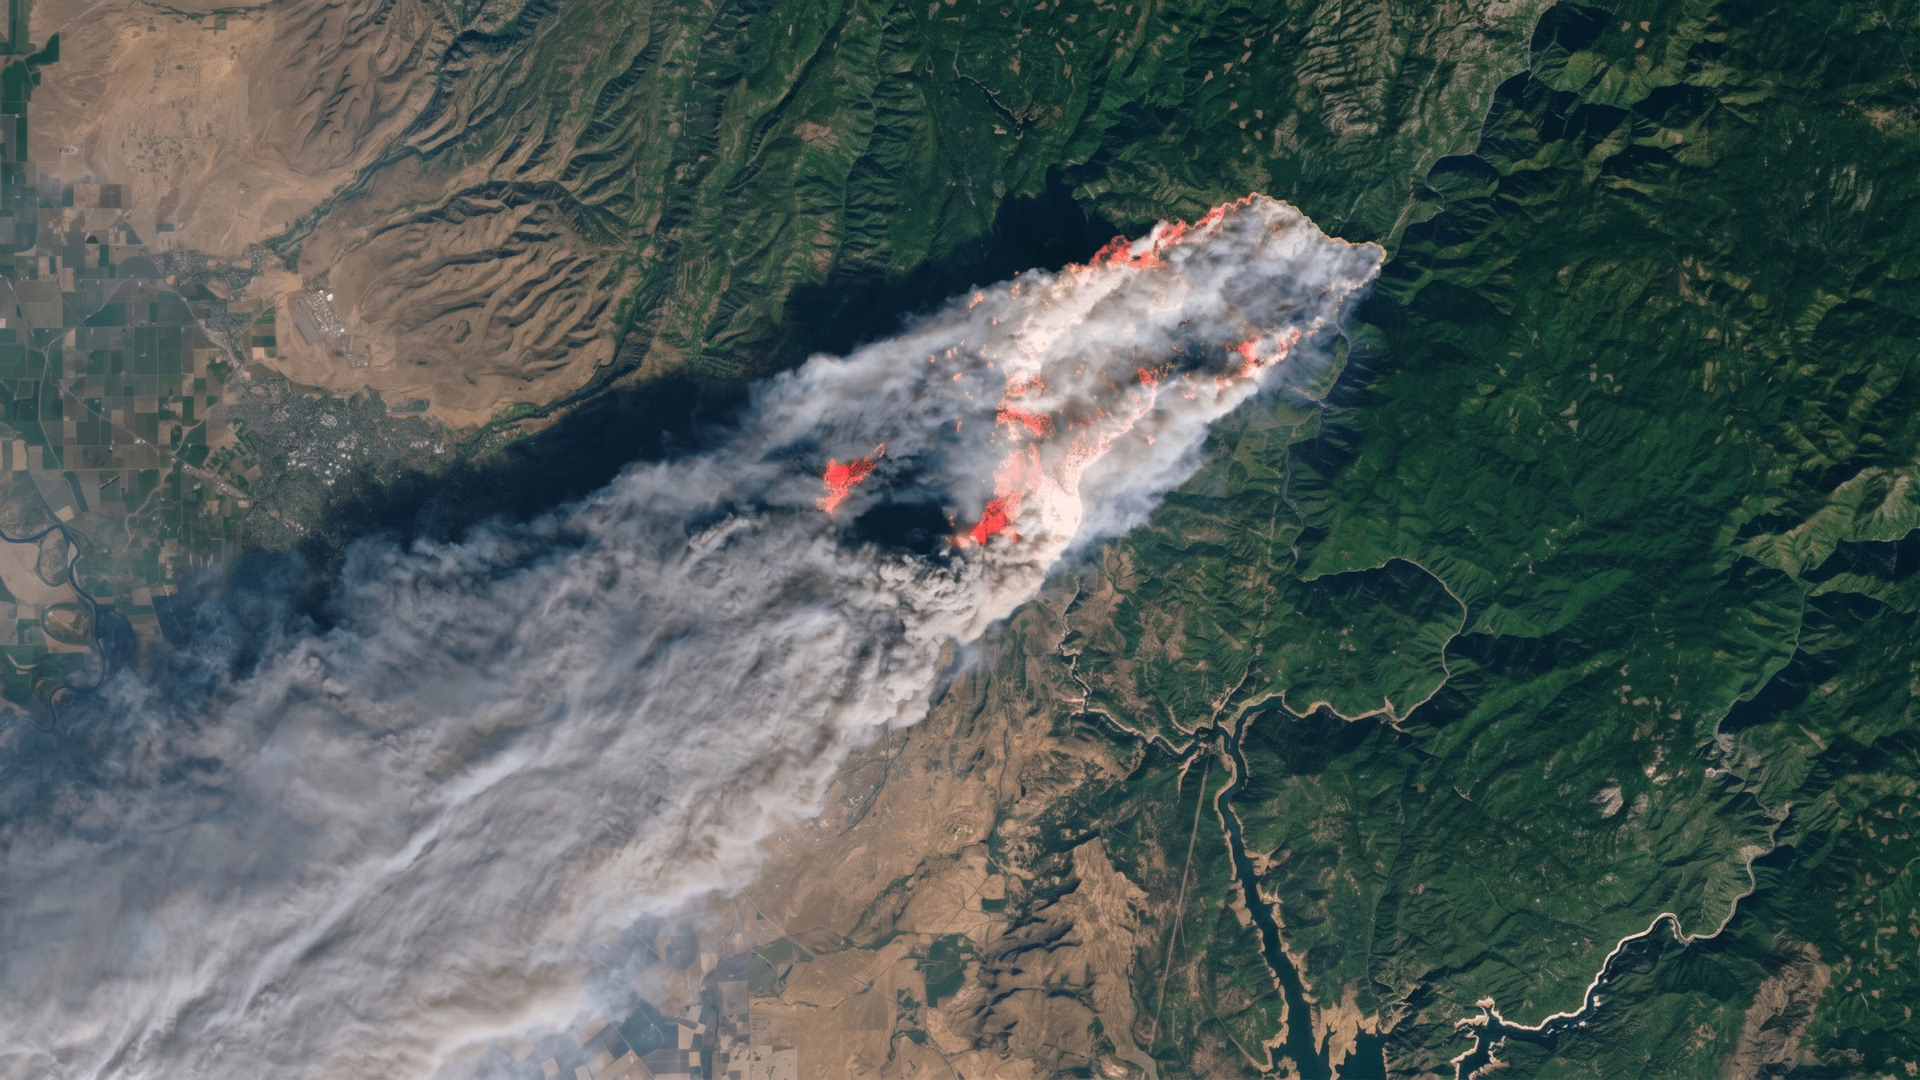
图 6。野火的卫星图像。
挑战与未来方向#
尽管视觉模型已经取得了显著成就,但由于其极高的复杂性和开发过程中的诸多要求,它们仍面临许多挑战,需要持续研究并进一步发展。
可解释性与可理解性#
视觉模型,尤其是深度学习模型,常被视为透明度有限的“黑箱”,这是因为这类模型极其复杂。缺乏可解释性会削弱人们的信任,也不利于追究责任,在医疗健康等关键应用中尤其如此。
计算需求#
训练和部署最先进的 AI 模型需要大量计算资源。视觉模型尤其如此,因为它们通常需要处理大量图像和视频数据。高清图像和视频是数据量最大的训练输入之一,会进一步增加计算负担。例如,一张高清图像可能占用数 MB 的存储空间,因此训练过程既耗费资源,也耗费时间。
因此,我们需要强大的硬件和经过优化的计算机视觉算法,以处理开发高效视觉模型所涉及的海量数据和复杂计算。针对更高效架构、模型压缩以及 GPU 和 TPU 等硬件加速器的研究,是推动视觉模型未来发展的关键方向。
这些改进旨在降低计算需求并提高处理效率。此外,利用 Ultralytics YOLOv8等先进的预训练模型,可以大幅减少大量训练的需求,简化开发流程并提升效率。
不断演进的领域#
如今,视觉模型的应用十分广泛,从医疗健康领域的肿瘤检测,到交通监控等日常用途,都能见到它们的身影。这些先进模型通过提供更高的准确性、效率和能力,为无数行业带来了创新,而这些优势在过去难以想象。
随着技术不断进步,视觉模型在创新和改善生活与产业各方面的潜力依然无穷无尽。这种持续演进凸显了在计算机视觉领域继续开展研究和开发的重要性。
想了解视觉 AI 的未来吗?如需了解最新进展,请查阅 Ultralytics 文档,并在 Ultralytics GitHub和 YOLOv8 GitHub上查看相关项目。此外,如需了解 AI 在各行业的应用,自动驾驶汽车和制造业解决方案页面也提供了特别实用的信息。









