使用图像分割进行 AI 文档认证
了解 AI 和图像分割如何验证文件真伪、检测被篡改的身份证件和签名,并防范银行和政府机构中的欺诈行为。
 Mostafa Ibrahim9 分钟阅读
试想这样一个世界:被篡改的文档能在几秒内被标记出来,欺诈行为在发生前就被制止,验证任何文档的真伪也变得轻而易举。借助人工智能(AI)及其在文档验证图像分割方面的进步,这一切都能成为现实。
护照、身份证和金融记录等重要文件的真实性持续面临威胁。美国的欺诈损失已超过100 亿美元,因此对强大的文档验证系统的需求比以往任何时候都更加迫切。依赖人工检查的传统验证方法越来越难以应对快速演变的伪造技术所带来的挑战。基于 AI 的验证可以改变我们保护这些文件的方式。
AI 可以将文档拆解为文本块、签名和安全特征等关键组成部分,细致检测人眼无法发现的不一致之处,改变银行、法律领域和政府机构确保安全与信任的方式。欺诈给组织造成的损失相当于其年收入的5%,AI 驱动的解决方案可以有效减少这些损失。
本文将探讨 AI 如何重塑文档认证,从提高效率到防止欺诈。如果你是保护敏感信息的企业,或是管理个人记录的个人,AI 都能改变我们保护和验证生活中最重要文件的方式。
了解 AI 中的图像分割#
图像分割是将图像划分为不同区域,例如使用计算机视觉模型分割街道上的汽车、自行车和其他物体。应用于文档时,图像分割可以分出文本、签名和印章等元素。这个过程会拆解复杂图像,让 AI 模型聚焦于特定组成部分,因此成为检测文档篡改或伪造的重要工具。
Ultralytics YOLOv8 等计算机视觉模型可用于实时目标检测和分割任务。通过训练和应用这些模型,可以对文档进行分割,识别文本块、签名和水印等重要元素,协助完成文档认证。
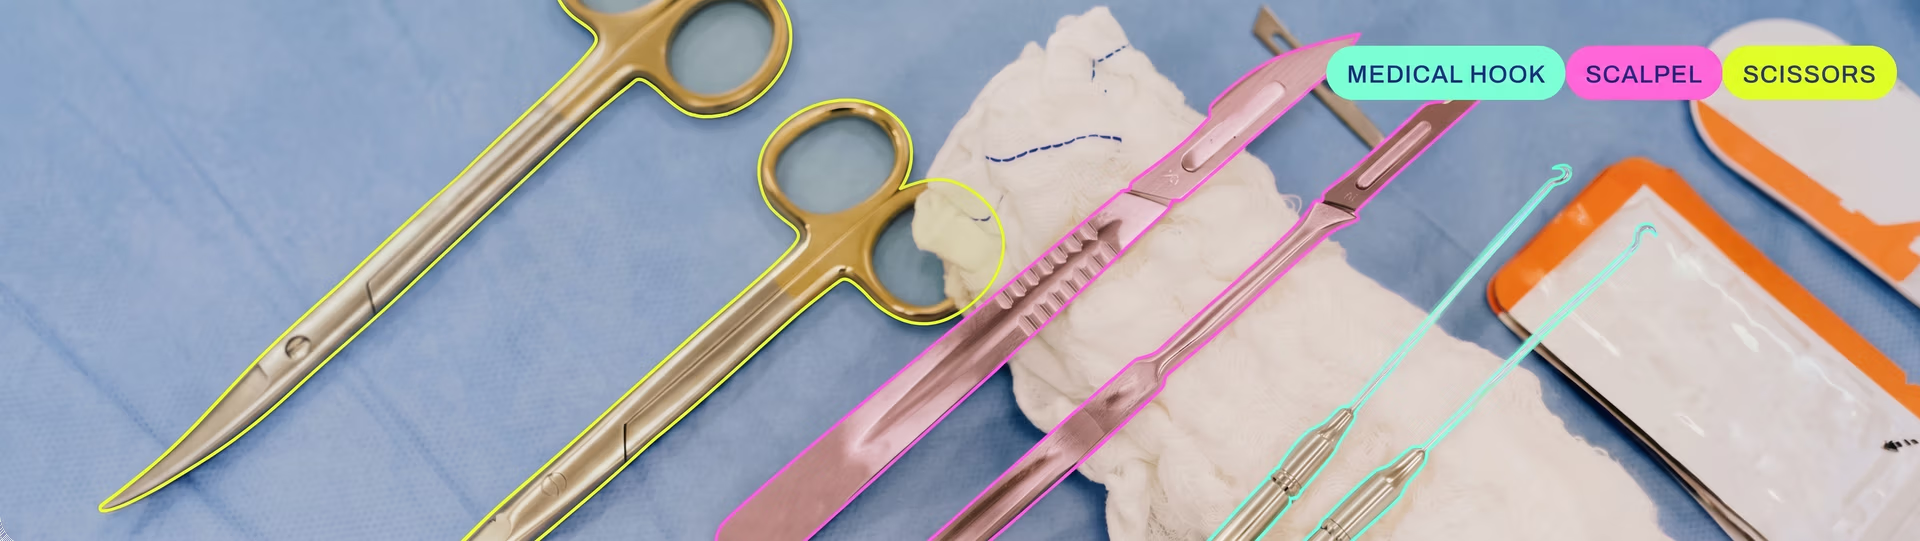
图 1. Ultralytics YOLOv8 模型在图像中分割并识别手术工具,以提升医学分析效果。
在文档认证中,实例分割可以分离文本块、签名、图像以及水印等安全特征。这样,AI 就能仔细检查每个元素,查找文本或字体被修改、签名不匹配等差异,从而更好地检测篡改。在文档安全领域使用图像分割,对于确保各行业文档的真实性和安全性可以发挥重要作用。
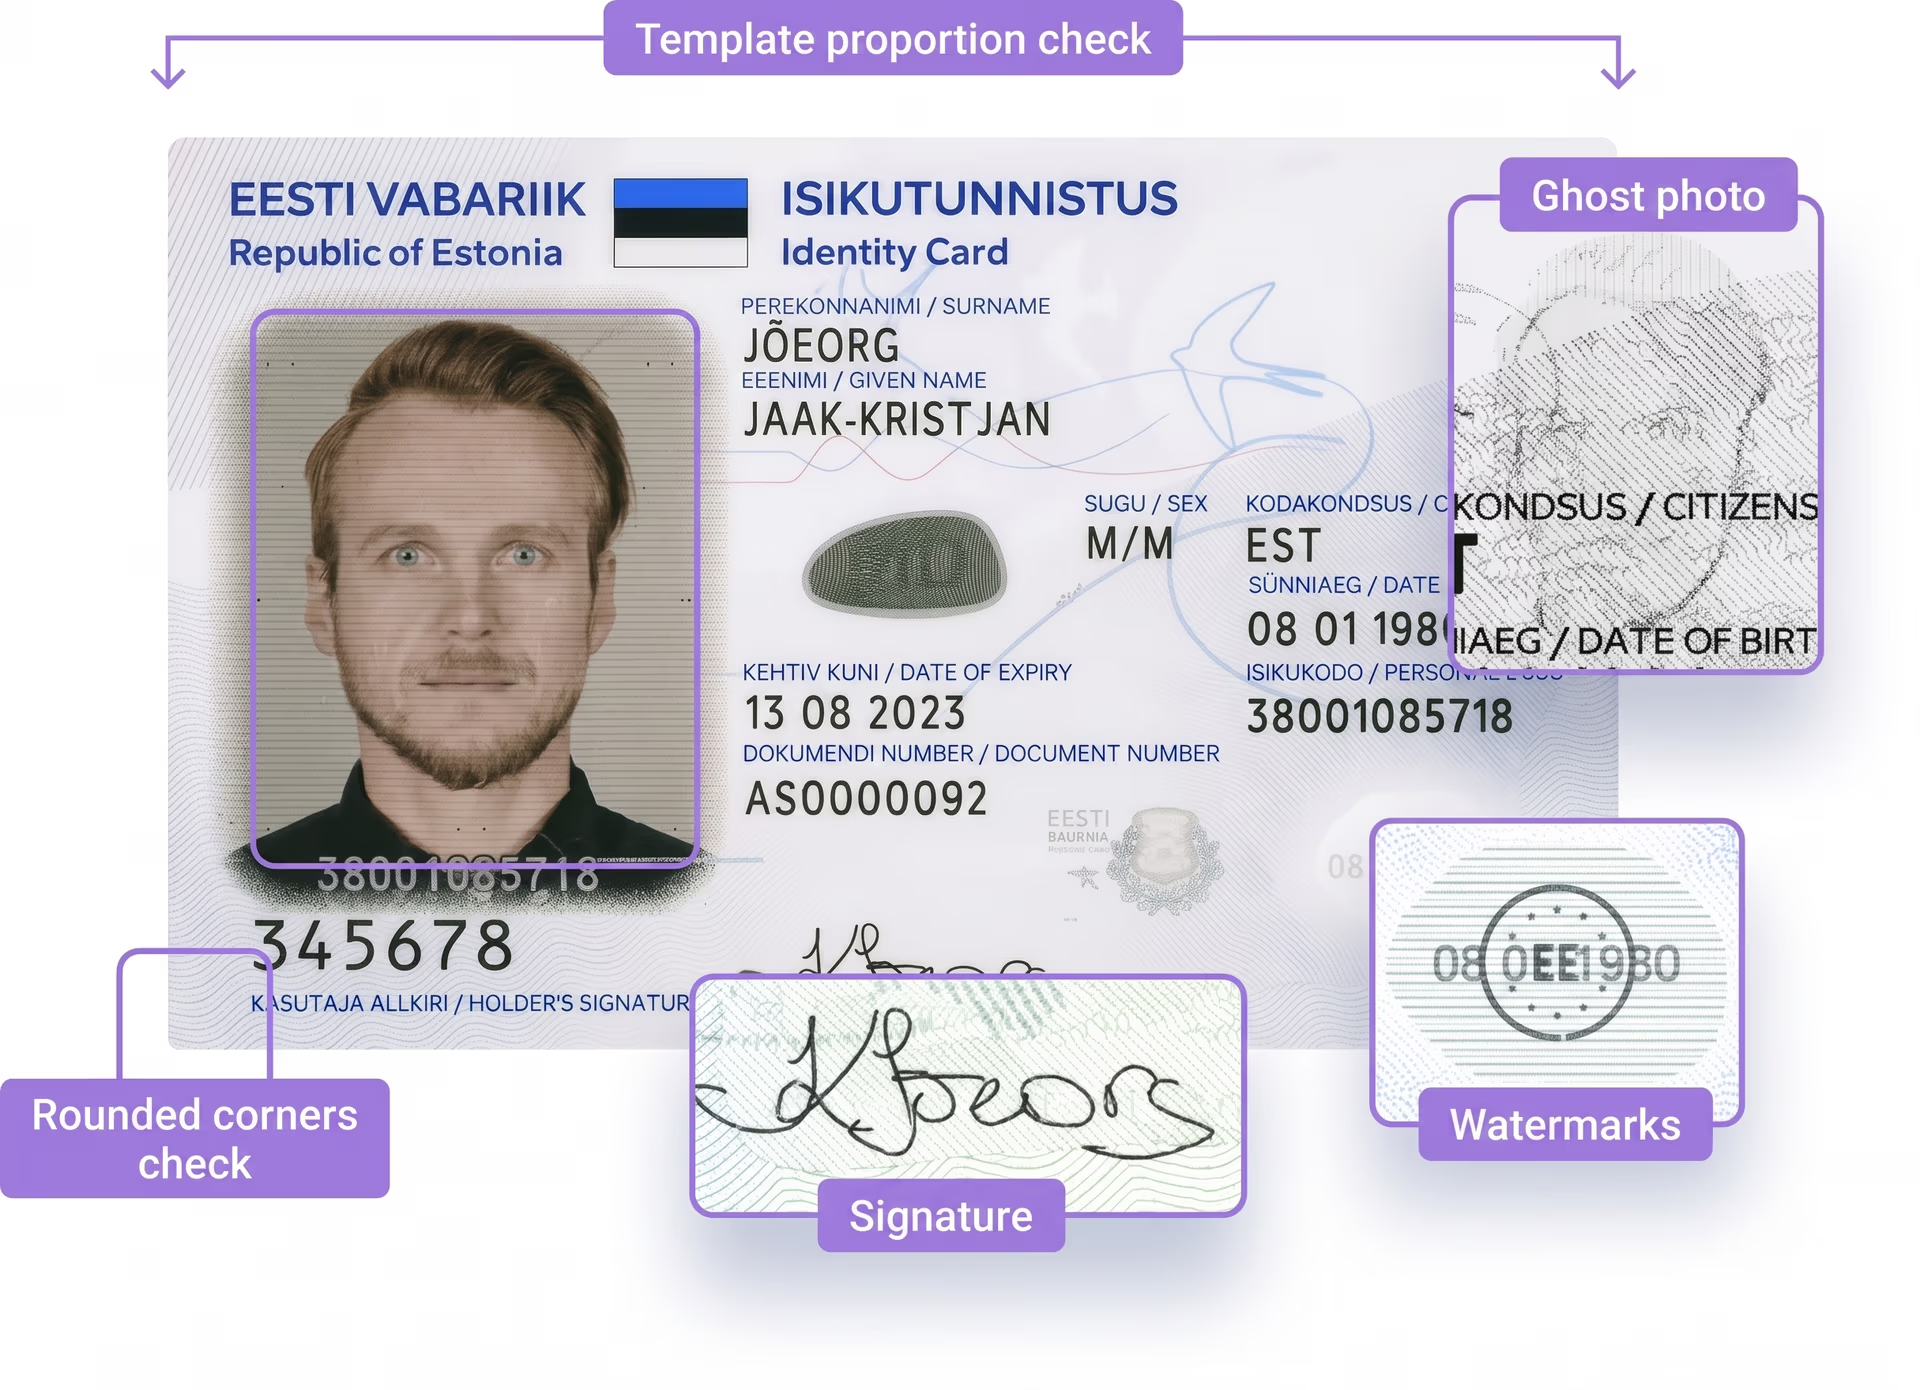
图 2。图像分割从身份证中分离并分析关键特征。
AI 驱动的图像分割如何用于文档认证#
AI 驱动的图像分割包含三个关键步骤,始于图像预处理,终于伪造检测。
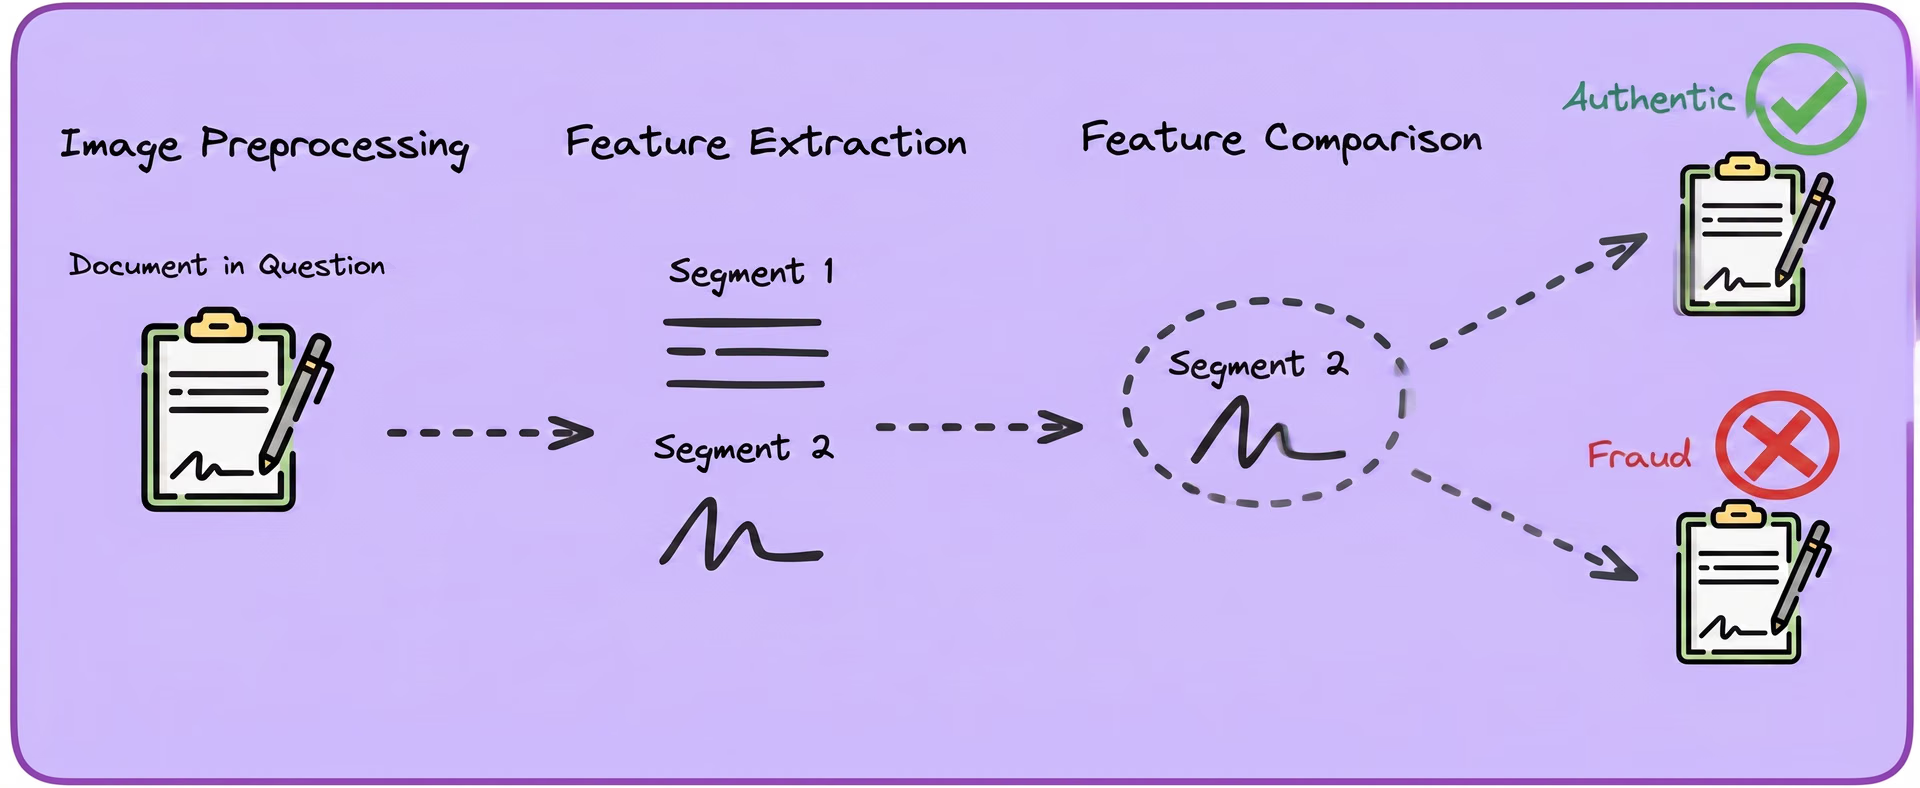
图 3. 展示 AI 驱动的文档认证流程的示意图。(图片由作者提供)
1. 图像预处理#
AI 文档认证的第一步是获取清晰的文档数字图像。可以通过扫描、拍照或直接接收数字副本来完成。图像质量非常重要,因为它是后续所有分析的基础。
实施图像分类流程来识别护照、身份证和财务记录等不同类型的文档,正在简化认证流程。例如,Regula等公司会检查 MRZ、条形码和 RFID 芯片等安全特征是否存在,从而自动识别所提交的文档类型。这样就能针对每种文档类型采用相应的验证方法,确保使用最合适的技术来验证其特定特征。因此,整个验证流程会更加顺畅、高效。
Ultralytics YOLOv8 等计算机视觉模型可以针对不同任务进行训练。例如,可以训练模型去除特定文档周围的背景图像,以便更好地识别文档的边界。模型还可以通过分析文本块或徽标等特征来检测并识别文档方向是否不正确(例如上下颠倒或横向放置),这些特征可以指示文档通常的正向位置。
2. 特征提取(分割)#
处理文档图像后,可以训练 YOLOv8 等 AI 工具,将文档划分为有意义的部分。例如,在文档版面检测中,YOLOv8 能够高效地将文档分割成标题、页脚和文本块等不同区域。
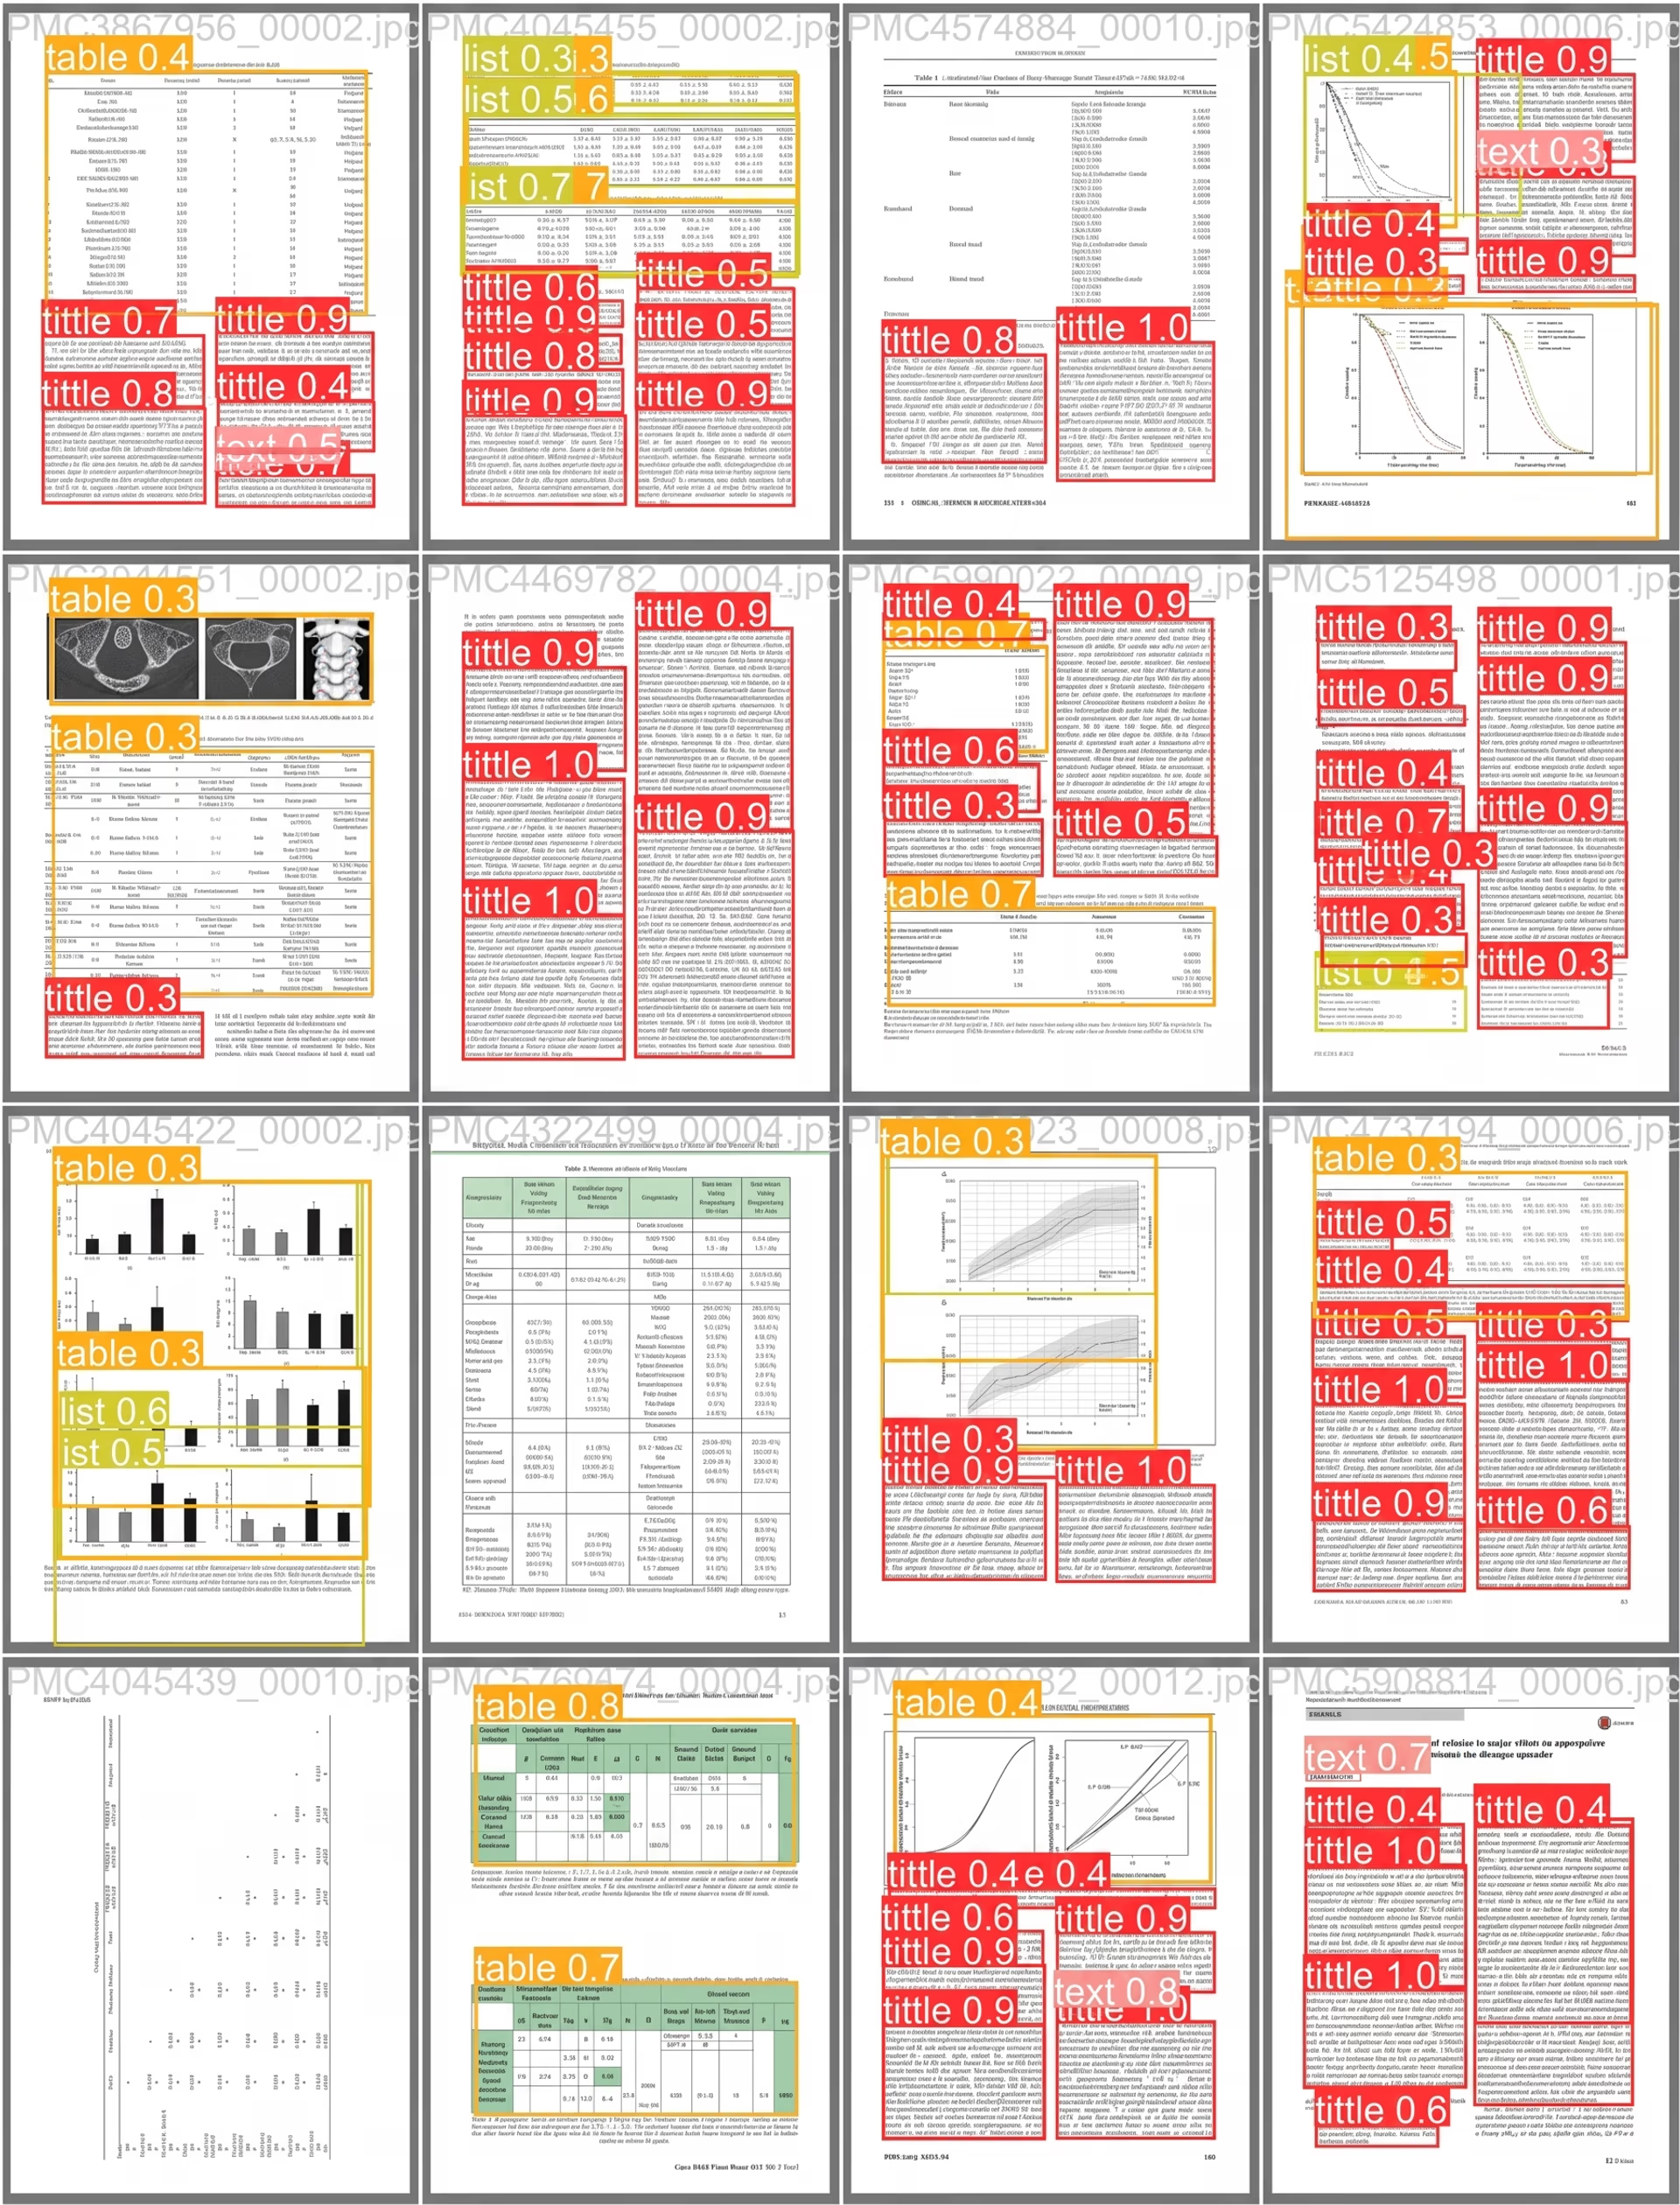
图 4。YOLOv8 模型将文档分割为不同区域。
在文档认证中,首先需要使用分割工具分离签名、安全印章和文本块等重要组成部分,以便进一步分析。这种分割有助于系统更准确地检测潜在篡改或不一致之处,从而简化文档验证流程。将文档拆分为不同元素后,AI 模型可以精确识别被篡改的区域,提高认证的速度和可靠性。
在特征提取阶段,可以训练 Ultralytics YOLOv8 识别签名、印章和文本等特定文档元素。它可以区分这些组成部分,并将其提取出来以供进一步处理。
例如,可以使用Ultralytics 签名数据集对 YOLOv8 进行训练,以检测并提取指定签名,确保签名认证准确无误。该数据集包含预先标注的手写签名图像,使模型能够识别签名模式,例如连笔书写的独特形状。模型可以学习的关键模式之一是:签名通常由人手写成,具有独特的笔势和不规则之处,因此有别于机器生成的文本。
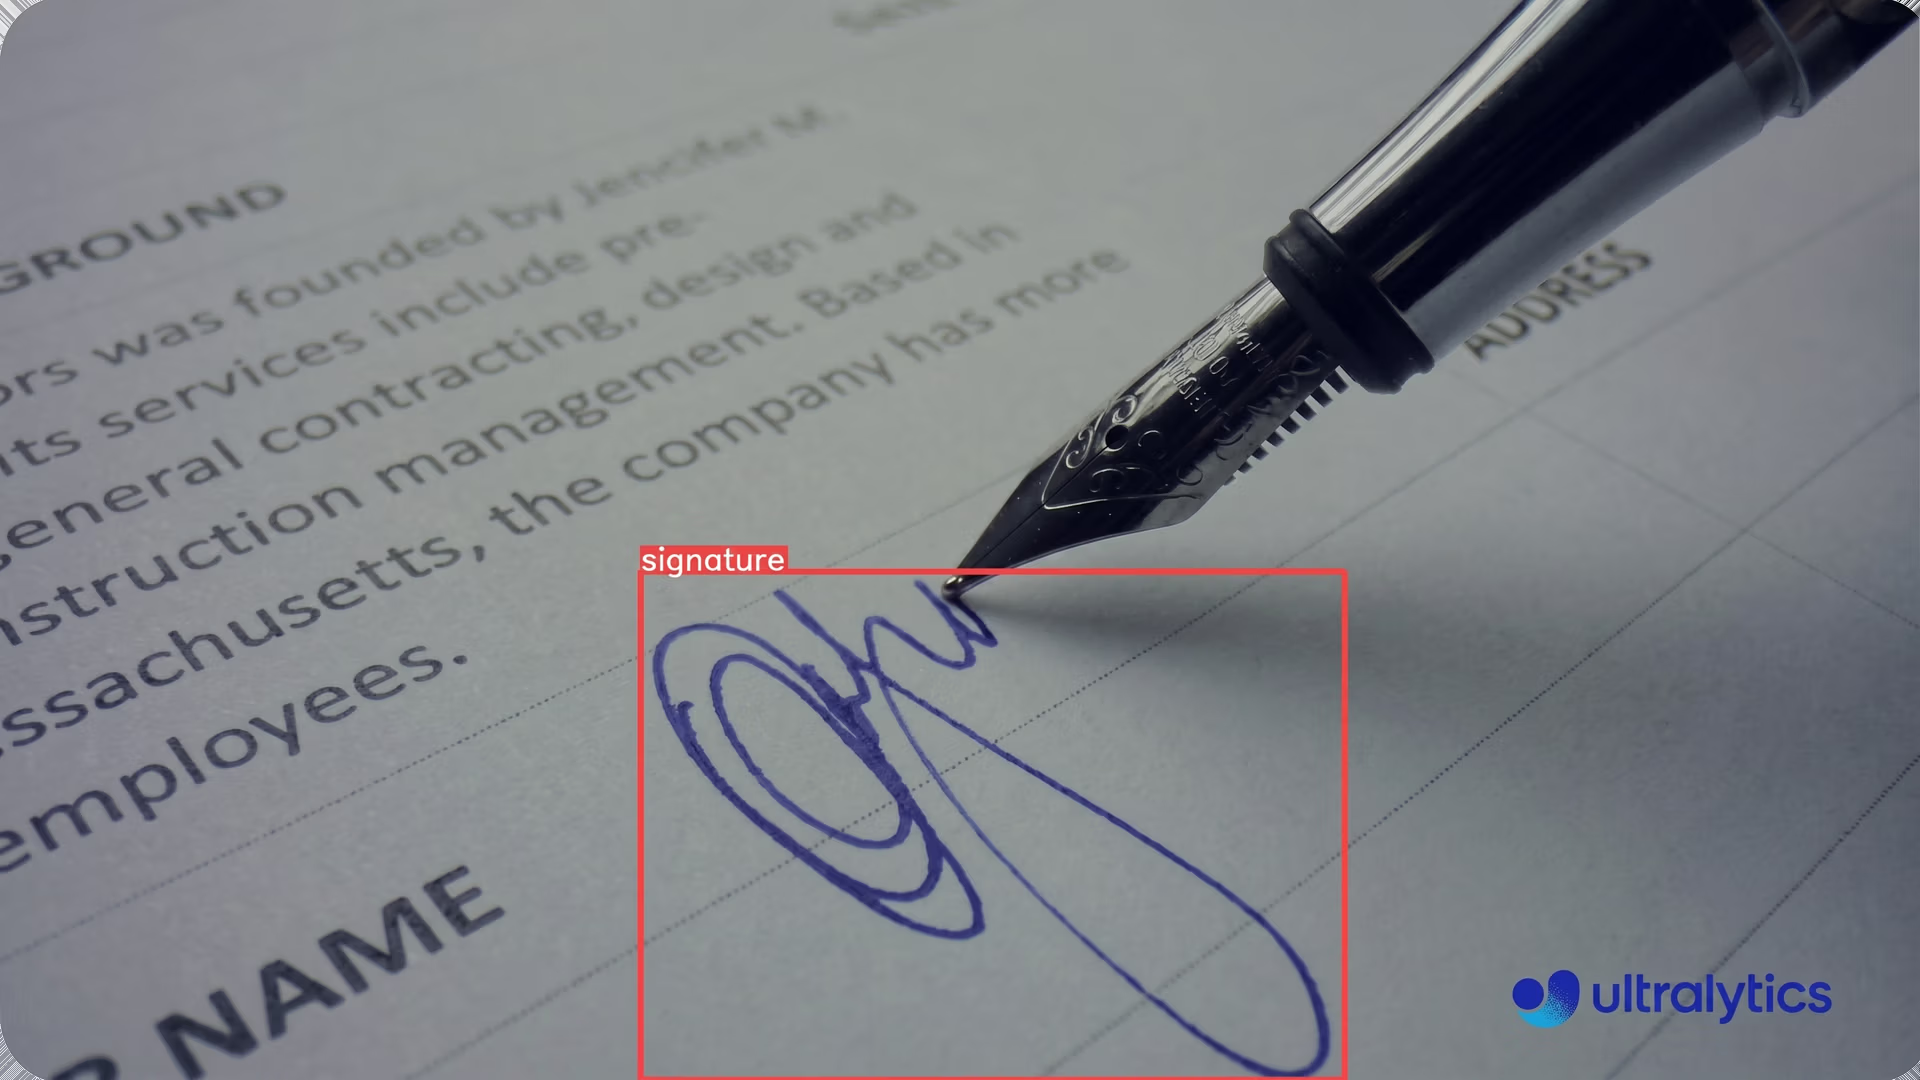
图 5. Ultralytics YOLOv8 模型检测文档中的签名区域,以实现精准认证。
印章、戳记、图像和水印等类似特征也可以用相同方式提取。通过使用针对每种特征类型的特定数据集对 Ultralytics YOLOv8 进行训练,模型可以提升检测性能,从而对文档组成部分进行细致、准确的分析。
3. 伪造检测(特征比较)#
这个流程的最后一步是伪造检测。在此阶段,AI 系统会将文档与参考数据进行比较,分析墨迹差异、签名不匹配或虚假个人数据等细微异常。
这类计算机视觉模型使用包含真实和伪造文档的标注数据集进行训练。例如,真实文档的墨迹模式、文本格式和图像位置都保持一致,而遭篡改的文档则会在颜色、强度、图像位置甚至墨迹流动方面呈现细微差异。
类似方法也用于比较水印或其他嵌入式安全特征的完整性和位置。这些特征的位置、大小或透明度出现偏差,都可能是伪造的有力迹象。即使是轻微错位或字体不匹配,也可能表明文档存在伪造,从而确保验证过程全面而准确。
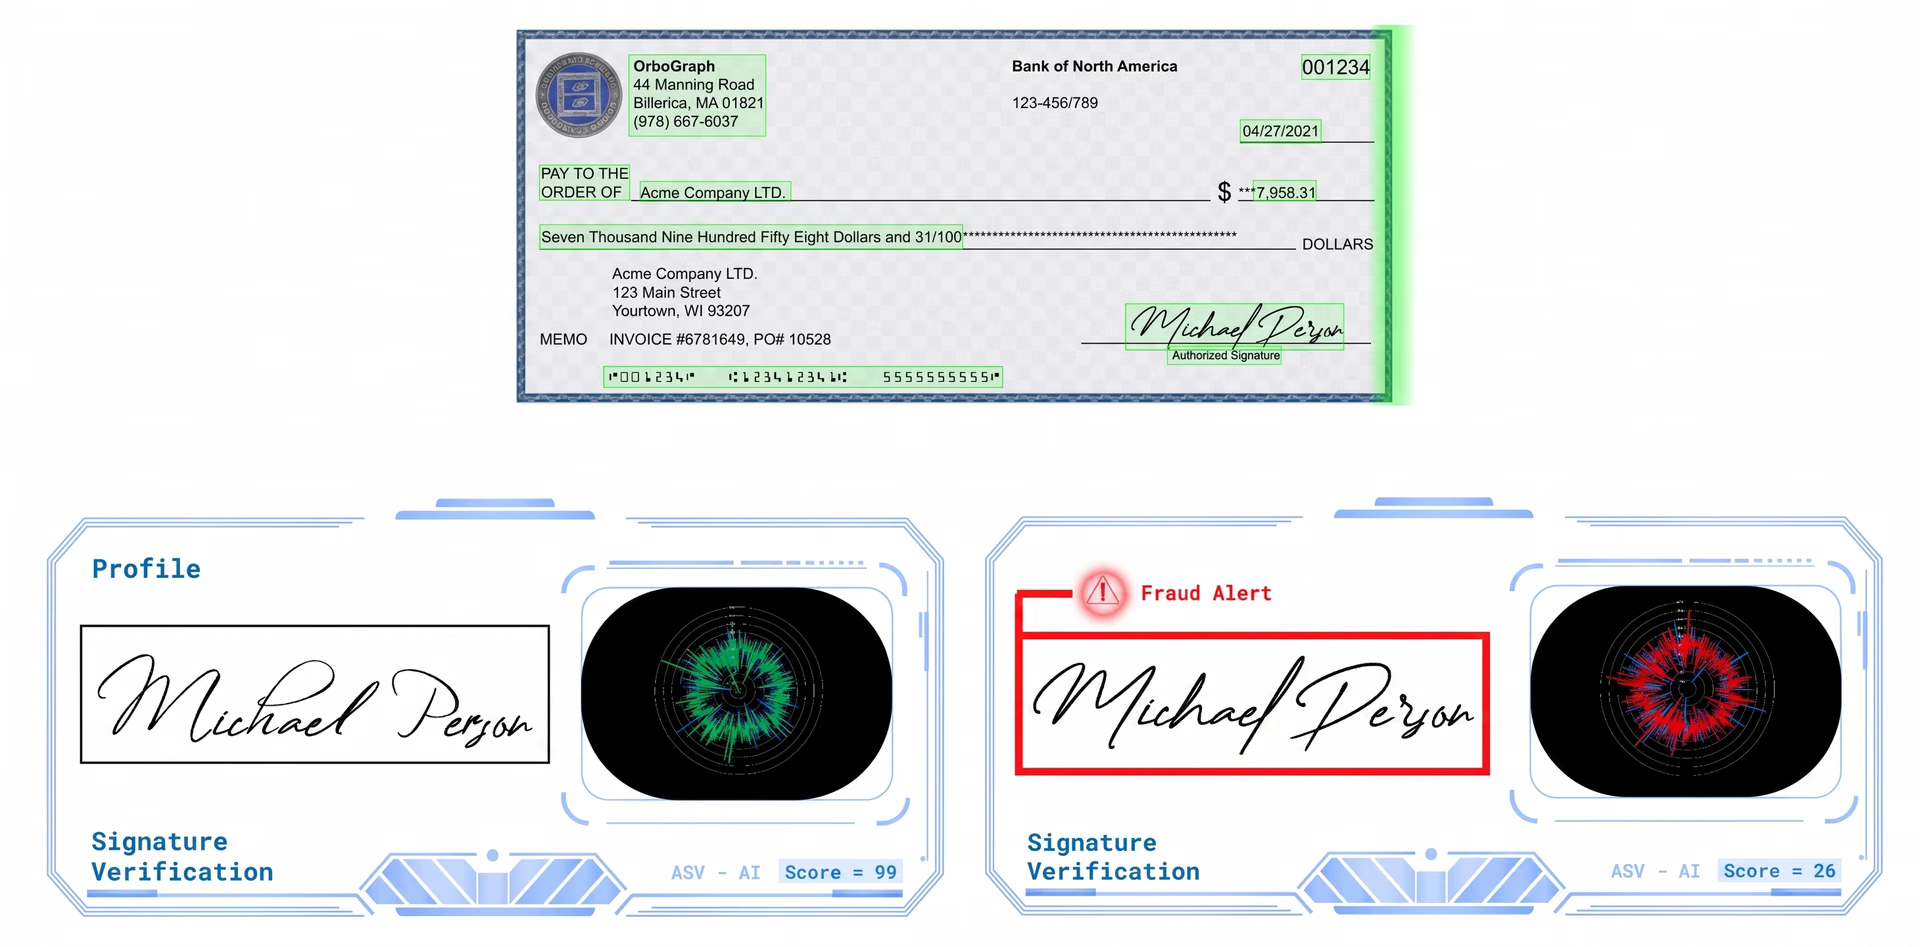
图 6。AI 签名欺诈检测。
随后,AI 会根据文档各部分为真的可能性,为其分配置信度分数。任何异常都可能触发进一步的人工审核,以确保文档完整性并验证检测结果。
AI 在多个行业文档认证中的应用#
AI 驱动的图像分割可以改变各行业认证和验证重要文档的方式。从银行业到政府服务,这项技术都能在提升安全性、防止欺诈以及简化多个领域的流程方面发挥作用。
下面来看看 AI 如何在不同行业中用于文档认证。
银行和金融服务#
在银行和金融服务领域,AI 驱动的图像分割用于认证支票、贷款协议和财务报表等各类文件。通过准确检测任何篡改或伪造迹象,AI 有助于防范欺诈,并确保重要金融交易的完整性。
Stripe 使用其 Stripe Identity 平台,通过 AI 驱动的工具比对身份证件和实时人脸图像,以验证客户身份。该系统增强了交易安全性,确保符合了解你的客户(KYC)法规,并降低了注册流程中的欺诈风险。
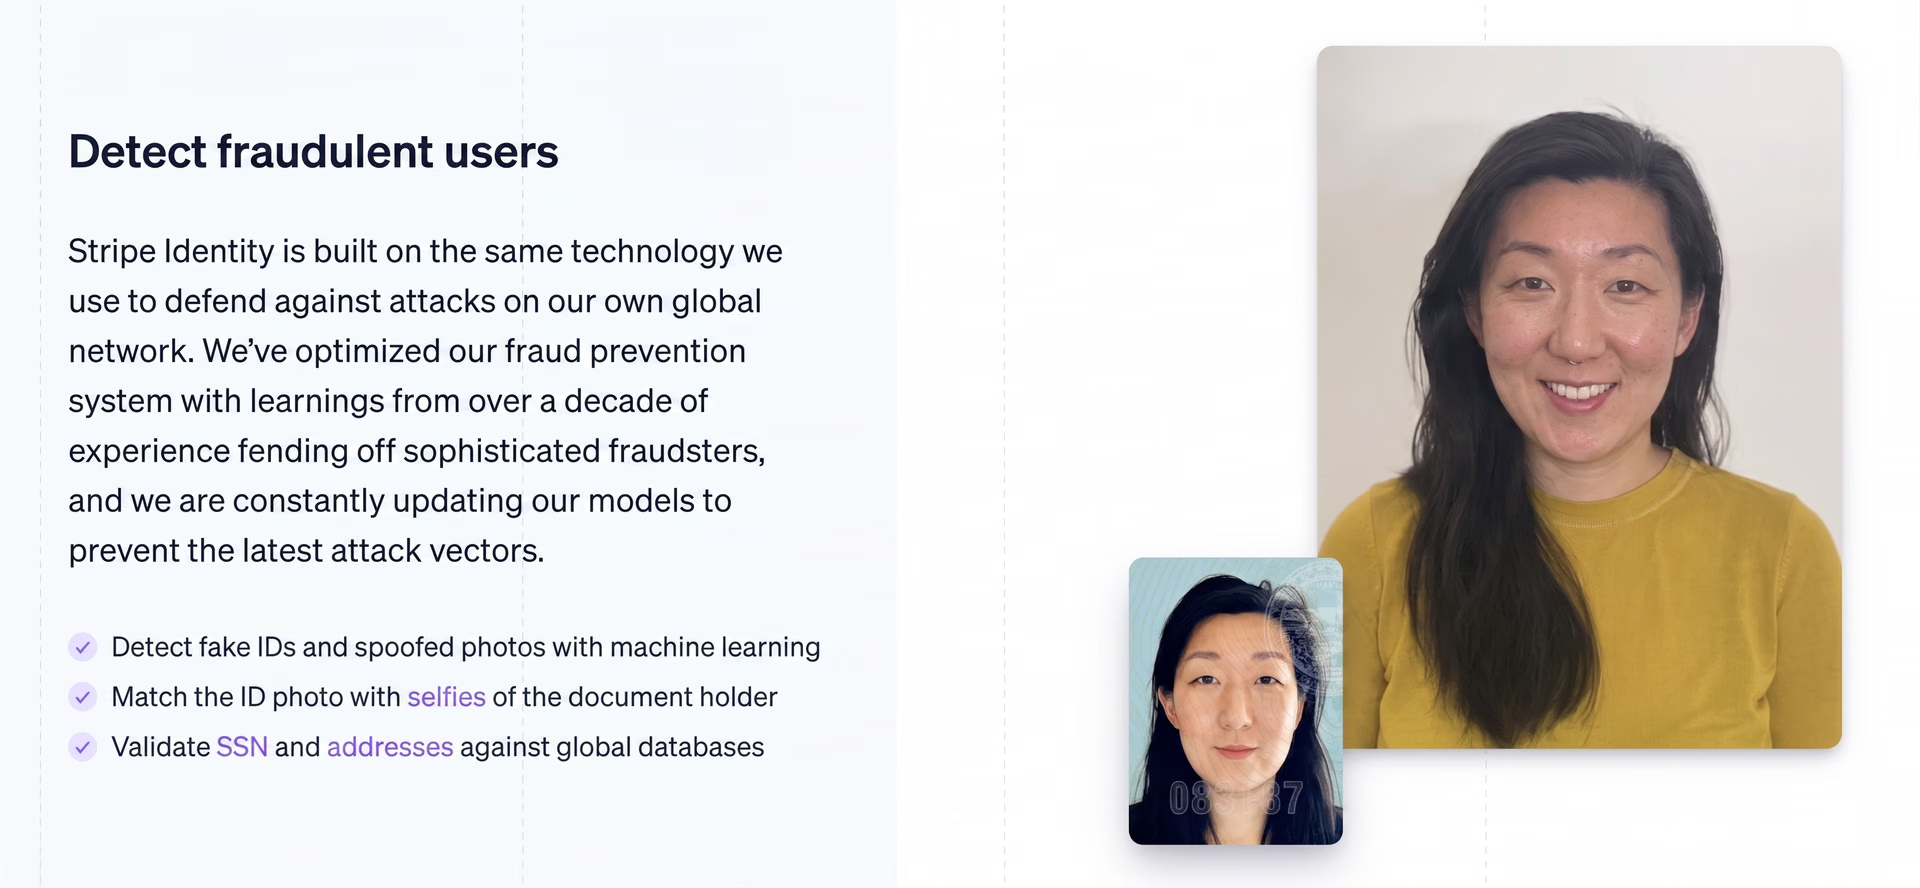
图 7。Stripe 的 AI 驱动系统通过将身份证件图像与实时人脸扫描结果进行比对来检测欺诈用户。
此外,计算机视觉模型还可用于检测重要文档是否遭到篡改、验证支票上的签名,以及检测贷款文件中的改动,从而大幅降低金融欺诈风险,并借助 AI 加快文档验证速度。
政府和法律文件#
AI 驱动的图像分割在政府领域发挥着重要作用,可以确保护照、国家身份证、签证和其他官方文件的真实性。计算机视觉模型有助于防止身份盗窃、未经授权的越境行为以及假冒文件的使用。
例如,美国海关与边境保护局(CBP)已在多个机场部署人脸识别技术,通过将旅客的面部与旅行证件进行比对来验证身份。这些模型能够检测伪造和篡改行为,例如识别原始文档版面中的不一致之处,包括字体被修改或文本未对齐等可能表明存在篡改的迹象。
iDenfy 等一些公司专门提供 AI 驱动的文档验证工具,用于检测各类官方文件中的不一致之处。这类工具通过分析内嵌的安全特征,验证护照、身份证和驾驶执照等文件。这样可以确保文件真实且未被篡改,提升企业和政府机构的注册及安全流程。
因此,快速、准确地认证文档可以提升国家安全,同时简化边境管控流程。
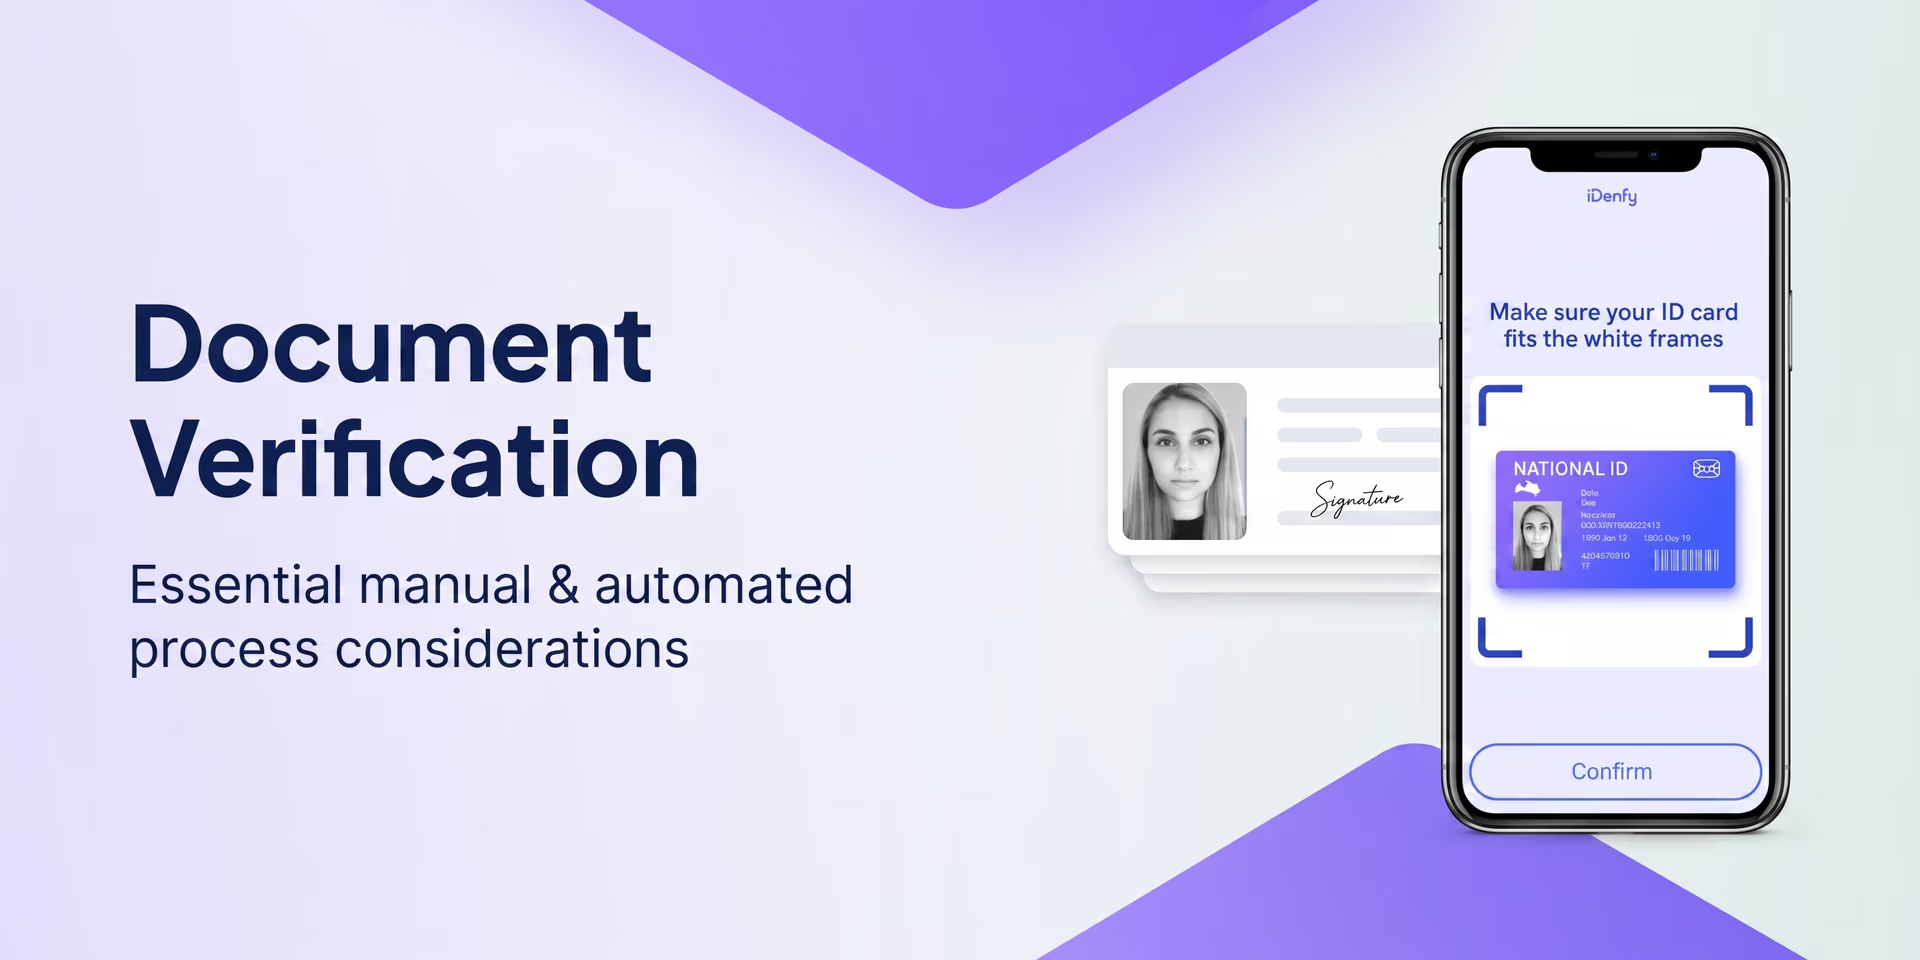
图 8. 国家身份证件验证示例。
AI 文档验证系统的优势#
将计算机视觉集成到文档认证中有许多优势,可以让流程更高效、更准确、更灵活。这些优势正帮助各行业组织增强安全性并简化文档验证流程。以下是 AI 在这一领域的一些主要优势。
多语言文档验证#
基于 AI 的系统可以通过训练来分析和认证多种语言的文档。这对国际组织或边境管控机构尤其有用,因为这些机构需要验证多种语言的文档。使用多语言数据集训练 AI 模型,可以确保系统高效处理来自不同地区的文档。
例如,在人工验证文档时,边境管控站的工作人员可能会遇到用自己不懂的语言书写的护照。由于不懂这种语言,工作人员可能会漏掉关键信息,或难以验证文档的真实性。相比之下,具备多语言能力的 AI 系统可以自动处理文档、提取关键信息并验证真伪,避免因语言障碍导致人为错误。
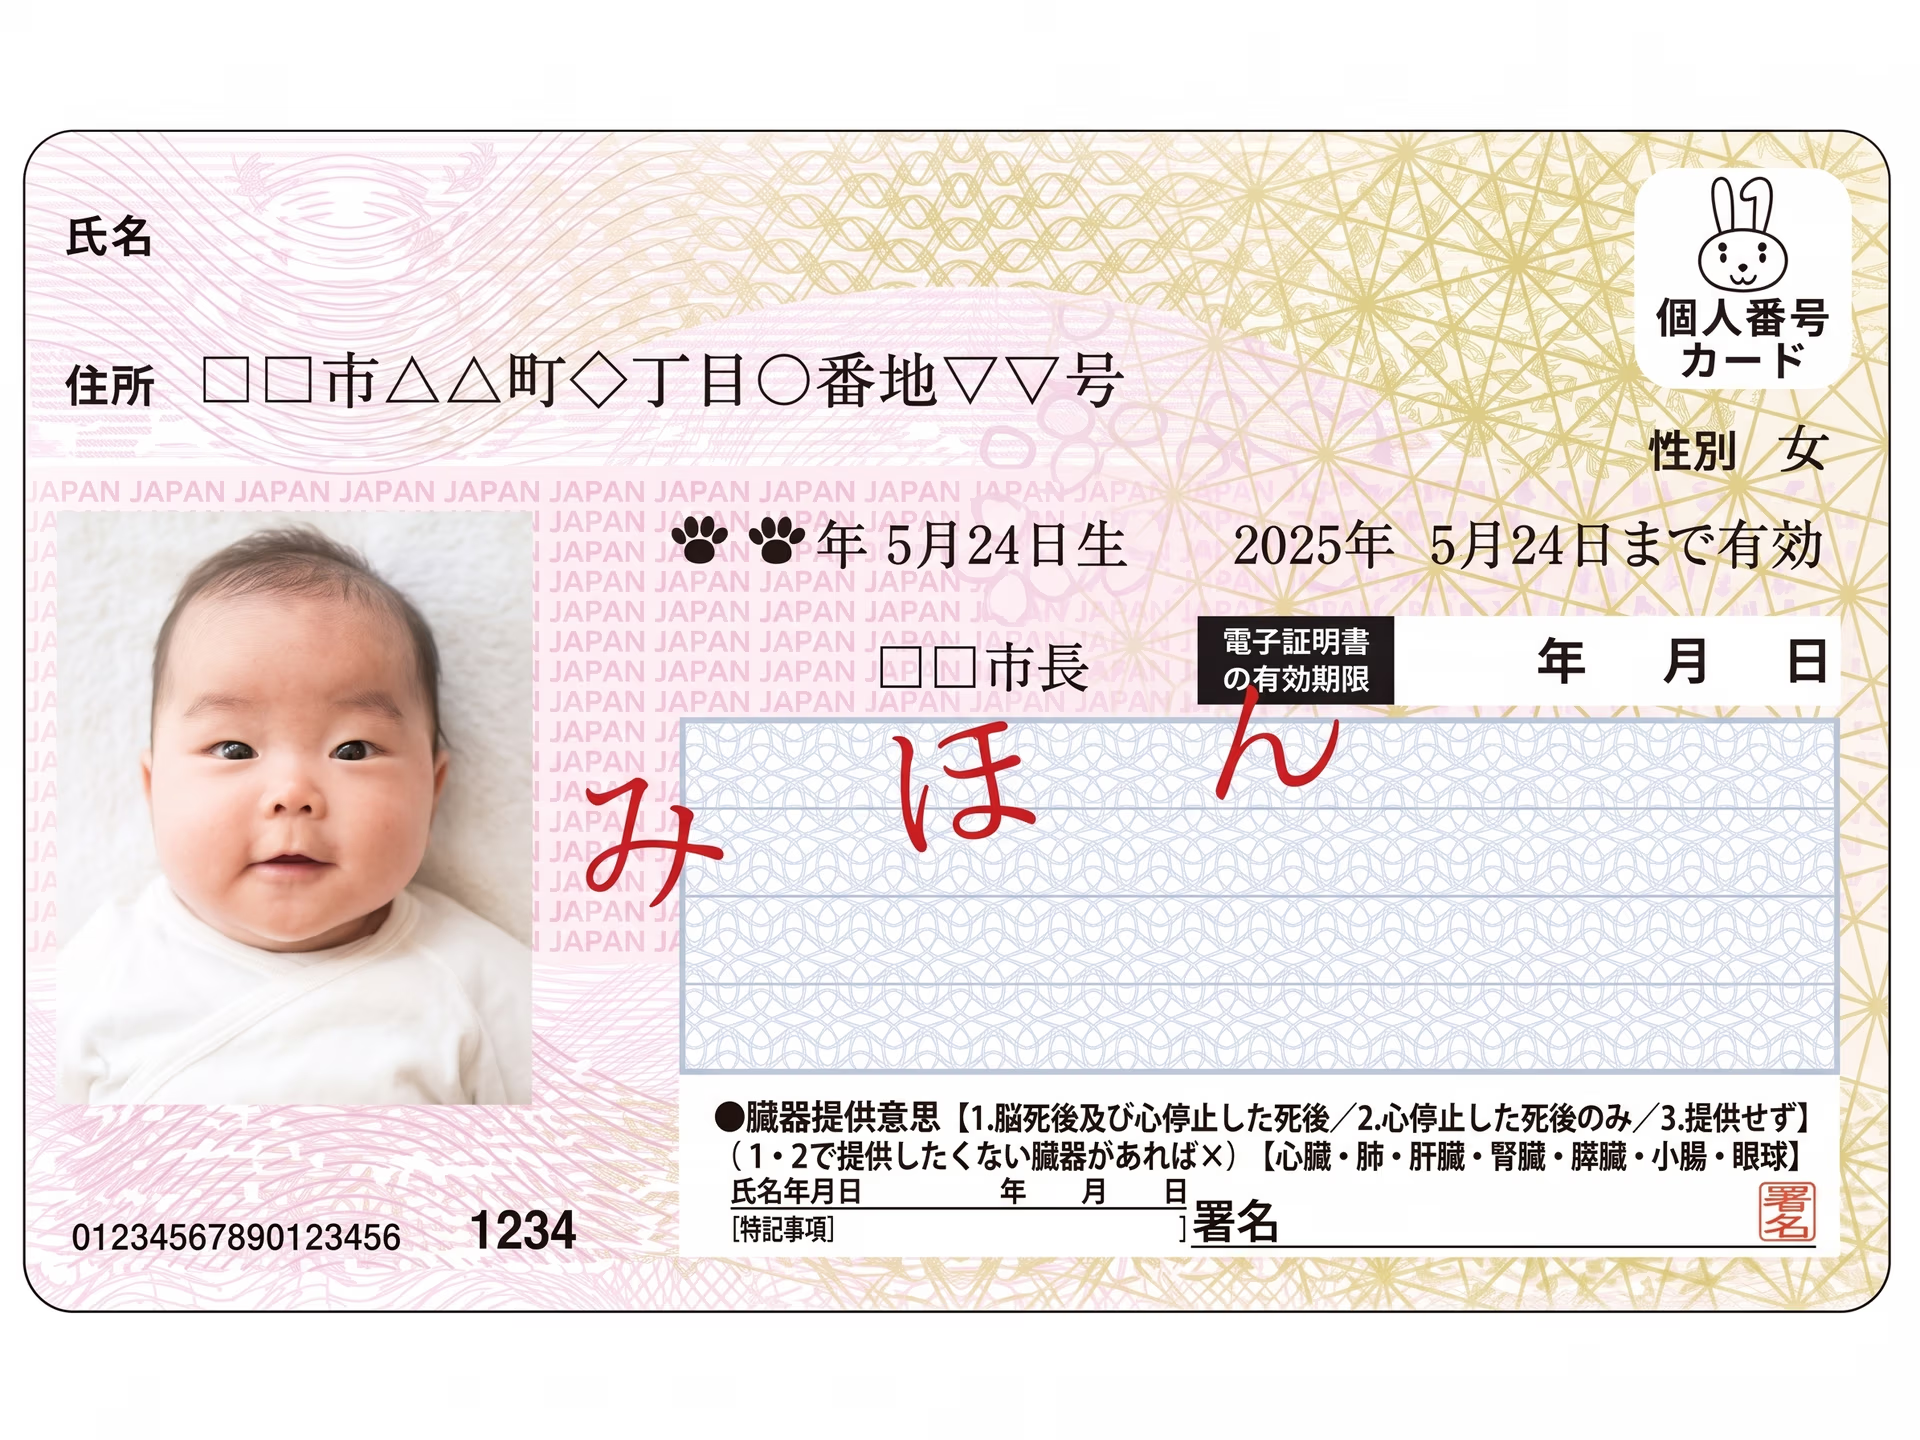
图 9。日本个人编号卡。
实时欺诈预警#
借助 AI,文档验证系统可以在检测到可疑元素时立即发出欺诈警报。实时检测使企业能够在欺诈行为升级前将其制止。例如,金融机构或边境管控机构可以立即标记被篡改的文件,阻止后续流程并降低风险。
可扩展性与适应性#
AI 文档验证系统具有很强的可扩展性,能够处理大量文档,因此适用于各类行业和大规模数据处理。AI 还可以适应不同类型的文档和不断演变的伪造技术,确保在出现新挑战时,认证流程仍然稳健有效。
AI 文档认证面临的挑战#
尽管 AI 驱动的图像分割在文档认证方面优势显著,但也带来了一些挑战和局限。要确保 AI 系统在这一领域的可靠性和有效性,就必须解决这些问题。以下是 AI 文档认证面临的一些主要挑战和局限。
大量数据需求#
部署基于 AI 的图像分析来认证文档时,一个重大挑战是需要大量且多样化的数据集。AI 模型需要大量高质量数据进行训练。在文档认证场景中,这意味着要收集各种格式和质量的真实文档与被篡改文档。
训练机器学习模型时,最大的挑战之一是获取足够且具有代表性的数据,以训练出能够准确泛化到不同文档类型并检测细微篡改的模型。
误报和漏报风险#
AI 系统虽然有效,但也无法完全避免错误。误报是指合法文档被错误标记为遭到篡改;漏报则是指被篡改的文档被错误判定为真实。
这些错误可能造成各种后果,例如处理延迟、无理拒绝或安全漏洞。尽量减少这类错误是一项关键挑战,尤其是在处理复杂情况或高超的伪造品时。
伦理与隐私考量#
将 AI 用于文档认证会引发重要的伦理和隐私问题。这些系统通常会处理敏感个人信息,因此数据处理、存储和保护方式都值得关注。
确保遵守GDPR或HIPAA等数据保护法律,对于避免法律和伦理问题至关重要。此外,AI 模型可能存在偏见——由于训练数据的局限,某些文档类型或格式可能受到不公平对待——因此在模型开发过程中也需要谨慎考量。
要点#
AI 驱动的图像分割正在改变文档认证方式,让验证流程更准确、更快速、更可靠。银行、政府和企业等行业正在采用这项技术来打击欺诈并确保文档真实性。
尽管优势显著,但仍存在一些挑战,例如需要大量数据、可能出现错误、伦理考量和技术难题。必须解决这些挑战,才能尽可能提高系统的有效性。随着 AI 不断发展,文档认证预计也将持续演进,提供更先进的实时解决方案,从而提升安全性并简化流程。
在 Ultralytics,我们致力于推动 AI 技术发展。访问我们的 GitHub 代码库,了解我们的最新成果。加入我们的社区,了解我们如何将 AI 应用于文档处理、自动驾驶汽车和制造业等领域。
作者
软件工程师与技术撰稿人 · 自由职业
评论
提出问题、分享你的结果,或帮助其他人。









