计算机视觉驱动视觉 AI 智能体的决策方式
了解 AI 智能体如何利用计算机视觉革新各行各业,探索其在安防、自动驾驶汽车等领域的应用。
从制造业到零售业,每个行业都有自身的流程挑战,而寻找创新方法解决这些问题一直是企业成功运营的关键。近期,AI 智能体已成为许多领域的热门解决方案。这些系统不只是分析数据,还能采取行动。
例如,制造业中的 AI 智能体可以实时检测缺陷,并自动启动质量控制措施,确保生产顺利进行。同样,在物流和零售领域,AI 智能体可以利用智能监控系统监视多个地点,并立即提醒团队注意异常活动。
随着这一趋势不断发展,AI 智能体正在积极改变全球各行各业。全球 AI 智能体市场在 2024 年达到 51 亿美元,预计到 2030 年将增长至 471 亿美元。
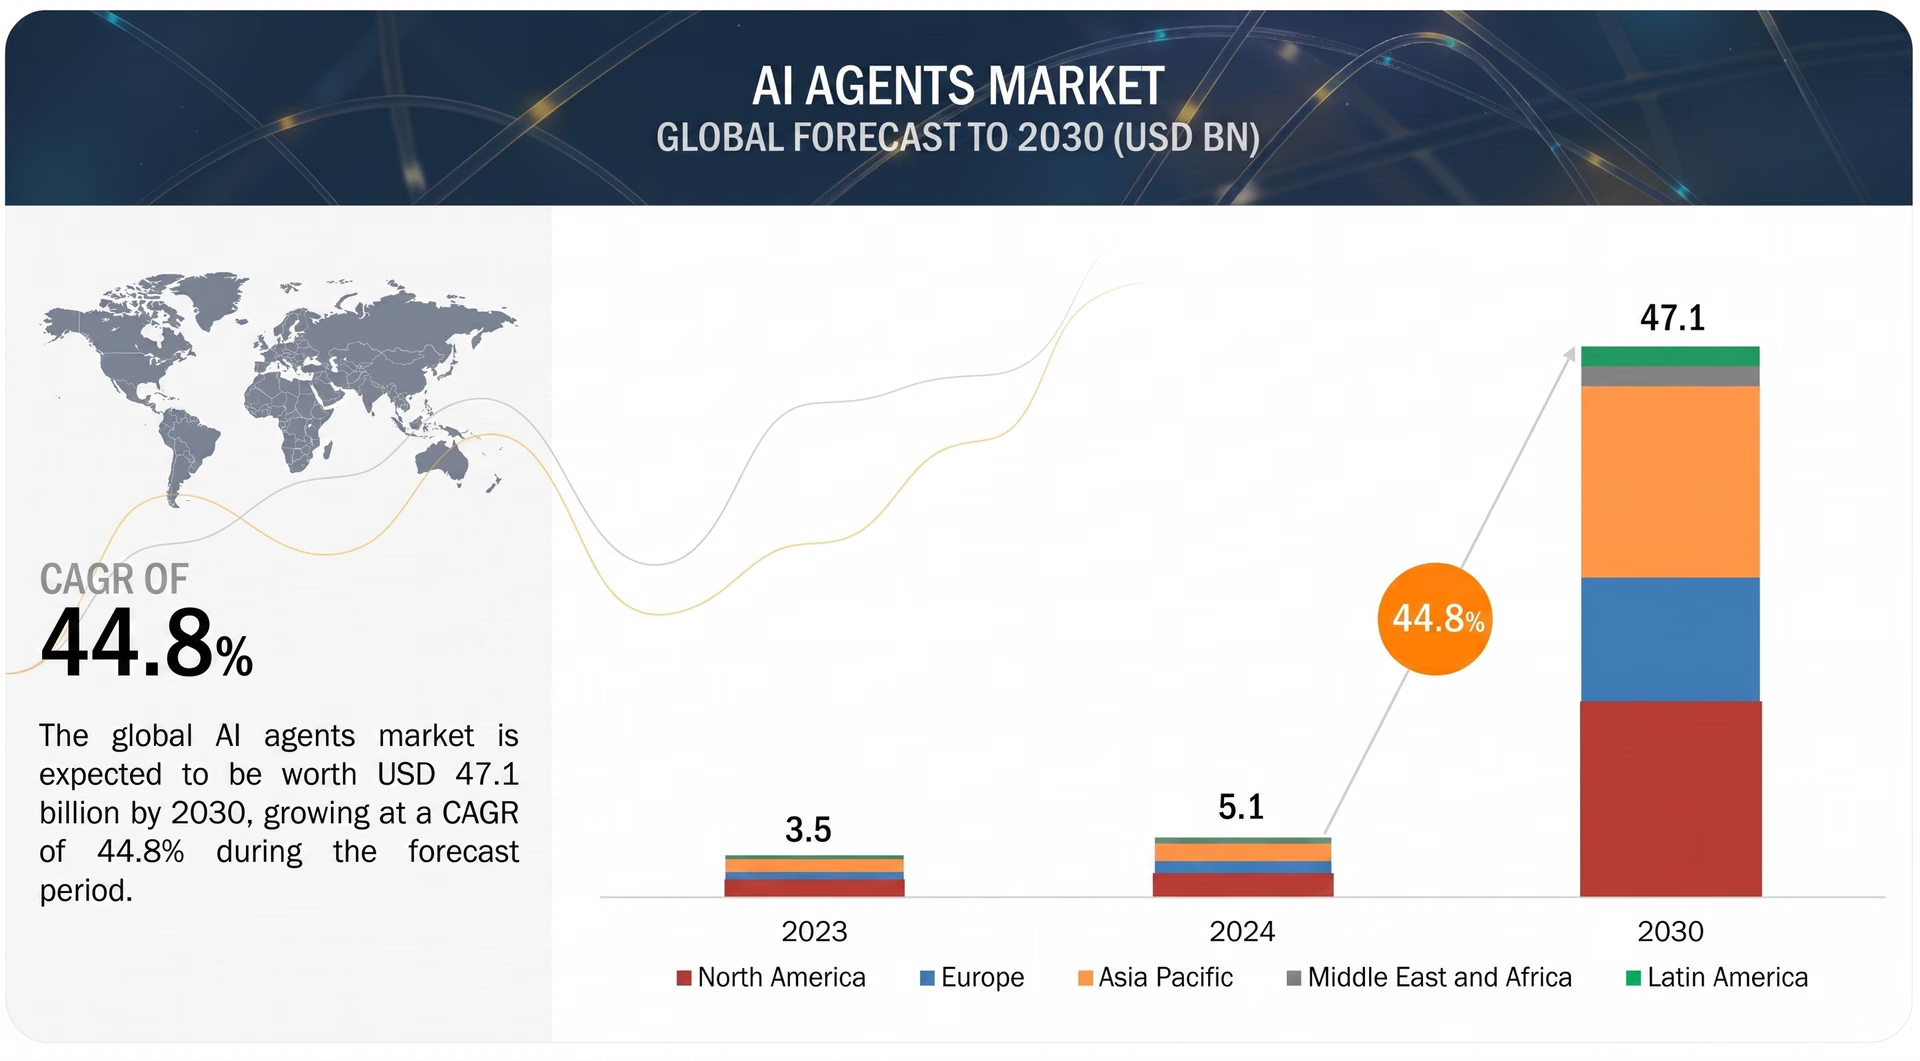
图 1。全球 AI 智能体市场规模一览。
推动这些进步的关键技术之一是计算机视觉。通过让机器能够处理和理解视觉数据,视觉 AI 使 AI 智能体能够以极高的准确率执行实时目标检测、实例分割和目标跟踪等计算机视觉任务。它弥合了机器所见与决策方式之间的差距,因此成为许多 AI 驱动解决方案的重要组成部分。
本文将探讨 AI 智能体及其与计算机视觉的关系。我们还会讨论 AI 智能体的不同类型,以及它们如何用于基于视觉的应用。现在开始吧!
什么是 AI 智能体?#
在深入了解基于视觉的 AI 智能体之前,我们先花点时间了解一下 AI 智能体的基本概念,看看这类系统究竟有多灵活。
AI 智能体是一种智能系统,无需人工协助就能理解并响应任务或问题。许多 AI 智能体会使用机器学习和自然语言处理 (NLP) 来处理各种任务,从回答简单问题到管理复杂流程。
有些 AI 智能体甚至能够随着时间推移不断学习和改进,而传统 AI 系统则需要人工输入来进行每次更新。这就是 AI 智能体迅速成为 AI 领域重要组成部分的原因。它们可以自动执行任务、做出决策并与周围环境交互,而无需持续监督。它们尤其适合管理重复且耗时的任务。
例如,你可以在客户服务和酒店业等领域看到 AI 智能体。在客户服务中,AI 智能体可用于处理退款并提供个性化产品推荐。在酒店业,它们则能帮助酒店员工管理客人请求、简化客房服务流程,并向客人推荐附近的景点。这些例子展示了 AI 智能体如何让日常流程变得更快捷、更高效。
了解视觉 AI 智能体的工作原理#
接下来,我们快速了解一下 AI 智能体的工作原理。每个 AI 智能体都各不相同,针对特定任务而设计,但它们都遵循相同的三个主要步骤:感知、决策和行动。
首先,在感知阶段,AI 智能体从不同来源收集信息,以了解正在发生什么。接下来是决策阶段。它们根据收集到的信息,使用算法分析情况并决定最佳行动方案。最后是行动阶段。做出决定后,它们就会采取行动——无论是回答问题、完成任务,还是标记需要人工处理的问题。
这听起来可能很简单,但根据 AI 智能体的类型,要让这些步骤顺利运行,幕后往往需要处理许多工作。从分析复杂数据到使用先进的机器学习模型,每个 AI 智能体都以自己的方式构建,用于处理特定任务。
例如,许多 AI 智能体专注于通过 NLP 处理语言,而另一些称为视觉 AI 智能体的智能体则会集成计算机视觉来处理视觉数据。借助 Ultralytics YOLO11 等先进的计算机视觉模型,视觉 AI 智能体能够更精准地分析图像。
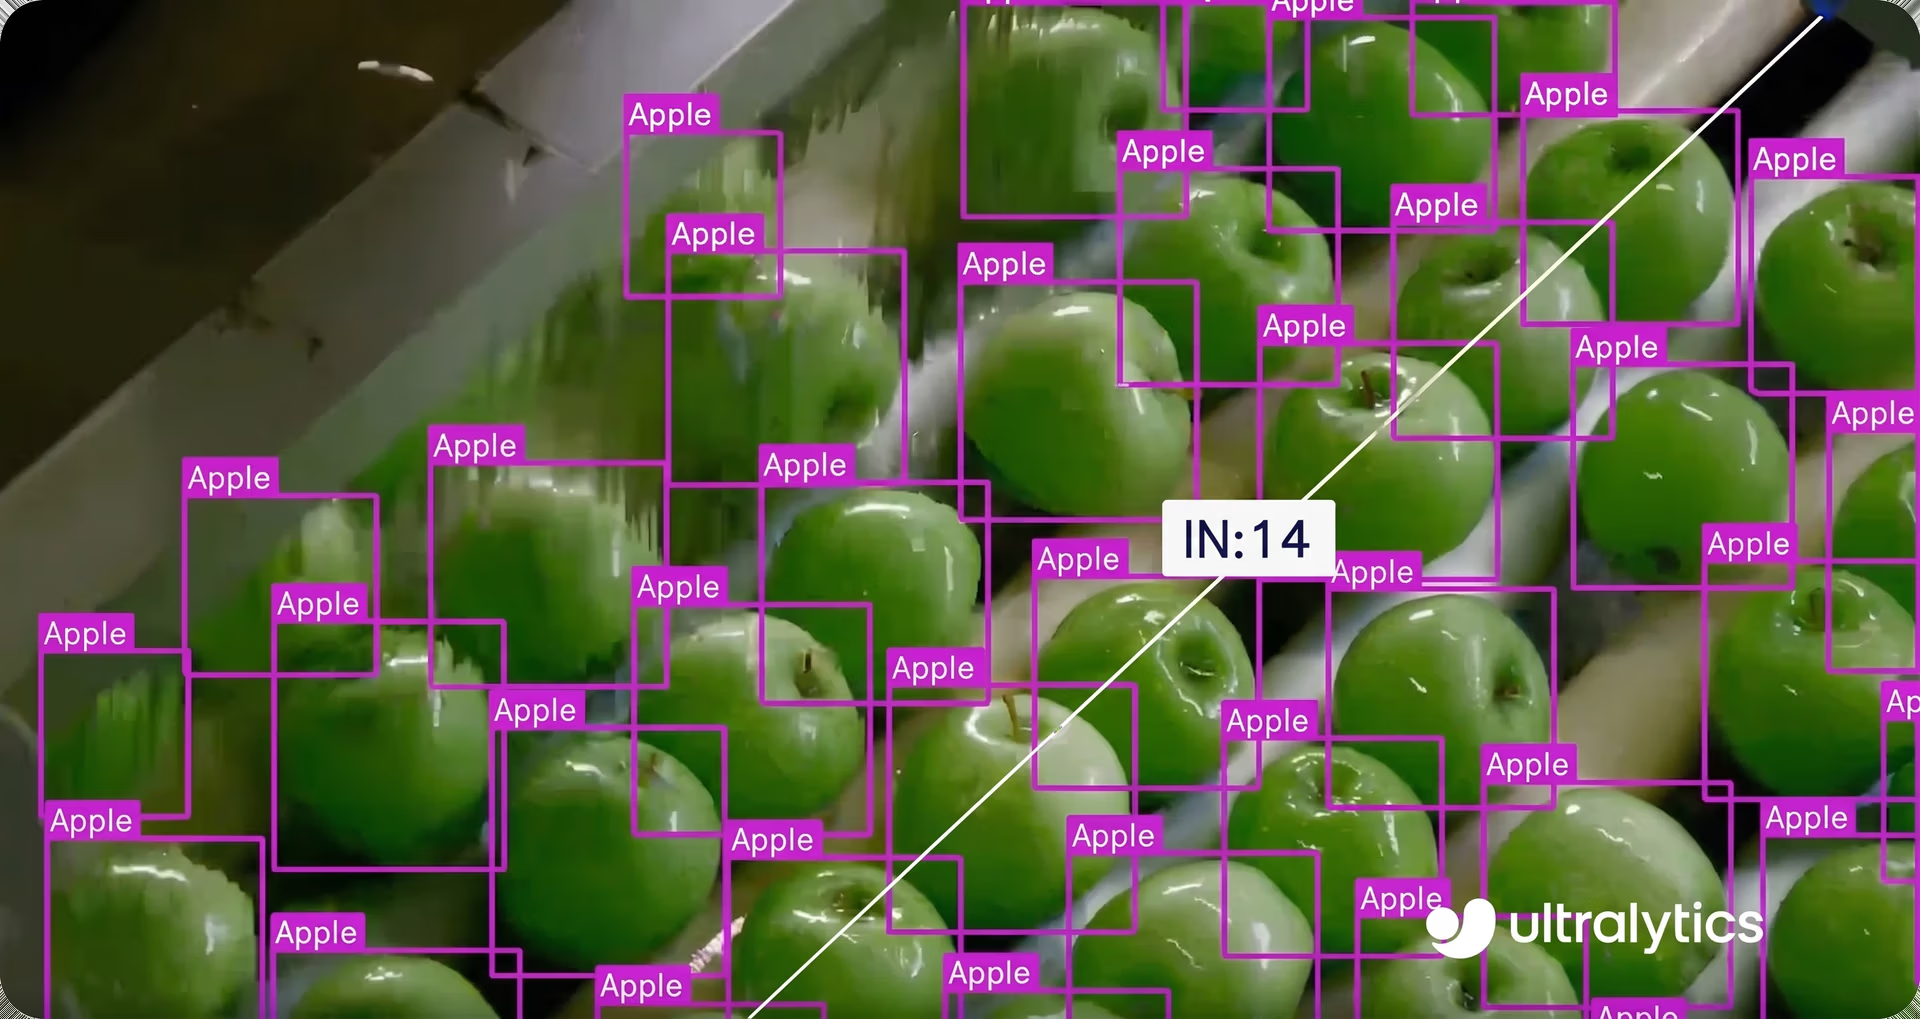
图 2。 使用 YOLO11 对图像中的苹果计数示例。
自动驾驶汽车中的视觉 AI 智能体#
我们以自动驾驶汽车为例,看看视觉 AI 智能体如何通过上述三个主要步骤开展工作:
- 感知: 自动驾驶汽车中的视觉 AI 智能体会收集安装在车辆上的摄像头和传感器所获取的视觉数据。这些数据包括周围环境的图像和视频,例如其他车辆、行人、交通信号灯和道路标志。
- 决策: AI 智能体使用 Ultralytics YOLO11 等模型处理这些视觉数据。它会识别汽车和行人等物体,检测障碍物或突然变道的情况,并识别交通流量和信号灯状态等模式。这有助于汽车实时了解路况。
- 行动: AI 智能体根据分析结果采取行动,例如转向以避开障碍物、调整速度或在红灯前停车。它会迅速做出这些决策,以确保驾驶安全、高效。
Waymo 的自动驾驶汽车就是这项技术的典型例子。它们使用视觉 AI 智能体了解周围环境、实时做出决策,并在没有人工输入的情况下安全、高效地在道路上行驶。
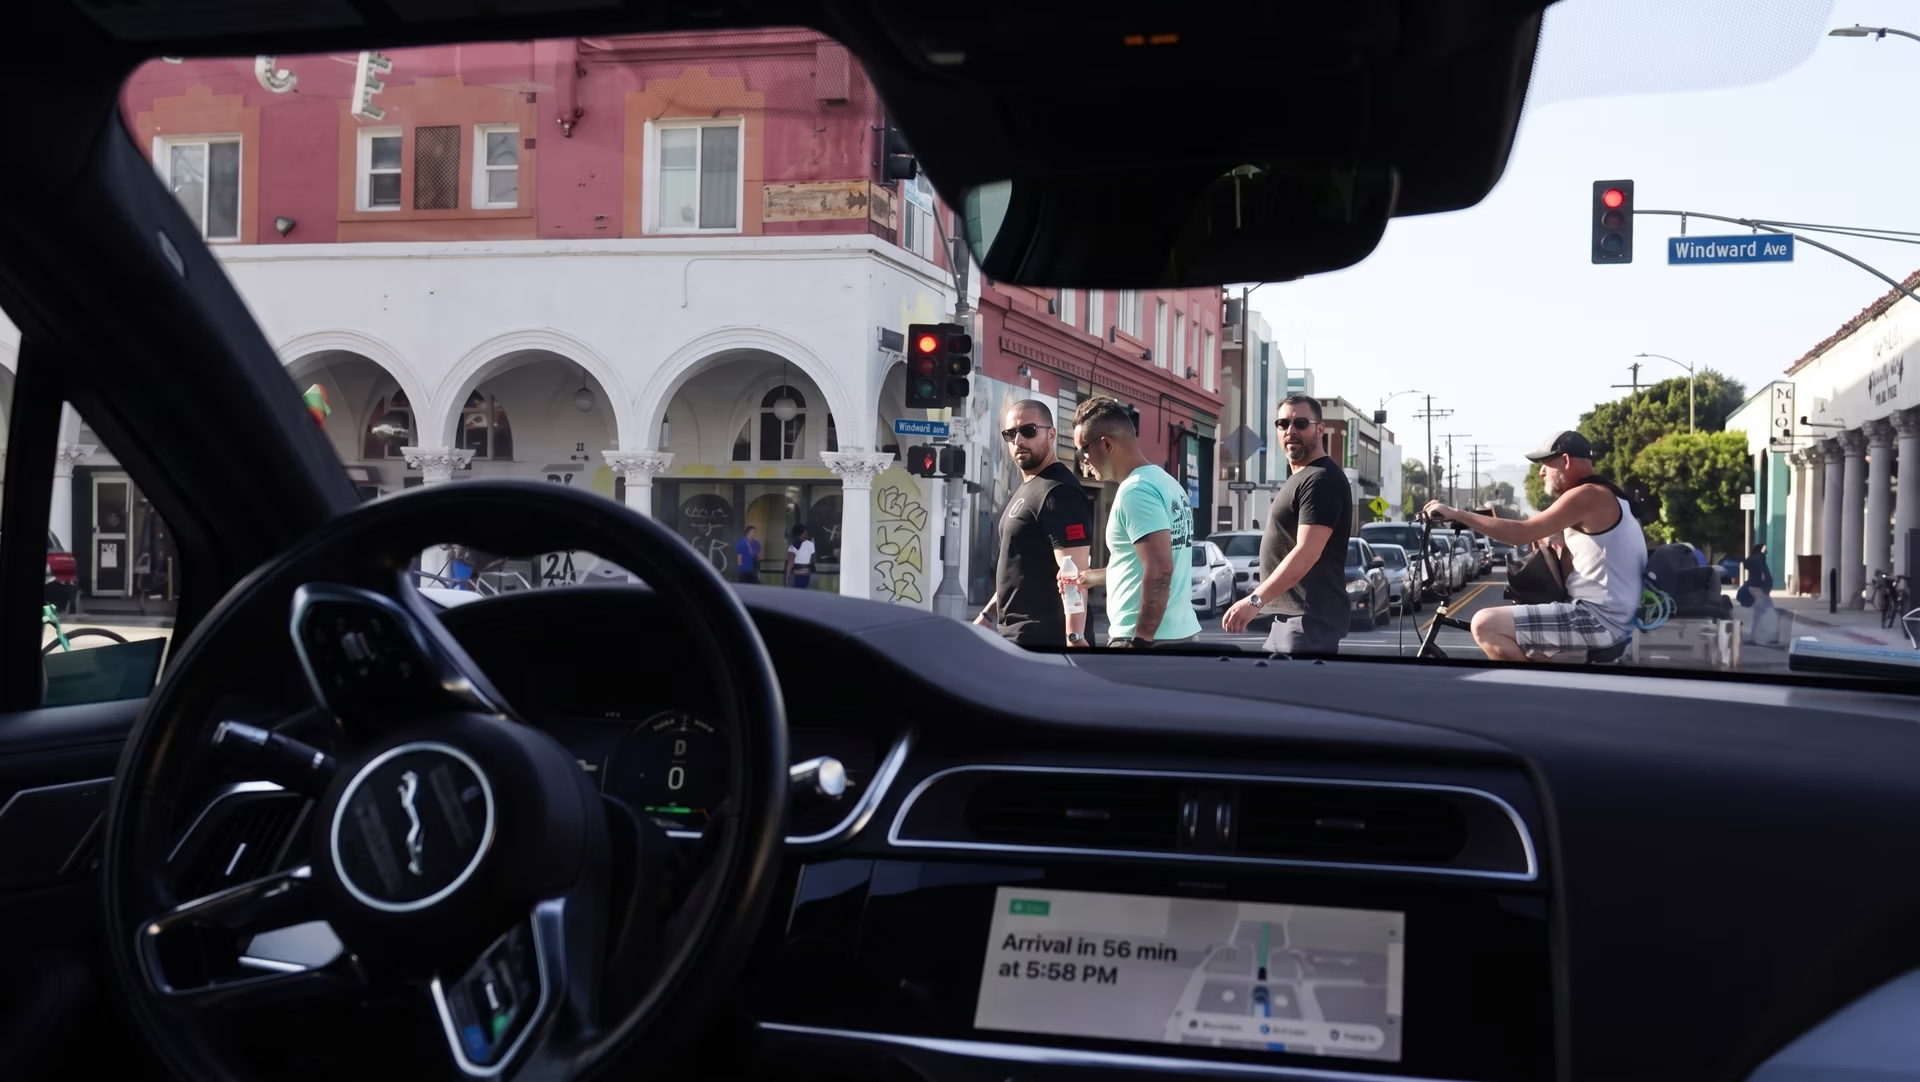
图 3。 Waymo 的 AI 智能体驱动自动驾驶出租车。
视觉 AI 智能体的类型#
了解 AI 智能体的工作方式以及它们如何使用计算机视觉后,我们来看看不同类型的 AI 智能体。每种类型都针对特定任务而设计,任务范围从简单操作到更复杂的决策和学习。
简单反射型智能体#
简单反射型智能体是最基础的 AI 智能体类型。它们会针对特定输入执行预定义的操作,只根据当前情况做出响应,不考虑历史信息或未来结果。这类智能体通常使用简单的“如果-那么”规则来指导行为。
在图像分析中,简单反射型智能体可以被编程为检测特定颜色(例如红色),并立即触发某项操作(例如突出显示或统计红色物体)。虽然这类智能体能够处理简单任务,但在更复杂的环境中就显得力不从心,因为它们不会从以往经验中学习或调整。
基于模型的反射型智能体#
基于模型的反射型智能体比简单反射型智能体更先进,因为它们会使用对环境的内部模型来更好地理解情况。这个模型让它们能够处理缺失或不完整的信息,并做出更明智的决策。
以 AI 安防摄像头系统为例。集成到这类系统中的视觉 AI 智能体可以使用计算机视觉实时分析正在发生的情况。它们可以将人员的动作和行为与正常行为模型进行比较,从而更准确地发现入店行窃等异常活动,并标记潜在的安全威胁。
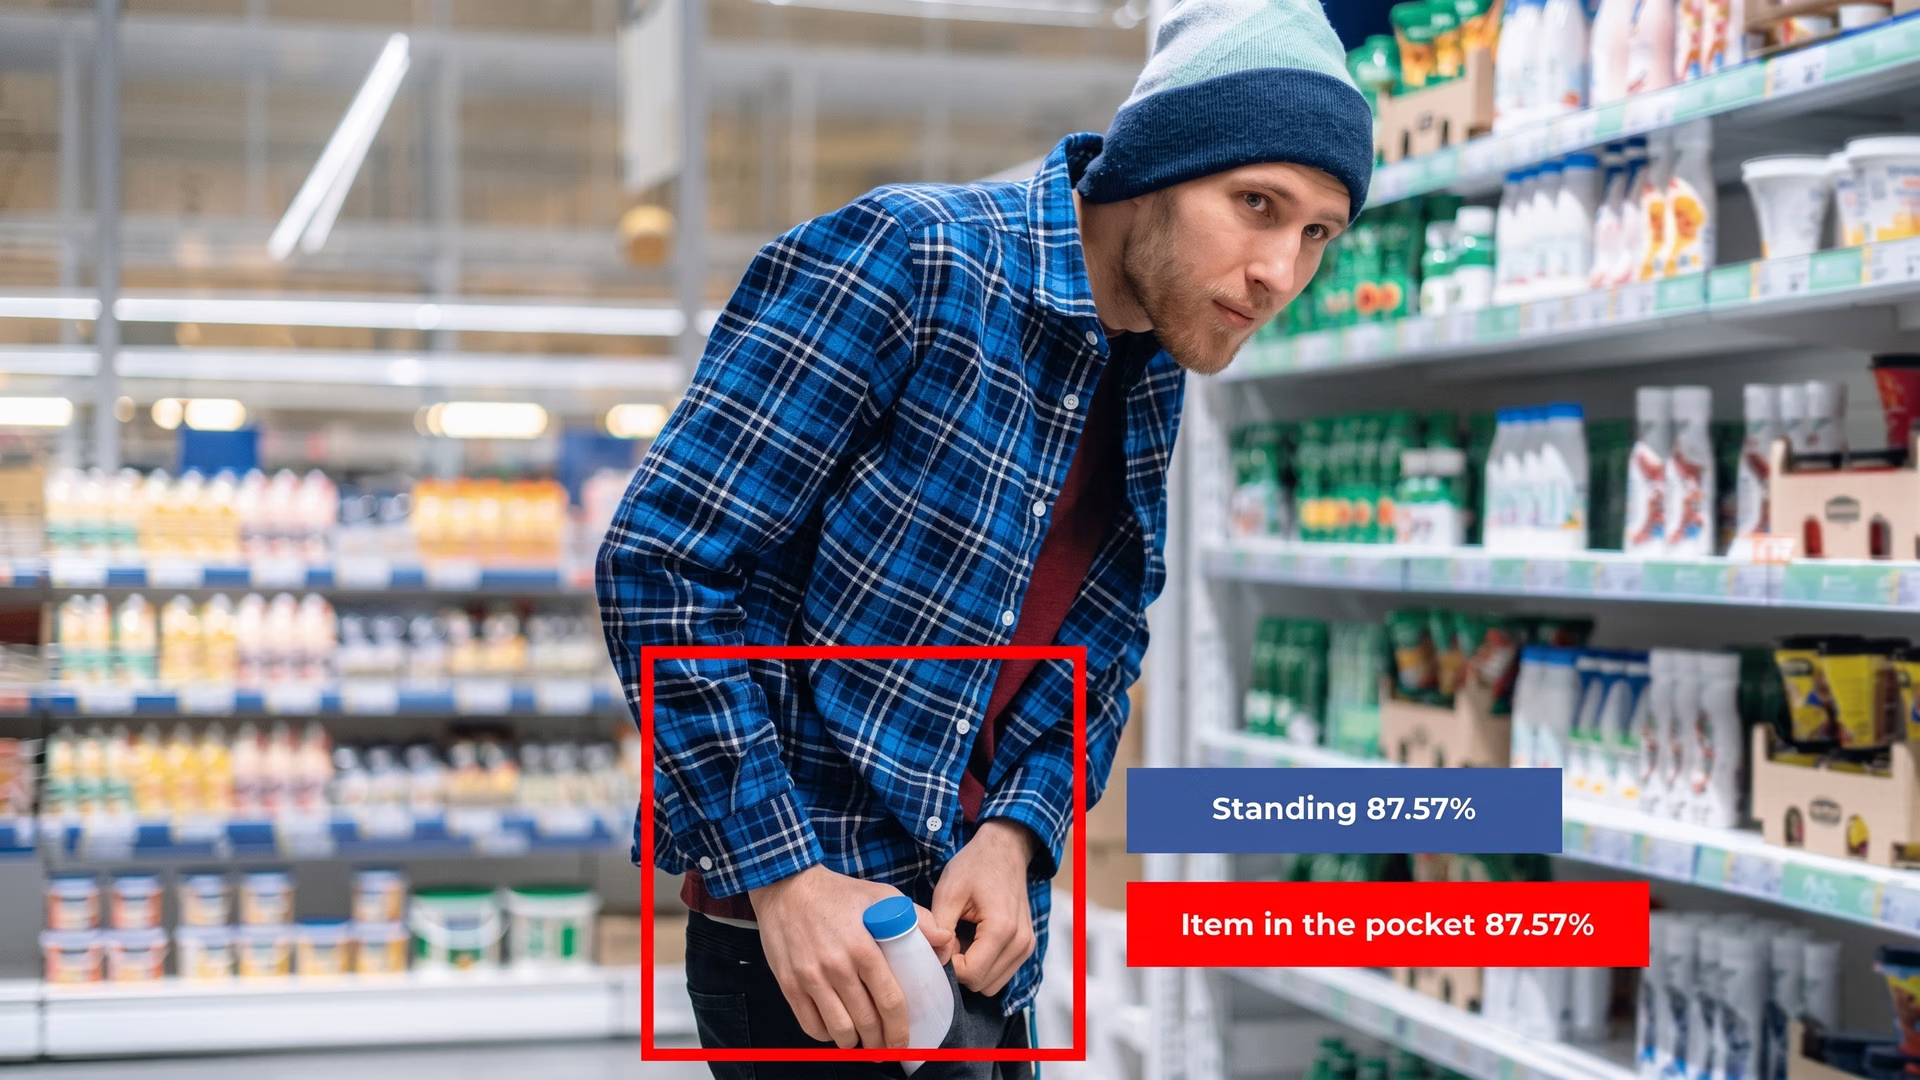
图 4。 使用计算机视觉检测盗窃行为的示例。
基于效用的智能体#
想象一下用于农作物监测的基于效用的无人机。它会调整飞行路线,在避开障碍物的同时覆盖更多区域,并选择最适合任务的路线。这意味着无人机会评估多个可能的操作,例如优先监测哪个区域或如何高效导航,然后选出最能提升其工作效果的操作。
同样,基于效用的智能体旨在从多个选项中选择最佳操作,以实现最大收益或最佳结果。为此设计的视觉 AI 智能体可以处理和分析不同的视觉输入,例如图像或传感器数据,并根据预定义的标准选出最有用的结果。
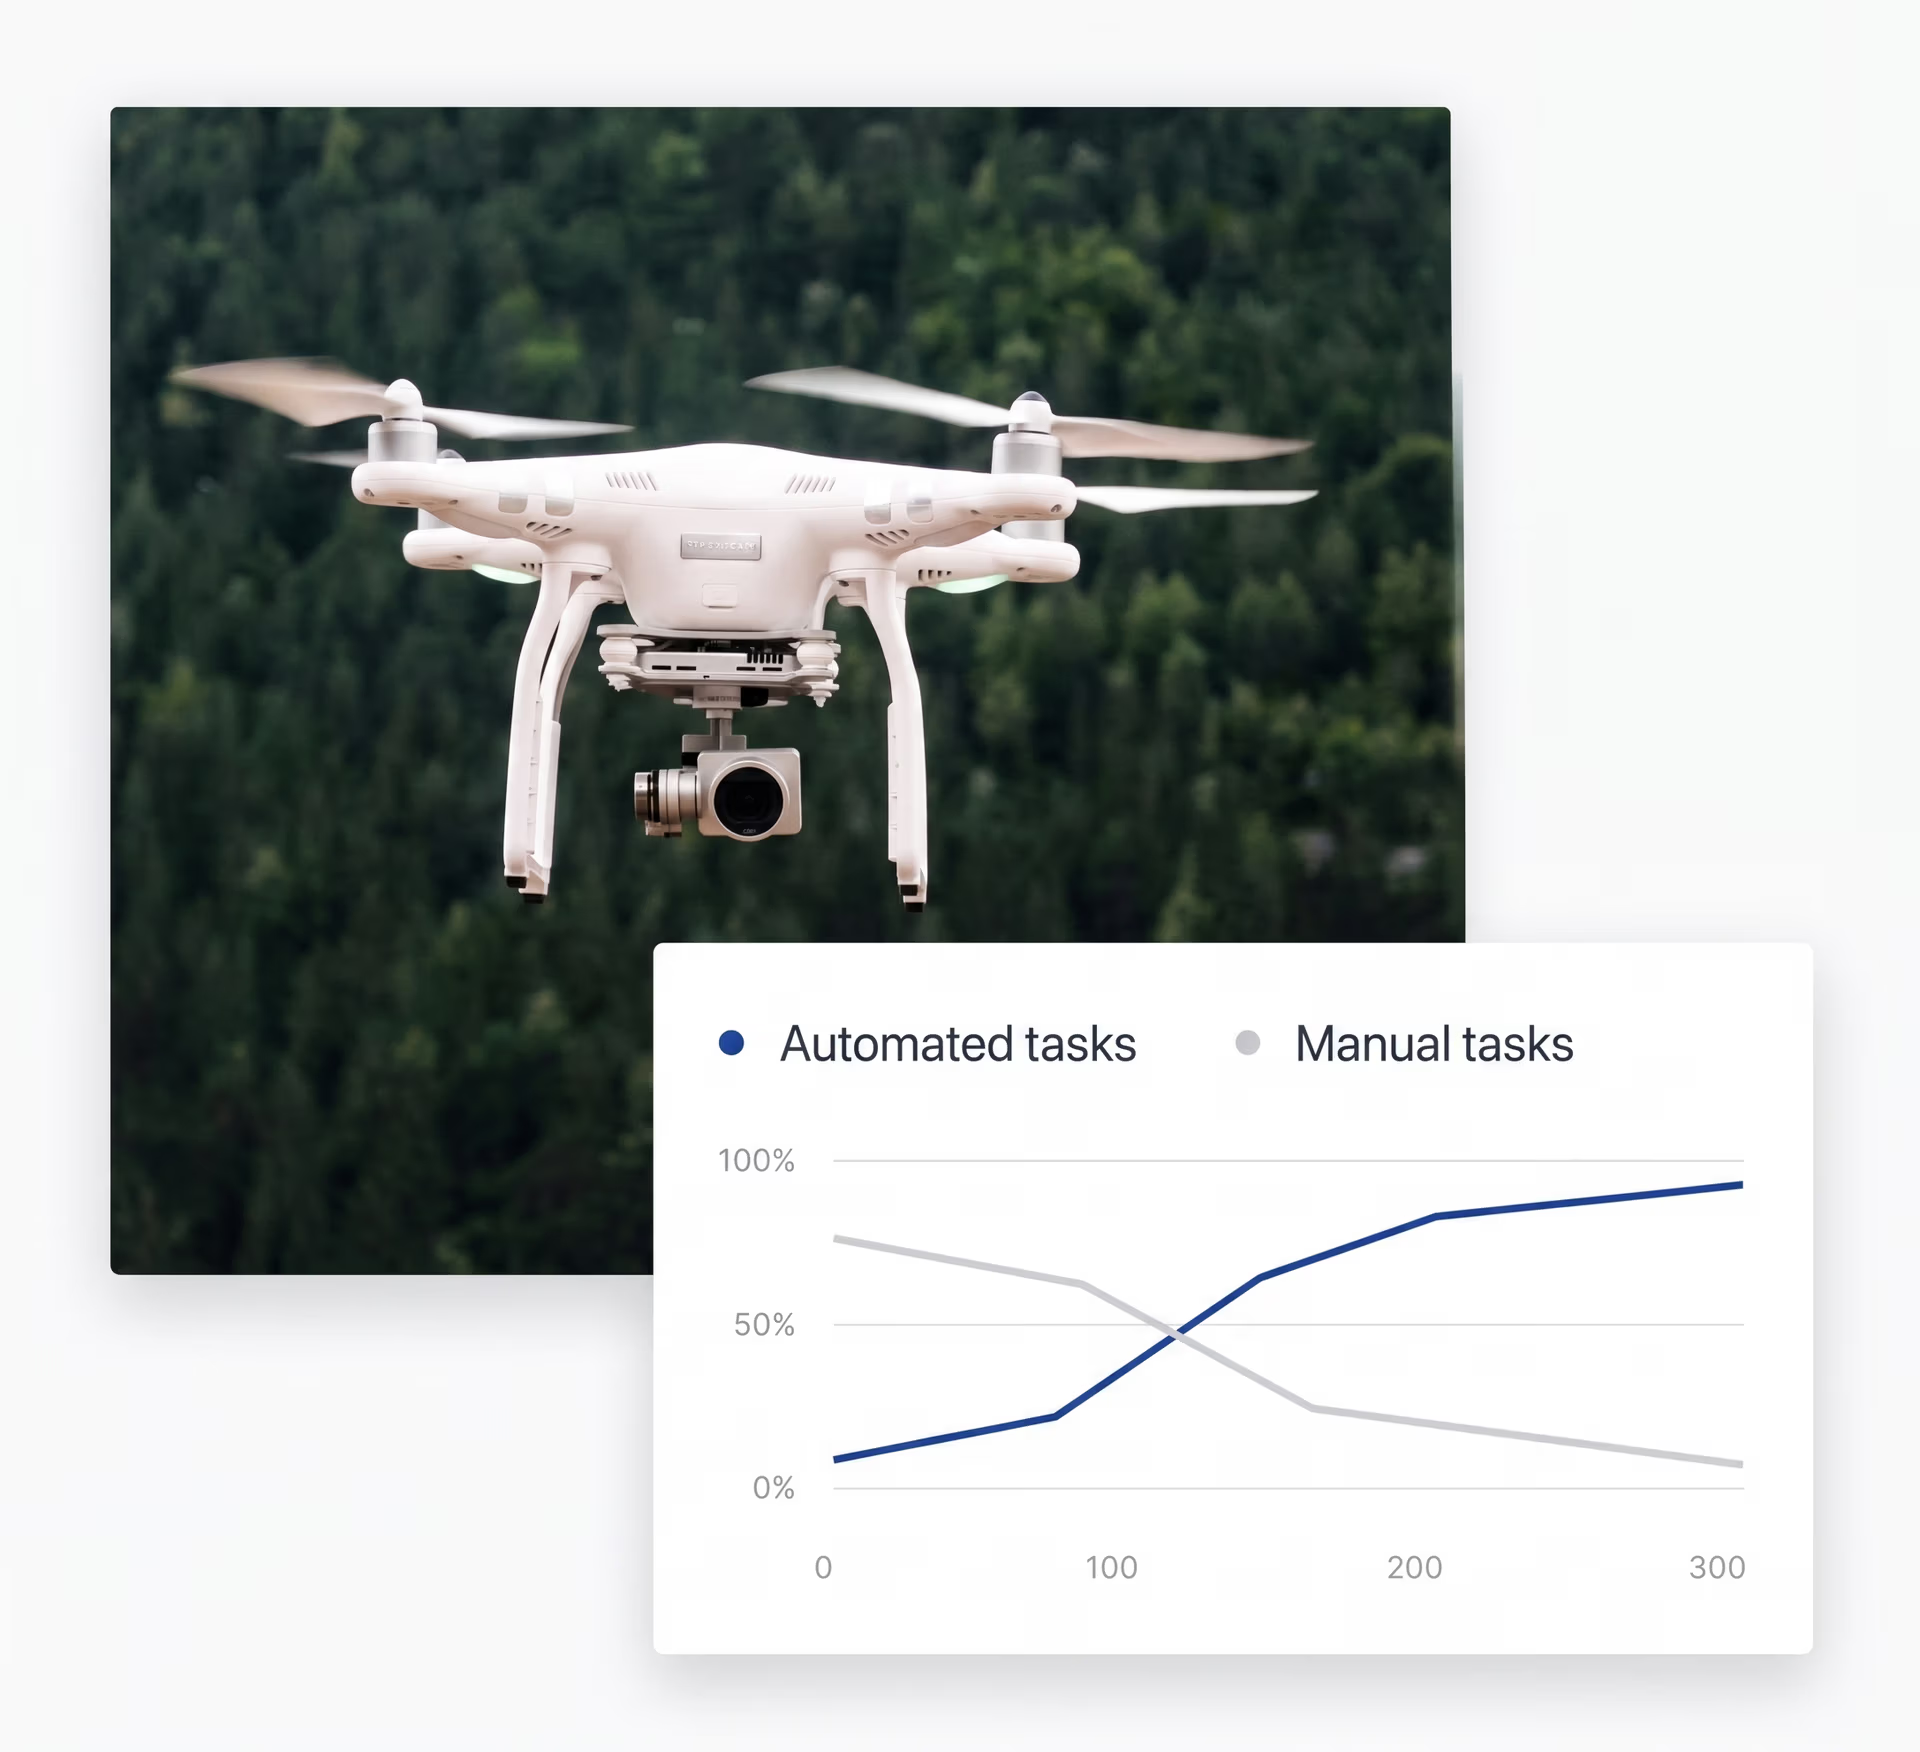
图 5。基于效用的无人机可用于农作物监测。
基于目标的智能体#
基于目标的智能体与基于效用的智能体类似,因为两者都旨在实现特定目标。不过,基于目标的智能体只关注能够让自己更接近既定目标的操作。它们会根据每项操作对实现目标的帮助程度进行评估,而不会权衡总体价值或取舍等其他因素。
例如,当自动驾驶汽车的目标是抵达目的地时,它就以基于目标的智能体方式运行。它会处理来自 AI 摄像头和传感器的数据,做出避开障碍物、遵守交通信号灯以及选择正确转弯路线等决策,以确保行驶方向正确。这些决策完全依据其是否有助于安全、高效地抵达目的地。与基于效用的智能体不同,基于目标的智能体只专注于实现目标,不会考虑效率或优化等其他标准。
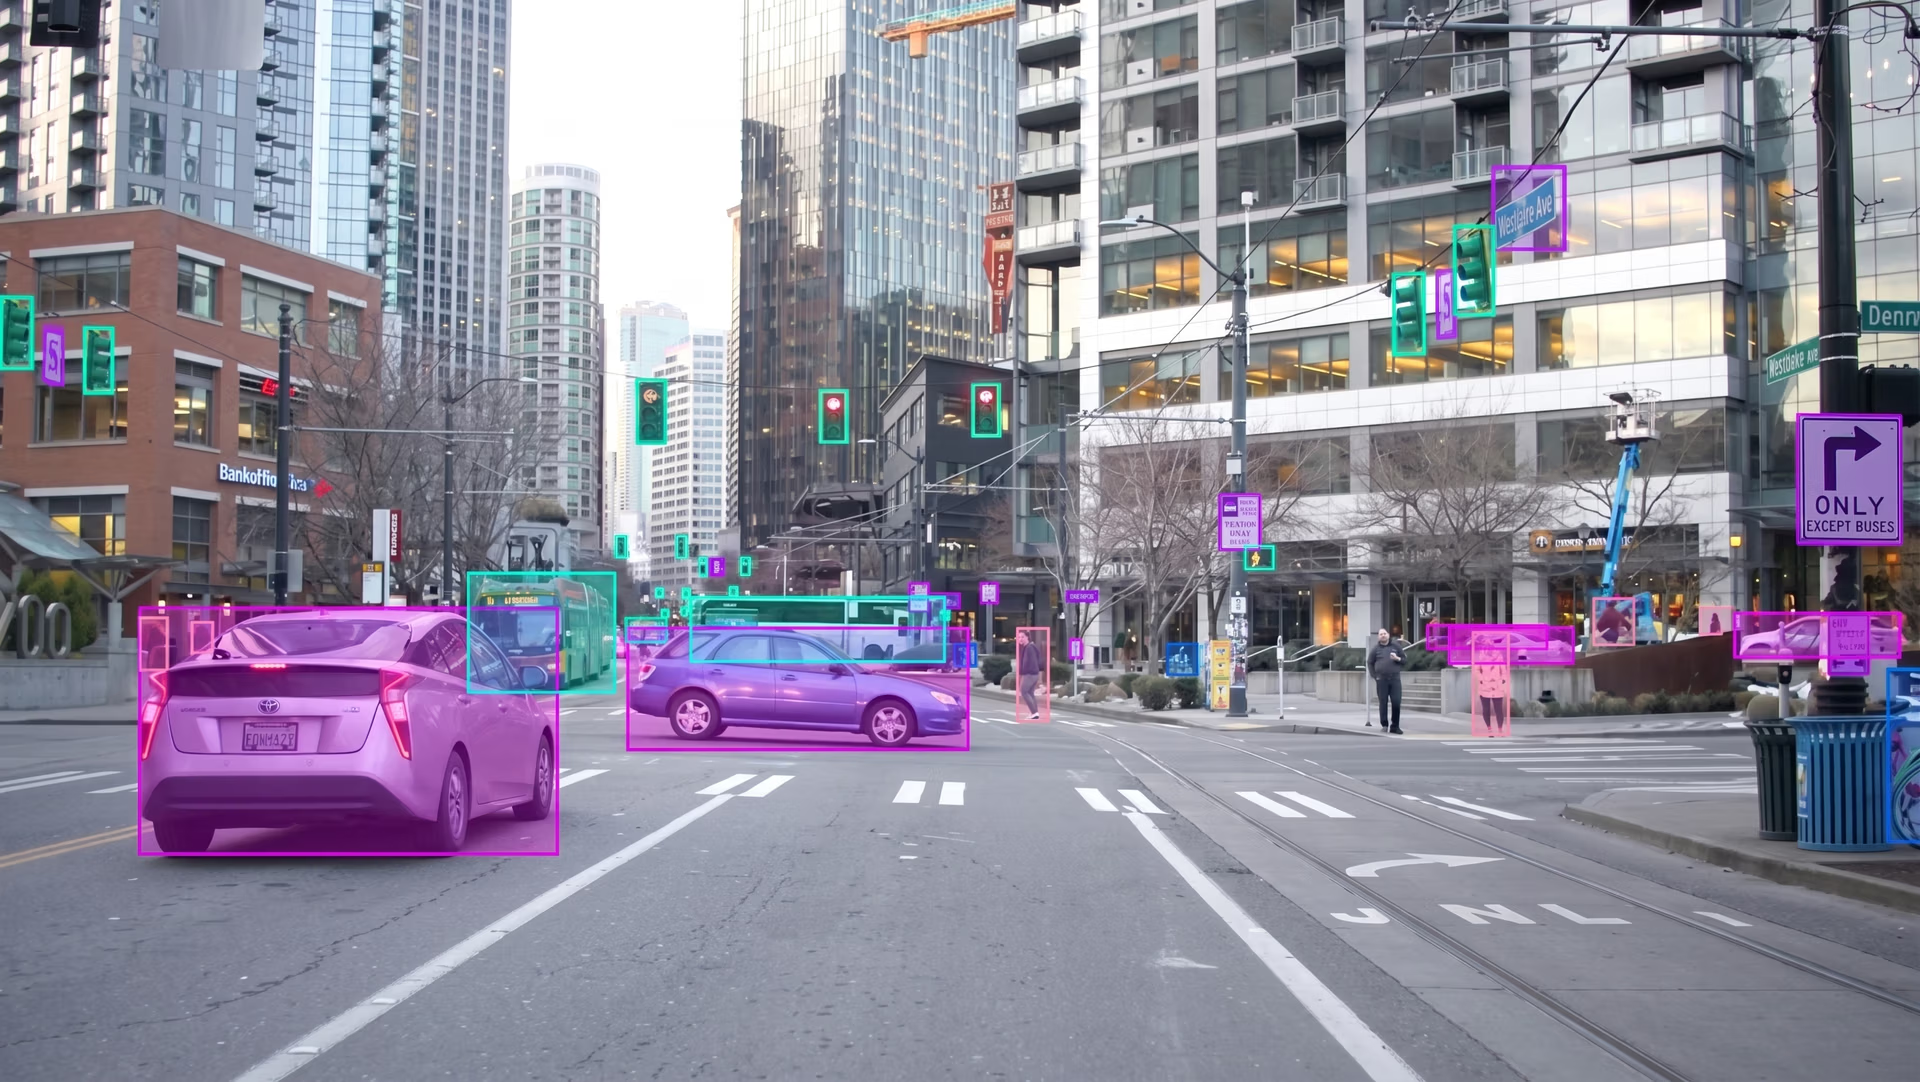
图 6。 使用计算机视觉识别周围物体的自动驾驶汽车。
学习型智能体#
如果你熟悉计算机视觉,可能听说过微调——模型通过新数据进行学习和改进的过程。学习型智能体也以类似的方式工作,会随着经验积累不断调整和改进。在基于视觉的质量控制等应用中,这类智能体会在每次检查后变得更加善于检测缺陷。这种不断改进性能的能力在航空等领域尤其重要,因为安全和精度至关重要。
分层智能体#
分层智能体会将复杂任务拆解为更小、更易管理的步骤,从而简化任务。高层智能体负责监督整个流程并做出战略决策,低层智能体则负责处理具体任务。在涉及多个步骤和细致执行的操作中,这种方式效率更高。
例如,在自动化仓库中,高层机器人可能会规划分拣流程,决定不同物品应该送往哪些区域。与此同时,低层机器人则专注于使用计算机视觉识别物品、分析尺寸、形状或标签等特征,并将物品整理到正确的货箱中。明确划分职责有助于系统顺利运行。
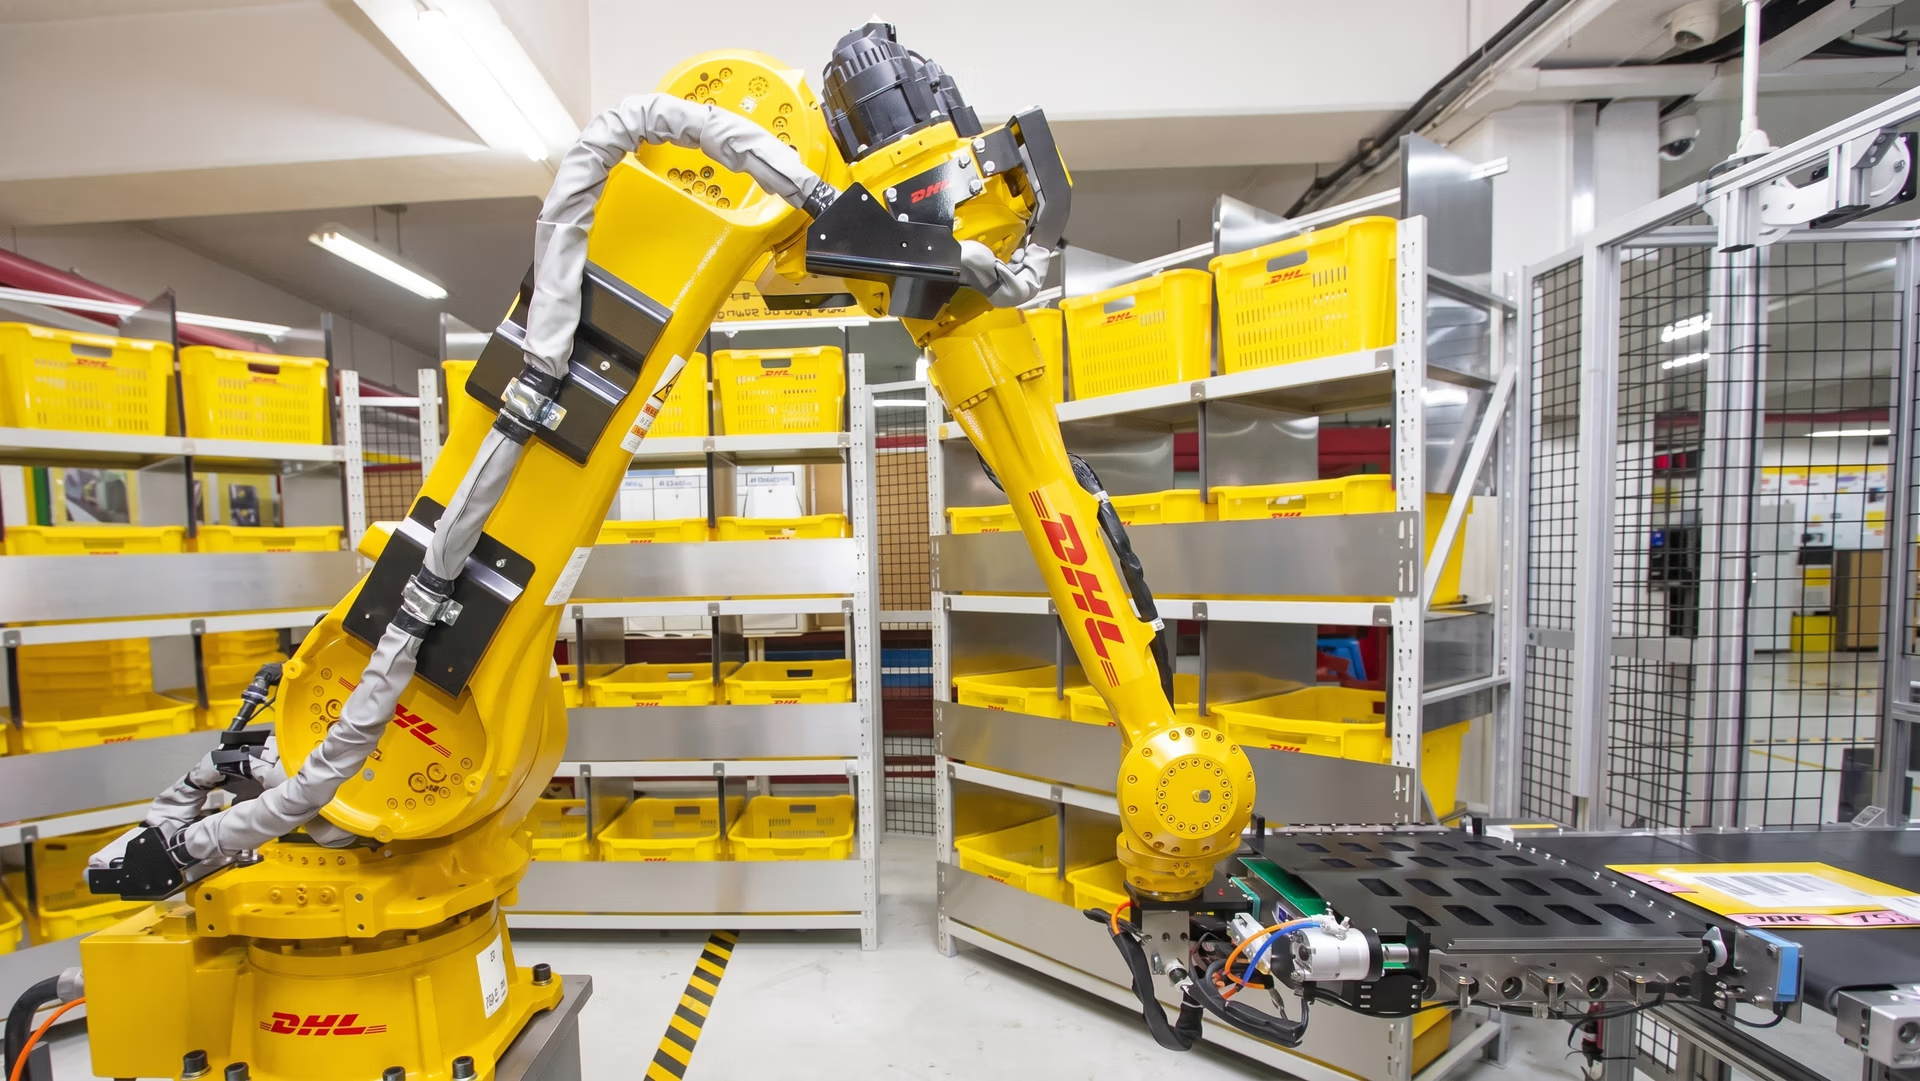
图 7。 机器人 AI 智能体分拣包裹的示例。
如何开始构建视觉 AI 智能体#
具备视觉能力的 AI 智能体的核心是计算机视觉模型。目前可用的最新、最可靠的计算机视觉模型之一是 Ultralytics YOLO11。YOLO11 以实时处理效率和准确性见长,非常适合计算机视觉任务。
下面介绍使用 Ultralytics YOLO11 的能力构建自己的 AI 智能体时涉及的不同流程:
-
准备数据集: 收集并预处理与你的 AI 智能体要执行的任务相关的已标注图像。
-
定制训练 模型: 使用你的数据集专门训练 Ultralytics YOLO11,以提升其在特定应用中的准确性和性能。
-
集成决策框架: 将训练好的模型连接到一个系统,使 AI 智能体能够根据视觉输入做出决策。
-
测试并改进: 部署 AI 智能体、测试其性能、收集反馈,并调整模型以提升准确性和可靠性。
要点#
集成计算机视觉的 AI 智能体(即视觉 AI 智能体)正在改变各行各业,它们能够自动执行任务、加快流程并改善决策。从控制交通的智慧城市到使用人脸识别的安防系统,这些智能体正为常见问题带来新的解决方案。
它们还能够持续学习和改进,因此适用于不断变化的环境。借助 Ultralytics YOLO11 等工具,创建和使用这些 AI 智能体变得更容易,从而带来更智能、更高效的解决方案。
加入我们的社区,并查看我们的 GitHub 代码库,了解 AI。浏览我们的解决方案页面,探索计算机视觉在医疗保健领域的应用和AI 在农业领域的应用。查看可用的许可选项,开始使用!









