探索 Claude 3 模型卡:它对视觉 AI 意味着什么
探索 Anthropic 的 Claude 3 模型卡:Opus、Sonnet 和 Haiku 在视觉基准测试中的表现,以及它们在计算机视觉任务中的不足。
 Mostafa Ibrahim5 分钟阅读
近年来,视觉 AI取得了长足进步,改变了从医疗保健到零售等多个行业。要有效利用这些进步,了解相关模型及其文档至关重要。AI 开发者的一项重要工具是模型卡,它全面介绍 AI 模型的特征和性能。
本文将介绍 Anthropic 开发的 Claude 3 模型卡片,并探讨其对视觉 AI 开发的影响。Claude 3 是一个由三种变体组成的新型大型多模态模型系列:能力最强的 Claude 3 Opus;兼顾性能与速度的 Claude 3 Sonnet;以及速度最快、成本效益最高的 Claude 3 Haiku。每种模型都新增了视觉能力,可以处理和分析图像数据。
Claude 3 模型卡片概览#
模型卡究竟是什么?模型卡是一份详细文档,介绍机器学习模型的开发、训练和评估情况。它旨在通过清晰说明模型的功能、预期使用场景和潜在局限,促进透明度、问责制和 AI 的合乎伦理使用。为此,模型卡会提供模型的详细数据,例如评估结果,以及与以往模型和竞品的比较。
评估指标#
评估指标对于评估模型性能至关重要。Claude 3 模型卡报告了模型在行业标准基准测试中的分数,清晰展示了模型的优势和有待改进之处。这些分数还与其他领先模型进行了比较,展现了 Claude 3 的竞争力。
此外,Claude 3 还在前代模型的优势基础上,融入了架构和训练技术方面的进展。模型卡片将 Claude 3 与早期版本进行了比较,突出了其在准确性、效率和新用例适用性方面的提升。
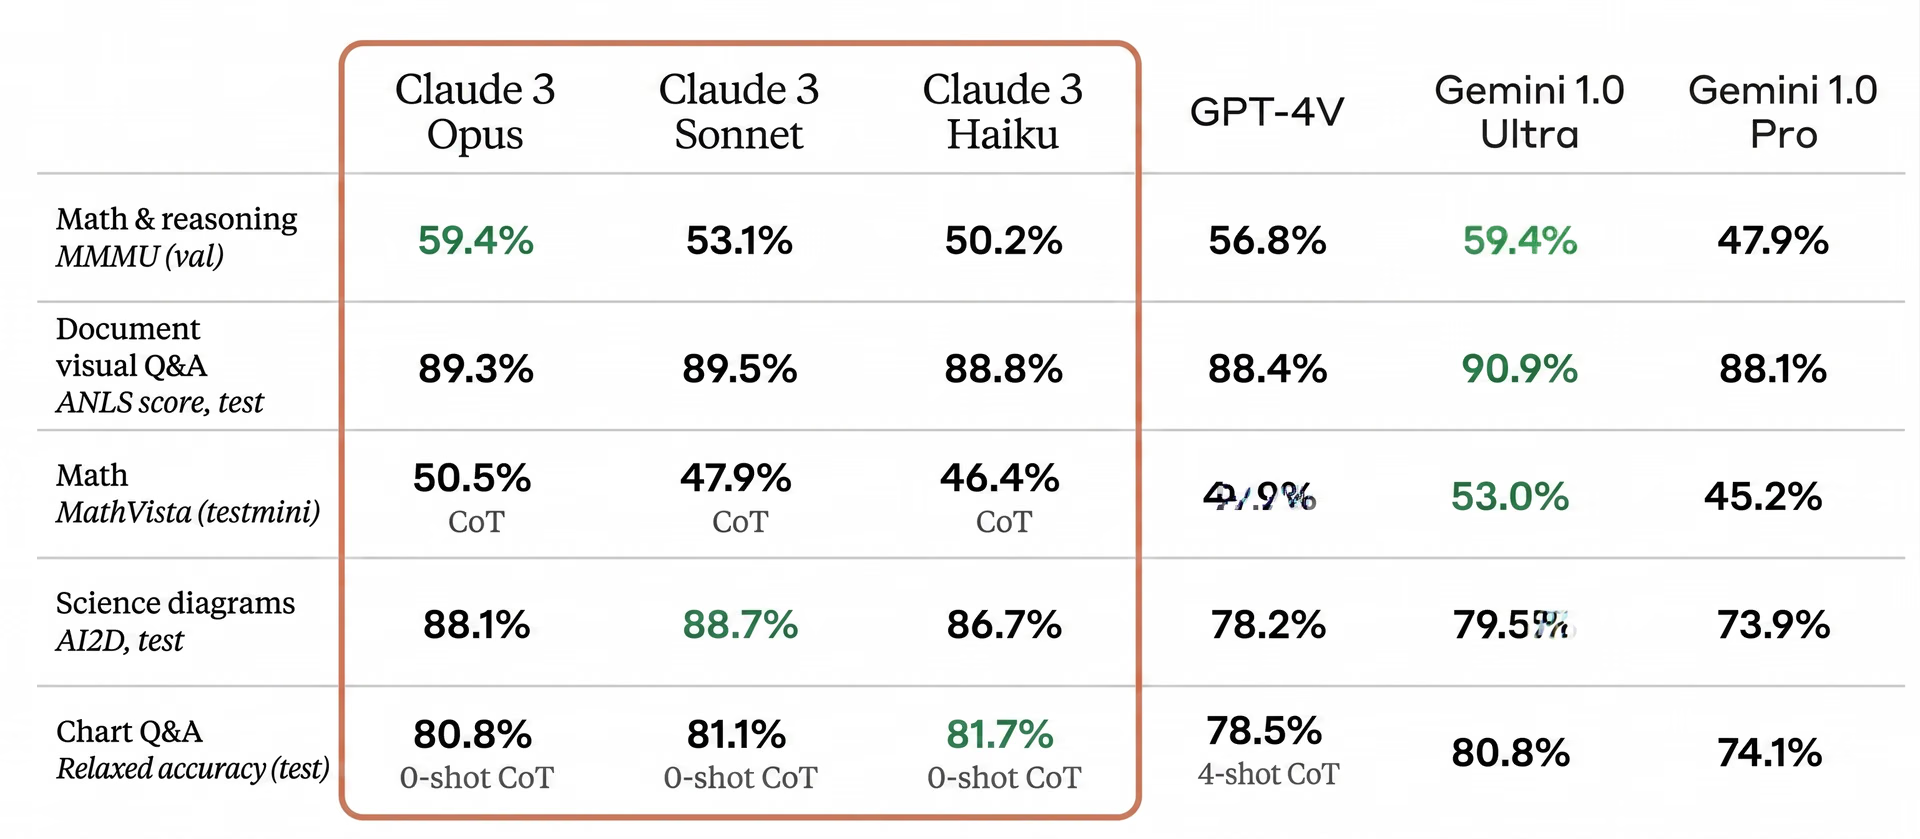
图 1。Claude 3 模型与其他模型在各种任务上的对比表。
Claude 3 如何影响视觉 AI 的发展#
Claude 3 的架构和训练流程使其在各种自然语言处理 (NLP) 和视觉任务中都能可靠运行。它在基准测试中持续取得出色成绩,展现了有效执行复杂语言分析的能力。
Claude 3 使用多样化数据集进行训练,确保了模型的稳健性以及在不同场景下的泛化能力。这使模型能够胜任广泛的应用,并发挥良好效果。
尽管 Claude 3 的结果值得关注,但它本质上是一个大型语言模型(LLM)。虽然 Claude 3 这类 LLM 可以执行多种计算机视觉任务,但它们并非专为目标检测、边界框创建和图像分割等任务设计。因此,它们在这些领域的准确率可能不如专门为计算机视觉打造的模型,例如 Ultralytics YOLOv8。不过,LLM 在其他领域表现出色,尤其是在自然语言处理(NLP)方面,Claude 3 将简单的视觉任务与人类推理相结合,展现了显著的优势。
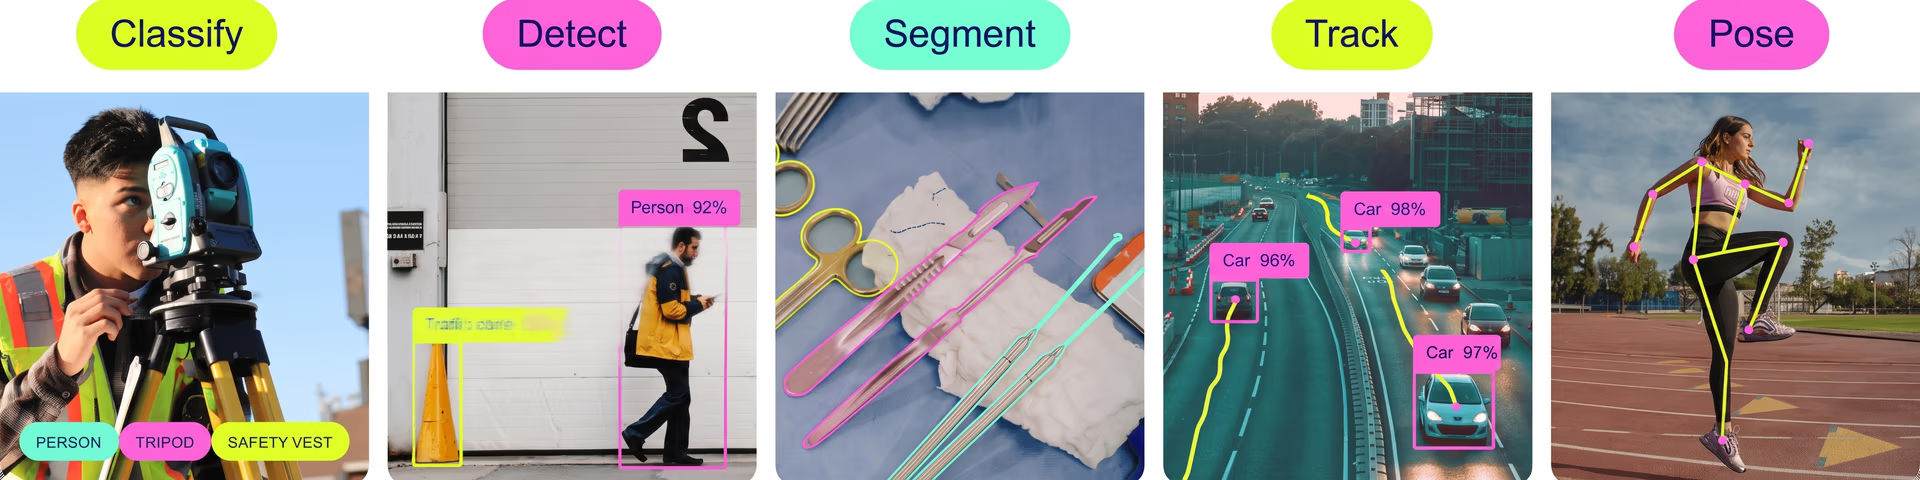
图 2. 使用 Ultralytics YOLOv8 进行目标分类、检测、分割、跟踪和姿势估计的概览。
NLP 能力是指 AI 模型理解人类语言并作出回应的能力。Claude 3 在视觉领域的应用充分利用了这项能力,使其能够提供内容丰富且符合语境的描述、解读复杂的视觉数据,并提升其在视觉 AI 任务中的整体表现。
图像转文本#
Claude 3 的一项出色能力,尤其是在视觉 AI 任务中的应用,是处理低质量图像,并将其中难以辨认的手写文字转换为文本。这项功能展现了模型先进的处理能力和多模态推理能力。本节将介绍 Claude 3 如何完成这项任务,并探讨其底层机制及其对视觉 AI 开发的影响。
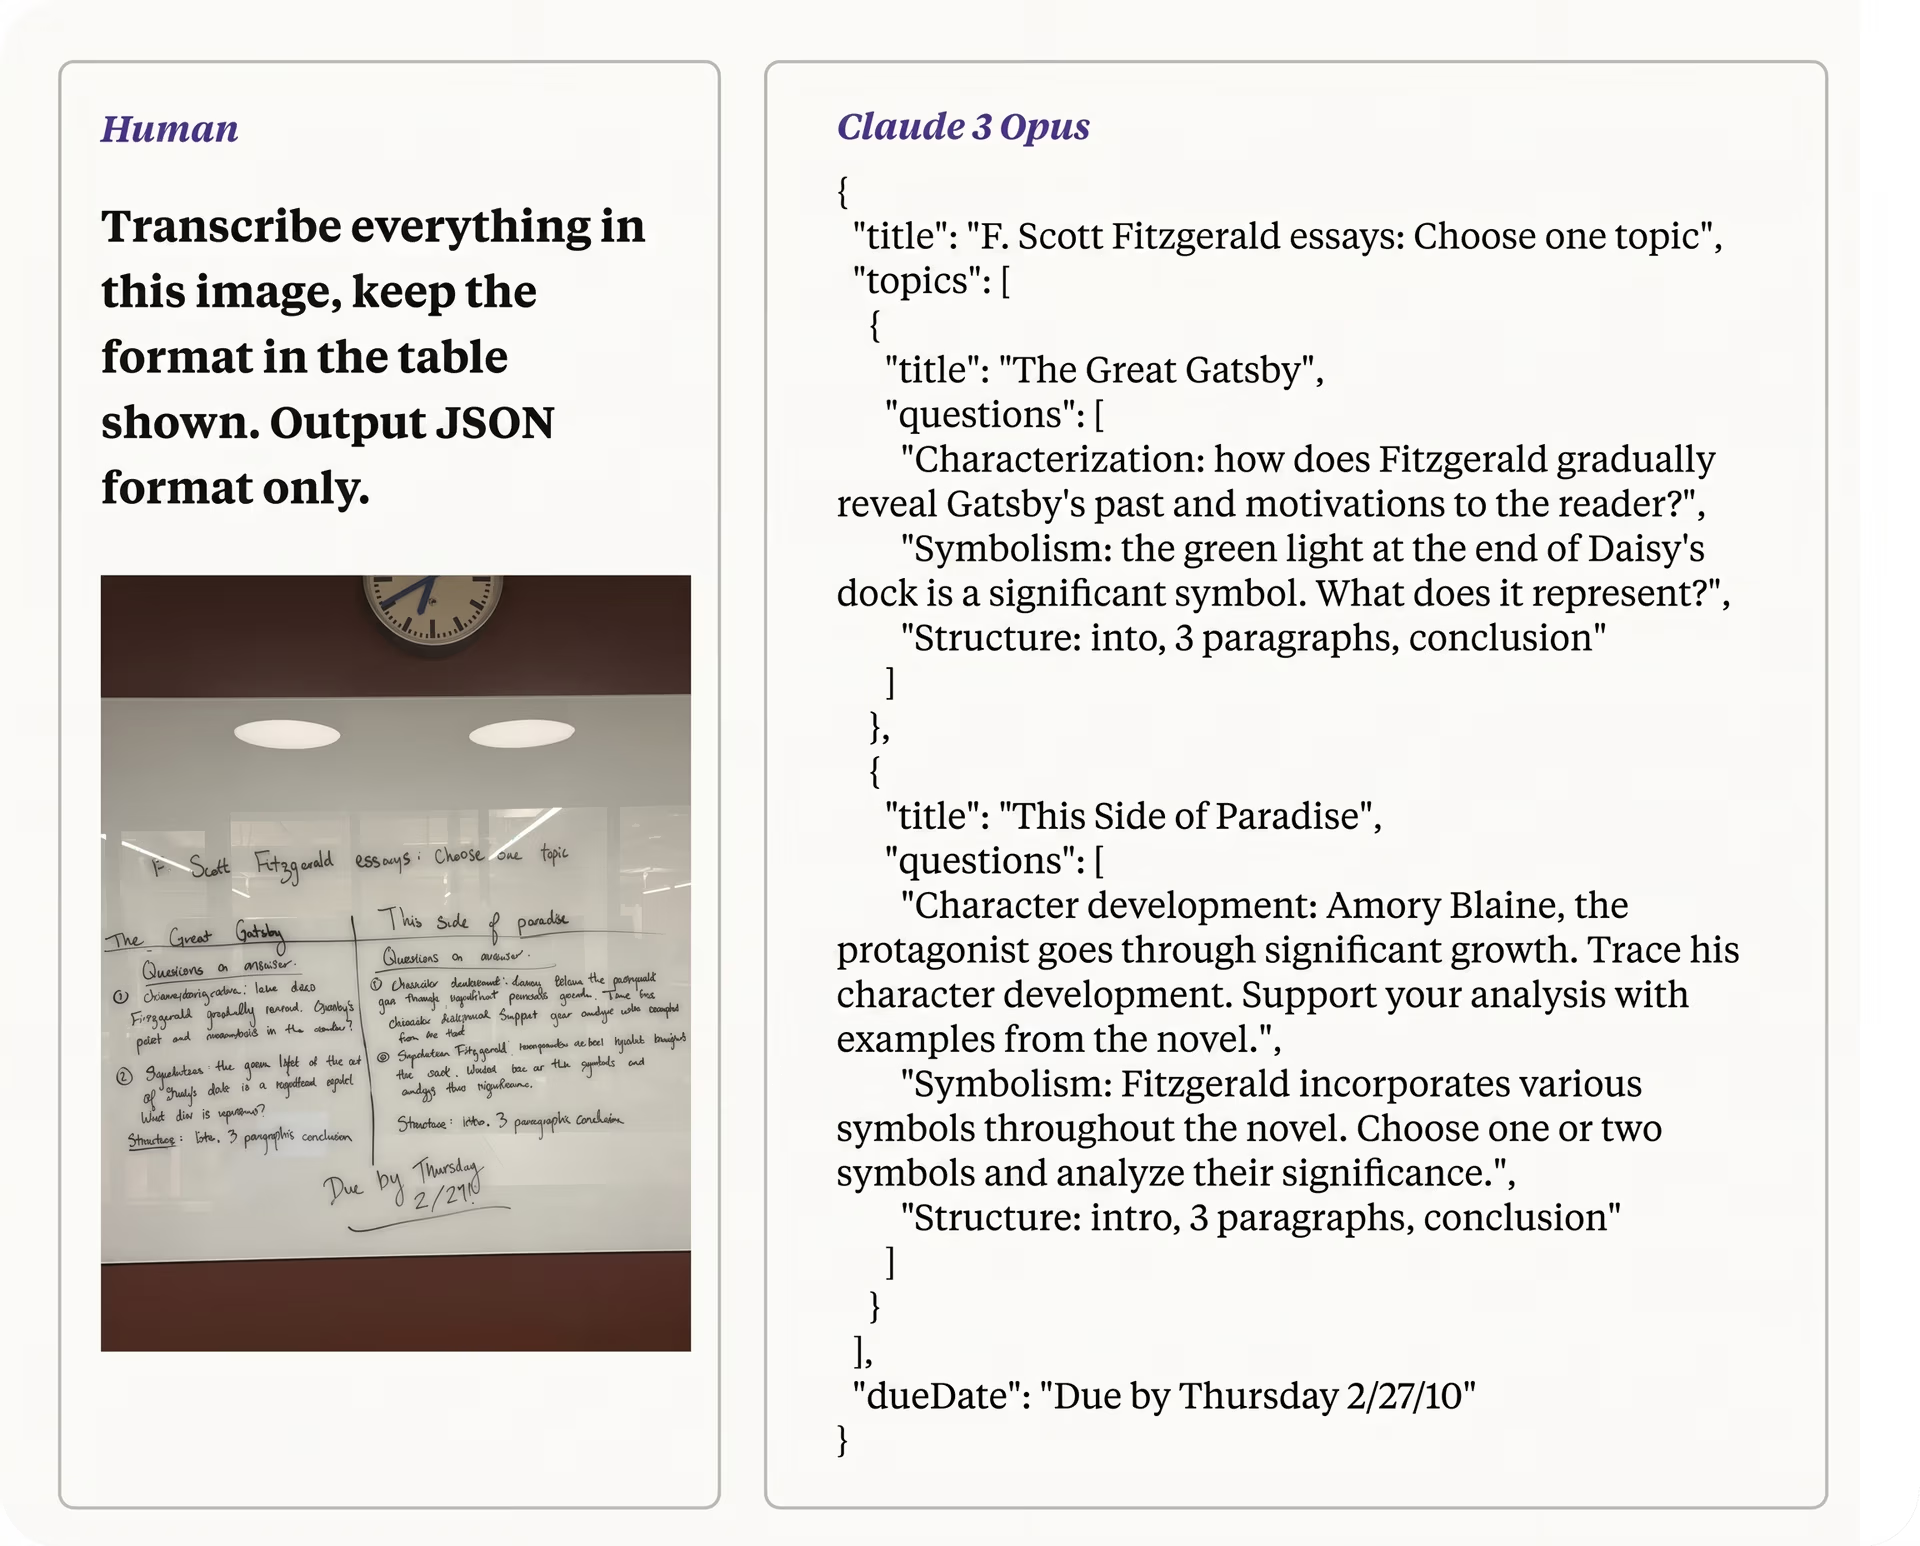
图 3。Claude 3 Opus 将一张手写文字难以辨认的低质量照片转换为文本。
了解挑战#
将一张手写文字难以辨认的低质量照片转换为文本是一项复杂任务,涉及多种挑战:
- 图像质量:低分辨率、噪声和不佳的光照条件可能会掩盖图像细节。
- 手写差异:不同人的书写风格差异很大,因此模型很难识别和解读文本。
- 语境理解:要准确地将手写内容转换为文本,需要结合语境来消除手写内容中的歧义。
如前所述,Claude 3 模型通过结合计算机视觉和自然语言处理 (NLP) 领域的先进技术来应对这些挑战。
利用视觉信息进行推理(多模态)#
Claude 3 的架构使其能够利用视觉输入完成复杂的推理任务。例如,如图 4 所示,该模型可以解读图表,例如在有关互联网使用情况的图表中找出 G7 国家,提取相关数据,并进行计算以分析趋势。这种多步推理(例如计算不同年龄组互联网使用情况的统计差异)提升了模型在现实应用中的准确性和实用性。
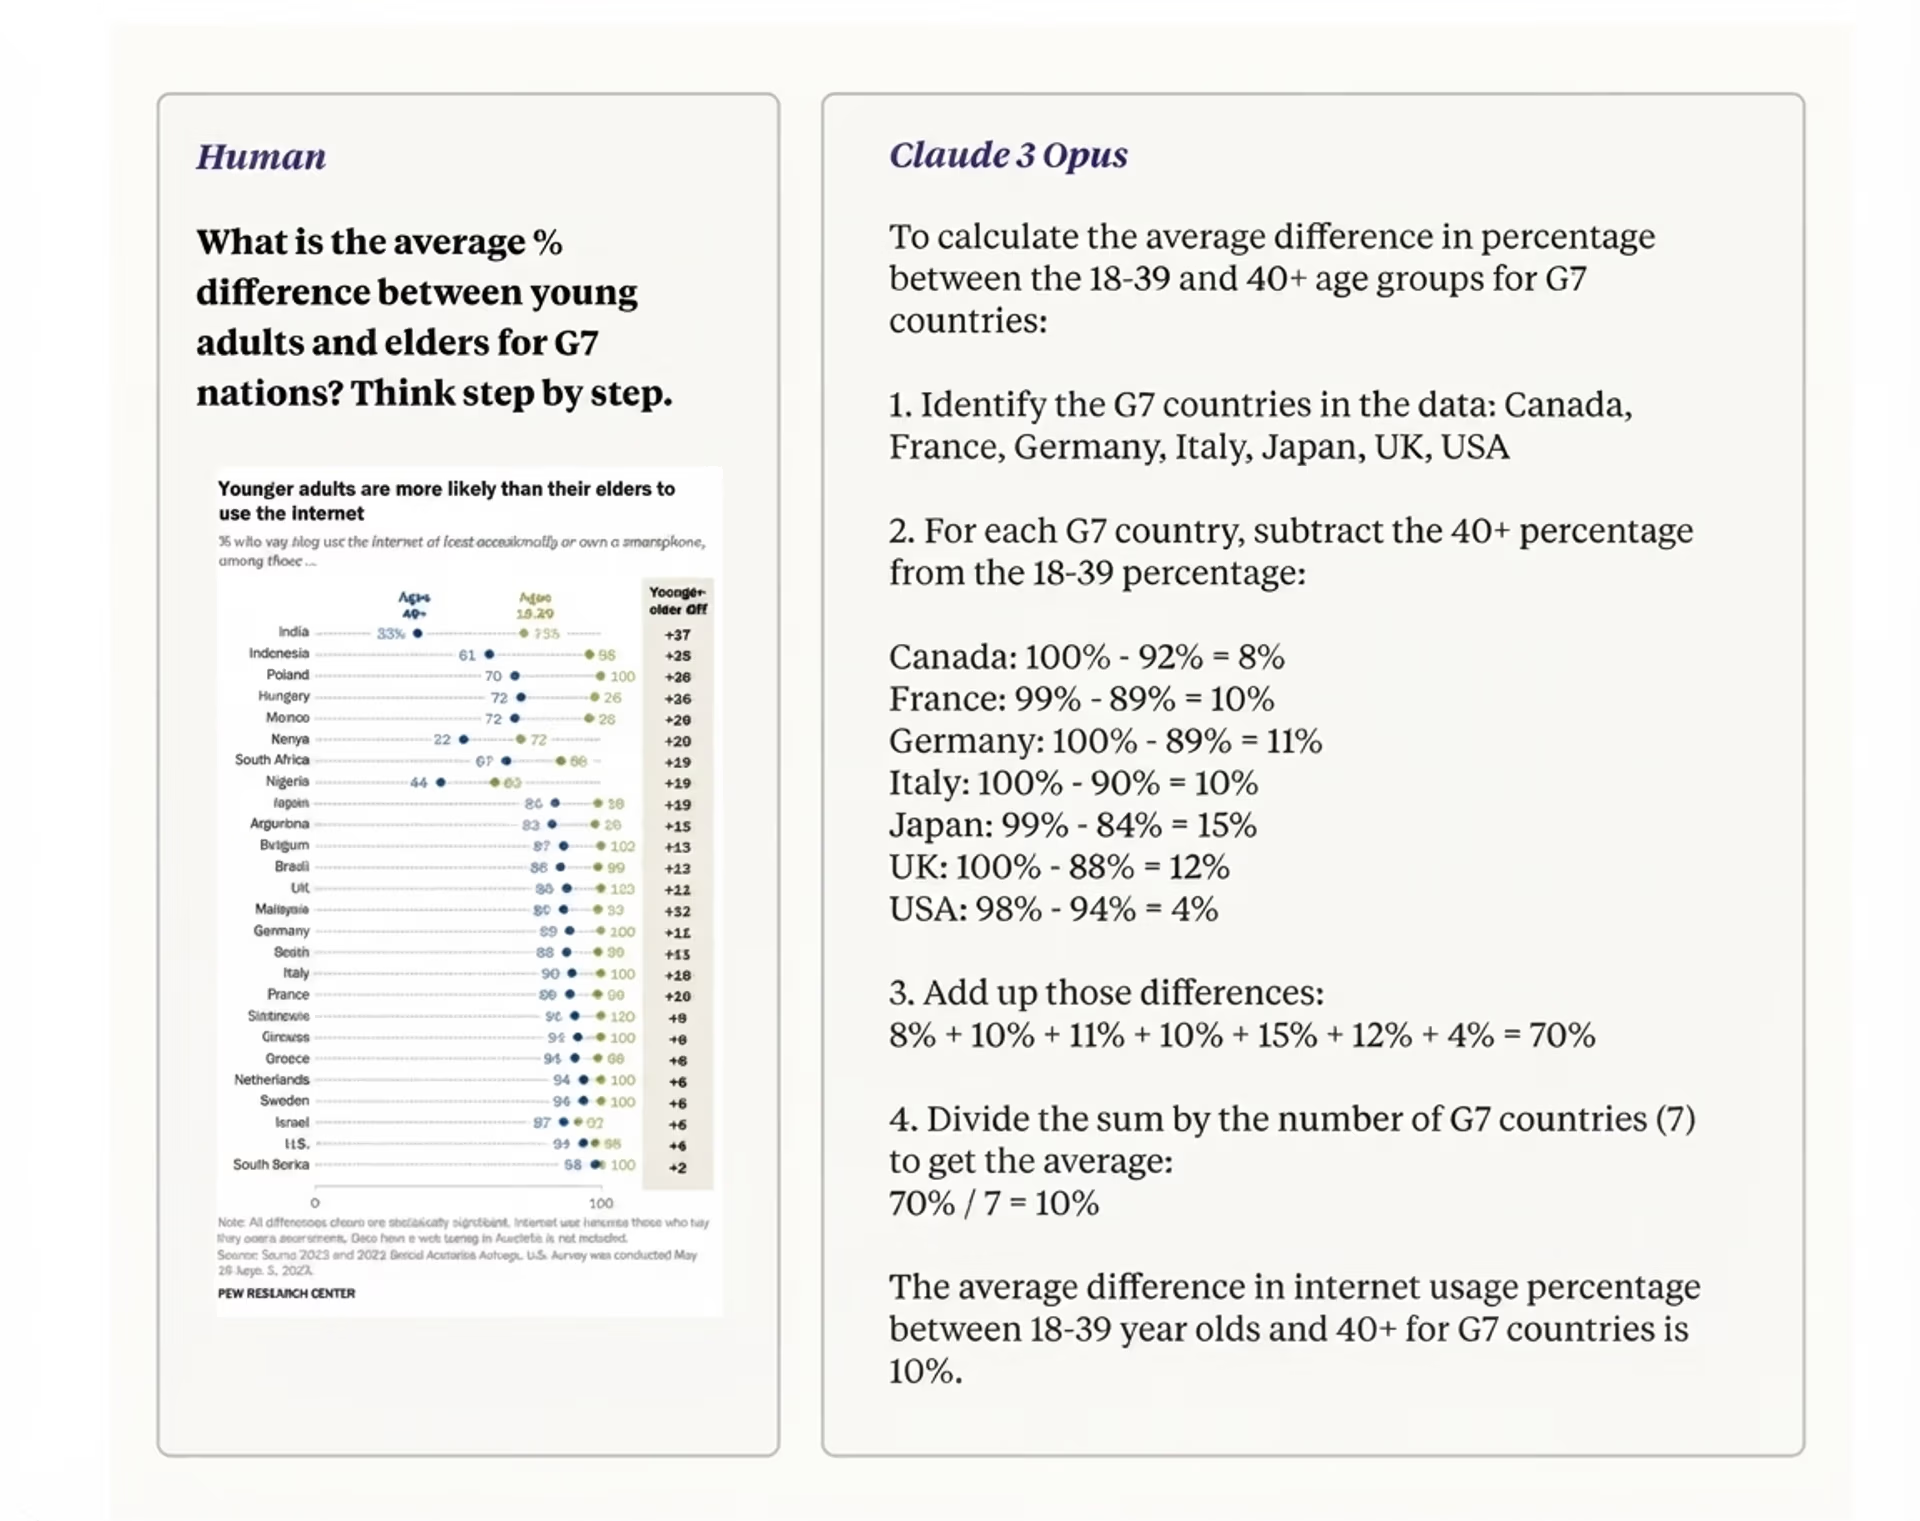
图 4。Claude 3 Opus 在可视化图表上执行多步推理任务。
描述图像#
Claude 3 擅长将图像转化为详细描述,展现了它在计算机视觉和自然语言处理方面的强大能力。它不仅能识别物体,还能理解物体之间的互动及其在场景中的意义,从而生成准确且内容丰富的描述。
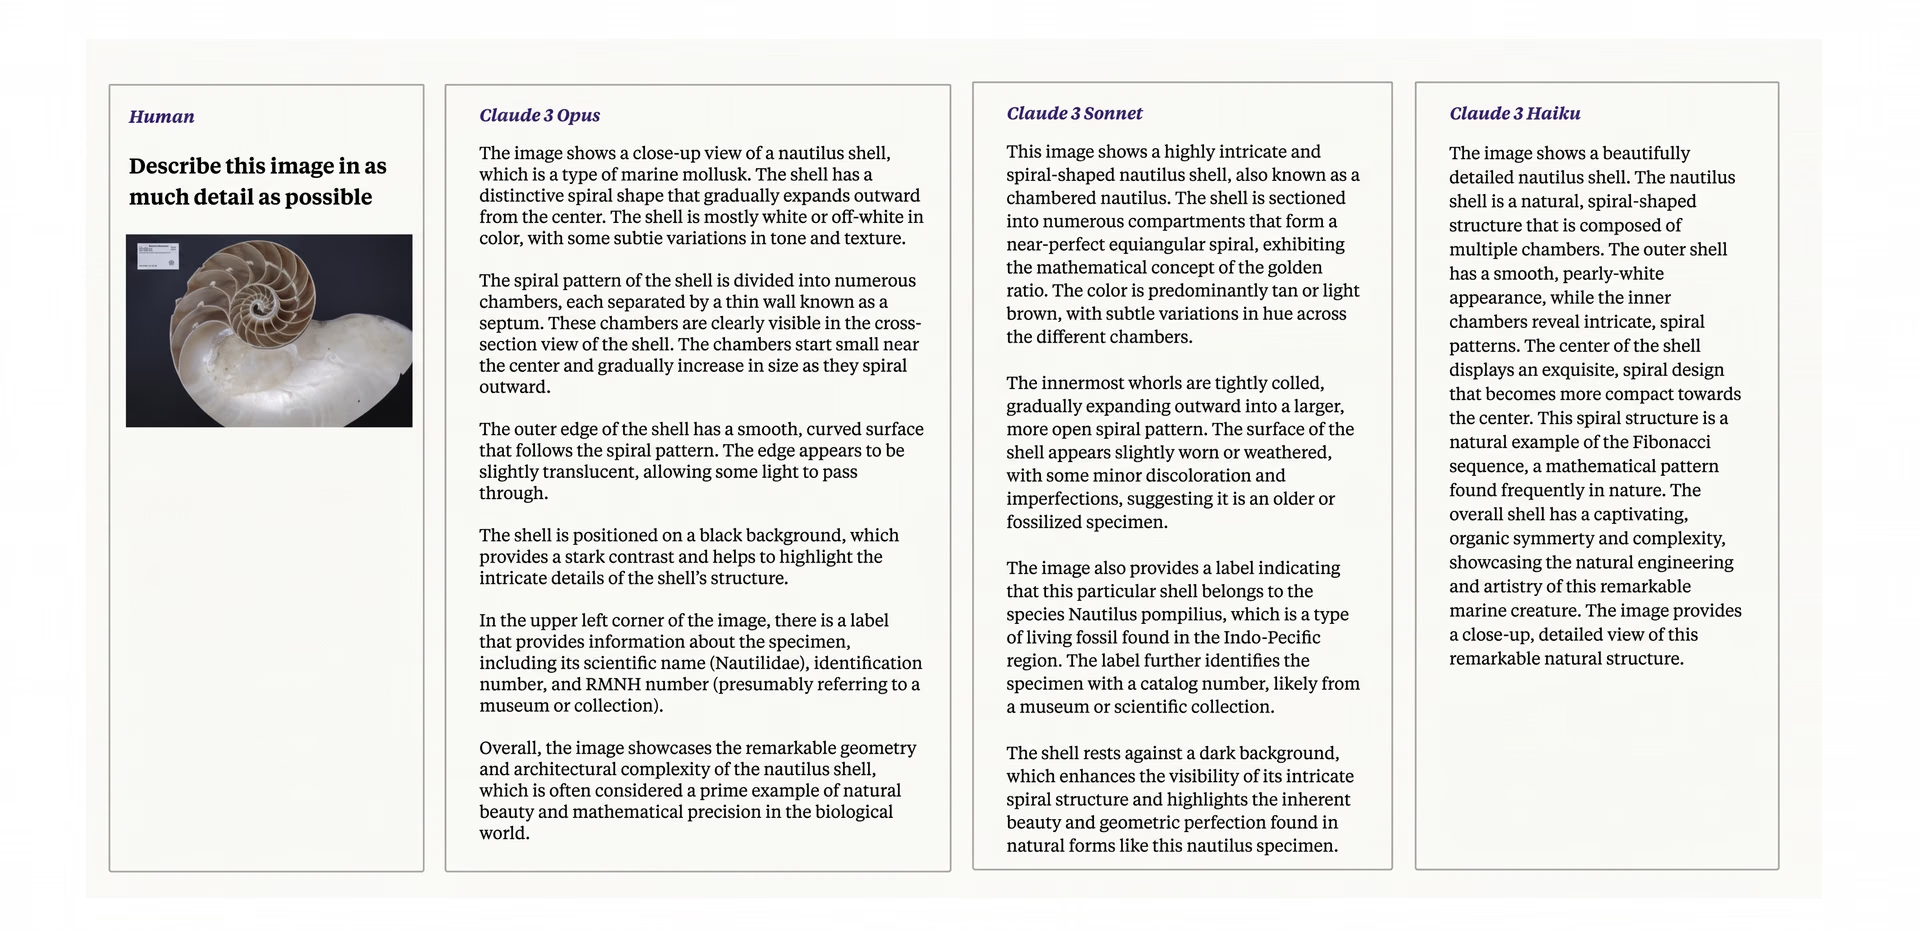
图 5。Claude 3 模型理解图像中的视觉对象,并用人类可理解的语言描述这些对象。
Claude 3 模型在计算机视觉方面面临的挑战与不足#
不面向计算机视觉#
Claude 3 这类大型语言模型(LLM)擅长自然语言处理,而非计算机视觉。虽然它们可以描述图像,但目标检测和图像分割等任务更适合由 Ultralytics YOLOv8 这类面向视觉的模型处理。这些专用模型针对视觉任务进行了优化,在图像分析方面表现更出色。此外,Claude 3 无法执行边界框创建等任务。
集成复杂性#
将 Claude 3 与计算机视觉系统结合起来可能很复杂,或许还需要额外的处理步骤来弥合文本数据与视觉数据之间的差距。
训练数据的局限#
Claude 3 主要使用海量文本数据进行训练,因此缺乏在计算机视觉任务中取得高性能所需的大规模视觉数据集。因此,虽然 Claude 3 擅长理解和生成文本,但它无法像专为视觉数据设计的模型那样熟练地处理或分析图像。这一局限使它不太适合需要解读或生成视觉内容的应用。
Claude 3 在视觉 AI 领域的未来潜力#
与其他大型语言模型类似,Claude 3 也会持续改进。未来的改进可能会着重提升图像检测和对象识别等视觉任务,以及自然语言处理任务。这将使模型能够在类似任务中更准确、详细地描述对象和场景。较新的 Claude 模型(例如 Claude Opus 5.5 和 Claude Haiku 5.5)能够使用边界框检测对象,而 VLM 基准测试结果展示了它们与其他视觉语言模型的对比情况。
最后,针对 Claude 3 的持续研究将优先提升可解释性、减少偏见,并增强模型在不同数据集上的泛化能力。这些工作将确保模型在各种应用中保持稳健表现,并提高人们对其输出的信任度和可靠性。
总结#
Claude 3 模型卡是视觉 AI 领域开发者和利益相关者的重要资源,提供了有关模型架构、性能和伦理考量的详细信息。它通过促进透明度和问责制,帮助确保 AI 技术得到负责任且有效的使用。随着视觉 AI 不断发展,Claude 3 这类模型卡将在指导开发、增进人们对 AI 系统的信任方面发挥关键作用。
在 Ultralytics,我们热衷于推动 AI 技术的发展。访问我们的 GitHub 代码仓库,探索 AI 解决方案并了解最新创新。加入我们的 Discord 社区,了解我们如何改变自动驾驶汽车和制造业等行业!
作者
软件工程师与技术撰稿人 · 自由职业
评论
提出问题、分享你的结果,或帮助其他人。









