Florence-2:Microsoft 最新的视觉语言模型
认识 Florence-2:Microsoft 的视觉语言模型,可用于目标检测、分割、图像描述和定位,并具备出色的零样本性能。
 Abirami Vina6 分钟阅读
2024 年 6 月,Microsoft 推出了 Florence-2,这是一种多模态视觉语言模型(VLM),旨在处理多种任务,包括目标检测、分割、图像描述生成和定位。Florence-2 为零样本性能树立了新的标杆,也就是说,它无需事先针对特定任务进行训练就能执行任务,而且其模型尺寸比其他最先进的视觉语言模型更小。
Florence-2 不只是又一个模型。它的多功能性和性能提升有望通过提高精度、减少对大量训练的需求,对多个行业产生重大影响。本文将介绍 Florence-2 的主要功能、比较它与其他 VLM 的性能,并讨论它的潜在应用。
什么是 Florence-2?#
Florence-2 可在一个统一框架内处理多种任务。模型的能力部分得益于名为 FLD-5B 的大型训练数据集。FLD-5B 包含 1.26 亿张图像上的 54 亿条标注。这个综合数据集专门用于赋予 Florence-2 所需的能力,使其能够高精度、高效率地处理各种视觉任务。
下面来具体了解 Florence-2 支持的任务:
- 目标检测:它可以高精度地识别并定位图像中的物体。
- 分割:这项任务会将图像划分为有意义的区域,以便更轻松地分析和解读。
- 图像描述生成:Florence-2 能够为图像生成描述性文字,提供背景信息和细节。
- 视觉定位:该模型可以将描述中的特定短语或词语与图像中的对应区域关联起来。
- 零样本性能:它无需针对特定任务进行训练即可执行任务。
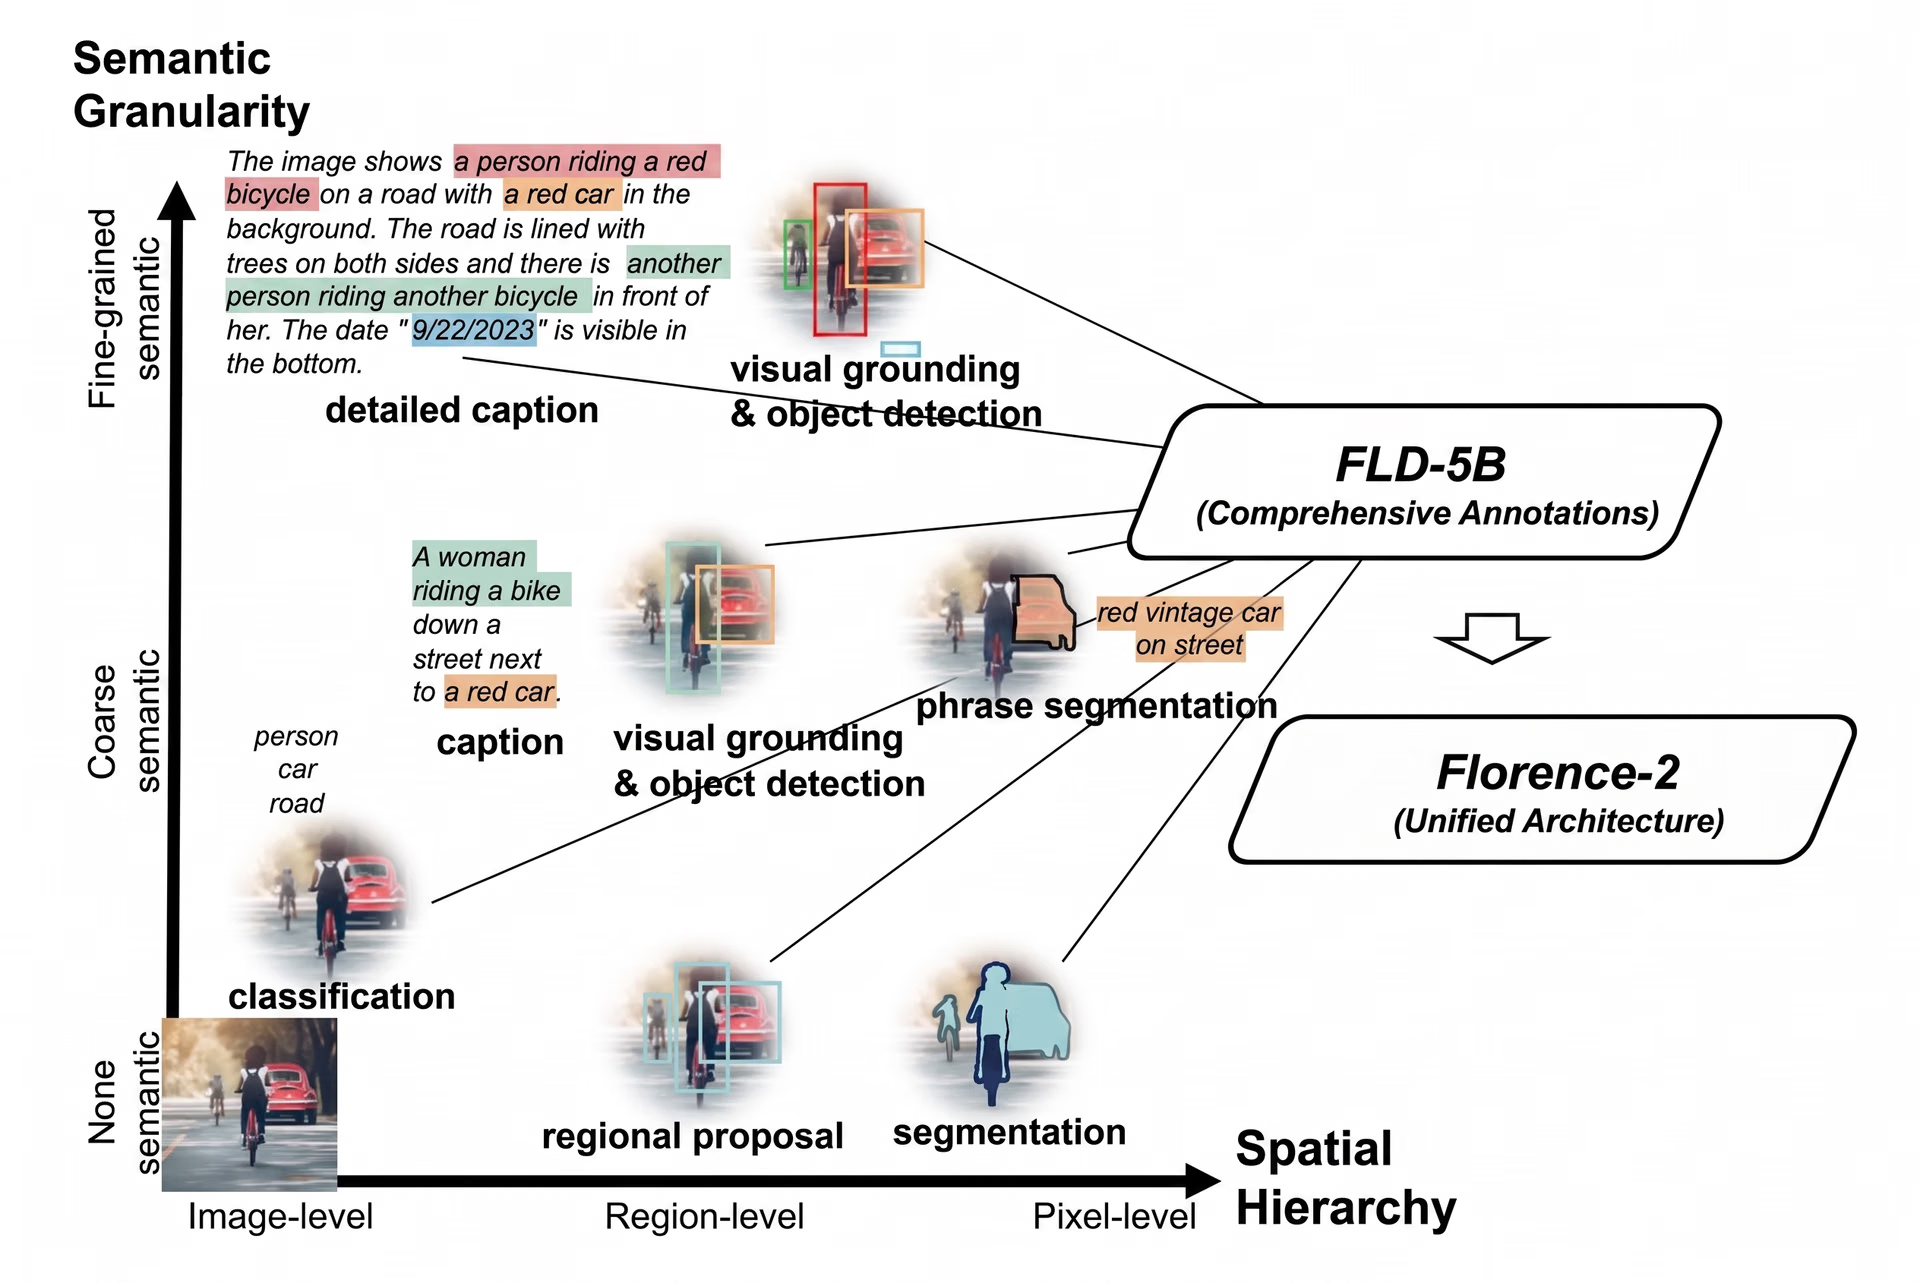
图 1:了解 Florence-2 的训练方式。
该模型同时支持基于文本和基于区域的任务。模型词汇表中加入了特殊的位置标记,用于处理涉及图像特定区域的任务。这些标记能帮助模型理解不同形状,例如物体周围的矩形(框表示)、四边形(四边框表示)和多边形(多边形表示)。模型使用标准交叉熵损失函数进行训练,通过将预测结果与正确答案进行比较并相应调整内部参数来学习。
创建 FLD-5B 数据集#
FLD-5B 数据集包含多种类型的标注:文本描述、区域与文本的配对,以及文本、短语和区域的组合。该数据集通过两步流程创建,其中包括数据收集和标注。图像来源于 ImageNet-22k、Objects365、Open Images、Conceptual Captions 和 LAION 等热门数据集。FLD-5B 数据集中的标注大多为合成数据,也就是说,它们是自动生成的,而非人工标注的。
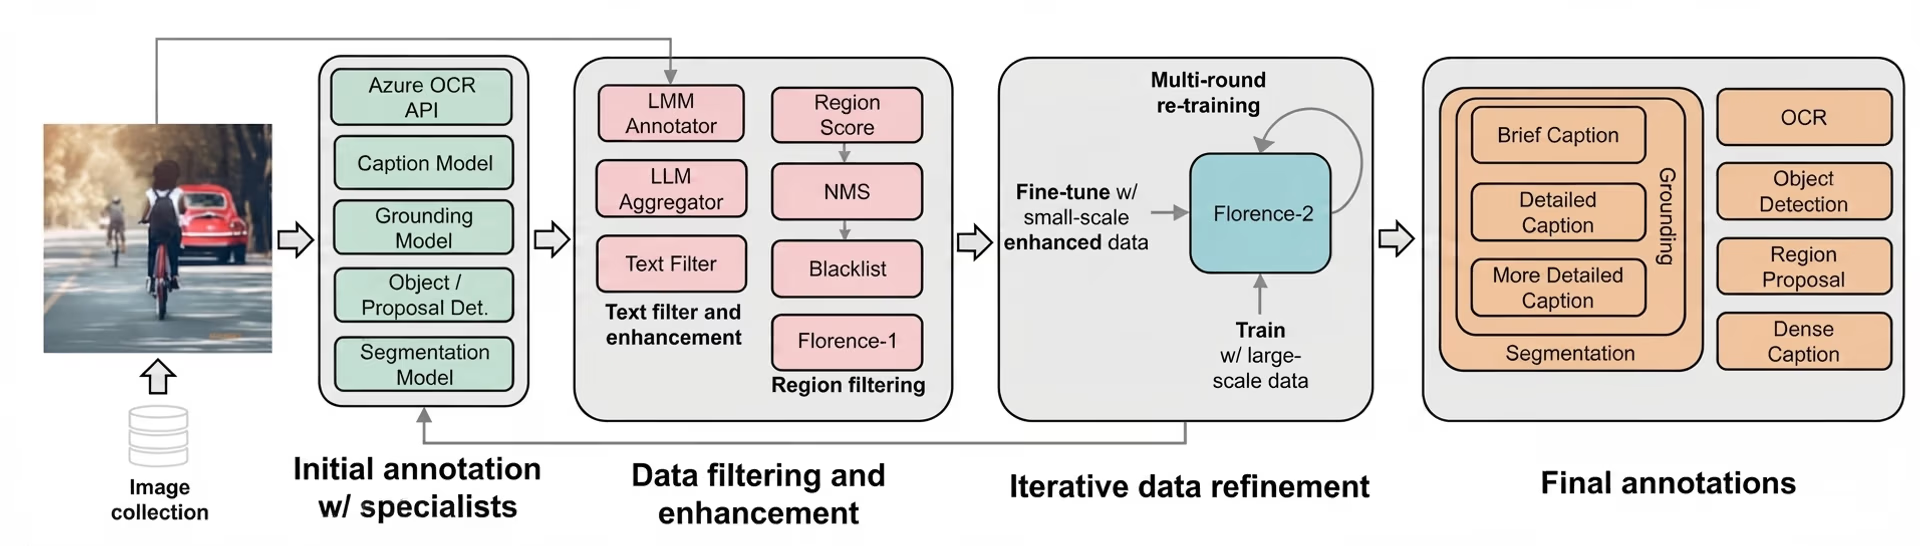
图 2:创建 FLD-5B 数据集。
最初,由擅长目标检测或分割等特定任务的专业模型生成这些标注。随后,通过筛选和增强流程确保标注详细且准确。去除噪声后,数据集会经过迭代优化:利用 Florence-2 的输出持续更新和改进标注。
了解 Florence-2 的模型架构#
Florence-2 的模型架构采用序列到序列学习方法。这意味着模型会逐步处理输入序列(例如带有文本提示的图像),并生成输出序列(例如描述或标签)。在序列到序列框架中,每项任务都被视为一个翻译问题:模型接收输入图像和特定任务的提示,然后生成相应的输出。
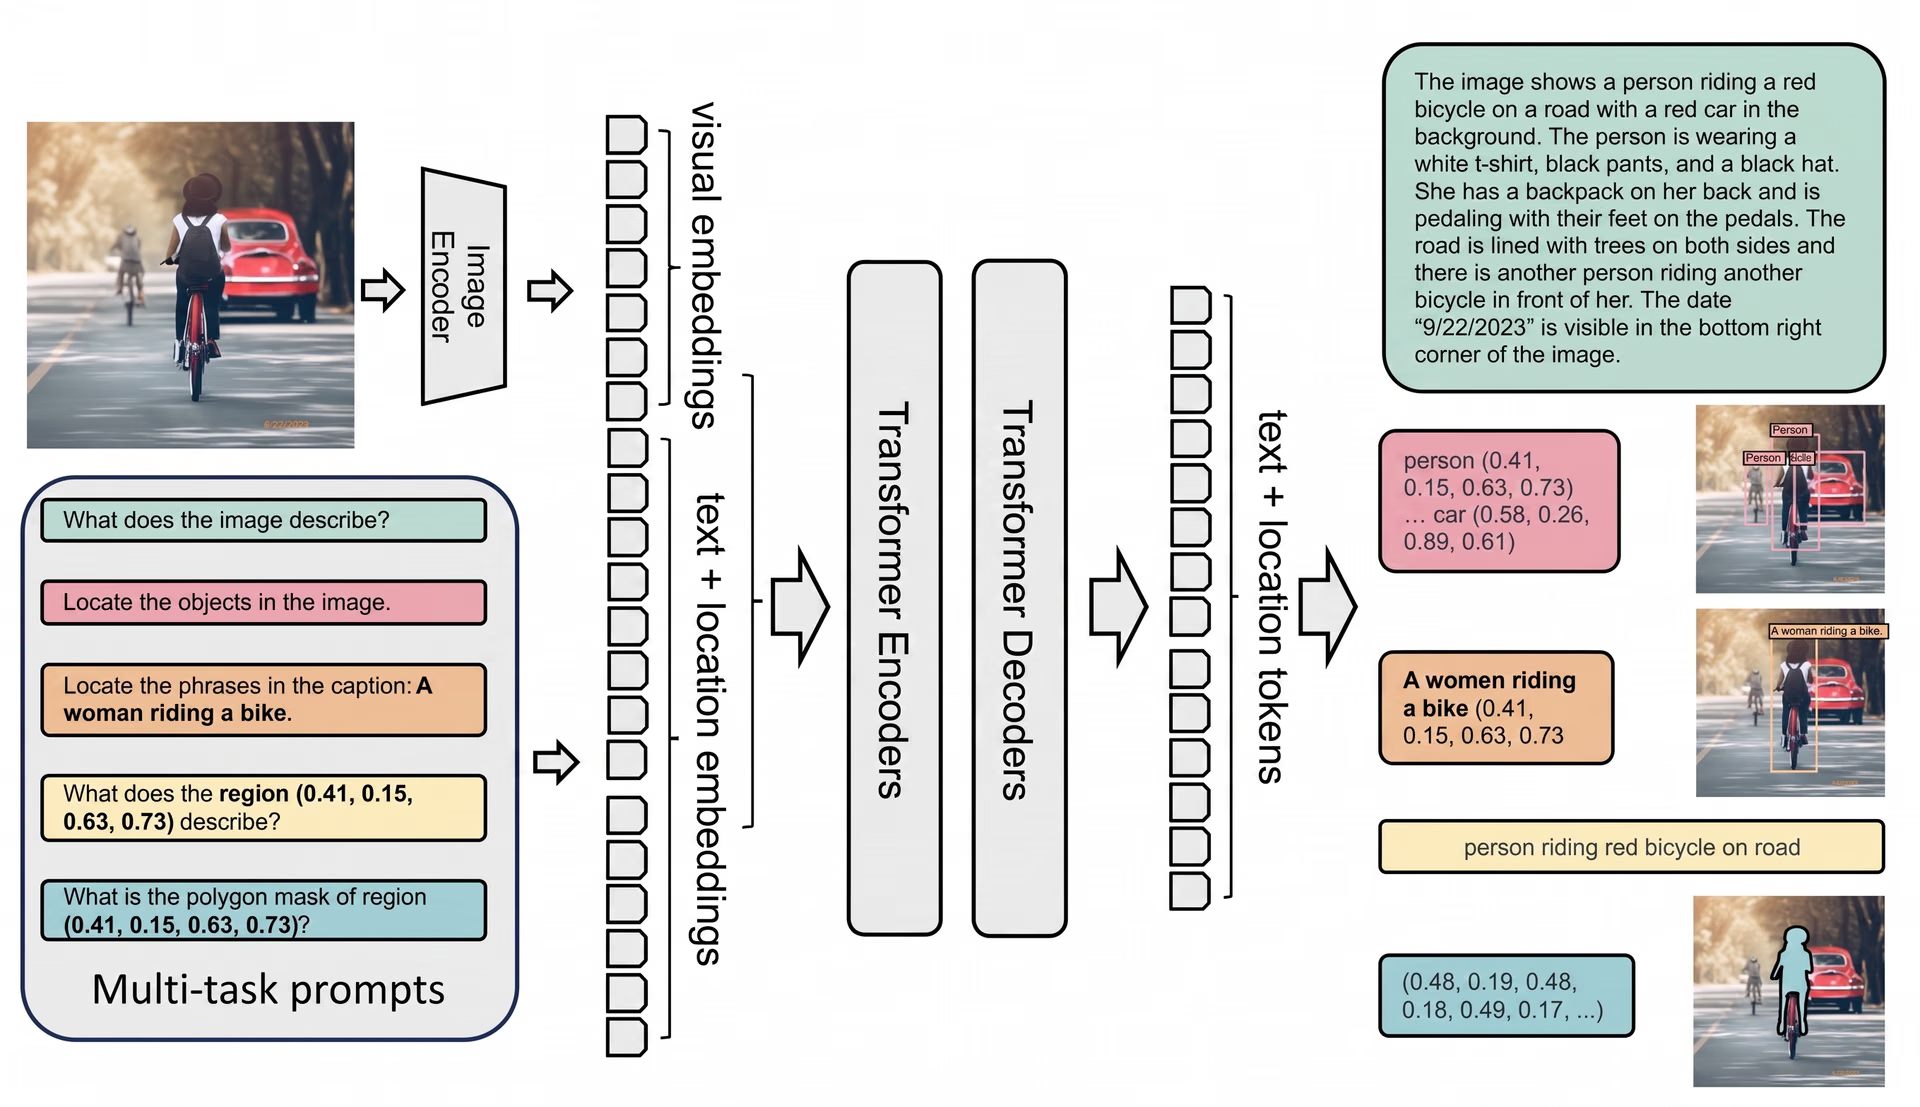
图 3:Florence-2 视觉语言模型架构。
模型架构的核心是一个多模态编码器-解码器 Transformer,它结合了图像编码器和多模态编码器-解码器。图像编码器名为 DaViT(双重注意力视觉 Transformer),它会处理输入图像,将其转换为视觉 token 嵌入——这是图像的紧凑表示,可捕捉空间信息(事物的位置)和语义信息(事物的内容)。随后,这些视觉 token 会与文本嵌入(文本的表示)结合,让模型能够融合文本和视觉数据。
Florence-2 与其他 VLM 的比较#
Florence-2 凭借强大的零样本能力,在其他视觉语言模型中脱颖而出。与依赖大量微调来适应各种任务的 PaliGemma 等模型不同,Florence-2 开箱即用且表现出色。此外,Florence-2 能与 GPT-4V 和 Flamingo 等更大型的模型竞争;这些模型通常拥有更多参数,但表现并不总能胜过 Florence-2。例如,尽管 Kosmos-2 的参数量是 Florence-2 的两倍多,Florence-2 的零样本表现仍优于 Kosmos-2。
在基准测试中,Florence-2 在 COCO 图像描述生成和指代表达理解等任务上表现出色。它在COCO 数据集的目标检测和分割任务上胜过 PolyFormer 和 UNINEXT 等模型。对于同时重视性能和资源效率的真实应用来说,它是极具竞争力的选择。你可以在 Ultralytics Platform 上使用 Florence-2 自动标注检测数据集,并在 VLM 排行榜上查看它与其他视觉语言模型的比较结果。
Florence-2 的应用#
Florence-2 可用于娱乐、无障碍、教育等多个行业。下面通过几个示例来进一步了解。
图像描述生成的应用#
当你在流媒体平台上挑选想看的内容时,可能会先阅读电影简介来帮助做决定。如果平台还能提供电影海报的详细描述呢?Florence-2 可以通过图像描述生成来实现这一点,也就是为图像生成描述性文字。Florence-2 能够生成详细的电影海报描述,让视障用户也能更轻松地使用流媒体平台。通过分析海报中的视觉元素,例如人物、场景和文字,Florence-2 可以生成详细描述,传达海报的内容和氛围。下图展示了 Florence-2 能够提供的描述细节。
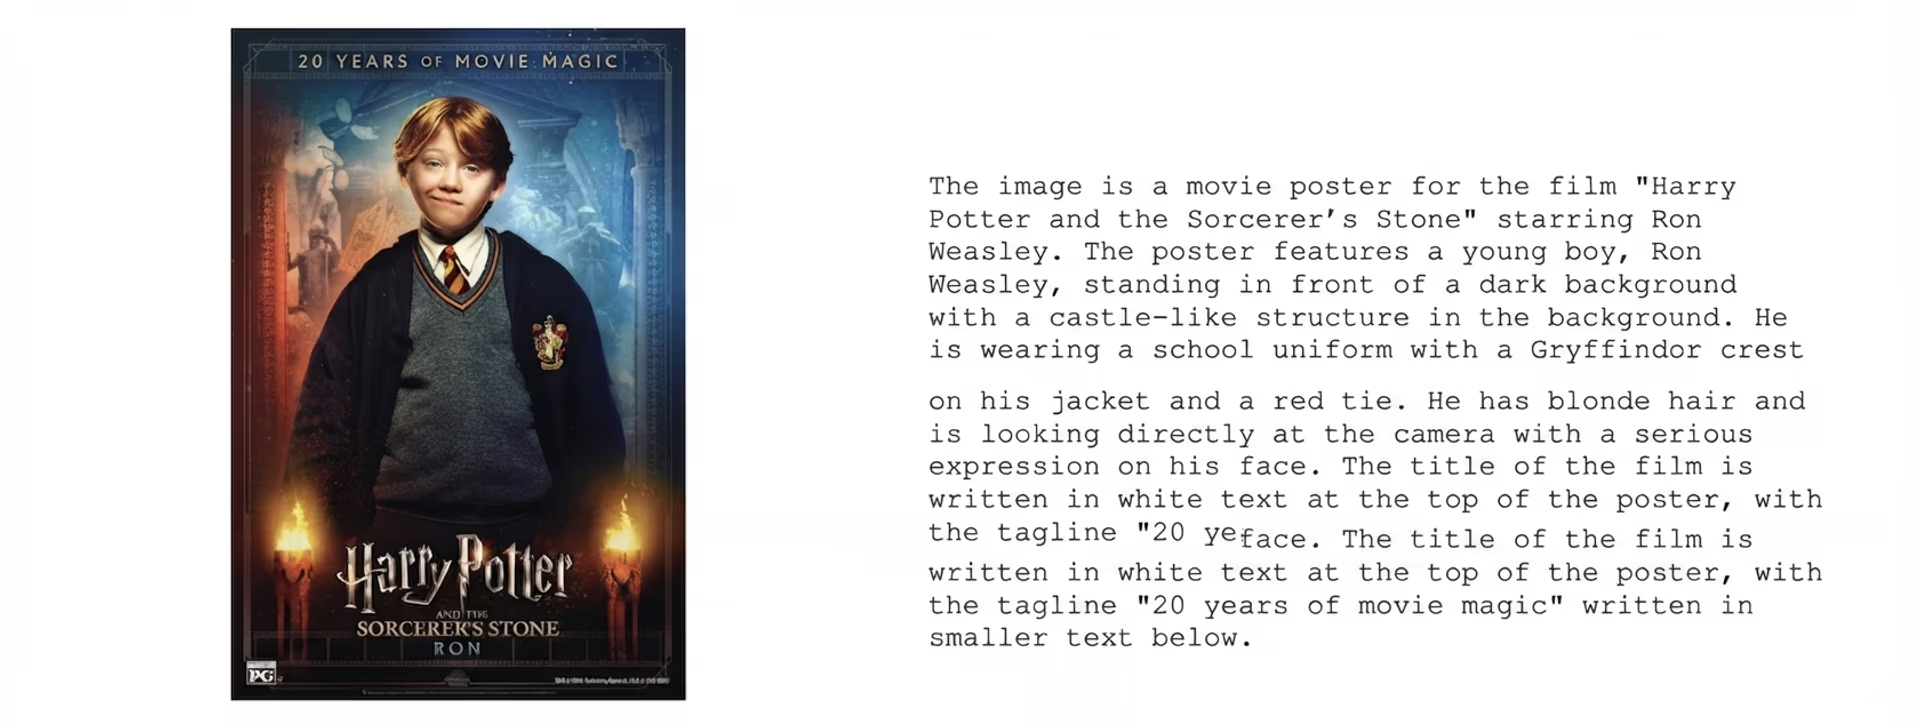
图 4. Florence-2 生成的图像描述示例。
以下是图像描述生成的其他一些实用场景:
- 电子商务:图像描述生成可以为商品图片提供详细说明,帮助客户更清楚地了解商品特性和细节。
- 旅游:它可以在旅游指南和应用中提供地标与景点的详细描述。
- 教育:图像描述生成可以为教育图片和示意图添加标签并进行描述,辅助教学与学习。
- 房地产:它可以详细描述房产图片,突出房屋特色和配套设施,供潜在买家参考。
烹饪时使用视觉定位#
Florence-2 还可用于丰富烹饪体验。例如,在线食谱可以使用 Florence-2 对复杂的食谱图片进行视觉定位并添加标签。视觉定位通过将图像的特定部分与对应的描述性文字关联起来发挥作用。每种食材和每个步骤都能得到准确的标注和说明,让家庭厨师更容易按照食谱操作,并了解每种食材在菜肴中的作用。
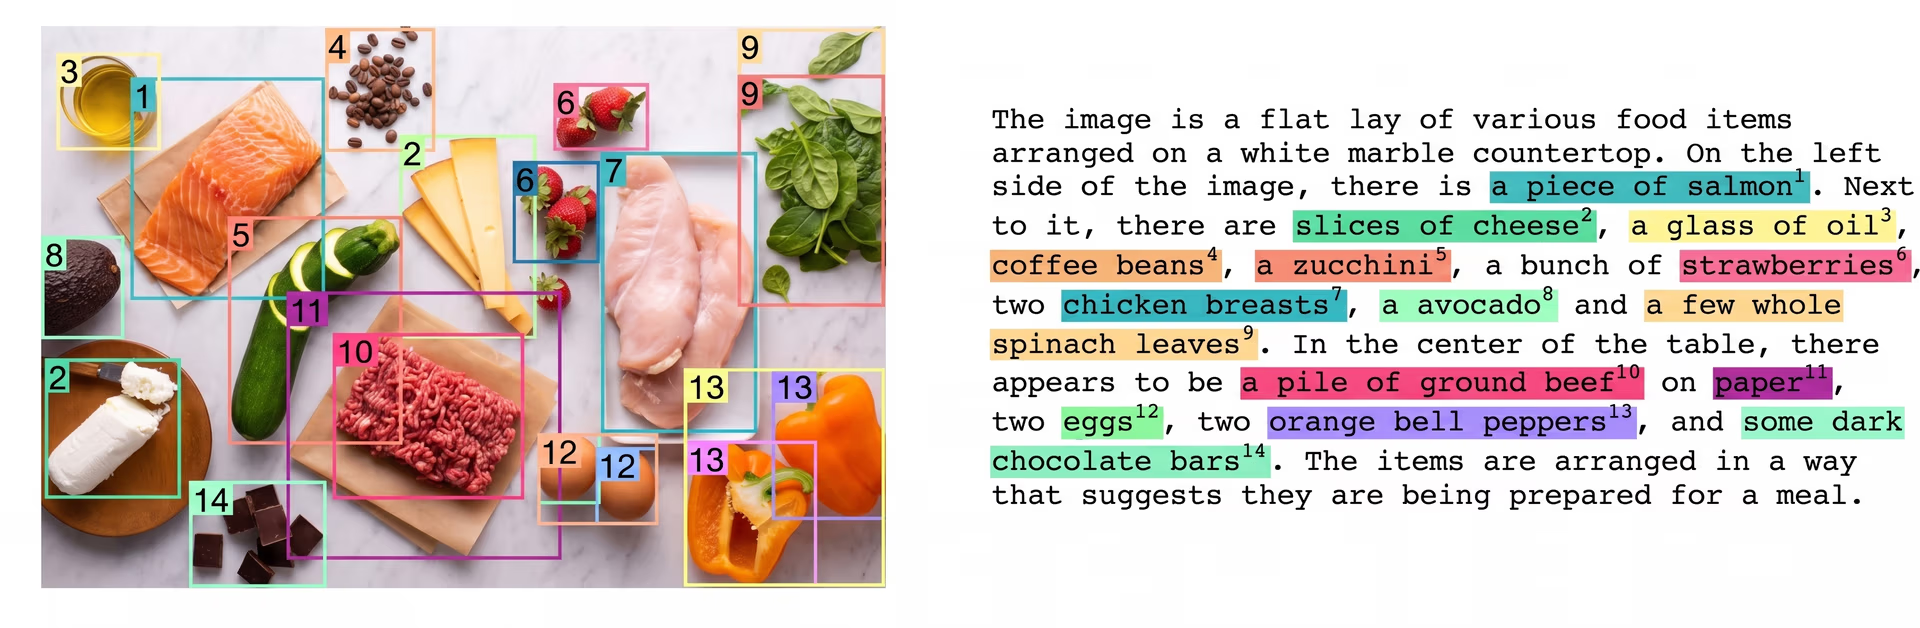
图 5. 使用 Florence-2 进行视觉定位的示例。
金融文档的基于区域的 OCR#
基于区域的 OCR 会从文档中的特定区域提取文本,在会计等领域非常实用。它可以分析金融文档中的指定区域,自动提取交易详情、账号和到期日等重要信息。它减少了人工录入数据的需求,从而降低错误率并加快处理速度。金融机构可以用它简化发票处理、收据对账和支票清算等任务,从而加快交易速度并改善客户服务。
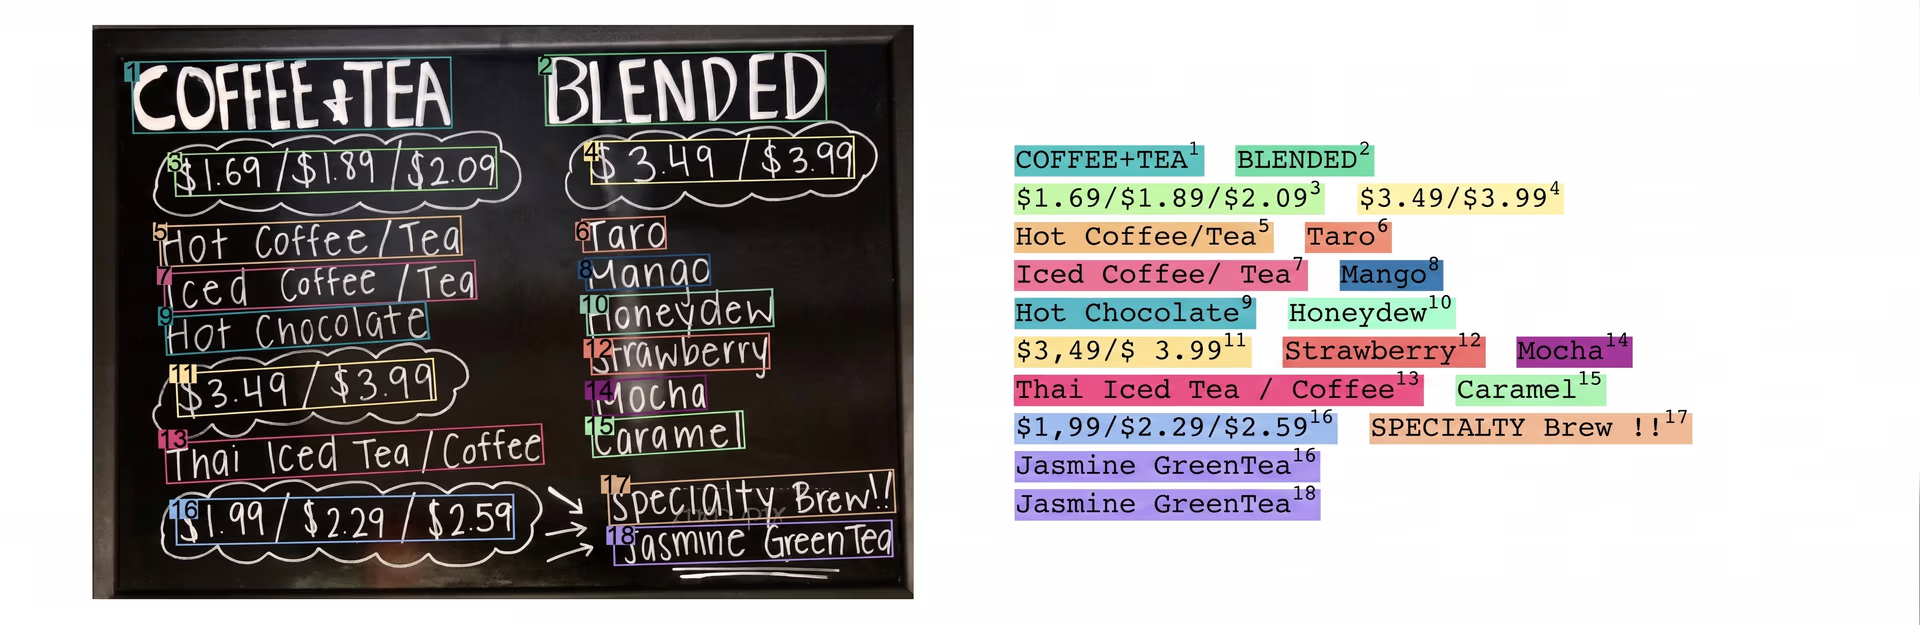
图 6. 使用 Florence-2 通过区域提取 OCR 文本的示例。
工业应用中的基于区域的分割#
基于区域的分割会将图像划分为有意义的部分,以便有针对性地分析和详细检查。它可以推动工业应用的发展,提升各种流程的精度和效率。通过聚焦图像中的特定区域,这项技术可以详细检查和分析零件与产品。在质量控制方面,它可以识别材料中的缺陷或不一致,例如裂纹或错位,确保只有优质产品进入市场。
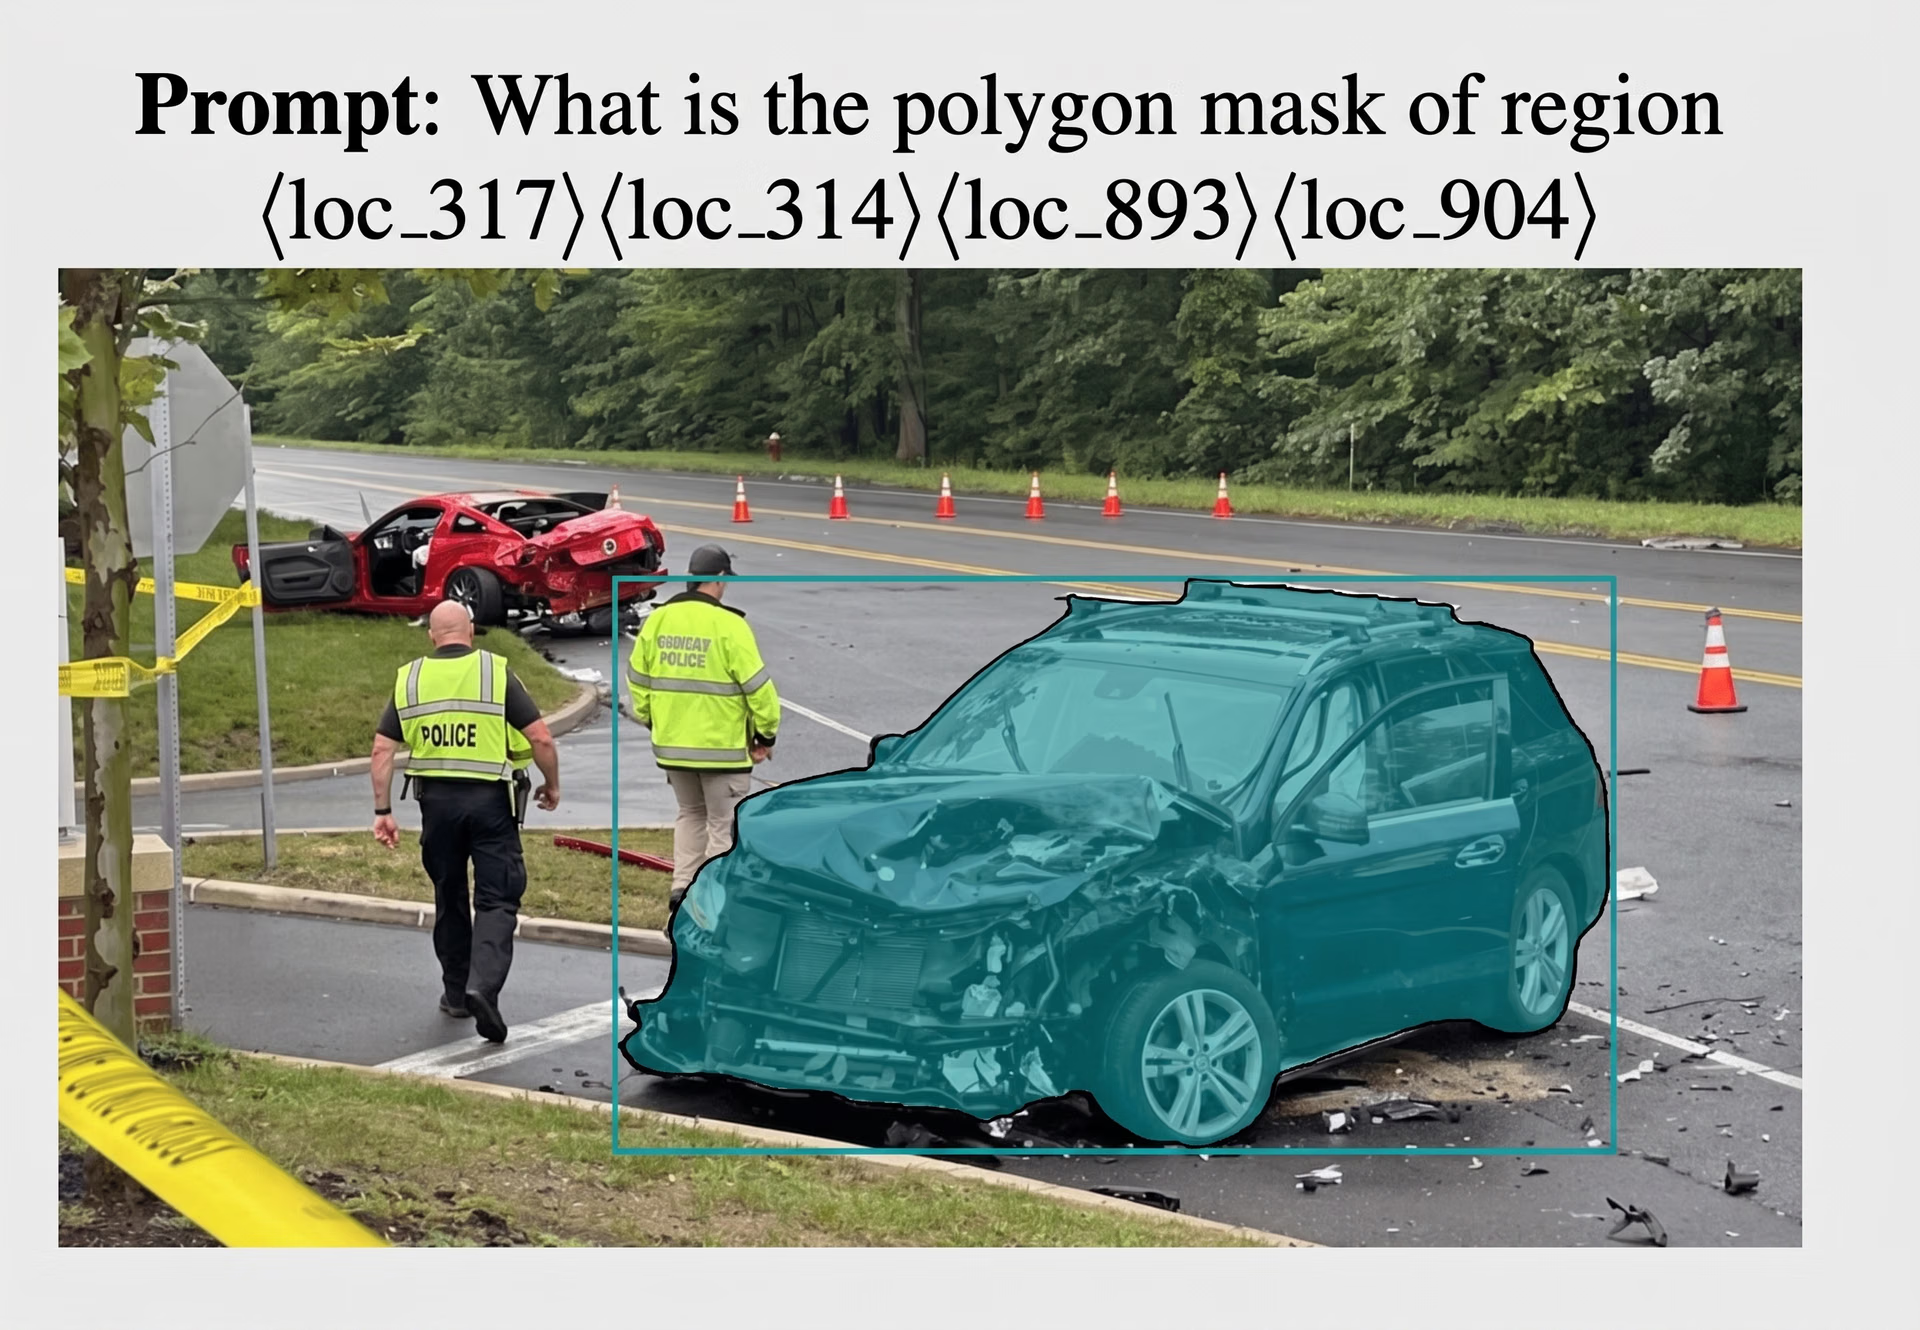
图 7. 使用 Florence-2 进行基于区域分割的示例。
它还能改进自动化装配线,引导机器人机械臂移动到特定部件,并优化零件的摆放和装配。同样,在库存管理中,它可以帮助跟踪和监控货物的状态与位置,从而提高物流效率并减少停机时间。总的来说,基于区域的分割能够提高工业环境中的准确性和生产力,降低成本并提升产品质量。
要点#
我们开始看到一种趋势:AI 模型在保持高性能的同时变得更加轻量。Florence-2 标志着视觉语言模型取得了重大进展。它凭借出色的零样本性能,可处理目标检测、分割、图像描述生成和定位等多种任务。尽管尺寸更小,Florence-2 依然高效且多功能,因此适用于各行各业的应用。Florence-2 这样的模型正带来更多可能性,拓展 AI 创新的潜力。
访问我们的 GitHub 代码仓库并加入我们的社区,进一步探索 AI。查看我们的解决方案页面,了解 AI 在制造业和农业中的应用。
作者
评论
提出问题、分享你的结果,或帮助其他人。









