认识 Meta 的 Llama 3
了解 Meta 的 Llama 3:这款于 2024 年 4 月发布的开放权重 LLM,包含 8B 和 70B 版本,并介绍其架构、大规模训练和基准测试结果。
 Abirami Vina6 分钟阅读
在回顾2024 年第一季度人工智能 (AI) 创新时,我们看到不同组织接连发布了 LLM,也就是大语言模型。延续这一趋势,Meta 于 2024 年 4 月 18 日发布了新一代先进开源 LLM Llama 3。
你可能会想:这不过是又一个 LLM。AI 社区为什么这么兴奋?
虽然你可以微调 GPT-3 或 Gemini 等模型来生成定制化回复,但这些模型不会完全公开其内部运作机制,例如训练数据、模型参数或算法。相比之下,Meta 的 Llama 3 更加透明,其架构和权重都可以下载。对 AI 社区来说,这意味着有更大的实验自由。
本文将介绍 Llama 3 的功能、它的诞生过程,以及它对 AI 领域的影响。
Meta Llama 模型的演进#
深入了解 Llama 3 之前,我们先回顾一下它的早期版本。
Meta 于 2023 年 2 月推出了 Llama 1,该模型有四种变体,参数量从 70 亿到 650 亿不等。在机器学习中,“参数”指模型从训练数据中学习得到的元素。由于参数量较少,Llama 1 有时难以理解细微差别,回答也不够稳定。
Llama 1 发布后不久,Meta 于 2023 年 7 月推出了 Llama 2。它使用 2 万亿个 token 进行训练。token 是一段文本,例如一个词或词的一部分,是模型处理数据时使用的基本单位。该模型还进行了改进,例如将上下文窗口扩大一倍至 4096 个 token,以便理解更长的文本,并采用了超过 100 万条人工标注来减少错误。尽管有这些改进,Llama 2 仍需要大量计算资源,Meta 希望通过 Llama 3 解决这一问题。
认识 Meta 的 Llama 3#
Llama 3 有四种变体,训练所用的 token 数量高达 15 万亿。其中超过 5% 是覆盖 30 多种语言的高质量非英语数据。所有 Llama 3 变体都能在多种消费级硬件上运行,并且上下文长度为 8k token。
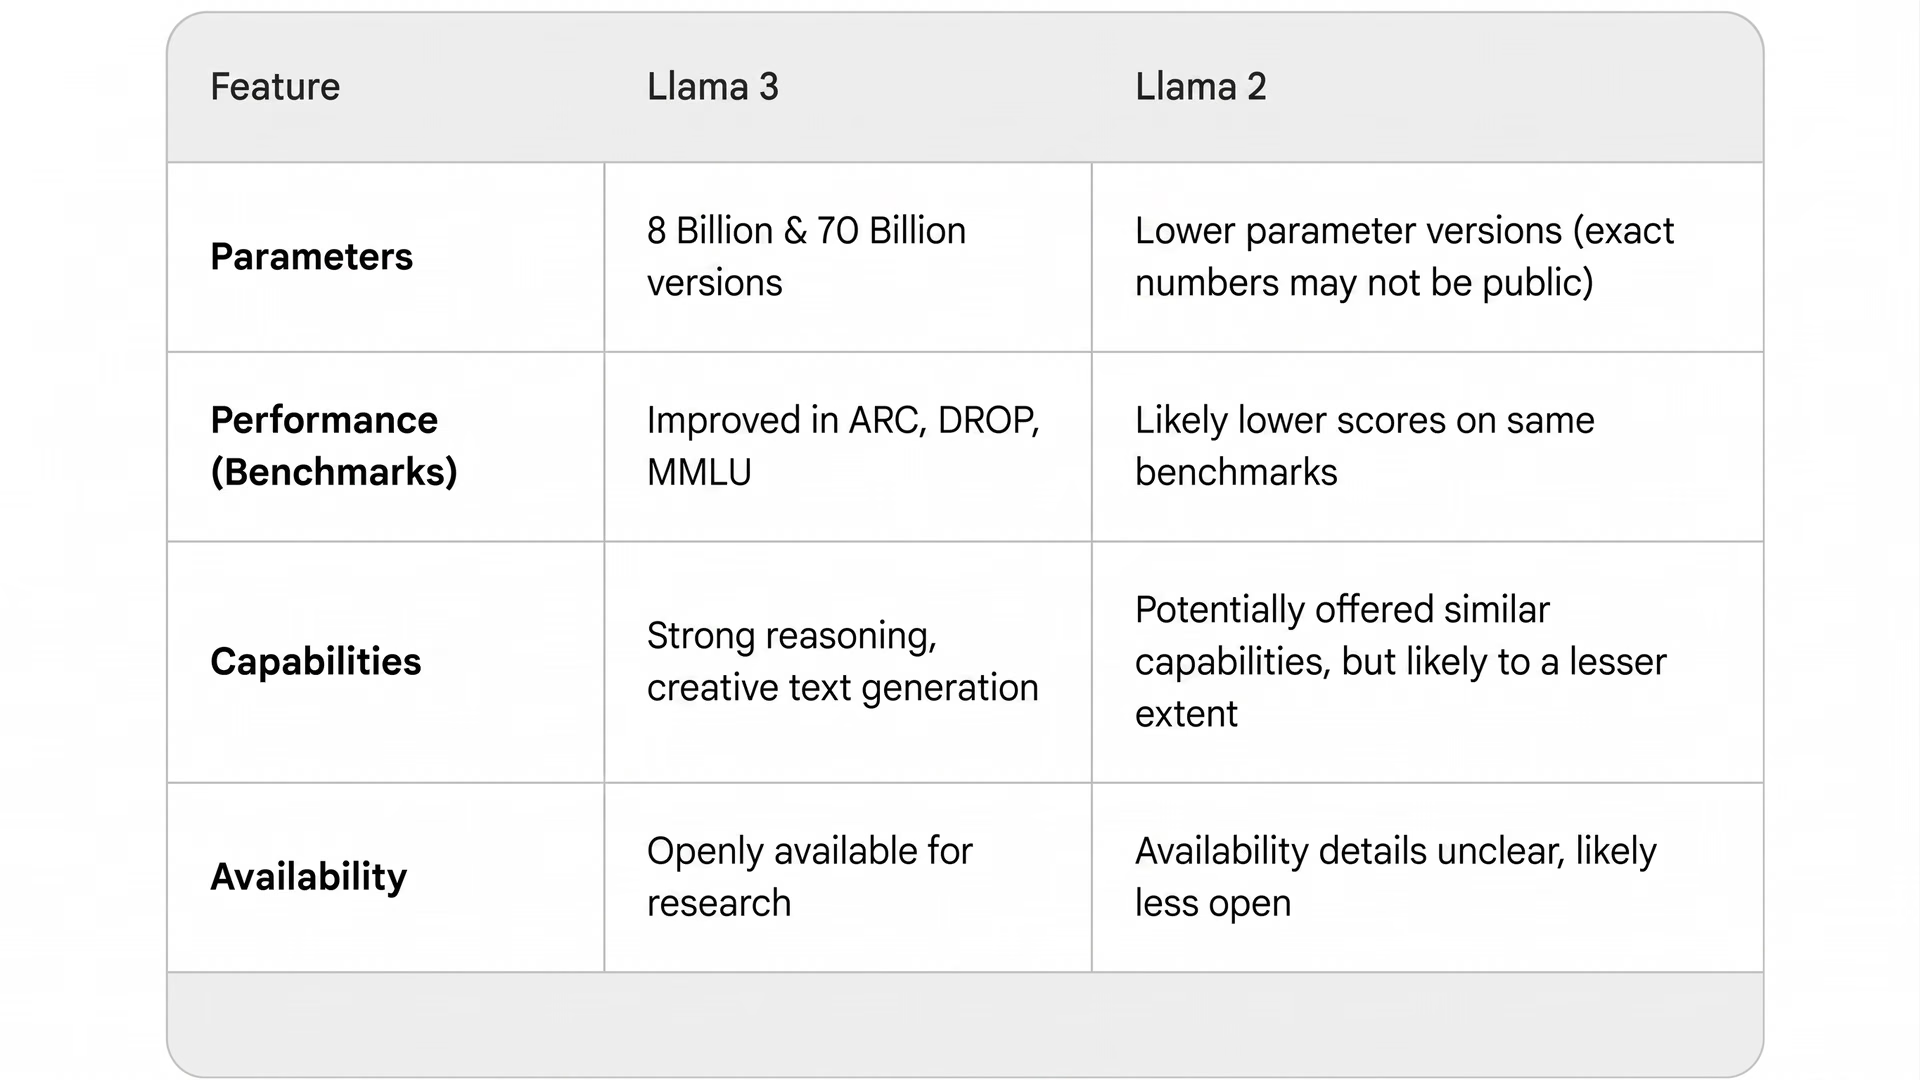
图 1. Llama 3 与 Llama 2 对比。
模型变体分为两种规模:8B 和 70B,分别表示 80 亿和 700 亿个参数。此外,模型还有两个版本:base 和 instruct。“Base”指标准预训练版本。“Instruct”则是经过微调以遵循指令、并针对对话用例优化的版本。
以下是 Llama 3 的模型变体:
- Meta-Llama-3-8b:基础版 8B 模型提供基本的 AI 能力,适合开发客服聊天机器人等通用任务。
- Meta-Llama-3-8b-instruct:这是经过指令微调的 8B 模型,针对特定任务进行了优化。例如,它可以用于创建能够讲解复杂主题的教育工具。
- Meta-Llama-3-70b:基础版 70B 模型专为高性能 AI 应用打造。它适用于处理大量生物医学文献等应用,助力药物研发。
- Meta-Llama-3-70b-instruct:此版本基于 70B 模型进行微调,适用于法律或医疗文档分析等对精确度要求极高的场景。
Meta 的 Llama 3 模型架构#
与 Meta 的其他 AI 进展一样,Llama 3 的开发过程实施了严格的质量控制措施,以维护数据完整性并尽量减少偏见。因此,最终打造出了一个强大的模型,并且其开发过程秉持负责任的原则。
Llama 3 模型架构的突出特点,是在自然语言处理任务中兼顾效率与性能。它基于 Transformer 架构,采用仅解码器架构,尤其注重提升文本生成过程中的计算效率。
该模型只根据前文上下文生成输出,无需单独的编码器,因此文本生成效率更高。
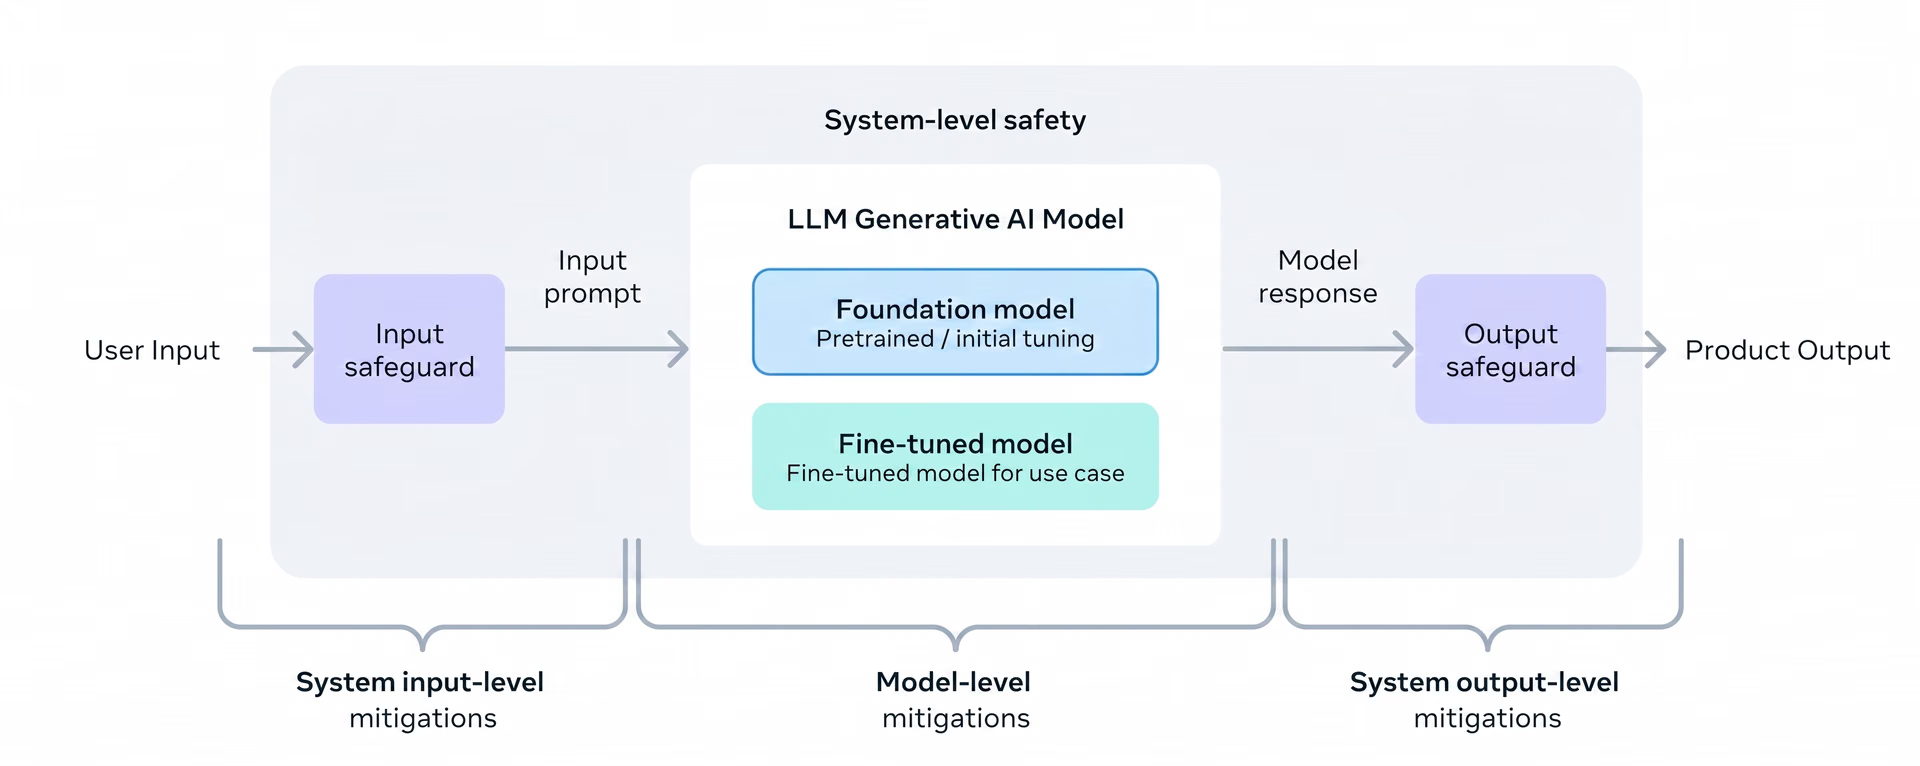
图 2. Llama 3 负责任的模型架构。
Llama 3 模型采用了词汇量为 128K 个 token 的分词器。词汇量越大,模型就越能准确理解和处理文本。此外,模型现在还使用分组查询注意力(GQA)来提高推理效率。GQA 让多个注意力头组共享相同的键和值,从而减少内存占用,并在质量损失很小的情况下加快文本生成。
以下是 Llama 3 模型架构的其他一些有趣细节:
- 边界感知文档处理:Llama 3 能够在不同文档的边界处保持清晰区分,这对摘要生成等任务至关重要。
- 更强的代码理解能力:Llama 3 的训练数据中包含的代码样本是之前的四倍,提升了模型的编程能力。
- 严格的质量控制:通过启发式过滤和 NSFW 内容移除等严格措施,确保数据完整性并尽量减少偏见。
Llama 3 正在改变我们的模型训练方式#
为了训练规模最大的 Llama 3 模型,团队结合了三种并行化方式:数据并行、模型并行和流水线并行。
数据并行会将训练数据分配到多块 GPU 上;模型并行则会划分模型架构,以利用每块 GPU 的计算能力。流水线并行会将训练过程划分为按顺序执行的阶段,从而优化计算和通信。
最高效的实现实现了很高的计算利用率:在 16,000 个 GPU 上同时训练时,每个 GPU 的性能超过 400 TFLOPS。这些训练任务在两个定制 GPU 集群上进行,每个集群都包含 24,000 个 GPU。如此庞大的计算基础设施为高效训练大规模 Llama 3 模型提供了必要算力。
为了最大限度地提高 GPU 利用率,团队开发了全新的高级训练技术栈,自动处理错误检测、故障处理和维护。团队还大幅改进了硬件可靠性和检测机制,以降低静默数据损坏的风险。此外,团队还开发了新的可扩展存储系统,以减少检查点保存和回滚的开销。
这些改进使有效训练时间超过 95%。综合来看,与 Llama 2 相比,Llama 3 的训练效率提高了约三倍。这种效率为 AI 训练方法带来了新的可能性。
借助 Llama 3 开启新可能#
由于 Llama 3 是开源的,研究人员和学生可以研究其代码、开展实验,并讨论伦理问题和偏见。不过,Llama 3 并非只适用于学术群体,它也用于实际应用。它正成为 Meta AI 聊天界面的核心,并集成到 Facebook、Instagram、WhatsApp 和 Messenger 等平台中。借助 Meta AI,用户可以用自然语言交流、获取个性化推荐、执行任务,并轻松与他人联系。
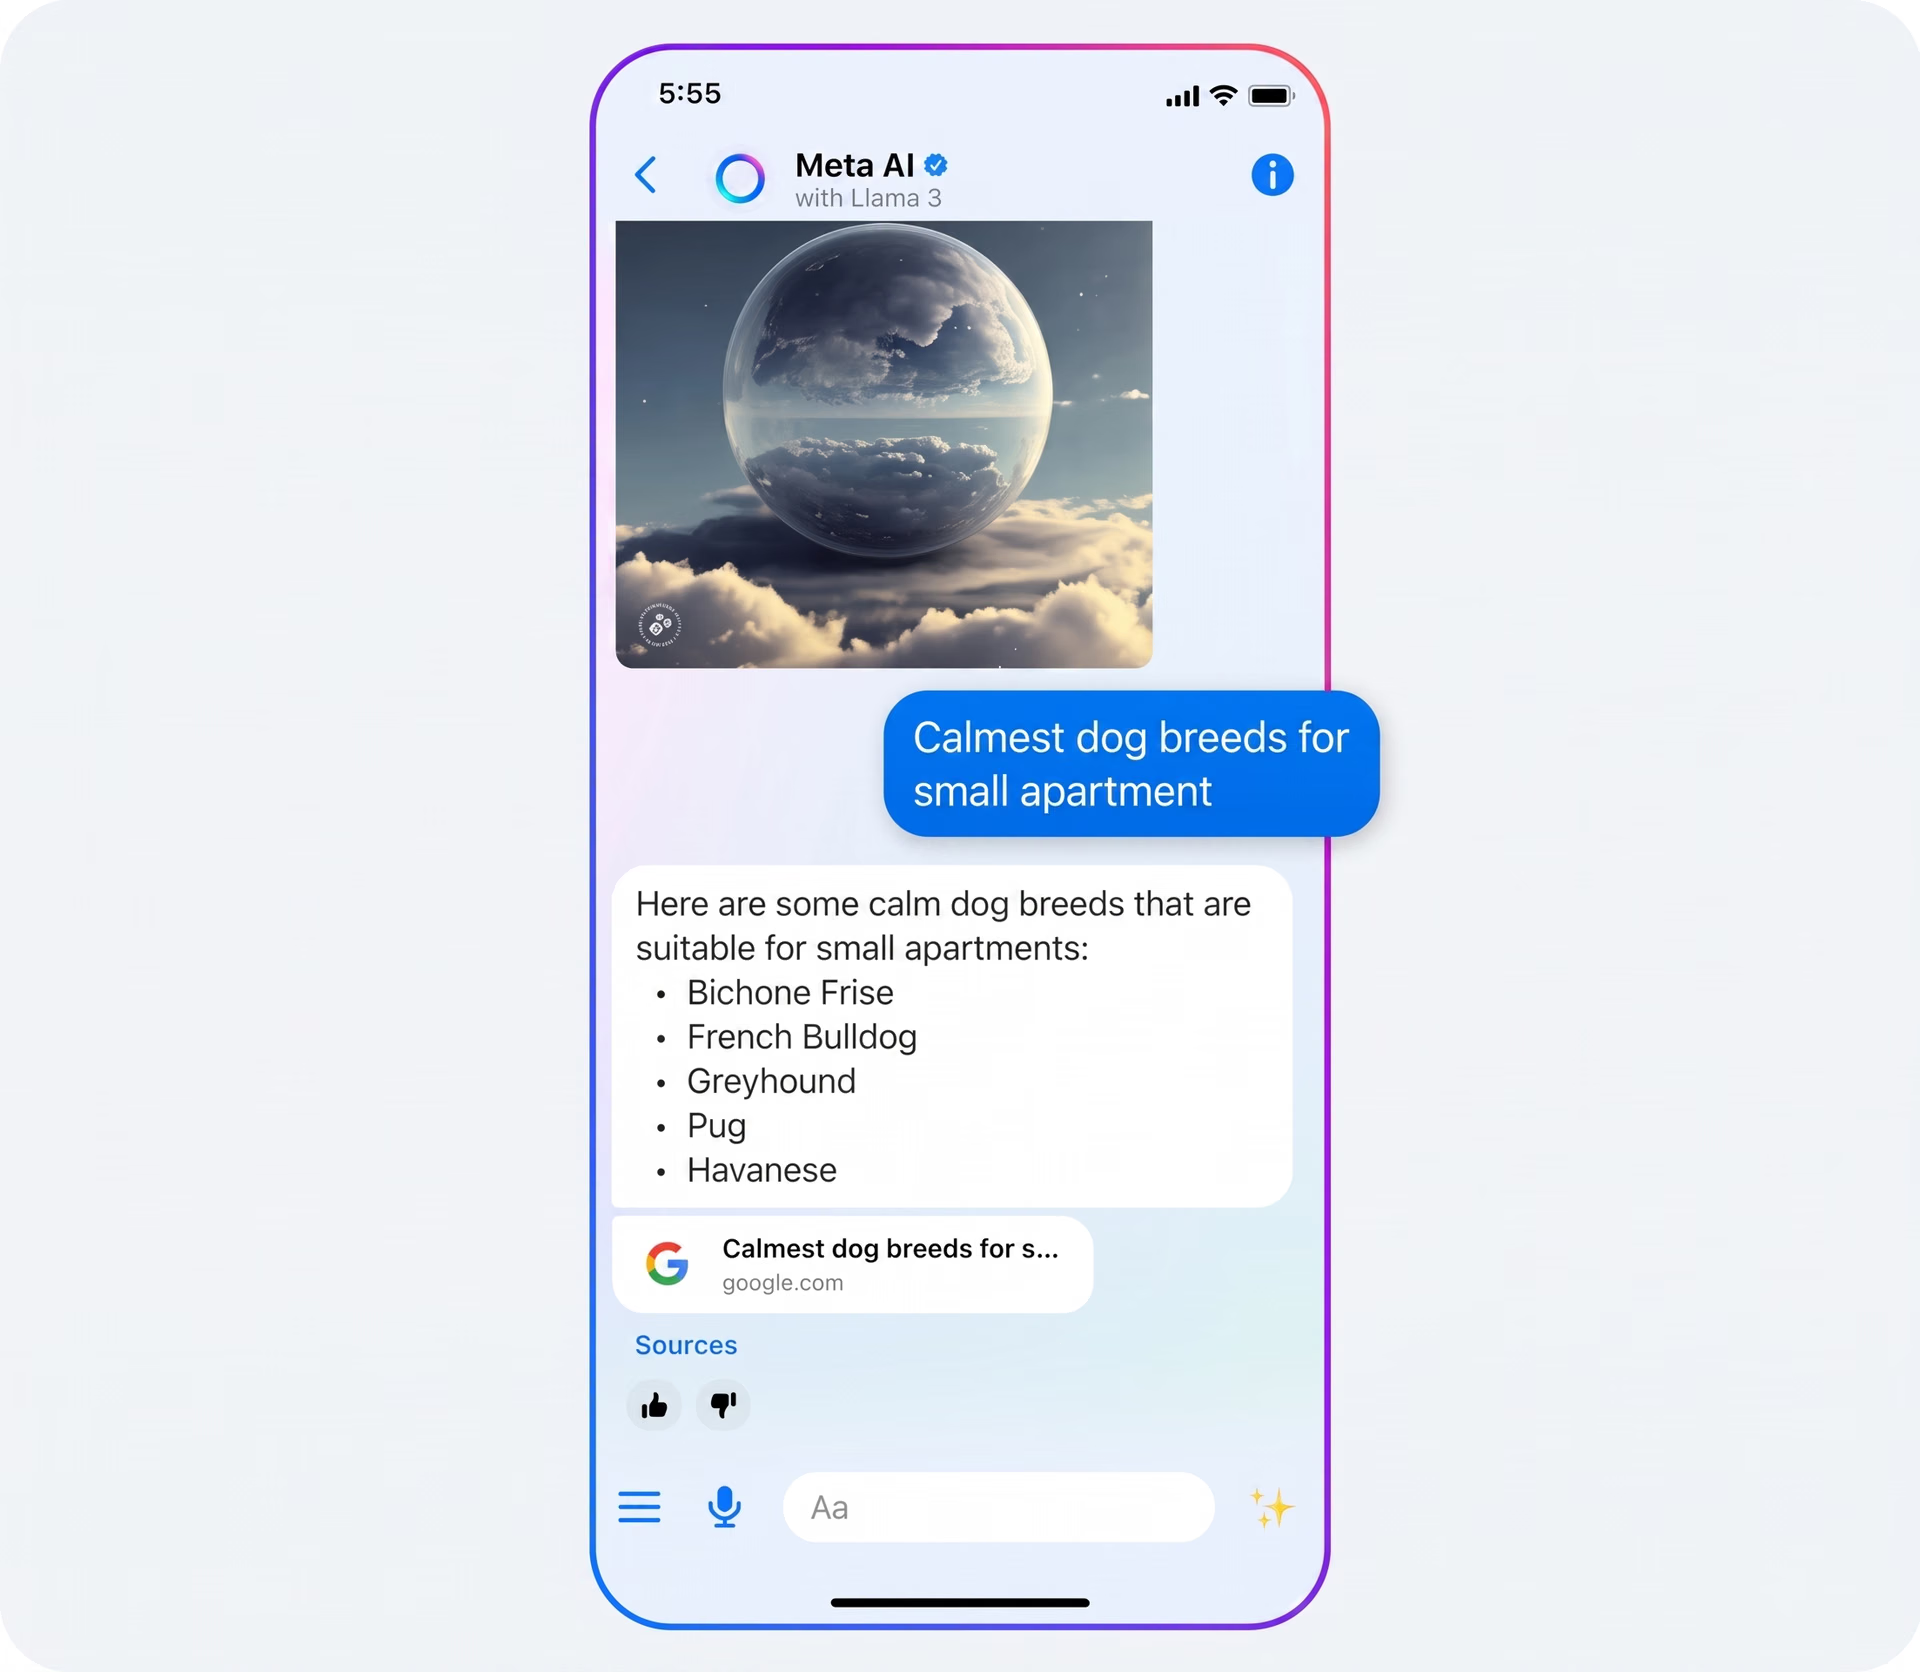
图 3. Meta AI:由 Llama 3 驱动。
将 Llama 3 与其他 LLM 进行比较#
Llama 3 在多项关键基准测试中表现出色,这些测试评估复杂的语言理解和推理能力。以下是用于检验 Llama 3 不同能力的部分基准测试:
- 大规模多任务语言理解(MMLU)——衡量模型在不同领域的知识水平。
- 研究生水平的 Google 防作弊问答(GPQA)——评估模型回答生物、物理和化学领域高难度研究生水平问题的能力。
- HumanEval——专注于编程和问题解决任务,测试模型生成可运行代码和解决算法挑战的能力。
Llama 3 在这些测试中的出色成绩使其明显优于 Google 的 Gemma 7B、Mistral 的 Mistral 7B 和 Anthropic 的 Claude 3 Sonnet 等竞争模型。根据已发布的统计数据,尤其是 70B 模型,Llama 3 在上述所有基准测试中都胜过这些模型。
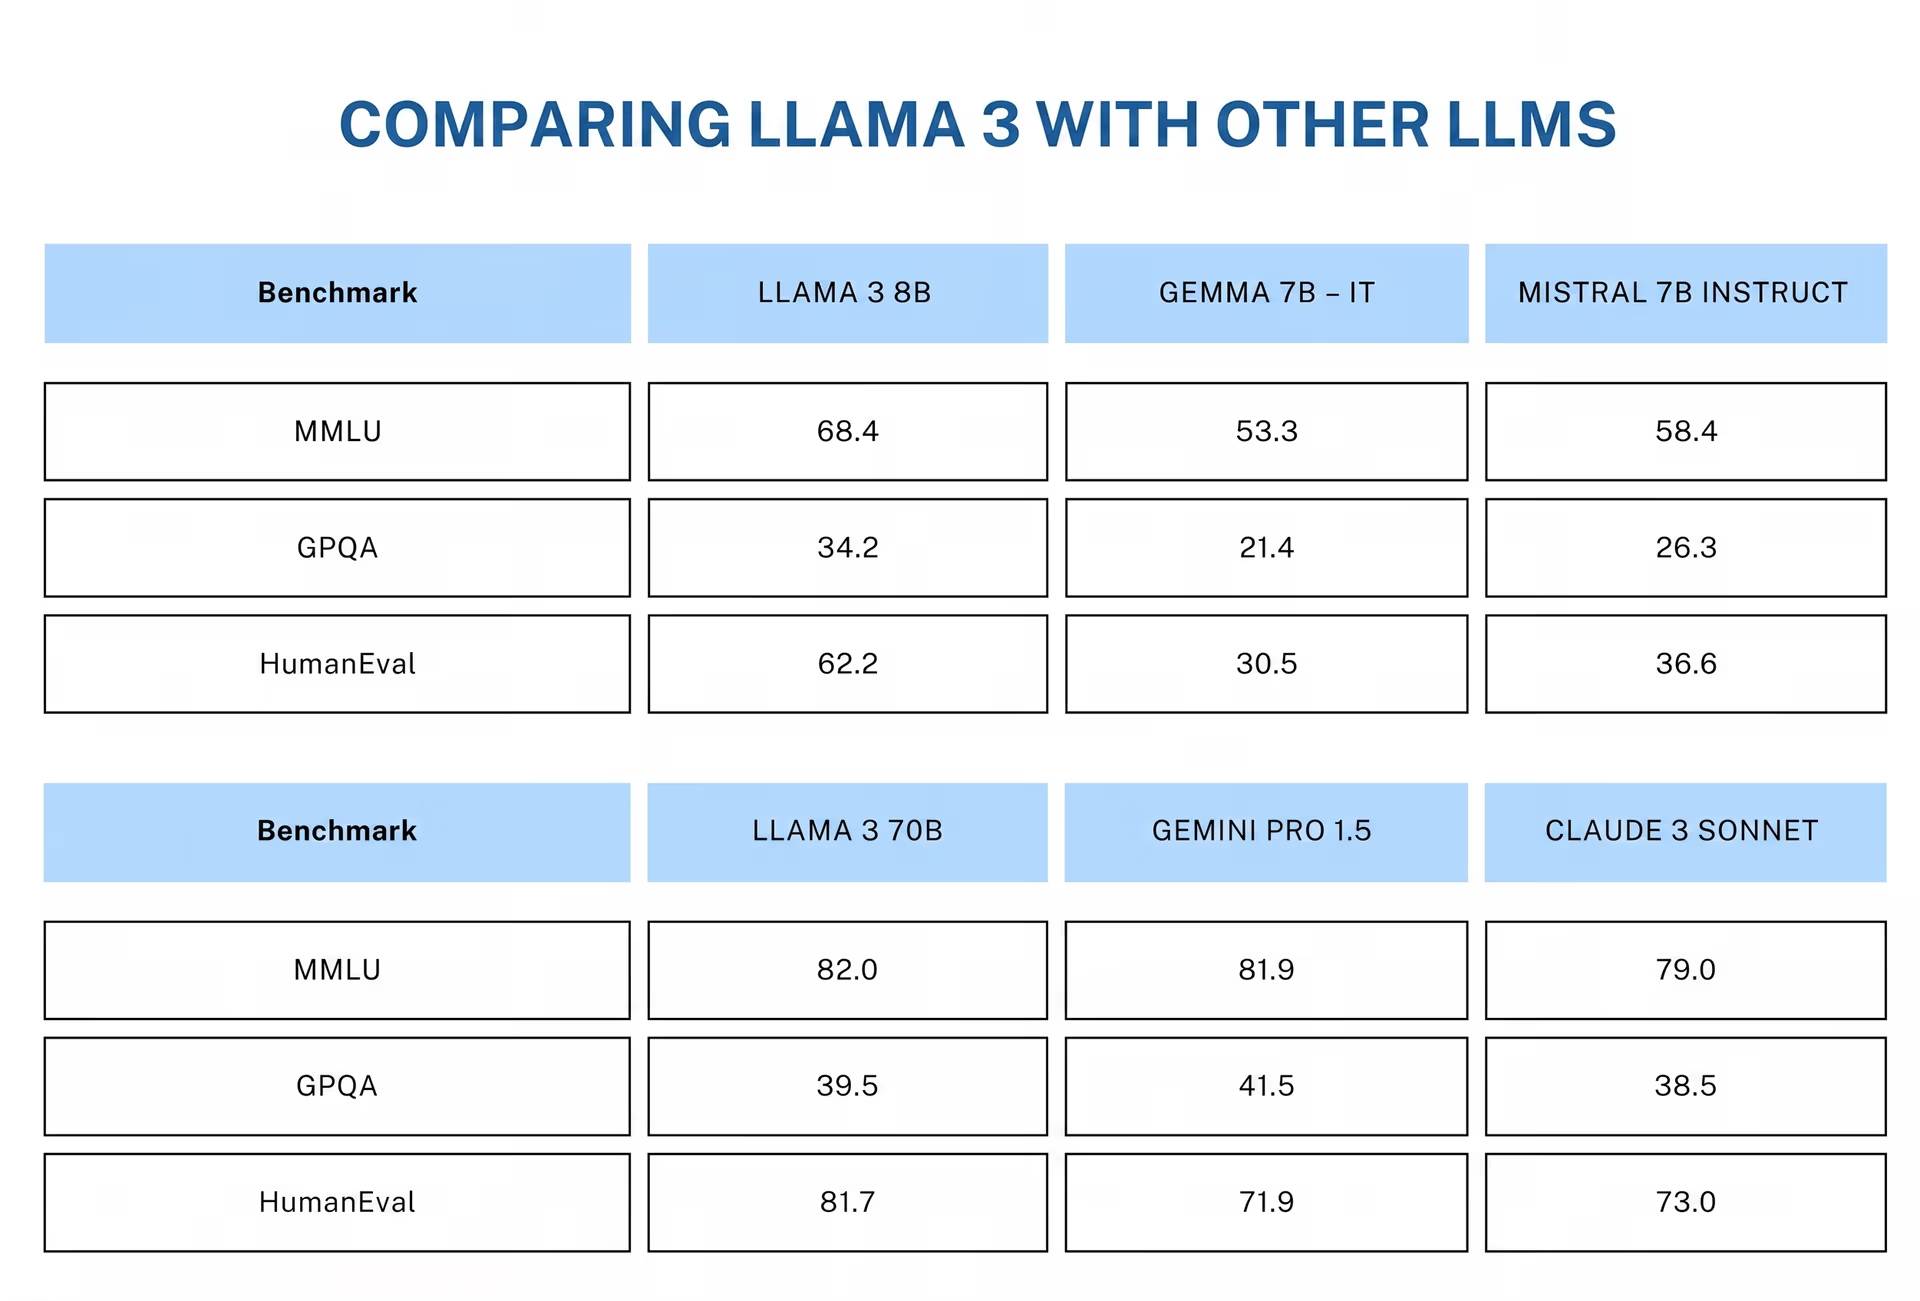
图 4. Llama 3 与其他 LLM 的比较。
Meta 正在让更多人使用 Llama 3#
Meta 正在将 Llama 3 推向更多平台,面向普通用户和开发者提供服务。对于日常用户,Llama 3 已集成到 WhatsApp、Instagram、Facebook 和 Messenger 等 Meta 热门平台中。用户可以直接在这些应用中使用实时搜索和创意内容生成等高级功能。
Llama 3 还将集成到 Ray-Ban Meta 智能眼镜和 Meta Quest VR 头显等可穿戴技术产品中,带来交互式体验。
开发者可以在多个平台上使用 Llama 3,包括 AWS、Databricks、Google Cloud、Hugging Face、Kaggle、IBM WatsonX、Microsoft Azure、NVIDIA NIM 和 Snowflake。你也可以直接从 Meta 获取这些模型。丰富的平台选择让开发者可以轻松地将这些先进 AI 模型的能力集成到自己的项目中,无论是直接使用 Meta 的服务,还是通过其他热门平台。
要点总结#
机器学习的进步持续改变着我们每天与技术互动的方式。Meta 的 Llama 3 表明,LLM 已不再只是生成文本。LLM 正在解决复杂问题并处理多种语言。总的来说,Llama 3 让 AI 比以往更加灵活、更易使用。展望未来,Llama 3 的计划升级将带来更多能力,例如多模态支持和更长的上下文窗口。
查看我们的 GitHub 代码库,加入我们的社区,了解更多 AI 相关信息。访问我们的解决方案页面,了解 AI 如何应用于制造业和农业等领域。
作者
评论
提出问题、分享你的结果,或帮助其他人。









