了解为什么人在环路标注至关重要
了解人工标注数据如何提升计算机视觉模型的准确性,以及为什么人类专业知识对于构建可靠的视觉 AI 系统仍然不可或缺。
 Abirami Vina7 分钟阅读
二十年前,如果有人说自己正考虑买个机器人来帮忙做家务,听起来会非常不切实际。不过,如今我们正处于 AI 热潮之中,机器人也正在类似的场景中接受测试。
推动这一进步的一项关键 AI 技术是计算机视觉,它赋予机器理解图像和视频的能力。换句话说,Ultralytics YOLO11和更新的 Ultralytics YOLO26等计算机视觉模型,可以使用包含视觉数据和标注的数据集进行训练。
这些标注能帮助模型理解视觉数据。例如,目标检测数据集会使用边界框,在感兴趣的物体周围画出矩形。这使模型能够在新图像中检测并定位这些物体,即使场景杂乱或物体部分被遮挡也不例外。
其他计算机视觉任务依赖不同类型的标注。分割数据集会在像素级标注物体的精确轮廓,而关键点数据集则会标记特定的关键位置,例如人体关节。
然而,在所有这些格式中,标签的质量和一致性都是至关重要的因素。模型直接从训练数据中学习,因此如果标签不一致或有误,模型通常会在预测中重现这些错误。
即使有自动化技术,在医学影像等高风险领域,人工标注的数据集仍然至关重要。细微的标注错误,例如肿瘤边界不准确或漏掉异常,都可能让模型学到错误的模式,并在之后做出不安全的预测。人类专家能够提供这些应用所需的准确基准真值和判断。
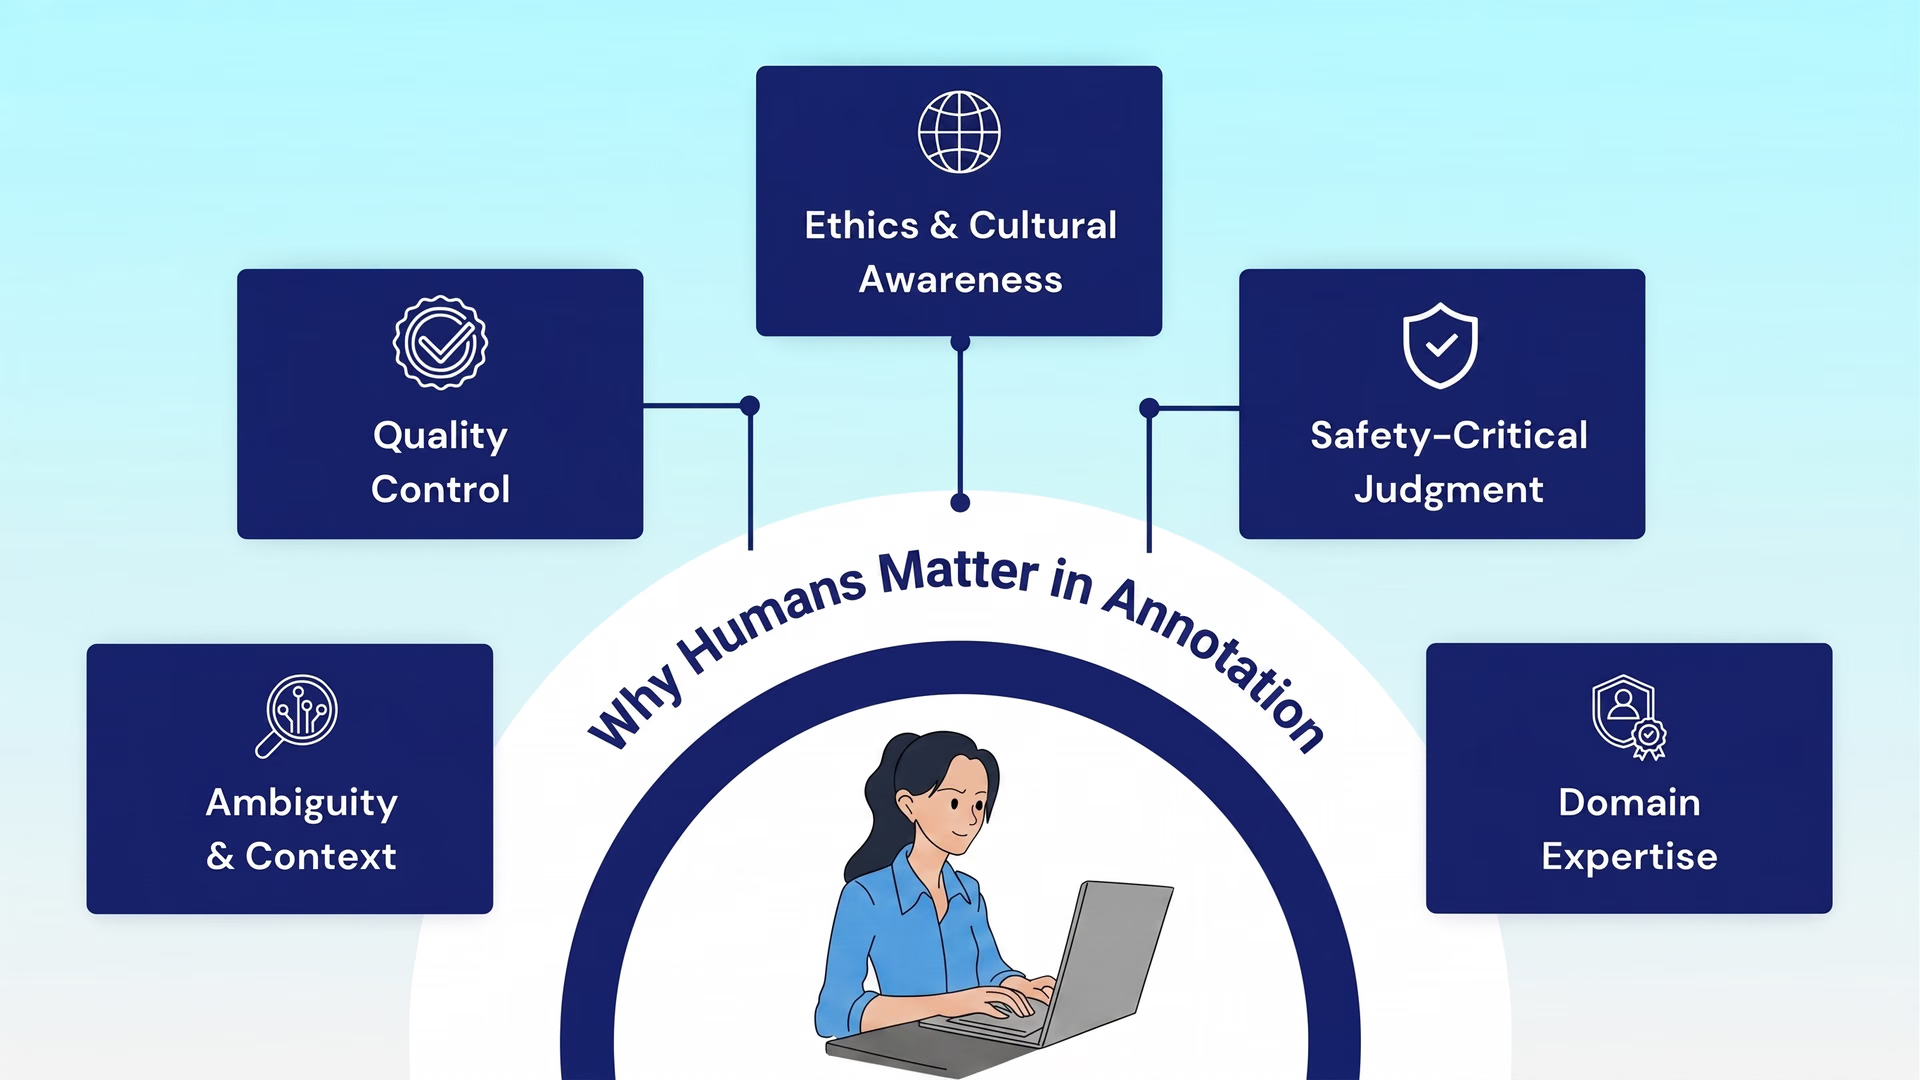
图 1. 人工标注的数据集不可或缺。图片由作者提供。
本文将深入探讨,即使 AI 持续发展,人工标注的数据为何仍不可或缺。
图像和视频标注的必要性#
计算机视觉模型的学习方式与我们很相似,也是通过观察大量样本来学习。不同之处在于,它们通过训练大型图像数据集和视频来学习,而这些数据集和视频事先由人类进行标注。这些标签充当基准真值,教会模型诸如“这是行人”“这是肿瘤边界”或“那个物体是汽车”等信息。
现实世界中的视觉内容很少干净或一致。光照可能发生变化,让同一个物体看起来有所不同。人和车辆可能相互重叠,或被部分遮挡。背景可能杂乱且令人分心。如果数据集在这些情况下都包含细致、一致的标注,模型就能更好地应对受控环境之外的实际情况。
数据标注也不只是画框或描摹轮廓。它还涉及应用标注指南,并对哪些内容算作目标、目标边界应在哪里,以及遇到不明确的情况时该如何处理做出实际判断。这种人工判断能让数据保持准确且可用。
归根结底,计算机视觉系统的表现取决于它学习所用的标注数据。在扫描图像中发现癌症或为自动驾驶汽车检测道路危险等影响重大的应用中,熟练人员提供的精准标注会切实提升准确性和安全性。
数据标注自动化的兴起#
随着计算机视觉规模扩大、数据集不断增长,自动化已成为加快标注速度的常见方式。团队不再需要手动标注所有内容,而是使用 AI 模型生成初步标签。
然后由人工审核结果、修正错误,并处理模型无法有把握标注的情况。这种方法能在保持高质量的同时加快标注速度。
以下是自动化通常帮助数据标注的几种方式:
- 自动分割:模型可以自动建议物体轮廓或像素级掩码,从而减少标注人员需要手动勾勒的内容。
- 光流跟踪:对于视频,跟踪方法可以跨帧跟随移动目标,并将目标标签延续到后续帧,帮助保持标注的时间一致性。
- 帧插值:工具可以利用运动和跟踪线索,为两帧已标注画面之间的帧补充标签,因此标注人员不必逐帧标注。
- 主动学习:训练流程可以找出模型认为不确定或不寻常的样本,并优先交给人工处理,让人工投入集中在最能提升性能的数据上。
为什么人工数据标注仍然至关重要#
自动化可以加快标注,但 AI 模型仍需要人工判断,才能保持准确和可靠。
以下是人工专业知识能为数据标注带来重要影响的一些关键领域:
- 理解上下文:真实图像和视频往往杂乱复杂。阴影、反射、运动模糊和相互重叠的目标都可能让自动化工具困惑。人工标注人员能够判断实际发生的情况,从而提高标签的准确性。
- 保持标签一致:随着数据集增长,自动生成的标签可能逐渐偏移,或在不同批次间出现差异。人工可以审核、修正并统一标签,让数据集从头到尾保持一致。
- 减少偏见和伤害:人更善于发现敏感内容、文化细微差异,以及可能引入偏见的模式。人工监督有助于让数据集更加公平,并避免意外伤害。
- 运用领域专业知识:有些任务需要领域知识,例如识别医学异常或工业缺陷。专家可以提供精确标签,并解决模糊案例,让模型学到正确的细节。
人在回路标注概述#
Roboflow 等标注工具和平台集成了自动化功能,以加快标注速度,通常会使用 Segment Anything Model 3 等基础模型,也就是 SAM 3。SAM 3是 Meta AI 推出的可通过提示进行分割的基础模型。
它可以根据点击、边界框或简短文本短语等简单提示,检测、分割并跟踪图像和视频中的目标,为匹配的目标生成分割掩码,而无需针对每个新类别进行专门训练。
即使采用这些先进方法,仍然需要人工专家审核并完成标注。自动化工具生成初稿后,由人工进行验证、纠正和完善,这种工作流程称为人在回路标注。这种方式既能保持标注效率,也能确保最终标签足够准确、一致,从而训练出可靠的模型。
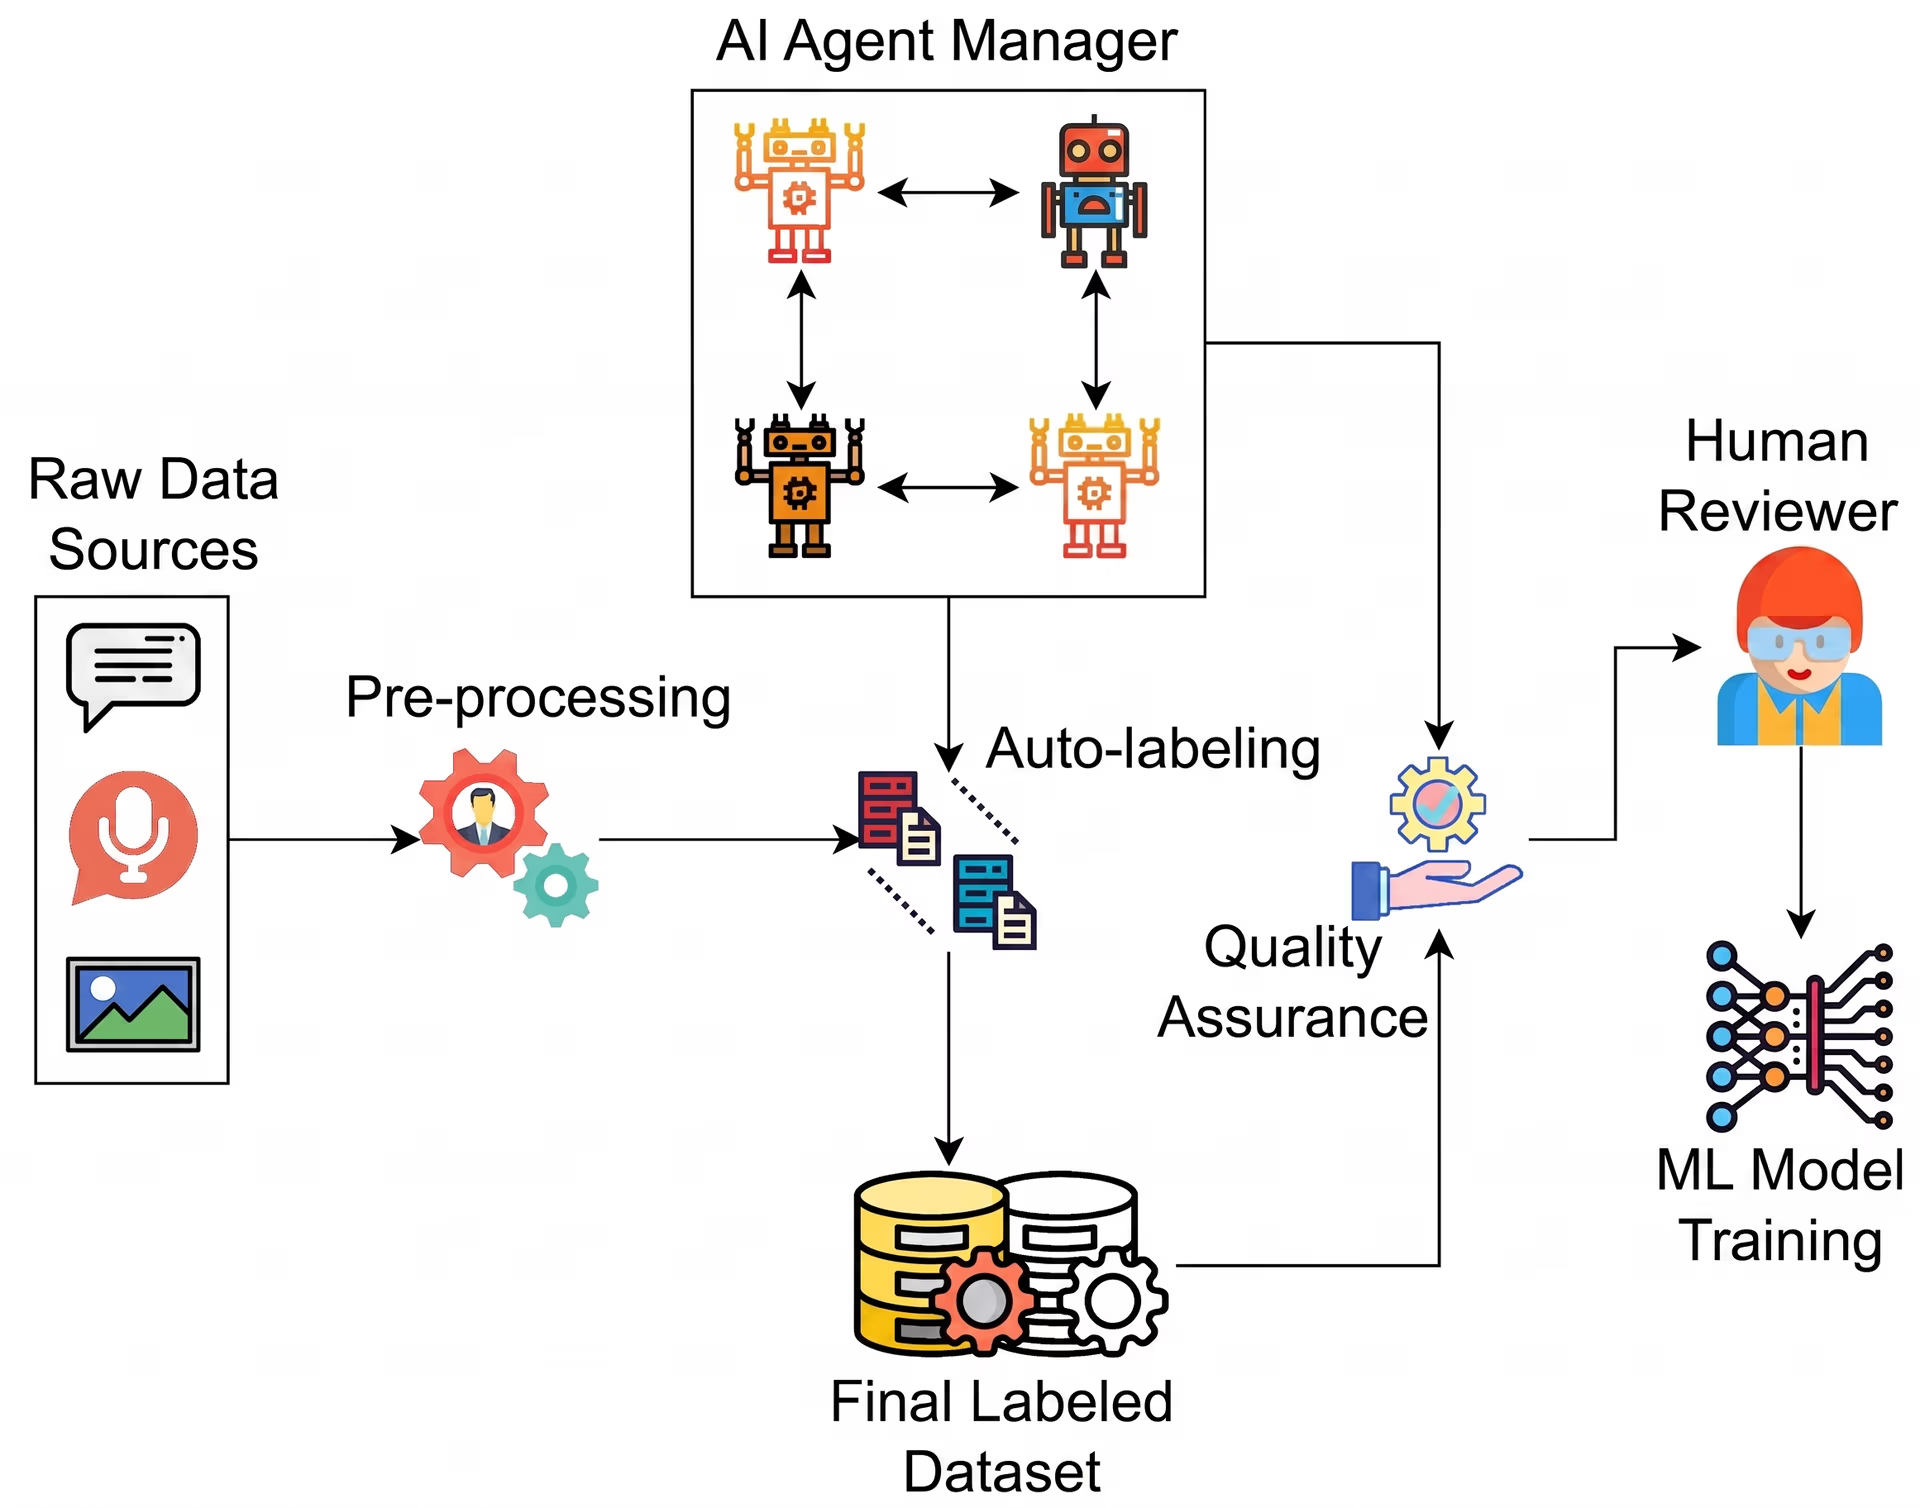
图 2. 人在回路标注示意图。(来源)
标注自动化何时有效,何时无效#
对于来自受控场所的数据,自动标注效果最好。在工厂、仓库或零售通道采集的图像通常光照稳定、目标清晰,因此自动化工具可以准确标注,帮助团队以更少的人工工作更快扩大规模。
来自控制较少场所的数据则更加复杂。户外影像会随一天中的时间和天气变化,街道或住宅场景往往包含杂物、运动模糊、相互遮挡的物体以及大量重叠。小目标、精细边界或罕见情况会进一步增加出错的可能。即使模型在干净的室内数据上表现良好,面对杂乱的真实世界视觉内容时仍可能力有不逮。
这就是人工参与仍然重要的原因。模型不确定时,人可以介入、解读棘手的上下文,并在错误进入最终数据集之前将其修正。人在回路标注能让自动化立足于真实世界条件,并使模型在部署后保持可靠。
人在回路标注可以在哪些方面发挥作用?#
现在我们已经了解自动化在哪些情况下效果良好、又在哪些情况下有所不足,接下来看看人在回路标注发挥重要作用的一些应用。
制造业缺陷检测#
想象一条工厂传送带,每分钟有数百个零件经过摄像头。大多数缺陷都很明显,但偶尔会出现一道角度刁钻或处于灯光眩光下的细微裂纹。自动化系统可能会漏掉它,或把它标成无害的表面纹理;人工审核人员则可以发现缺陷、修正标注,并确保模型学会区分两者。
这就是人在回路标注在工业检测中的作用。自动化可以预标注常见缺陷类型,并快速处理大量图像,但仍需要人工核验结果、细化边界,并处理训练中不常出现的罕见故障。
自动驾驶汽车与智能交通#
同样,自动驾驶汽车利用计算机视觉识别行人、读取标志并在交通中行驶,但真实道路难以预测。例如,夜间行人从停放的汽车后方走出时,可能被部分遮挡,并因眩光而难以看清。
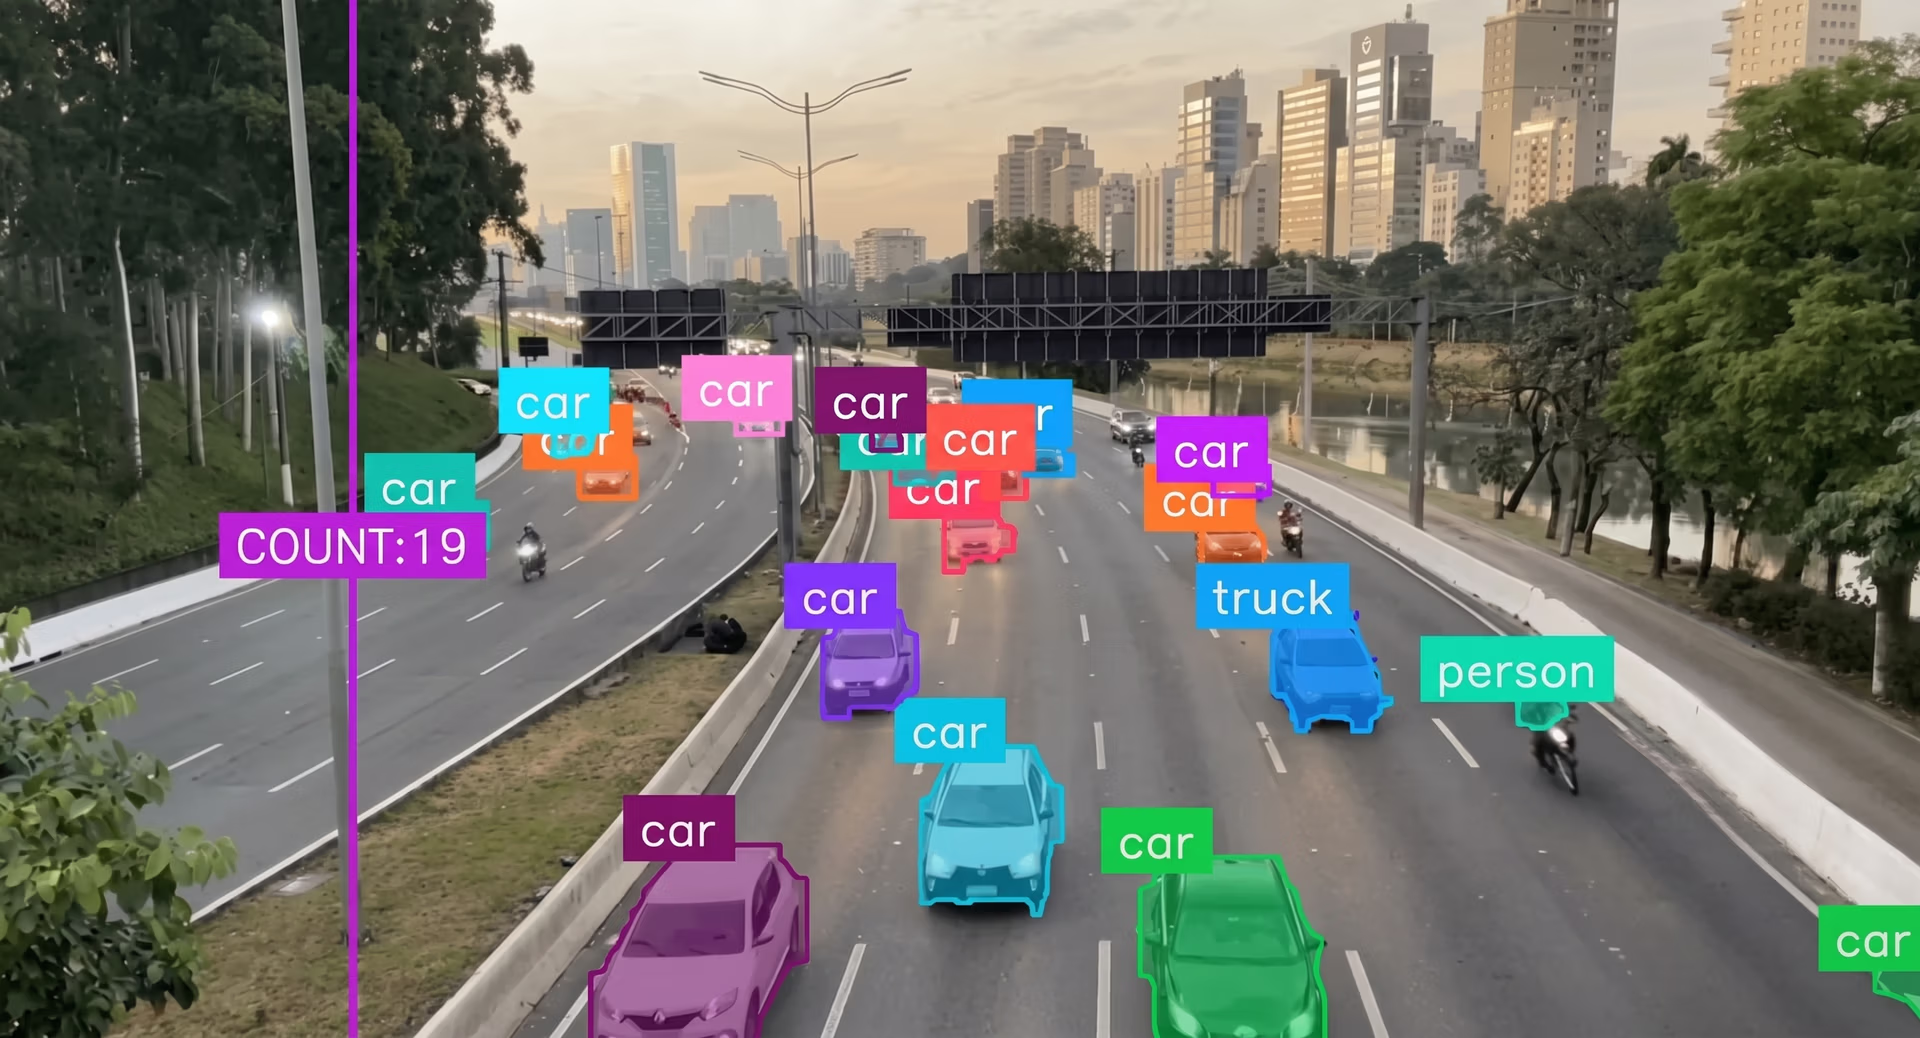
图 3. 使用计算机视觉分析交通的示例。(来源)
人工标注人员可以在训练期间标注这些罕见且关乎安全的边缘案例,让模型不仅在正常情况下,也能在最关键的时刻学会正确应对。人在回路这一步对于教会系统处理仅靠自动化难以捕捉的低频事件至关重要。
人工标注数据集的未来发展#
随着技术进步,人在回路标注正变得更具协作性。有趣的是,视觉语言模型 (VLM) 能从图像和文本中学习,现在正被用于生成第一轮标签,并根据简单提示提出修正建议。
因此,标注人员不必手动检查每张图像来决定要标注什么,而是可以用“标注所有行人、汽车和红绿灯”或“分割该零件上的所有缺陷”之类的短语提示 VLM,生成一批待审核的草稿标注。在 Ultralytics Platform 上,团队可以使用视觉语言模型自动标注检测数据集,而 VLM Leaderboard 会比较不同模型对真实世界图像进行标注的准确度。
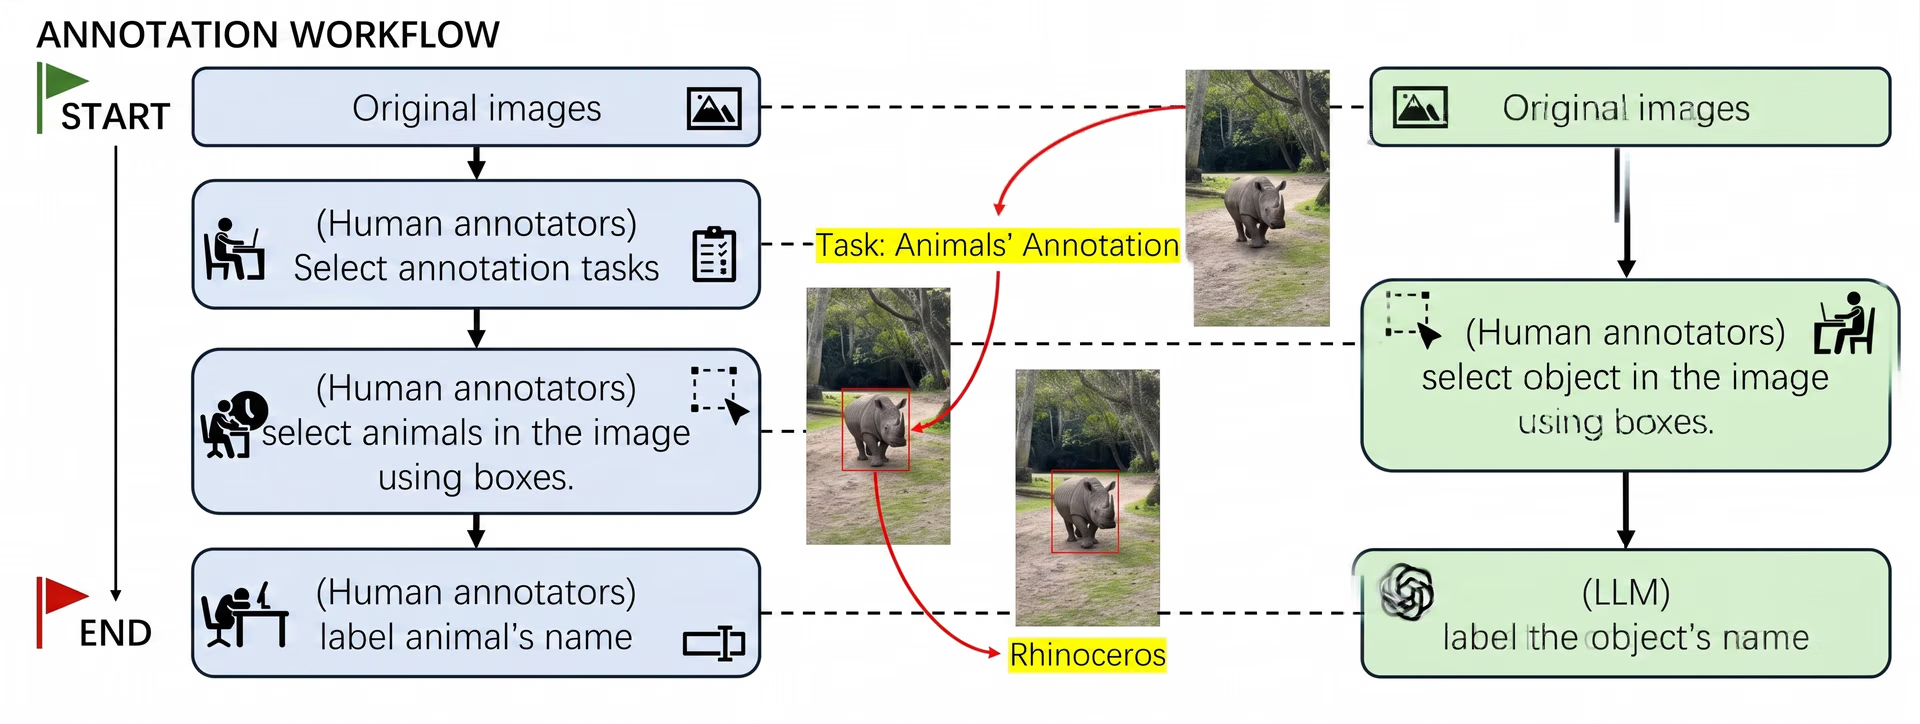
图 4. 大型多模态模型可以与人工标注人员协同工作(来源)
模型可以先处理许多简单案例,因此人工可以专注于审核结果、修正棘手样本并保持数据集一致,从而缩短标注时间。大型多模态模型也开始引导标注人员优先处理最不确定的样本,让人工投入更有针对性,并提升整体数据集质量。
要点#
计算机视觉帮助机器理解并响应所见内容,但有人类专业知识参与时效果最佳。人工标注数据能让模型立足于真实世界条件,并提升模型表现的可靠性。自动化与人工判断相辅相成,团队便能构建具有实际影响力的视觉系统。
加入活跃的社区,了解物流领域的 AI和机器人领域的视觉 AI等创新。访问我们的 GitHub 代码库了解更多信息。想立即开始使用计算机视觉?查看我们的许可选项。
作者
评论
提出问题、分享你的结果,或帮助其他人。









