什么是计算机视觉中的过拟合?如何防止过拟合?
了解计算机视觉中的过拟合是什么、如何发现过拟合,以及如何通过数据增强、正则化、提前停止和预训练模型来防止过拟合。
 Abdelrahman Elgendy6 分钟阅读
计算机视觉模型旨在识别模式、检测物体并分析图像。然而,模型的性能取决于其对未见过的数据的泛化能力。泛化能力是指模型在新图像上的表现,而不只是对训练过的图像表现良好。训练这类模型时,一个常见问题是过拟合:模型过度学习训练数据,包括不必要的噪声,而不是识别有意义的模式。
发生这种情况时,模型在训练数据上的表现很好,却难以处理新图像。例如,只在高分辨率、光线充足的图像上训练的目标检测模型,在真实环境中遇到模糊或有阴影的图像时可能会失效。过拟合会限制模型的适应能力,妨碍模型在自动驾驶、医学影像和安防系统等真实应用中的使用。
本文将探讨什么是过拟合、过拟合为何发生,以及如何预防过拟合。我们还会了解 Ultralytics YOLO11 等计算机视觉模型如何帮助减少过拟合并提升泛化能力。
什么是过拟合?#
过拟合是指模型记住了训练数据,而没有学会适用于新输入的普遍模式。模型过于关注训练数据,因此难以应对从未见过的新图像或新情境。
在计算机视觉中,过拟合会影响不同任务。只在明亮清晰的图像上训练的分类模型,可能难以应对低光照环境。从完美图像中学习的目标检测模型,可能无法处理拥挤或杂乱的场景。同样,实例分割模型可能在受控环境中表现良好,却难以应对阴影或相互重叠的物体。
在真实世界的 AI 应用中,模型必须能够在受控训练条件之外进行泛化,因此过拟合会成为问题。例如,自动驾驶汽车必须能够在不同光照、天气和环境下检测行人。过拟合训练集的模型无法在这类不可预测的场景中可靠地运行。
过拟合何时发生,又为何发生?#
过拟合通常由数据集不平衡、模型过于复杂和训练过度引起。以下是主要原因:
- 训练数据有限:小型数据集会让模型记住模式,而不是学会泛化。只用 50 张鸟类图像训练的模型,可能难以检测数据集之外的鸟类物种。
- 参数过多的复杂模型:层数和神经元过多的深度网络往往会记住细节,而不是关注重要特征。
- 缺少数据增强:如果没有裁剪、翻转或旋转等变换,模型可能只会从原封不动的训练图像中学习。
- 训练时间过长:如果模型反复遍历训练数据太多次(即过多训练轮次),就会记住细节,而不是学习通用模式,导致模型适应能力下降。
- 标注不一致或含有噪声:错误标注的数据会导致模型学到错误的模式。这在手动标注的数据集中很常见。
合理平衡模型复杂度、数据集质量和训练方法,可以确保模型获得更好的泛化能力。
过拟合与欠拟合#
过拟合和欠拟合是深度学习中两个相反的问题。
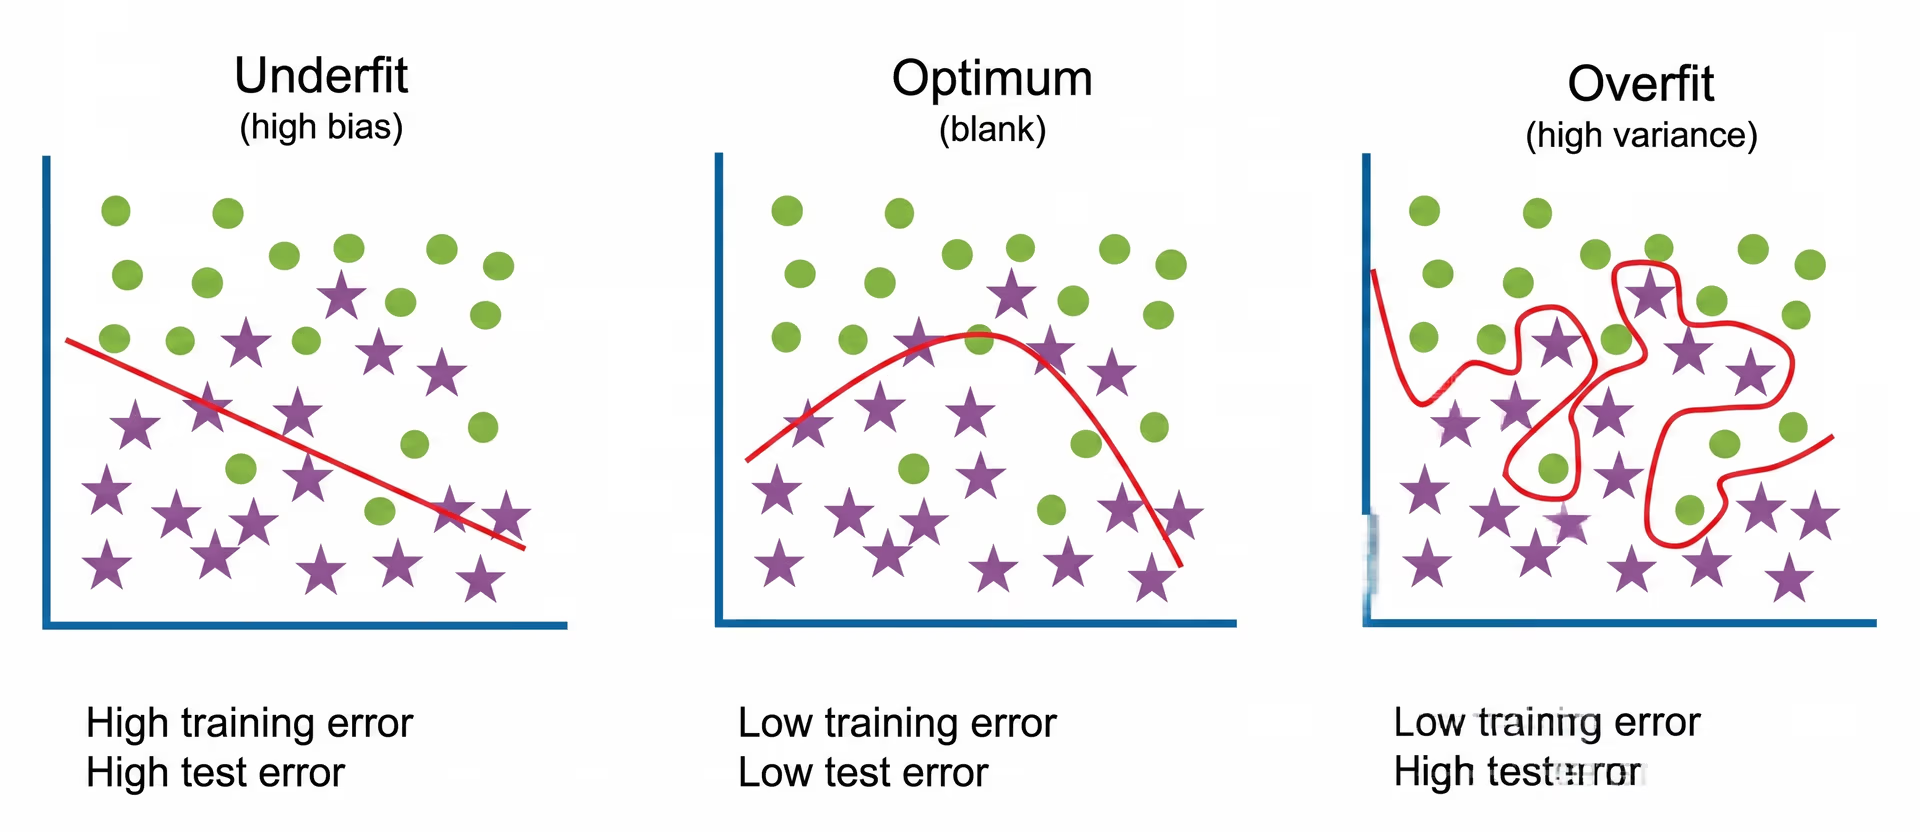
图 1. 计算机视觉模型欠拟合、理想学习与过拟合的对比。
过拟合发生在模型过于复杂、过度关注训练数据时。模型没有学习通用模式,而是记住了细枝末节,甚至是背景噪声等无关信息。这会导致模型在训练数据上的表现很好,却难以处理新图像,说明模型并未真正学会如何识别适用于不同情境的模式。
欠拟合发生在模型过于简单、无法捕捉数据中的重要模式时。当模型层数太少、训练时间不足或数据有限时,都可能出现这种情况。因此,模型无法识别重要模式,也就无法准确预测。由于模型没有充分学习来正确理解任务,它在训练数据和测试数据上的表现都会很差。
训练良好的模型能在复杂度和泛化能力之间找到平衡。模型应当足够复杂,能够学习相关模式,但又不能复杂到只会记住数据,而无法识别底层关系。
如何识别过拟合#
以下是一些表明模型过拟合的迹象:
- 如果训练准确度明显高于验证准确度,模型很可能过拟合。
- 训练损失与验证损失之间的差距不断扩大,也是一个明显信号。
- 模型会对错误答案过于自信,表明它记住了细节,而不是理解了模式。
为了确保模型具备良好的泛化能力,需要使用能反映真实世界条件的多样化数据集进行测试。
如何预防计算机视觉中的过拟合#
过拟合并非不可避免,而且可以预防。采用正确的方法,计算机视觉模型就能学习通用模式,而不是记住训练数据,从而在真实应用中更加可靠。
以下是预防计算机视觉过拟合的五种关键策略。
通过数据增强和合成数据提高数据多样性#
帮助模型在新数据上表现良好的最佳方式,是通过数据增强和合成数据扩充数据集。合成数据由计算机生成,而不是从真实世界图像中收集。数据不足时,合成数据有助于弥补缺口。
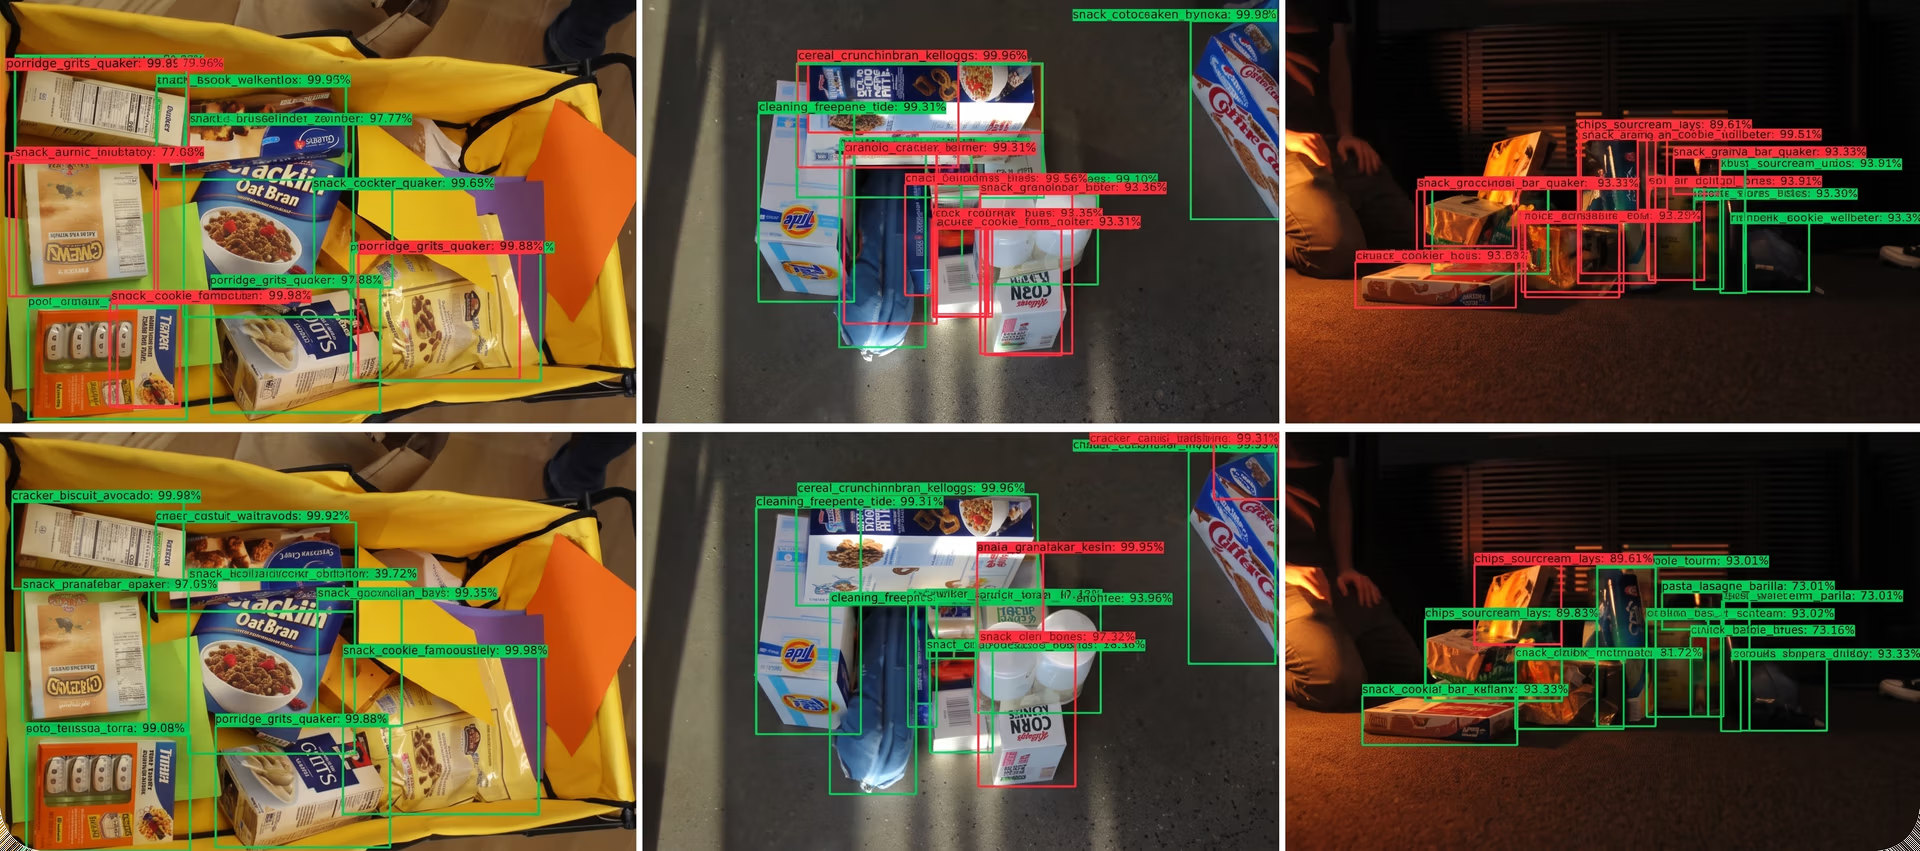
图 2. 结合真实世界数据与合成数据可以减少过拟合并提高目标检测准确率。
数据增强通过翻转、旋转、裁剪或调整亮度,对现有图像进行轻微变换,让模型不只是记住细节,还能学会在不同场景下识别物体。
难以获取真实图像时,合成数据很有用。例如,自动驾驶汽车模型可以使用计算机生成的道路场景进行训练,学习如何在不同天气和光照条件下检测物体。这样一来,无需数千张真实世界图像,模型也能变得更灵活、更可靠。
优化模型复杂度和架构#
深度神经网络是一种包含许多层、通过这些层处理数据的机器学习模型,并不总是更好的选择。当模型的层数或参数过多时,它会记住训练数据,而不是识别更普遍的模式。减少不必要的复杂度有助于防止过拟合。
一种实现方式是进行剪枝,移除冗余的神经元和连接,让模型更精简、更高效。
另一种方式是减少层数或神经元数量,以简化架构。Ultralytics YOLO11 等预训练模型经过设计,能够以较少的参数在不同任务中实现良好的泛化,因此与从头训练深度模型相比,它们更不容易过拟合。
在模型深度和效率之间找到恰当的平衡,有助于模型学习有用的模式,而不是单纯记住训练数据。
应用正则化技术#
正则化技术可以防止模型过度依赖训练数据中的特定特征。以下是几种常用技术:
- Dropout 会在训练期间随机关闭模型的部分单元,让模型学会识别不同的模式,而不是过度依赖少数特征。
- 权重衰减(L2 正则化)会抑制过大的权重值,从而控制模型的复杂度。
- 批归一化通过降低模型对数据集变化的敏感度,帮助稳定训练过程。
这些技术有助于保持模型的灵活性和适应能力,在保留准确率的同时降低过拟合风险。
通过验证和早停监控训练#
为防止过拟合,跟踪模型的学习情况并确保模型能够很好地泛化到新数据至关重要。以下是两种有助于实现这一目标的技术:
- 早停:当验证性能不再提升时自动结束训练,避免模型继续学习不必要的细节。
- 交叉验证:将数据划分为若干折,反复使用除一折以外的所有数据进行训练,并在留出的一折上验证。这样可以更可靠地评估模型在特定图像之外的泛化能力。
这些技术有助于保持模型的平衡,让模型在达到足够准确度的同时,不会过度专注于训练数据。
使用预训练模型并改进数据集标注#
与从头开始训练相比,使用 Ultralytics YOLO11 等预训练模型可以减少过拟合。YOLO11 在大规模数据集上训练,因此能够很好地泛化到不同条件。
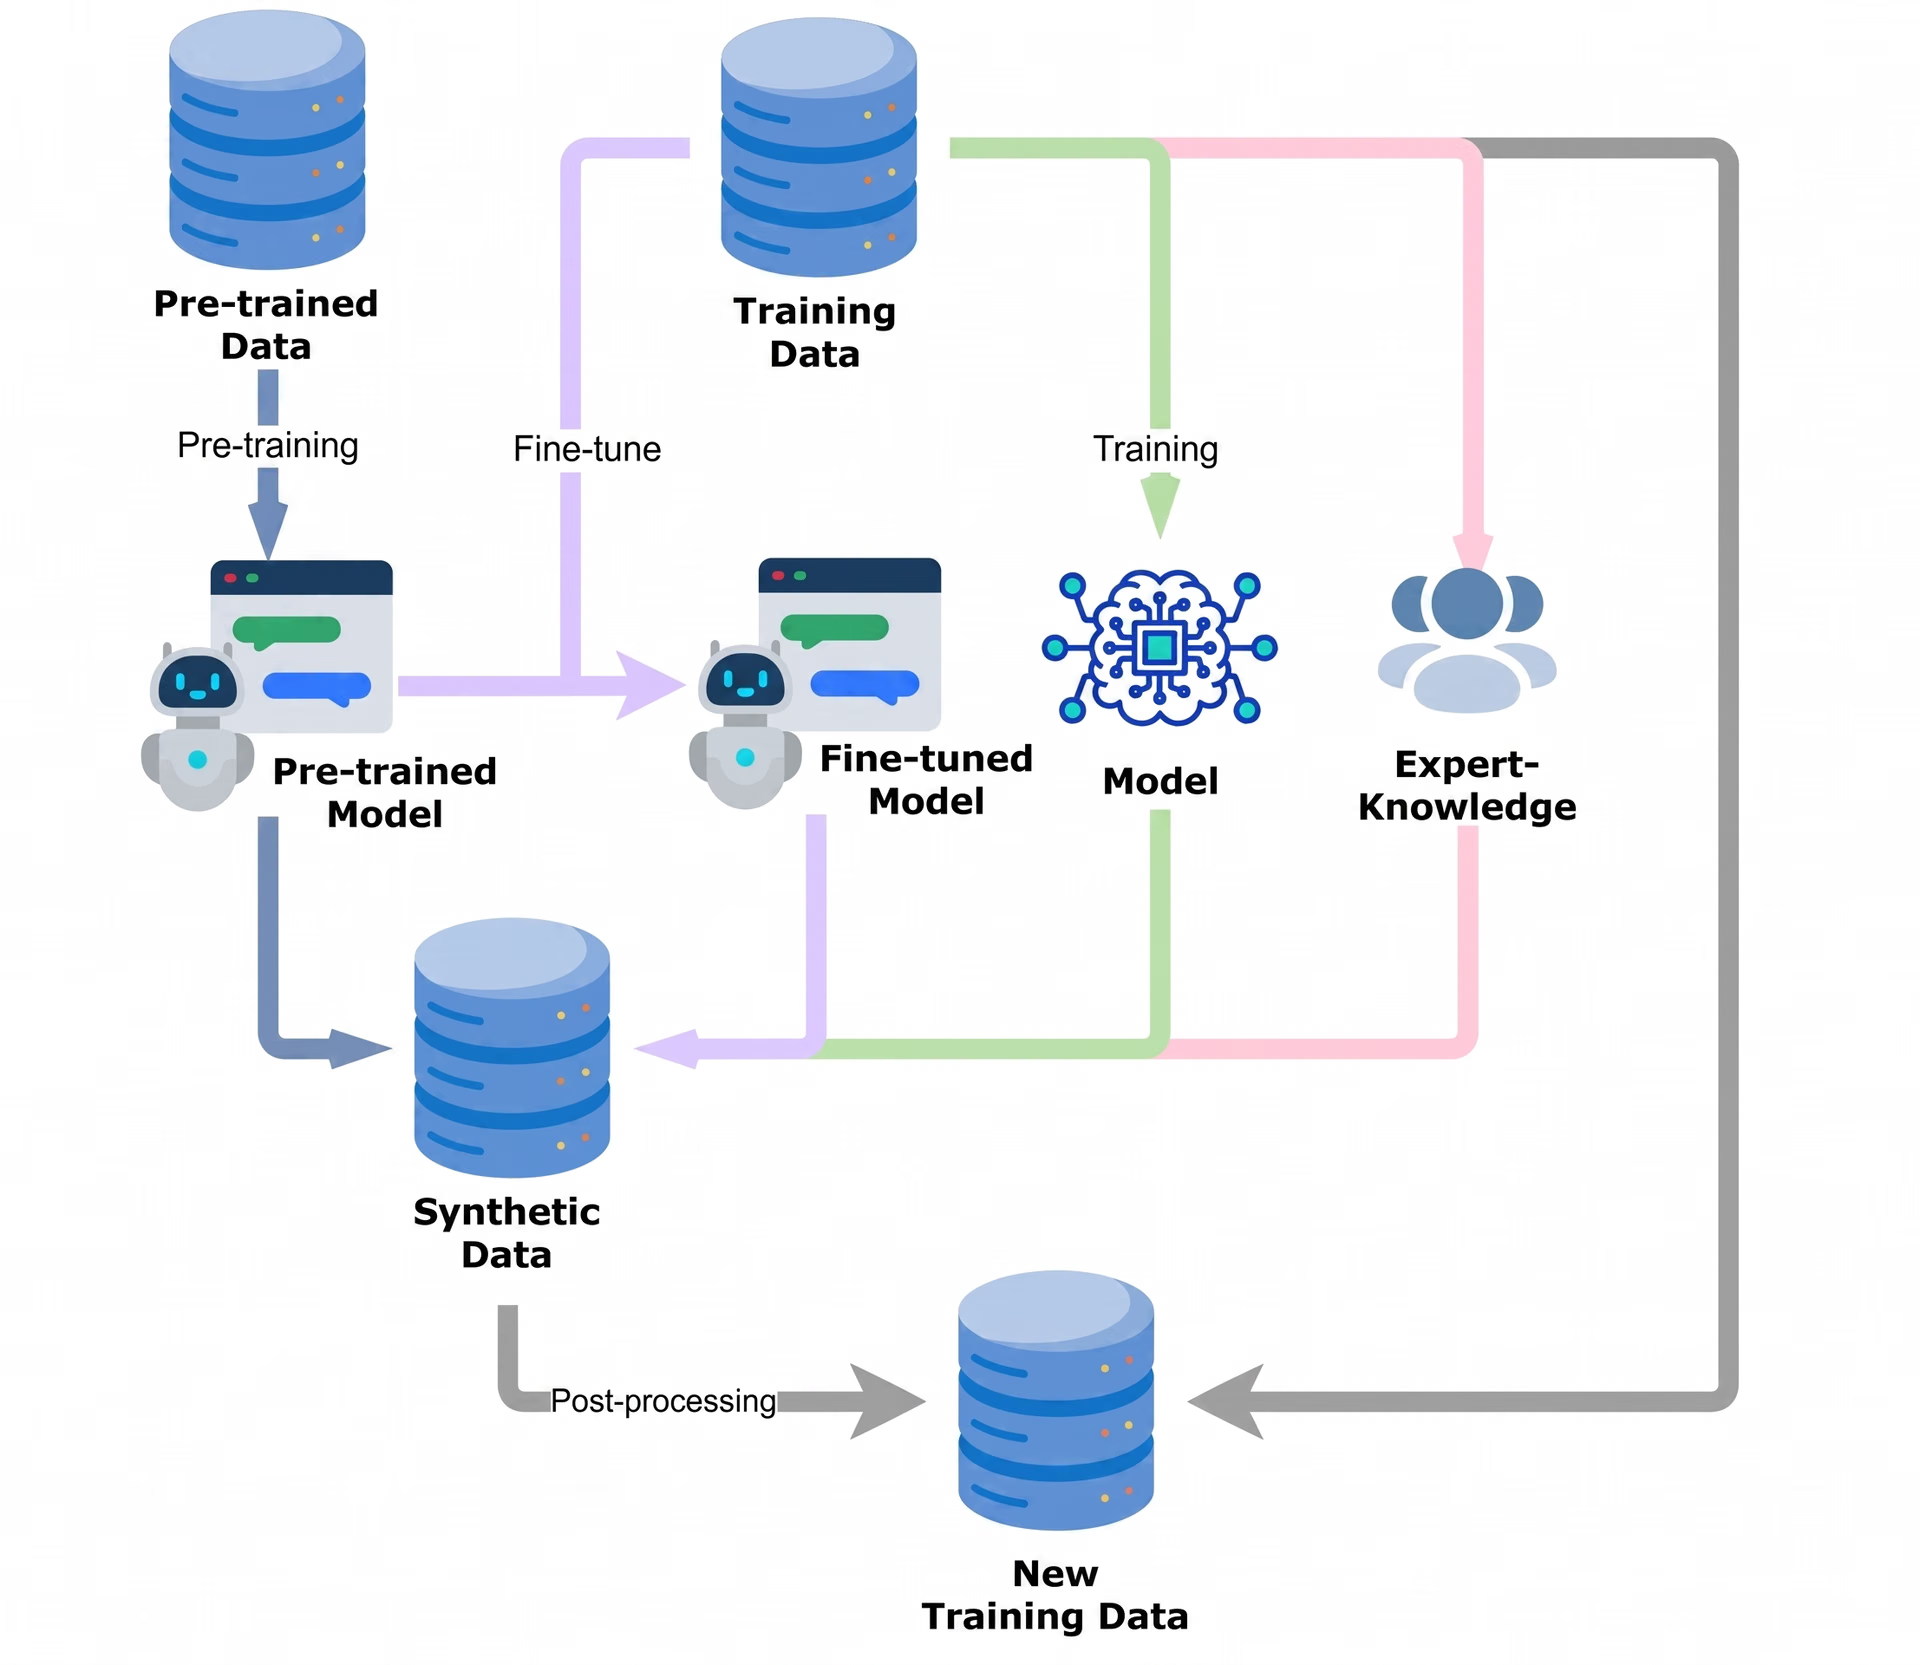
图 3. 预训练计算机视觉模型能够提高准确率并防止过拟合。
微调预训练模型可以让模型在学习新任务的同时保留已有知识,而不是单纯记住训练数据。
此外,确保数据集标注质量高也至关重要。标注错误或类别不平衡的数据会误导模型,使其学到错误的模式。清理数据集、修正标注错误的图像并平衡类别,有助于提高准确率并降低过拟合风险。另一种有效的方法是对抗训练,让模型接触经过轻微修改或更具挑战性的样本,以此检验模型的能力边界。
要点#
过拟合是计算机视觉中的常见问题。模型可能在训练数据上表现良好,却难以处理真实世界图像。为避免这种情况,可以使用数据增强、正则化以及 Ultralytics YOLO11 等预训练模型等技术来提高准确率和适应能力。
应用这些方法,可以让 AI 模型保持可靠,并在不同环境中表现良好。随着深度学习不断进步,确保模型能够正确泛化将是 AI 在现实世界取得成功的关键。
加入不断壮大的社区!访问我们的 GitHub 代码仓库,进一步了解 AI。准备好启动自己的计算机视觉项目了吗?来看看我们的许可选项。访问我们的解决方案页面,了解自动驾驶中的视觉 AI和医疗保健中的 AI!
作者
作者 · Ultralytics
评论
提出问题、分享你的结果,或帮助其他人。









