什么是单目深度估计?概览
了解单目深度估计的工作原理、它与基于传感器的深度方法的区别,以及它如何在视觉系统中实现可扩展的 3D 感知。
自动驾驶汽车旨在理解周围发生的事情,从而安全行驶。这意味着不能只识别行人或其他车辆等物体。
它们还需要知道这些物体距离自己有多远,才能做出正确响应。然而,让机器获得这种距离感并不简单。与人类不同,机器不会自然地从图像中感知深度,必须经过明确训练才能做到这一点。
其中一个原因是,大多数相机将世界捕捉为平面的二维图像。将这些图像转换为能够反映真实世界深度和 3D 结构的内容非常棘手,尤其是在系统需要在日常环境中可靠运行时。
有趣的是,计算机视觉是人工智能的一个分支,专注于解读和理解视觉数据,因此能够帮助机器更好地从图像中理解世界。例如,单目深度估计是一种计算机视觉技术,仅使用单个相机图像来估计物体的距离。
通过学习物体大小、透视、纹理和阴影等视觉线索,这些模型无需依赖 LiDAR(激光探测与测距)或立体相机等额外传感器,就能预测深度。本文将介绍单目深度估计是什么、它如何工作,以及它在现实世界中的一些应用。让我们开始吧!
单目深度估计简介#
单目深度估计使机器仅通过单张图像就能理解物体距离自身有多远。由于只依赖一个相机,这种方法具有多项优势,包括成本更低、硬件需求更简单。
例如,它可以用于配备单个相机的经济型家用机器人。即使只有一张图像,机器人系统也能识别哪些墙壁更近、哪些门更远,并推断空间的整体深度。
通常,单张图像不包含正确尺度的信息,因此单目深度估计通常关注相对深度。换句话说,即使不知道确切距离,它也能判断哪些物体更近、哪些物体更远。
如果模型使用包含真实距离或绝对深度的数据进行训练,例如来自 LiDAR 等传感器的深度测量值,那么它就能学习预测以米等现实世界单位表示的距离。没有这类参考数据时,模型仍然可以推断相对深度,但无法可靠地估计绝对距离。
单目深度估计的输出通常是深度图,也就是一张图像,其中每个像素表示场景对应部分的远近程度。深度图为视觉系统提供了对环境 3D 结构的基本理解。
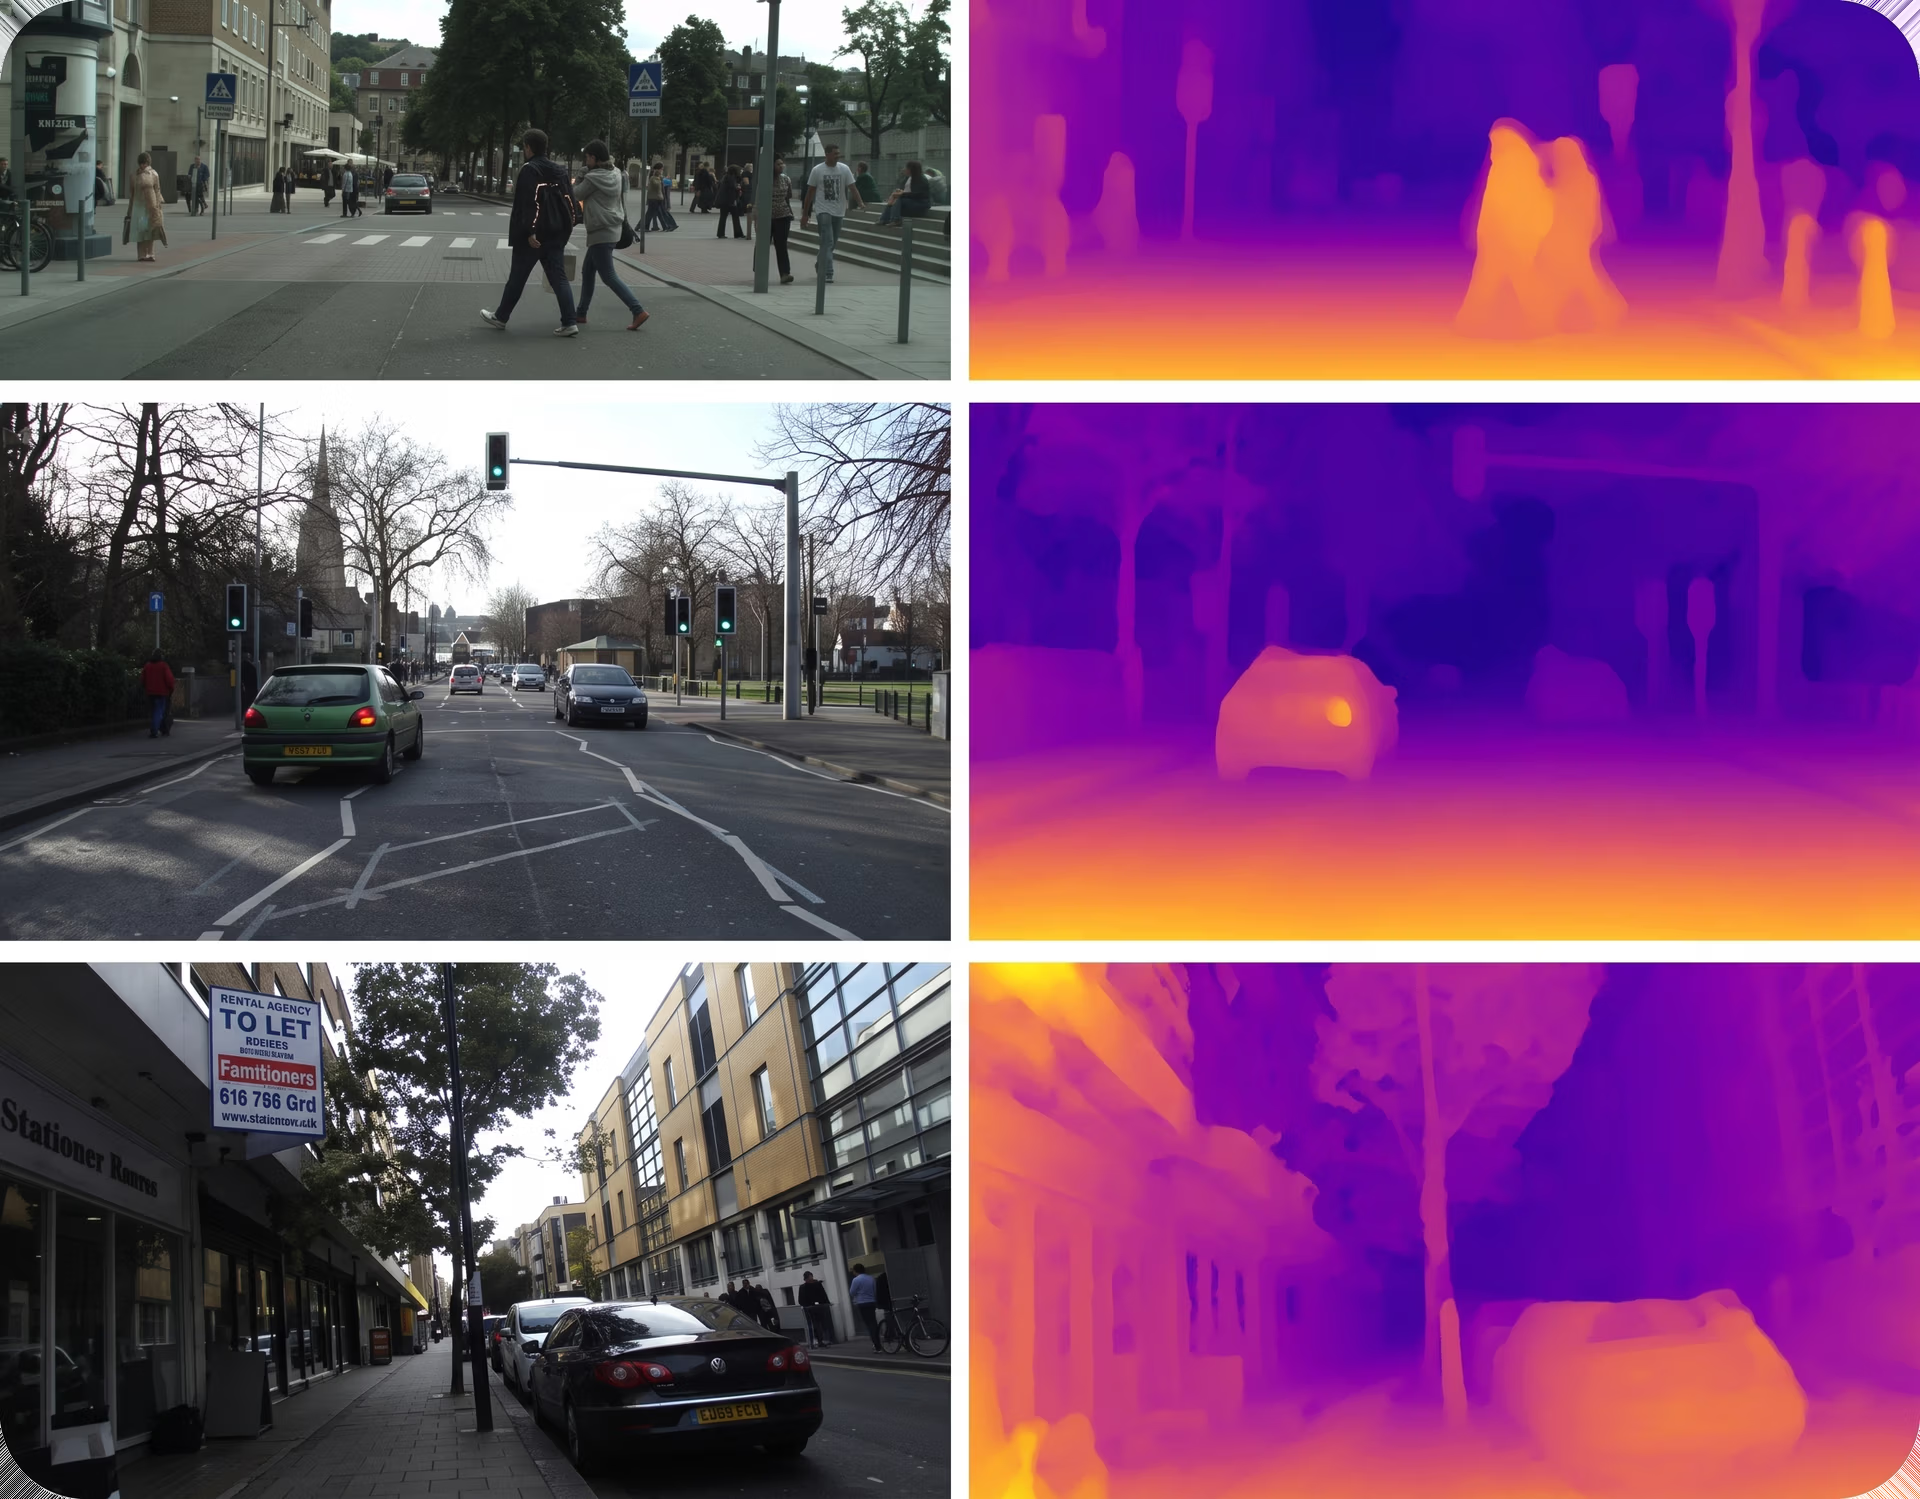
图 1. 使用单目深度估计生成的预测深度图示例(来源)
从传感器到图像:估计深度#
深度估计有多种实现方式,具体取决于可用传感器、硬件限制和精度要求。传统方法通常依赖多个视角或专用传感器来直接测量距离。
一种常见方法是立体视觉,它通过比较从略有不同视角同步捕获的两张图像来估计深度。通过测量两张图像中对应点之间的差异,系统可以推断物体距离相机有多远。
另一种方法是 RGB-D(红、绿、蓝和深度)系统,它使用主动深度传感器直接测量每个像素处的距离。这些系统可以在受控环境中提供准确的深度信息,但需要额外硬件。
与此同时,基于 LiDAR 的方法使用激光脉冲生成场景的精确 3D 表示。LiDAR 传感器虽然精度很高,但通常价格昂贵,并会显著增加硬件复杂度。
相比之下,单目深度估计仅使用单张 RGB 图像来推断深度。由于不依赖多台相机或专用传感器,它更易于大规模部署,并且在成本和硬件资源有限时是不错的选择。
从单张图像中学习深度#
从单张图像估计深度时,单目深度模型会学习识别人类凭直觉判断距离时使用的视觉线索。这些线索包括透视线、物体大小、纹理密度、物体重叠和阴影,它们都能提示物体距离相机有多远。
这些线索共同构成深度感。看起来更小或部分被遮挡的物体通常距离更远,而更清晰的细节和更大的视觉外观通常意味着物体更近。
为了学习这些模式,单目深度模型会在大规模图像数据集上训练,这些数据集通常配有从 LiDAR 或立体系统等其他来源获取的深度信息。在训练过程中,模型学习视觉线索与深度之间的关系,从而在推理时根据单张图像推断距离。
借助多样化的训练数据,现代视觉模型可以将所学理解泛化到各种环境中,包括室内和室外场景,并处理不熟悉的视角。
不同单目深度估计技术一览#
接下来,我们将探讨用于从单张图像估计深度的主要方法,以及这些方法如何随着时间发展。
经典方法与基于几何的方法#
早期深度估计方法依赖与相机几何相关的直接视觉规则。透视、物体大小以及一个物体是否遮挡另一个物体等线索,都被用于估计距离。
例如,当两个相似物体以不同大小出现时,人们会假设较小的物体距离更远。这些方法在光照、相机位置和场景布局等因素保持一致的受控环境中表现尚可。
然而,在现实场景中,这些假设往往会失效。光照变化、视角改变以及场景复杂度增加都可能导致不可靠的深度估计,限制经典方法在非受控环境中的有效性。
早期机器学习方法#
早期机器学习方法通过直接从数据中学习模式,为深度估计带来了更大的灵活性。这些模型不再只依赖固定的几何规则,而是尝试学习视觉信息与距离之间的关系,将深度预测视为基于边缘、纹理和颜色变化等线索的回归问题。
特征选择是这一过程的关键环节。工程师必须决定提取哪些视觉信号以及如何表示这些信号,而模型性能在很大程度上取决于这些选择。
虽然这种方法比早期方法表现更好,但仍存在局限。如果所选特征缺少重要上下文,深度预测就会不够准确。随着场景变得更加复杂和多样,这些模型往往难以产生可靠结果。
深度学习算法#
大多数现代单目深度估计系统都使用深度学习,即使用包含许多层、能够从数据中学习复杂模式的神经网络。这些模型学习直接从图像预测深度,并生成深度图。
许多方法基于卷积神经网络(CNNs)构建。CNNs 是一种通过检测边缘和形状等模式来处理图像的神经网络。此类模型通常采用编码器—解码器结构:编码器从图像中提取视觉特征,解码器将这些特征转换为深度图。在多个尺度上处理图像,有助于模型捕捉场景的整体布局,同时保留清晰的物体边界。
较新的模型更加关注理解图像不同部分之间的关系。基于 Transformer 的模型和视觉 Transformer(ViT)模型使用注意力机制,使模型能够识别图像中最相关的区域,并建立远距离区域之间的联系。这有助于模型在整个场景中形成更加一致的深度理解。
有些系统会结合这两种思路。混合 CNN—Transformer 模型使用 CNNs 捕捉精细的局部细节,并使用 Transformers 建模场景的全局上下文。虽然这通常能提升准确率,但往往需要更多计算资源,例如额外的内存和处理能力。
为什么深度理解对视觉 AI 系统很重要#
在了解单目深度估计时,你可能会想知道,为什么深度理解是基于视觉的 AI 系统如此重要的一部分。
当系统能够估计物体和表面距离自身有多远时,它就能更好地理解场景布局以及不同元素之间的关系。这种空间感知能力对于做出可靠决策至关重要,尤其是在自动驾驶等现实应用中。
深度信息还为其他计算机视觉任务提供了有价值的上下文。例如,由 Ultralytics YOLO26 等模型支持的目标检测可以告诉系统场景中有什么,但深度信息有助于回答这些物体相对于相机以及彼此之间位于何处。
这些能力结合起来,可以支持广泛的视觉 AI 应用,例如构建 3D 地图、在复杂环境中导航,以及整体理解场景。
机器人和自动驾驶汽车依靠这些信息来安全移动、避开障碍物并实时应对变化。例如,Tesla 的纯视觉驾驶方法依靠相机图像结合深度估计,而不是 LiDAR,来理解物体距离有多远以及它们在道路上的位置。
单目深度估计模型如何工作#
尽管模型架构各不相同,但大多数单目深度估计模型都会遵循类似流程,将单张图像转换为深度图。下面快速介绍其中的关键步骤:
- 输入与预处理: 工作流从输入图像开始。在输入模型之前,原始图像通常会经过调整大小、归一化,并转换为张量;张量是神经网络用于高效处理图像数据的一种格式。
- 特征提取: 编码器网络分析图像并提取有意义的视觉特征。这些特征包含纹理、物体边界和场景整体布局等信息。大多数模型会在多个尺度上运行,以便同时理解精细细节和全局结构。
- 深度推理: 模型利用提取出的特征,将局部细节与全局上下文结合起来,推理场景中的空间关系。在这一阶段,模型学习判断图像中的哪些区域更靠近相机,哪些区域更远。
- 深度图生成: 随后,解码器将这些信息转换为稠密深度图。图像中的每个像素都会被分配一个深度值,通常还会融合不同尺度的预测结果,以提高准确性和一致性。
单目深度估计模型如何训练#
我们刚才讨论的流程假定已经有一个经过训练或预训练的模型。但单目深度估计模型的训练究竟是如何进行的?
训练首先要准备图像数据,使其能够被网络高效处理。输入图像会被调整大小并归一化到一致的尺度,然后输入模型,生成预测深度图,估计每个像素处的距离。
随后,使用损失函数将预测深度图与参考深度数据进行比较,以衡量模型预测结果与真实深度之间的差距。这个损失值表示模型当前的误差,并为改进提供信号。
优化器利用这一信号,通过调整模型的内部权重来更新模型。为此,优化器会计算梯度,描述损失相对于每个模型参数的变化情况,并在多个训练轮次中反复应用这些更新;一个训练轮次指完整遍历一次训练数据集。
这一迭代式监督学习训练过程由学习率和批量大小等超参数引导。学习率控制每次更新步长的大小,批量大小决定一次处理多少张图像。由于训练涉及大量数学运算,通常会使用图形处理单元(GPU)加速,而 GPU 非常适合并行计算。
训练完成后,模型会在验证集上使用标准评估指标进行评估。验证集由训练期间未使用过的图像组成。这项评估有助于衡量模型对新数据的泛化能力。
随后,可以将训练好的模型复用于新的场景,或针对新场景进行微调。总体而言,这一训练过程使单目深度估计模型能够生成一致的深度估计结果,而这对于 3D 重建和现实部署等下游任务至关重要。
探索最先进的模型与研究趋势#
随着模型逐渐能够更好地理解完整场景,而不只是局部视觉细节,单目深度估计也得到了快速发展。早期方法生成的深度图往往不够均匀,尤其是在复杂环境中。
正如近期发表于 arXiv 的研究所展示的那样,较新的模型更加关注全局上下文,因此生成的深度预测看起来更加稳定和真实。MiDaS 和 DPT 等知名模型通过从多样化的高分辨率数据集中学习深度,并在众多场景中实现良好泛化,推动了这一转变。
包括 ZoeDepth 和 Depth Anything V2 在内的较新模型,在此基础上通过提升尺度一致性来进一步改进,同时在各种环境中保持出色性能。这类进展通常使用 KITTI 和 NYU 等常见基准数据集进行衡量,这些数据集涵盖室外和室内场景。
另一个明显趋势是在准确性与实用性之间取得平衡。较小的模型针对速度进行了优化,可以在边缘设备或移动设备上实时运行;较大的模型则优先考虑更高分辨率和更远距离的深度准确性。
单目深度估计的应用#
接下来,我们将介绍一些现实世界中的示例,展示单目深度估计如何从单张图像推理场景的 3D 结构。
在所有这些情况下,都必须注意,深度信息是根据视觉线索推断出的估计值,而不是精确测量值。因此,单目深度估计适合用于理解相对布局和空间关系,但不能替代 LiDAR 或立体系统等专门用于精确测距的传感器。
基于无人机的地形测绘与导航#
无人机经常在 GPS 信号不可靠的环境中运行,例如森林、建筑工地、灾区或密集的城市区域。为了在这些条件下安全飞行,它们需要理解周围地形,并知道障碍物距离有多远。过去,这通常需要增加 LiDAR 或立体相机等传感器,但这些设备会增加重量、功耗和总体成本。
单目深度估计是一种更简单的替代方案。无人机仅使用单个 RGB 相机,就能从图像中估计深度,并构建对周围环境的基本 3D 理解。这使它们能够检测建筑物、树木或地形突变等障碍物,并实时调整飞行路径。
这些深度估计结果支持包括避障、高度控制和安全着陆在内的关键导航任务。因此,轻量级无人机无需依赖专用深度传感器,也能执行测绘、巡检和导航任务。
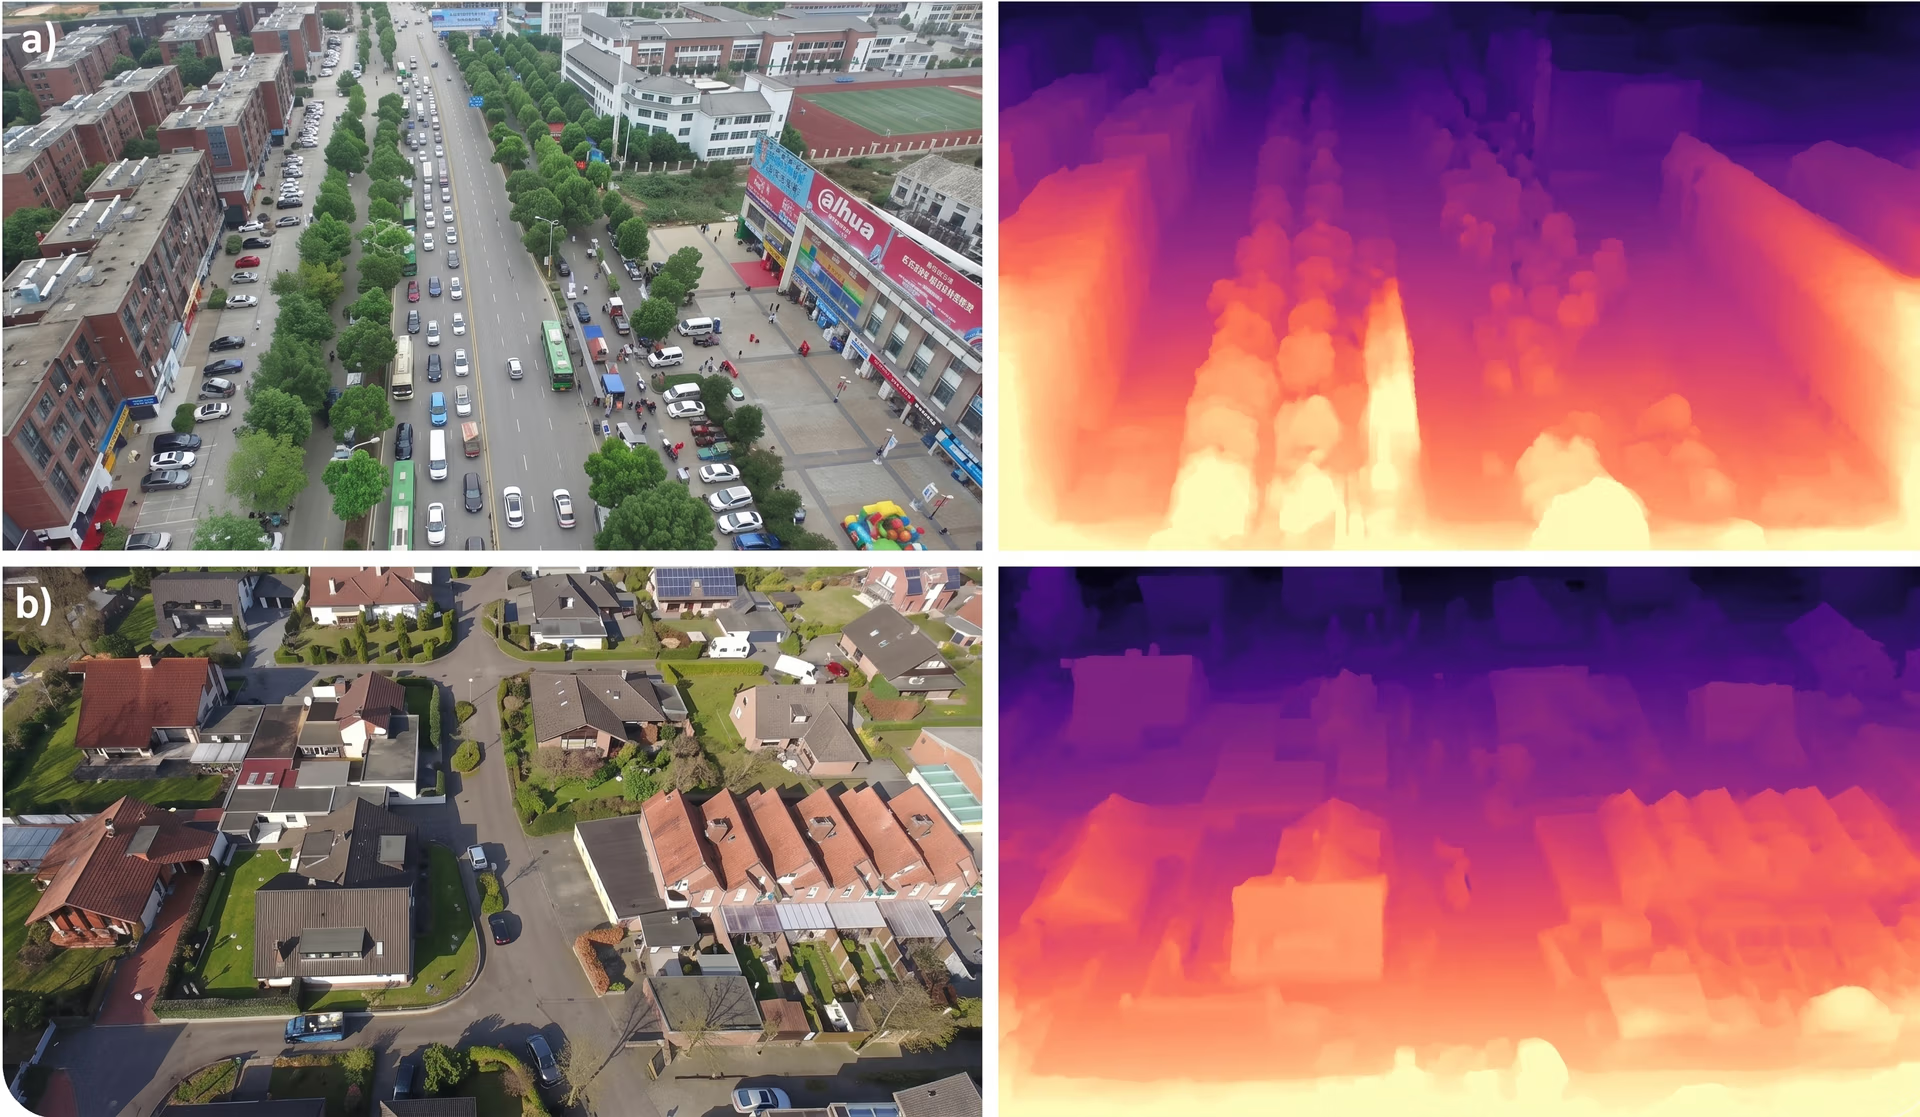
图 2. 单目深度估计可用于分析无人机图像(来源)
为自动驾驶赛车填补盲区#
自动驾驶汽车通常高度依赖 LiDAR 传感器。LiDAR 使用激光脉冲测量距离,并构建道路的 3D 视图。虽然精度很高,但在道路陡峭 crest、陡坡、遮挡或车辆俯仰突然变化的情况下,LiDAR 可能会遇到困难,有时会返回稀疏或缺失的深度数据。
即使 LiDAR 数据不完整,单目深度估计也能从单张 RGB 图像提供稠密深度信息,帮助填补这些空缺。设想一辆自动驾驶汽车正在高速接近山顶。LiDAR 光束可能越过山顶,照射到山顶后方的道路,从而无法确定前方情况。
然而,基于相机的深度估计仍能根据透视和纹理等视觉线索推断道路形状,帮助车辆在 LiDAR 数据稳定之前维持可靠感知。LiDAR 与单目深度估计结合后,可以在具有挑战性的驾驶条件下实现更稳定的感知和更安全的控制。
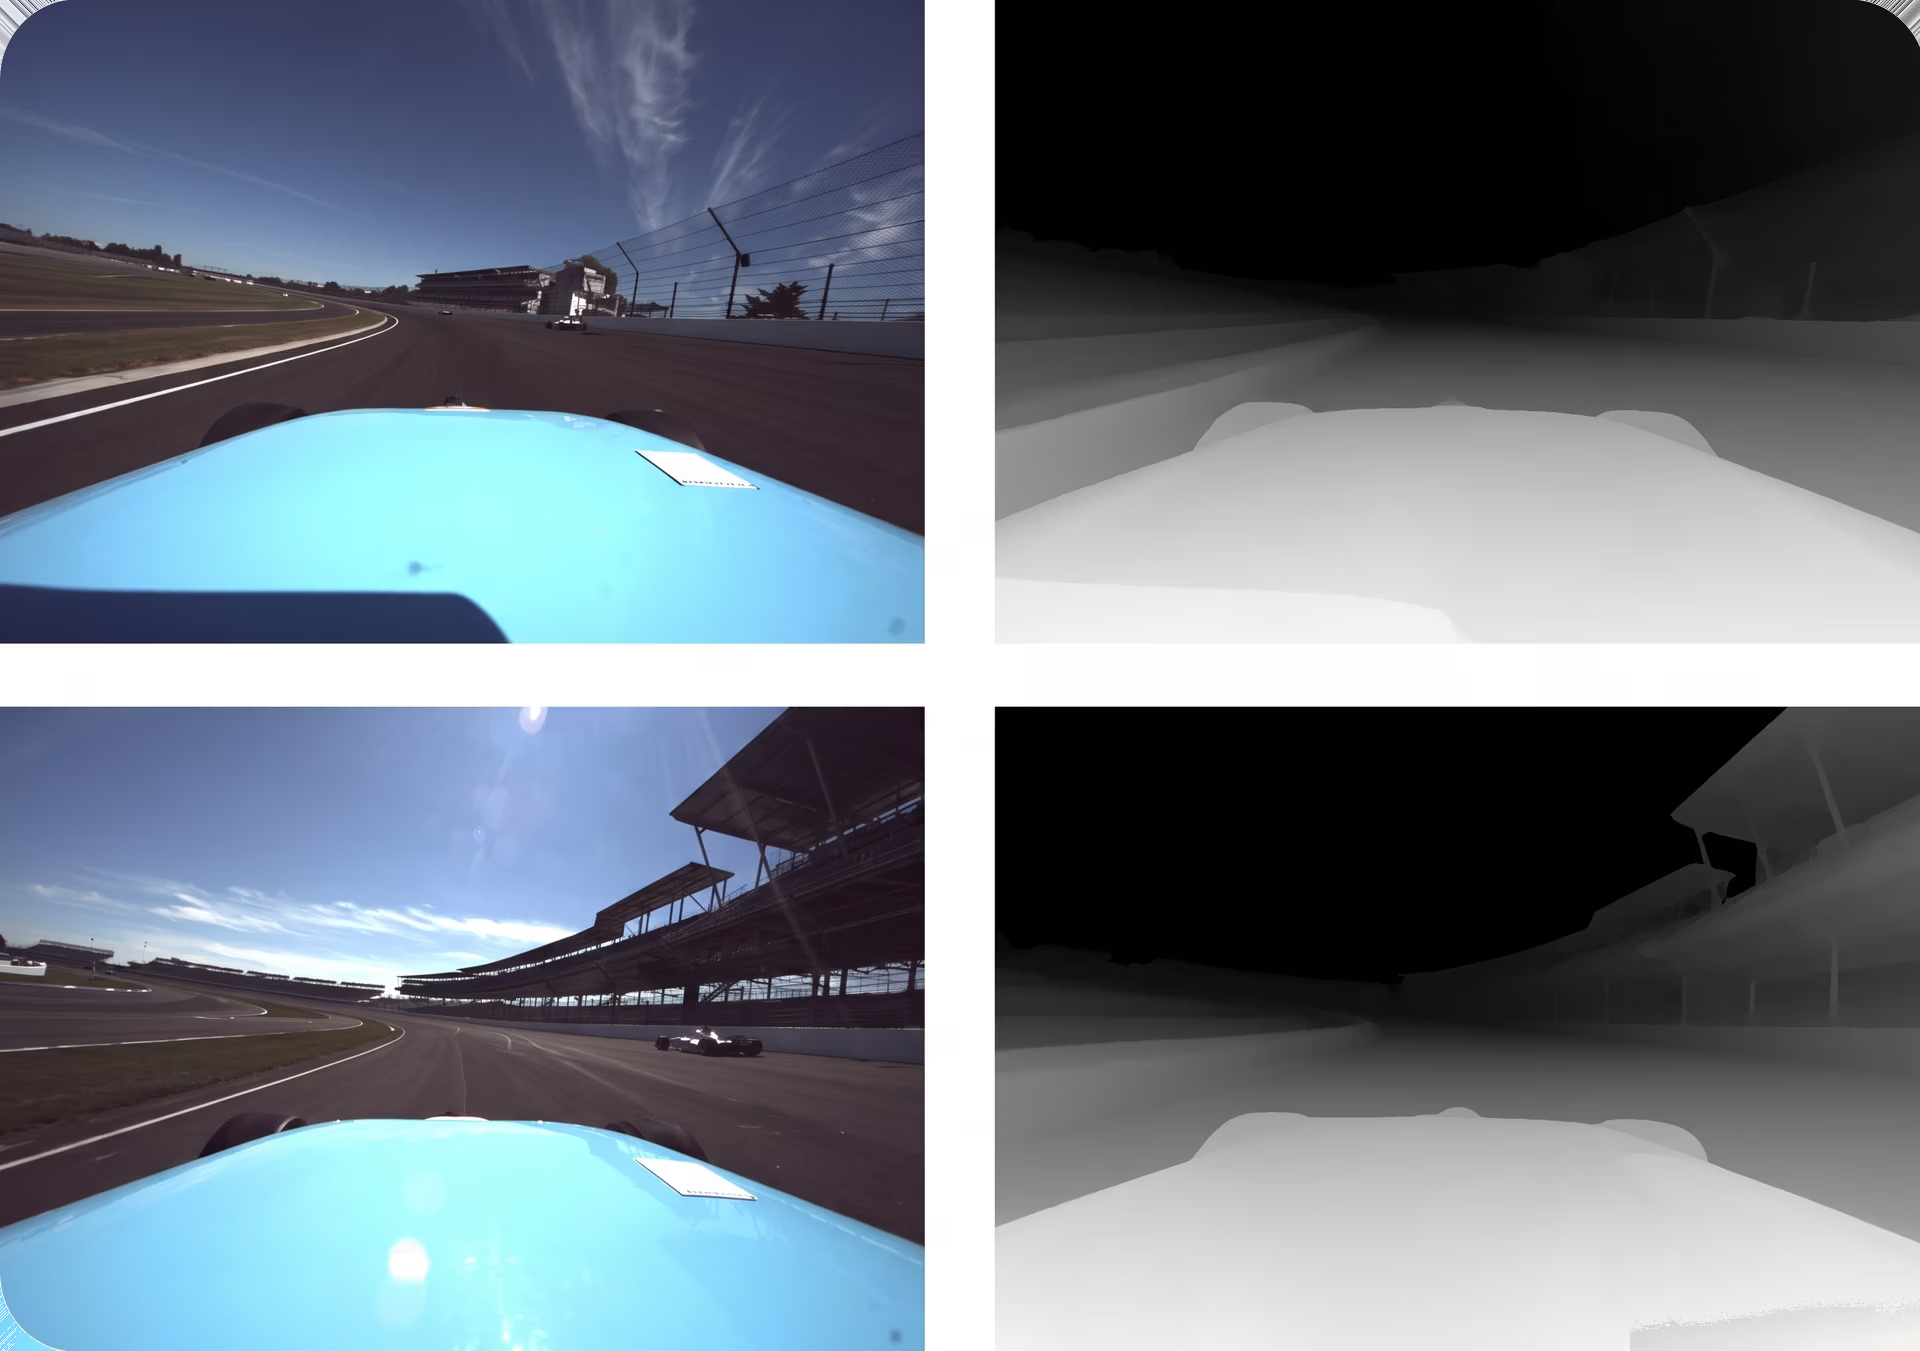
图 3. 使用单目深度估计进行自动驾驶赛车的可视化(来源)
机器人导航与避障#
机器人经常在无法获得详细地图且环境不断变化的地方运行。为了安全移动,它们需要可靠地感知周围有多少空间以及障碍物位于何处。
单目深度估计仅使用一个 RGB 相机即可提供这种空间感知能力,无需依赖笨重或昂贵的硬件。通过学习尺度和透视等视觉线索,深度估计模型可以生成周围环境的稠密深度图。这能让机器人清楚了解表面和物体的距离。
尤其是当深度信息与目标检测和语义分割等计算机视觉任务结合时,机器人可以更完整地了解周围环境。它们能够识别物体、理解物体距离,并判断哪些位置可以安全移动。这支持避障、自由空间检测和实时路径规划。
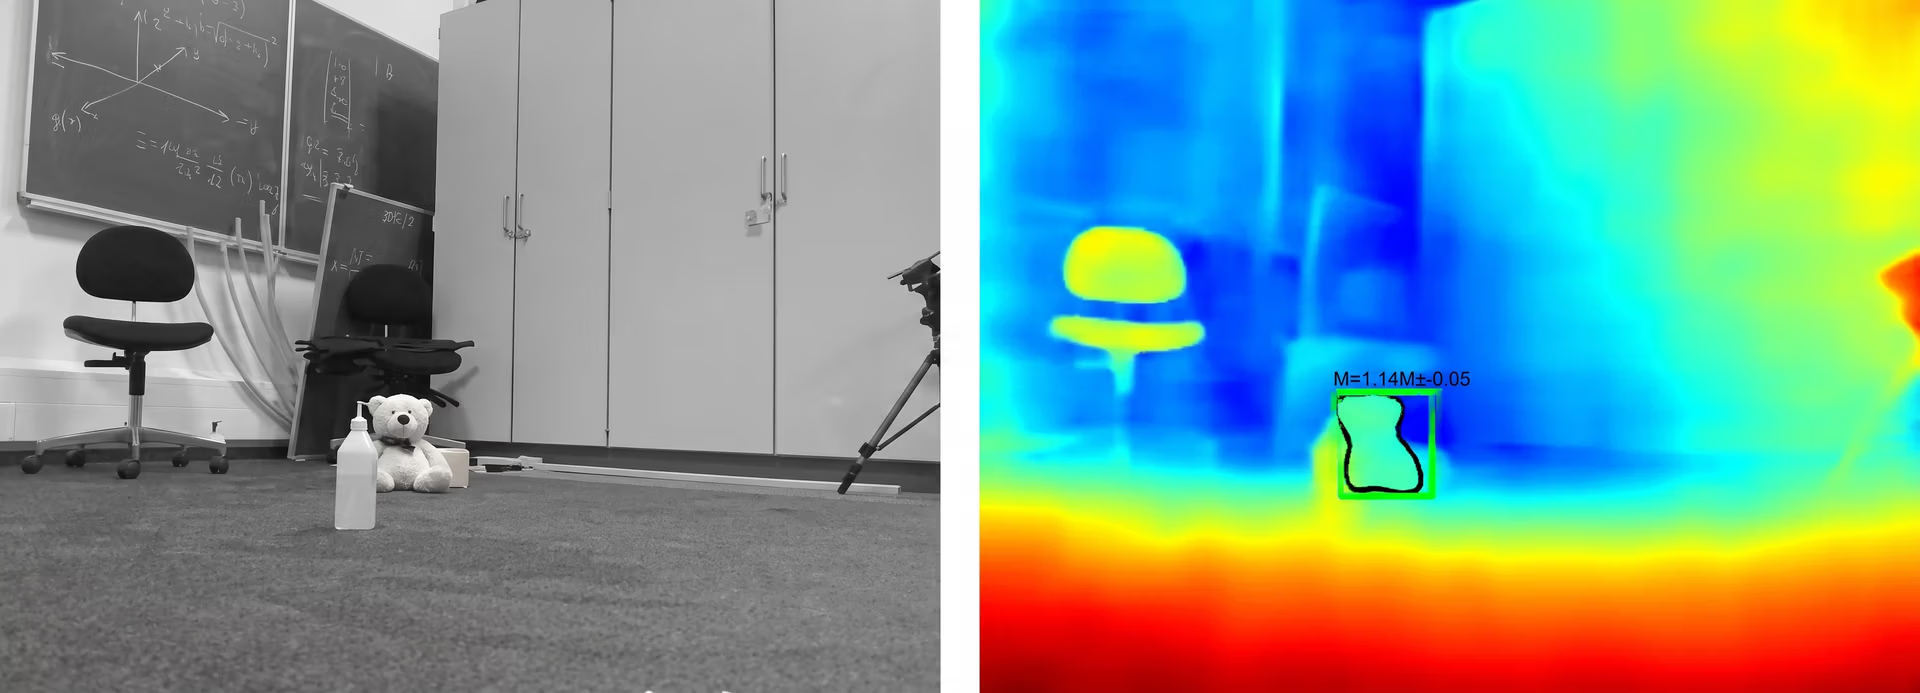
图 4. 使用单目深度估计和目标检测检测物体(来源)
单目深度估计的优缺点#
以下是使用单目深度估计的主要优势:
- 轻量且节能: 使用单个相机可以减轻系统重量并降低功耗,这对于移动机器人、无人机和嵌入式系统尤为重要。
- 便于传感器融合: 单目深度可以补充 LiDAR 或雷达等其他传感器,填补数据空缺或提供冗余。
- 适用于多种环境: 同一种基于相机的方法可以在室内、室外以及不同平台上使用,无需更改硬件。
虽然单目深度估计具有明显优势,但也需要考虑以下局限:
- 准确性低于主动传感器: 尽管发展迅速,单目深度估计通常仍无法在受控条件下达到 LiDAR 或结构光传感器的绝对精度。
- 对光照条件敏感: 在低光照环境、强阴影、眩光或纹理较少的场景中,性能可能会下降。
- 泛化方面的挑战: 在某一环境中训练的模型,如果不进行适配或微调,未必能可靠迁移到未见过的领域。
不应依赖单目深度估计的情况#
虽然单目深度估计是一个有趣的研究领域,但必须了解它在什么情况下可以实际使用,以及在什么情况下不能使用。它生成的距离是根据模型在图像中看到的内容得出的估计值,而不是从现实世界直接测量的精确值。
因此,结果质量可能会受到光照、场景复杂度以及当前场景与模型训练数据的相似程度等因素影响。单目深度估计通常擅长判断什么更近、什么更远,但在需要精确距离时并不可靠。
在安全关键系统、工业检测或需要与物体进行高精度交互的机器人等对精度要求很高的场景中,深度必须直接测量。LiDAR、雷达、立体相机或结构光系统等传感器就是为此设计的,能够提供更加可靠的距离信息。
单目深度估计在视觉条件困难时也可能表现不佳。光照不足、强阴影、反光或透明表面、雾、烟,以及视觉纹理极少的场景,都可能降低深度估计的可靠性。在远距离处估计深度,也是专用传感器通常表现更好的场景。
在实际应用中,单目深度估计更适合作为辅助工具,而不是独立解决方案。它可以提供有用的空间上下文,在其他传感器受限时帮助填补信息空缺,并提升整体场景理解能力。不过,当准确性、安全性或严格的可靠性要求至关重要时,不应将其作为唯一的深度信息来源。
要点总结#
单目深度估计是一种计算机视觉技术,使机器仅使用单张相机图像就能估计物体的距离。通过学习透视关系、物体大小、纹理和阴影等视觉线索,这些 AI 模型可以推断场景的 3D 结构,而无需依赖 LiDAR 或立体相机等传感器。这使单目深度估计成为自动驾驶、机器人和 3D 场景理解等应用中经济高效且可扩展的方法。
想进一步了解视觉 AI,请访问我们的 GitHub 仓库 并加入我们的 社区。查看我们的解决方案页面,了解 机器人领域的 AI 和 制造业中的计算机视觉。探索我们的许可选项,立即开始使用计算机视觉!








