Explorar os melhores conjuntos de dados de visão computacional em 2025
Vê mais de perto os melhores conjuntos de dados de visão computacional de 2025. Aprende como conjuntos de dados diversificados e de alta qualidade impulsionam soluções de IA visual mais inteligentes.
Você sabia que os dados têm um papel em quase tudo o que você faz diariamente? Assistir a um vídeo, tirar uma foto ou consultar o Google Maps contribui para o fluxo constante de informações capturadas por mais de 75 bilhões de dispositivos conectados. Esses dados formam a base da inteligência artificial (IA). Na verdade, modelos avançados de visão computacional, como o Ultralytics YOLO11, dependem de dados visuais para identificar padrões, interpretar imagens e compreender o mundo ao nosso redor.
Curiosamente, o valor dos dados não depende apenas da quantidade. A forma como são organizados e preparados é ainda mais importante. Se um conjunto de dados estiver desorganizado ou incompleto, isso pode levar a erros. No entanto, quando os conjuntos de dados são limpos e diversificados, ajudam os modelos de visão computacional a ter um desempenho melhor, seja no reconhecimento de objetos em uma multidão ou na análise de imagens complexas. Os conjuntos de dados de alta qualidade fazem toda a diferença.
Neste artigo, vamos explorar os melhores conjuntos de dados de visão computacional de 2025 e ver como eles contribuem para criar modelos de visão computacional mais precisos e eficientes. Vamos começar!
O que são conjuntos de dados de visão computacional?#
Um conjunto de dados de visão computacional é uma coleção de imagens ou vídeos que ajuda os sistemas de visão computacional a aprender a compreender e reconhecer informações visuais. Esses conjuntos de dados incluem rótulos ou anotações que ajudam os modelos a reconhecer objetos, pessoas, cenas e padrões nos dados.
Eles podem ser usados para treinar modelos de visão computacional, ajudando-os a melhorar em tarefas como identificar rostos, detectar objetos ou analisar cenas. Quanto melhor for o conjunto de dados — bem organizado, diversificado e preciso —, melhor será o desempenho do modelo de IA visual, levando a tecnologias mais inteligentes e úteis no dia a dia.
Como criar um conjunto de dados de visão computacional#
Criar um conjunto de dados de visão computacional é como preparar anotações de estudo para ensinar alguém a enxergar e compreender o mundo. Tudo começa pela coleta de imagens e vídeos adequados à aplicação específica que você está desenvolvendo.
Um conjunto de dados ideal inclui exemplos variados dos objetos de interesse, capturados de diferentes ângulos, em diversas condições de iluminação e com vários planos de fundo e ambientes. Essa variedade garante que o modelo de visão computacional aprenda a reconhecer padrões com precisão e tenha um desempenho confiável em situações do mundo real.
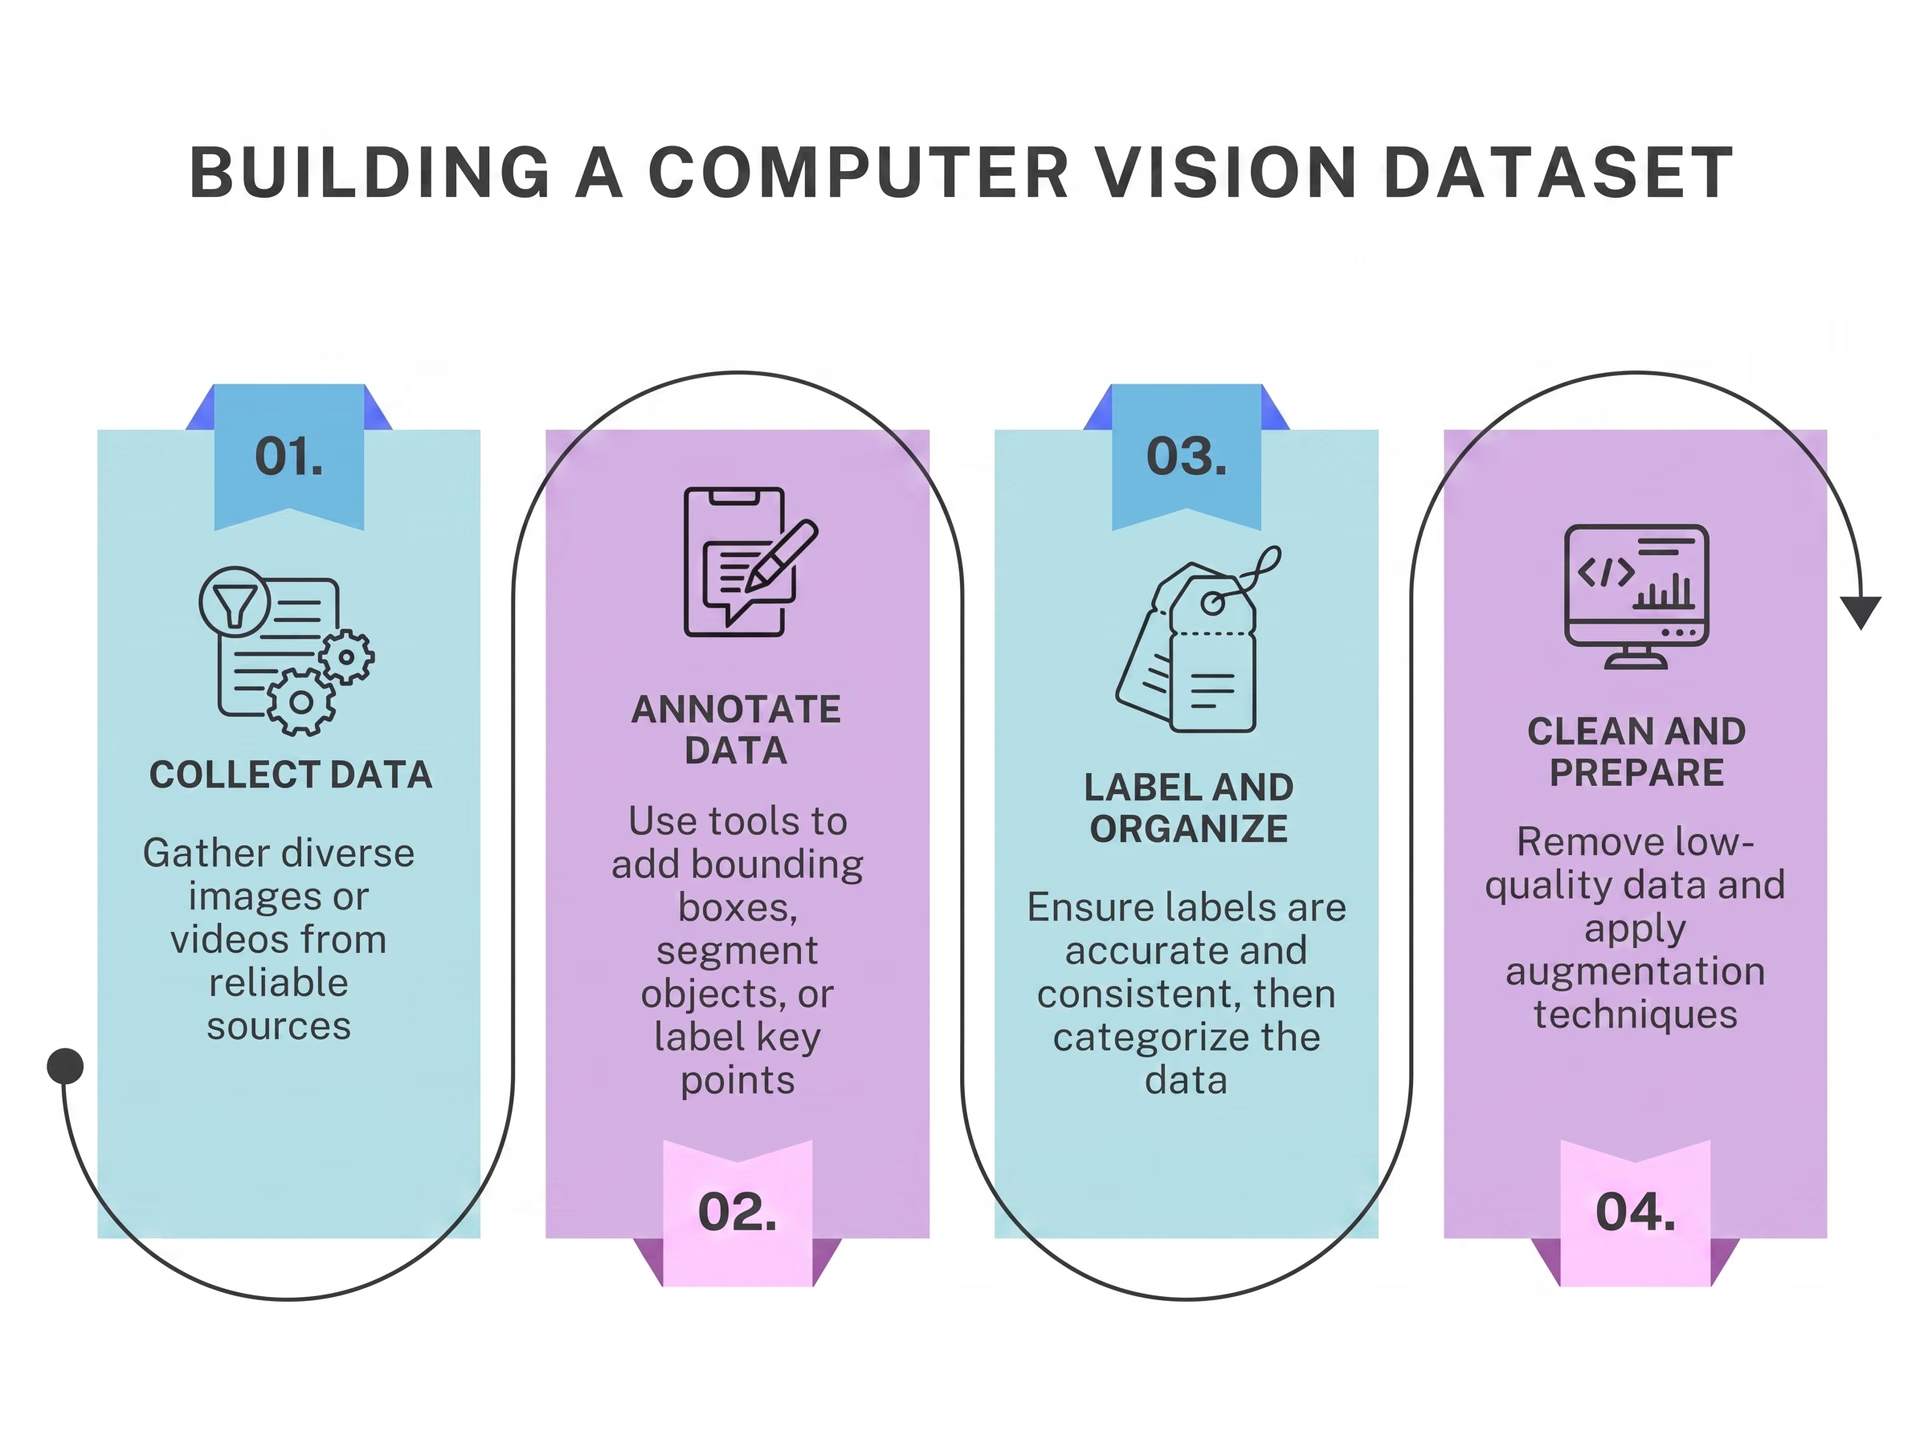
Fig. 1. Criando o conjunto de dados de visão ideal. Imagem do autor.
Depois de coletar imagens e vídeos relevantes, o próximo passo é a rotulagem de dados. Esse processo envolve adicionar etiquetas, anotações ou descrições aos dados para que a IA entenda o conteúdo de cada imagem ou vídeo.
Os rótulos podem incluir nomes de objetos, localizações, limites ou outros detalhes relevantes que ajudam a treinar o modelo para reconhecer e interpretar informações visuais com precisão. A rotulagem de dados transforma uma simples coleção de imagens em um conjunto de dados estruturado que pode ser usado para treinar um modelo de visão computacional.
O treinamento do modelo exige dados de alta qualidade#
Talvez você esteja se perguntando o que torna um conjunto de dados de alta qualidade. Há muitos fatores envolvidos, como rotulagem precisa, diversidade e consistência. Por exemplo, se vários anotadores estiverem rotulando um conjunto de dados de detecção de objetos para identificar orelhas de gato, um pode rotulá-las como parte da cabeça, enquanto outro pode rotulá-las separadamente como orelhas. Essa inconsistência pode confundir o modelo e afetar sua capacidade de aprender corretamente.
Veja um resumo rápido das qualidades de um conjunto de dados de visão computacional ideal:
- Rótulos claros: Cada imagem é anotada com precisão, usando rótulos consistentes e precisos.
- Dados diversificados: O conjunto de dados inclui diferentes objetos, planos de fundo, condições de iluminação e ângulos para ajudar o modelo a funcionar bem em diversas situações.
- Imagens de alta resolução: Imagens nítidas e detalhadas facilitam o aprendizado e o reconhecimento de características pelo modelo.
A Ultralytics oferece suporte a vários conjuntos de dados#
Os modelos Ultralytics YOLO, como o YOLO11, foram desenvolvidos para trabalhar com conjuntos de dados em um formato de arquivo YOLO específico. Embora seja fácil converter seus próprios dados para esse formato, também oferecemos uma opção simples para quem quer começar a experimentar sem demora.
O pacote Python da Ultralytics oferece suporte a uma ampla gama de conjuntos de dados de visão computacional, permitindo que você comece projetos com tarefas como detecção de objetos, segmentação de instâncias ou estimativa de pose sem nenhuma configuração adicional.
Os usuários podem acessar facilmente conjuntos de dados prontos para uso, como COCO, DOTA-v2.0, Open Images V7 e ImageNet, especificando o nome do conjunto de dados como um dos parâmetros na função de treinamento. Nesse caso, o conjunto de dados é baixado e pré-configurado automaticamente, para que você possa se concentrar em criar e aprimorar seus modelos.
Os 5 principais conjuntos de dados de visão computacional em 2025#
Os avanços em IA visual dependem de conjuntos de dados diversos e em grande escala, que impulsionam a inovação e possibilitam descobertas. Vamos conhecer alguns dos conjuntos de dados mais importantes, compatíveis com Ultralytics, que estão influenciando os modelos de visão computacional.
Conjunto de dados ImageNet#
ImageNet, criado por Fei-Fei Li e sua equipe na Universidade de Princeton em 2007 e apresentado em 2009, é um grande conjunto de dados com mais de 14 milhões de imagens rotuladas. Ele é amplamente usado para treinar sistemas a reconhecer e categorizar diferentes objetos. Sua estrutura organizada o torna especialmente útil para ensinar os modelos a classificar imagens com precisão. Embora seja bem documentado, ele se concentra principalmente na classificação de imagens e não oferece anotações detalhadas para tarefas como detecção de objetos.
Veja alguns dos principais pontos fortes do ImageNet:
- Diversidade: Com imagens que abrangem mais de 20.000 categorias, o ImageNet oferece um conjunto de dados vasto e variado, que aprimora o treinamento e a capacidade de generalização dos modelos.
- Organização estruturada: As imagens são categorizadas meticulosamente usando a hierarquia do WordNet, o que facilita a recuperação eficiente de dados e o treinamento sistemático de modelos.
- Documentação abrangente: Pesquisas extensas e anos de estudo tornam o ImageNet acessível tanto para iniciantes quanto para especialistas, oferecendo informações e orientações valiosas para projetos de visão computacional.
No entanto, como qualquer conjunto de dados, ele tem limitações. Veja alguns desafios a considerar:
- Exigências computacionais: Seu tamanho enorme pode representar um desafio para equipes menores com recursos computacionais limitados.
- Falta de dados temporais: Como contém apenas imagens estáticas, talvez não atenda às necessidades de aplicações que exigem vídeos ou dados temporais.
- Imagens desatualizadas: Algumas imagens do conjunto de dados são antigas e podem não refletir objetos, estilos ou ambientes atuais, reduzindo potencialmente sua relevância para aplicações modernas.
Conjunto de dados DOTA-v2.0#
O conjunto de dados DOTA-v2.0, em que DOTA significa Conjunto de dados para detecção de objetos em imagens aéreas, é uma coleção abrangente de imagens aéreas criada especialmente para a detecção de objetos com caixas delimitadoras orientadas (OBB). Na detecção OBB, são usadas caixas delimitadoras rotacionadas para se alinharem com mais precisão à orientação real dos objetos na imagem. Esse método funciona particularmente bem com imagens aéreas, nas quais os objetos costumam aparecer em vários ângulos, permitindo uma localização mais precisa e, em geral, uma detecção melhor.
Esse conjunto de dados contém mais de 11.000 imagens e mais de 1,7 milhão de caixas delimitadoras orientadas em 18 categorias de objetos. As imagens variam de 800×800 a 20.000×20.000 pixels e incluem objetos como aviões, navios e edifícios.
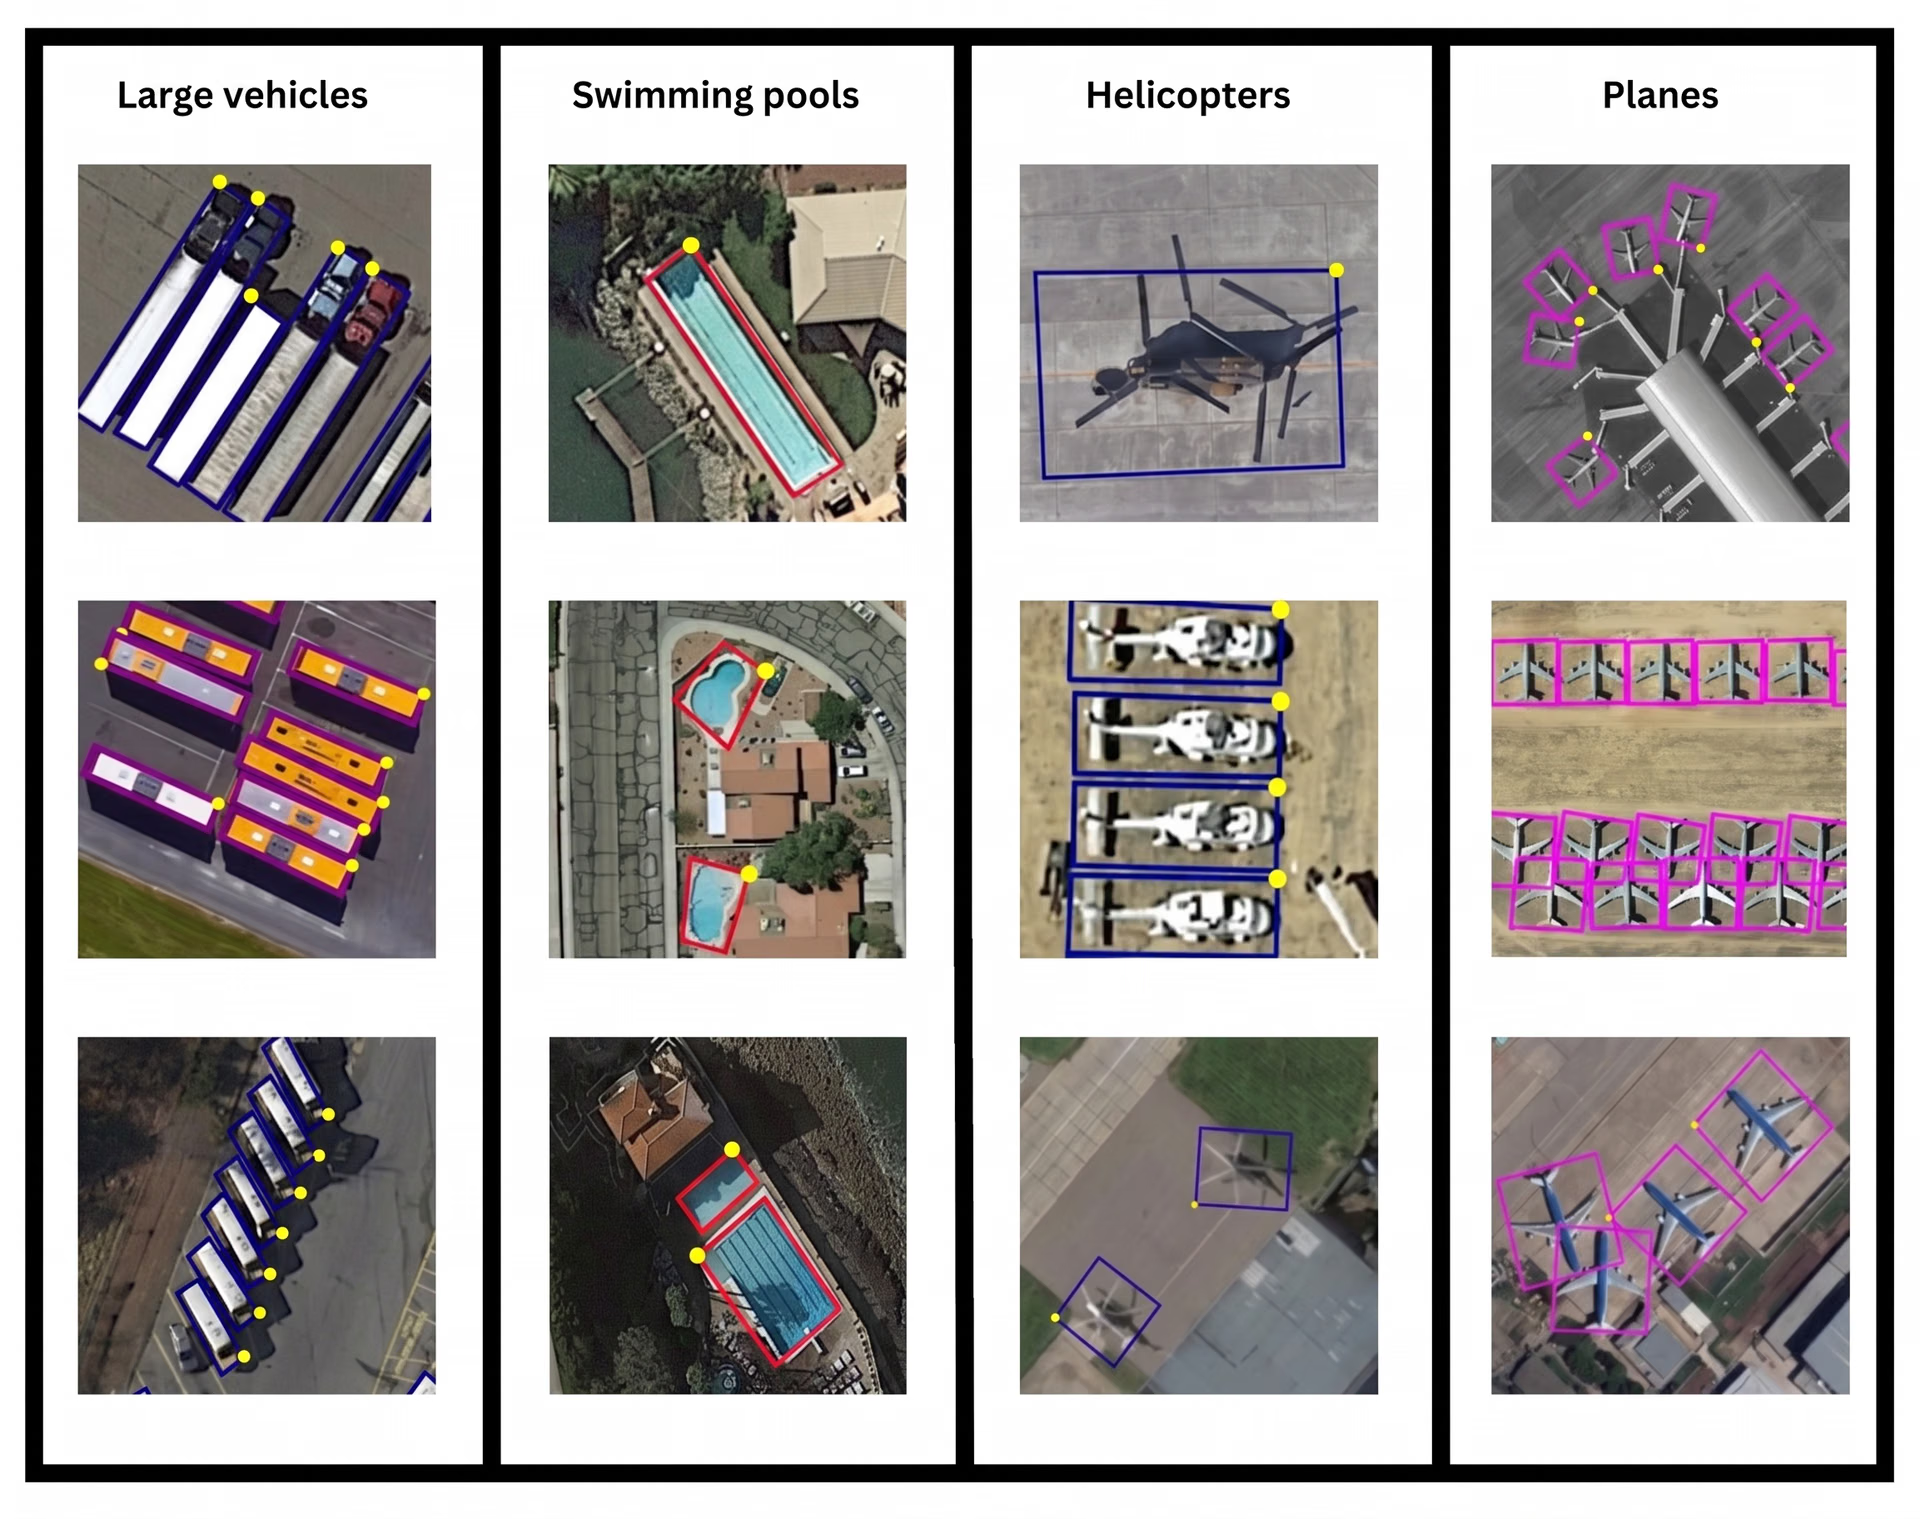
Fig. 2 Exemplos de imagens e anotações do conjunto de dados DOTA-v2.0. Imagem do autor.
Graças às suas anotações detalhadas, o DOTA-v2.0 se tornou uma opção popular para projetos de sensoriamento remoto e vigilância aérea. Veja algumas das principais características do DOTA-v2.0:
- Categorias de objetos diversas: Abrange muitos tipos diferentes de objetos, como veículos, portos e tanques de armazenamento, expondo os modelos a vários objetos do mundo real.
- Anotações de alta qualidade: Anotadores especialistas forneceram caixas delimitadoras orientadas com precisão, que mostram claramente as formas e direções dos objetos.
- Imagens multiescala: O conjunto de dados inclui imagens de diferentes tamanhos, ajudando os modelos a aprender a detectar objetos em escalas pequenas e grandes.
Embora o DOTA-v2 tenha muitos pontos fortes, veja algumas limitações que os usuários devem ter em mente:
- Etapas adicionais para baixar os dados: Devido à forma como o conjunto de dados DOTA é mantido, o DOTA-v2.0 exige uma etapa adicional de configuração. Primeiro, é preciso baixar as imagens do DOTA-v1.0 e, em seguida, adicionar as imagens extras e as anotações atualizadas do DOTA-v2.0 para completar o conjunto de dados.
- Anotações complexas: As caixas delimitadoras orientadas podem exigir mais esforço durante o treinamento dos modelos.
- Escopo limitado: O DOTA-v2 foi desenvolvido para imagens aéreas, o que o torna menos útil para tarefas gerais de detecção de objetos fora desse domínio.
Conjunto de dados Roboflow 100#
O conjunto de dados Roboflow 100 (RF100) foi criado pela Roboflow com o apoio da Intel. Ele pode ser usado para testar e avaliar o desempenho de modelos de detecção de objetos. Esse conjunto de dados de benchmark inclui 100 conjuntos de dados diferentes, selecionados entre mais de 90.000 conjuntos públicos. Ele contém mais de 224.000 imagens e 800 classes de objetos de áreas como saúde, imagens aéreas e jogos.
Veja algumas das principais vantagens do RF100:
- Ampla cobertura de domínios: Inclui conjuntos de dados de sete áreas, como imagens médicas, imagens aéreas e exploração subaquática.
- Incentiva o aprimoramento dos modelos: A variabilidade e os desafios específicos de cada domínio no RF100 revelam lacunas nos modelos atuais, direcionando a pesquisa para soluções de detecção de objetos mais adaptáveis e robustas.
- Formato de imagem consistente: Todas as imagens são redimensionadas para 640x640 pixels. Isso ajuda os usuários a treinar modelos sem precisar ajustar os tamanhos das imagens.
Apesar de seus pontos fortes, o RF100 também apresenta algumas desvantagens a considerar:
- Limitado quanto às tarefas: O RF100 foi desenvolvido para detecção de objetos, portanto não atende a tarefas como segmentação ou classificação.
- Foco em benchmarks: O RF100 foi desenvolvido principalmente como uma ferramenta de avaliação comparativa, e não para treinar modelos para aplicações do mundo real; por isso, seus resultados podem não se traduzir totalmente em cenários práticos de implantação.
- Variação nas anotações: Como o RF100 agrega conjuntos de dados coletados por crowdsourcing, pode haver inconsistências na qualidade das anotações e nas práticas de rotulagem, o que pode afetar a avaliação e o ajuste fino dos modelos.
Conjunto de dados COCO (Objetos comuns em contexto)#
O conjunto de dados COCO é um dos conjuntos de dados de visão computacional mais usados, com mais de 330.000 imagens e anotações detalhadas. Ele foi desenvolvido para detecção de objetos, segmentação e geração de legendas para imagens, o que o torna um recurso valioso para muitos projetos. Seus rótulos detalhados, que incluem caixas delimitadoras e máscaras de segmentação, ajudam os sistemas a aprender a analisar imagens com precisão.
Esse conjunto de dados é conhecido por sua flexibilidade e é útil para várias tarefas, de projetos simples a complexos. Ele se tornou um padrão na área de IA visual e é usado com frequência em desafios e competições para avaliar o desempenho dos modelos.
Entre seus pontos fortes estão:
- Dados diversos e realistas: O conjunto de dados inclui imagens de cenários do mundo real com vários objetos, oclusões e condições de iluminação variadas.
- Forte adesão da comunidade e da pesquisa: Usado em importantes competições de aprendizado de máquina e em pesquisas, o conjunto de dados COCO conta com documentação extensa, modelos pré-treinados e uma comunidade ativa que oferece suporte.
- Anotações detalhadas e abrangentes: O conjunto de dados COCO fornece anotações muito detalhadas, incluindo segmentação de objetos, pontos-chave e legendas, o que o torna ideal para projetos que exigem compreensão visual precisa.
Veja também alguns fatores limitantes que você deve conhecer:
- Altas exigências computacionais: Devido ao seu tamanho e à sua complexidade, treinar modelos com o COCO pode exigir recursos computacionais significativos, o que representa um desafio para equipes com hardware limitado.
- Desequilíbrio dos dados: Algumas categorias de objetos têm significativamente mais imagens do que outras, o que pode gerar viés no treinamento dos modelos.
- Estrutura complexa de anotações: As anotações detalhadas do conjunto de dados são valiosas, mas podem ser difíceis de lidar para iniciantes ou equipes menores sem experiência no trabalho com conjuntos de dados estruturados de IA visual.
Conjunto de dados Open Images V7#
O Open Images V7 é um enorme conjunto de dados de código aberto organizado pelo Google, com mais de 9 milhões de imagens anotadas para 600 categorias de objetos. Ele inclui vários tipos de anotação e é ideal para lidar com tarefas complexas de visão computacional. Sua escala e profundidade oferecem um recurso abrangente para treinar e testar modelos de visão computacional.
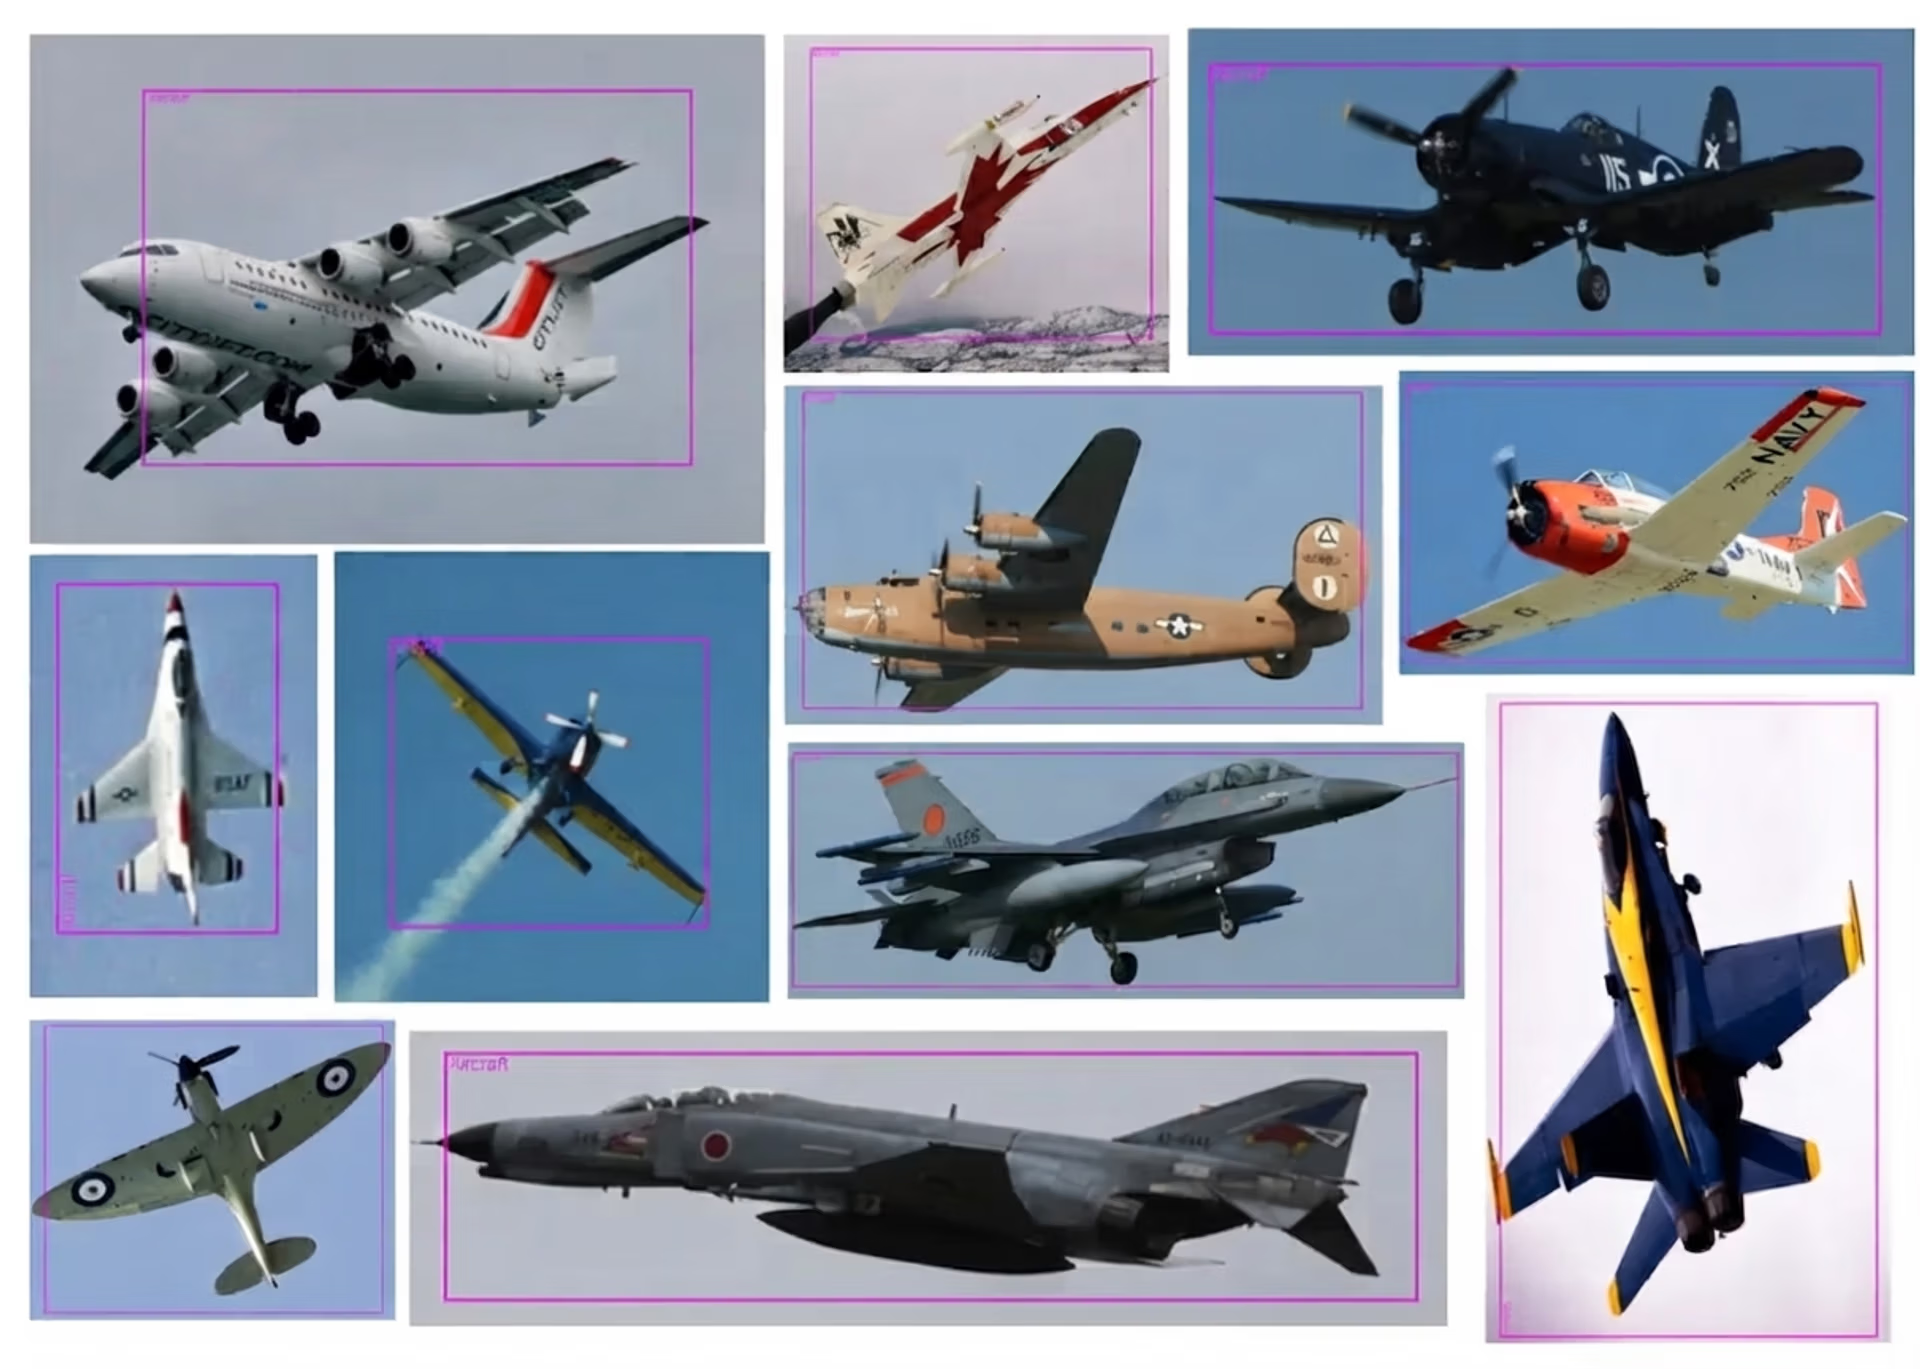
Fig. 3 Uma prévia do conjunto de dados Open Images V7. Imagem do autor.
Além disso, a popularidade do conjunto de dados Open Images V7 na pesquisa oferece muitos recursos e exemplos para os usuários aprenderem. No entanto, seu tamanho enorme pode tornar o download e o processamento demorados, especialmente para equipes menores. Outro problema é que algumas anotações podem ser inconsistentes, exigindo esforço adicional para limpar os dados; além disso, a integração nem sempre é simples, o que pode exigir preparação extra.
Como escolher o conjunto de dados certo#
Escolher o conjunto de dados certo é uma etapa importante para preparar seu projeto de visão computacional para o sucesso. A melhor opção depende da sua tarefa específica: encontrar uma boa combinação ajuda o modelo a aprender as habilidades certas. O conjunto também deve se integrar facilmente às suas ferramentas, para que você possa se concentrar mais em desenvolver o modelo e menos em solucionar problemas.
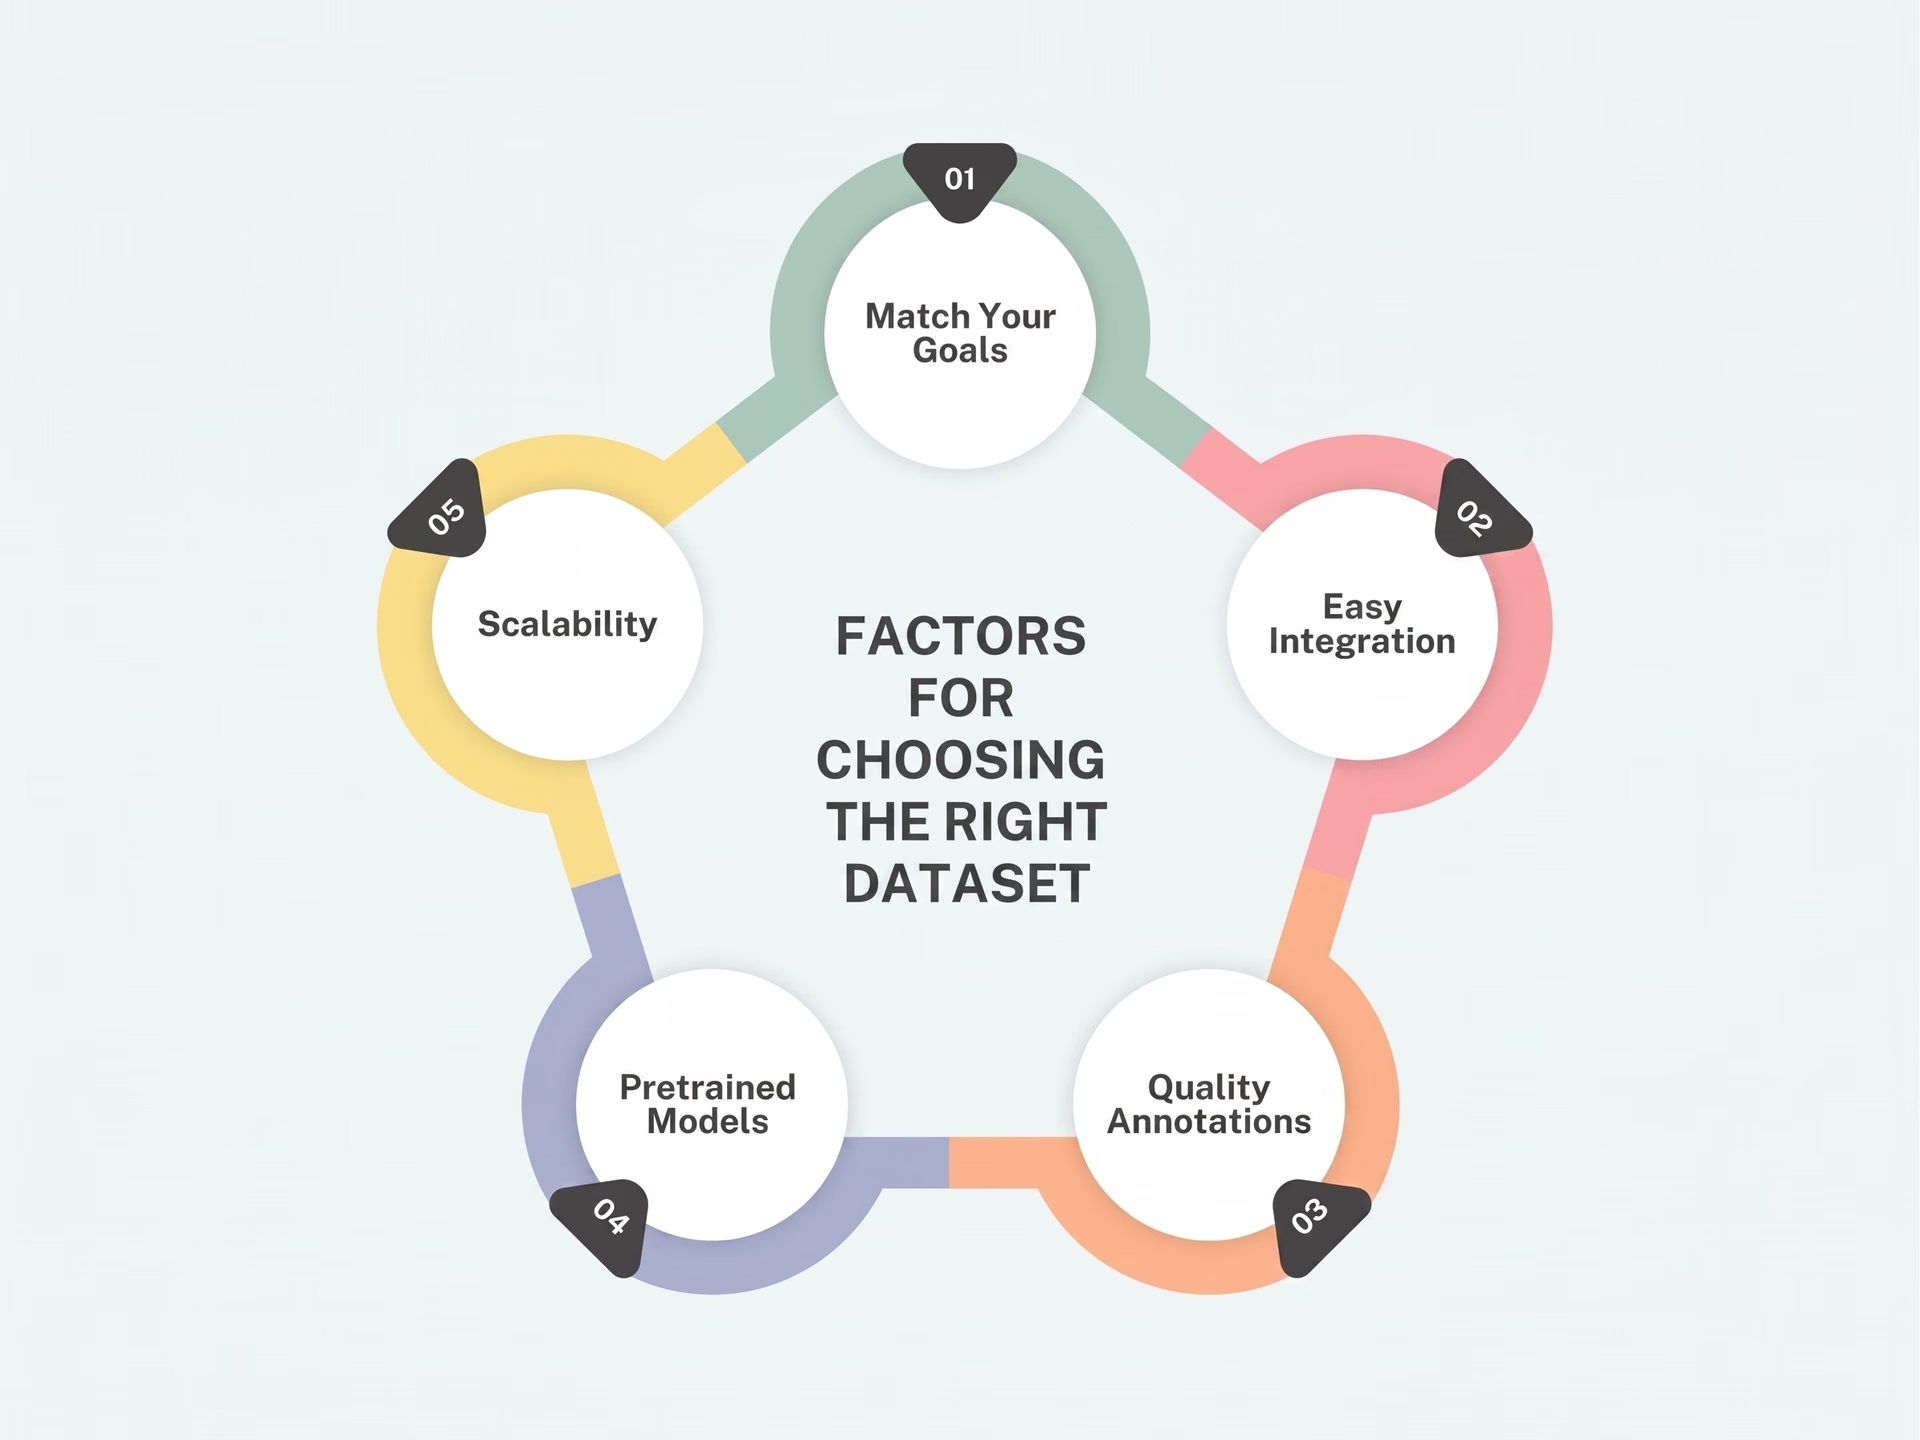
Fig. 4. Fatores para escolher o conjunto de dados certo. Imagem do autor.
Principais conclusões#
Conjuntos de dados de alta qualidade são a base de qualquer modelo de visão computacional e ajudam os sistemas a aprender a interpretar imagens com precisão. Conjuntos de dados diversos e bem anotados são especialmente importantes, pois permitem que os modelos tenham um desempenho confiável em cenários do mundo real e reduzem os erros causados por dados limitados ou de baixa qualidade.
A Ultralytics simplifica o acesso e o trabalho com conjuntos de dados de visão computacional, facilitando a busca dos dados certos para seu projeto. Escolher o conjunto de dados certo é uma etapa fundamental para criar um modelo de alto desempenho e obter resultados mais precisos e impactantes.
Participe da nossa comunidade e explore nosso repositório no GitHub para saber mais sobre IA. Conheça avanços como visão computacional na área da saúde e IA em carros autônomos nas nossas páginas de soluções. Confira nossas opções de licenciamento e dê hoje o primeiro passo para começar a trabalhar com visão computacional!









