Conheça o Llama 3 da Meta
Conheça o Llama 3 da Meta, o LLM de pesos abertos lançado em abril de 2024: as variantes 8B e 70B, a arquitetura, o treino em grande escala e os resultados de benchmarks.
 Abirami Vina9 min de leitura
Quando recapitulamos as inovações de inteligência artificial (AI) do primeiro trimestre de 2024, vimos que LLMs, ou modelos de linguagem grandes, estavam sendo lançados a todo momento por diferentes organizações. Seguindo essa tendência, em 18 de abril de 2024, a Meta lançou o Llama 3, um LLM de código aberto de última geração e nível avançado.
Talvez você esteja pensando: É só mais um LLM. Por que a comunidade de IA está tão empolgada com ele?
Embora seja possível ajustar modelos como GPT-3 ou Gemini para gerar respostas personalizadas, eles não oferecem transparência total sobre seu funcionamento interno, como os dados de treinamento, os parâmetros do modelo ou os algoritmos. Em contrapartida, o Llama 3 da Meta é mais transparente, com sua arquitetura e seus pesos disponíveis para download. Para a comunidade de IA, isso significa mais liberdade para experimentar.
Neste artigo, vamos aprender o que o Llama 3 pode fazer, como surgiu e qual é o seu impacto no campo da AI.
A evolução dos modelos Llama da Meta#
Antes de nos aprofundarmos no Llama 3, vamos relembrar suas versões anteriores.
A Meta lançou o Llama 1 em fevereiro de 2023, com quatro variantes que tinham de 7 bilhões a 65 bilhões de parâmetros. Em aprendizado de máquina, "parâmetros" são os elementos do modelo que são aprendidos a partir dos dados de treinamento. Por ter menos parâmetros, o Llama 1 às vezes tinha dificuldade para compreender nuances e apresentava respostas inconsistentes.
Pouco depois do Llama 1, a Meta lançou o Llama 2 em julho de 2023. Ele foi treinado com 2 trilhões de tokens. Um token representa um trecho de texto, como uma palavra ou parte de uma palavra, usado como unidade básica de dados para o processamento pelo modelo. O modelo também trouxe melhorias, como uma janela de contexto duplicada, de 4096 tokens, para compreender passagens mais longas, e mais de 1 milhão de anotações humanas para reduzir erros. Apesar dessas melhorias, o Llama 2 ainda precisava de muito poder computacional, algo que a Meta buscou resolver com o Llama 3.
Conheça o Llama 3 da Meta#
O Llama 3 tem quatro variantes, treinadas com o impressionante total de 15 trilhões de tokens. Mais de 5% desses dados de treinamento eram dados de alta qualidade em idiomas diferentes do inglês, abrangendo mais de 30 idiomas. Todas as variantes do Llama 3 podem ser executadas em vários tipos de hardware de consumo e têm um comprimento de contexto de 8 mil tokens.
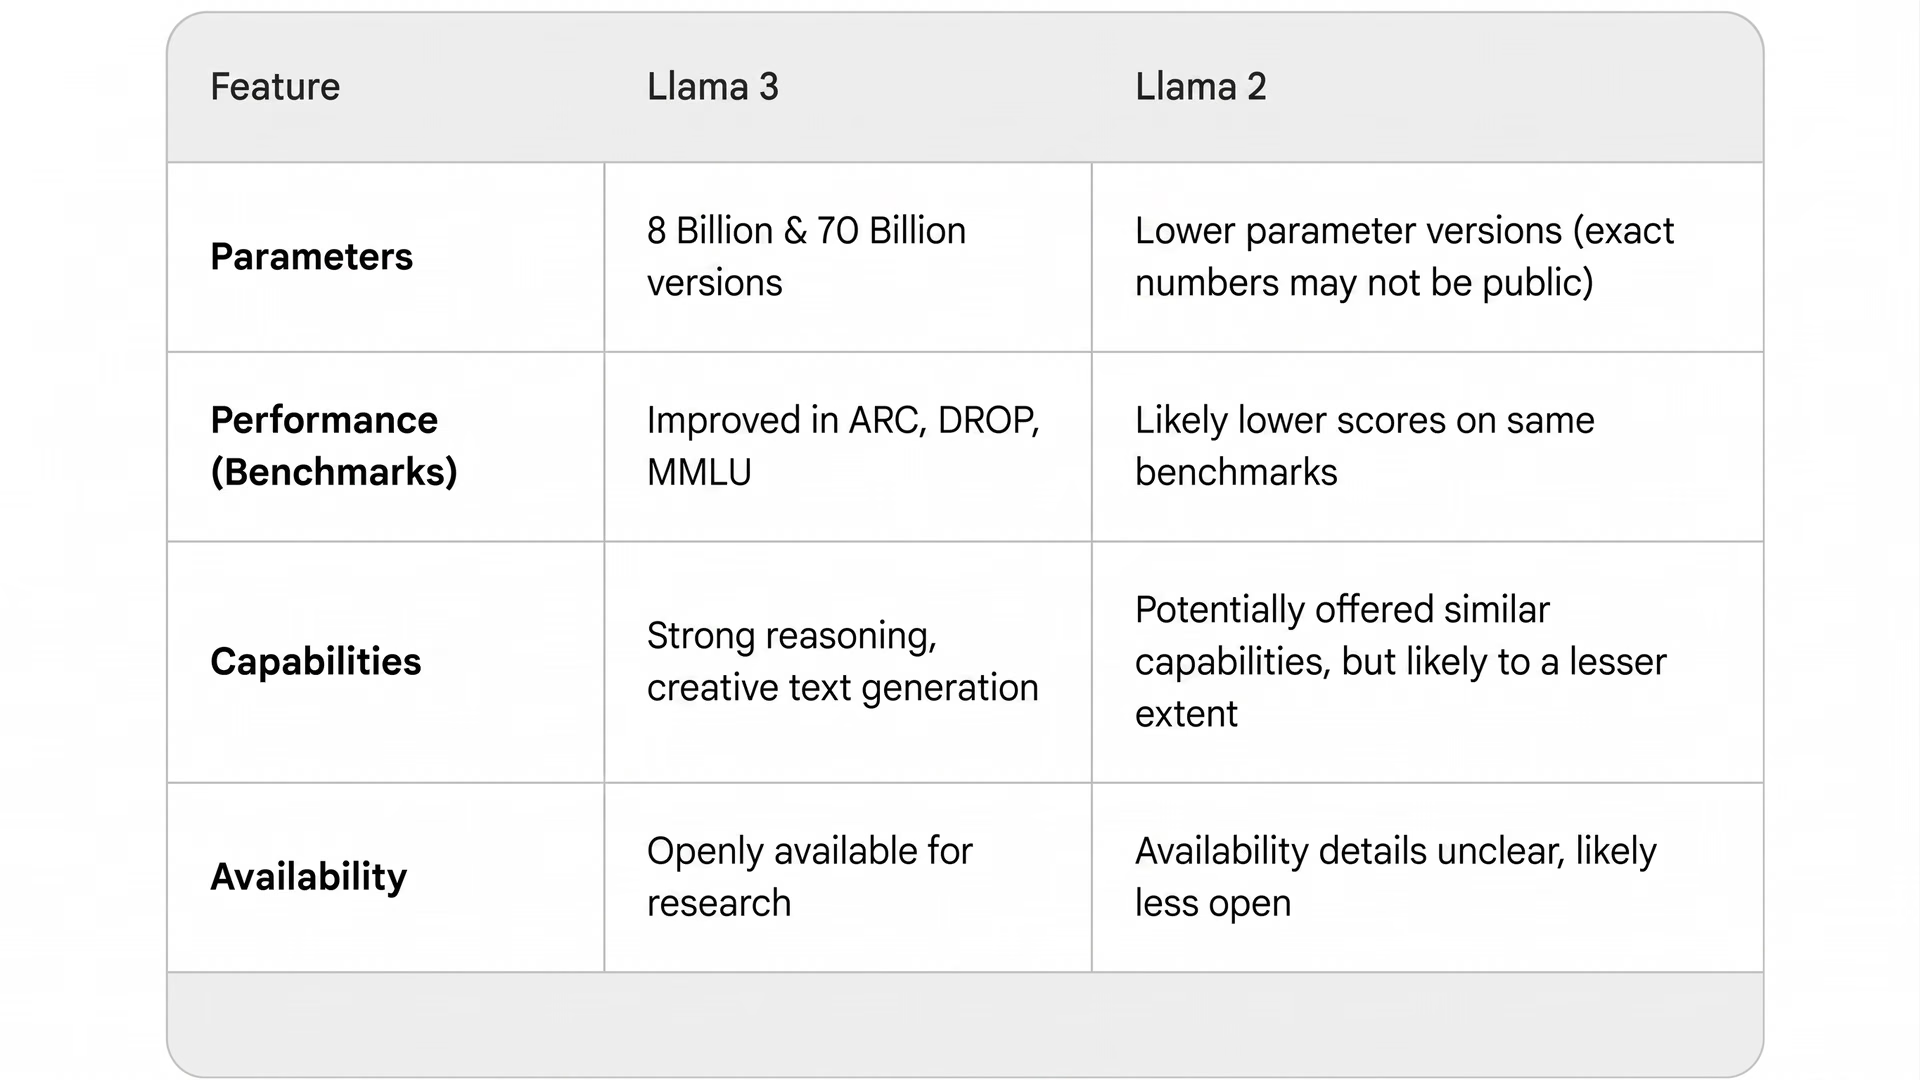
Fig. 1. Llama 3 vs. Llama 2.
As variantes do modelo estão disponíveis em dois tamanhos: 8B e 70B, que representam 8 bilhões e 70 bilhões de parâmetros, respectivamente. Também há duas versões: base e instruct. "Base" se refere à versão pré-treinada padrão. "Instruct" é uma versão ajustada para seguir instruções e otimizada para casos de uso em diálogos.
Estas são as variantes do modelo Llama 3:
- Meta-Llama-3-8b: O modelo base 8B oferece recursos fundamentais de IA e é ideal para tarefas gerais, como desenvolver chatbots de atendimento ao cliente.
- Meta-Llama-3-8b-instruct: Uma versão do modelo 8B ajustada com instruct e otimizada para tarefas específicas. Por exemplo, pode ser usada para criar ferramentas educacionais que explicam assuntos complexos.
- Meta-Llama-3-70b: O modelo base 70B foi projetado para aplicações de IA de alto desempenho. Esse modelo seria adequado para aplicações como analisar extensos textos biomédicos para descoberta de medicamentos.
- Meta-Llama-3-70b-instruct: Esta versão foi ajustada a partir do modelo 70B para aplicações de elevada precisão, como a análise de documentos jurídicos ou médicos, em que a exatidão é fundamental.
A arquitetura do modelo Llama 3 da Meta#
Assim como em outros avanços da Meta AI, foram implementadas medidas rigorosas de controle de qualidade para manter a integridade dos dados e minimizar vieses durante o desenvolvimento do Llama 3. Assim, o resultado é um modelo poderoso criado de forma responsável.
A arquitetura do modelo Llama 3 se destaca pelo foco em eficiência e desempenho em tarefas de processamento de linguagem natural. Construída com base em uma estrutura Transformer, ela prioriza a eficiência computacional, especialmente durante a geração de texto, usando uma arquitetura apenas com decodificador.
O modelo gera resultados exclusivamente com base no contexto anterior, sem um codificador separado, o que mantém a geração de texto eficiente.
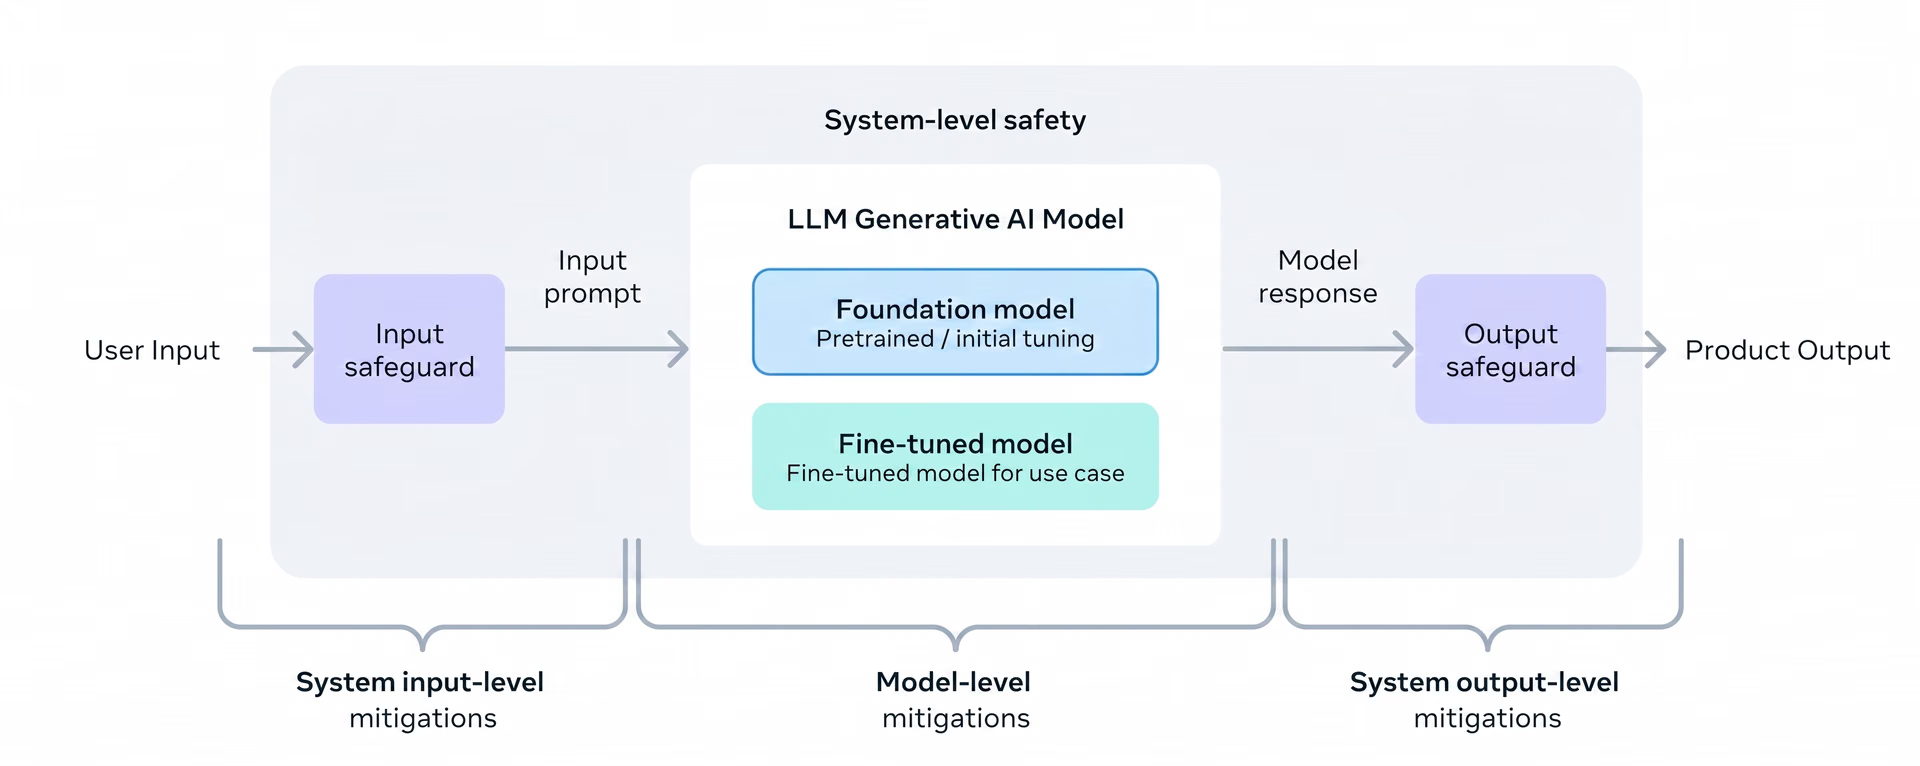
Fig. 2. Arquitetura responsável do modelo Llama 3.
Os modelos Llama 3 incluem um tokenizador com um vocabulário de 128 mil tokens. Um vocabulário mais amplo permite que os modelos compreendam e processem melhor o texto. Além disso, os modelos usam agora atenção de consulta agrupada (GQA) para melhorar a eficiência da inferência. A GQA permite que grupos de cabeças de atenção partilhem as mesmas chaves e valores, reduzindo a utilização de memória e acelerando a geração de texto com pouca perda de qualidade.
Veja mais alguns detalhes interessantes sobre a arquitetura do modelo Llama 3:
- Processamento de documentos com atenção aos limites: o Llama 3 mantém a clareza entre os limites dos documentos, algo essencial para tarefas como sumarização.
- Melhor compreensão de código: os dados de treinamento do Llama 3 incluem quatro vezes mais amostras de código, aprimorando suas capacidades de programação.
- Controle de qualidade robusto: medidas rigorosas, incluindo filtros heurísticos e a remoção de conteúdo NSFW, garantem a integridade dos dados e minimizam vieses.
O Llama 3 está transformando nossa abordagem ao treinamento de modelos#
Para treinar os maiores modelos Llama 3, foram combinados três tipos de paralelização: paralelização de dados, paralelização de modelo e paralelização de pipeline.
A paralelização de dados divide os dados de treinamento entre várias GPUs, enquanto a paralelização de modelo particiona a arquitetura do modelo para aproveitar o poder computacional de cada GPU. A paralelização de pipeline divide o processo de treinamento em etapas sequenciais, otimizando a computação e a comunicação.
A implementação mais eficiente alcançou uma elevada utilização computacional, ultrapassando 400 TFLOPS por GPU quando foi treinada simultaneamente em 16 000 GPUs. Estas execuções de treino foram realizadas em dois clusters de GPU construídos à medida, cada um com 24 000 GPUs. Esta infraestrutura computacional substancial forneceu a potência necessária para treinar eficientemente os modelos Llama 3 de grande escala.
Para maximizar o tempo de atividade das GPUs, foi desenvolvido um novo conjunto avançado de ferramentas de treinamento, que automatiza a detecção e o tratamento de erros, além da manutenção. A confiabilidade do hardware e os mecanismos de detecção foram bastante aprimorados para mitigar os riscos de corrupção silenciosa de dados. Também foram desenvolvidos novos sistemas de armazenamento escaláveis para reduzir a sobrecarga de criação de checkpoints e reversão.
Estas melhorias permitiram alcançar um tempo de treino efetivo superior a 95%. Em conjunto, aumentaram cerca de três vezes a eficiência do treino do Llama 3 em comparação com o Llama 2. Esta eficiência abre novas possibilidades para os métodos de treino de AI.
Abrindo portas com o Llama 3#
Como o Llama 3 é de código aberto, investigadores e estudantes podem estudar o seu código, fazer experiências e participar em debates sobre questões éticas e enviesamentos. No entanto, o Llama 3 não se destina apenas ao meio académico. Também é utilizado em aplicações práticas. Está a tornar-se a base da interface de chat Meta AI, integrada em plataformas como o Facebook, o Instagram, o WhatsApp e o Messenger. Com a Meta AI, os utilizadores podem conversar em linguagem natural, receber recomendações personalizadas, realizar tarefas e estabelecer contactos com outras pessoas facilmente.
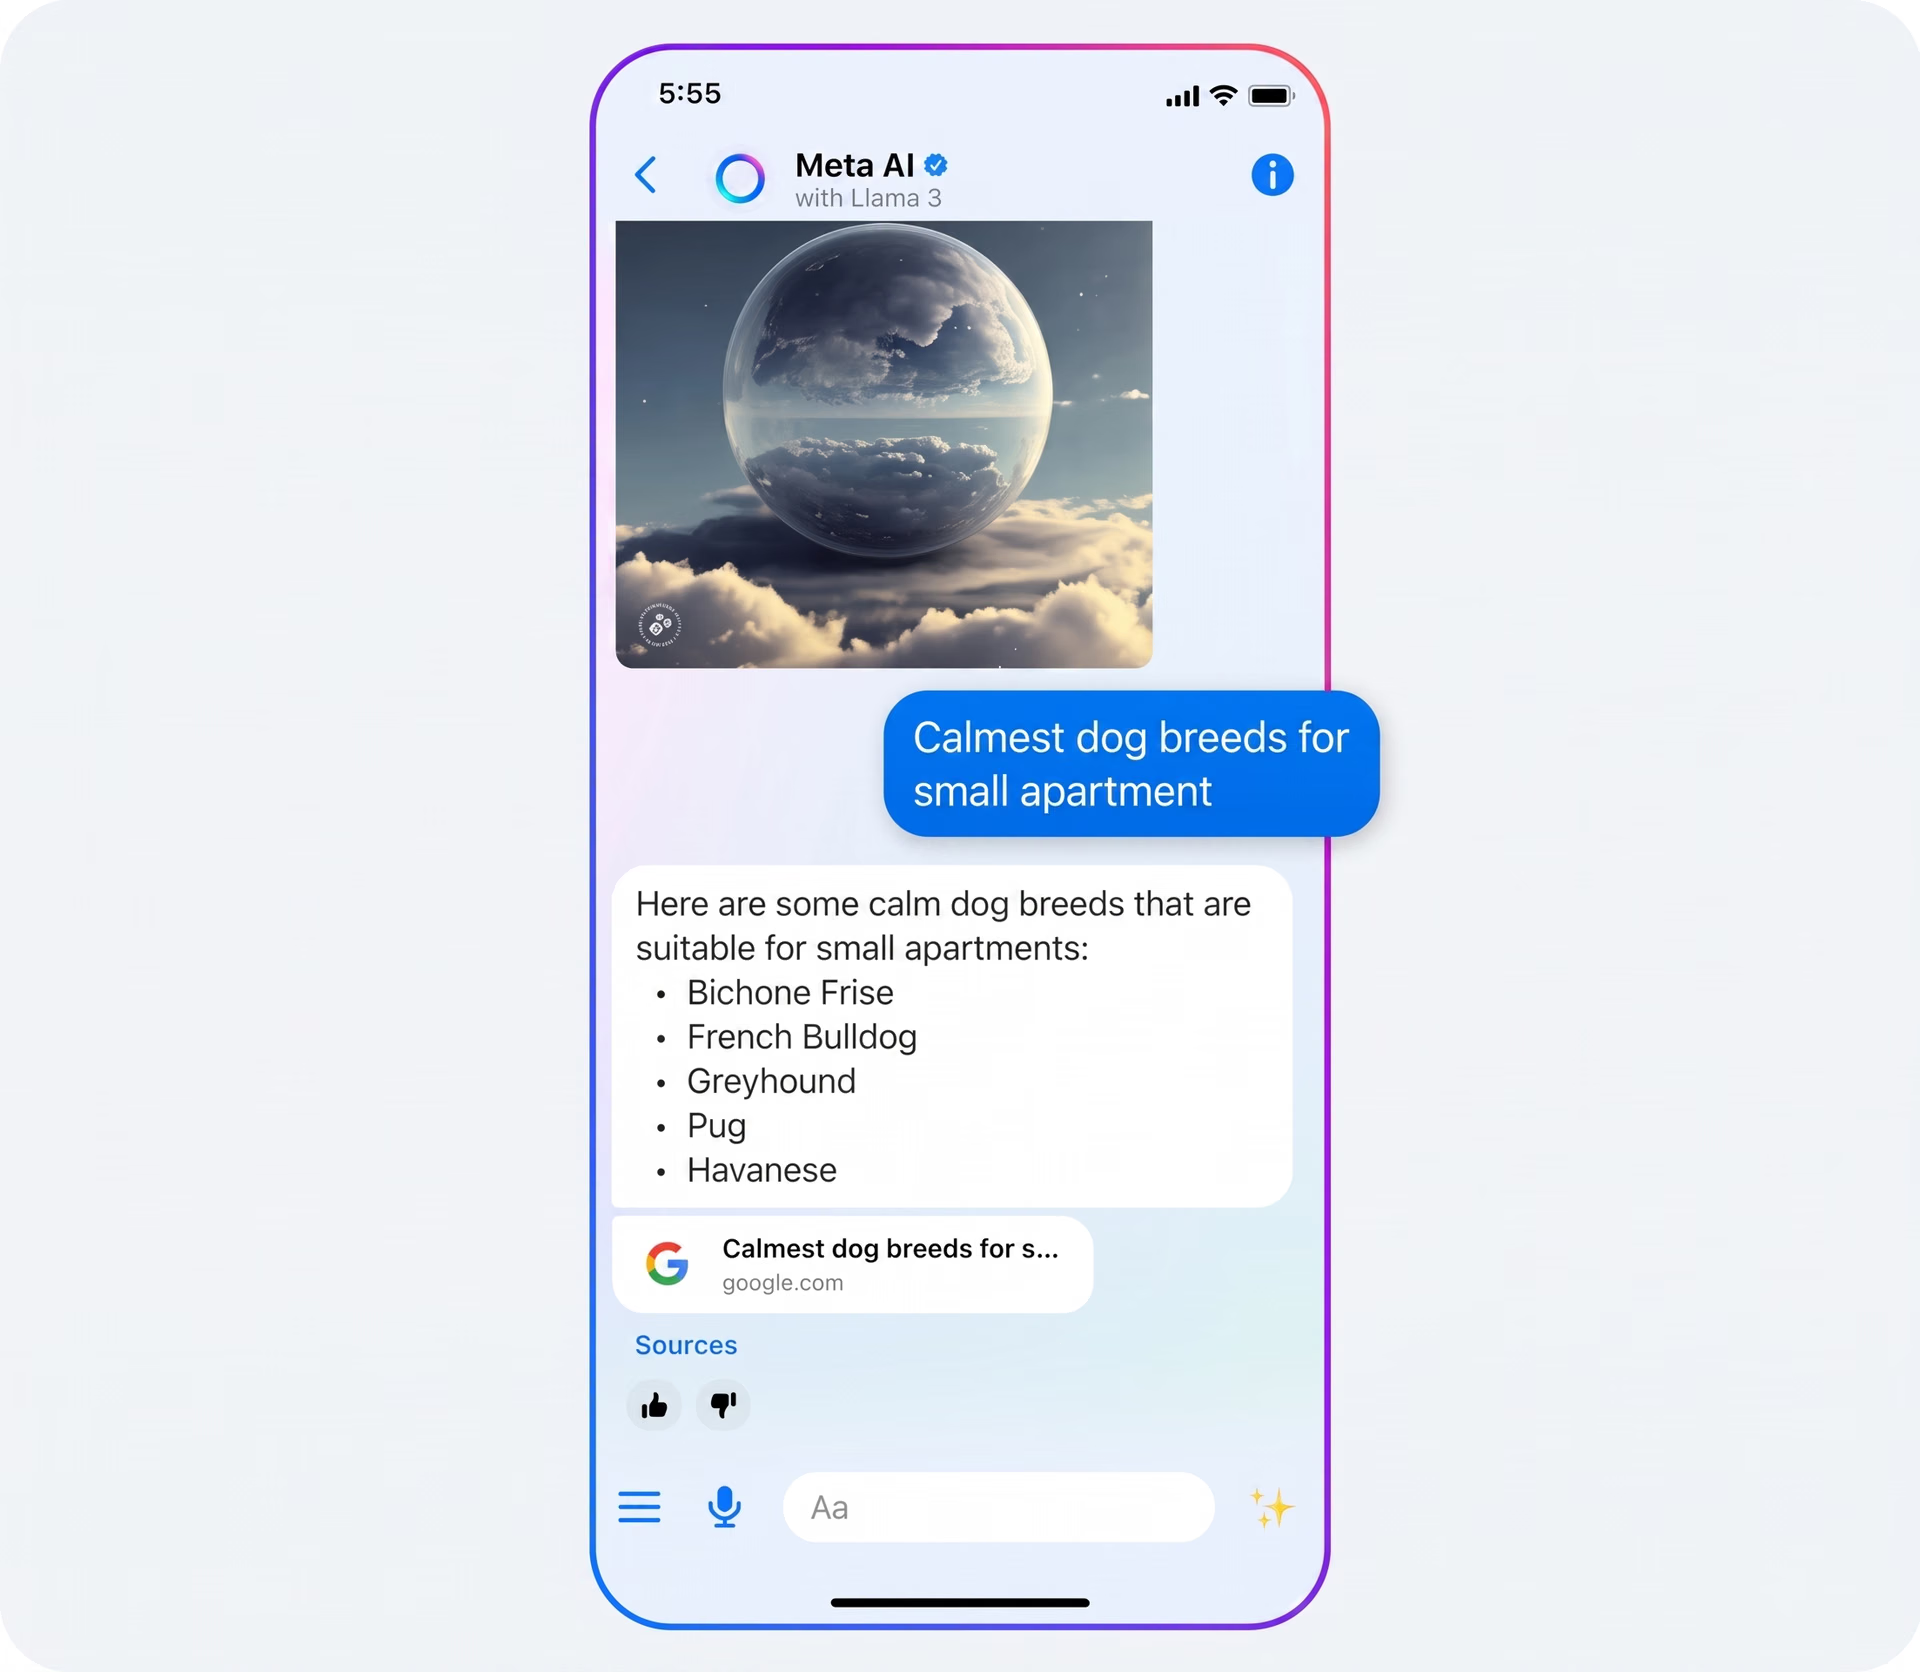
Fig. 3. Meta AI: com tecnologia Llama 3.
Comparação do Llama 3 com outros LLMs#
O Llama 3 tem um bom desempenho em vários benchmarks importantes que avaliam capacidades complexas de compreensão da linguagem e raciocínio. Eis alguns benchmarks que testam diferentes aspetos das capacidades do Llama 3:
- Compreensão de Linguagem em Multitarefas em Larga Escala (MMLU) - Avalia o conhecimento do modelo em diversos domínios.
- Perguntas e respostas de nível de pós-graduação à prova do Google (GPQA) - Avalia a capacidade do modelo para responder a perguntas difíceis de nível de pós-graduação em biologia, física e química.
- HumanEval - Concentra-se em tarefas de programação e resolução de problemas, testando a capacidade do modelo de gerar código funcional e resolver desafios algorítmicos.
Os excelentes resultados do Llama 3 nestes testes distinguem-no claramente de concorrentes como o Gemma 7B da Google, o Mistral 7B da Mistral e o Claude 3 Sonnet da Anthropic. De acordo com as estatísticas publicadas, em particular o modelo 70B do Llama 3 supera estes modelos em todos os benchmarks acima.
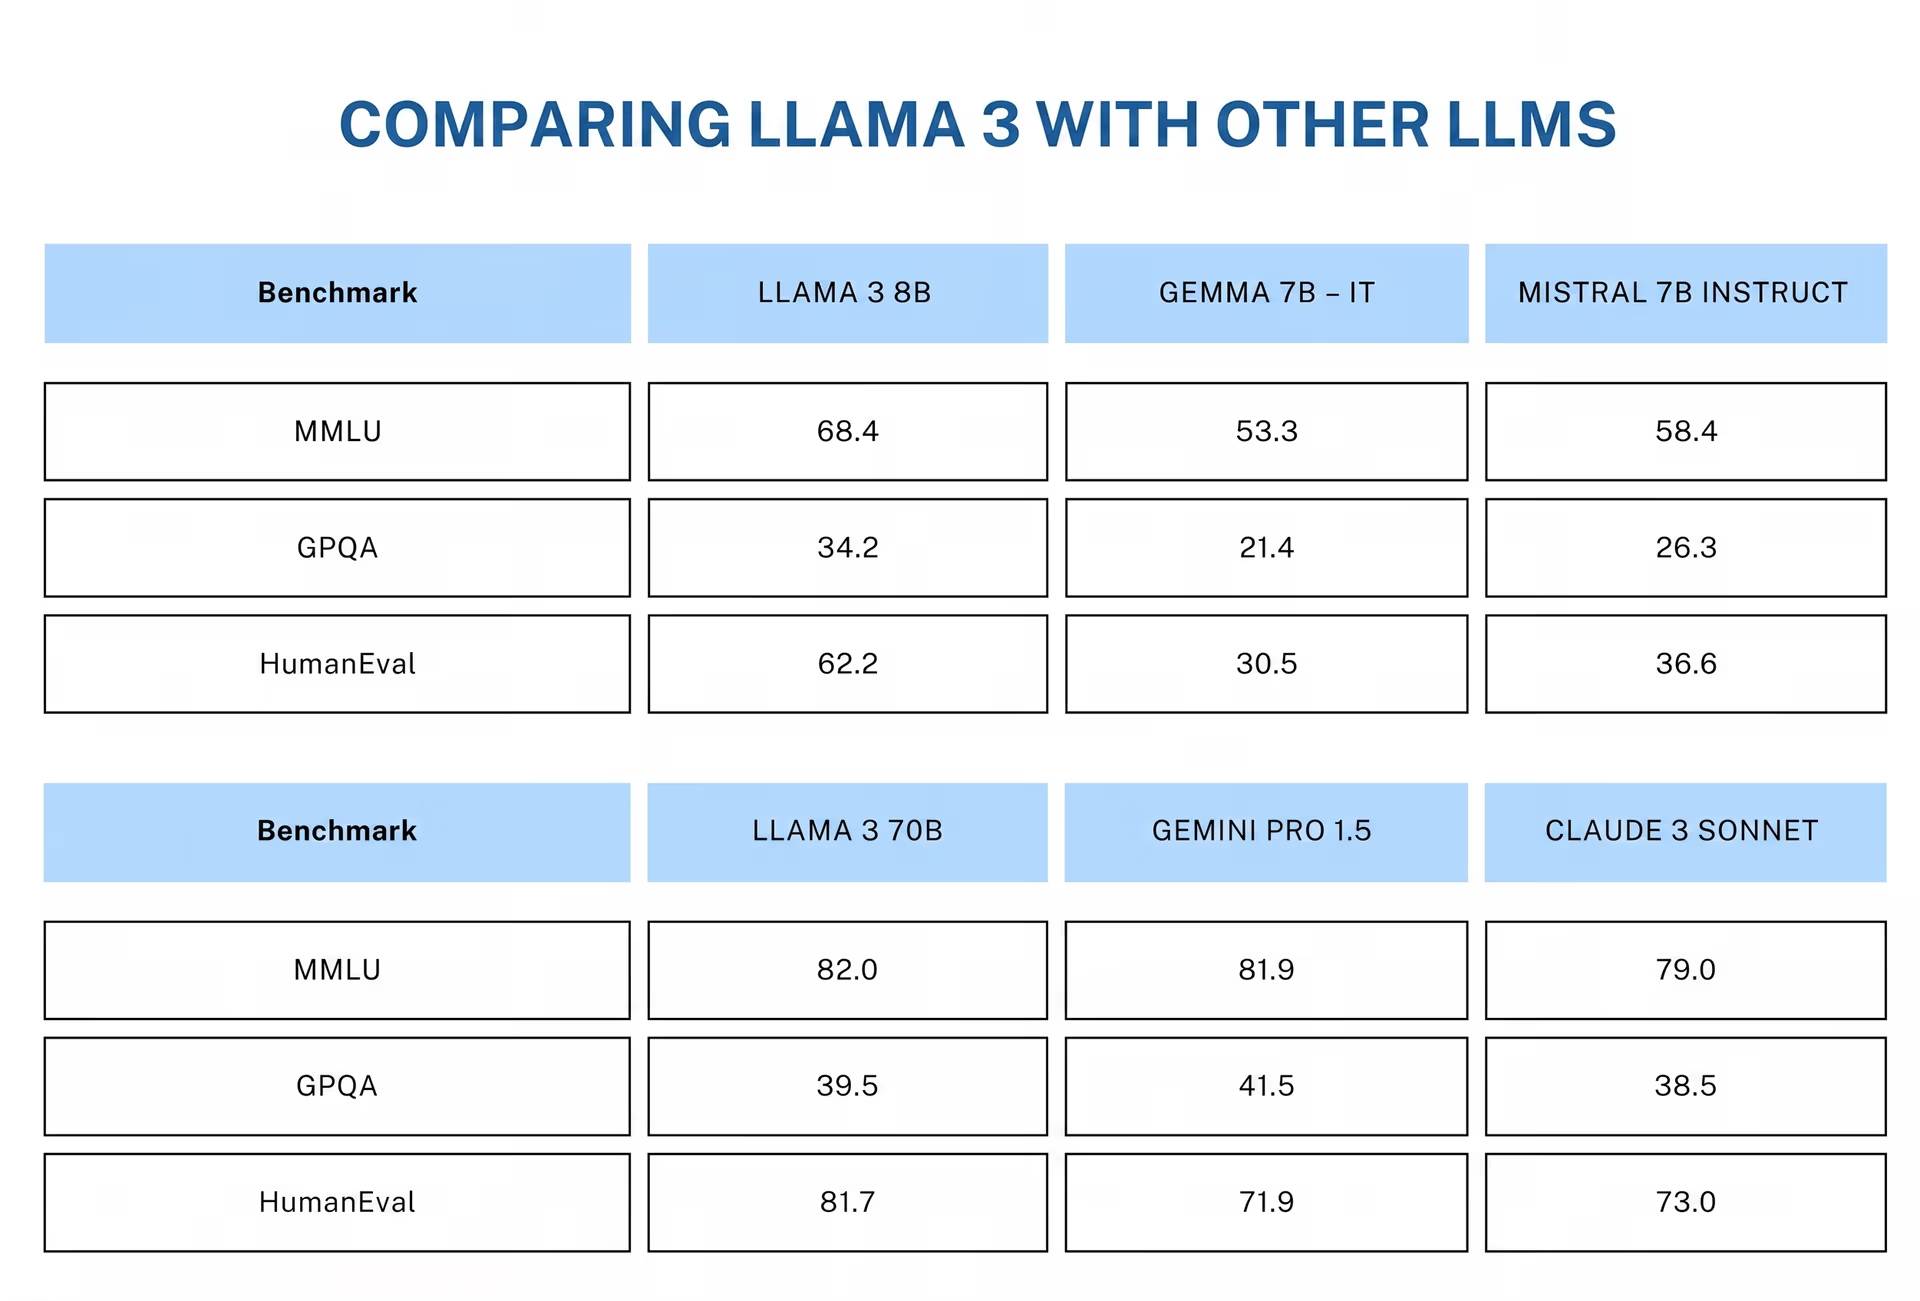
Fig. 4. Comparação do Llama 3 com outros LLMs.
O Meta Llama 3 está se tornando amplamente acessível#
A Meta está ampliando o alcance do Llama 3, disponibilizando-o em várias plataformas para usuários em geral e desenvolvedores. Para o dia a dia, o Llama 3 está integrado a plataformas populares da Meta, como WhatsApp, Instagram, Facebook e Messenger. Os usuários podem acessar recursos avançados, como busca em tempo real e geração de conteúdo criativo, diretamente nesses aplicativos.
O Llama 3 também está sendo incorporado a tecnologias vestíveis, como os óculos inteligentes Ray-Ban Meta e o headset de realidade virtual Meta Quest, para proporcionar experiências interativas.
O Llama 3 está disponível em várias plataformas para desenvolvedores, incluindo AWS, Databricks, Google Cloud, Hugging Face, Kaggle, IBM WatsonX, Microsoft Azure, NVIDIA NIM e Snowflake. Você também pode acessar esses modelos diretamente pela Meta. A grande variedade de opções facilita a integração dos recursos avançados desses modelos de IA aos projetos dos desenvolvedores, seja trabalhando diretamente com a Meta ou por meio de outras plataformas populares.
Conclusão#
Os avanços em aprendizado de máquina continuam transformando a forma como interagimos com a tecnologia todos os dias. O Llama 3 da Meta mostra que os LLMs já não se limitam a gerar texto. Os LLMs estão resolvendo problemas complexos e lidando com vários idiomas. De modo geral, o Llama 3 está tornando a IA mais adaptável e acessível do que nunca. As atualizações planejadas para o Llama 3 prometem ainda mais recursos, como multimodalidade e janelas de contexto mais longas.
Confira nosso repositório no GitHub e participe da nossa comunidade para saber mais sobre IA. Acesse nossas páginas de soluções para ver como a IA está sendo aplicada em áreas como manufatura e agricultura.
Escrito por
Criador de conteúdo · Ultralytics
Comentários
Faça uma pergunta, compartilhe seus resultados ou ajude alguém.









