Por que o Ultralytics YOLO26 remove o NMS e como isso muda a implantação
Descobre como o Ultralytics YOLO26 possibilita inferência verdadeiramente ponta a ponta e sem NMS, e por que remover o pós-processamento simplifica a exportação e a implantação na borda.
Em 14 de janeiro, lançámos o Ultralytics YOLO26, a geração mais recente dos nossos modelos de visão computacional. Com o YOLO26, o nosso objetivo não era apenas melhorar a precisão ou a velocidade, mas repensar a forma como os modelos de deteção de objetos são criados e implementados em sistemas reais.
À medida que a visão computacional passa da investigação para a produção, espera-se cada vez mais que os modelos funcionem em CPUs, dispositivos de edge, câmaras, robôs e hardware incorporado. Nestes ambientes, a fiabilidade, a baixa latência e a facilidade de implementação são tão importantes quanto o desempenho.
O Ultralytics YOLO26 foi concebido tendo esta realidade em mente, com uma arquitetura end-to-end simplificada que elimina complexidade desnecessária do pipeline de inferência. Uma das inovações mais importantes do YOLO26 é a remoção da supressão não máxima, normalmente conhecida como NMS.
Durante anos, a NMS foi uma parte padrão dos sistemas de deteção de objetos, usada como etapa de pós-processamento para eliminar deteções duplicadas. Embora seja eficaz, também acrescentava computação e desafios de implementação, especialmente em hardware de edge.
Com o YOLO26, adotámos uma abordagem diferente. Ao repensar a forma como as previsões são geradas e aprendidas, permitimos uma inferência verdadeiramente end-to-end e sem NMS. O modelo produz diretamente as deteções finais, sem depender de etapas externas de limpeza ou de regras criadas manualmente. Isto torna o YOLO26 mais rápido, mais fácil de exportar e mais fiável de implementar numa vasta gama de plataformas de hardware.
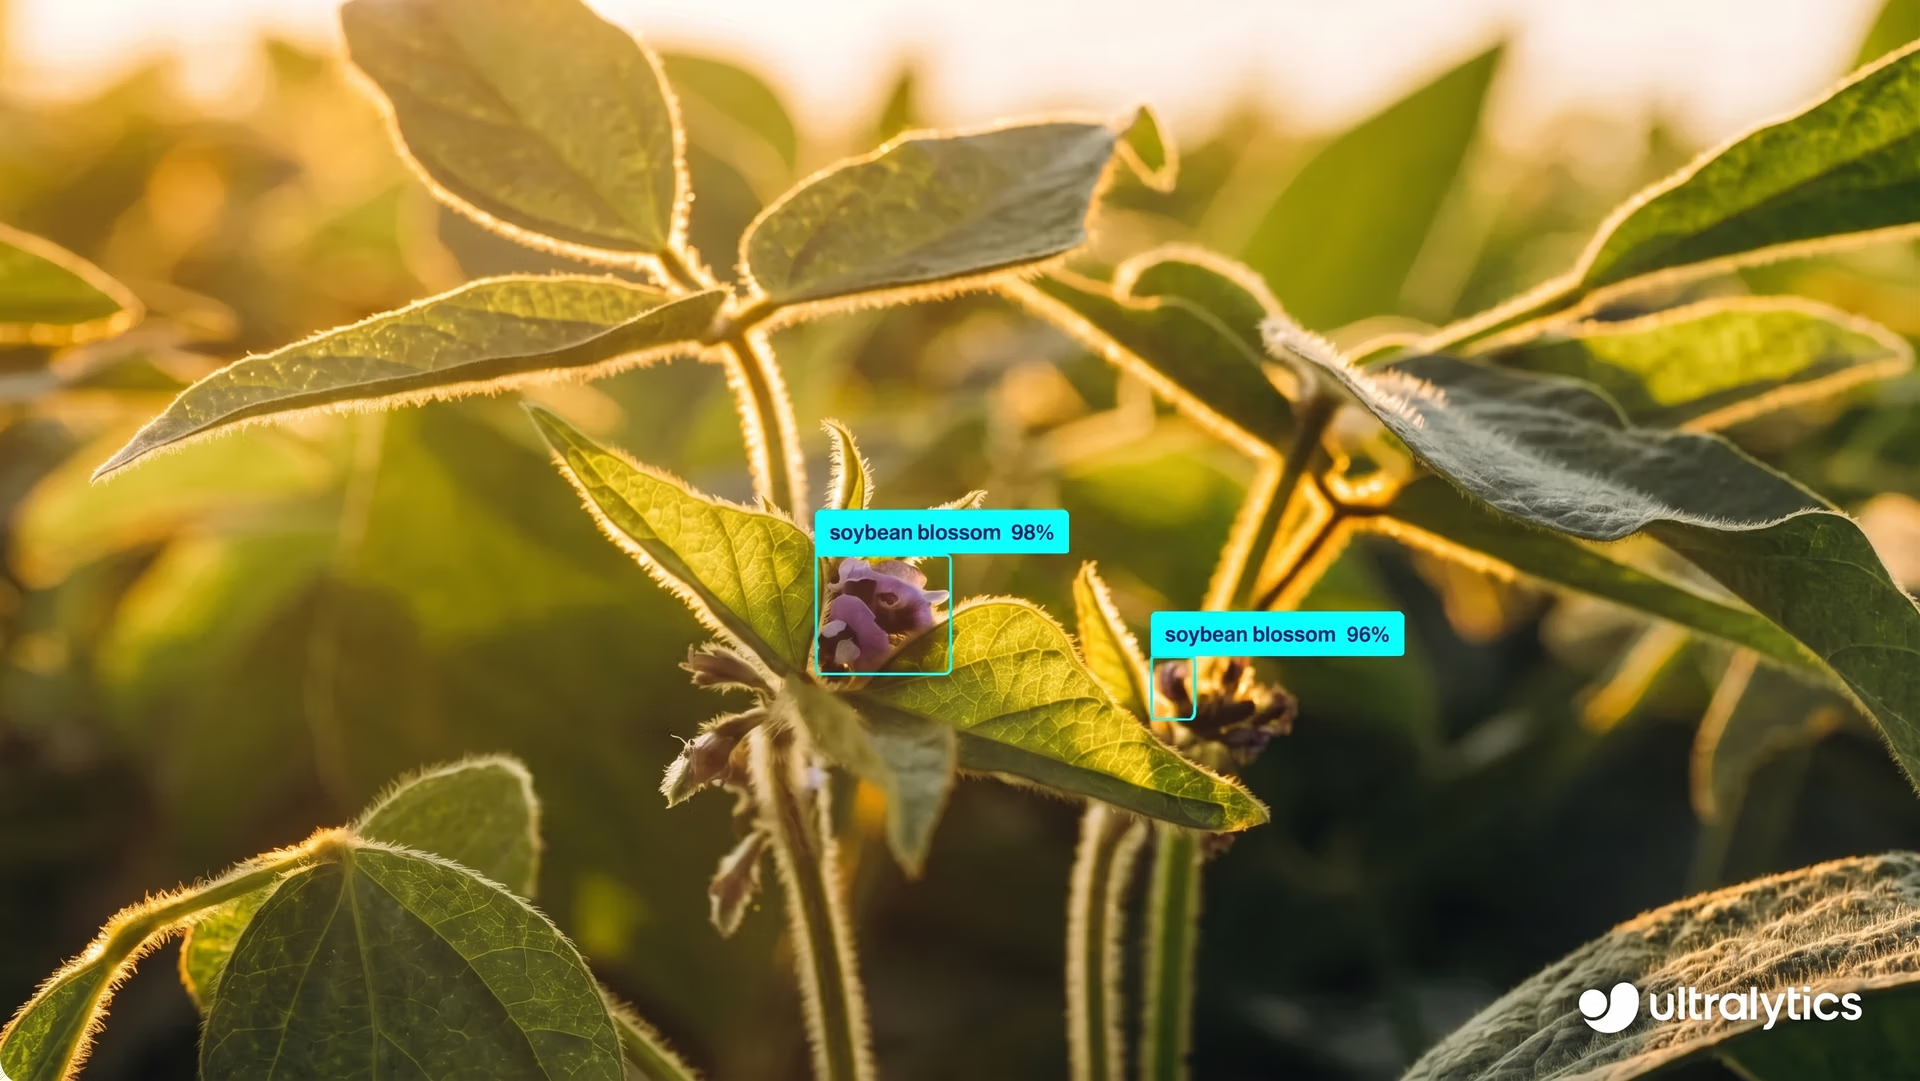
Fig. 1. Deteção de objetos numa imagem usando o Ultralytics YOLO26.
Neste artigo, vamos analisar mais de perto por que motivo a deteção tradicional de objetos dependia da NMS, como esta se tornou um obstáculo à implementação e como o Ultralytics YOLO26 elimina a necessidade de soluções alternativas. Vamos começar!
A deteção tradicional de objetos produz deteções duplicadas#
Antes de explicarmos o que é a NMS e por que motivo a removemos no Ultralytics YOLO26, vamos recuar um pouco e analisar como os modelos tradicionais de deteção de objetos geram as suas previsões.
Os modelos tradicionais de deteção de objetos produzem frequentemente várias caixas delimitadoras sobrepostas para o mesmo objeto. Cada uma destas caixas tem a sua própria pontuação de confiança, embora todas se refiram ao mesmo objeto na imagem.
Isto acontece por alguns motivos. Primeiro, o modelo faz previsões em muitas posições espaciais e em diferentes escalas ao mesmo tempo. Isto ajuda o modelo a detetar objetos de vários tamanhos, mas também significa que posições próximas podem identificar o mesmo objeto de forma independente.
Segundo, muitos sistemas de deteção de objetos usam abordagens baseadas em âncoras, que geram um grande número de caixas candidatas em torno de cada posição. Embora isto aumente as hipóteses de encontrar objetos com precisão, também aumenta o número de previsões sobrepostas.
Por fim, a própria deteção baseada em grelha conduz naturalmente à redundância. Quando um objeto está próximo dos limites de várias células da grelha, várias células podem prever uma caixa para esse objeto, resultando em várias deteções sobrepostas.
Por este motivo, a saída bruta do modelo contém frequentemente várias caixas para um único objeto. Para que os resultados sejam úteis, é necessário filtrar estas previsões redundantes para que reste apenas uma deteção final.
Compreender a supressão não máxima#
Quando um modelo de deteção de objetos produz várias caixas delimitadoras sobrepostas para o mesmo objeto, é necessário limpar esses resultados antes de os utilizar. É aqui que se aplica a supressão não máxima.
A supressão não máxima é uma etapa de pós-processamento executada depois de o modelo terminar de fazer as previsões. O seu objetivo é reduzir as deteções duplicadas, para que cada objeto seja representado por uma única caixa delimitadora final.
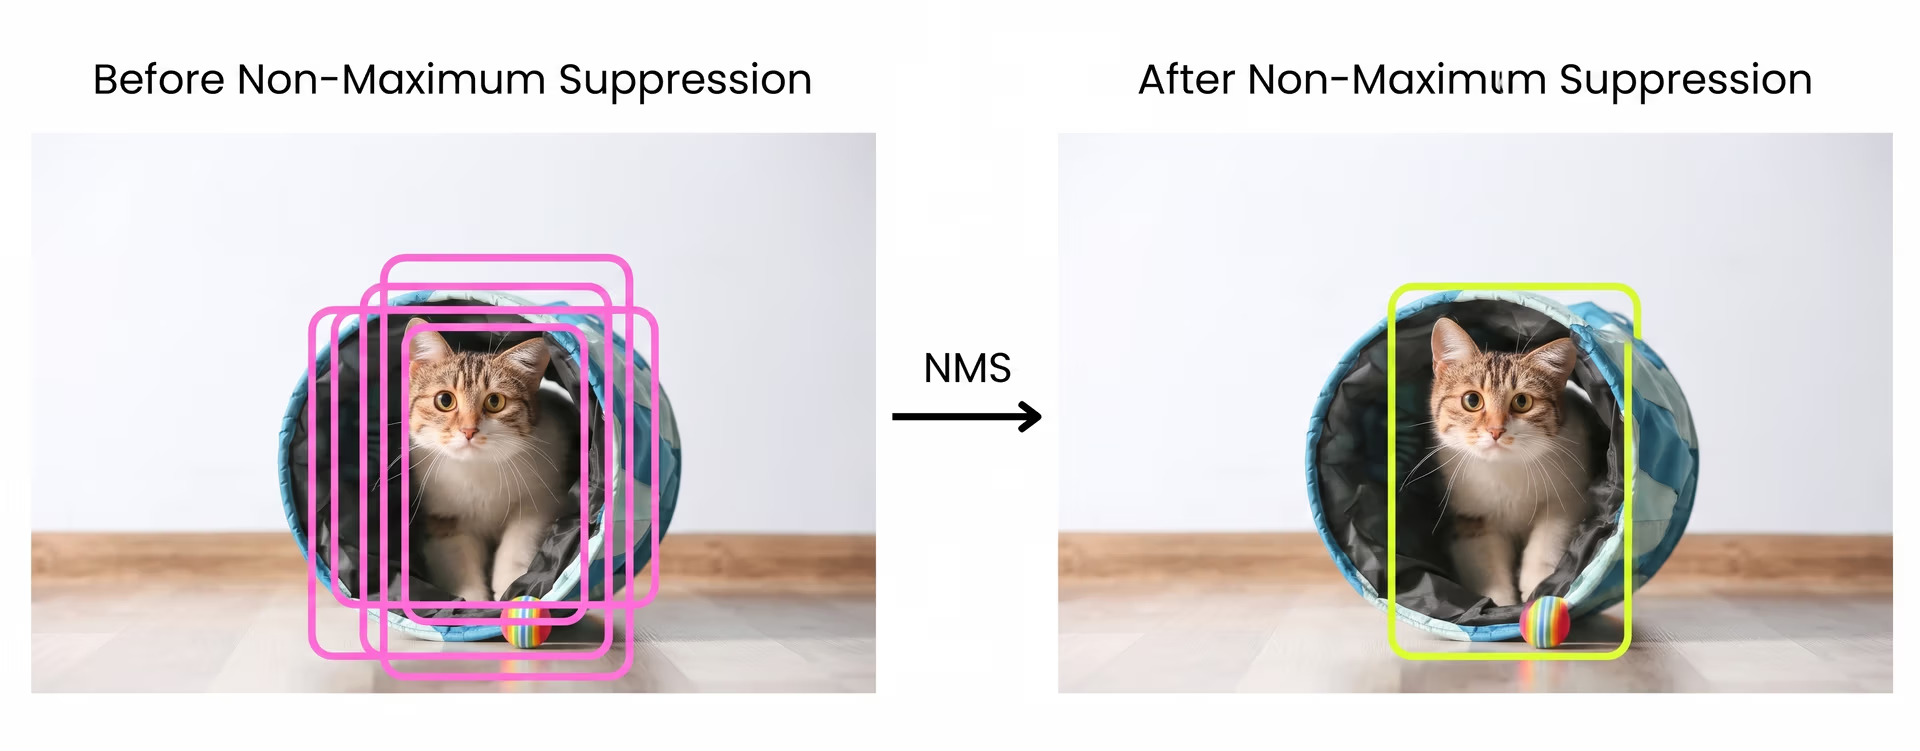
Fig. 2. Visão geral da NMS. Imagem do autor.
O processo funciona comparando as caixas delimitadoras com base nas respetivas pontuações de confiança e no grau de sobreposição. As previsões com confiança muito baixa são removidas primeiro.
Em seguida, as caixas restantes são ordenadas por confiança, e a caixa com a pontuação mais elevada é selecionada como a melhor deteção. Essa caixa selecionada é comparada com as outras caixas.
Se outra caixa tiver uma sobreposição excessiva com ela, essa caixa é suprimida e removida. A sobreposição é normalmente medida usando a interseção sobre união, uma métrica que calcula a proporção entre a área partilhada por duas caixas e a área total coberta por ambas. Este processo repete-se até restarem apenas as deteções mais confiantes e sem sobreposição.
Por que motivo a NMS complica a implementação#
Embora a supressão não máxima ajude a filtrar deteções duplicadas, também introduz desafios que se tornam mais evidentes quando os modelos saem da investigação e passam para a implementação no mundo real.
Um dos maiores problemas é o desempenho. A NMS é executada após a inferência e exige comparar as caixas delimitadoras entre si para decidir quais manter.
Este processo é computacionalmente dispendioso e difícil de paralelizar de forma eficiente. Em dispositivos de edge e sistemas baseados em CPU, este trabalho adicional pode aumentar significativamente a latência, dificultando o cumprimento dos requisitos de tempo real.
A NMS também aumenta a complexidade da implementação. Como não faz parte do próprio modelo, tem de ser implementada separadamente como código de pós-processamento.
Diferentes ambientes de execução e plataformas tratam a NMS de formas distintas, o que muitas vezes exige manter implementações personalizadas para cada ambiente de destino. O que funciona numa configuração pode comportar-se de forma ligeiramente diferente noutra, tornando a implementação mais frágil e difícil de escalar.
A otimização de hardware é outro desafio. A NMS não se adapta facilmente a aceleradores de IA especializados, concebidos para executar operações de redes neuronais com eficiência. Por isso, mesmo quando o modelo funciona rapidamente em hardware otimizado, a NMS pode tornar-se um obstáculo que limita o desempenho geral.
Além destes fatores, a NMS depende de parâmetros escolhidos manualmente, como limiares de confiança e de sobreposição. Estas definições podem afetar significativamente os resultados e, muitas vezes, precisam de ser ajustadas para diferentes conjuntos de dados, aplicações ou hardware. Isto torna o comportamento menos previsível em sistemas de produção e acrescenta trabalho de configuração.
Explicação da inferência end-to-end na deteção de objetos#
As limitações da supressão não máxima levaram-nos a repensar como os modelos de deteção de objetos devem comportar-se durante a inferência. Em vez de gerar muitas previsões sobrepostas e limpá-las depois, colocámos uma questão mais fundamental.
E se o modelo pudesse produzir diretamente as deteções finais? Esta questão está no cerne da inferência end-to-end na deteção de objetos. Num sistema end-to-end, o modelo é treinado para tratar de todo o processo de deteção, do início ao fim, sem depender de etapas externas de limpeza.
Em vez de produzir muitas caixas candidatas e filtrá-las após a inferência, o modelo aprende a gerar por si próprio um pequeno conjunto de previsões confiantes e sem sobreposição. As deteções duplicadas são resolvidas dentro da rede, em vez de serem removidas no pós-processamento.
Arquiteturas de modelos mais recentes demonstraram que esta abordagem era possível e prática. Com a estratégia de treino adequada, os modelos podiam aprender a associar cada objeto a uma única previsão, em vez de várias previsões concorrentes, reduzindo a redundância na sua origem.
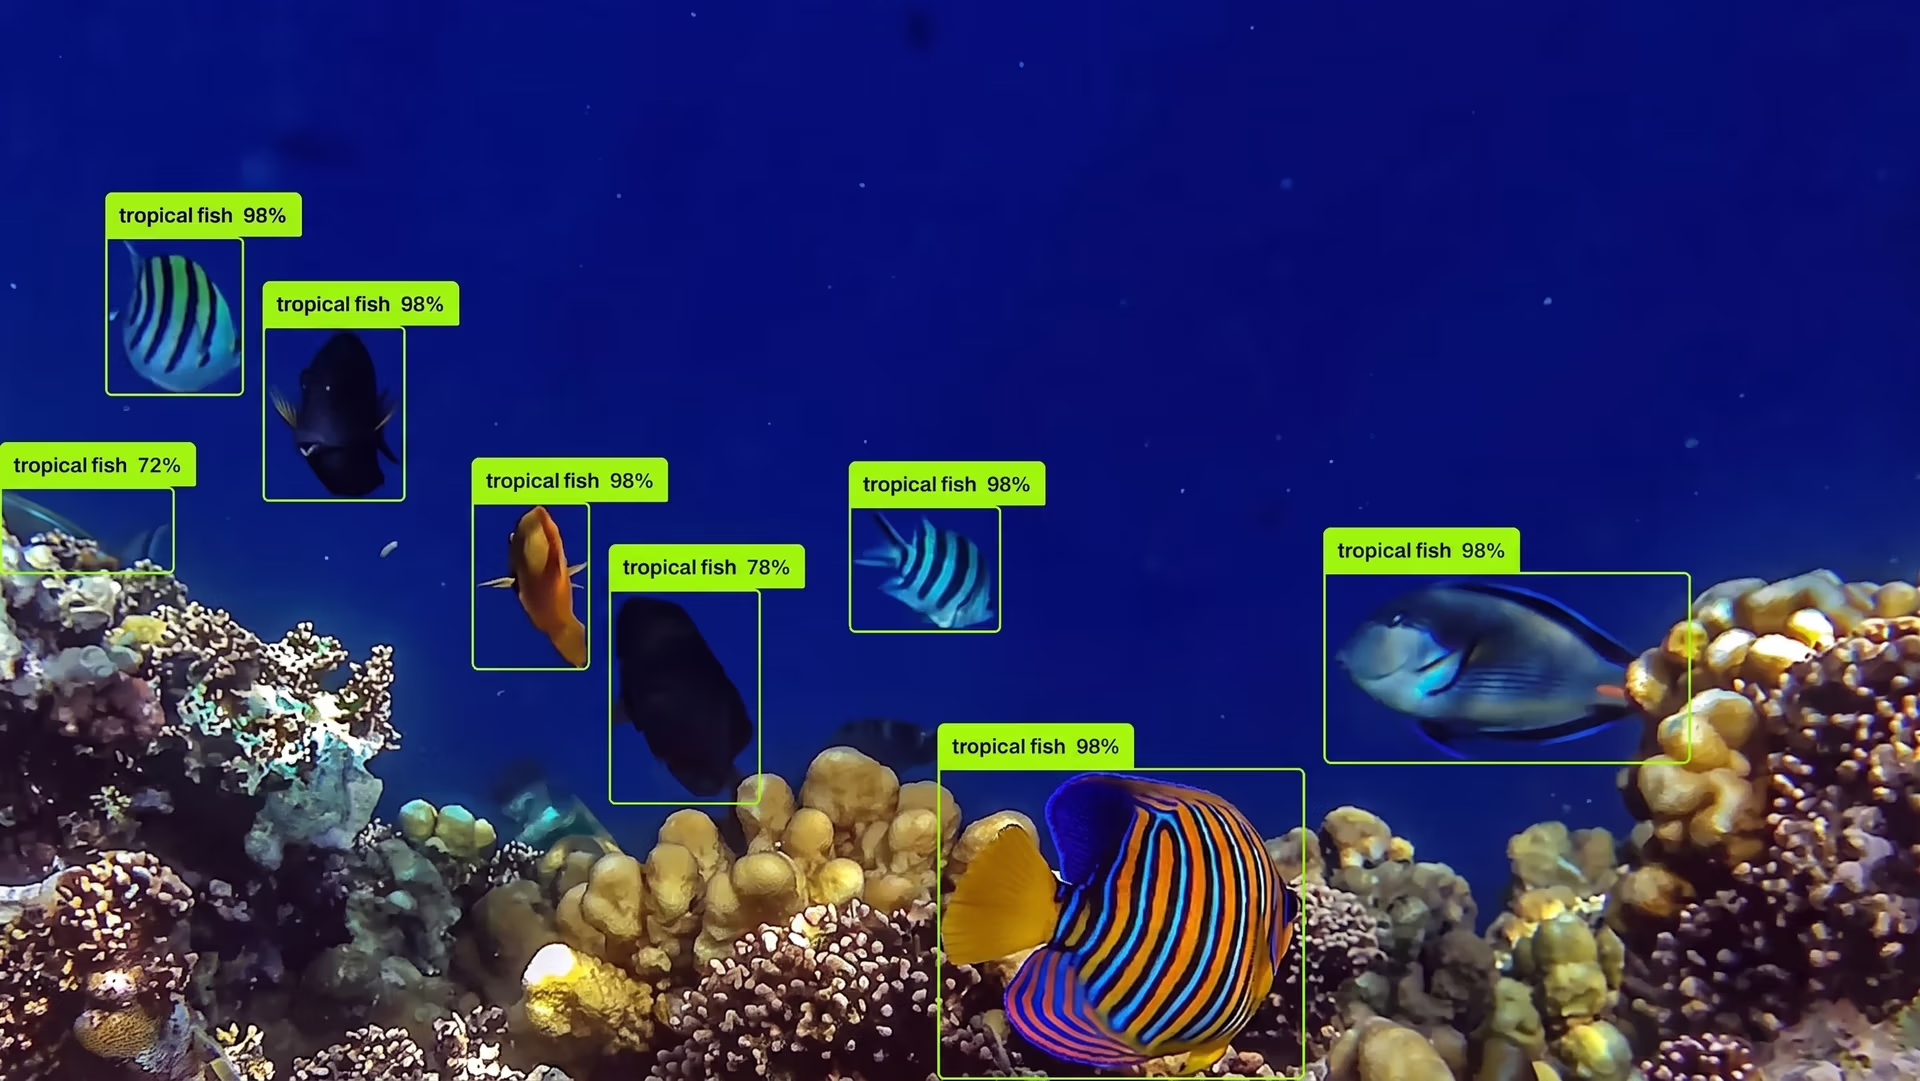
Fig. 3. Exemplo de deteção de objetos usando o Ultralytics YOLO26.
Para que isto funcione, o treino também tem de mudar. Em vez de permitir que muitas previsões concorram pelo mesmo objeto, o modelo aprende a tomar uma decisão clara, produzindo menos deteções e mais confiantes.
O resultado geral é um pipeline de inferência mais simples. Como as duplicações já são resolvidas internamente, não é necessária supressão não máxima durante a inferência. A saída do modelo já corresponde ao conjunto final de deteções.
Este design end-to-end também facilita a implementação. Sem etapas de pós-processamento ou implementações de NMS específicas para cada plataforma, o modelo exportado é totalmente autónomo e comporta-se de forma consistente em diferentes frameworks de inferência e plataformas de hardware.
Como explica o nosso engenheiro principal de parcerias, Francesco Mattioli, «A verdadeira aprendizagem end-to-end significa que o modelo deve tratar de tudo, dos píxeis às previsões, sem etapas de pós-processamento criadas manualmente que quebram a diferenciabilidade e complicam a implementação.»
Como o Ultralytics YOLO26 remove a NMS#
O Ultralytics YOLO26 remove a supressão não máxima ao alterar a forma como as deteções são aprendidas e produzidas, em vez de depender do pós-processamento para as limpar. Em vez de permitir que muitas previsões concorram pelo mesmo objeto, o YOLO26 é treinado para aprender uma relação clara de um para um entre objetos e saídas.
Isto é possível, em parte, graças à deteção baseada em consultas aprendíveis, que ajuda o modelo a concentrar-se em produzir uma única previsão confiante para cada objeto, em vez de muitas candidatas sobrepostas. Cada objeto é associado a uma previsão, reduzindo naturalmente as deteções duplicadas.
Este comportamento é reforçado por estratégias de correspondência consistentes durante o treino, incentivando o modelo a tomar uma decisão confiante por objeto em vez de gerar previsões sobrepostas. No fim, o modelo produz menos previsões, mas cada uma representa uma deteção final.
Por que motivo a remoção de DFL tornou possível a deteção sem NMS#
Outra inovação importante que permite a inferência sem NMS no Ultralytics YOLO26 é a remoção da Distribution Focal Loss, ou DFL. Nos modelos YOLO anteriores, a DFL era usada para melhorar a regressão das caixas delimitadoras, prevendo uma distribuição de possíveis posições da caixa em vez de um único valor.
Embora esta abordagem tenha melhorado a precisão da localização, também acrescentou complexidade ao pipeline de deteção. Essa complexidade tornou-se uma limitação na transição para uma inferência verdadeiramente end-to-end.
A DFL introduzia computação adicional e intervalos fixos de regressão, o que dificultava a aprendizagem, pelo modelo, de associações claras de um para um entre objetos e aumentava a dependência de etapas de pós-processamento como a supressão não máxima. No Ultralytics YOLO26, removemos a DFL e reformulámos a regressão das caixas delimitadoras para a tornar mais simples e direta.
Em vez de depender de saídas baseadas em distribuições, o modelo aprende a prever coordenadas precisas das caixas de uma forma que permite produzir menos deteções e mais confiantes. Esta alteração ajuda a reduzir as previsões sobrepostas na sua origem e alinha a regressão das caixas delimitadoras com o design end-to-end e sem NMS do Ultralytics YOLO26.
O Ultralytics YOLO26 não usa NMS e é fácil de implementar#
Um design sem NMS torna o Ultralytics YOLO26 um modelo verdadeiramente end-to-end. Isto tem um impacto importante na exportação de modelos.
Exportar significa converter um modelo treinado para um formato que possa funcionar fora do ambiente de treino, como ONNX, TensorRT, CoreML ou OpenVINO. Nos pipelines tradicionais, este processo muitas vezes falha porque a supressão não máxima não faz parte do próprio modelo.
Ao remover a NMS, o Ultralytics YOLO26 evita totalmente este problema. O modelo exportado já inclui tudo o que é necessário para produzir as deteções finais.
Isto torna o modelo exportado totalmente autónomo e mais portátil entre frameworks de inferência e plataformas de hardware. O mesmo modelo comporta-se de forma consistente quer seja implementado em servidores, sistemas apenas com CPU, dispositivos incorporados ou aceleradores de edge. A implementação torna-se mais simples, porque aquilo que exportas é exatamente aquilo que executas.
Esta simplicidade é especialmente importante para aplicações de edge. Por exemplo, o YOLO26 pode ser facilmente implementado em dispositivos como drones para casos de uso como a monitorização de culturas, a inspeção de campos e a análise da saúde das plantas, em que os orçamentos limitados de computação e energia tornam impraticáveis os pipelines complexos de pós-processamento. Como o modelo produz diretamente as deteções finais, funciona de forma fiável em hardware leve, sem etapas adicionais de processamento.
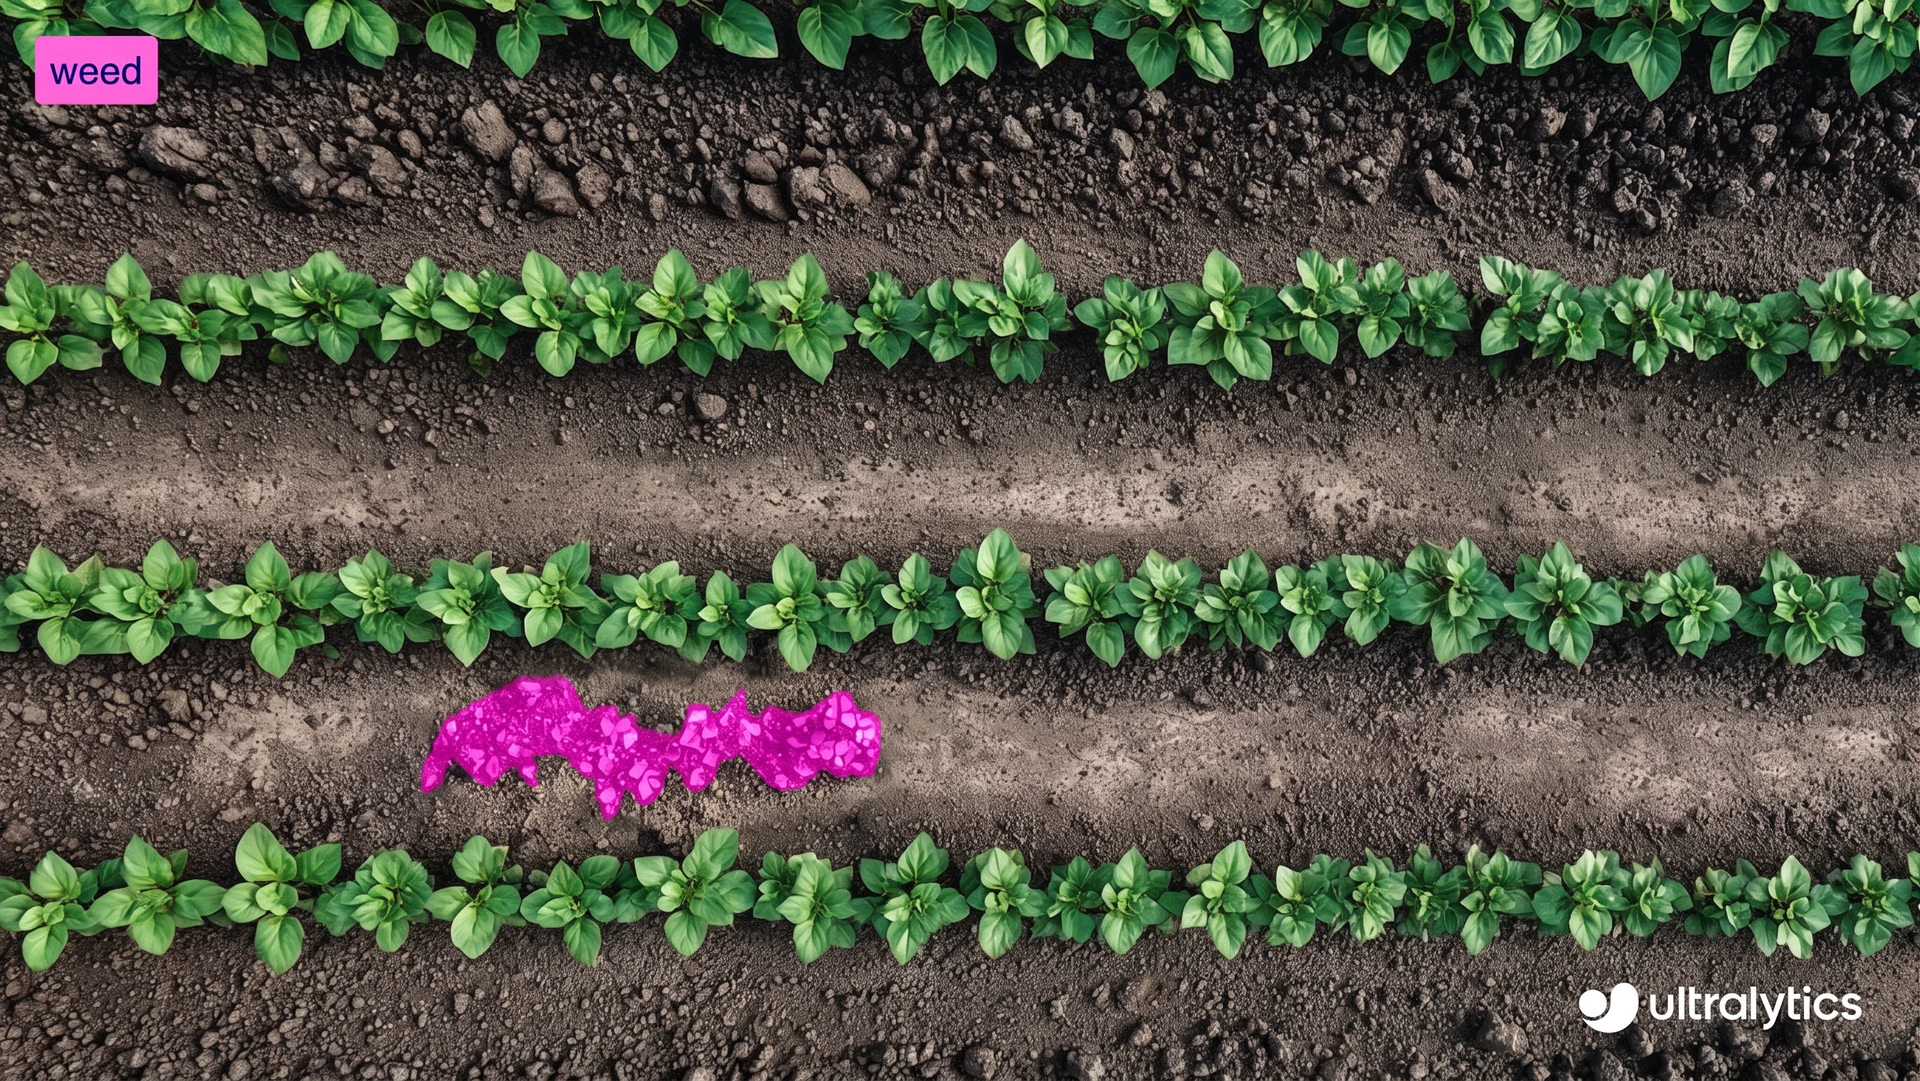
Fig. 4. O Ultralytics YOLO26 é fácil de implementar em dispositivos de edge, como drones.
Em suma, a inferência sem NMS elimina entraves à exportação e à implementação, permitindo sistemas de visão mais limpos e fiáveis. A NMS era uma solução alternativa. O Ultralytics YOLO26 já não precisa de soluções alternativas.
Principais conclusões#
O Ultralytics YOLO26 remove a supressão não máxima ao resolver o problema subjacente das deteções duplicadas, em vez de as limpar posteriormente. O seu design end-to-end permite que o modelo produza diretamente as deteções finais, tornando a exportação e a implementação mais simples e consistentes em diferentes tipos de hardware. A NMS era uma solução alternativa útil para sistemas anteriores, mas o YOLO26 já não precisa dela.
Junta-te à nossa comunidade e confere o nosso repositório no GitHub para saber mais sobre IA. Explora as nossas páginas de soluções sobre IA na agricultura e visão computacional no retalho. Descobre as nossas opções de licenciamento e começa hoje a trabalhar com IA para visão!









