Изучаем карточку модели Claude 3: что она означает для Vision AI
Узнай о карточке модели Claude 3 и ее влиянии на развитие Vision AI.
В последние годы vision AI значительно продвинулся, произведя революцию в самых разных отраслях — от здравоохранения до розничной торговли. Чтобы эффективно использовать эти достижения, важно понимать лежащие в их основе модели и сопровождающую их документацию. Одним из таких важных инструментов в арсенале разработчика систем искусственного интеллекта (AI) является карточка модели, которая дает полное представление о характеристиках и производительности модели AI.
В этой статье мы рассмотрим карточку модели Claude 3, разработанную Anthropic, и ее значение для развития vision AI. Claude 3 — это новое семейство больших мультимодальных моделей, состоящее из трех вариантов: Claude 3 Opus — наиболее мощная модель; Claude 3 Sonnet, сочетающая производительность и скорость; и Claude 3 Haiku — самый быстрый и экономичный вариант. Каждая модель теперь оснащена возможностями работы с изображениями, что позволяет ей обрабатывать и анализировать данные изображений.
Обзор карточки модели Claude 3#
Что именно представляет собой карточка модели? Карточка модели — это подробный документ, содержащий сведения о разработке, обучении и оценке модели машинного обучения. Она призвана способствовать прозрачности, подотчетности и этичному использованию AI, представляя четкую информацию о функциональности модели, предполагаемых сценариях использования и потенциальных ограничениях. Этого можно достичь, предоставив более подробные данные о модели, такие как метрики оценки и ее сравнение с предыдущими моделями и другими конкурентами.
Метрики оценки#
Метрики оценки имеют решающее значение для определения производительности модели. В карточке модели Claude 3 перечислены такие метрики, как точность, precision, полнота и F1-score, что дает четкое представление о сильных сторонах модели и областях для улучшения. Эти метрики сравниваются с отраслевыми стандартами, демонстрируя конкурентоспособную производительность Claude 3.
Кроме того, Claude 3 развивает сильные стороны своих предшественников, внедряя улучшения в архитектуру и методы обучения. В карточке модели Claude 3 сравнивается с более ранними версиями, подчеркивая улучшения точности, эффективности и применимости к новым сценариям использования.
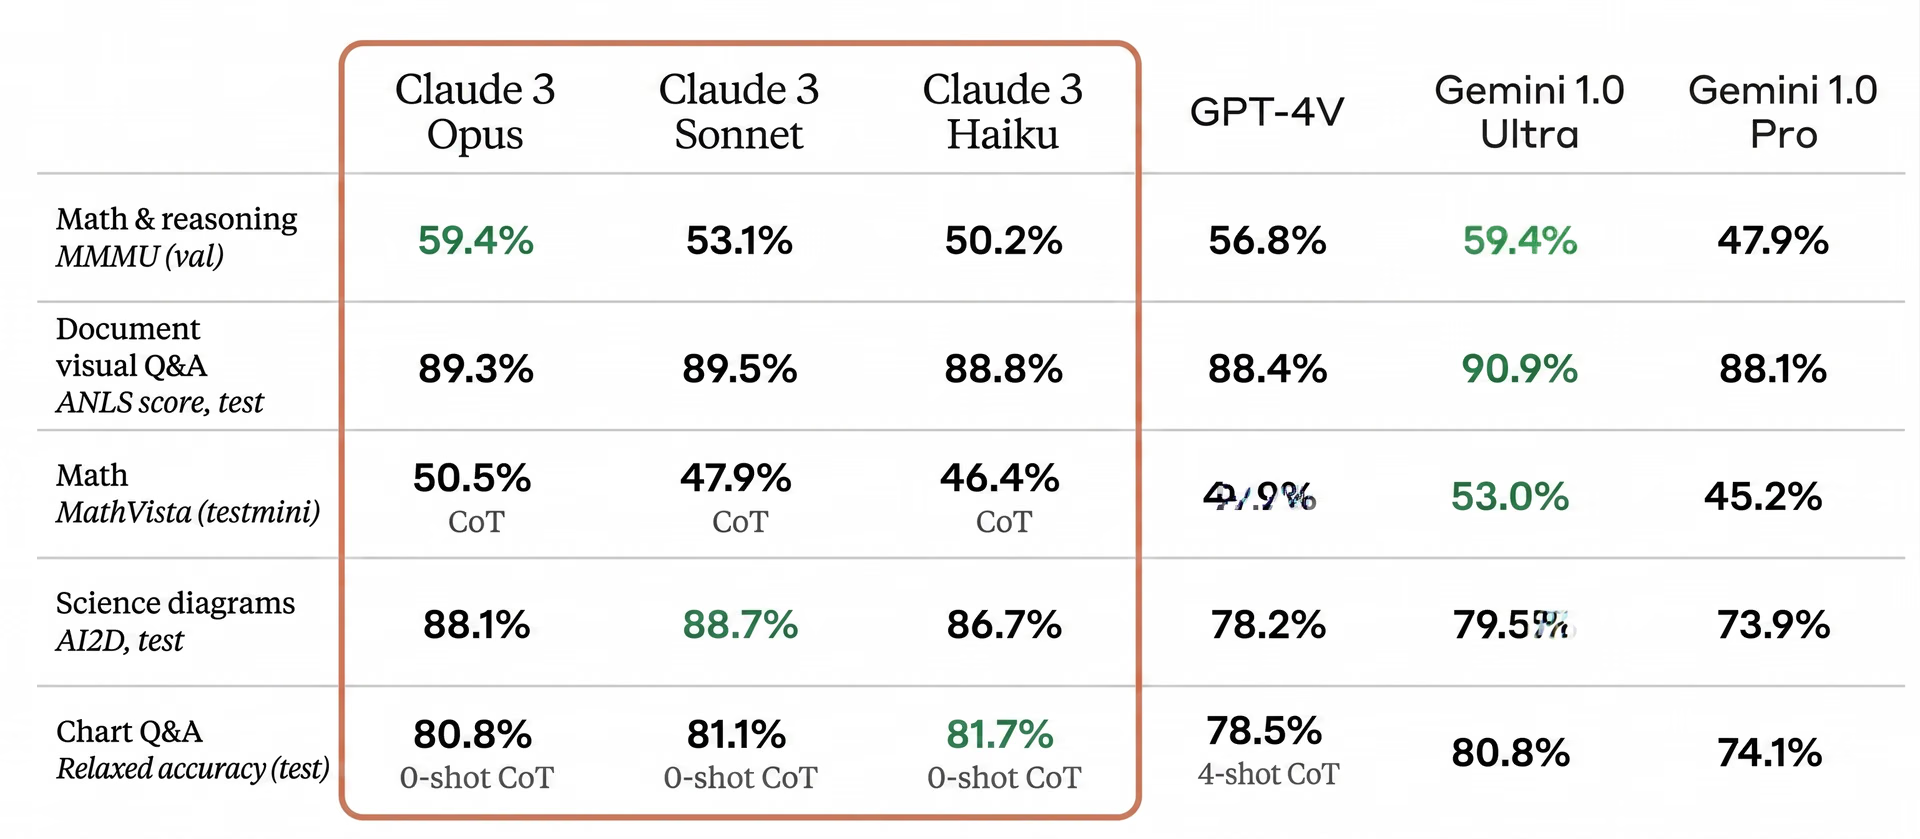
Рис. 1. Таблица сравнения моделей Claude 3 с другими моделями в различных задачах.
Как Claude 3 влияет на развитие vision AI#
Архитектура и процесс обучения Claude 3 обеспечивают надежную производительность в различных задачах обработки естественного языка (NLP) и работы с изображениями. Модель стабильно показывает высокие результаты в бенчмарках, демонстрируя способность эффективно выполнять сложный языковой анализ.
Обучение Claude 3 на разнообразных наборах данных и использование методов аугментации данных обеспечивают ее устойчивость и способность обобщать знания в различных сценариях. Благодаря этому модель универсальна и эффективна в широком спектре приложений.
Несмотря на примечательные результаты, Claude 3 по сути является большой языковой моделью (LLM). Хотя LLM, такие как Claude 3, могут выполнять различные задачи компьютерного зрения, они не были специально разработаны для таких задач, как обнаружение объектов, создание ограничивающих рамок и сегментация изображений. Поэтому их точность в этих областях может не соответствовать точности моделей, специально созданных для компьютерного зрения, таких как Ultralytics YOLOv8. Тем не менее LLM превосходно справляются с другими задачами, особенно с обработкой естественного языка (NLP), где Claude 3 демонстрирует значительную силу, объединяя простые задачи работы с изображениями с человеческим рассуждением.
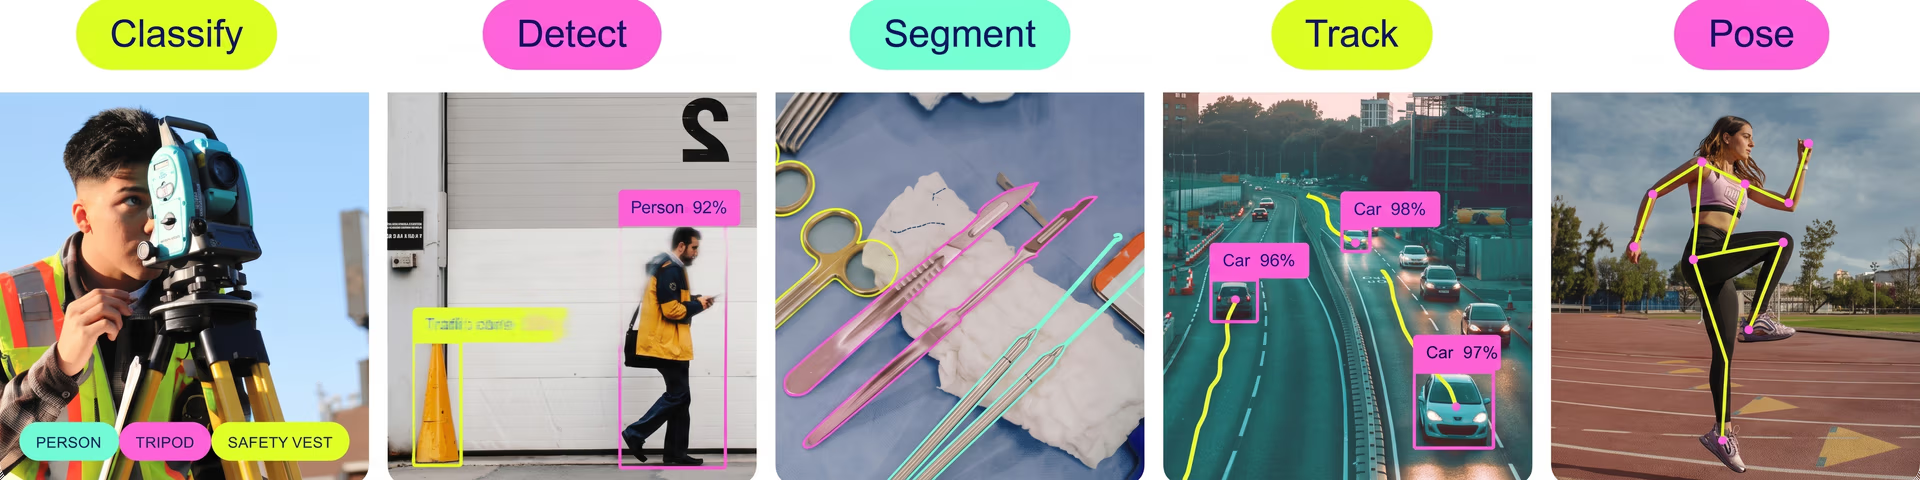
Рис. 2. Обзор классификации объектов, обнаружения, сегментации, отслеживания и оценки позы с использованием Ultralytics YOLOv8.
Возможности NLP — это способность модели AI понимать человеческий язык и отвечать на нем. Эта возможность широко используется в приложениях Claude 3 для работы с изображениями, позволяя модели создавать насыщенные контекстом описания, интерпретировать сложные визуальные данные и повышать общую производительность в задачах vision AI.
Преобразование изображения в текст#
Одна из впечатляющих возможностей Claude 3, особенно при использовании для задач vision AI, — способность обрабатывать изображения низкого качества с трудночитаемым почерком и преобразовывать их в текст. Эта функция демонстрирует передовые возможности модели по обработке данных и мультимодальному рассуждению. В этом разделе мы рассмотрим, как Claude 3 выполняет эту задачу, уделив внимание лежащим в ее основе механизмам и значению для развития vision AI.
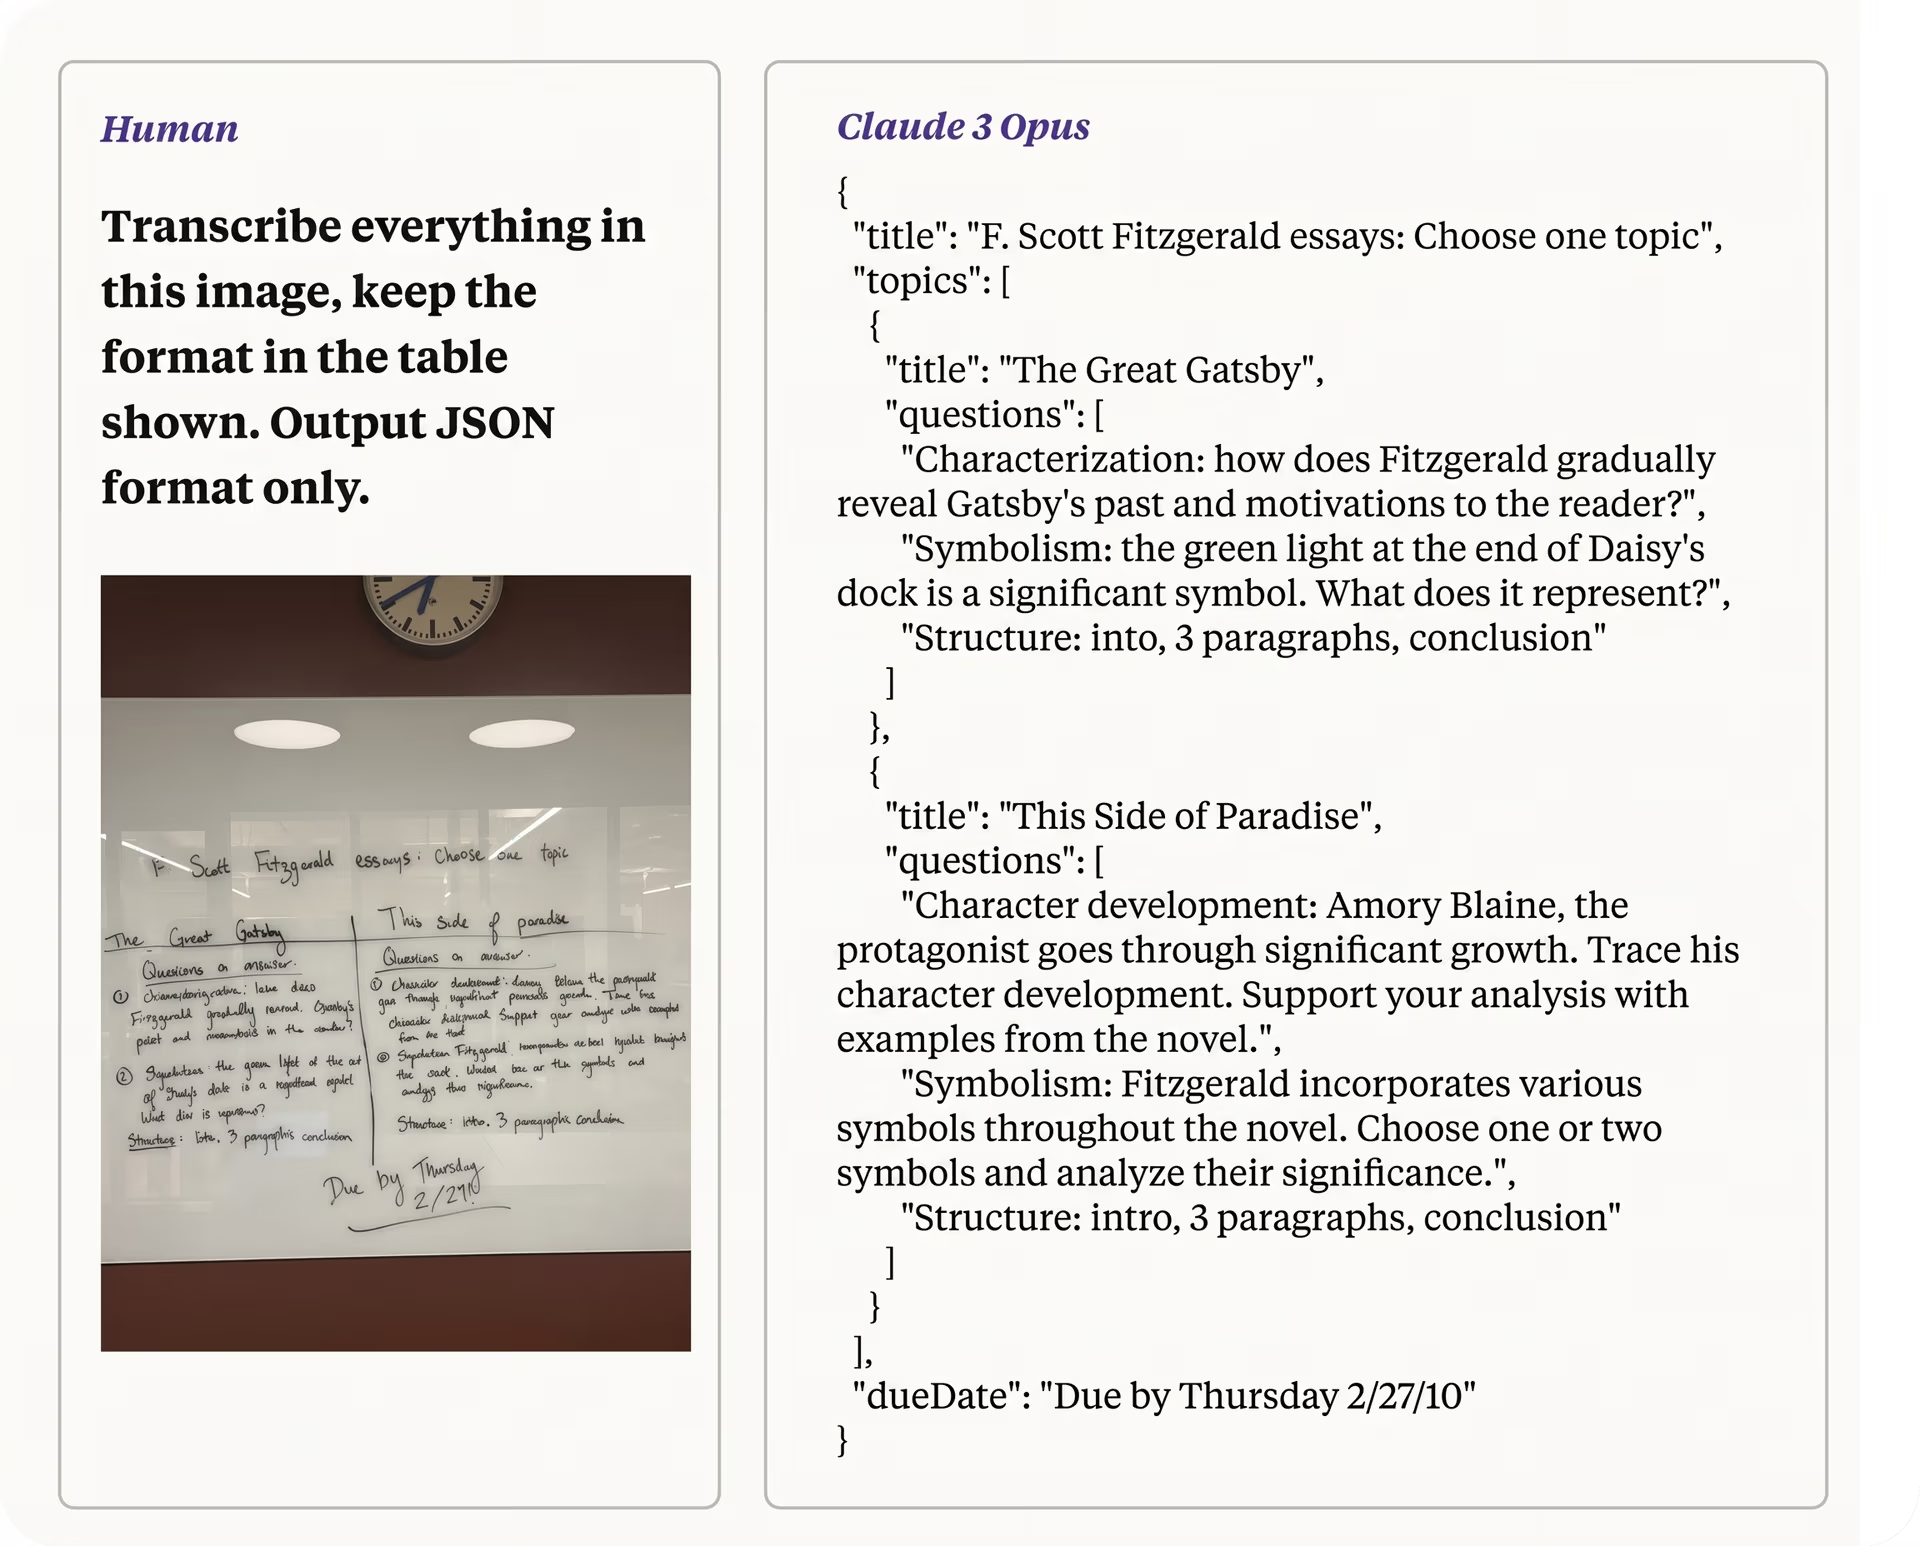
Рис. 3. Преобразование Claude 3 Opus фотографии низкого качества с трудночитаемым почерком в текст.
Понимание проблемы#
Преобразование фотографии низкого качества с трудночитаемым почерком в текст — сложная задача, связанная с несколькими проблемами:
- Качество изображения: Низкое разрешение, шум и плохое освещение могут скрывать детали изображения.
- Вариативность почерка: Почерк разных людей значительно различается, поэтому моделям сложно распознавать и интерпретировать текст.
- Понимание контекста: Для точного преобразования рукописного текста в печатный необходимо понимать контекст, чтобы разрешать неоднозначности в почерке.
Как упоминалось ранее, модели Claude 3 решают эти проблемы благодаря сочетанию передовых методов компьютерного зрения и обработки естественного языка (NLP).
Рассуждение по визуальным данным (мультимодальное)#
Архитектура Claude 3 позволяет модели выполнять сложные задачи рассуждения с использованием визуальных входных данных. Например, как показано на рисунке 1, модель может интерпретировать диаграммы и графики, например определять страны G7 на графике об использовании интернета, извлекать релевантные данные и выполнять вычисления для анализа тенденций. Такое многоэтапное рассуждение, например расчет статистических различий в использовании интернета между возрастными группами, повышает точность модели и ее полезность в реальных приложениях.
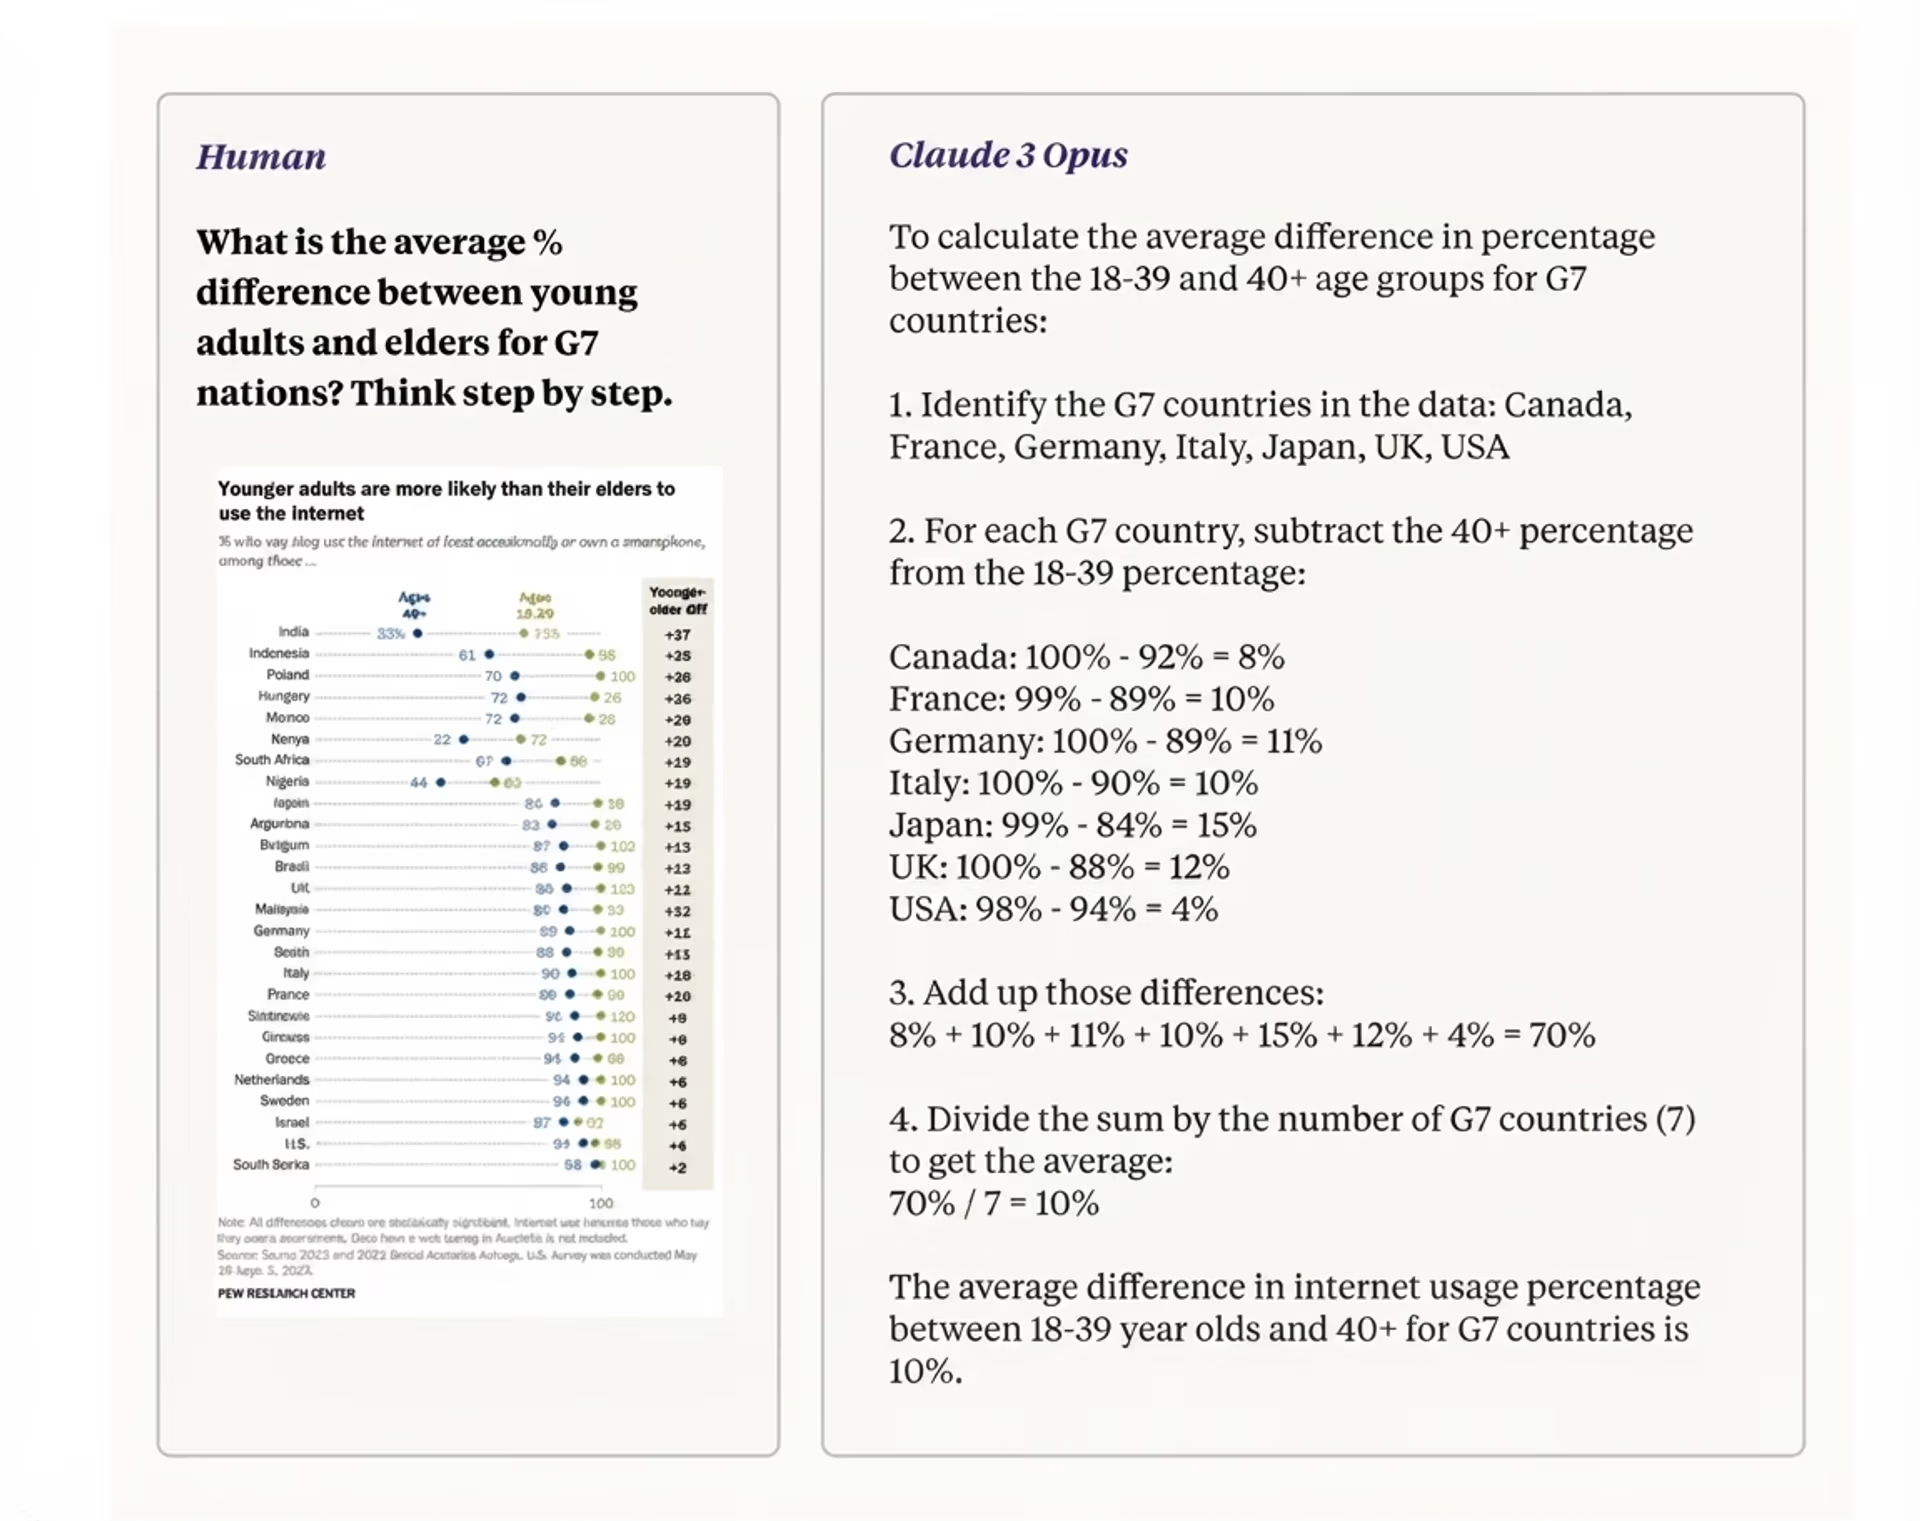
Рис. 4. Выполнение Claude 3 Opus задач, требующих многоэтапного рассуждения, на визуальном графике.
Описание изображений#
Claude 3 превосходно преобразует изображения в подробные описания, демонстрируя мощные возможности как в компьютерном зрении, так и в обработке естественного языка. Получив изображение, Claude 3 сначала использует сверточные нейронные сети (CNNs) для извлечения ключевых признаков и выявления объектов, закономерностей и контекстных элементов в визуальных данных.
Затем слои Transformer анализируют эти признаки, используя механизмы внимания для понимания взаимосвязей и контекста между различными элементами изображения. Такой мультимодальный подход позволяет Claude 3 создавать точные, насыщенные контекстом описания, не только выявляя объекты, но и понимая их взаимодействие и значение в сцене.
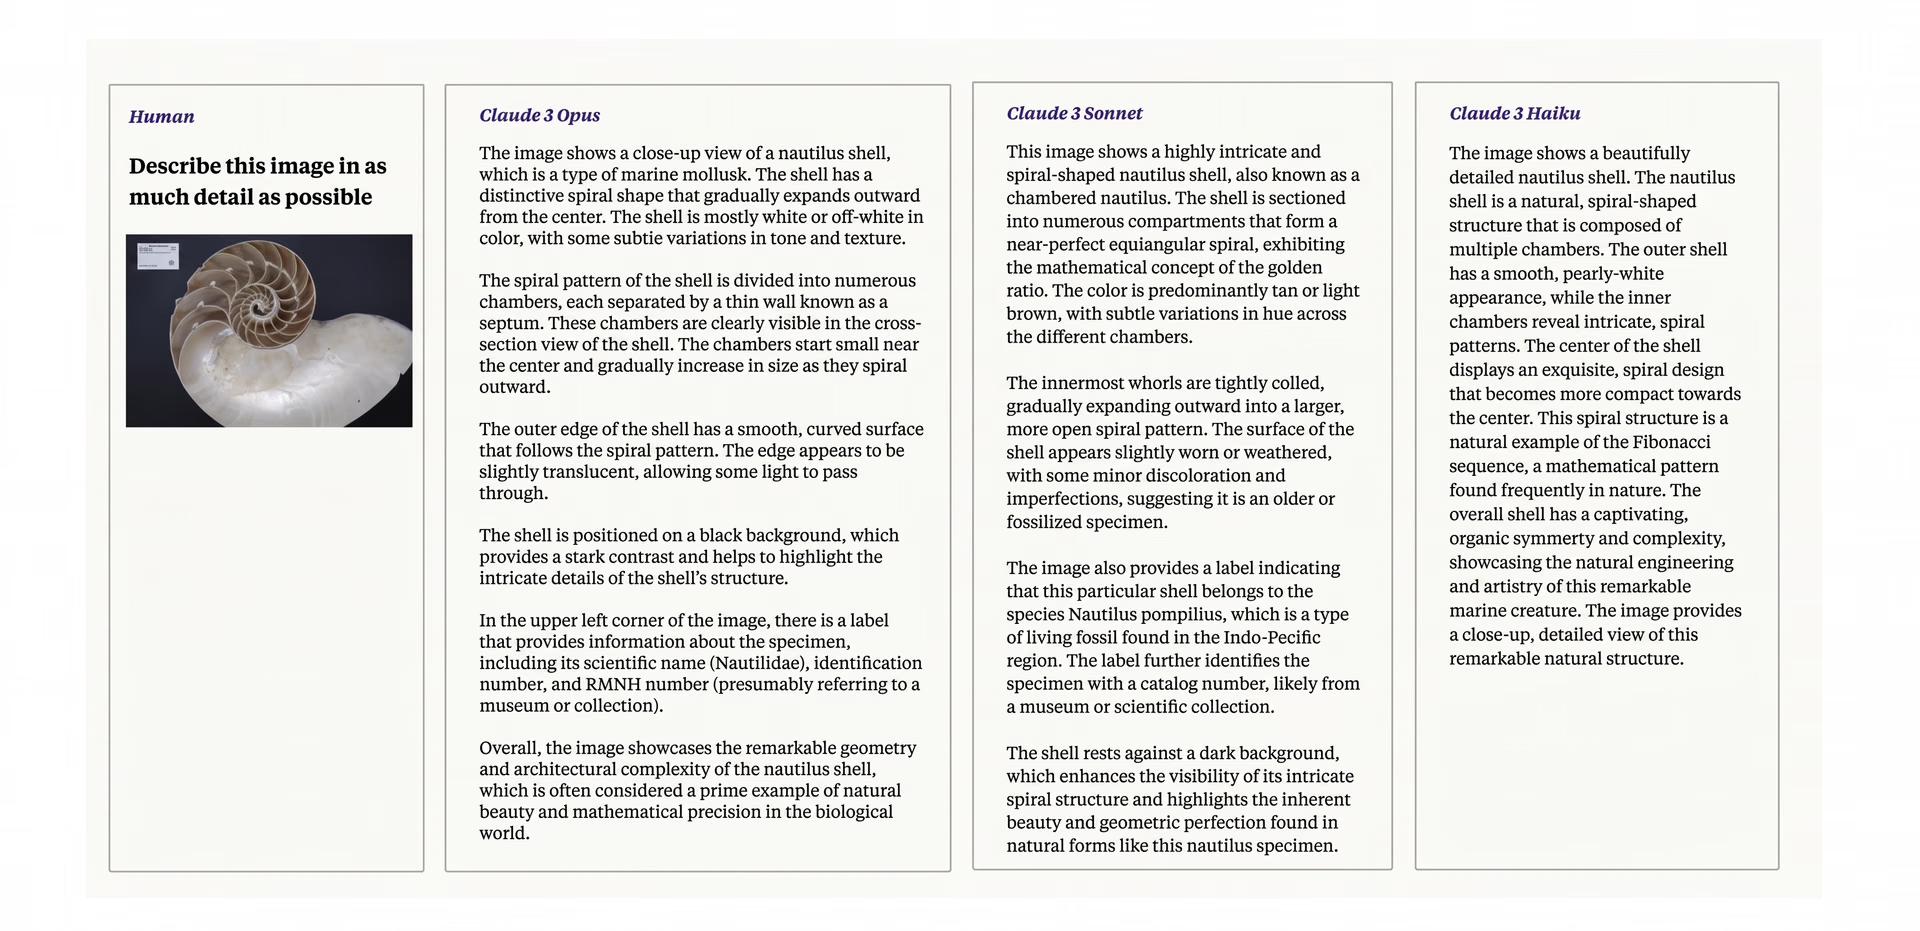
Рис. 5. Понимание моделями Claude 3 визуальных объектов на изображении и их описание на понятном человеку языке.
Проблемы и недостатки моделей Claude 3 в компьютерном зрении#
Отсутствие ориентации на компьютерное зрение#
Большие языковые модели (LLM), такие как Claude 3, превосходно справляются с обработкой естественного языка, но не с компьютерным зрением. Хотя они могут описывать изображения, такие задачи, как обнаружение объектов и сегментация изображений, лучше выполнять с помощью ориентированных на зрение моделей, таких как Ultralytics YOLOv8. Эти специализированные модели оптимизированы для визуальных задач и обеспечивают более высокую производительность при анализе изображений. Кроме того, модель не может выполнять такие задачи, как создание ограничивающих рамок.
Сложность интеграции#
Объединение Claude 3 с системами компьютерного зрения может быть сложным и потребовать дополнительных этапов обработки для устранения разрыва между текстовыми и визуальными данными.
Ограничения обучающих данных#
Claude 3 в основном обучается на огромных объемах текстовых данных, а значит, ей не хватает обширных наборов визуальных данных, необходимых для достижения высокой производительности в задачах компьютерного зрения. Поэтому, хотя Claude 3 превосходно понимает и генерирует текст, она не способна обрабатывать или анализировать изображения с той же эффективностью, что и модели, специально разработанные для визуальных данных. Это ограничение делает ее менее эффективной для приложений, требующих интерпретации или создания визуального контента.
Будущий потенциал Claude 3 в сфере vision AI#
Как и другие большие языковые модели, Claude 3 будет постоянно совершенствоваться. Будущие улучшения, вероятно, будут направлены на повышение качества выполнения визуальных задач, таких как обнаружение изображений и распознавание объектов, а также на развитие задач обработки естественного языка. Это позволит создавать более точные и подробные описания объектов и сцен, а также выполнять другие подобные задачи.
Наконец, текущие исследования Claude 3 будут сосредоточены на повышении интерпретируемости, снижении предвзятости и улучшении обобщения на разнообразных наборах данных. Эти усилия обеспечат стабильную производительность модели в различных приложениях и укрепят доверие к ее результатам и их надежности.
Заключительные мысли#
Карточка модели Claude 3 — ценный ресурс для разработчиков и других заинтересованных сторон в сфере vision AI, предоставляющий подробные сведения об архитектуре, производительности и этических аспектах модели. Способствуя прозрачности и подотчетности, она помогает обеспечить ответственное и эффективное использование технологий AI. По мере развития vision AI роль таких карточек моделей, как карточка Claude 3, будет иметь решающее значение для направления разработки и укрепления доверия к системам AI.
В Ultralytics мы увлечены развитием технологий AI. Чтобы изучить наши решения AI и быть в курсе последних инноваций, посетите наш репозиторий на GitHub. Присоединяйся к нашему сообществу в Discord и узнай, как мы преобразуем такие отрасли, как беспилотные автомобили и производство! 🚀








