Florence-2: Microsoft'un en yeni görsel-dil modeli
Microsoft'un nesne algılama, segmentasyon, açıklama yazma ve görsel temellendirme için geliştirdiği; sıfır örnekli görevlerde güçlü performans sunan görsel-dil modeli Florence-2 ile tanış.
 Abirami Vina7 dakikalık okuma
Microsoft, Haziran 2024'te Florence-2'yi tanıttı; bu çok modlu görsel-dil modeli (VLM), nesne algılama, segmentasyon, görüntü açıklaması oluşturma ve görsel temellendirme dâhil çok çeşitli görevleri yerine getirmek üzere tasarlanmıştır. Florence-2, sıfır örnekli performans alanında yeni bir ölçüt belirliyor; yani önceden göreve özgü bir eğitim almadan görevleri yerine getirebiliyor ve diğer son teknoloji ürünü görsel-dil modellerinden daha küçük bir model boyutuna sahip.
Florence-2 sıradan bir başka modelden ibaret değil. Çok yönlülüğü ve geliştirilmiş performansı, doğruluğu artırıp kapsamlı eğitim ihtiyacını azaltarak çeşitli sektörleri önemli ölçüde etkileyebilir. Bu makalede Florence-2'nin temel özelliklerini inceleyecek, performansını diğer VLM'lerle karşılaştıracak ve potansiyel uygulamalarını ele alacağız.
Florence-2 nedir?#
Florence-2, tek ve birleşik bir çerçeve içinde çeşitli görevleri yerine getirebilir. Modelin yetenekleri kısmen FLD-5B adlı büyük eğitim veri kümesinden kaynaklanır. FLD-5B, 126 milyon görüntüde 5,4 milyar açıklama içerir. Bu kapsamlı veri kümesi, Florence-2'nin çok çeşitli görsel görevlerini yüksek doğruluk ve verimlilikle yerine getirmek için gereken yeteneklere sahip olmasını sağlamak üzere oluşturulmuştur.
Florence-2'nin desteklediği görevlere daha yakından bakalım:
- Nesne Algılama: Görüntülerdeki nesneleri yüksek hassasiyetle tanımlayıp konumlarını belirleyebilir.
- Segmentasyon: Bu görev, daha kolay analiz ve yorumlama için görüntüyü anlamlı bölümlere ayırmayı içerir.
- Görüntü Açıklaması Oluşturma: Florence-2, bağlam ve ayrıntı sağlayan açıklayıcı görüntü altyazıları oluşturabilir.
- Görsel Temellendirme: Model, bir açıklamadaki belirli ifadeleri veya sözcükleri görüntüdeki karşılık gelen bölgelerle ilişkilendirebilir.
- Sıfır Örnekli Performans: Belirli bir eğitim almadan görevleri yerine getirebilir.
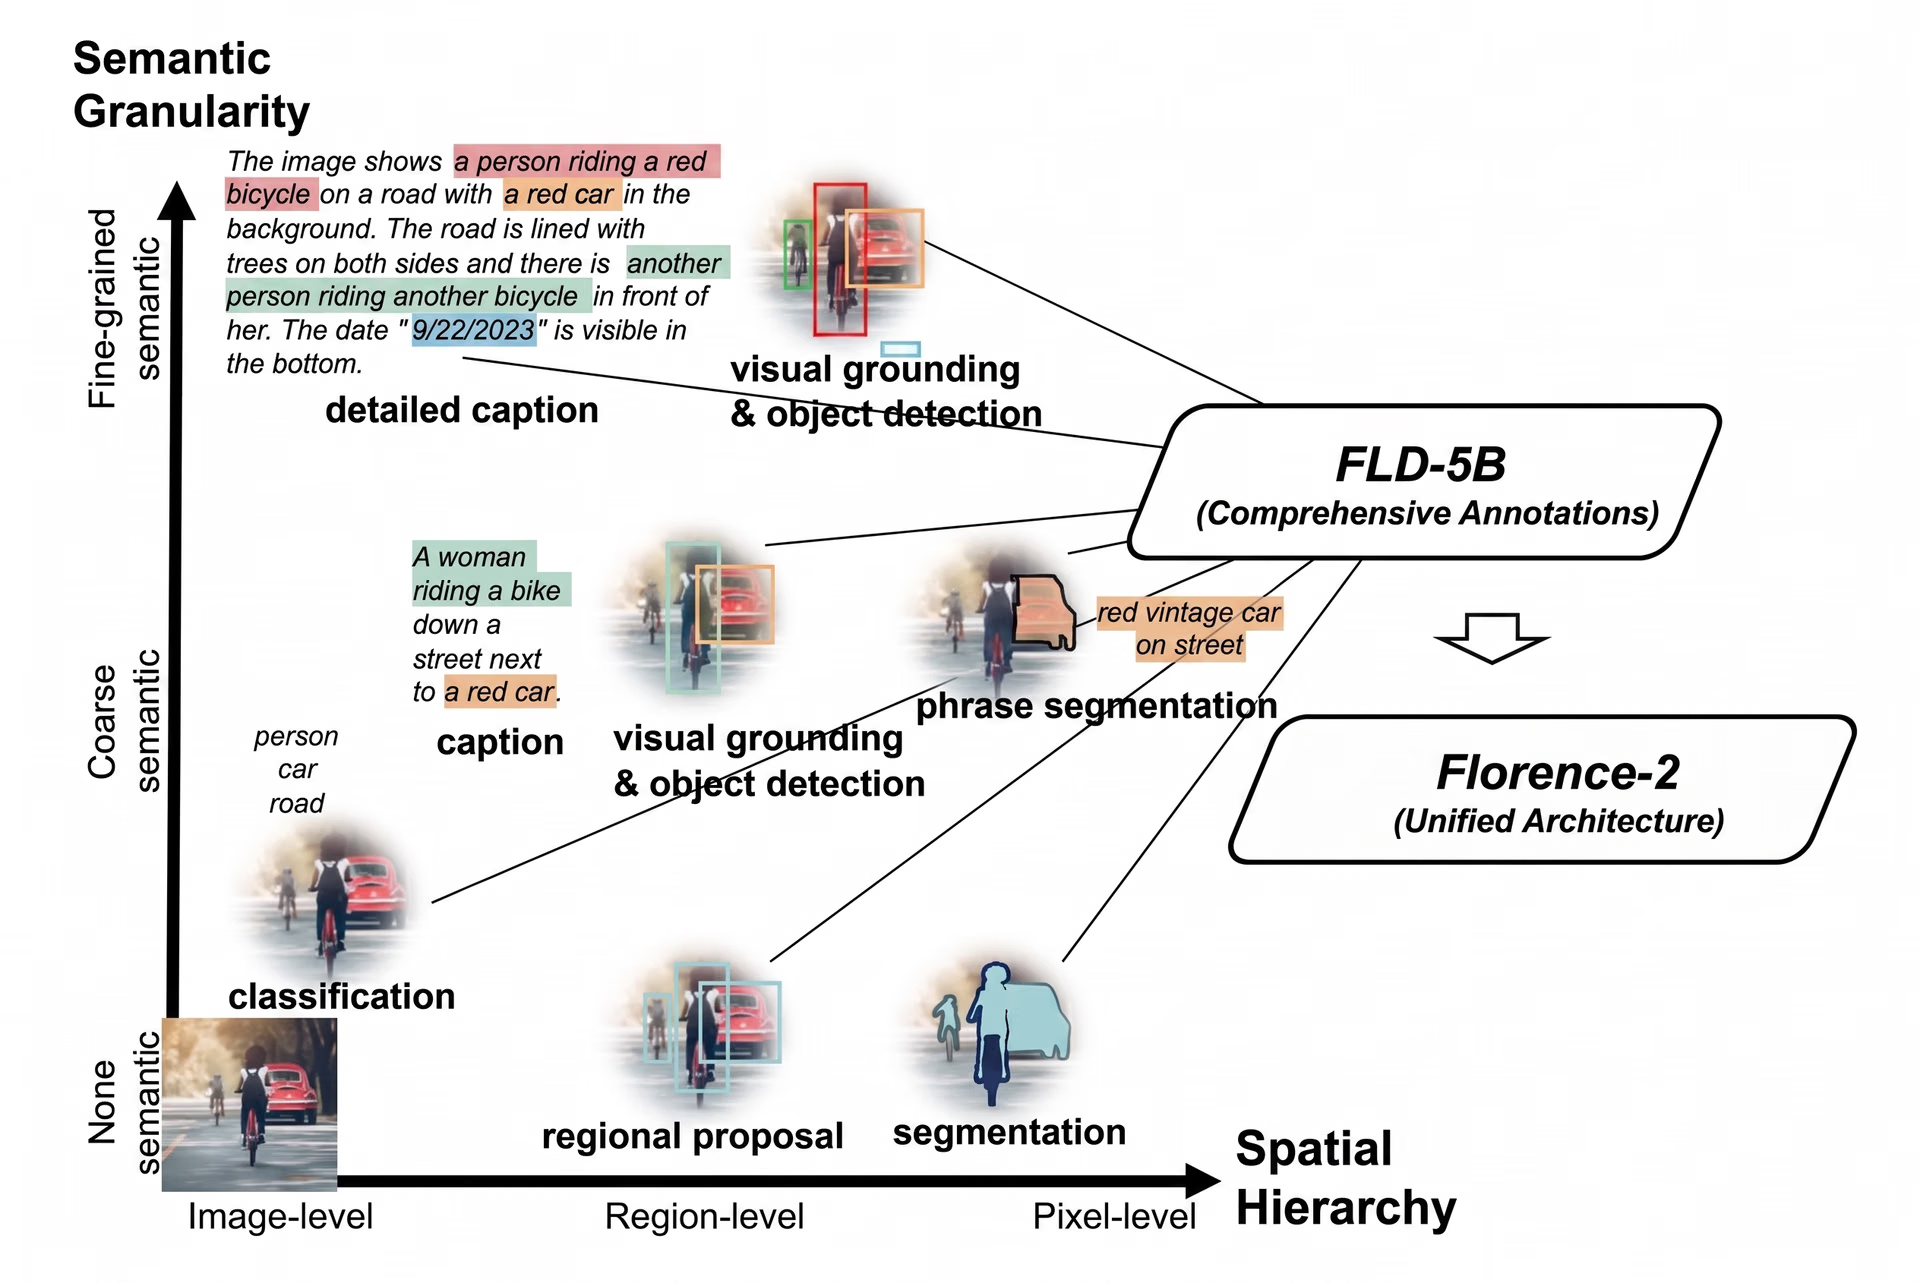
Şekil 1. Florence-2'nin nasıl eğitildiğini anlama.
Model hem metin tabanlı hem de bölge tabanlı görevleri destekler. Görüntünün belirli bölgelerini içeren görevler için modele özel konum belirteçleri eklenir. Bu belirteçler, modelin nesnelerin çevresindeki dikdörtgenler (kutu gösterimi), dört kenarlı şekiller (dörtgen kutu gösterimi) ve çok kenarlı şekiller (çokgen gösterimi) gibi farklı şekilleri anlamasına yardımcı olur. Model, tahminlerini doğru yanıtlarla karşılaştırıp iç parametrelerini buna göre ayarlayarak öğrenmesini sağlayan standart bir çapraz entropi kaybı işleviyle eğitilir.
FLD-5B veri kümesinin oluşturulması#
FLD-5B veri kümesi farklı türlerde açıklamalar içerir: metin açıklamaları, bölge ve metin çiftleri ile metin, ifade ve bölge bileşimleri. Veri kümesi, veri toplama ve açıklama eklemeyi içeren iki aşamalı bir süreçle oluşturulmuştur. Görüntüler ImageNet-22k, Objects365, Open Images, Conceptual Captions ve LAION gibi popüler veri kümelerinden alınmıştır. FLD-5B veri kümesindeki açıklamaların çoğu sentetiktir; yani elle etiketlenmek yerine otomatik olarak oluşturulmuştur.
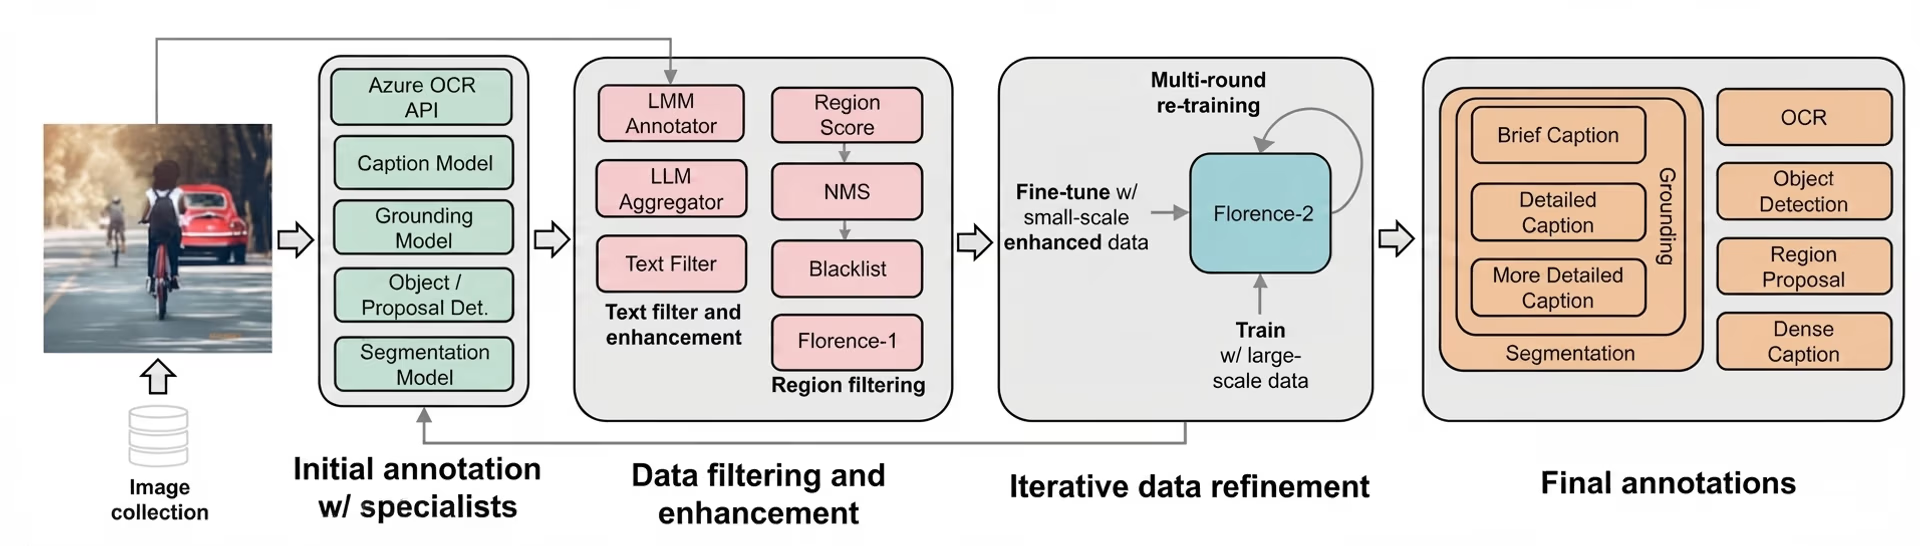
Şekil 2. FLD-5B veri kümesinin oluşturulması.
İlk olarak, nesne algılama veya segmentasyon gibi belirli görevlerde uzmanlaşmış modeller bu açıklamaları oluşturdu. Ardından, açıklamaların ayrıntılı ve doğru olmasını sağlamak için bir filtreleme ve iyileştirme süreci uygulandı. Gürültü temizlendikten sonra veri kümesi yinelemeli olarak iyileştirildi; bu süreçte Florence-2'nin çıktıları, açıklamaları sürekli güncellemek ve geliştirmek için kullanıldı.
Florence-2 model mimarisini anlama#
Florence-2'nin model mimarisi, diziden diziye öğrenme yaklaşımını izler. Bu, modelin bir giriş dizisini (metin istemi içeren bir görüntü gibi) işlemesi ve adım adım bir çıkış dizisi (açıklama veya etiket gibi) oluşturması anlamına gelir. Diziden diziye çerçevesinde her görev bir çeviri problemi olarak ele alınır: model, bir giriş görüntüsüyle göreve özgü bir istem alır ve karşılık gelen çıktıyı oluşturur.
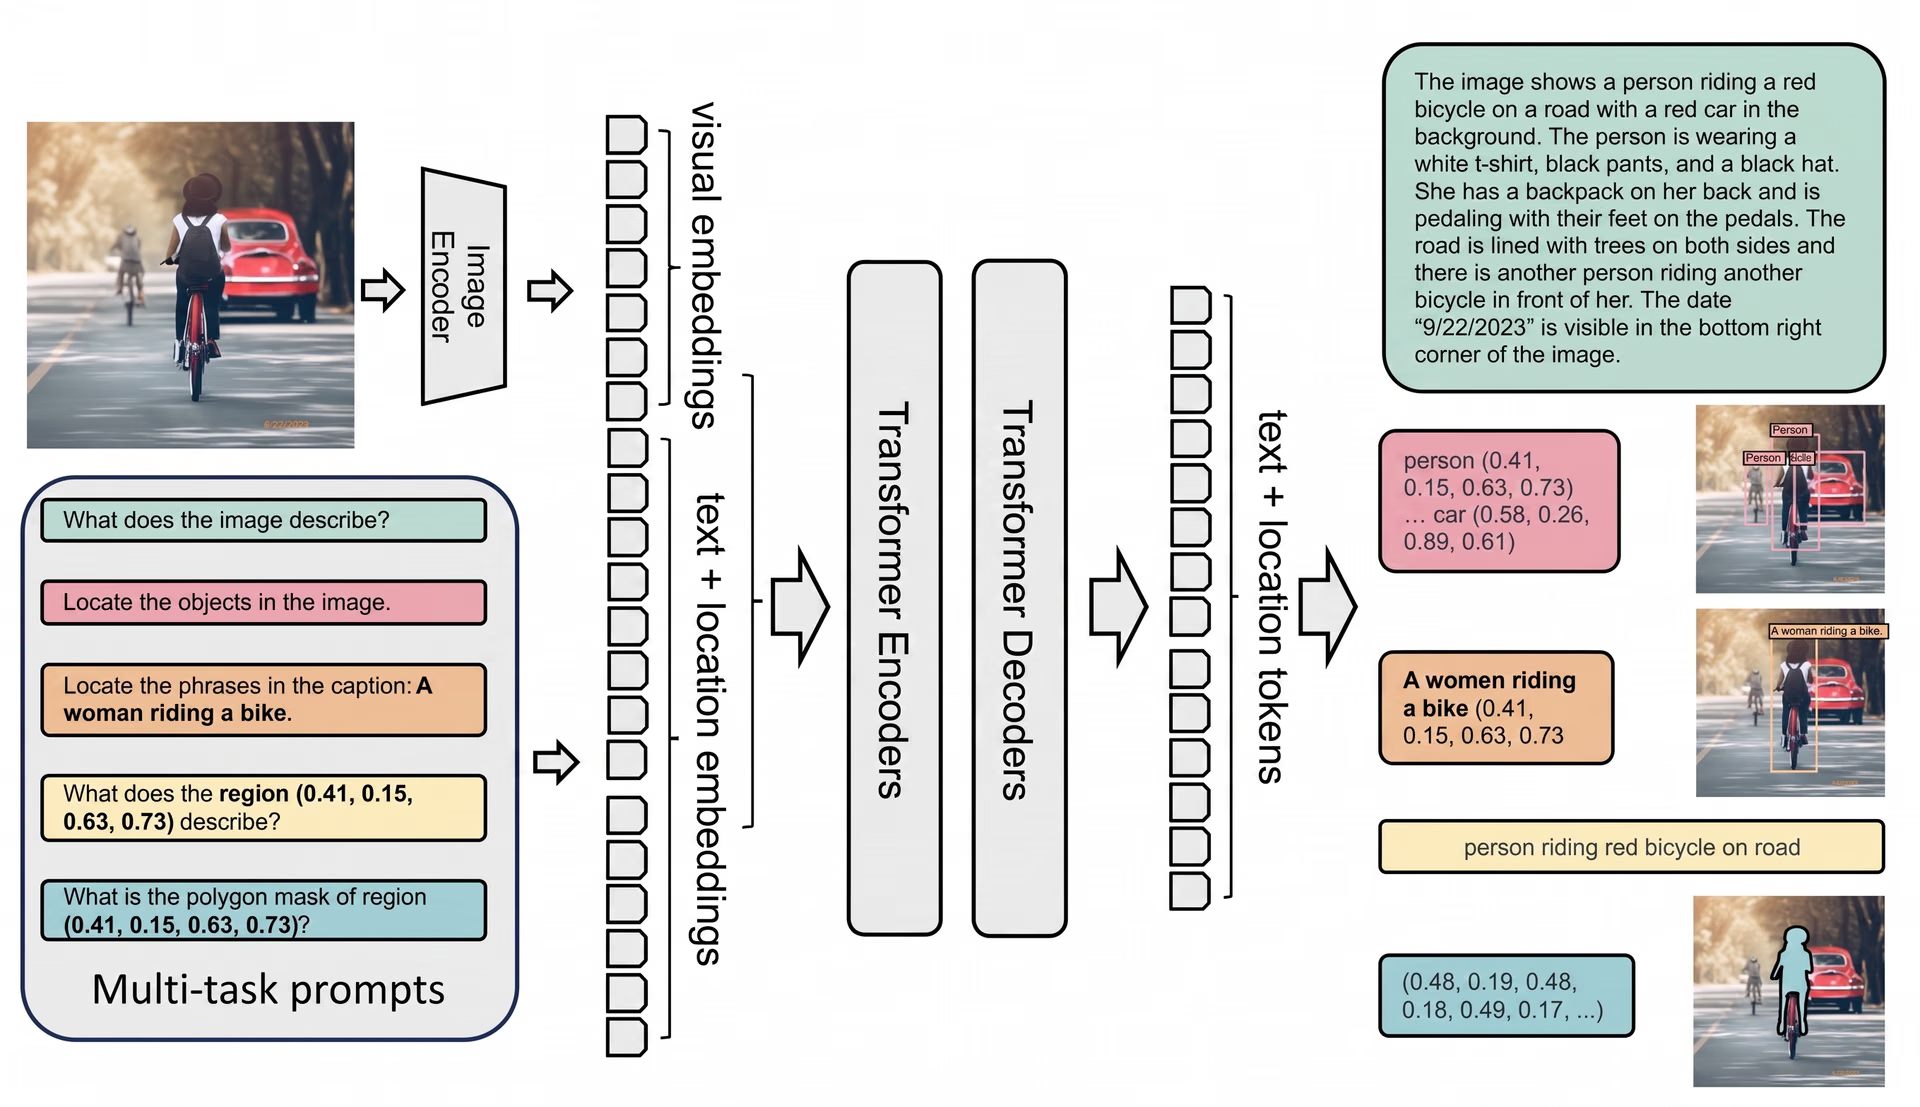
Şekil 3. Florence-2 görsel-dil modeli mimarisi.
Model mimarisinin temelinde, görüntü kodlayıcı ile çok kipli bir kodlayıcı-çözücüyü birleştiren çok kipli bir kodlayıcı-çözücü Transformer bulunuyor. DaViT (Dual Attention Vision Transformer) adı verilen görüntü kodlayıcı, girdi görüntülerini görsel belirteç gömmelerine dönüştürerek işler. Bunlar, hem uzamsal (nesnelerin nerede olduğu) hem de anlamsal (nesnelerin ne olduğu) bilgileri yakalayan, görüntünün özlü temsilleridir. Modelin metinsel ve görsel verileri birleştirmesini sağlamak için bu görsel belirteçler daha sonra metin gömmeleriyle (metnin temsilleriyle) bir araya getirilir.
Florence-2'yi diğer VLM'lerle karşılaştırma#
Florence-2, güçlü sıfır örnekli yetenekleriyle diğer görsel-dil modellerinden ayrılır. Çeşitli görevlere uyum sağlamak için kapsamlı ince ayara dayanan PaliGemma gibi modellerin aksine Florence-2, kullanıma hazır hâliyle iyi çalışır. Ayrıca Florence-2, genellikle çok daha fazla parametreye sahip olan ancak performansını her zaman yakalayamayan GPT-4V ve Flamingo gibi büyük modellerle rekabet edebilir. Örneğin Florence-2, Kosmos-2'nin iki kattan fazla parametresi olmasına rağmen sıfır örnekli görevlerde Kosmos-2'den daha iyi sonuçlar elde eder.
Performans kıyaslama testlerinde Florence-2; COCO altyazı oluşturma ve gönderimsel ifade anlama gibi görevlerde güçlü bir performans sergiledi. COCO veri kümesinde nesne algılama ve segmentasyon görevlerinde PolyFormer ve UNINEXT gibi modelleri geride bıraktı. Performans ve kaynak verimliliğinin önemli olduğu gerçek dünya uygulamaları için son derece rekabetçi bir seçenektir. Ultralytics Platform'da algılama veri kümelerine Florence-2 ile otomatik açıklama ekleyebilir ve diğer görsel-dil modelleriyle karşılaştırmasını VLM Liderlik Tablosu üzerinden görebilirsin.
Florence-2'nin uygulamaları#
Florence-2; eğlence, erişilebilirlik, eğitim gibi birçok farklı sektörde kullanılabilir. Daha iyi anlamak için birkaç örneğe göz atalım.
Görüntü açıklaması oluşturma uygulamaları#
Bir yayın platformunda izleyecek bir şey seçmeye çalışırken karar vermene yardımcı olması için bir filmin özetini okuyabilirsin. Peki ya platform film afişinin ayrıntılı bir açıklamasını da sunabilseydi? Florence-2, görüntüler için açıklayıcı metinler oluşturan görüntü açıklaması özelliğiyle bunu mümkün kılabilir. Florence-2, film afişlerinin ayrıntılı açıklamalarını oluşturarak yayın platformlarını görme engelli kullanıcılar için daha kapsayıcı hâle getirebilir. Karakterler, manzara ve metin gibi bir afişin görsel öğelerini analiz ederek afişin içeriğini ve atmosferini aktaran ayrıntılı açıklamalar oluşturabilir. Aşağıdaki görüntü, Florence-2'nin açıklamasında sunabileceği ayrıntı düzeyini gösteriyor.
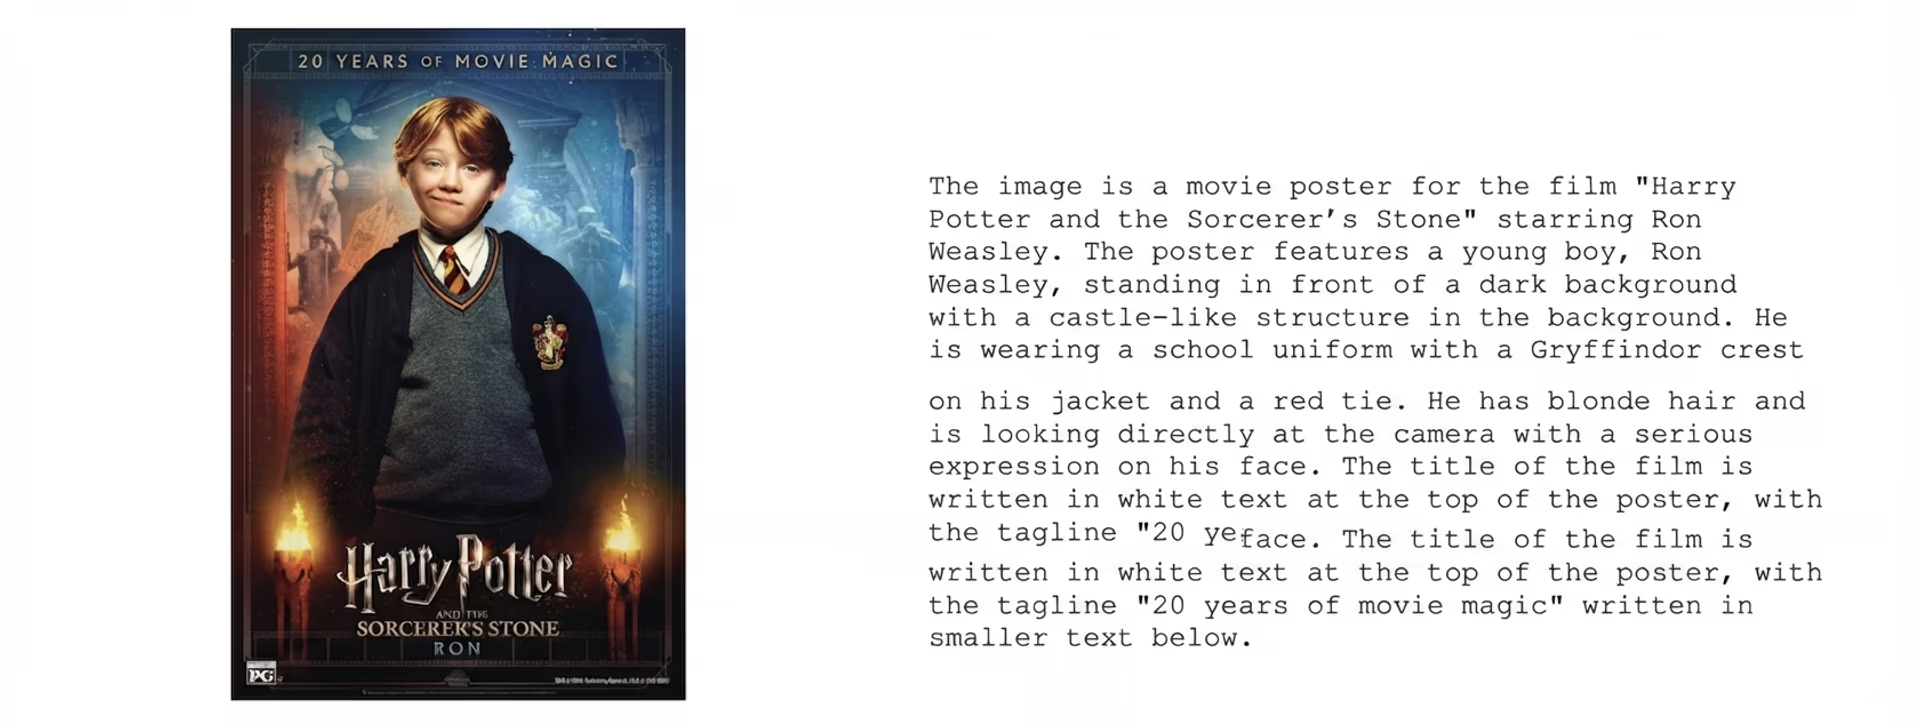
Şekil 4. Florence-2 tarafından oluşturulan görüntü açıklaması örneği.
Görüntü açıklaması oluşturmanın yararlı olabileceği başka bazı örnekler şunlardır:
- E-ticaret: Görüntü açıklamaları, ürün görsellerine ayrıntılı açıklamalar ekleyerek müşterilerin ürün özelliklerini ve ayrıntılarını daha net anlamasına yardımcı olabilir.
- Seyahat ve Turizm: Seyahat rehberlerinde ve uygulamalarında önemli yerler ve turistik noktalar için ayrıntılı açıklamalar sunabilir.
- Eğitim: Görüntü açıklaması, eğitim görsellerini ve şemalarını etiketleyip açıklayarak öğretme ve öğrenmeye katkıda bulunabilir.
- Gayrimenkul: Potansiyel alıcılar için özellikleri ve olanakları öne çıkaran ayrıntılı mülk görseli açıklamaları sunabilir.
Yemek yaparken görsel temellendirmeyi kullanma#
Florence-2, yemek deneyimlerini zenginleştirmek için de kullanılabilir. Örneğin çevrim içi bir yemek kitabı, karmaşık bir tarif görselindeki bölümleri görsel olarak temellendirmek ve etiketlemek için Florence-2'den yararlanabilir. Görsel temellendirme, görüntünün belirli bölümlerini bunlara karşılık gelen açıklayıcı metinlerle ilişkilendirerek yardımcı olur. Her malzeme ve adım doğru biçimde etiketlenip açıklanabilir; böylece evde yemek yapanlar tarifi daha kolay izler ve her bileşenin yemekteki rolünü anlayabilir.
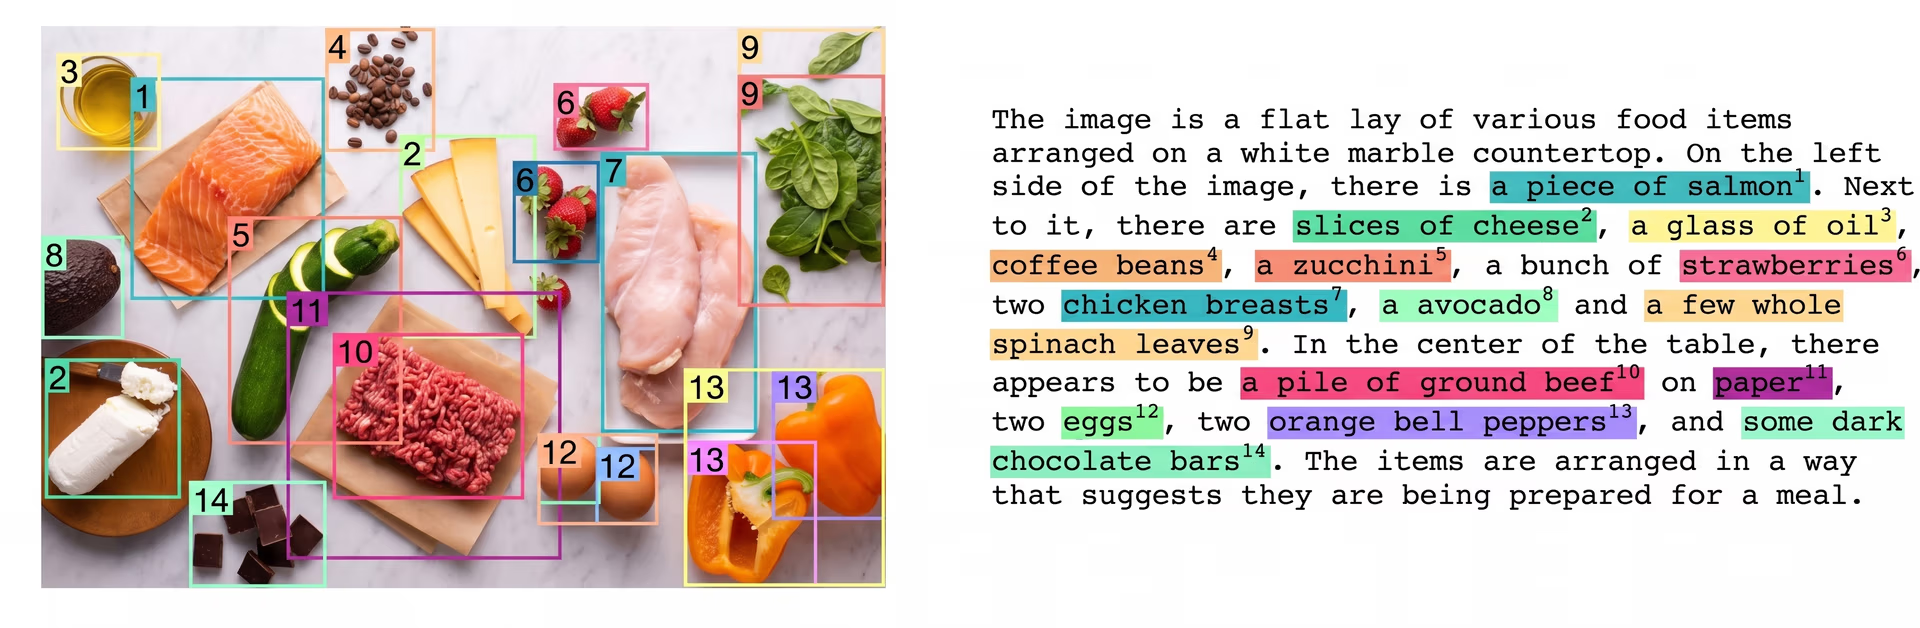
Şekil 5. Florence-2 kullanılarak görsel temellendirme örneği.
Finansal belgeler için bölge tabanlı OCR#
Bir belgenin belirli alanlarından metin çıkarmaya odaklanan bölge tabanlı OCR, muhasebe gibi alanlarda kullanışlı olabilir. Finansal belgelerde belirlenmiş alanlar analiz edilerek işlem ayrıntıları, hesap numaraları ve son ödeme tarihleri gibi önemli bilgiler otomatik olarak çıkarılabilir. Elle veri girişi ihtiyacını azaltarak hataları en aza indirir ve işlem sürelerini kısaltır. Finans kuruluşları bu yöntemi fatura işleme, makbuz mutabakatı ve çek takası gibi görevleri kolaylaştırmak için kullanabilir; böylece işlemler hızlanır ve müşteri hizmetleri iyileşir.
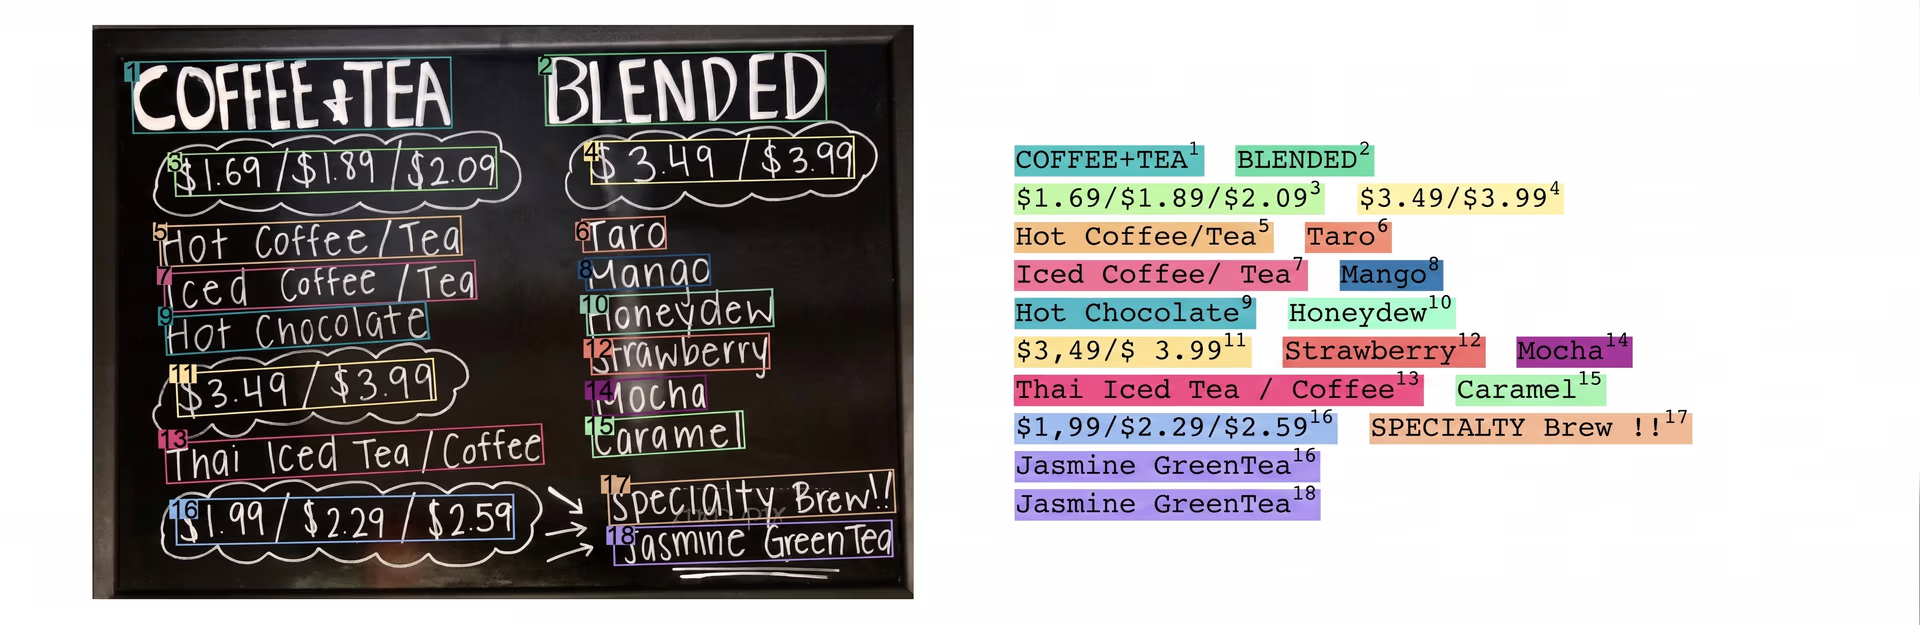
Şekil 6. Florence-2 kullanılarak bölge tabanlı OCR ile metin çıkarma örneği.
Endüstriyel uygulamalarda bölge tabanlı segmentasyon#
Odaklı analiz ve ayrıntılı inceleme için görüntüyü anlamlı parçalara ayıran bölge tabanlı segmentasyon, çeşitli süreçlerde hassasiyeti ve verimliliği artıran endüstriyel uygulamalara güç katabilir. Bu teknoloji, bir görüntüdeki belirli alanlara odaklanarak bileşenlerin ve ürünlerin ayrıntılı biçimde incelenmesini ve analiz edilmesini sağlar. Kalite kontrolünde malzemelerdeki çatlaklar veya hizalama hataları gibi kusurları ve tutarsızlıkları belirleyerek pazara yalnızca en kaliteli ürünlerin ulaşmasını sağlar.
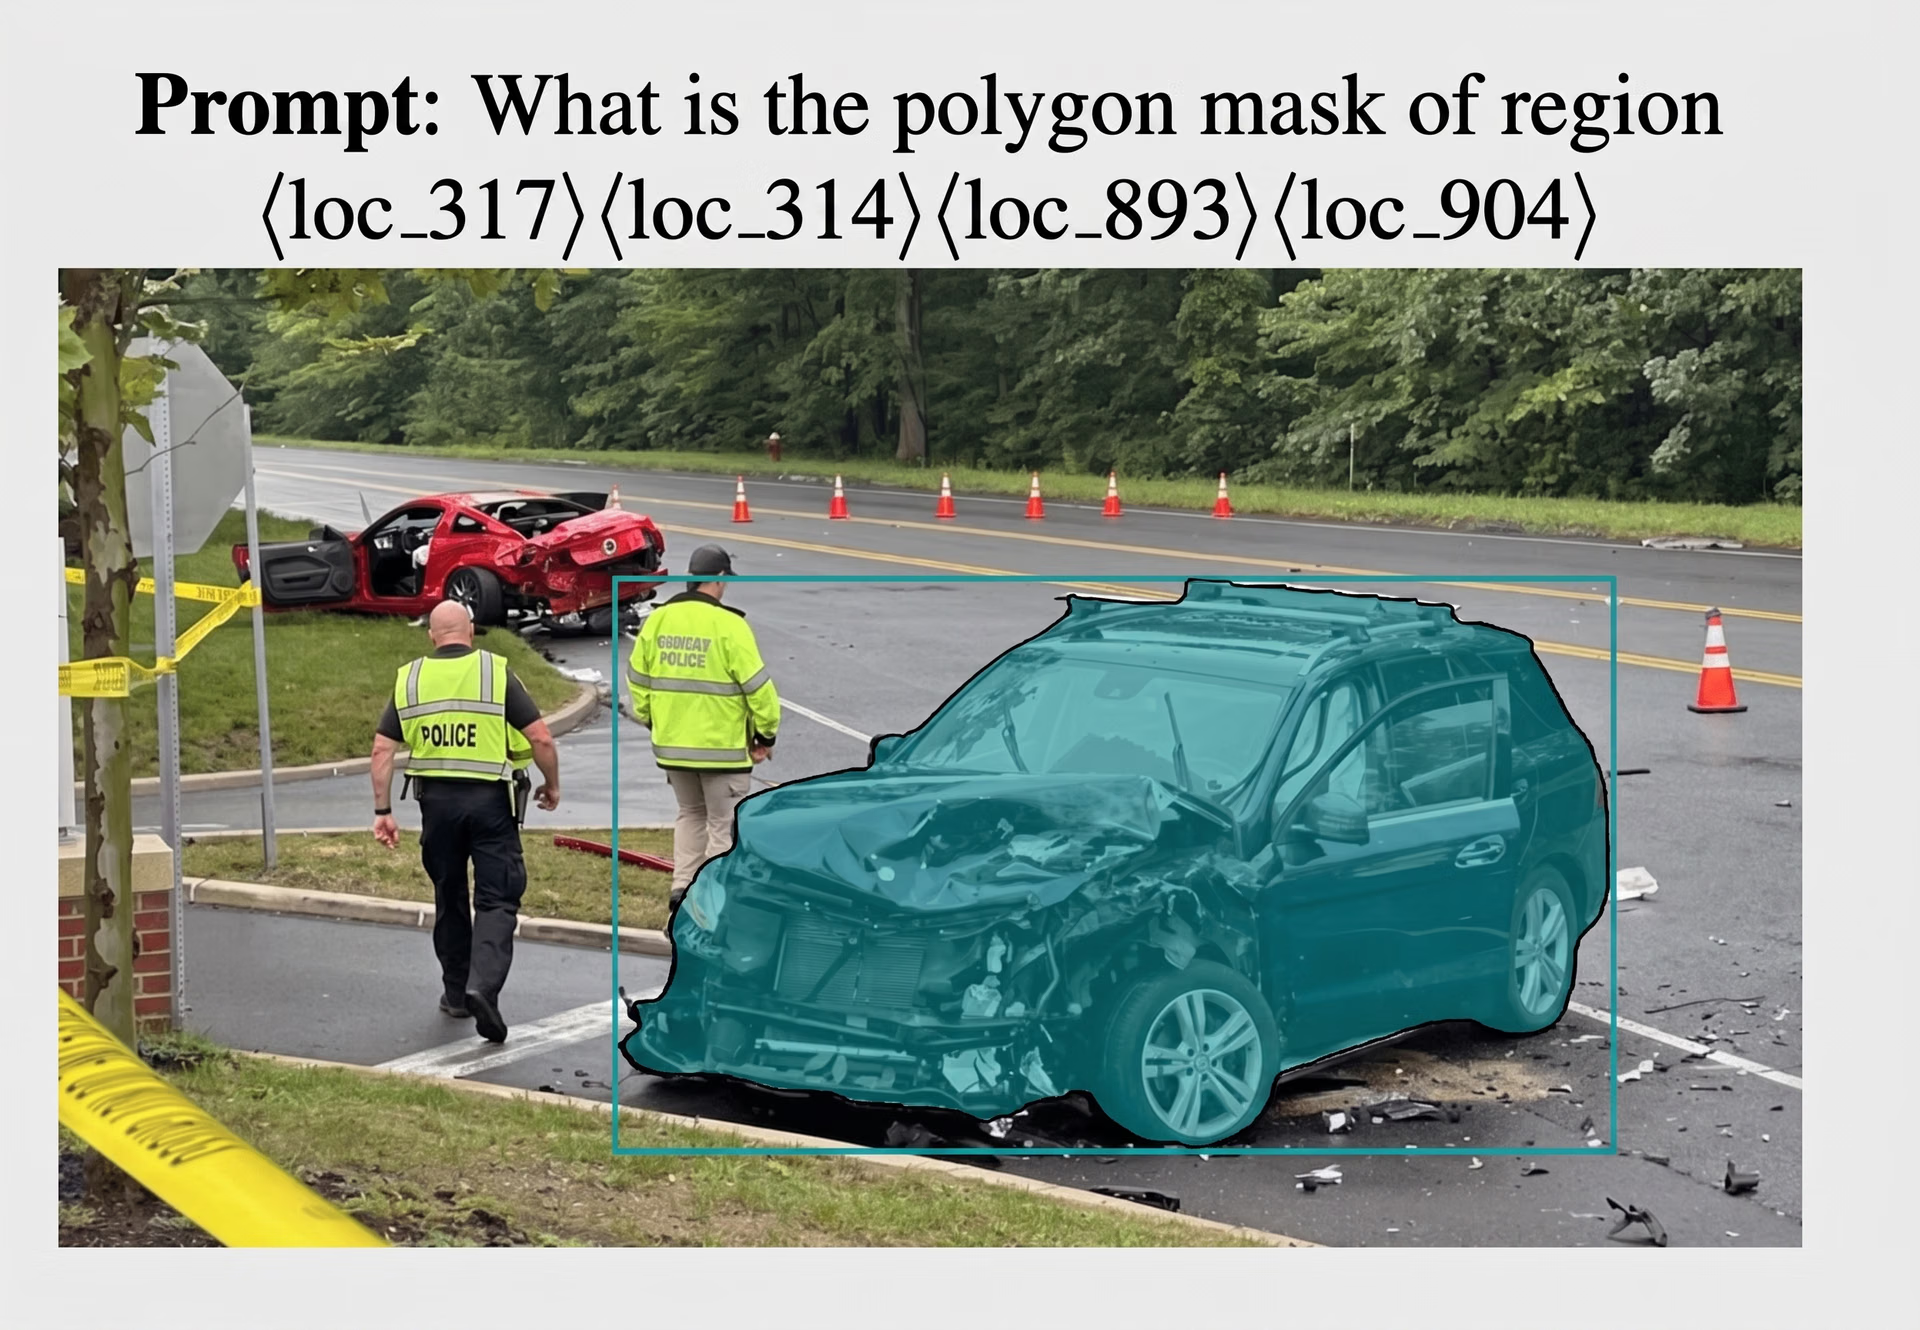
Şekil 7. Florence-2 kullanılarak bölgelere dayalı segmentasyon örneği.
Ayrıca robotik kolları belirli parçalara yönlendirip bileşenlerin yerleştirilmesini ve montajını optimize ederek otomatik montaj hatlarını iyileştirir. Benzer şekilde envanter yönetiminde malların durumunu ve konumunu izlemeye yardımcı olur; bu da lojistiği daha verimli hâle getirir ve duruş süresini azaltır. Genel olarak bölge tabanlı segmentasyon doğruluğu ve üretkenliği artırarak endüstriyel ortamlarda maliyet tasarrufu ve daha yüksek ürün kalitesi sağlar.
Önemli çıkarımlar#
Yüksek performansı korurken yapay zekâ modellerinin hafiflediği bir eğilimin başladığını görüyoruz. Florence-2, görsel-dil modelleri için ileriye doğru atılmış önemli bir adımdır. Nesne algılama, segmentasyon, görüntü açıklaması oluşturma ve temellendirme gibi çeşitli görevleri etkileyici sıfır örnekli performansla yerine getirebilir. Daha küçük boyutuna rağmen Florence-2 verimli ve çok işlevlidir; bu da onu farklı sektörlerdeki uygulamalar için yararlı kılar. Florence-2 gibi modeller yeni olanaklar sunarak yapay zekâ yeniliklerinin potansiyelini genişletiyor.
Yapay zekâ hakkında daha fazla bilgi edinmek için GitHub depomuzu ziyaret et ve topluluğumuza katıl. Yapay zekânın üretim ve tarım alanlarındaki uygulamaları hakkında bilgi edinmek için çözümler sayfalarımıza göz at.
Yazan
İçerik Üreticisi · Ultralytics
Yorumlar
Soru sor, sonuçlarını paylaş veya başka birine yardım et.









