Mask R-CNN nedir ve nasıl çalışır?
Mask R-CNN'in omurgasından bölge öneri ağına, ROI Align'a ve maske tahminine kadar nasıl çalıştığını; kullanım alanlarını, sınırlarını ve YOLO haleflerini öğren.
 Abirami Vina7 dakikalık okuma
Depolardaki robotlar, yoğun caddelerde güvenle ilerleyen otonom araçlar, ekinleri kontrol eden dronlar ve fabrikalarda ürünleri inceleyen yapay zekâ sistemleri gibi yenilikler, yapay zekâ kullanımı arttıkça yaygınlaşıyor. Bu yeniliklerin temelindeki teknolojilerden biri, makinelerin görsel verileri anlamasını ve yorumlamasını sağlayan bir yapay zekâ dalı olan bilgisayarlı görüdür.
Örneğin, nesne algılama; görüntülerdeki nesneleri sınırlayıcı kutular kullanarak tanımlamaya ve konumlarını belirlemeye yardımcı olan bir bilgisayarlı görü görevidir. Sınırlayıcı kutular yararlı bilgiler sunsa da nesnenin konumuna ilişkin yalnızca yaklaşık bir tahmin verir ve nesnenin tam şeklini ya da sınırlarını gösteremez. Bu nedenle hassas tanımlama gerektiren uygulamalarda daha az etkilidir.
Bu sorunu çözmek için araştırmacılar, daha doğru algılama ve analiz amacıyla nesnelerin tam hatlarını yakalayan ve piksel düzeyinde ayrıntılar sunan segmentasyon modelleri geliştirdi.
Mask R-CNN bu modellerden biridir. Facebook Yapay Zekâ Araştırmaları (FAIR) tarafından 2017'de tanıtılan bu model, R-CNN, Fast R-CNN ve Faster R-CNN gibi önceki modelleri temel alır. Bilgisayarlı görü tarihindeki önemli bir dönüm noktası olan Mask R-CNN, Ultralytics YOLO11 gibi daha gelişmiş modellere zemin hazırladı.
Bu makalede Mask R-CNN'in ne olduğunu, nasıl çalıştığını, uygulama alanlarını ve ardından Ultralytics YOLO11'e uzanan süreçte hangi iyileştirmelerin yapıldığını inceleyeceğiz.
Mask R-CNN'e genel bakış#
Açılımı Maskeli Bölge Tabanlı Evrişimsel Sinir Ağı olan Mask R-CNN, nesne algılama ve örnek segmentasyonu gibi bilgisayarlı görü görevleri için tasarlanmış bir derin öğrenme modelidir.
Örnek segmentasyonu, görüntüdeki nesneleri yalnızca tanımlamakla kalmayıp her birinin dış hatlarını da hassas biçimde belirleyerek geleneksel nesne algılamanın ötesine geçer. Algılanan her nesneye benzersiz bir etiket atar ve tam şeklini piksel düzeyinde yakalar. Bu ayrıntılı yaklaşım, üst üste binen nesneleri net biçimde ayırt etmeyi ve karmaşık şekilleri doğru şekilde işlemeyi mümkün kılar.
Mask R-CNN, nesneleri algılayıp etiketleyen ancak tam şekillerini belirlemeyen Faster R-CNN'i temel alır. Mask R-CNN, her nesneyi oluşturan pikselleri belirleyerek bu yaklaşımı geliştirir ve görüntülerin çok daha ayrıntılı ve doğru biçimde analiz edilmesini sağlar.
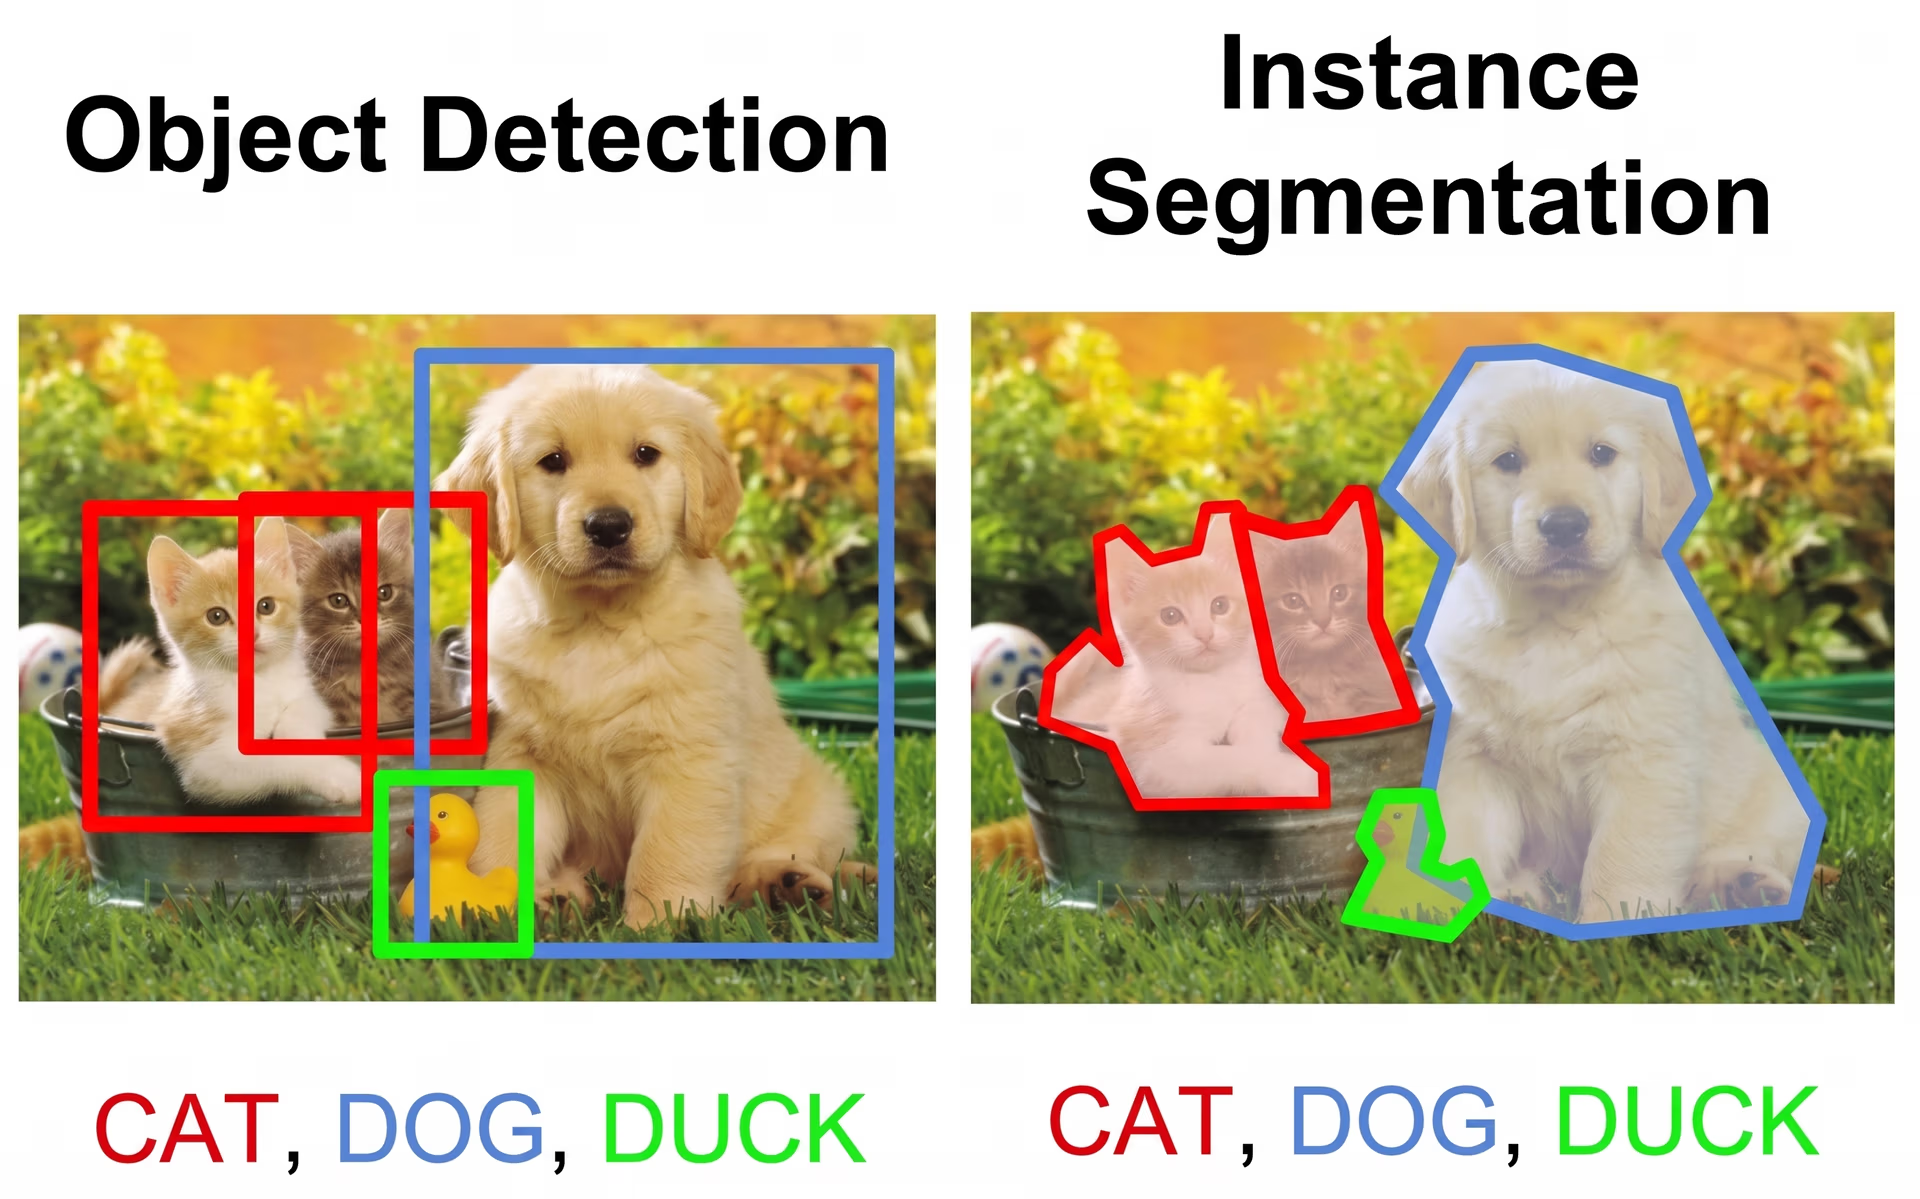
Şekil 1. Nesne algılama ve örnek segmentasyonunun karşılaştırması.
Mask R-CNN mimarisine ve çalışma şekline bakış#
Mask R-CNN, nesneleri doğru şekilde algılamak ve segmentlere ayırmak için adım adım ilerler. Önce derin bir sinir ağı (verilerden öğrenen çok katmanlı bir model) kullanarak temel özellikleri çıkarır, ardından bölge öneri ağı (olası nesne bölgelerini öneren bir bileşen) ile potansiyel nesne alanlarını belirler ve son olarak her nesnenin tam şeklini yakalayan ayrıntılı segmentasyon maskeleri (nesnelerin hassas dış hatları) oluşturarak bu alanları iyileştirir.
Şimdi Mask R-CNN'in nasıl çalıştığını daha iyi anlamak için her adımı ele alacağız.
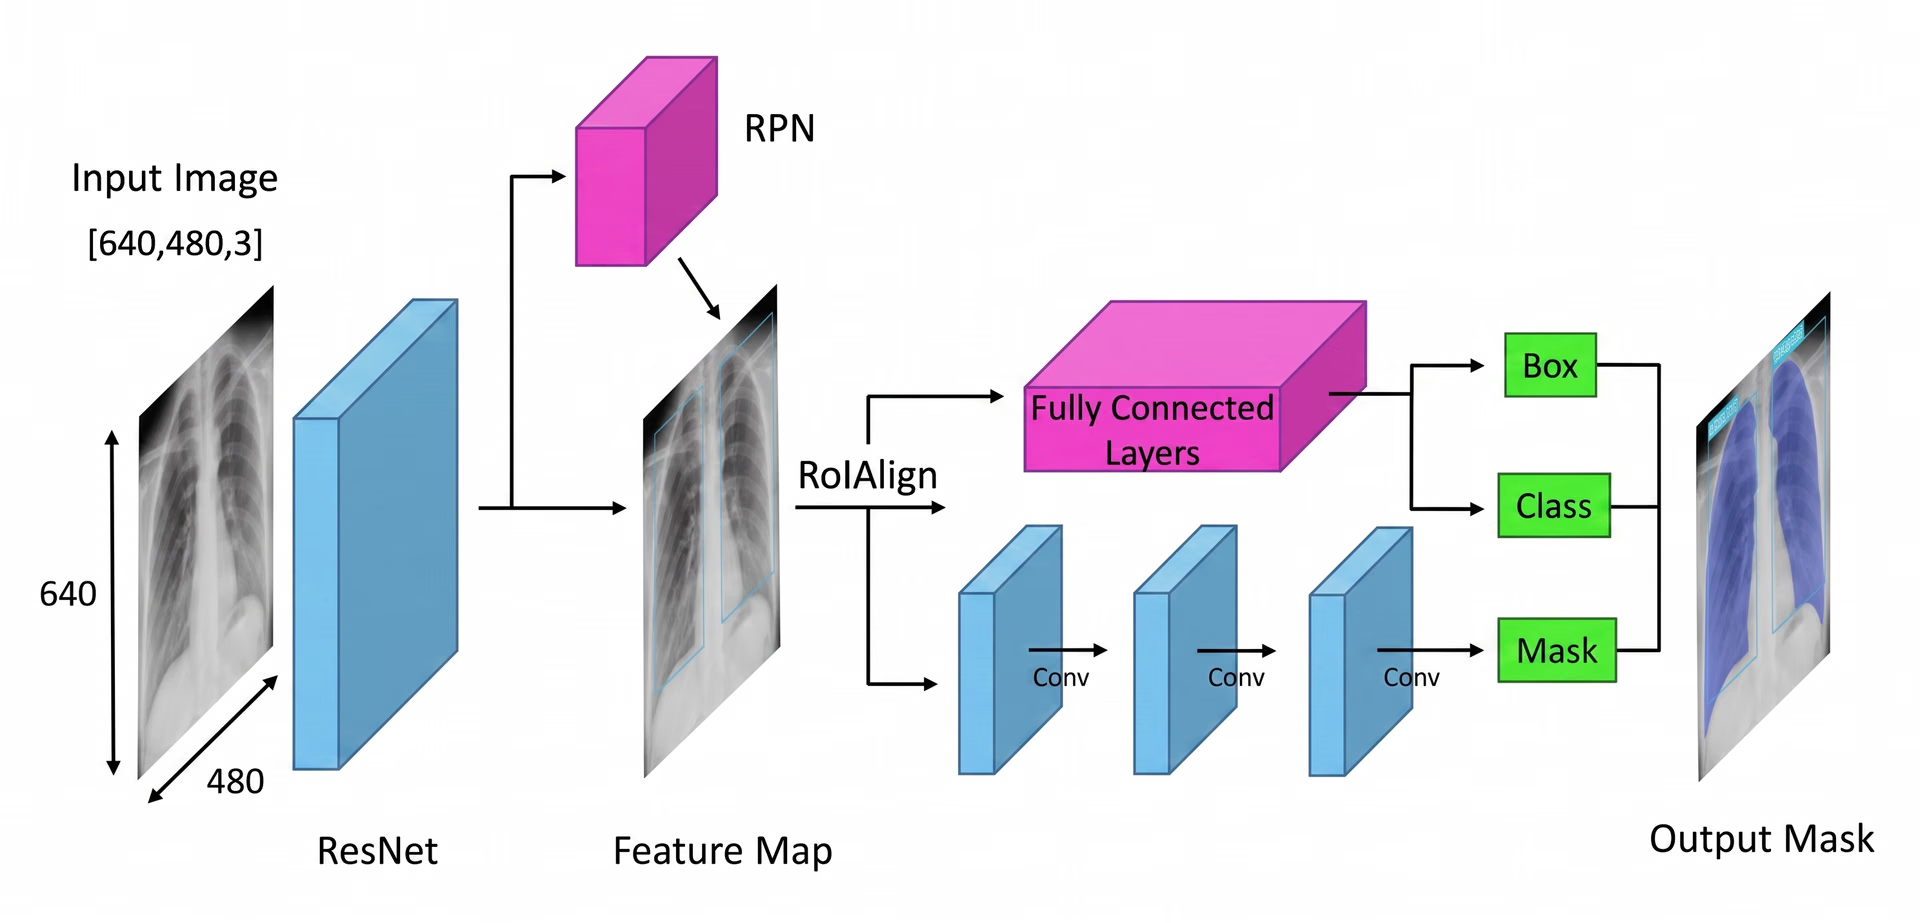
Şekil 2. Mask R-CNN mimarisine genel bakış (Kaynak: researchgate.net).
Özellik çıkarımıyla başlama#
Mask R-CNN mimarisinin ilk adımı, modelin görüntüde neler olduğunu anlayabilmesi için görüntüyü temel bileşenlerine ayırmaktır. Bir fotoğrafa bakıp şekiller, renkler ve kenarlar gibi ayrıntıları doğal olarak fark ettiğini düşün. Model de görüntüyü tarayıp önemli ayrıntıları yakalamak için, gözleri gibi çalışan ve genellikle ResNet-50 veya ResNet-101 olan, "omurga" adı verilen derin bir sinir ağı kullanarak benzer bir işlem yapar.
Görüntülerdeki nesneler çok küçük veya çok büyük olabileceğinden Mask R-CNN bir Özellik Piramidi Ağı kullanır. Bu, modelin hem ince ayrıntıları hem de genel görünümü görmesini sağlayan farklı büyüteçlere sahip olmak gibidir; böylece her boyuttaki nesnenin fark edilmesi sağlanır.
Bu önemli özellikler çıkarıldıktan sonra model, görüntüdeki potansiyel nesneleri bulmaya geçerek sonraki analiz aşamasının temelini oluşturur.
Görüntüde nesnelerin bulunabileceği alanları önerme#
Görüntü temel özellikleri bulmak için işlendikten sonra Bölge Öneri Ağı devreye girer. Modelin bu bölümü görüntüyü inceler ve nesne içerme olasılığı yüksek alanları önerir.
Bunu, çapalar adı verilen birden çok olası nesne konumu oluşturarak yapar. Ağ daha sonra bu çapaları değerlendirir ve ileri analiz için en umut verici olanları seçer. Böylece model, görüntüdeki her noktayı incelemek yerine yalnızca ilgi çekici olma olasılığı en yüksek alanlara odaklanır.
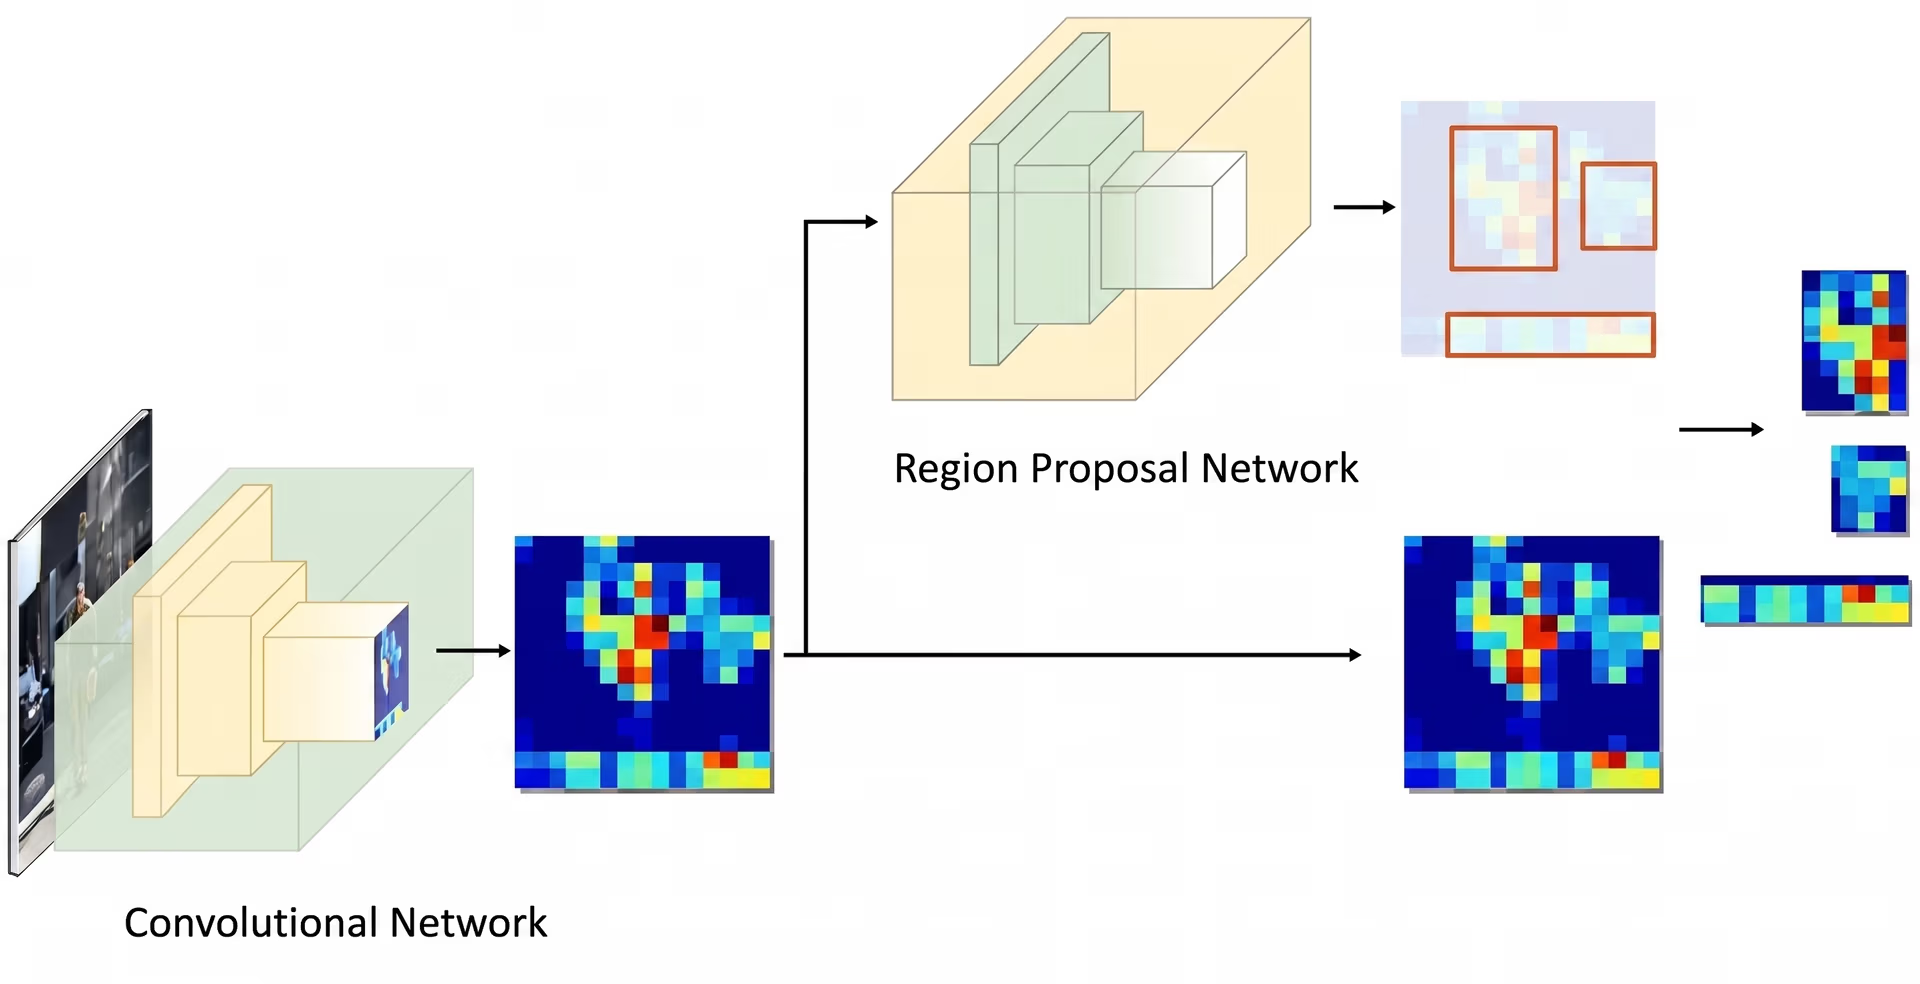
Şekil 3. Bölge Öneri Ağı örneği.
Çıkarılan özellikleri iyileştirme#
Temel alanlar belirlendikten sonraki adım, bu bölgelerden çıkarılan ayrıntıları iyileştirmektir. Önceki modeller, her alandan özellik almak için İlgi Bölgesi Havuzlama (ROI Pooling) adı verilen bir yöntem kullanıyordu; ancak bu teknik, bölgeleri yeniden boyutlandırırken bazen küçük hizalama hatalarına yol açıyor ve özellikle küçük ya da üst üste binen nesnelerde daha az etkili oluyordu.
Mask R-CNN, ROI Align (İlgi Bölgesini Hizalama) adı verilen bir teknikle bunu geliştirir. ROI Pooling'in yaptığı gibi koordinatları yuvarlamak yerine ROI Align, piksel değerlerini daha hassas tahmin etmek için çift doğrusal enterpolasyon kullanır. Çift doğrusal enterpolasyon, dört en yakın komşunun değerlerinin ağırlıklı ortalamasını alarak yeni bir piksel değeri hesaplayan ve daha yumuşak geçişler oluşturan bir yöntemdir. Bu, özelliklerin özgün görüntüyle doğru biçimde hizalanmasını sağlayarak nesne algılama ve bölütleme doğruluğunu artırır.
Örneğin, bir futbol maçında birbirine yakın duran iki oyuncu, sınırlayıcı kutuları üst üste geldiği için tek bir oyuncu sanılabilir. ROI Align, şekillerini birbirinden ayrı tutarak bu oyuncuları ayırmaya yardımcı olur.
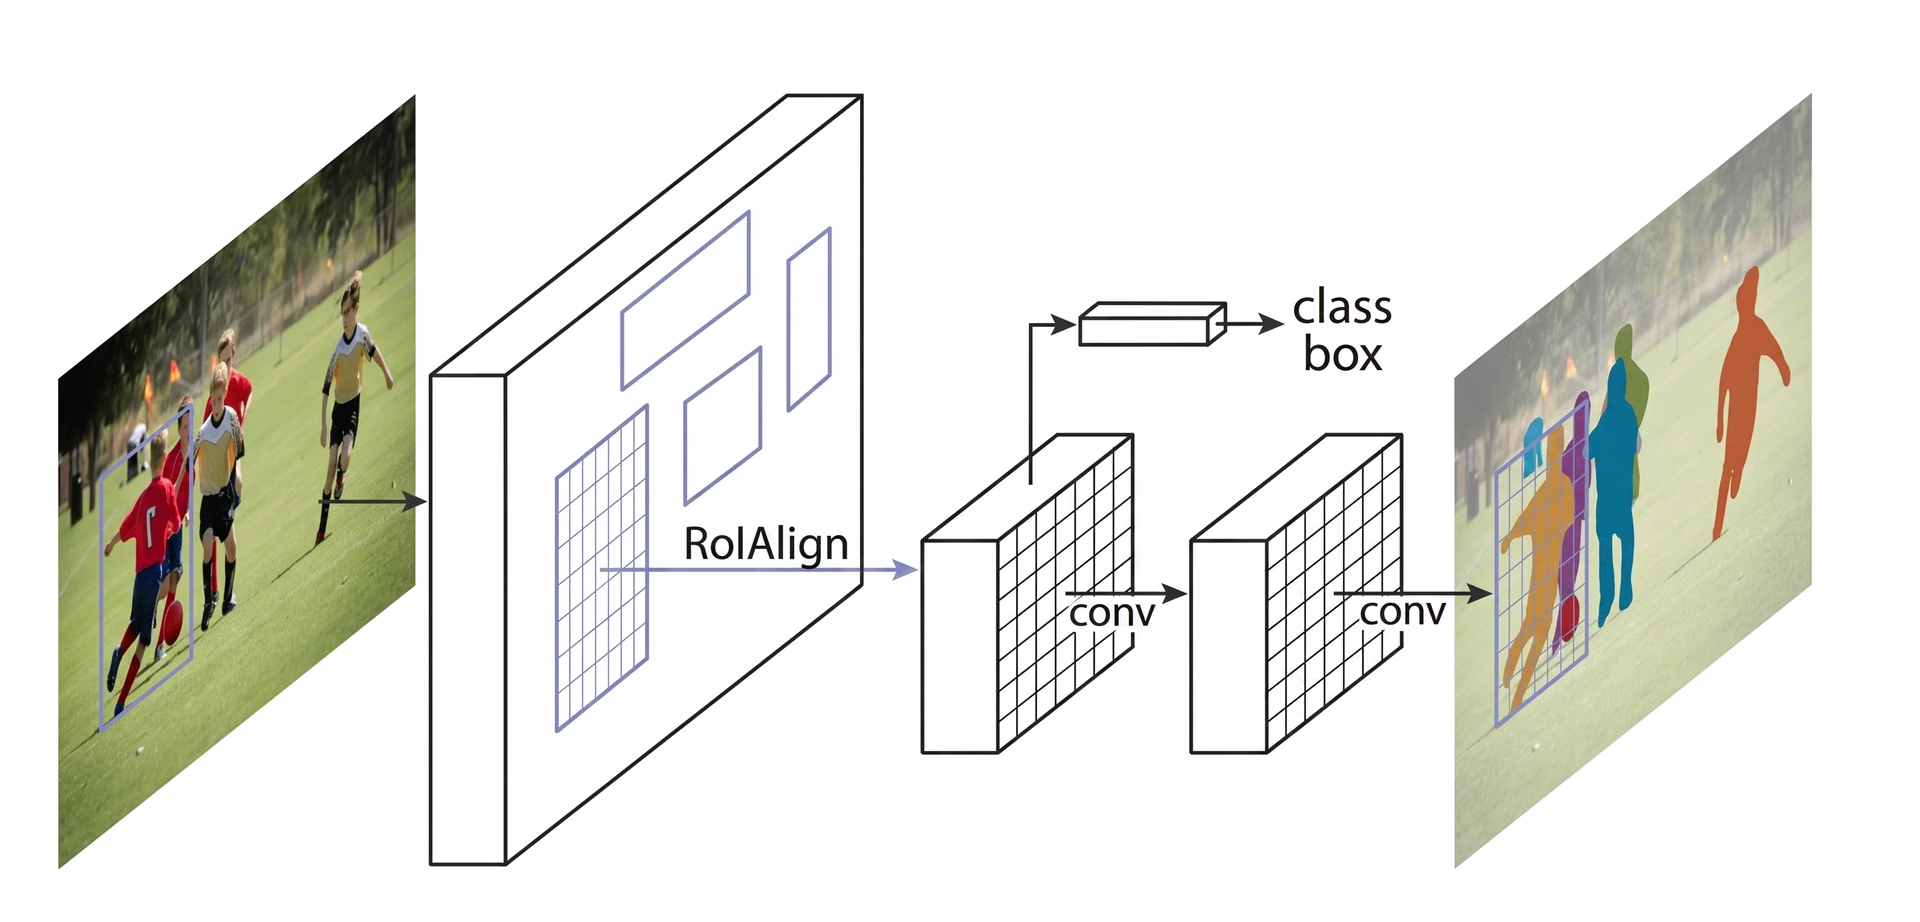
Şekil 4. Mask R-CNN, ROI Align kullanır.
Nesneleri sınıflandırma ve maskelerini tahmin etme#
ROI Align görüntüyü işledikten sonraki adım, nesneleri sınıflandırmak ve konumlarını hassaslaştırmaktır. Model, çıkarılan her bölgeyi inceler ve hangi nesneyi içerdiğine karar verir. Farklı kategoriler için olasılık puanları atar ve en iyi eşleşmeyi seçer.
Aynı zamanda, nesnelere daha iyi uyum sağlamaları için sınırlayıcı kutuları ayarlar. İlk kutular ideal şekilde yerleştirilmemiş olabilir; bu nedenle bu işlem, her kutunun algılanan nesneyi sıkıca çevrelemesini sağlayarak doğruluğu artırmaya yardımcı olur.
Son olarak Mask R-CNN, ek bir adım olarak her nesne için ayrıntılı bir segmentasyon maskesi oluşturur ve bunu paralel biçimde gerçekleştirir.
Mask R-CNN ve gerçek dünya uygulamaları#
Bu model piyasaya çıktığında yapay zekâ topluluğunda büyük heyecan yarattı ve kısa süre içinde çeşitli uygulamalarda kullanılmaya başlandı. Nesneleri piksel düzeyinde hassasiyetle algılayıp bölütleyebilmesi, onu farklı sektörlerde popüler hâle getirdi.
Örneğin, vahşi doğada nesli tükenmekte olan hayvanları izlemek zorlu bir iştir. Pek çok tür sık ormanlarda dolaştığından, koruma uzmanlarının onları takip etmesi zordur. Geleneksel yöntemlerde fotokapanlar, dronlar ve uydu görüntüleri kullanılır; ancak tüm bu verileri elle ayıklamak zaman alır. Yanlış teşhisler ve gözden kaçan görüntüler, koruma çalışmalarını yavaşlatabilir.
Kaplan çizgileri, zürafa benekleri veya fil kulaklarının şekli gibi benzersiz özellikleri tanıyan Mask R-CNN, görüntü ve videolardaki hayvanları daha yüksek doğrulukla algılayıp segmentlere ayırabilir. Hayvanlar ağaçların arkasında kısmen gizlendiğinde veya birbirlerine yakın durduğunda bile model onları birbirinden ayırıp her birini tek tek tanımlayabilir; bu da yaban hayatı izlemeyi daha hızlı ve güvenilir hâle getirir.
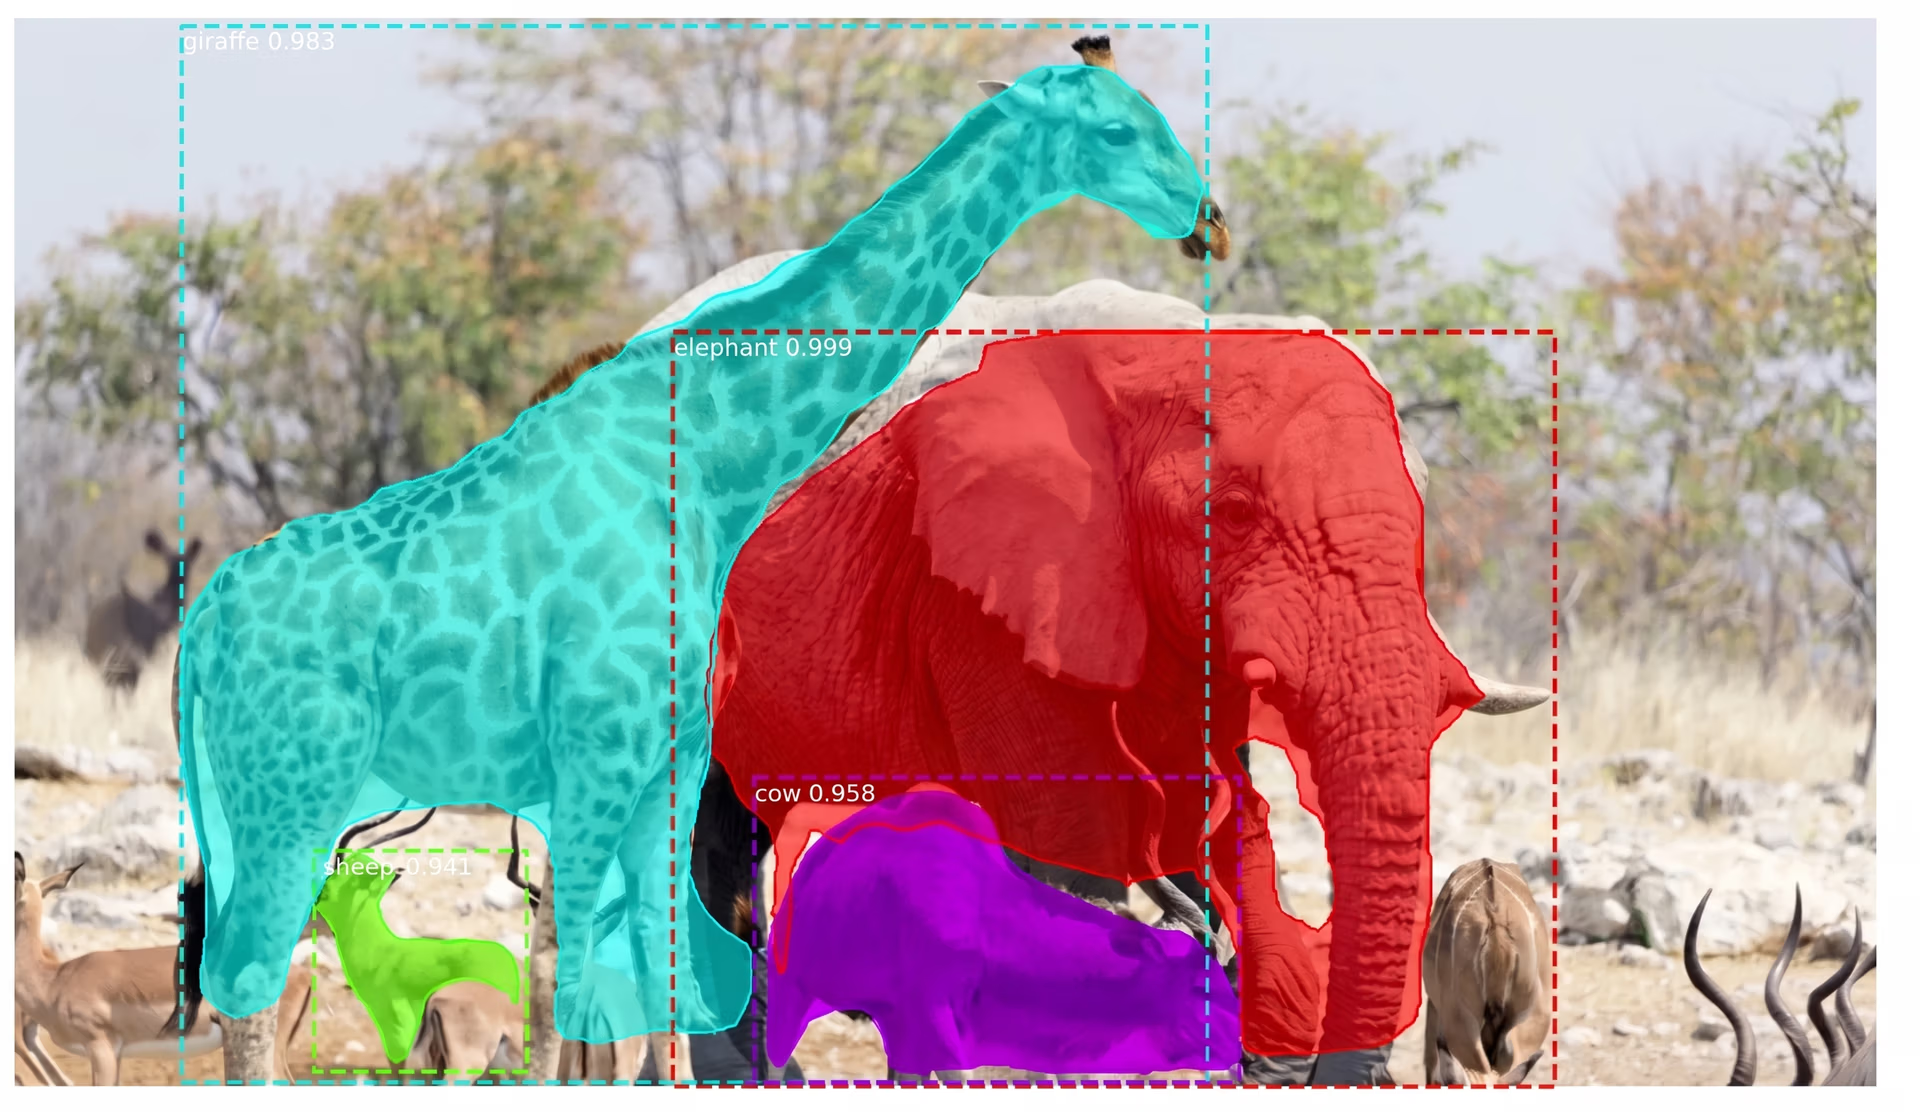
Şekil 5. Mask R-CNN kullanarak hayvanları algılama ve segmentlere ayırma.
Mask R-CNN'in sınırlamaları#
Nesne algılama ve segmentasyon alanındaki tarihî önemine rağmen Mask R-CNN'in bazı önemli dezavantajları da vardır. Mask R-CNN ile ilgili zorluklardan bazıları şunlardır:
- Yüksek hesaplama gereksinimi: Güçlü GPU'lara ihtiyaç duyar; bu da çalıştırmayı pahalı hâle getirebilir ve büyük miktarda veriyi işlerken yavaşlamasına neden olabilir.
- Daha yavaş işleme hızı: Çok aşamalı süreci, YOLO gibi daha hızlı gerçek zamanlı modellere kıyasla daha yavaş çalışmasına yol açar; bu nedenle zamana duyarlı görevler için ideal olmayabilir.
- Yüksek kaliteli verilere bağımlılık: Model, net ve iyi etiketlenmiş görüntülerle en iyi performansı gösterir. Bulanık veya yetersiz aydınlatılmış görüntüler doğruluğunu önemli ölçüde düşürebilir.
- Karmaşık uygulama: Çok aşamalı mimariyi kurmak ve optimize etmek, özellikle büyük veri kümeleriyle veya kısıtlı kaynaklarla çalışırken zor olabilir.
Mask R-CNN'den Ultralytics YOLO11'e#
Mask R-CNN segmentasyon görevlerinde başarılı olsa da birçok sektör, hıza ve gerçek zamanlı performansa öncelik verirken bilgisayarlı görüden yararlanmak istiyordu. Bu gereksinim, araştırmacıları nesneleri tek geçişte algılayan tek aşamalı modeller geliştirmeye yöneltti ve verimliliği büyük ölçüde artırdı.
Mask R-CNN'nin çok aşamalı sürecinden farklı olarak YOLO (You Only Look Once) gibi tek aşamalı bilgisayarlı görü modelleri, gerçek zamanlı bilgisayarlı görü görevlerine odaklanır. YOLO modelleri, algılama ve bölütleme işlemlerini ayrı ayrı yapmak yerine tek geçişte nesneleri algılayıp bölütleyebilir. Bu özellik, hızlı karar almanın kritik olduğu otonom sürüş, sağlık, üretim ve robotik gibi uygulamalar için onları ideal kılar.
Özellikle Ultralytics YOLO11, sonrasında yerini Ultralytics YOLO26'ya bırakarak, hem hızlı hem de doğru olmasıyla bunu bir adım ileri taşıyor. YOLOv8m'den %22 daha az parametre kullanmasına rağmen COCO veri kümesinde daha yüksek ortalama hassasiyet (mAP) elde ediyor; yani nesneleri daha hassas algılıyor. Geliştirilmiş işlem hızı, her milisaniyenin önemli olduğu gerçek zamanlı uygulamalar için onu iyi bir seçenek hâline getiriyor.
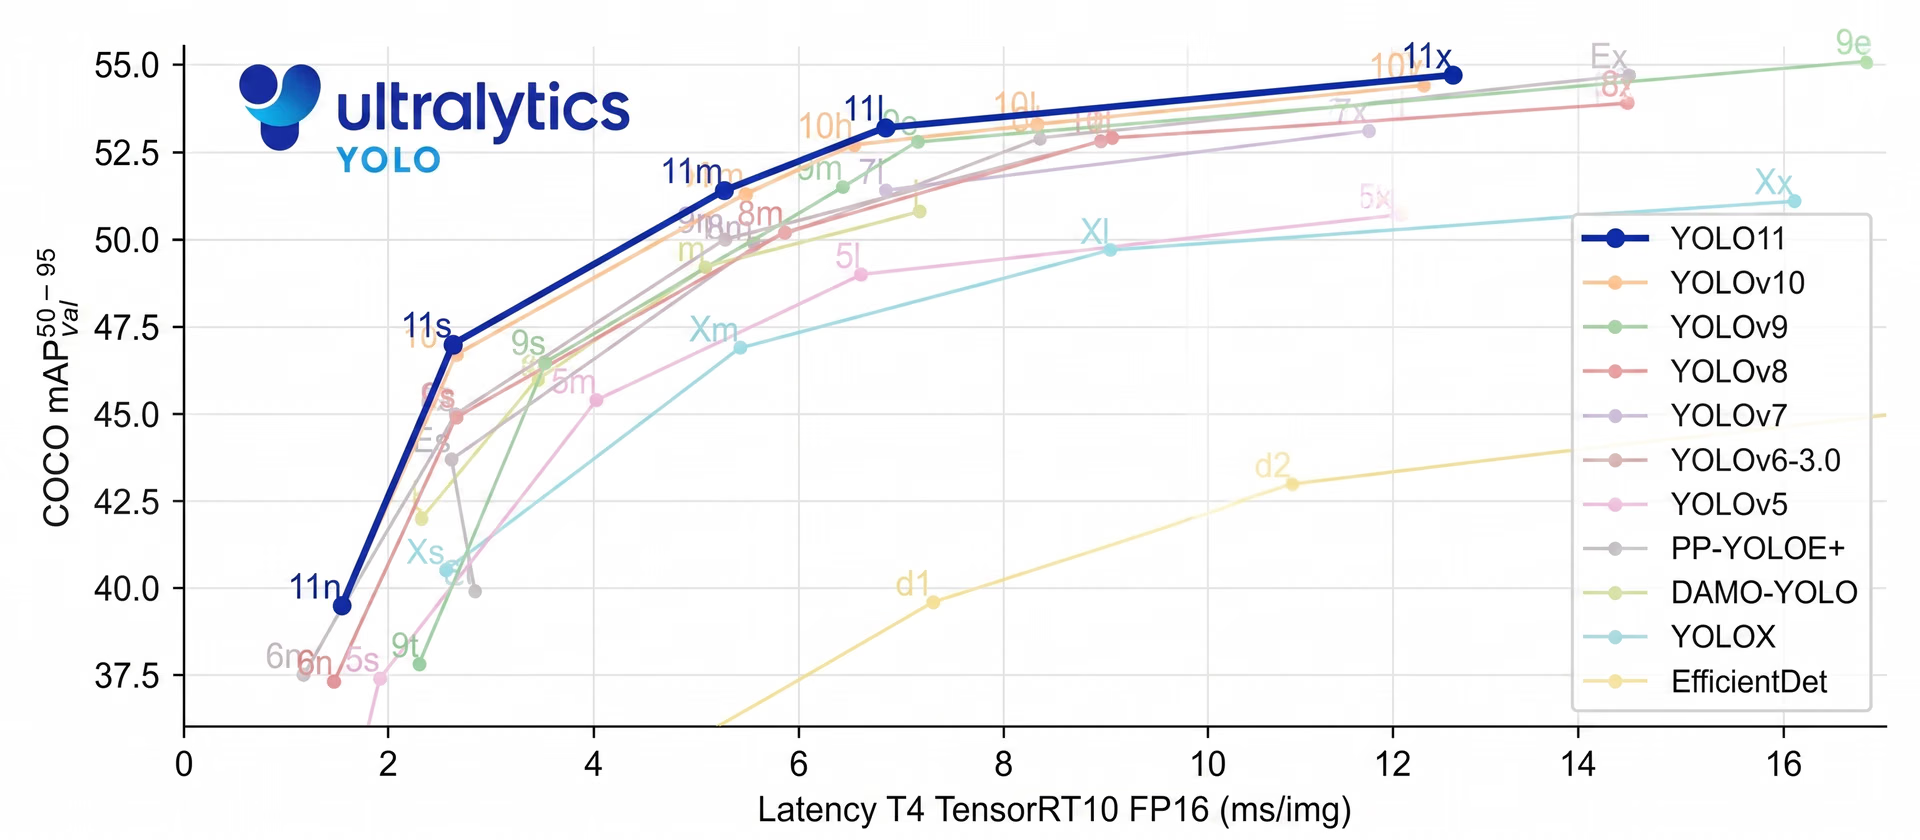
Şekil 6. YOLO11'in diğer modellerle karşılaştırmalı performansı.
Önemli çıkarımlar#
Bilgisayarlı görü tarihine dönüp baktığımızda Mask R-CNN, nesne algılama ve segmentasyonda önemli bir dönüm noktası olarak kabul edilir. Ayrıntılı ve çok adımlı süreci sayesinde karmaşık koşullarda bile son derece hassas sonuçlar verir.
Ancak aynı süreç, YOLO gibi gerçek zamanlı modellere kıyasla onu yavaşlatır. Hız ve verimlilik ihtiyacı arttıkça birçok uygulama, hızlı ve doğru nesne algılama sunan Ultralytics YOLO11 gibi tek aşamalı modelleri kullanıyor. Mask R-CNN bilgisayarlı görü alanının gelişimini anlamak açısından önemini korusa da gerçek zamanlı modellere yönelim, daha hızlı ve verimli çözümlere yönelik artan talebi yansıtıyor.
Büyüyen topluluğumuza katıl! Yapay zekâ hakkında daha fazla bilgi edinmek için GitHub depomuzu keşfet. Kendi bilgisayarlı görü projelerine başlamaya hazır mısın? Lisans seçeneklerimize göz at. Çözüm sayfalarımızı ziyaret ederek tarımda yapay zekâyı ve sağlık hizmetlerinde görsel yapay zekâyı keşfet!
Yazan
İçerik Üreticisi · Ultralytics
Yorumlar
Soru sor, sonuçlarını paylaş veya başka birine yardım et.









