U-Net 架构及其应用指南
了解 U-Net 架构、它如何支持图像分割、有哪些应用,以及它为何对计算机视觉的发展意义重大。
计算机视觉是人工智能(AI)的一个分支,专注于分析视觉数据。它为许多前沿系统铺平了道路,例如自动检查工厂产品,以及帮助自动驾驶汽车在道路上行驶。
最广为人知的计算机视觉任务之一是目标检测。这项任务可以让模型使用边界框定位并识别图像中的目标。虽然边界框适用于各种应用,但它们只能粗略估计目标的位置。
然而,在医疗等精度至关重要的领域,视觉 AI 的应用不止于识别目标。它们通常还需要了解目标的确切形状和位置。
计算机视觉任务中的分割正是为此而设计的。分割模型不使用边界框,而是在像素级别检测目标。多年来,研究人员开发了专门用于分割的计算机视觉模型。
U-Net 就是其中一种模型。尽管更新、更先进的模型已在性能上超越它,但 U-Net 在计算机视觉发展史中占有重要地位。本文将深入介绍 U-Net 架构、其工作原理、应用领域,以及它与当今更现代的分割模型相比有何不同。
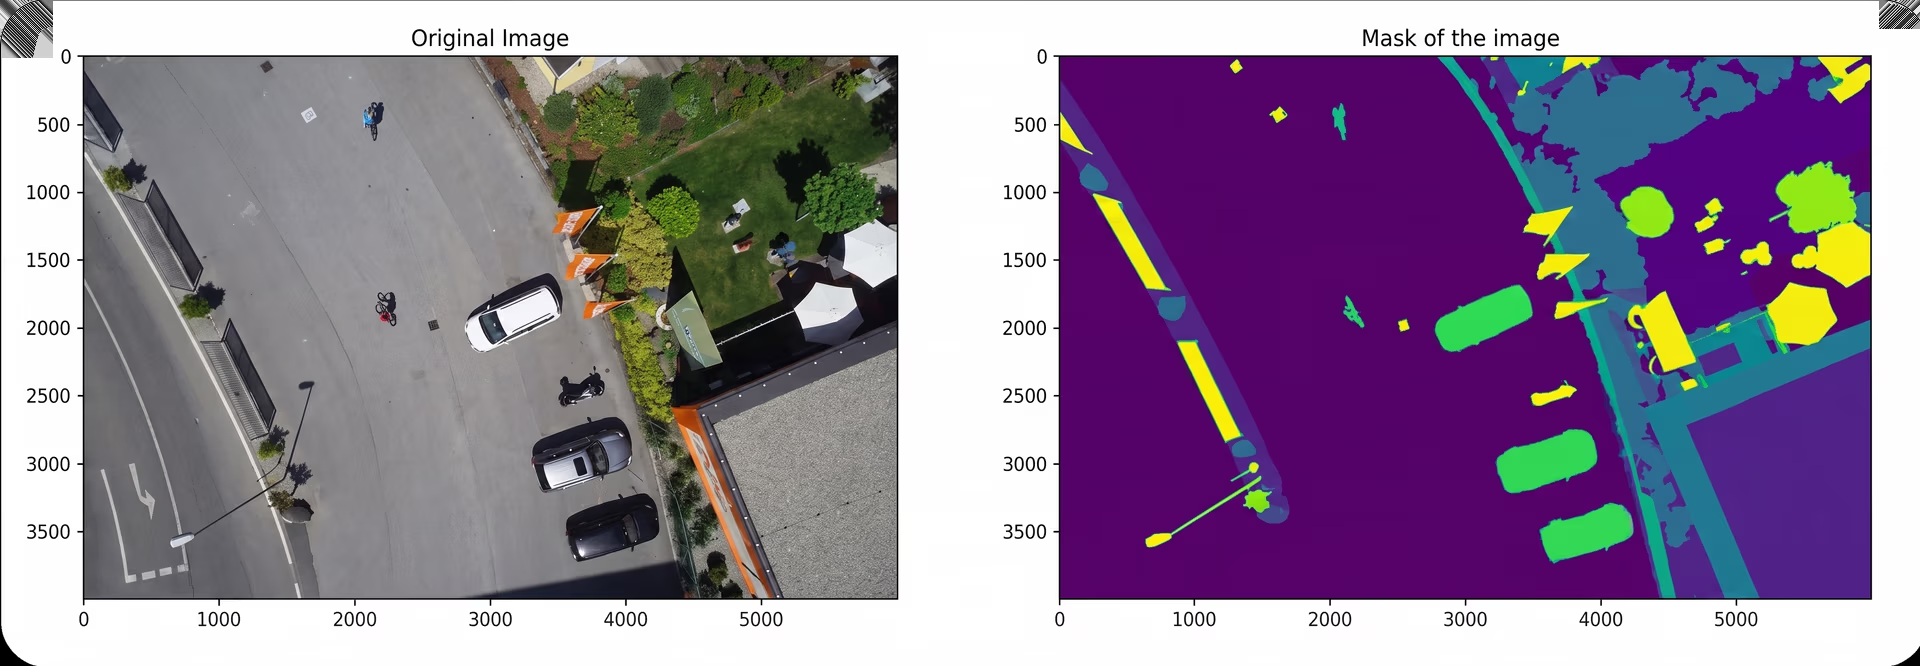
图 1. 使用 U-Net 深度学习模型进行分割的示例。(来源)
图像分割的发展历程#
在深入了解 U-Net 之前,我们先来进一步认识一下图像分割模型的发展历程。
最初,计算机视觉依靠边缘检测、阈值处理或区域生长等传统技术来分离图像中的目标。这些技术利用边缘检测目标边界,按像素强度分离区域,并对相似像素进行分组。它们适用于简单场景,但在图像包含噪声、形状重叠或边界不清晰时往往会失效。
随着2012 年深度学习兴起,研究人员于 2014 年提出了全卷积网络(FCNs)的概念,用于语义分割等任务。这些模型替换了卷积网络的某些部分,使计算机能够一次查看整幅图像,而不必将其拆分成更小的部分。这样一来,模型便能够生成细致的映射,更清晰地呈现图像中的内容。
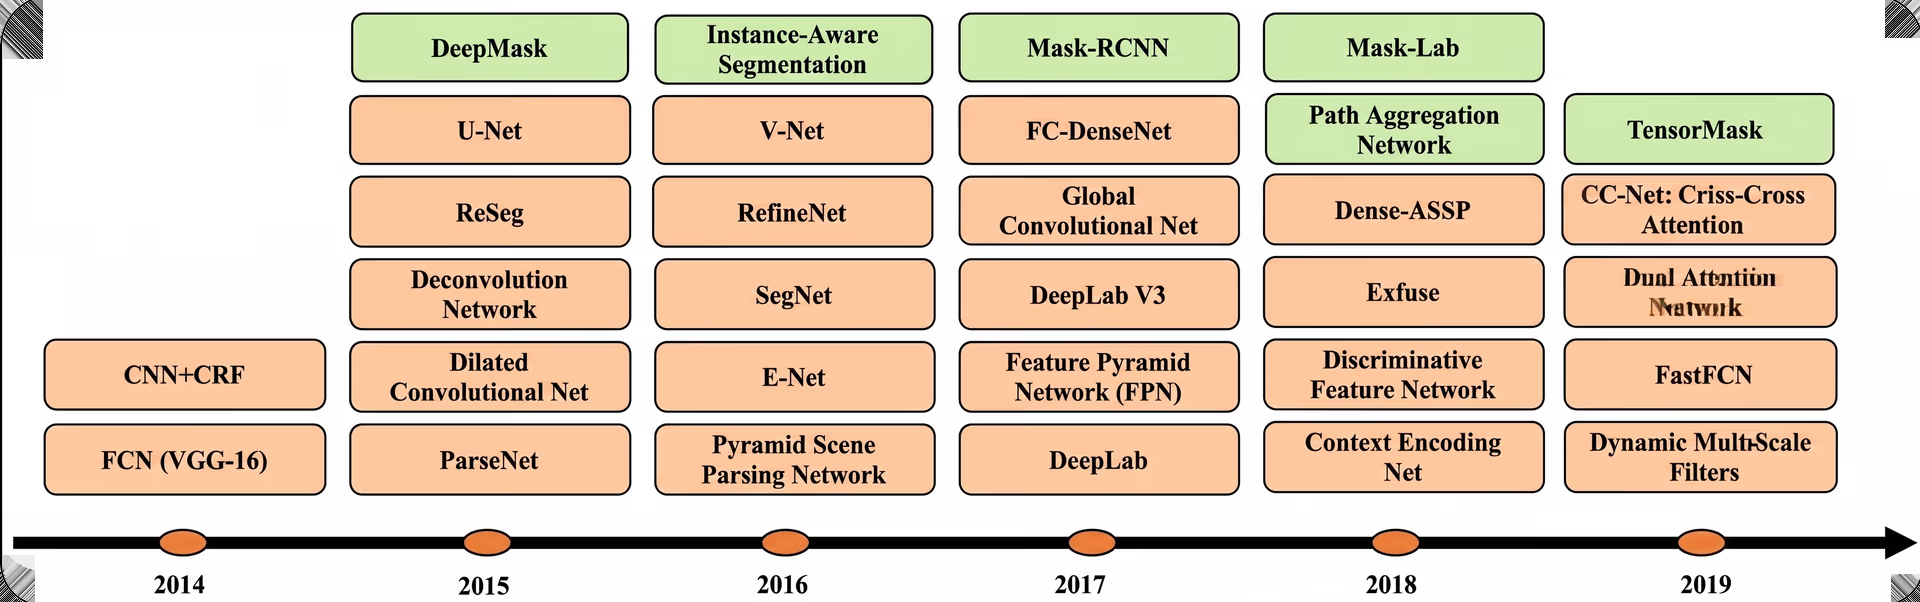
图 2. 基于深度学习的分割算法的发展历程。(来源)
在 FCN 的基础上,弗赖堡大学的研究人员于 2015 年推出了 U-Net。它最初是为生物医学图像分割而设计的。具体来说,U-Net 的设计目标是在标注数据有限的情况下依然表现良好。
与此同时,后续版本 UNet++ 和 TransUNet 增加了注意力层和更好的特征提取等改进。注意力层帮助模型聚焦于关键区域,而增强的特征提取则能捕获更详细的信息。
什么是 U-Net?特征如何在模型中流动?#
U-Net 是专为图像分割构建的深度学习模型。它以图像为输入,并输出一张分割掩码,根据每个像素所属的目标或区域对其进行分类。
该模型因其 U 形架构而得名。它由两个主要部分组成:用于压缩图像并学习其特征的编码器,以及将图像扩展回原始尺寸的解码器。这种设计形成了对称的 U 形结构,有助于模型理解图像的整体结构和细节。
U-Net 的一个关键特征是使用跳跃连接,让信息能够从编码器直接传递到解码器。这样,模型就能保留图像压缩过程中可能丢失的重要细节。
U-Net 架构概览#
下面简要介绍 U-Net 架构的工作方式:
- 输入图像: U-Net 从一张二维图像开始,例如医学扫描图或卫星照片。目标是为图像中的每个像素分配一个类别标签。
- 下采样: 图像经过卷积层,这些卷积层会学习重要的视觉特征。随着图像经过不同层,其分辨率逐渐降低,模型则识别出更广泛的模式。
- 瓶颈层: 在网络中心,特征图的空间分辨率达到最低,同时捕获高级语义特征。简而言之,这种压缩后的特征图表示了输入的整体上下文。
- 上采样: 随后,网络通过逐步提高分辨率来重建图像。转置卷积有助于将特征图扩展回接近原始尺寸。
- 跳跃连接: 下采样路径中的特征图会与上采样路径中的特征图拼接。这有助于在整合高级上下文信息的同时保留精细的空间细节。
- 输出为分割图: 最终输出是与输入尺寸相同的逐像素分割掩码。每个像素都会被分类为目标、背景或感兴趣区域等类别。
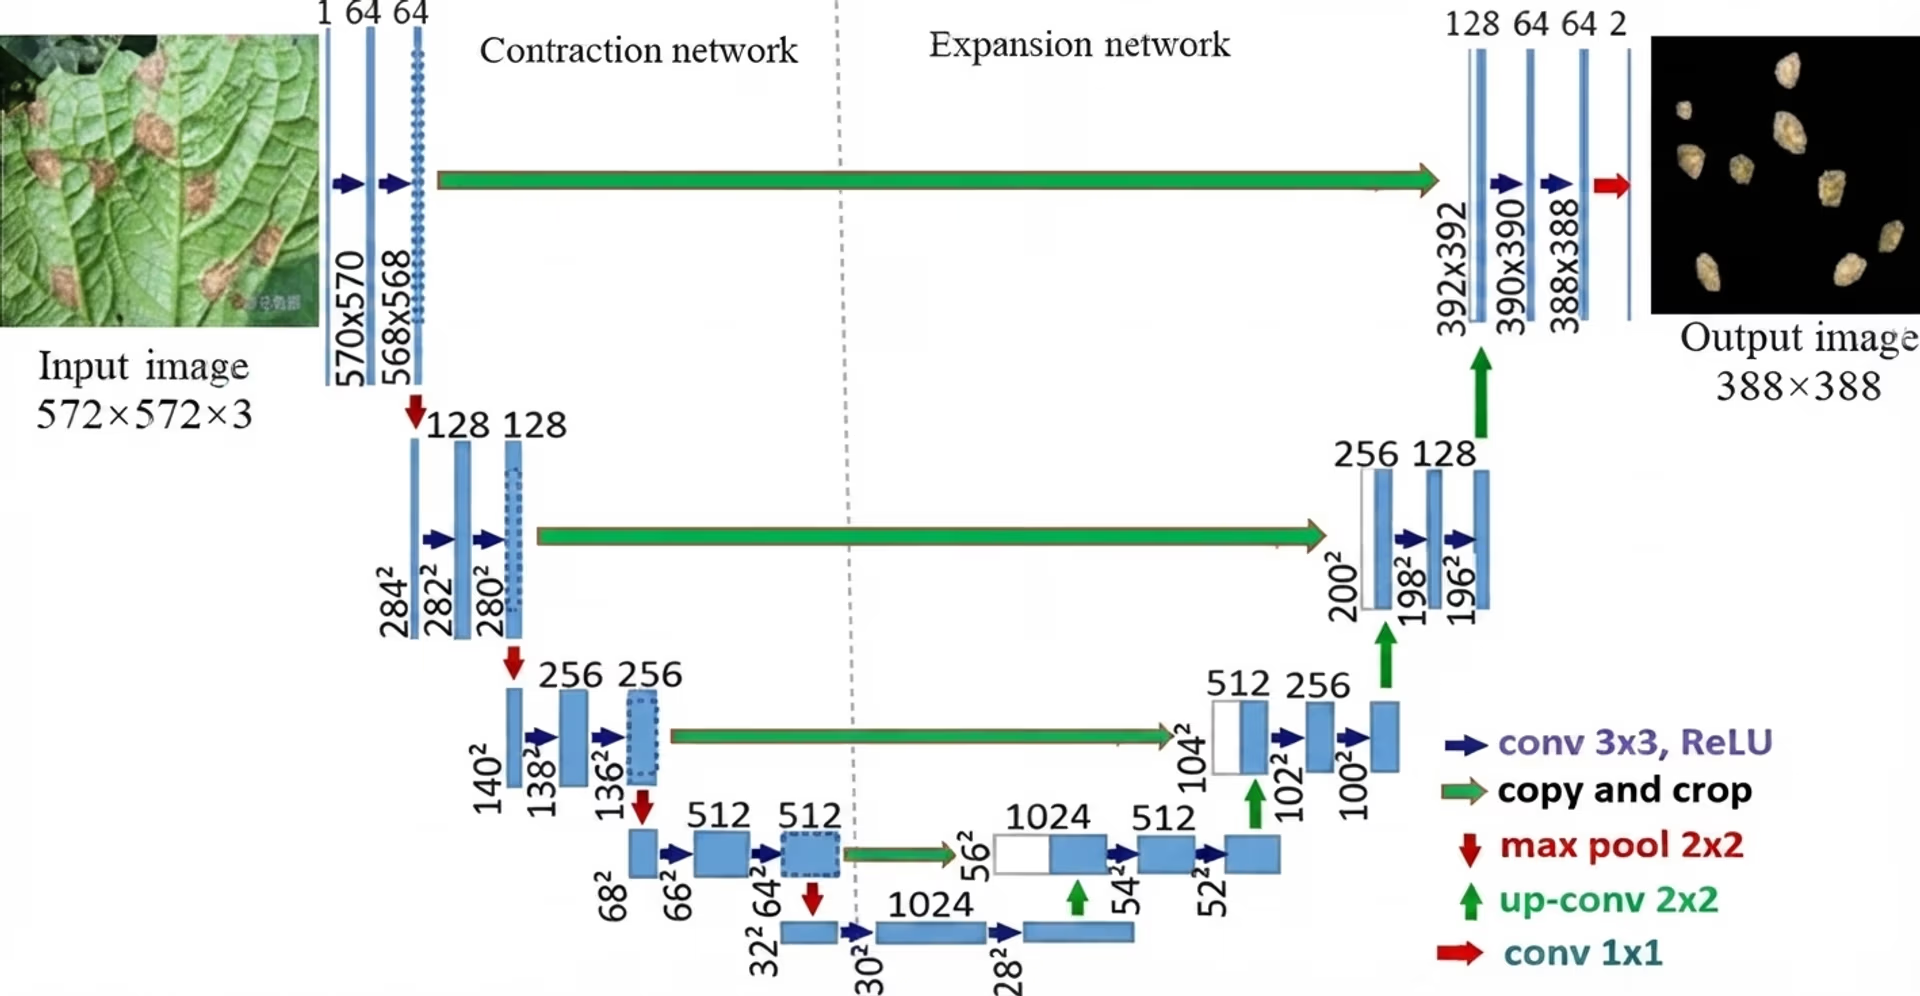
图 3. U-Net 架构示意图。(来源)
了解 ViT 和 U-Net 之间的区别#
了解 U-Net 时,你可能会想知道它与其他深度学习模型有何不同,例如也能执行分割任务的 Vision Transformer(ViT)。两种模型虽然都能执行类似任务,但它们的构建方式和处理分割任务的方式有所不同。
U-Net 通过编码器-解码器结构中的卷积层,在像素级别处理图像。它常用于需要精确分割的任务,例如医学扫描图或自动驾驶场景。
另一方面,Vision Transformer(ViT)会将图像拆分成多个图块,并通过注意力机制同时处理这些图块。它使用自注意力机制(一种让模型权衡图像不同部分相对重要性的机制)来捕捉图像各部分之间的关系,这与 U-Net 的卷积方法不同。
另一个重要区别是,ViT 通常需要更多数据才能发挥良好效果,但擅长捕捉复杂模式。相比之下,U-Net 在较小的数据集上表现良好,训练速度更快,而且通常所需的训练时间更短。
U-Net 模型的应用#
现在我们已经更了解 U-Net 是什么以及它如何工作,接下来看看 U-Net 在不同领域的应用。
医学影像中的脑出血分割#
U-Net 成为复杂医学图像像素级分割的可靠方法,在其研究应用的鼎盛时期尤其如此。研究人员利用它突出显示医学扫描图中的关键区域,例如肿瘤,以及 CT 和 MRI 图像中的内出血迹象。这种方法显著提高了诊断准确性,并简化了研究环境中复杂医疗数据的分析。
U-Net 在医疗研究中的一项影响实例,是它被用于从医学扫描图中识别中风和脑出血。研究人员可以使用 U-Net 分析头部扫描图并突出显示疑似区域,从而更快地识别需要立即关注的病例。
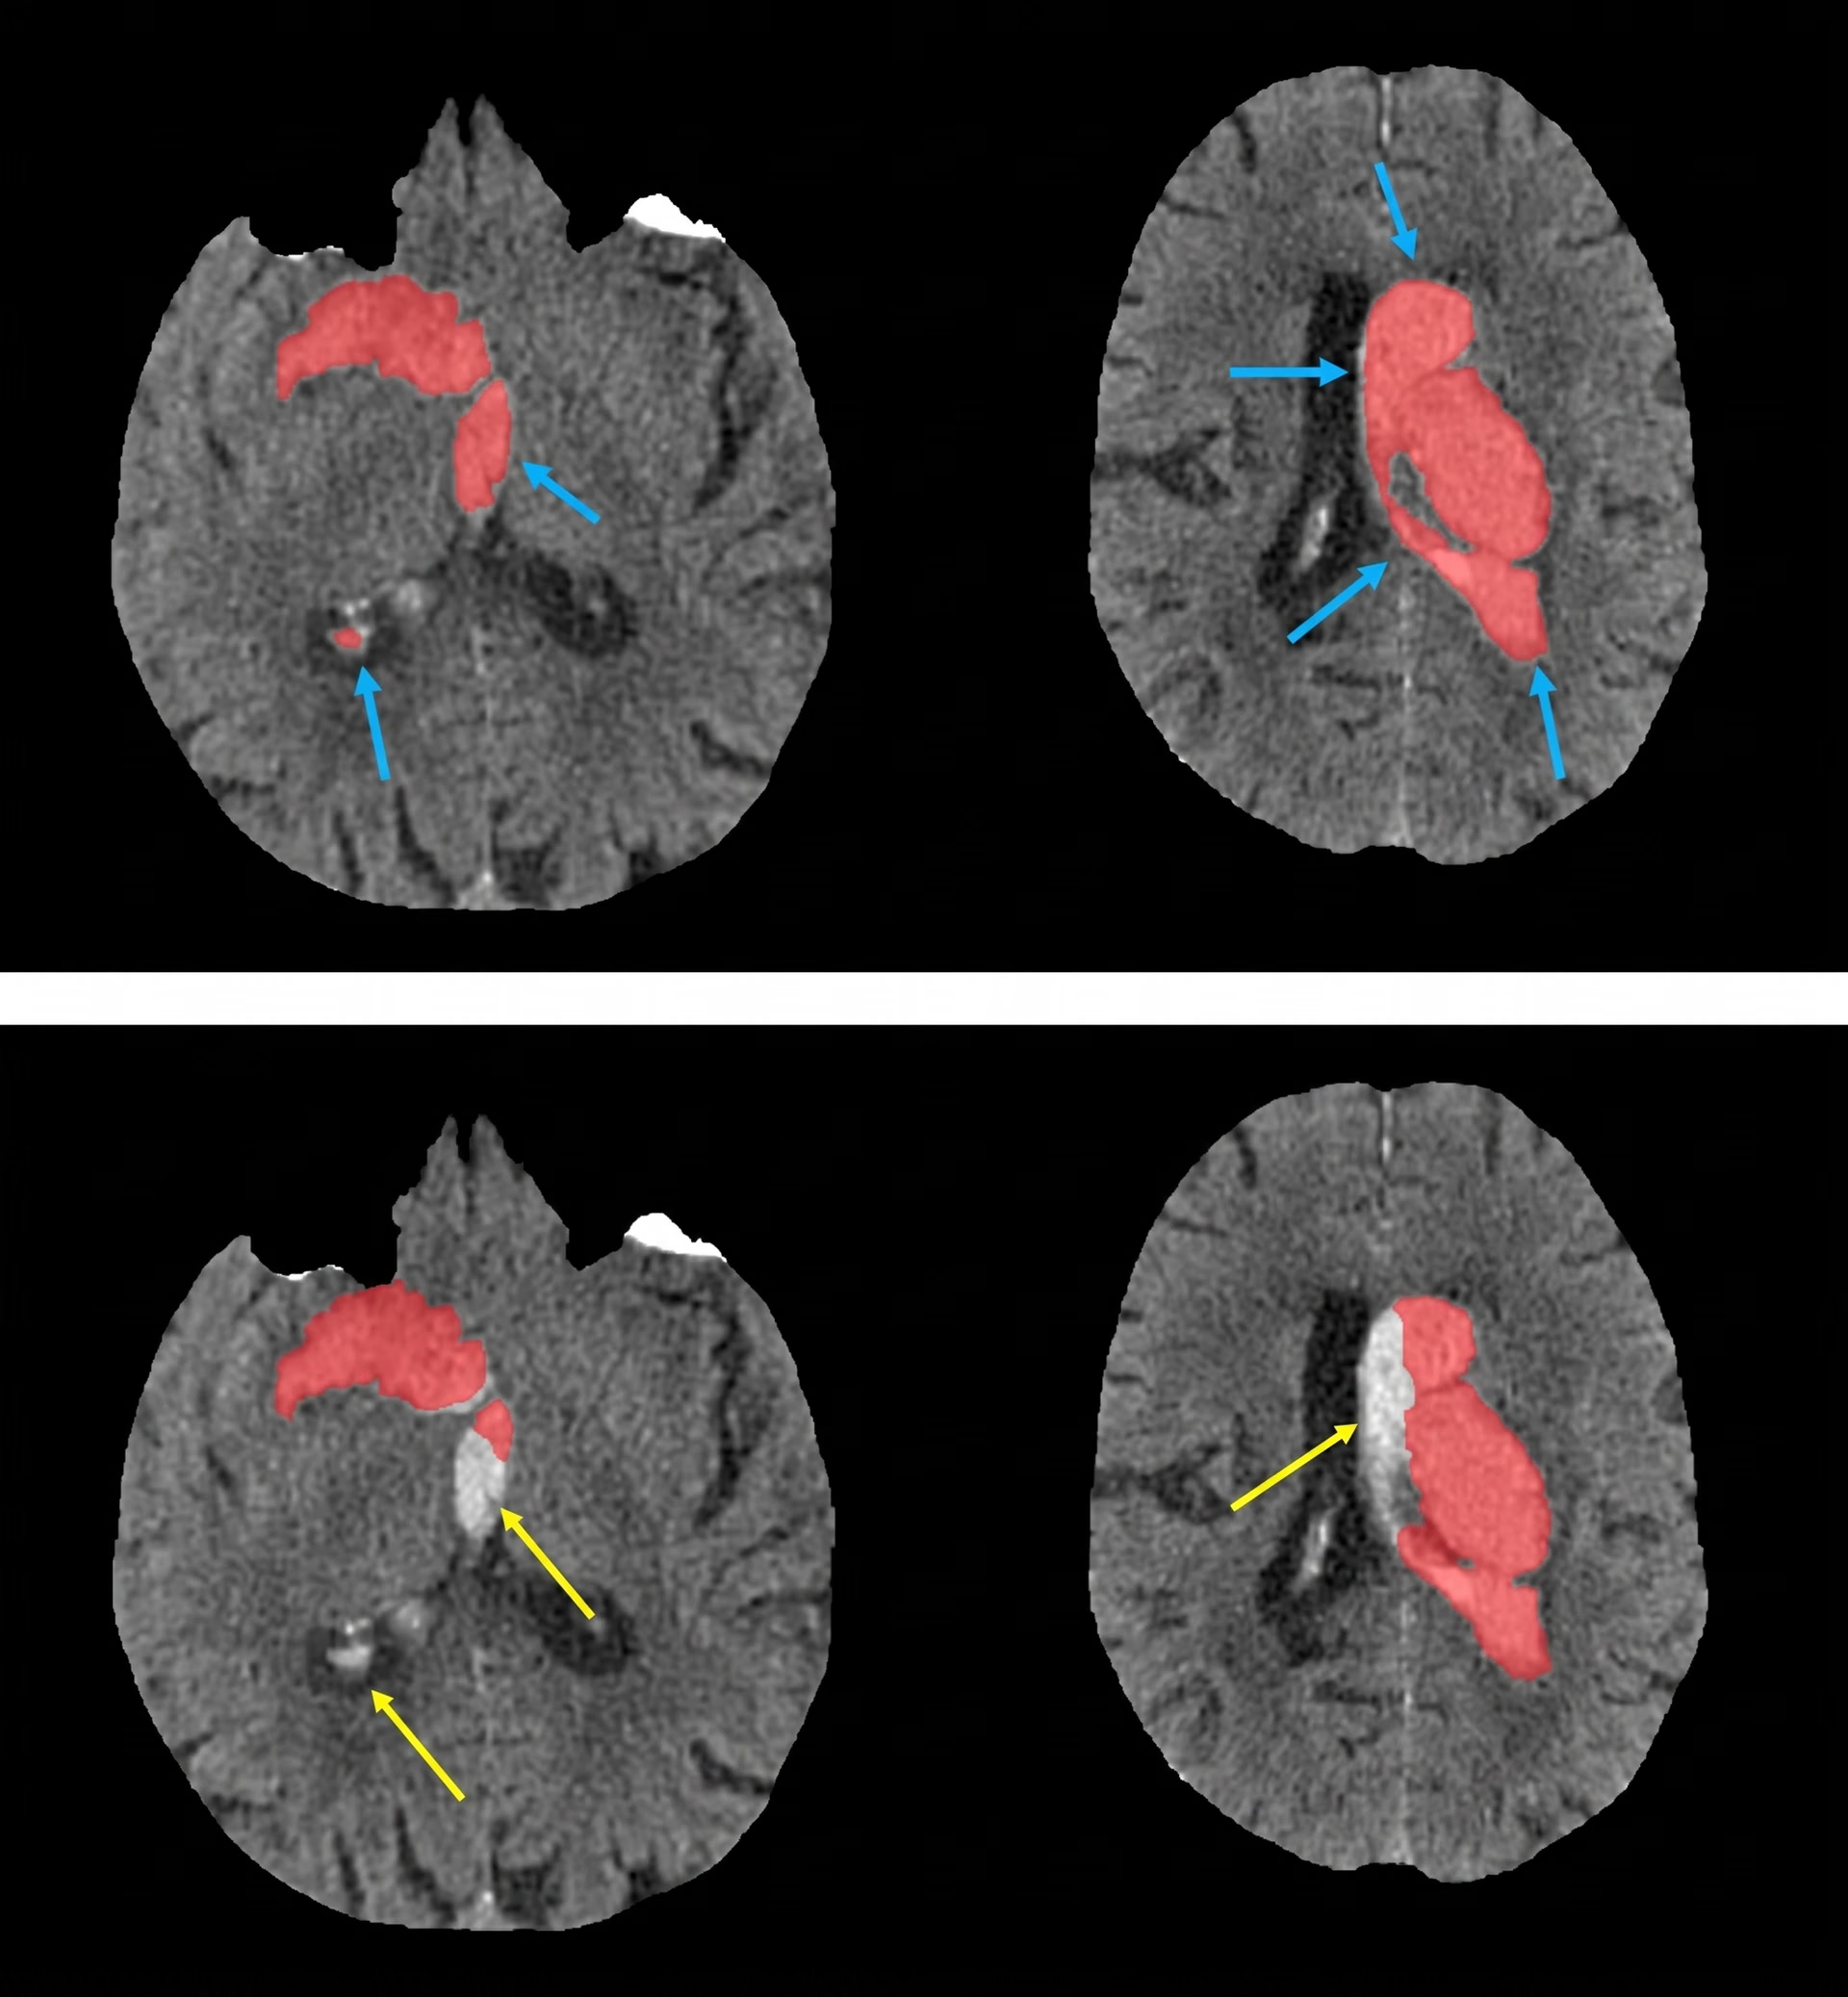
图 4. 使用 3D U-Net 分割出血性中风病灶。(来源)
农业中的作物分割#
研究人员还将 U-Net 用于农业领域,尤其是分割作物、杂草和土壤。它有助于农民监测植物健康状况、估算产量,并在大型农场中做出更好的决策。例如,U-Net 可以将作物与杂草分开,从而提高除草剂施用效率并减少浪费。
为了解决无人机图像中的运动模糊等挑战,研究人员通过图像去模糊技术改进了 U-Net。这样,即使在移动过程中采集数据(例如进行航空测绘时),也能确保分割结果更加清晰。
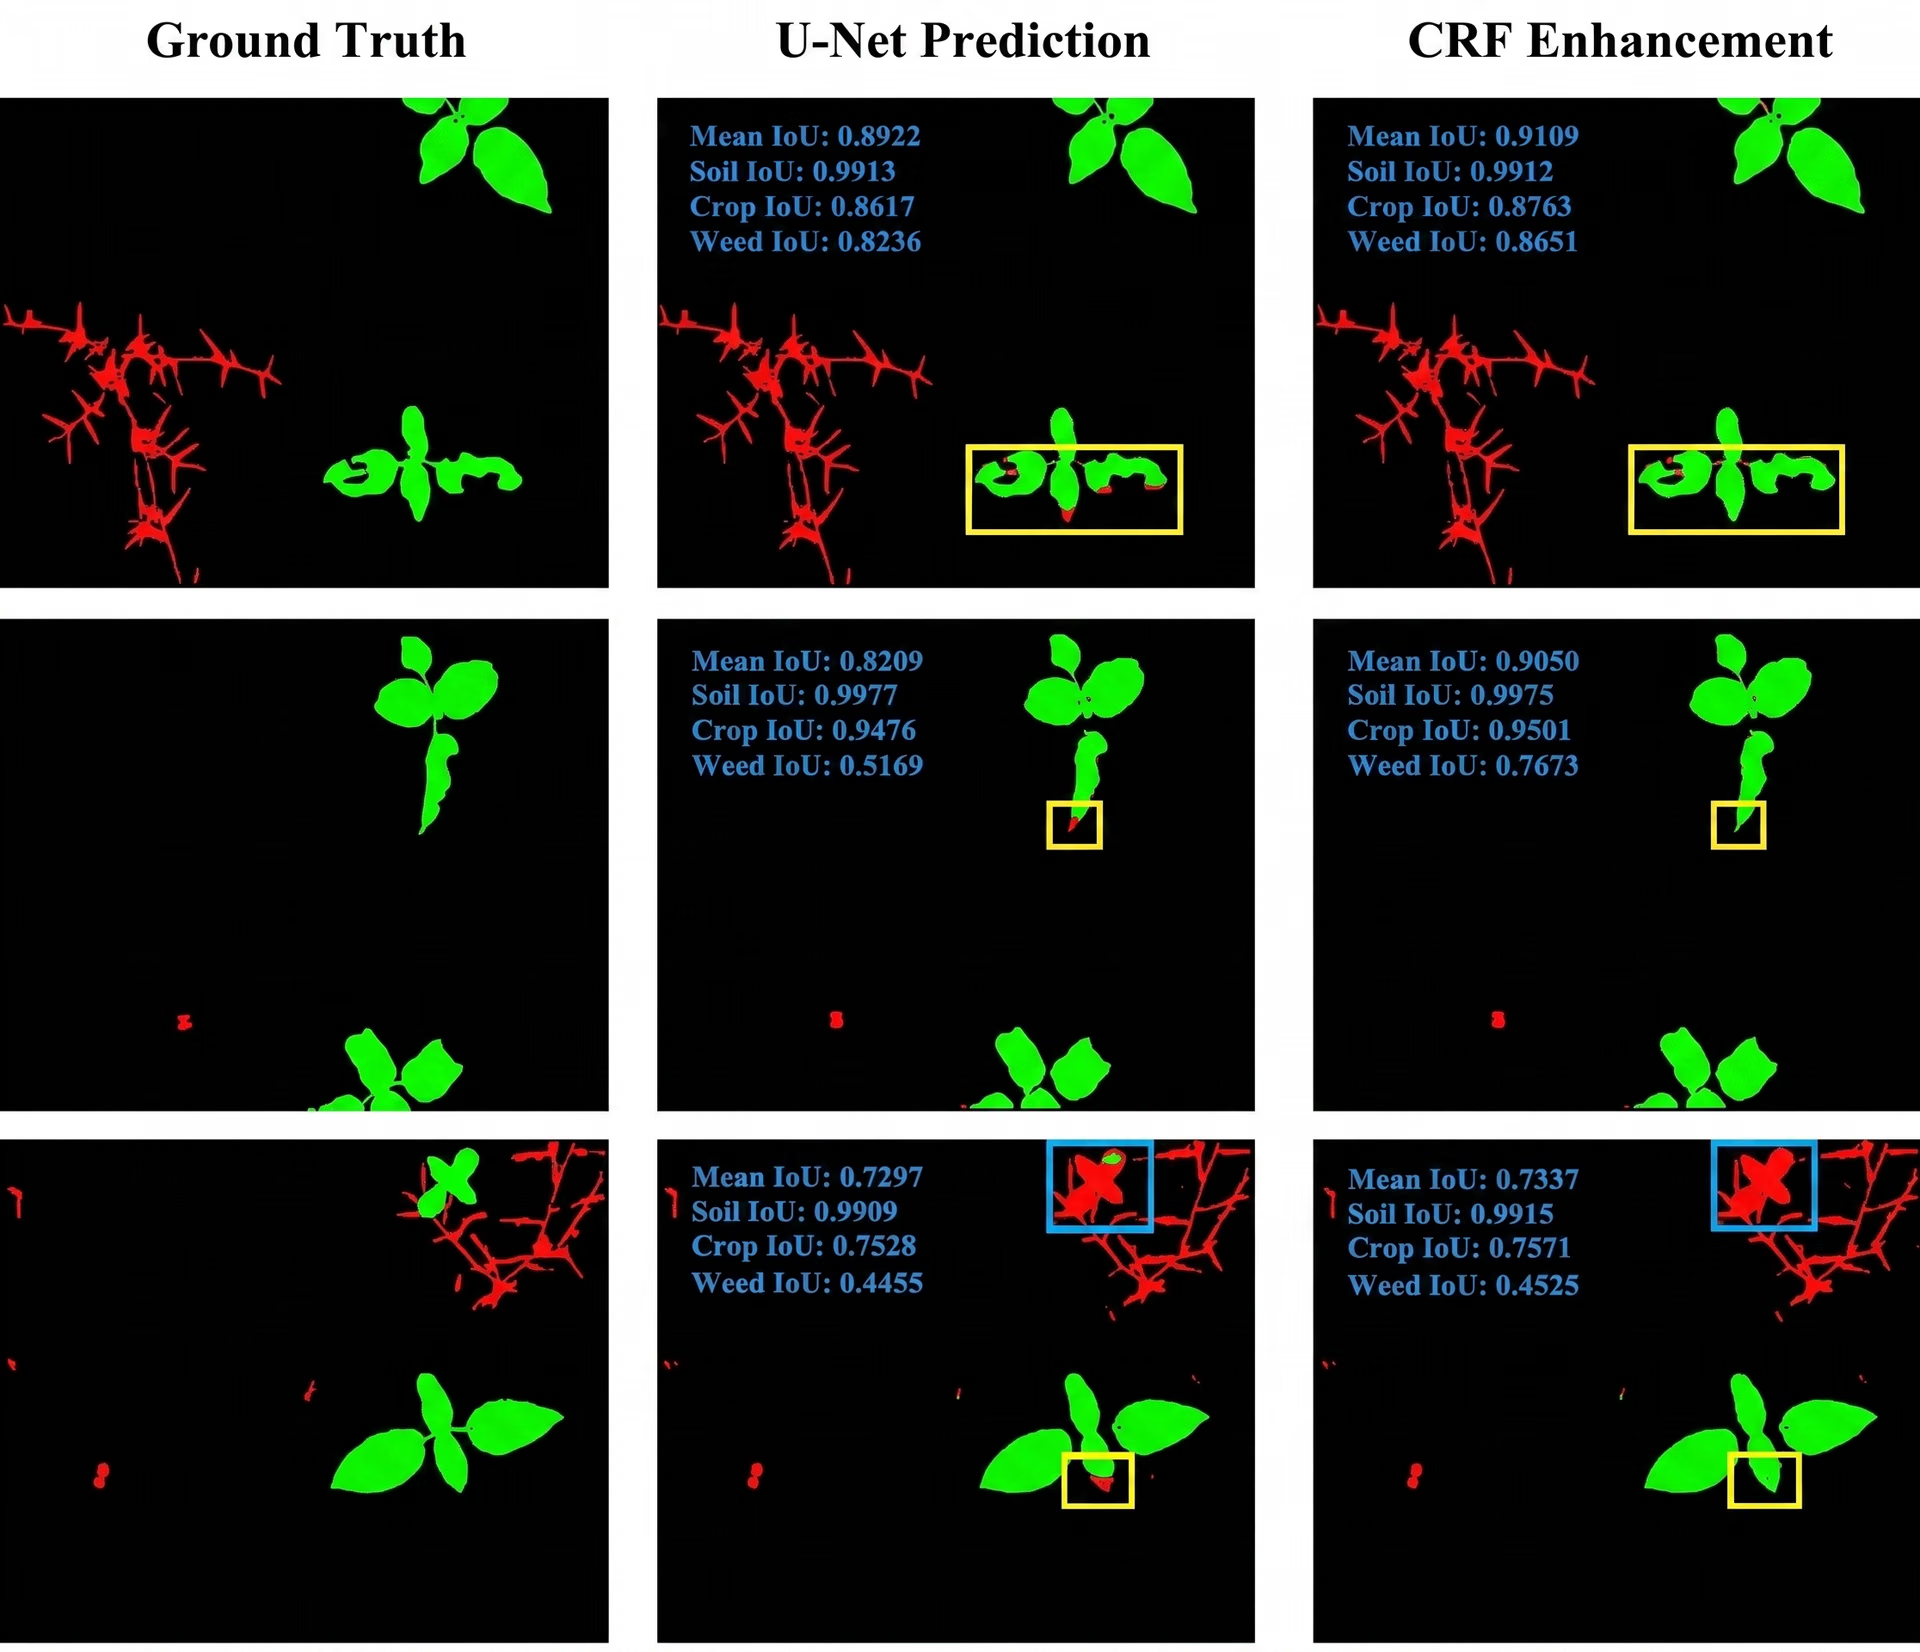
图 5. 使用 U-Net 将农田中的作物与杂草分开。(来源)
自动驾驶#
在更先进的 AI 模型问世之前,U-Net 在探索如何利用分割增强自动驾驶方面发挥了重要作用。在自动驾驶汽车中,U-Net 的语义分割可以将图像中的每个像素分类为道路、车辆、行人和车道标记等类别。这能让汽车清晰了解周围环境,帮助其安全导航并有效决策。
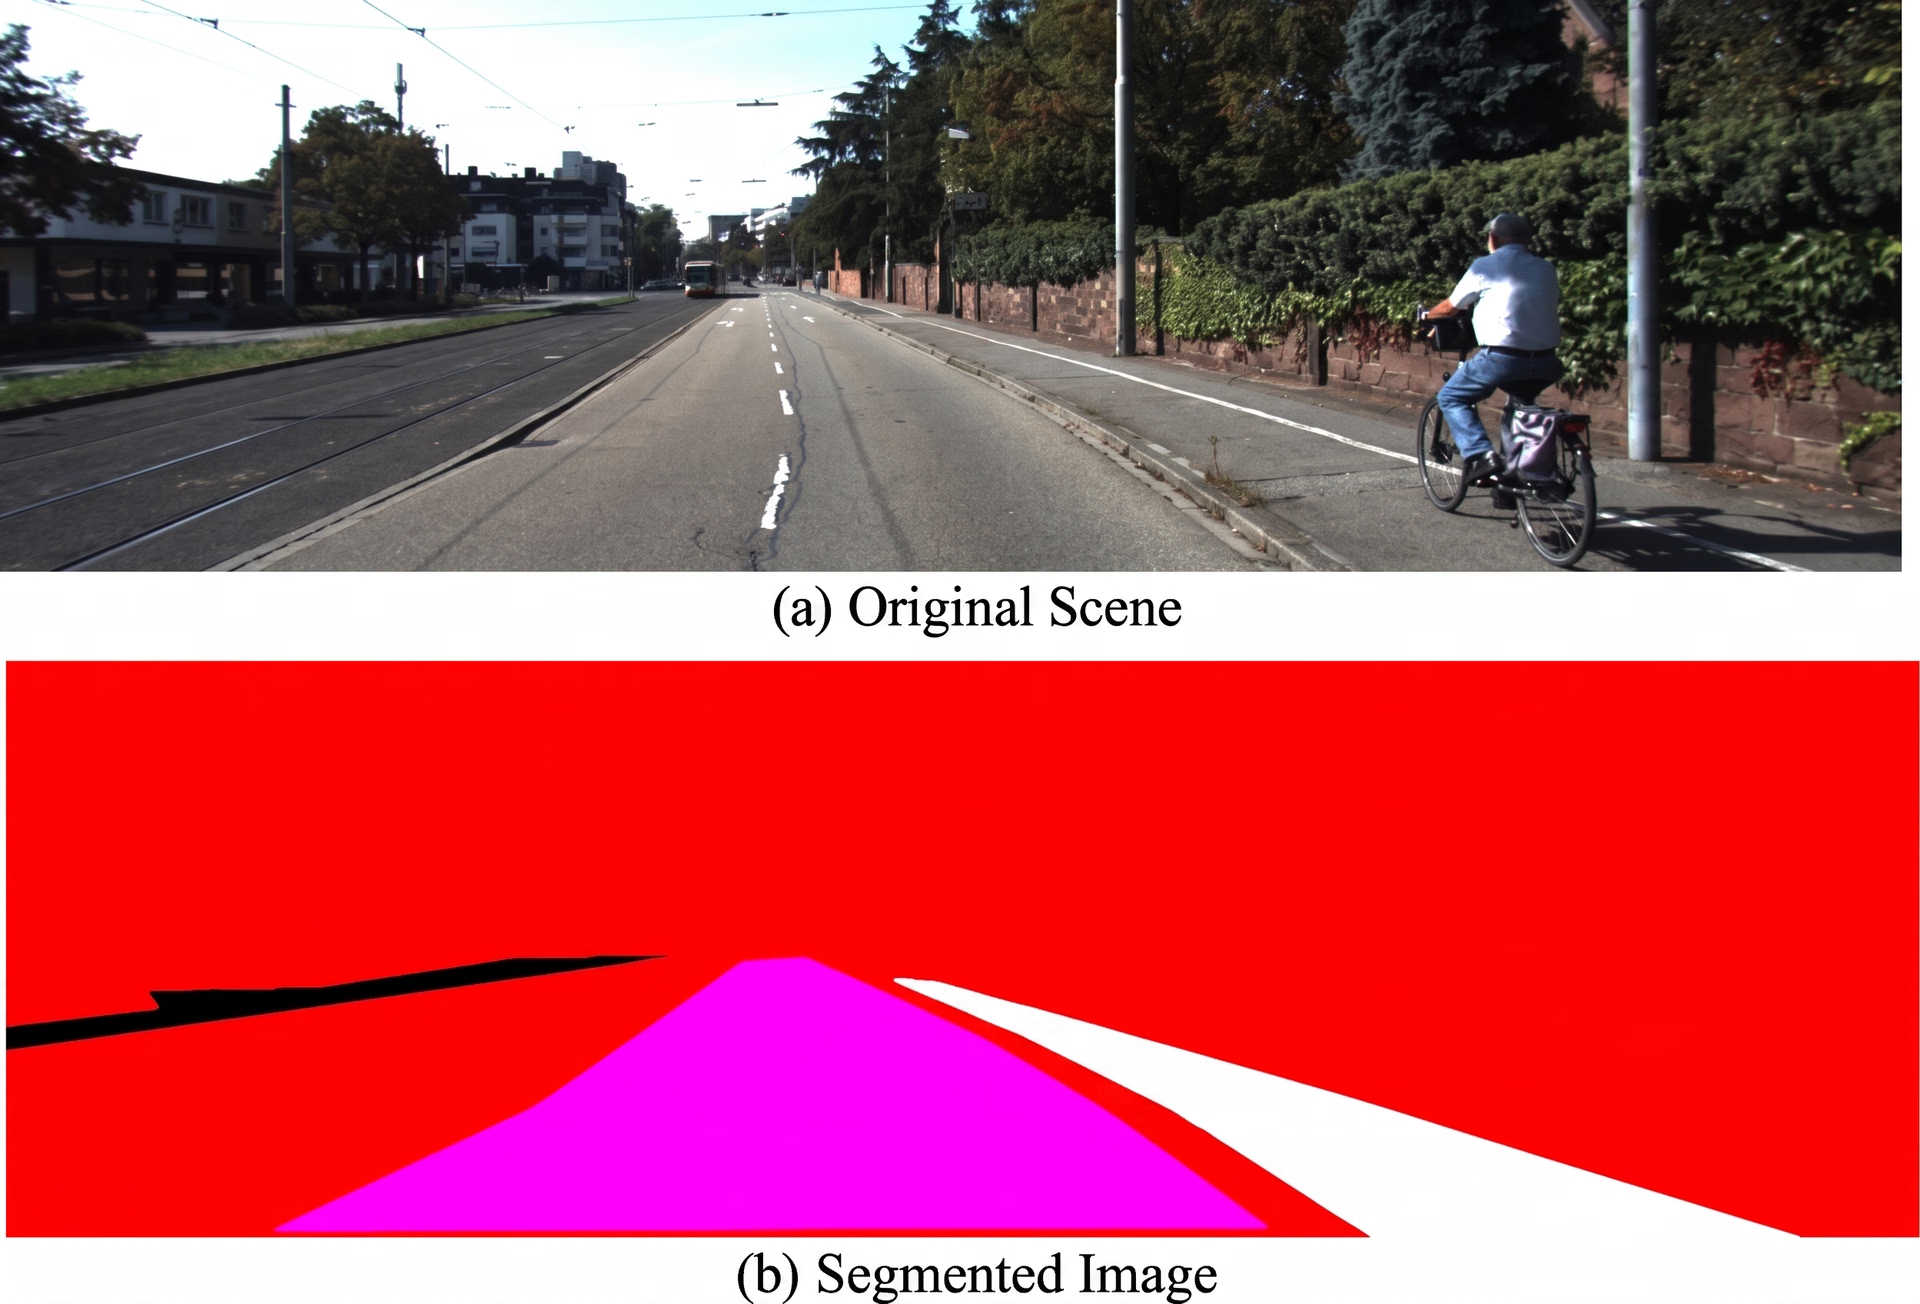
图 6. 使用 U-Net 分割出可行驶区域的道路场景。(来源)
U-Net 的优缺点#
即使在今天,U-Net 仍是研究人员进行图像分割的不错选择,因为它兼具简洁性、准确性和适应性。以下是让它脱颖而出的一些主要优势:
- 适用于不同模态: U-Net 已适配多种数据类型,包括 3D 医学扫描图、卫星图像,甚至视频帧。
- 优化后推理速度快: 经过适当调优后,U-Net 可以高效运行,适用于实时或近实时应用。
- 开源且拥有社区支持: U-Net 可用于各大深度学习库,并得到庞大的开发者和研究人员社区支持。
U-Net 虽然有许多优势,但也有一些需要注意的局限性。以下是需要考虑的一些因素:
- 对数据质量敏感: 噪声较多或分辨率较低等低质量数据会对 U-Net 的性能产生负面影响。
- 小型数据集上容易过拟合: 虽然 U-Net 在数据有限时表现良好,但如果没有进行适当的正则化,它仍有过拟合风险,尤其是在数据集过小或缺乏多样性时。
- 计算资源: U-Net 的计算开销可能很大,尤其是在处理大型数据集时,训练需要大量硬件资源。
要点#
U-Net 是图像分割发展历程中的重要里程碑。它证明了深度学习模型可以利用较小的数据集获得准确结果,尤其是在医学影像等领域。
这一突破为各个领域中更先进的应用铺平了道路。随着计算机视觉不断发展,U-Net 等分割模型仍是基础技术,使机器能够高精度地理解和解读视觉数据。
想构建自己的计算机视觉项目吗?浏览我们的 GitHub 代码库,深入了解 AI,并查看我们的许可选项。了解医疗领域的计算机视觉如何提升效率,并访问我们的解决方案页面,探索零售领域的 AI带来的影响!立即加入不断壮大的社区!









