导出并优化 Ultralytics YOLOv8,以便在 Intel OpenVINO 上进行推理
使用 OpenVINO 导出并优化 Ultralytics YOLOv8 模型,使其在 Intel CPU 和 GPU 上的推理速度最高提升 3 倍,然后与 PyTorch 进行基准测试。
 Nuvola Ladi3 分钟阅读
这篇博客将介绍如何导出并优化预训练或自定义训练的 Ultralytics YOLOv8模型,以便使用 OpenVINO 进行推理。如果你使用的是基于 Intel 的系统,无论是 CPU 还是 GPU,本指南都会介绍如何轻松显著加快模型运行速度。
为什么要使用 OpenVINO 优化 Ultralytics YOLOv8?#
使用 OpenVINO优化 Ultralytics YOLOv8 模型,可以让推理任务提速最高达 3 倍,特别是在 Intel CPU 上运行时。这种性能提升能为实时应用带来显著改善,应用范围涵盖目标检测、分割和安全系统。
导出并优化 Ultralytics YOLOv8 模型的步骤#
了解流程#
首先,我们来梳理一下流程。我们将把 PyTorch 模型转换为 OpenVINO 格式并进行优化。在视频发布时,这项转换会通过 ONNX 作为中间步骤;当前版本的 Ultralytics 则支持直接从 PyTorch 转换。整个流程只需几个简单步骤,可应用于多种模型和格式,包括 TensorFlow、PyTorch 和 ONNX。
导出模型#
查看 Ultralytics 文档后,我们发现,导出 YOLOv8 模型需要使用 Ultralytics 框架中的 export 方法。此方法会将模型从 PyTorch 转换并针对 OpenVINO 进行优化。最终模型在 Intel 硬件上的运行速度会显著提升。
安装依赖项#
运行导出脚本前,你需要确保已安装所有必需的依赖项,包括 Ultralytics 库和 OpenVINO。通过 pip(Python 包安装程序)安装这些软件包非常简单。
运行导出脚本#
环境配置完成后,你就可以运行导出脚本了。该脚本会将 PyTorch 模型转换为 OpenVINO。整个过程很简单,只需调用一个函数即可完成导出。Ultralytics 框架让模型转换和优化变得轻松,确保你以最少的操作获得最佳性能。
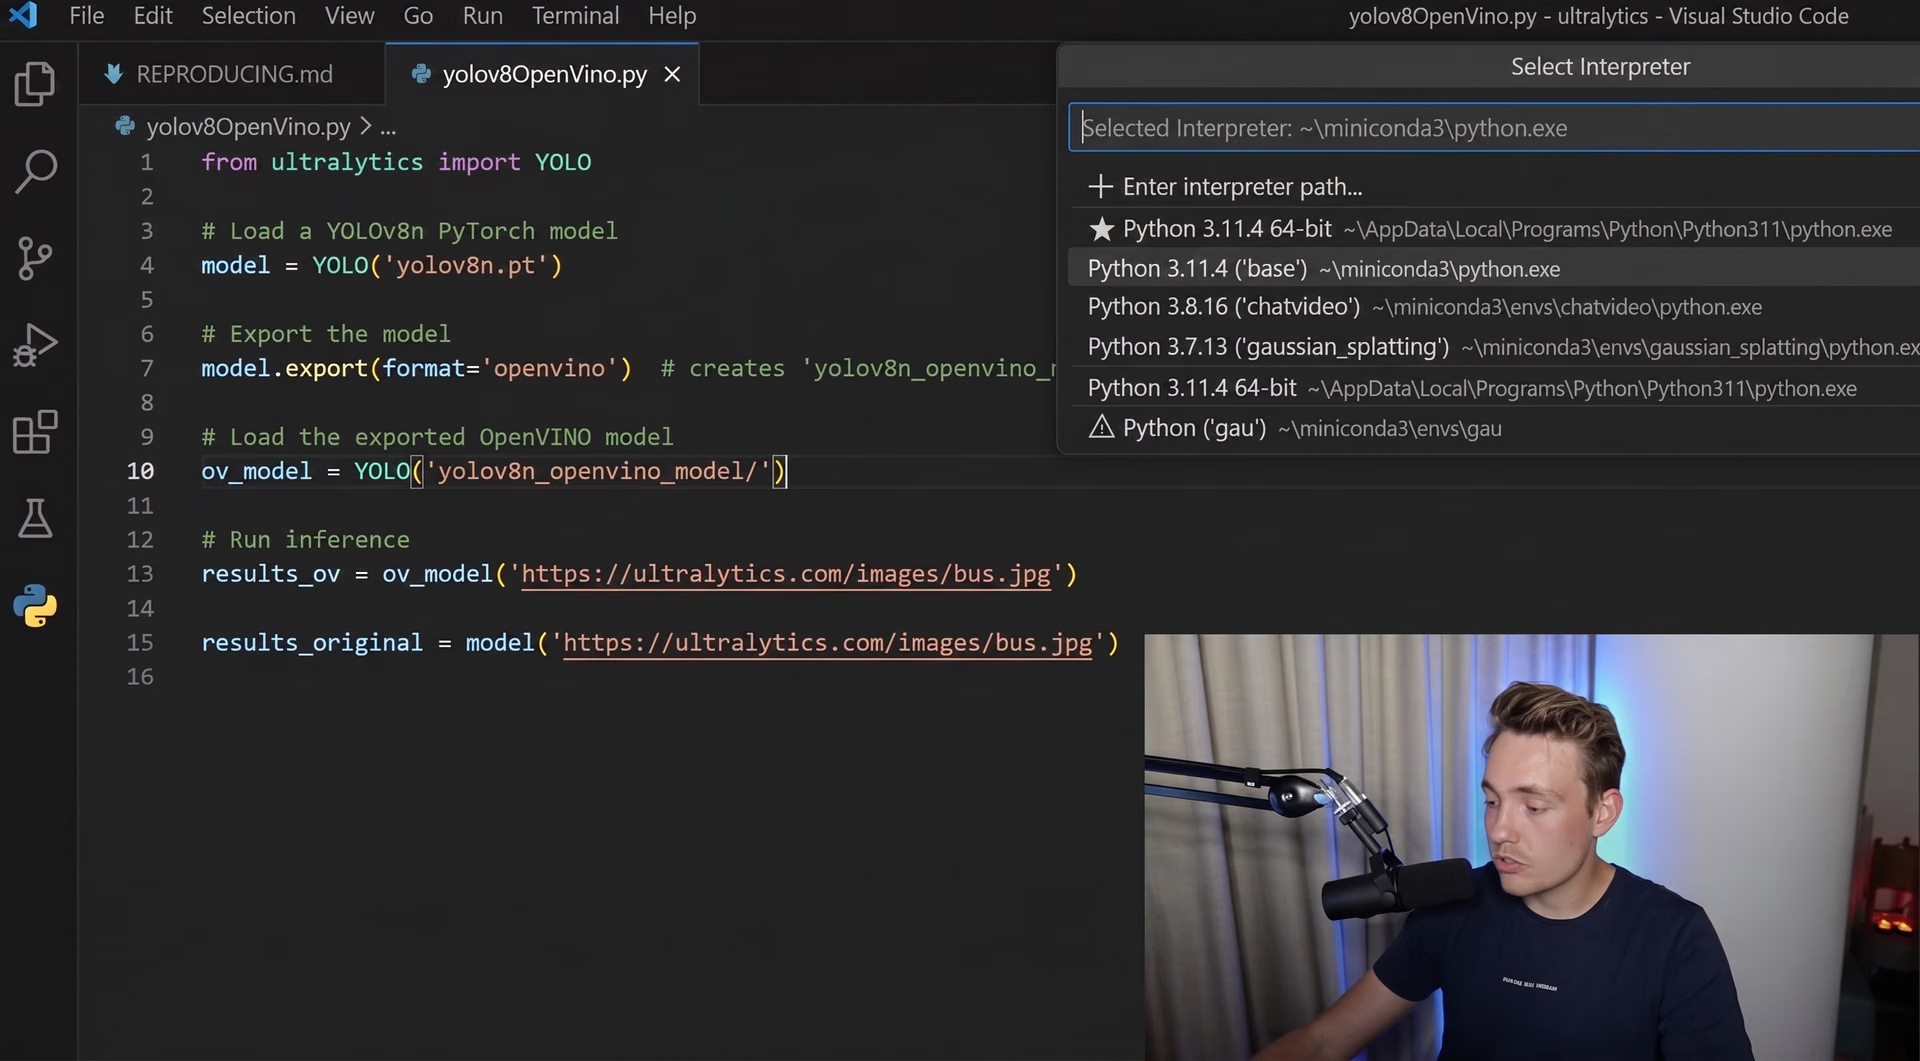
图 1. Nicolai Nielsen 介绍如何运行导出脚本。
比较性能#
导出后,务必比较原始模型和优化后模型的性能。通过对两个模型的推理时间进行基准测试,你可以清楚地看到性能提升。通常,与原始 PyTorch 模型相比,OpenVINO 模型的推理时间会显著缩短。对于较大的模型尤其如此,因为这类模型的性能提升最为明显。
实际应用与优势#
使用 OpenVINO 优化 Ultralytics YOLOv8 模型,对需要实时处理的应用尤其有益。以下是一些示例:
- 安全系统:实时目标检测可以立即向安保人员发出警报,提升安全性和响应速度。
- 自动驾驶车辆:更快的推理速度可以提升自动驾驶系统的响应能力,让系统更加安全可靠。
- 医疗保健:诊断工具可以快速处理图像并更快地提供结果,从而挽救生命并及时采取干预措施。
实施这些优化不仅能提升性能,还能增强应用的可靠性和效率。这有助于改善用户体验、提高生产力,并打造更多创新解决方案。
总结#
将 Ultralytics YOLOv8 模型导出并针对 OpenVINO 进行优化,是利用 Intel 硬件打造更快速、更高效 AI 应用的有效方式。只需几个简单步骤,你就能显著提升模型性能,并将其有效应用于现实场景。
不妨查看 Ultralytics 提供的更多教程和指南,例如 Ultralytics Academy 中的 OpenVINO on CPU课程,持续提升 AI 项目的能力。访问我们的 GitHub 代码仓库,加入 Ultralytics 社区,获取更多见解和动态。
请记住,优化模型不只是为了提升速度,更是为了发掘新的可能性,并确保你的 AI 解决方案稳健、高效,能够迎接未来挑战。
作者
评论
提出问题、分享你的结果,或帮助其他人。









