通过数据增强提升 AI 模型鲁棒性
了解如何通过数据增强为训练数据添加真实变化,从而提升 AI 模型的鲁棒性和真实场景性能。
测试是构建任何技术解决方案的关键环节。它能让团队在系统上线前了解其真实运行方式,并及时修复问题。这一点适用于许多领域,包括 AI,因为模型部署后需要应对不可预测的现实环境。
例如,计算机视觉是 AI 的一个分支,旨在教会机器理解图像和视频。Ultralytics YOLO26 等计算机视觉模型支持目标检测、实例分割和图像分类等任务。
它们可用于许多行业中的患者监护、交通分析、自动结账和制造业质量检测等应用。然而,即使拥有先进的模型和高质量的训练数据,视觉 AI 解决方案在面对光照变化、运动或物体部分被遮挡等现实环境变化时,仍可能表现不佳。
这是因为模型会从训练期间获得的示例中学习。如果模型此前没有见过眩光、运动模糊或部分可见等情况,那么在这些场景中正确识别物体的可能性就会降低。
提升模型鲁棒性的一种方法是使用数据增强。工程师无需收集大量新数据,而是可以对现有图像进行细微且有意义的修改,例如调整光照、裁剪或混合图像。这有助于模型学会在更广泛的情境下识别相同的物体。
本文将探讨数据增强如何提升模型鲁棒性,以及视觉 AI 系统部署到受控环境之外时的可靠性。让我们开始吧!
如何检查模型的鲁棒性#
在深入了解数据增强之前,我们先讨论如何判断一个计算机视觉模型是否真正做好了应对现实应用的准备。
鲁棒的模型即使在环境发生变化时也能保持良好表现,而不是只能处理干净且标注完美的图像。评估 AI 模型鲁棒性时,可以考虑以下实用因素:
- **光照变化:**模型在强光、弱光、眩光或阴影下可能表现不同,这些因素会影响模型检测物体时的置信度。
- **部分遮挡:**在日常场景中,物体经常会被其他物品挡住,或只有部分区域可见。更具鲁棒性的模型即使缺少部分视觉信息,也能够识别这些物体。
- **拥挤场景:**包含大量重叠物体的环境会增加检测难度。在这些情况下表现良好的模型,通常能更可靠地处理复杂环境。
在干净且拍摄完美的图像上取得良好结果,并不总能转化为现实环境中的出色表现。在多种条件下定期测试,有助于了解模型部署后能否经受住实际环境的考验。
什么是数据增强?#
物体在照片中的呈现方式会受到光照、角度、距离或背景的影响。当训练计算机视觉模型时,它所学习的数据集需要包含这类变化,才能在不可预测的环境中保持良好表现。
数据增强通过从现有图像创建更多示例来扩充训练数据集。具体做法包括对图像进行旋转或翻转、调整亮度,或裁剪其中一部分等有意修改。
例如,假设你只有一张猫的照片。如果旋转图像或改变其亮度,就可以从这张照片创建出多个新版本。每个版本看起来略有不同,但仍然是同一只猫的照片。这些变化有助于教会模型:物体的外观可以不同,但本质上仍然是同一个物体。
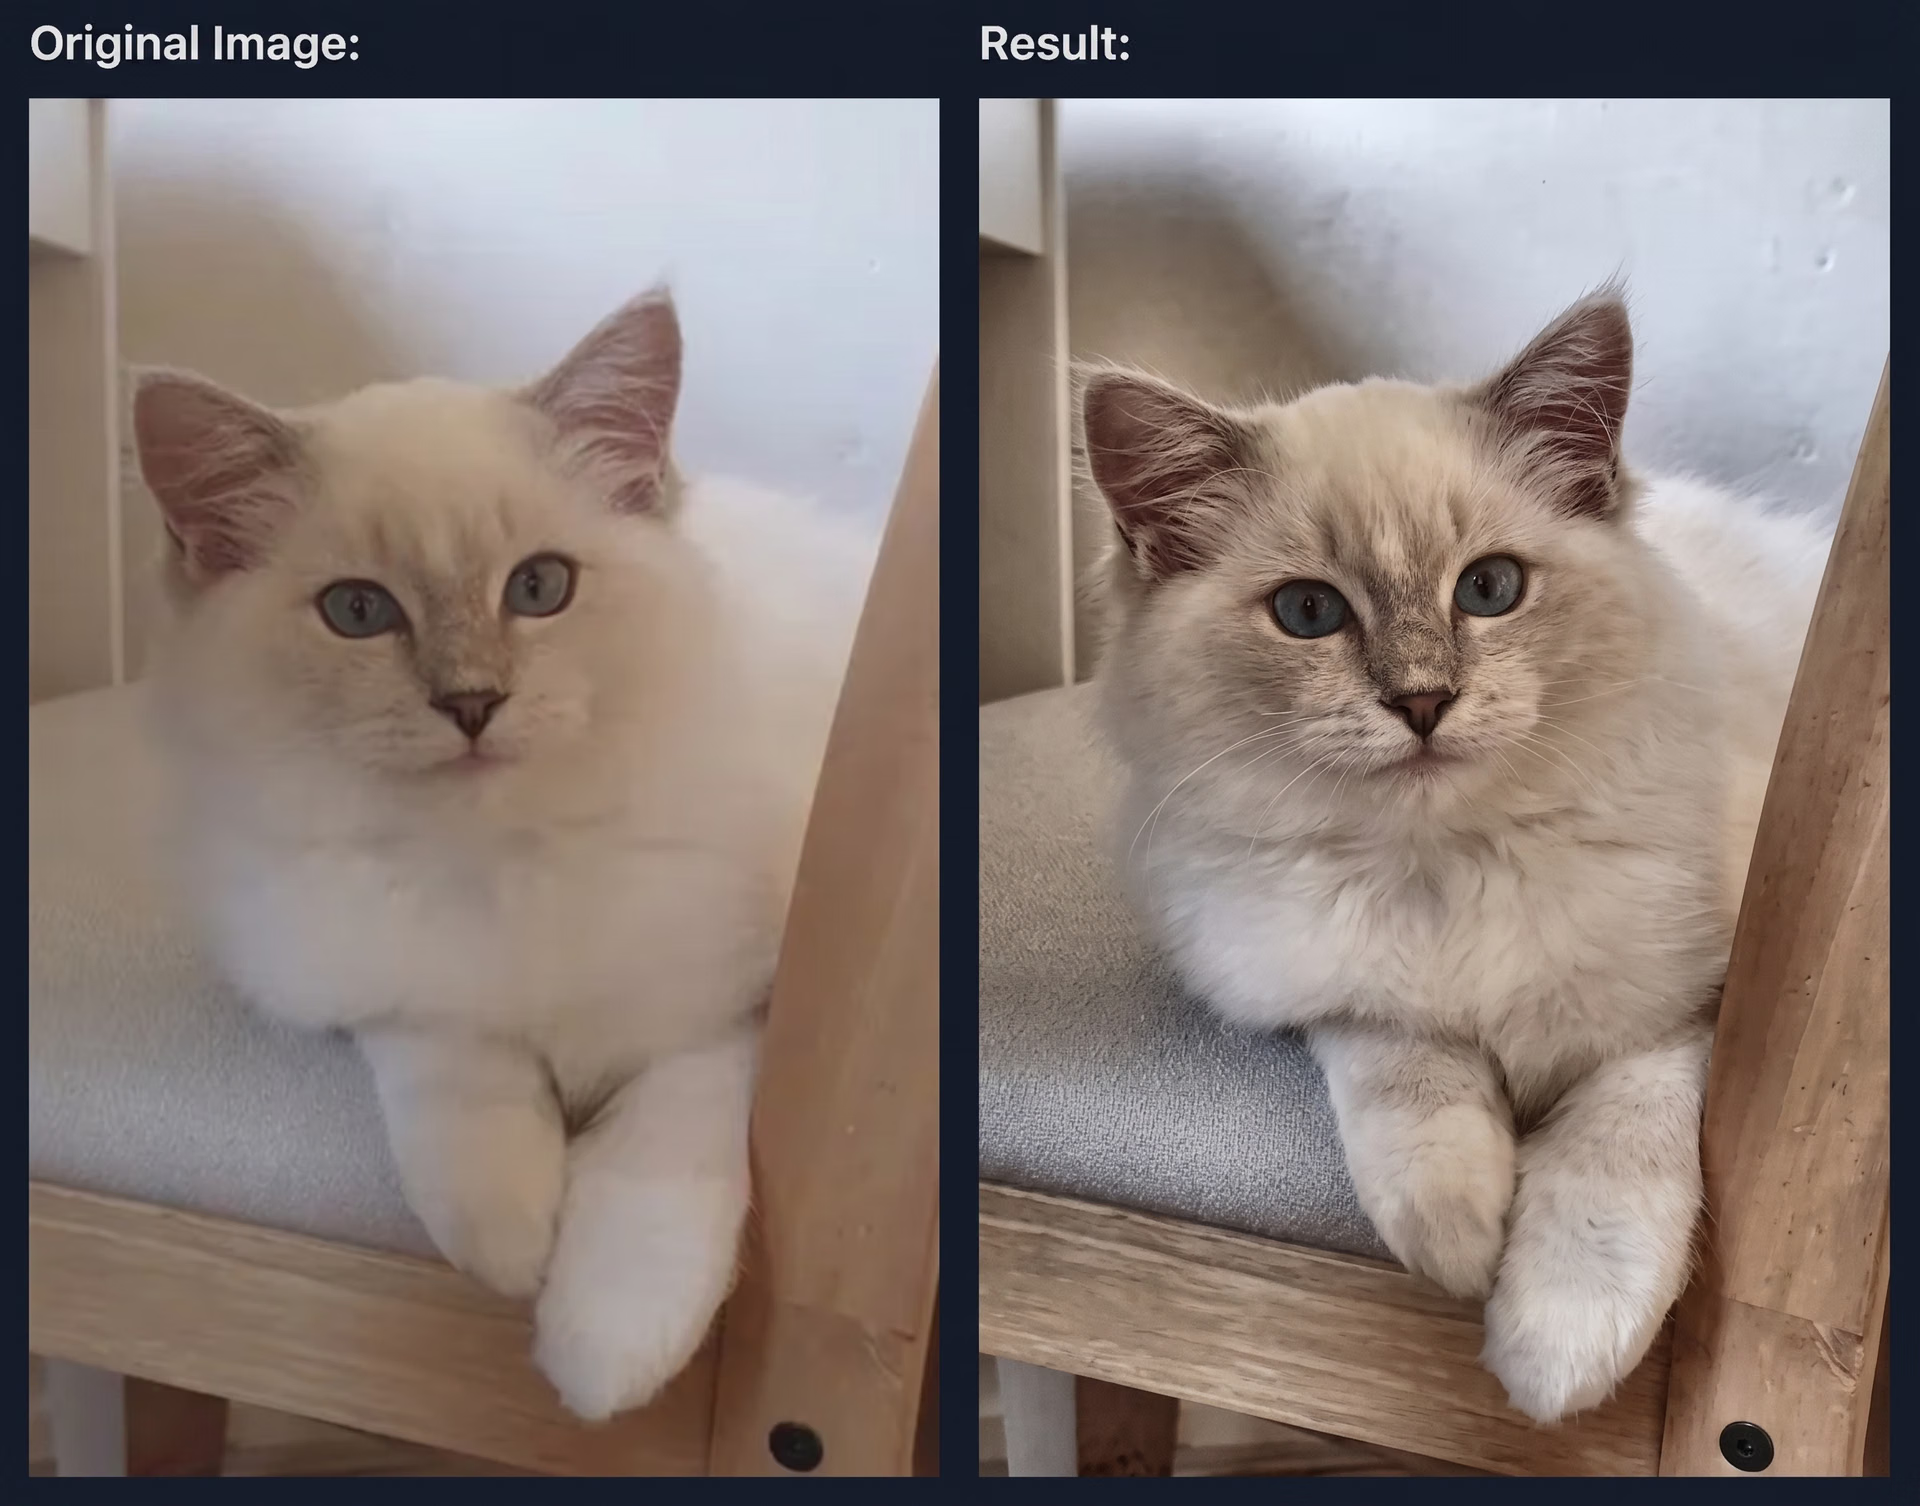
图 1. 猫咪图像增强示例(来源)
数据增强如何提升模型性能#
在模型训练期间,可以将数据增强直接集成到训练流水线中。无需手动创建和存储图像的新副本,而是在加载每张图像时应用随机变换。
这意味着模型每次看到的图像版本都会略有不同,例如图像可能更亮、经过翻转或部分隐藏。随机擦除等技术甚至可以移除图像中的小区域,以模拟物体被遮挡或仅部分可见的现实情况。
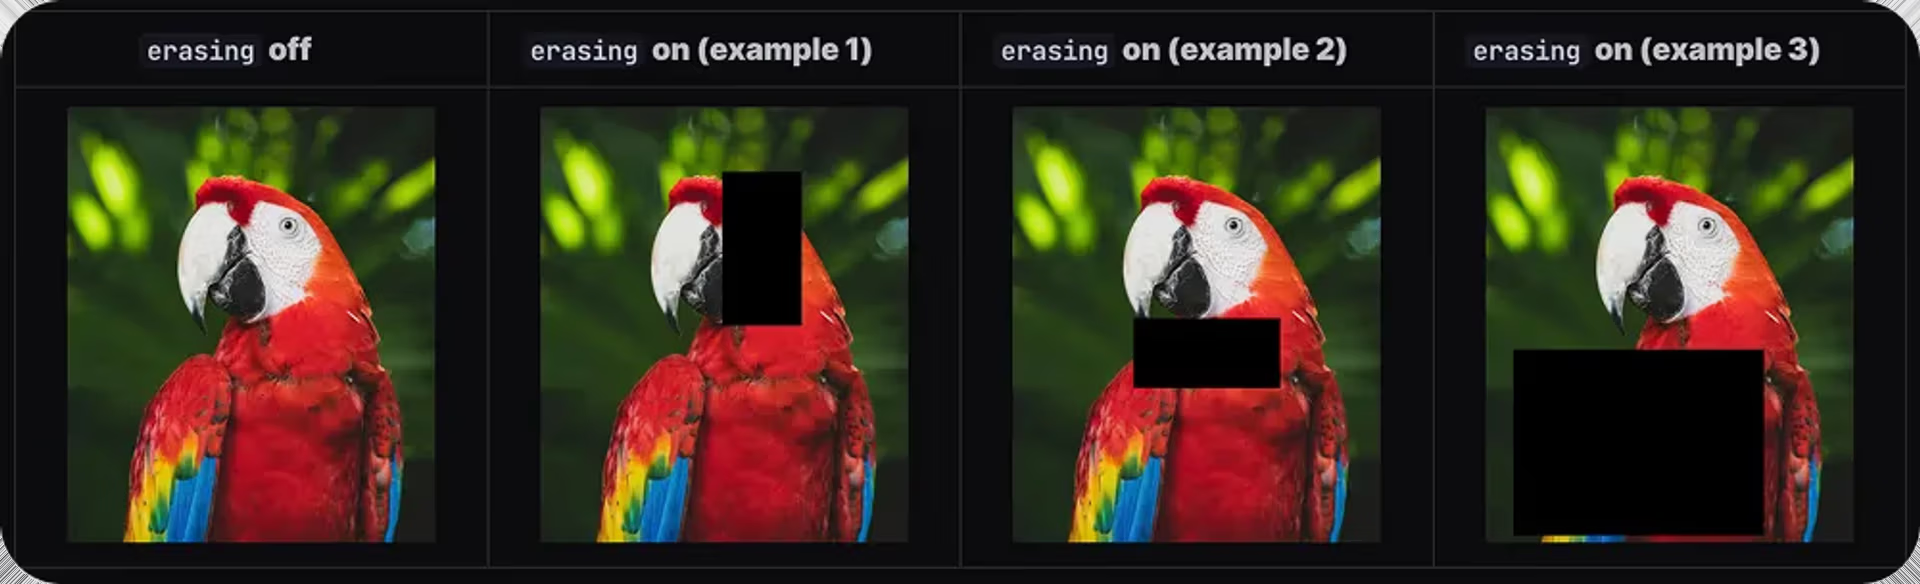
图 2. 基于随机擦除的数据增强示例(来源)
看到同一图像的许多不同版本后,模型就能学习哪些特征十分重要,而不是依赖某一个完美示例。这种多样性能够提升 AI 模型的鲁棒性,使其在现实环境中表现得更加可靠。
常见的数据增强技术#
以下是一些用于为训练图像引入变化的数据增强技术:
- **几何变换:**这些技术会改变物体在图像中的空间呈现方式。旋转、翻转、调整大小、裁剪或平移图像,可以帮助模型理解从不同角度或距离观察物体时的不同外观。
- **颜色和光照调整:**现实环境中的光照很少保持一致。根据所处环境或使用的相机不同,图像可能过亮、过暗,或存在轻微的色偏。调整亮度、对比度、色相和饱和度,可以让模型适应这些视觉变化,并在不同场景中保持良好表现。
- **图像质量变化:**模糊或视觉噪声会使图像看起来不清晰。在训练期间添加模糊或噪声,有助于模型学会应对运动模糊、弱光图像或低质量相机拍摄的结果,从而降低其对不完美视觉效果的敏感度。
- **基于遮挡的数据增强:**在现实环境中,物体经常会被其他物体部分遮挡。这被称为图像遮挡。在训练期间隐藏或遮盖图像中的小区域,可以帮助模型学会即使只能看到物体的一部分,也能检测出它们。
- **多图像数据增强:**这些技术会将多张图像的不同部分组合成一个训练示例,从而增加视野中的物体数量,并提升模型处理复杂或拥挤场景的能力。
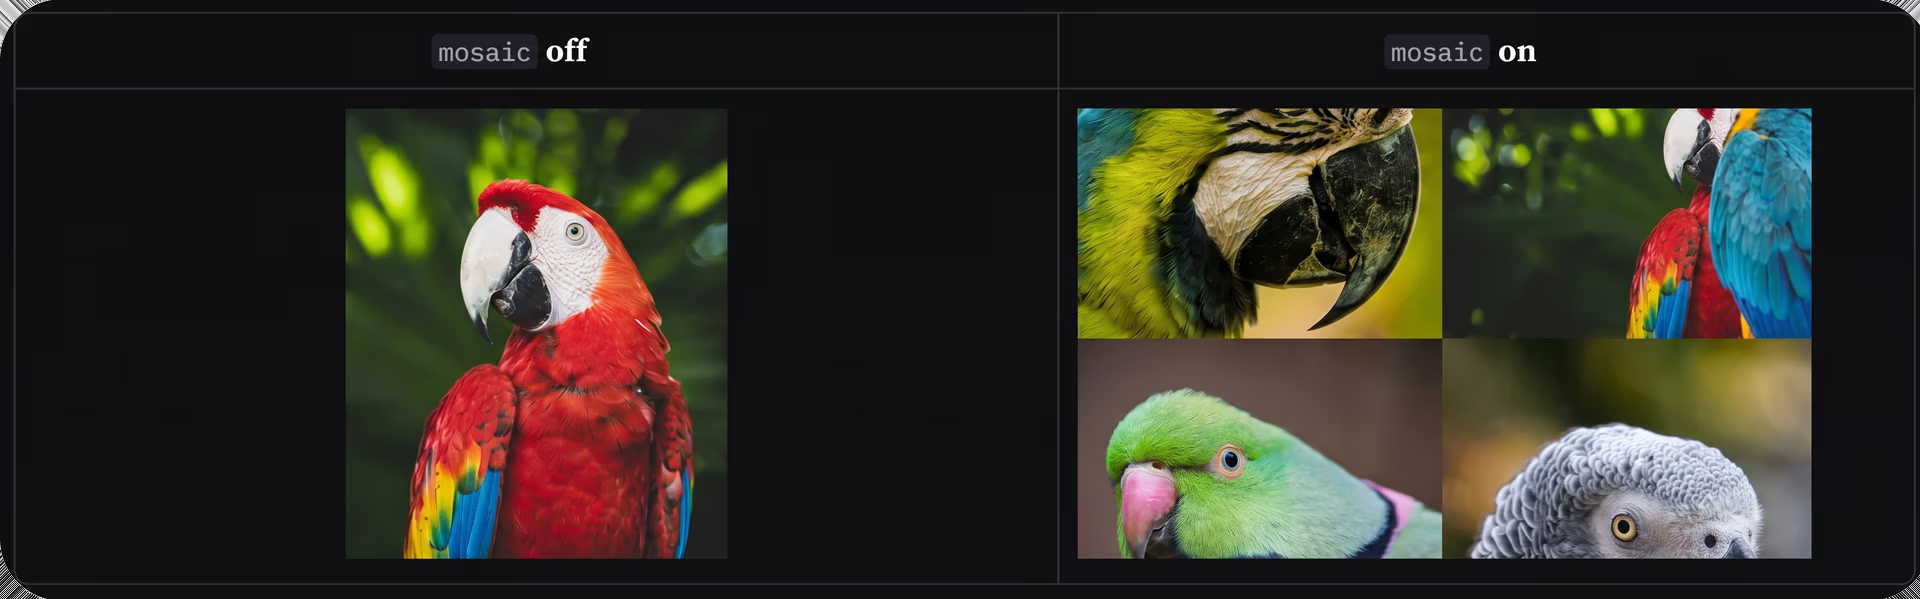
图 3. 多图像数据增强示例(来源)
借助 Ultralytics Python 包轻松实现数据增强#
管理数据集、创建图像变体以及编写变换代码,都会为构建计算机视觉应用增加额外步骤。Ultralytics Python 包通过提供统一接口,简化了 Ultralytics YOLO 模型(如 YOLO26)的训练、运行和部署流程。作为简化训练工作流的一部分,该软件包包含经过 Ultralytics 测试、针对 YOLO 模型优化的内置数据增强功能。
它还支持实用的集成,免去了使用独立工具或编写自定义代码的需要。具体来说,在数据增强方面,该软件包集成了广泛使用的图像增强库 Albumentations。通过这一集成,可以在训练期间自动应用数据增强,无需额外脚本或自定义代码。
管理标注和增强数据集#
影响模型鲁棒性的另一个因素是标注质量。使用 Roboflow 等标注工具创建和管理的整洁、准确标签,能帮助模型理解物体的位置及其外观。
在训练期间,翻转、裁剪和旋转等数据增强会动态应用,同时自动调整标注以匹配这些变化。当标签足够精确时,这一过程能够顺利进行,并为模型提供同一场景的许多真实示例。
如果标注不准确或不一致,这些错误可能会在增强图像中重复出现,从而降低训练效果。从准确的标注开始,可以避免这些错误扩散,并有助于提升模型鲁棒性。
通过数据增强增强视觉 AI 应用#
接下来,让我们通过示例了解数据增强如何在现实应用中提升 AI 模型的鲁棒性。
提升现实环境中的目标检测准确率#
当真实数据有限、敏感或难以收集时,人们经常使用合成图像训练目标检测系统。借助合成图像,团队可以快速生成产品、环境和相机角度的示例,无需在现实中拍摄每一种场景。
然而,与现实环境中的视频相比,合成数据集有时看起来过于干净,因为真实视频中的光照会变化、物体会相互重叠,场景中还会包含背景杂物。数据增强通过引入不同光照、噪声或物体位置等逼真变化,有助于弥合这一差距,使模型学会应对部署后将遇到的各种环境条件。
例如,在一项近期研究中,一个 Ultralytics YOLO11 模型完全使用合成图像进行训练,并通过加入数据增强来引入额外变化。这促使模型更广泛地学习识别物体。尽管训练期间从未见过现实数据,但该模型在真实图像上进行测试时仍表现良好。
提升医学影像解决方案的可靠性#
医学影像数据集通常规模有限,而扫描结果本身也会因设备类型、成像设置或临床环境而有所不同。患者解剖结构、角度、光照或视觉噪声的差异,可能使计算机视觉模型难以学习能够在不同患者和医院之间良好泛化的模式。
数据增强通过在训练期间创建同一张扫描图像的多个变体来帮助解决这一问题,例如添加噪声、轻微平移图像或应用小幅畸变。这些变化让训练数据更能代表真实的临床条件。
例如,在一项儿科影像研究中,研究人员使用 Ultralytics YOLO11 进行解剖结构分割,并使用增强后的医学数据对其进行训练。他们引入了添加噪声、轻微位置偏移和小幅畸变等变化,使图像更加逼真。
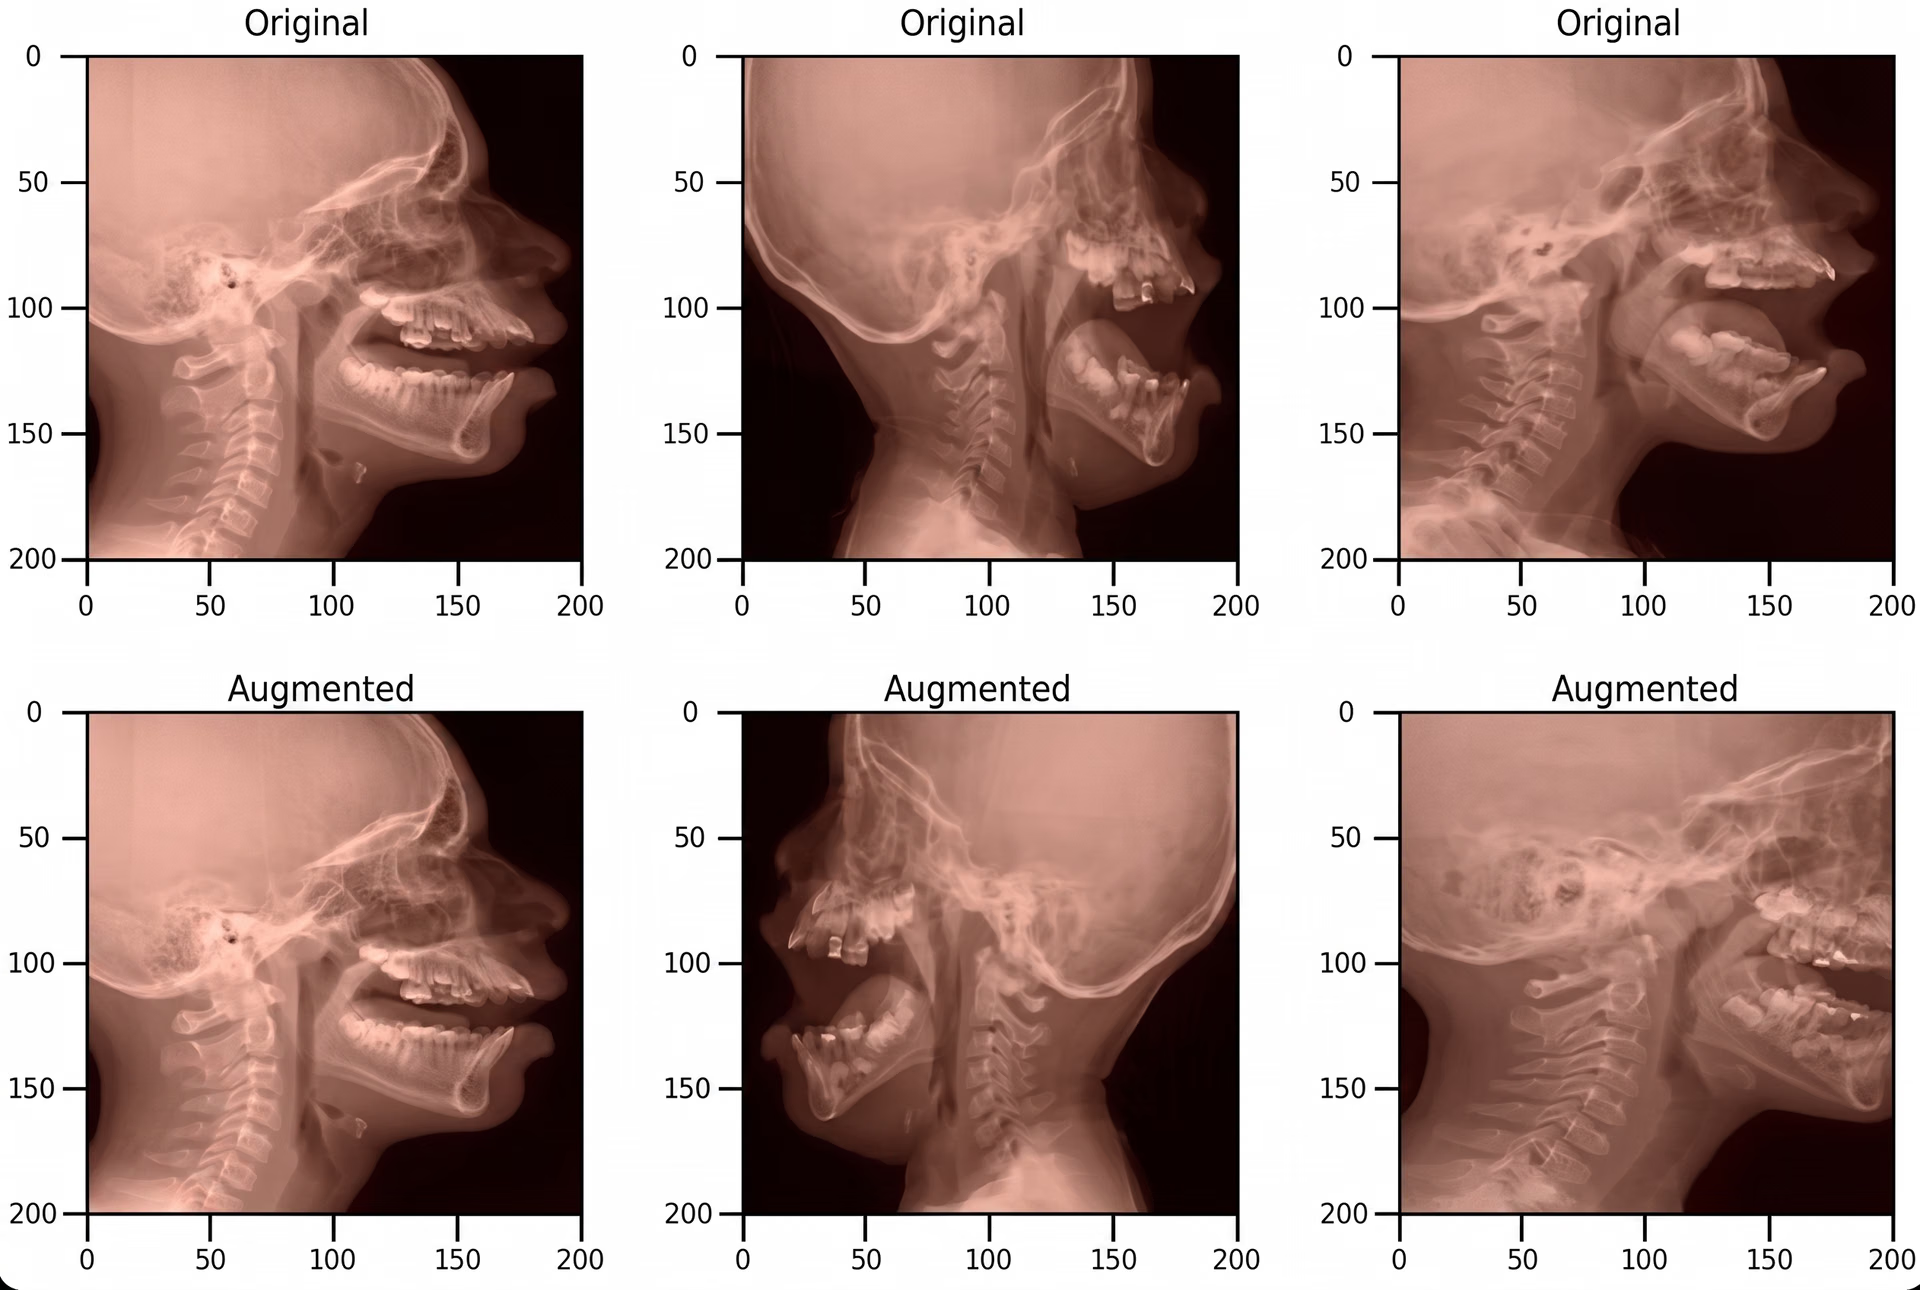
图 4. 原始儿科医学图像与增强后的儿科医学图像(来源)
通过从这些变化中学习,模型关注的是有意义的解剖特征,而不是表层差异。这使其在不同扫描图像和患者病例中的分割结果更加稳定。
要点总结#
收集多样化数据并不容易,但数据增强可以让模型从更广泛的视觉条件中学习。这能提升模型应对遮挡、光照变化和拥挤场景时的鲁棒性。总体而言,这有助于模型在受控训练环境之外更加可靠地运行。
加入我们的社区,并通过我们的 GitHub 代码仓库探索视觉 AI 的最新进展。访问我们的解决方案页面,了解制造业中的 AI和医疗保健中的计算机视觉等应用如何推动行业发展,并查看我们的许可选项,为你的下一个 AI 解决方案提供支持。








