改进使用 Ultralytics YOLO 模型进行的碰撞预测
了解 Ultralytics YOLO 模型提供的洞见如何帮助碰撞预测系统在动态环境中做出更安全、更迅速的决策。
即使开车时处处小心,事故仍有可能发生。汽车突然变道、行人横穿马路,或骑行者毫无预警地加速。这些日常场景都说明,碰撞预测系统可以发挥重要作用,帮助保障每个人的安全。
此前,我们探讨了球体轨迹预测,并了解到预测快速运动的球的路径如何帮助体育分析理解运动过程并预判接下来会发生什么。碰撞预测的原理与此类似。
这些预测系统本质上是在预见未来。通过观察车辆和行人的移动,它们可以及早发现风险,并在情况变得危险之前调整路径或行为(这也称为运动规划或路径规划)。
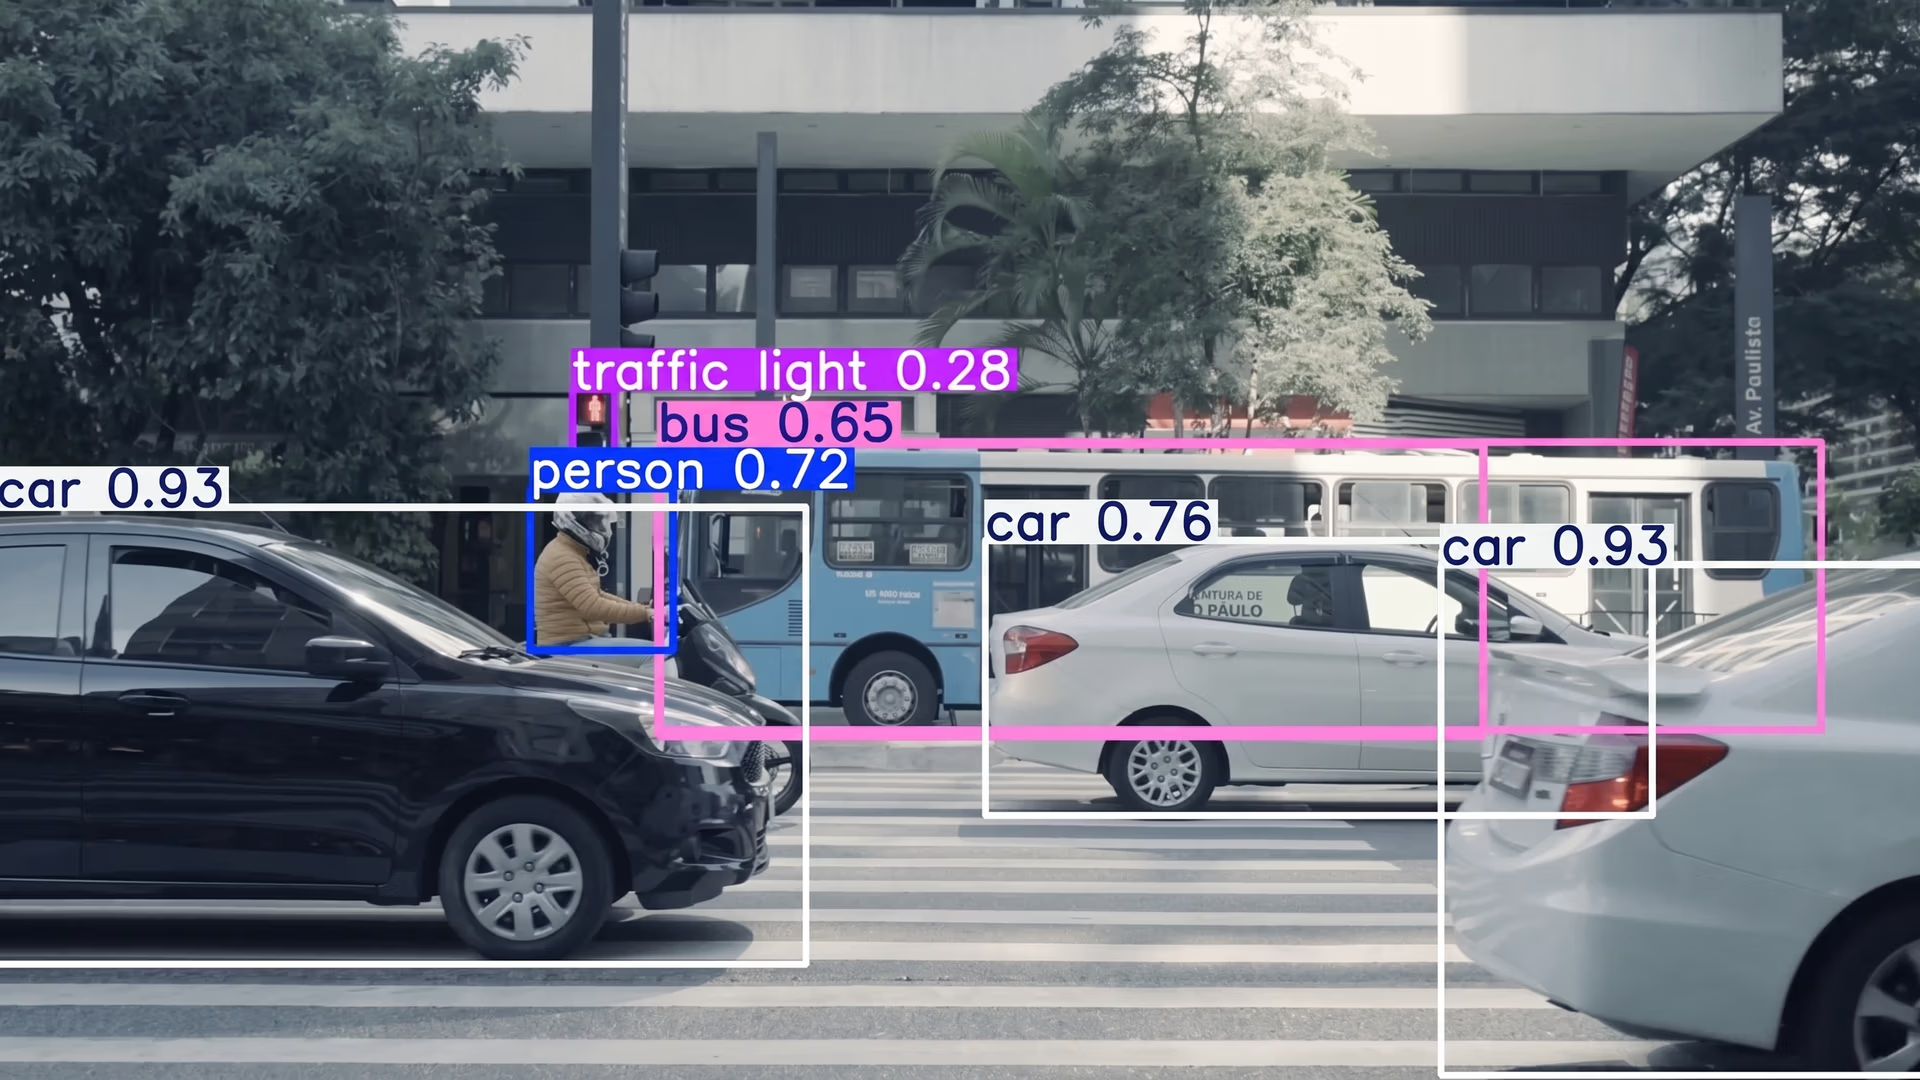
碰撞预测系统背后的关键计算机科学技术是人工智能及其子领域,例如计算机视觉和预测方法,后者有助于预测物体的运动方式。例如,Ultralytics YOLO11 和即将推出的 Ultralytics YOLO26 等计算机视觉模型可用于实时检测和跟踪车辆、行人等物体,而预测模型则利用这些信息估算物体接下来的运动。
图 1. YOLO11 检测道路上物体的示例(来源)。
最终得到的 AI 系统能够理解周围正在发生的事情,并在动态环境中支持更明智的决策。本文将介绍碰撞预测的工作原理、相关方法,以及计算机视觉和 Ultralytics YOLO 模型在此过程中能够发挥的作用。开始吧!
什么是碰撞预测?#
碰撞预测是指 AI 系统理解物体如何运动,并预判它们何时可能靠得很近或发生接触的能力。不同系统可以通过多种方式利用这些信息,包括支持安全功能、优化移动,或协调共享空间中的行动。
无论是在共享空间中移动的是高速公路上的汽车、仓库通道中的叉车,还是过马路的行人,碰撞预测都能帮助系统理解这些交互可能如何发展。在注重安全的应用中,这种预见能力可以用来降低风险;在其他场景中,它则可以支持路线规划、时间安排或协调移动等任务。
例如,在许多配备高级驾驶辅助系统(ADAS)的新型汽车中,摄像机和传感器会监控前方道路,并估算汽车接近附近物体的速度。如果系统检测到情况可能变得不安全,就会向驾驶员发出警报;在某些情况下,自动制动还可以帮助减轻碰撞影响。
了解碰撞预测的四个阶段#
碰撞预测是一个协同流程,各种 AI 组件共同识别物体、跟踪物体的运动并估算接下来可能发生的情况。这些系统通常分为四个相互关联的阶段:目标检测、目标跟踪、轨迹预测,最后是碰撞预测。每个阶段的工作都建立在前一阶段的准确性之上。
接下来,让我们仔细看看每个阶段的工作原理。
目标检测简介#
目标检测是计算机视觉的一项核心任务,视觉 AI 模型会在图像或视频帧中识别并定位物体。通过分析像素数据,目标检测模型可以输出三项主要信息:边界框、物体类别和置信度分数。边界框表示物体所在的位置;物体类别说明物体是什么,例如汽车、行人或骑行者;置信度分数则反映模型对预测结果的确信程度。
YOLO11 和 YOLO26 等视觉 AI 模型以此为基础,并支持多种相关任务,包括目标检测、目标跟踪和旋转边界框 (OBB) 检测。目标检测可以告诉预测系统每一帧中有什么;跟踪会持续跟随这些物体的运动;旋转边界框则能更准确地表示不同角度下物体的形状。
在这一阶段,碰撞预测系统只专注于理解视觉数据中出现了什么。它构成了后续所有步骤所依赖的基础信息层,但尚未考虑物体将如何移动或互动。
目标跟踪概述#
检测到物体后,下一步是在各帧中跟踪物体,以便系统理解物体随时间的运动方式。检测会在每一帧中生成新的边界框,而目标跟踪则通过跨帧关联这些检测结果来保持连续性。
Ultralytics Python 包支持 ByteTrack 和 BoT-SORT 等跟踪算法。这些算法与 YOLO11 等模型配合,利用每帧的检测数据跟随物体的移动。算法会为每个物体分配唯一 ID,并用它保持物体身份的一致性,即使物体移动很快或部分被遮挡也不例外。由此形成的平滑跟踪历史记录了物体的运动方式。
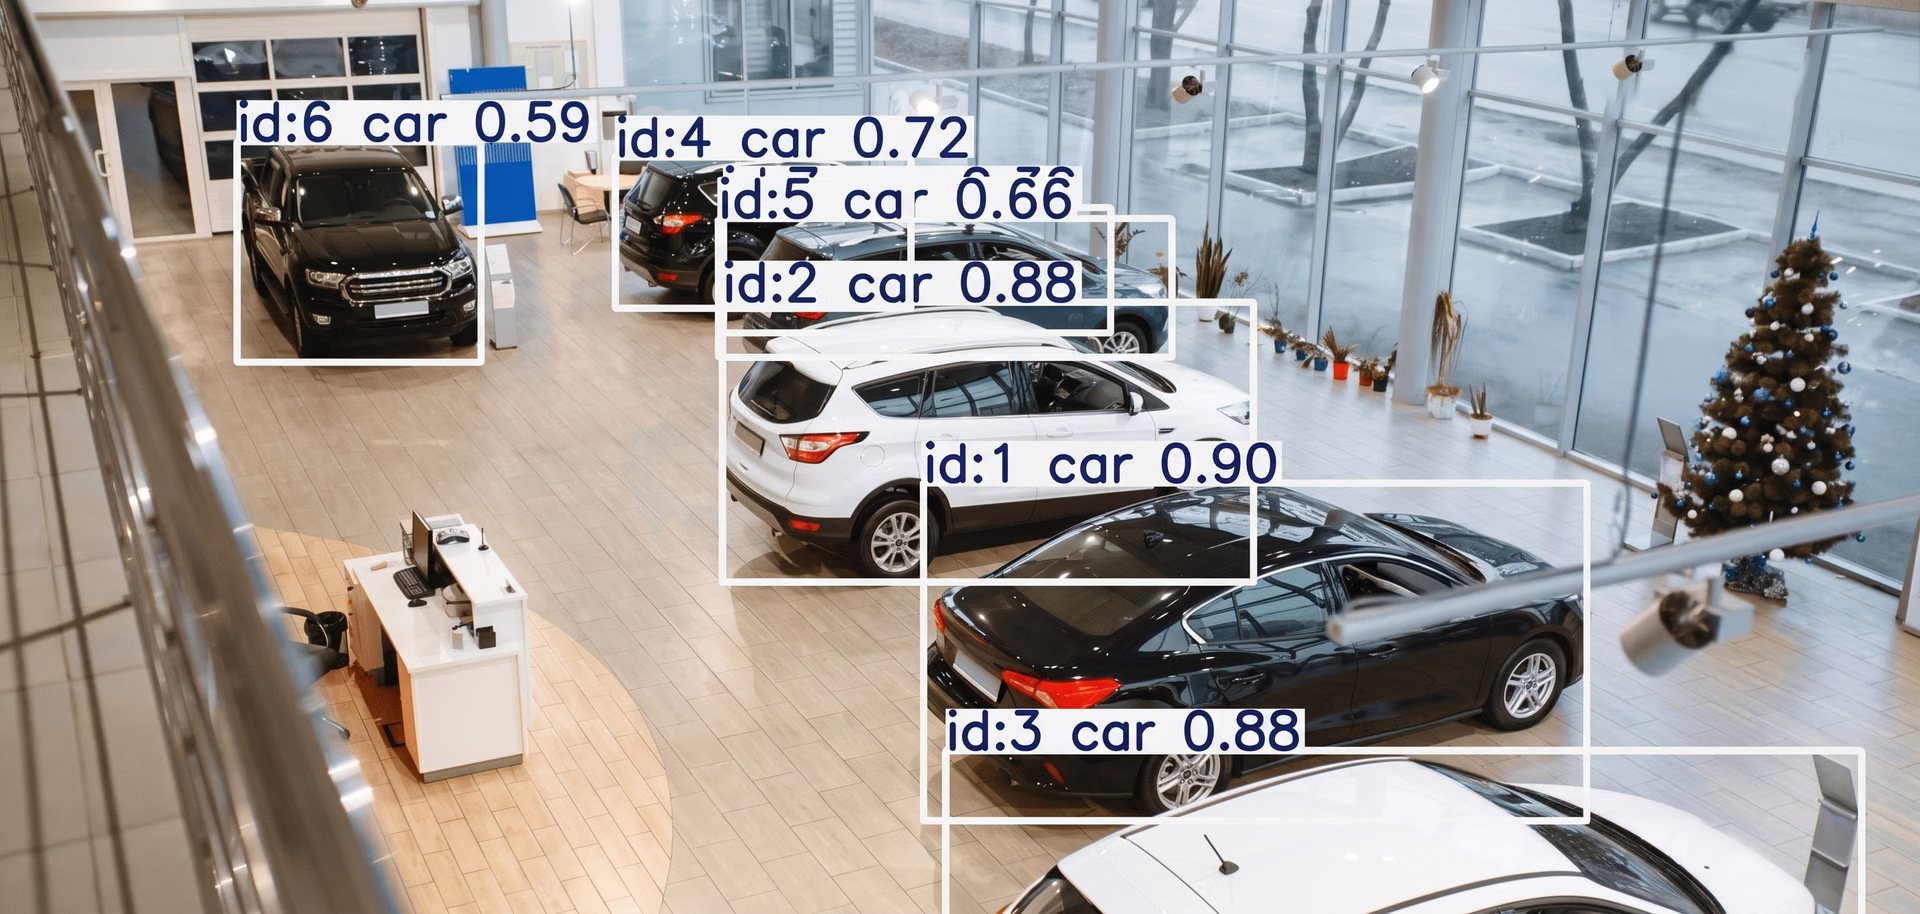
图 2. 使用 YOLO 为不同的检测结果分配唯一 ID。(来源)
下面简要介绍这两种跟踪方法的工作原理:
- ByteTrack:它会同时利用高、低置信度的检测结果来保持物体 ID 一致。卡尔曼滤波器提供的运动预测则有助于跟踪器在物体移动很快或暂时难以检测时保持稳定。
- BoT-SORT:该算法扩展了 SORT,将卡尔曼滤波器的运动预测与外观特征相结合,使跟踪器能够在人群密集或发生部分遮挡的场景中更可靠地跟踪物体。
为了衡量这些跟踪方法的表现,研究人员会使用成熟的多目标跟踪 (MOT) 数据集和基准进行评估。常用指标还包括多目标跟踪准确度 (MOTA),用于反映总体跟踪质量;身份识别 F1 分数 (IDF1),用于衡量物体身份保持的一致性;以及高阶跟踪准确度 (HOTA),可均衡评估检测性能和关联准确度。
了解轨迹预测#
在多个连续帧中跟踪物体后,下一步是预测物体接下来会去哪里,这称为轨迹预测。检测负责发现物体,跟踪负责跟随物体的运动,而预测则着眼于未来并估算物体的位置。
检测和跟踪得到的信息,例如物体的边界框、各帧中的位置和分配的 ID,可用于计算速度、方向和运动模式等运动特征。这些衍生信息为预测模型提供所需数据,使模型能够估算物体在接下来几秒内可能出现的位置。
如果跟踪数据存在缺失或突然跳变,插值技术可以帮助重建更平滑、更连贯的轨迹。这样可以确保预测模型获得高质量的运动输入,而不是含噪或不完整的位置数据。
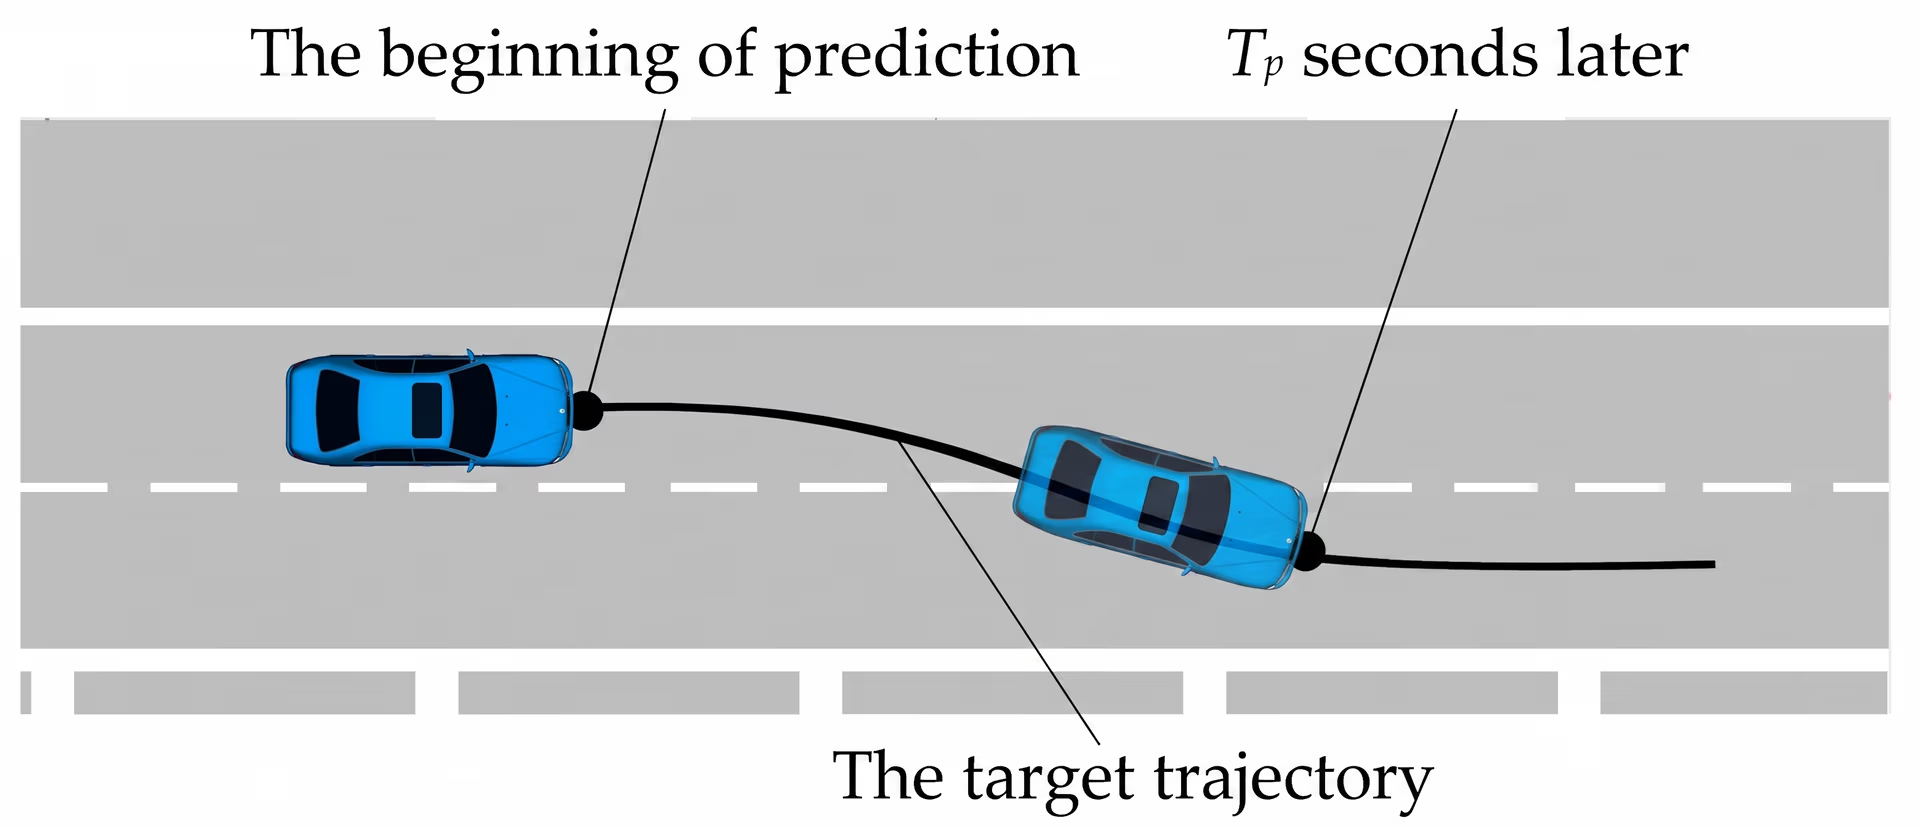
图 3. 汽车轨迹预测的可视化示例。(来源)
为了做出这些预测,许多系统依赖专门用于理解物体运动随时间变化情况的深度学习模型。通过分析过去的位置序列及其衍生的运动特征,这些模型可以学习常见的运动模式,并利用这些知识预测未来路径。
以下是一些常用于轨迹预测的深度学习和机器学习方法:
-
循环神经网络 (RNN):RNN 是专为处理序列(例如一系列视频帧)而设计的深度学习模型。它们能够记住先前的位置,并利用这些信息理解物体的运动方式。这有助于系统识别加速、减速或直线移动等简单运动模式。
-
长短期记忆网络 (LSTM):LSTM 是一种更先进的 RNN,能够记住较长时间内的信息。因此,它们可以捕捉更复杂的运动,例如车辆准备转弯或行人改变方向。由于能够跟踪较长时间的趋势,它们在繁忙环境中通常能做出更可靠的预测。
-
Transformer:Transformer 会处理完整的运动序列,并利用注意力机制聚焦于序列中最重要的细节。因此,在多个物体相互作用的场景中,例如汽车汇入车流或行人穿行时,它们尤其有效。
这些模型可以预测短期和较长期的路径。短期预测通常在两秒以内,准确度往往最高;较长时间范围的预测,例如两到六秒,可以提供更多前瞻信息,但不确定性也更高。
整合各环节:碰撞检测算法#
在最后的碰撞预测阶段,系统会综合利用目前为止收集到的所有信息:每个物体是什么(检测)、物体如何移动(跟踪),以及物体接下来可能去哪里(预测)。这一步会检查预测路径是否可能相交并导致碰撞。
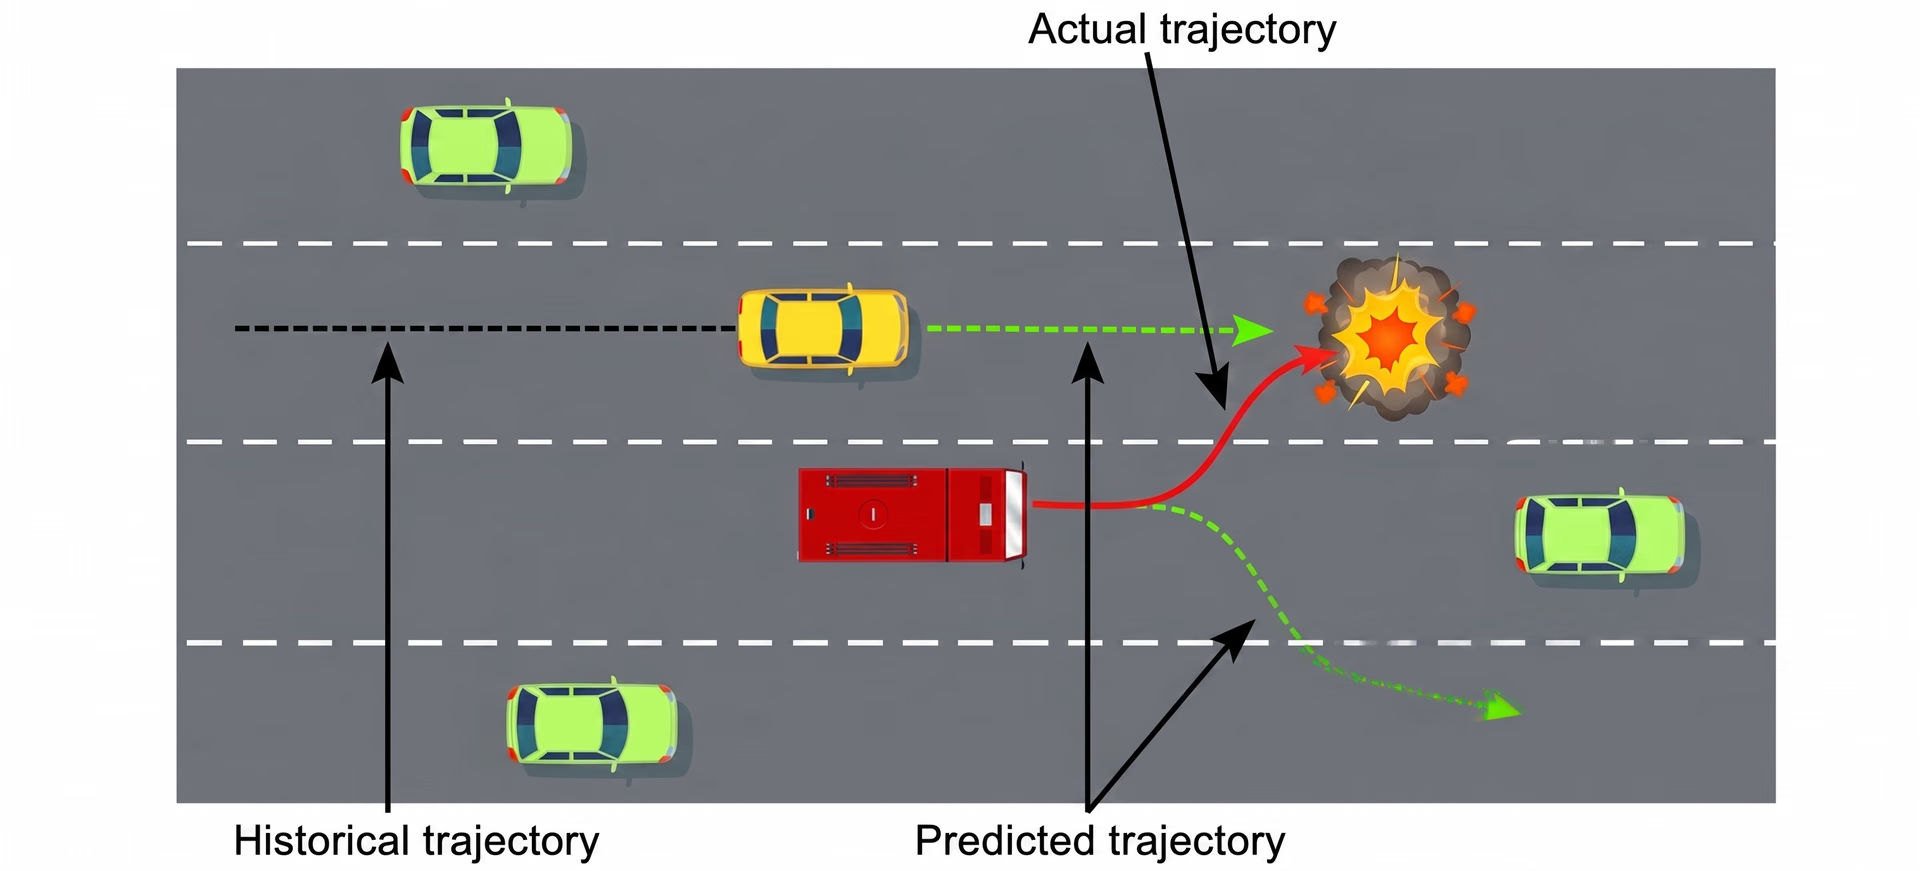
图 4. 碰撞预测系统的工作原理(来源)
对于自动驾驶汽车,碰撞检测系统会比较附近物体(如汽车、行人和骑行者)的未来轨迹。如果两条预测路径重叠或距离过近,系统就会将其标记为潜在的车辆碰撞。为了判断碰撞风险有多紧迫,系统还会计算一个称为碰撞时间的数值。
碰撞时间(TTC)是快速移动环境中的一项关键指标。它用于估算两个物体在保持当前速度和方向的情况下,距离碰撞还剩多少时间。当 TTC 低于某个阈值时,系统可以通过发出警告、制动或调整规划路径来做出响应。
碰撞预测的实际应用#
碰撞预测正逐渐成为众多行业的关键技术,包括交通管理、智慧城市基础设施、工业自动化和移动机器人。随着先进的计算机视觉和预测模型不断发展,这些系统预测运动的能力也越来越强。
现在我们对碰撞预测和轨迹预测的工作原理有了更深入的了解,接下来看看一些有趣的研究,了解这些方法如何应用于各种真实环境。
借助 YOLO 为应急自动驾驶车辆预测碰撞#
在人群密集且难以预测的环境中行驶,是自动系统面临的最大挑战之一,尤其是行人的移动方式不符合明确规律时。应急车辆更常遇到这个问题,因为它们需要在没有结构化道路、车道线或可预测行人行为的情况下,以较高速度快速穿过人流密集的公共区域。
在这类场景中,了解人们的位置以及他们在接下来几秒内可能如何移动,对于避免事故至关重要。例如,一项近期研究针对这一挑战,为在人行密集环境中行驶的应急自动驾驶车辆(EAV)构建了一套完整的碰撞预测流程。
借助 YOLO 的碰撞预测流程如何运作#
下面简要介绍这种方法的工作原理:
- 使用 YOLO 检测行人:基于 YOLO 的检测器会识别每个摄像头画面中的行人,并为每个可见行人输出边界框。
- 使用 ByteTrack 进行运动跟踪:ByteTrack 算法会关联不同画面中的检测结果,为每个行人分配一致的 ID,并生成运动历史,显示行人随时间推移的移动情况。
- 估算真实世界位置:逆透视映射(IPM)会将二维像素坐标转换为近似的地面位置,帮助系统了解行人相对于车辆在真实空间中的位置。
- 使用 cGAN 生成鸟瞰图:条件 GAN 是一种将一种图像格式转换为另一种格式的 AI 模型,它可以生成场景的鸟瞰图表示。这种俯视布局能让人更轻松地解读行人的位置及其周围环境。
- 使用 LSTM 模型预测轨迹:LSTM 模型会根据每位行人过去的位置和移动模式,预测他们在接下来几秒内可能前往的位置。
- 使用碰撞锥高效检测碰撞:系统会使用碰撞锥方法比较预测轨迹,判断车辆与任何行人的路径是否可能相交。
- 通过信号避免碰撞:如果系统预测到碰撞,就会在最佳时机发出声音信号(如喇叭声或铃声)。系统会选择合适的时机,以影响行人的行为,让他们有机会加快或放慢脚步并转移到安全地带。
利用边缘视觉和 YOLO 保障城市行人安全#
类似地,另一种碰撞预防方法不再只关注车辆,而是将重点转向基础设施本身。该方法不依赖汽车内部的传感器,而是在人行横道和十字路口安装智能摄像头,实时监测行人和车辆的移动。这些地点通常难以预测:有人可能突然走上马路,骑行者可能在车流中穿行,驾驶员也未必总会减速,因此及早检测风险至关重要。
一项有趣的研究通过名为 NAVIBox 的系统探索了这一思路。这是一种边缘视觉设备,旨在直接在十字路口预测车辆与行人之间的风险。该系统使用 Ultralytics YOLOv8 模型检测行人和车辆,并使用轻量级 Centroid 跟踪器在不同画面中跟踪它们。这样便能生成简短而可靠的运动历史,随后再通过透视变换进行优化,将倾斜的 CCTV 视角转换为更清晰的道路鸟瞰布局。
借助这些优化后的轨迹,NAVIBox 可以估算道路使用者在接下来几秒内可能如何移动,并检查他们的路径是否可能相交(也称为相交测试)。当系统检测到存在风险的交互时,会立即通过面向驾驶员的显示屏和面向行人的扬声器发出警告,无需依赖远程服务器或网络连接。在真实城市地点进行的测试表明,NAVIBox 的运行速度足以实现真正的实时响应,也能准确识别潜在碰撞场景,因此可作为繁忙城市十字路口的实用安全工具。
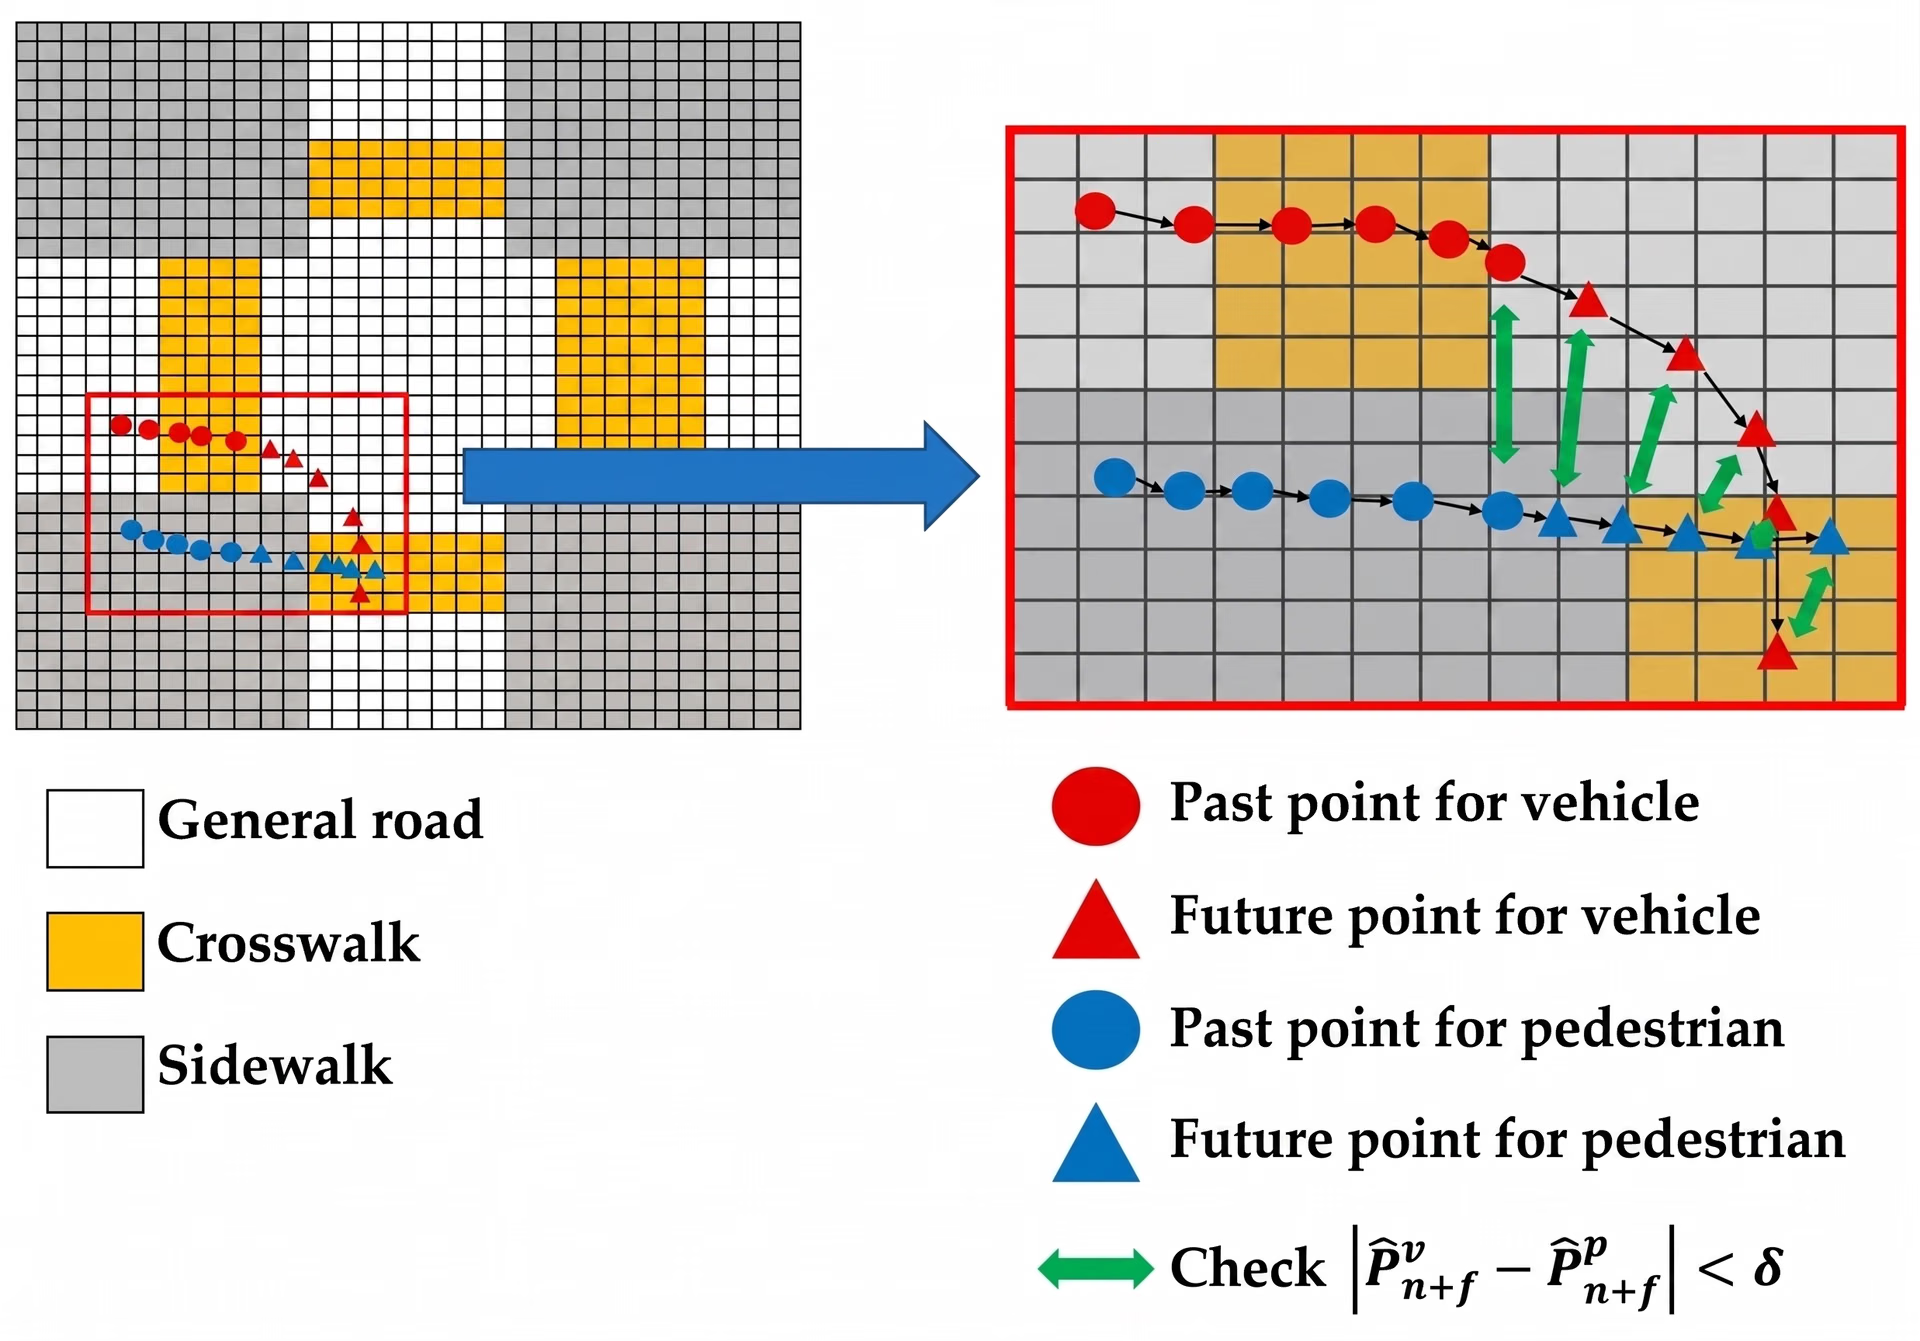
图 5. 预测车辆与行人之间的碰撞风险。(来源)
碰撞检测与预测的优缺点#
以下是使用 AI 驱动的碰撞预测系统的一些优势:
-
提升态势感知能力:AI 系统会持续绘制环境中物体的移动情况,从而更全面地了解大规模人群流动、交通行为或机器路径。
-
为长期规划提供数据洞察:通过记录检测结果、险些发生的碰撞和移动模式,AI 系统可以提供分析数据,帮助城市规划人员、安全团队和车队运营商重新设计十字路口、改进标识或优化运营政策。
-
以较低成本预防风险:通过在风险升级前将其检测出来,这些系统有助于避免代价高昂的事故、保险索赔或设备维修。
尽管有诸多优势,无碰撞系统也面临一些局限。以下是需要考虑的几个挑战:
- 传感器和摄像头的安装限制:安装位置或角度不当的摄像头可能会扭曲物体的大小或距离,使深度估算和轨迹预测的可靠性降低。
- 遮挡:物体可能被其他物体部分或完全遮住。这会导致物体跟踪变得困难,因为模型无法保持视觉连续性。
- 环境条件:光线昏暗、阳光强烈、下雨、有雾或摄像头质量较差,都会降低模型清晰观测场景的能力,影响准确性。
要点#
碰撞预测结合了两种强大的能力:计算机视觉让系统了解当前环境中正在发生的事情,轨迹预测则帮助系统预判接下来可能发生的情况。
结合这两种能力后,机器就能实时检测移动物体,并预测这些物体在接下来几秒内可能发生的交互。随着计算机视觉和预测技术不断发展,碰撞预测很可能成为构建更安全、更可靠且可扩展的自主系统的关键技术。
访问我们的社区和 GitHub 代码库,了解更多 AI 相关信息。前往我们的解决方案页面,探索 AI 在医疗保健领域的应用和制造业中的计算机视觉。了解我们的许可选项,立即开始构建!








