探索使用 Ultralytics YOLO11 进行小目标检测
了解 Ultralytics YOLO11 如何在监控和机器人等现实应用中实现快速、准确的小目标检测。
 Abirami Vina9 分钟阅读
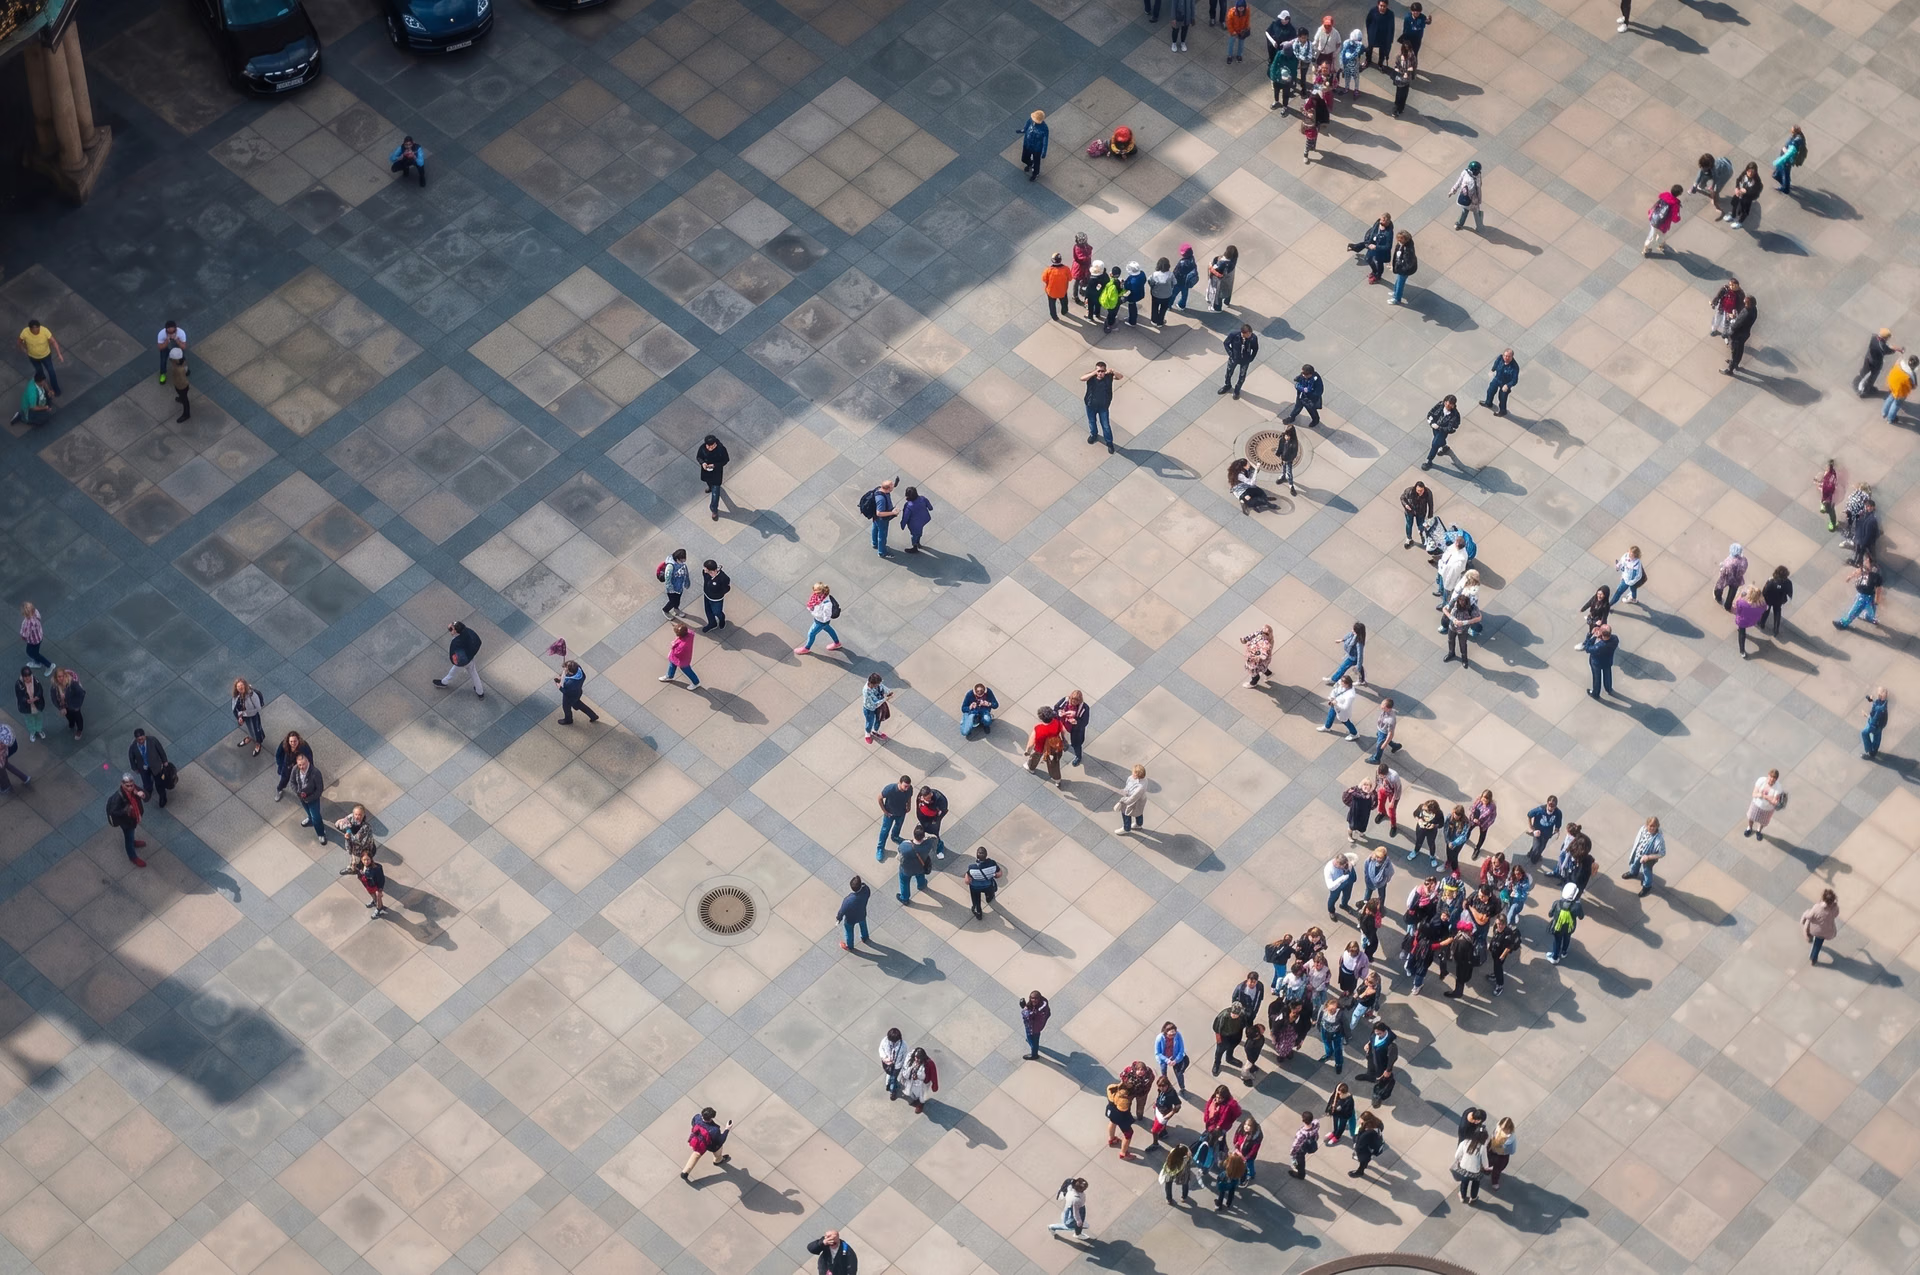
集成视觉 AI 的无人机可以在离地数百米的高空飞行,同时仍需检测视频画面中小到只有几个像素的人。实际上,这在机器人、监控和遥感等应用中很常见,因为这些系统必须识别图像中非常小的物体。
但传统的目标检测模型可能难以做到这一点。图像和视频中的小物体所包含的视觉信息非常有限。简单来说,模型观察这些物体时,几乎没有多少细节可供学习或识别。
在底层,这些模型通常依赖基于卷积神经网络(CNN)的架构。图像经过网络的各层处理后,会转换为特征图或简化表示,以突出相关模式,而不是保留原始像素。
随着图像在网络中逐层深入,特征图会变得越来越小。这能加快计算速度,但也意味着细节可能会消失。
对于极小的物体,这些细节至关重要。一旦细节消失,计算机视觉模型就可能难以检测到物体,从而导致边界框不够准确或不一致。
实时端到端计算机视觉系统让这一问题更加棘手。高分辨率图像有助于保留细节,但会拖慢推理速度并需要更多 GPU 算力。较低的分辨率运行更快,但小物体会变得更难检测。
这需要在速度、准确率和硬件限制之间不断权衡。得益于近期的技术进步,计算机视觉模型(例如 Ultralytics YOLO11 和后来发布的 Ultralytics YOLO26)旨在更有效地处理这种权衡。
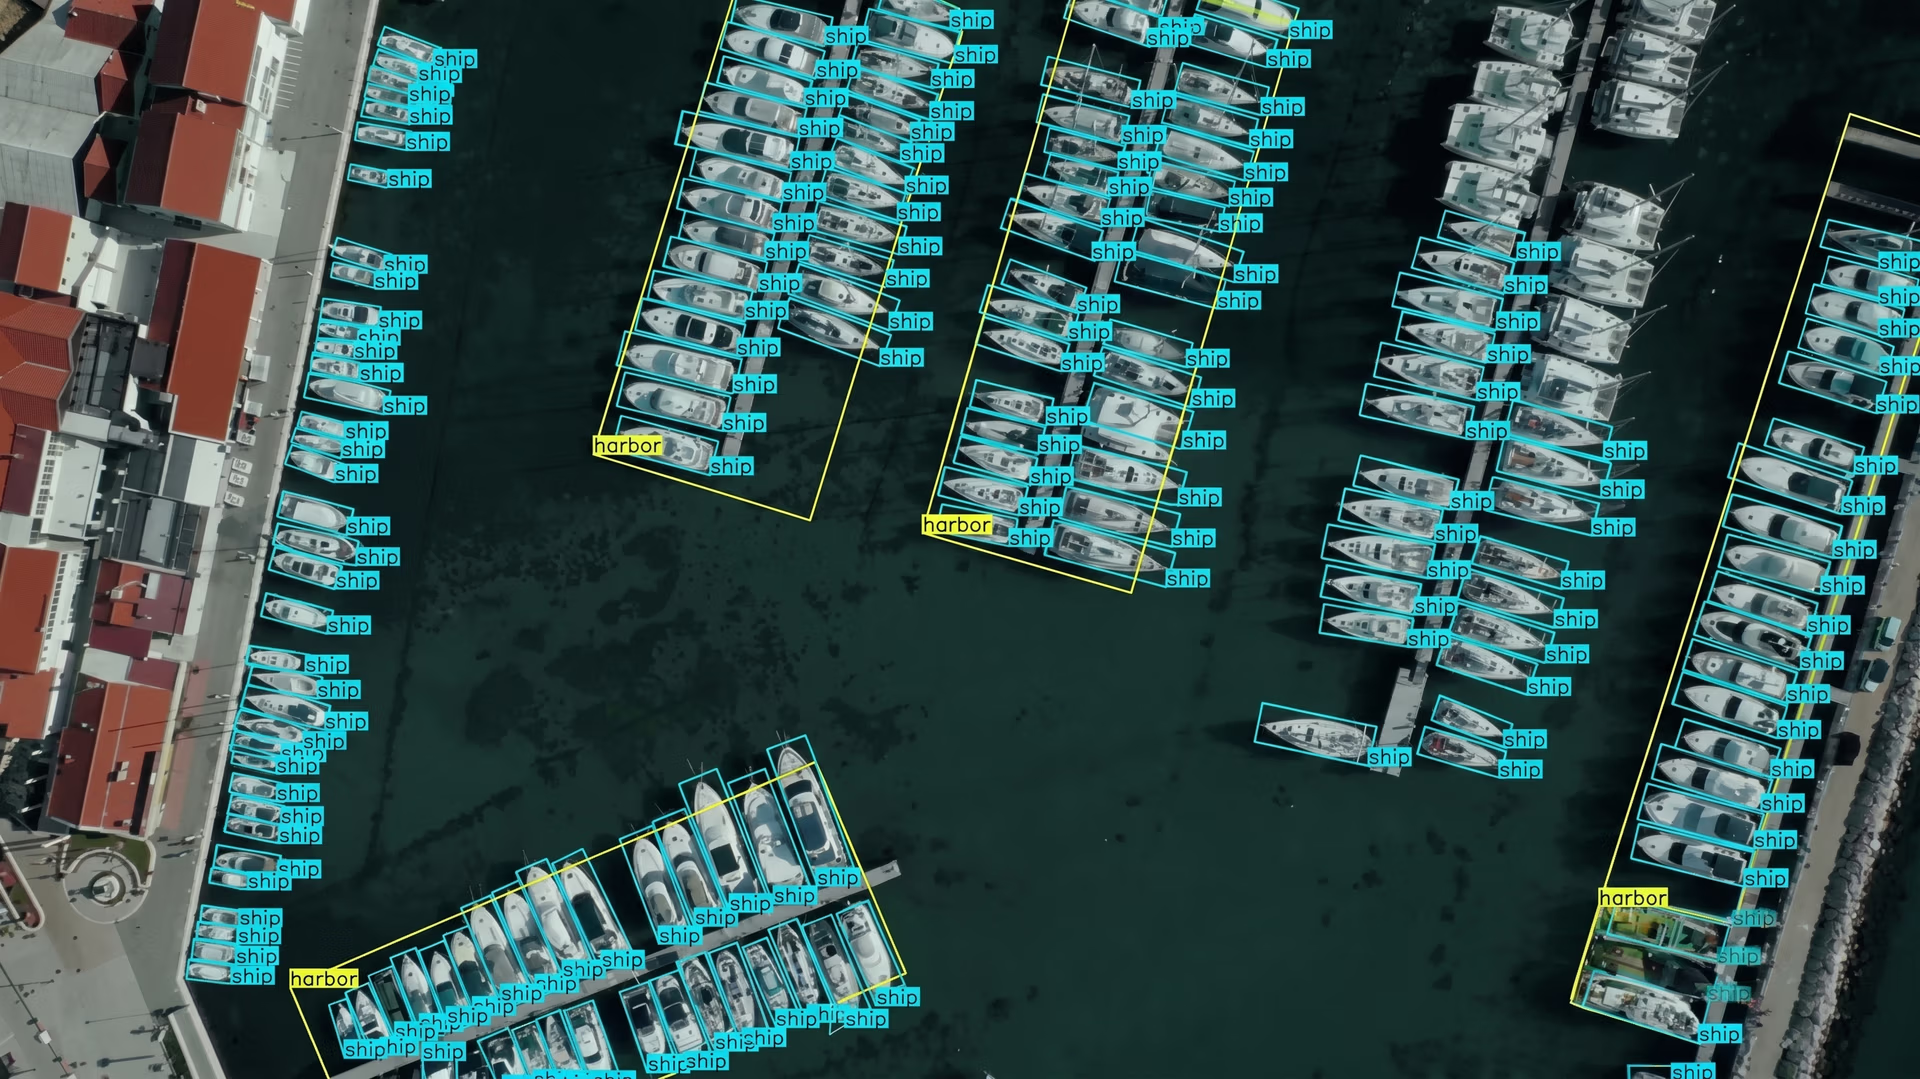
图 1. 使用 YOLO11 检测航拍图像中的小物体(来源)
本文将探讨小目标检测为何困难,以及 Ultralytics YOLO11 如何让检测变得更容易。
什么是小物体检测?它为什么重要?#
小物体检测是计算机视觉(一种 AI 分支)中的一项任务,专注于识别和定位图像中占比非常小的物体。这些物体在图像中通常只由少量像素表示,而像素是数字图像的最小单位。因此,与更大、更清晰的目标(通常包含更多像素)相比,它们更难检测。
例如,航拍图像中的车辆、工厂车间里的工具,或广角监控摄像头拍摄到的人,都可能在图像中显得很小。检测这些物体十分重要,因为它们往往包含关键信息,而且监控等许多现实应用都依赖检测结果才能正常运行。
漏检小物体会影响系统性能和决策。无人机(UAV)监控就是一个典型例子:漏掉地面上一个正在移动的小物体,可能会影响导航或追踪的准确度。
小物体检测面临的挑战#
早期系统使用手工设计的特征和传统计算机视觉方法,在复杂或多变的场景中表现不佳。即使如今深度学习模型的表现已好得多,当目标只占图像中极小一部分时,检测仍然很困难。
接下来,我们来看看在不同现实场景中检测小物体时常见的一些挑战。
尺寸、像素与信息丢失#
小物体包含的像素很少,这限制了模型在特征提取等阶段能够学习到的视觉细节。因此,边缘、形状和纹理等模式更难检测,小物体也更容易与背景融为一体。
图像在神经网络的卷积层中传递时,像素中的视觉信息会逐渐压缩为特征图。这有助于模型保持高效,但也意味着细节会逐渐淡化。
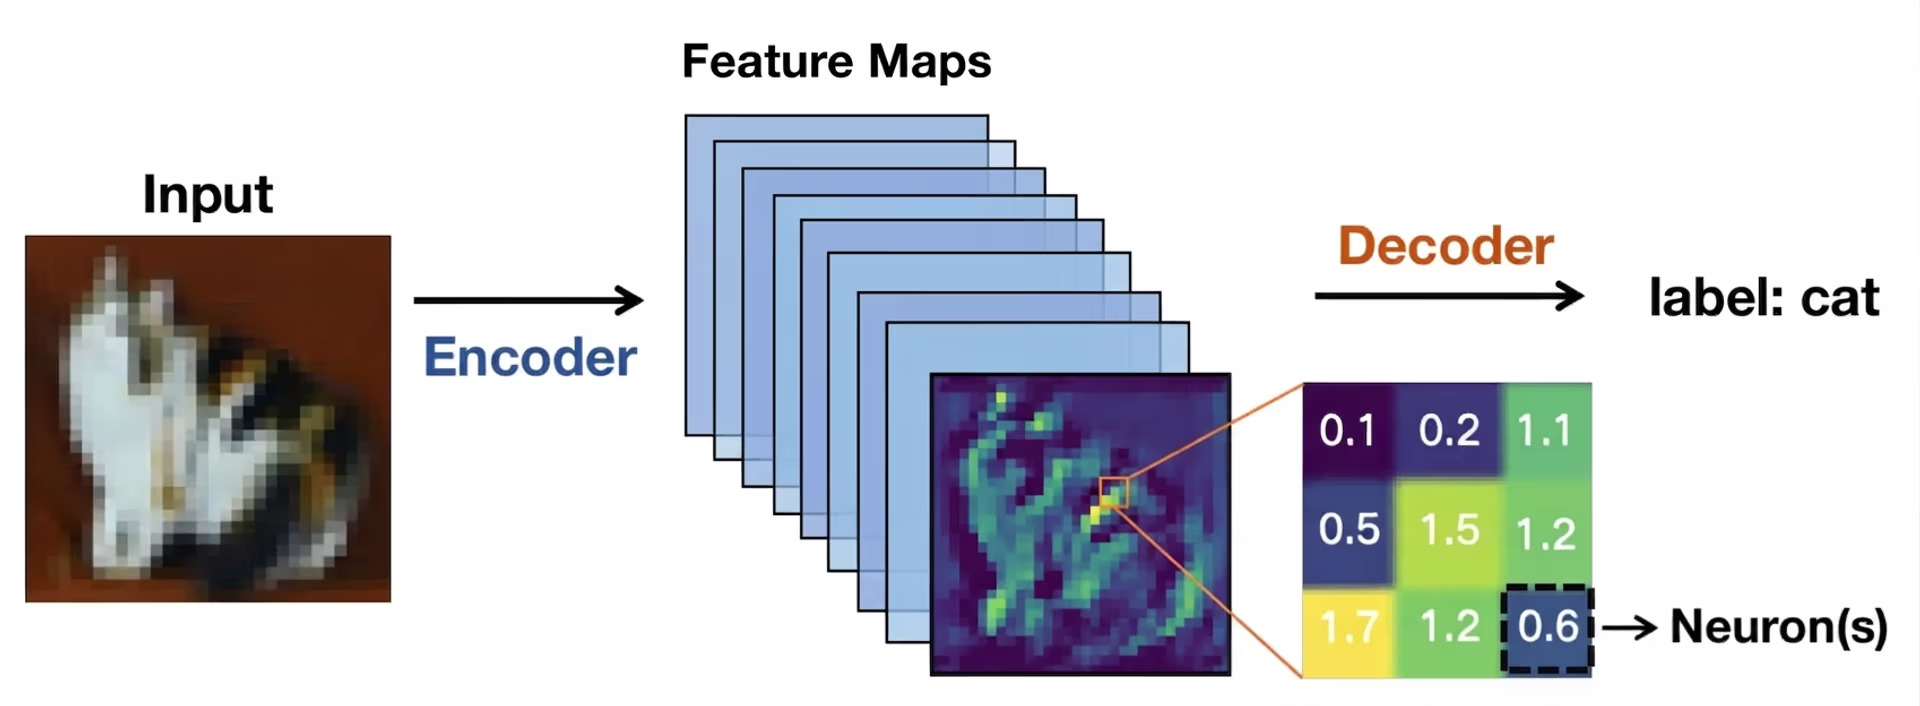
图 2. 特征图表示图像中的视觉模式(来源)
对于小目标,重要线索可能会在检测网络有机会处理它们之前就消失。发生这种情况时,定位会变得不可靠,边界框可能偏移、重叠,或完全漏掉目标物体。
遮挡、尺度变化与上下文#
尺寸相关的挑战也常常与遮挡有关。当场景中的其他物体部分挡住某个物体(尤其是较小的物体)时,就会发生遮挡。
这会缩小目标的可见区域,从而限制目标检测器可用的信息。即使是轻微遮挡,也可能让检测网络混淆,尤其是在输入分辨率较低时。VisDrone等 UAV 数据集就有一个典型例子:行人、自行车或车辆可能会被建筑物、树木或其他移动物体部分挡住。
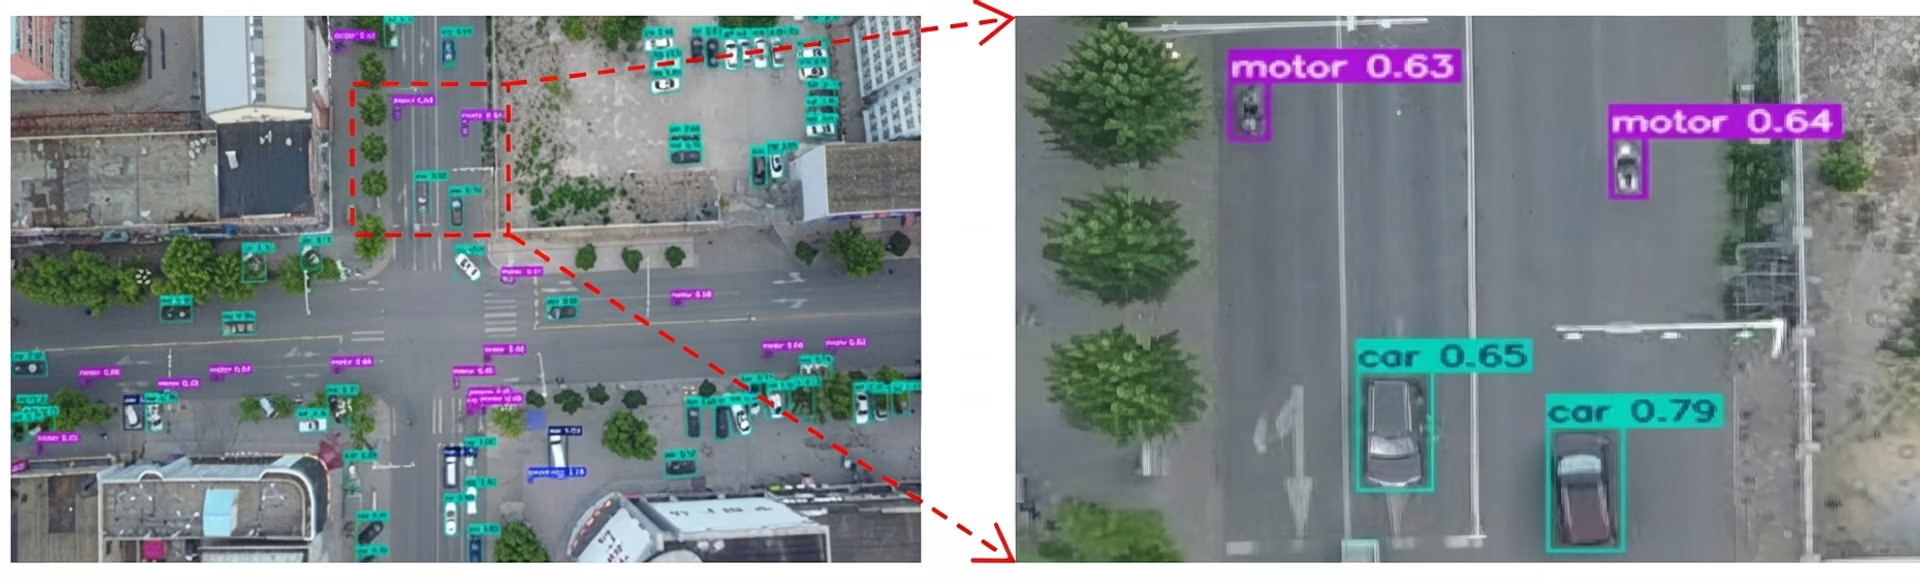
图 3. VisDrone 数据集中的小物体示例(来源)
类似地,同一物体会因距离和相机位置不同而显得很小或相对较大,这种尺度变化又增添了一层难度。尽管存在这些困难,检测算法仍必须在不同尺度下识别这些小物体,同时不损失准确度。
上下文在检测中也发挥着重要作用。例如,大型物体周围通常有清晰的环境,可以提供有用的视觉线索。相比之下,小目标往往缺少这类上下文信息,因此更难识别其模式。
小物体检测中隐藏的度量问题#
常见的评估指标,例如交并比(IoU),用于衡量预测边界框与真实标注框的重叠程度。IoU 对较大的物体效果不错,但对小物体的表现截然不同。
小物体只占几个像素,因此预测框的轻微偏移就可能造成很大的相对误差,并大幅降低 IoU 分数。这意味着,即使图像中能看到小物体,它们也经常无法达到将预测计为正确所需的标准 IoU 阈值。
因此,定位误差更容易被归类为假阳性或假阴性。这些局限促使研究人员重新思考目标检测系统应如何评估和处理难以检测的小目标。
多尺度特征:实时小物体检测的关键#
研究人员在改进小目标检测的过程中逐渐发现,保留并表示多个尺度上的视觉信息至关重要。近期的 arXiv 研究以及在 IEEE 国际会议和欧洲计算机视觉会议(ECCV)等会议上发表的论文也印证了这一观点。
图像在神经网络中逐层深入时,小物体可能会失去细节,甚至完全消失。因此,Ultralytics YOLO11 等现代计算机视觉模型非常重视改进特征提取。接下来,我们将介绍特征图和特征金字塔网络的核心概念,帮助你更好地理解它们。
特征图与尺度表示#
输入图像(例如遥感图像)进入神经网络后,会逐渐转换为特征图。特征图是图像的简化表示,可突出边缘、形状和纹理等视觉模式。
随着网络逐层深入,特征图的空间尺寸会变小。这种缩减有助于模型高效运行,并专注于高层信息。不过,特征图缩小并加深也会减少空间细节。
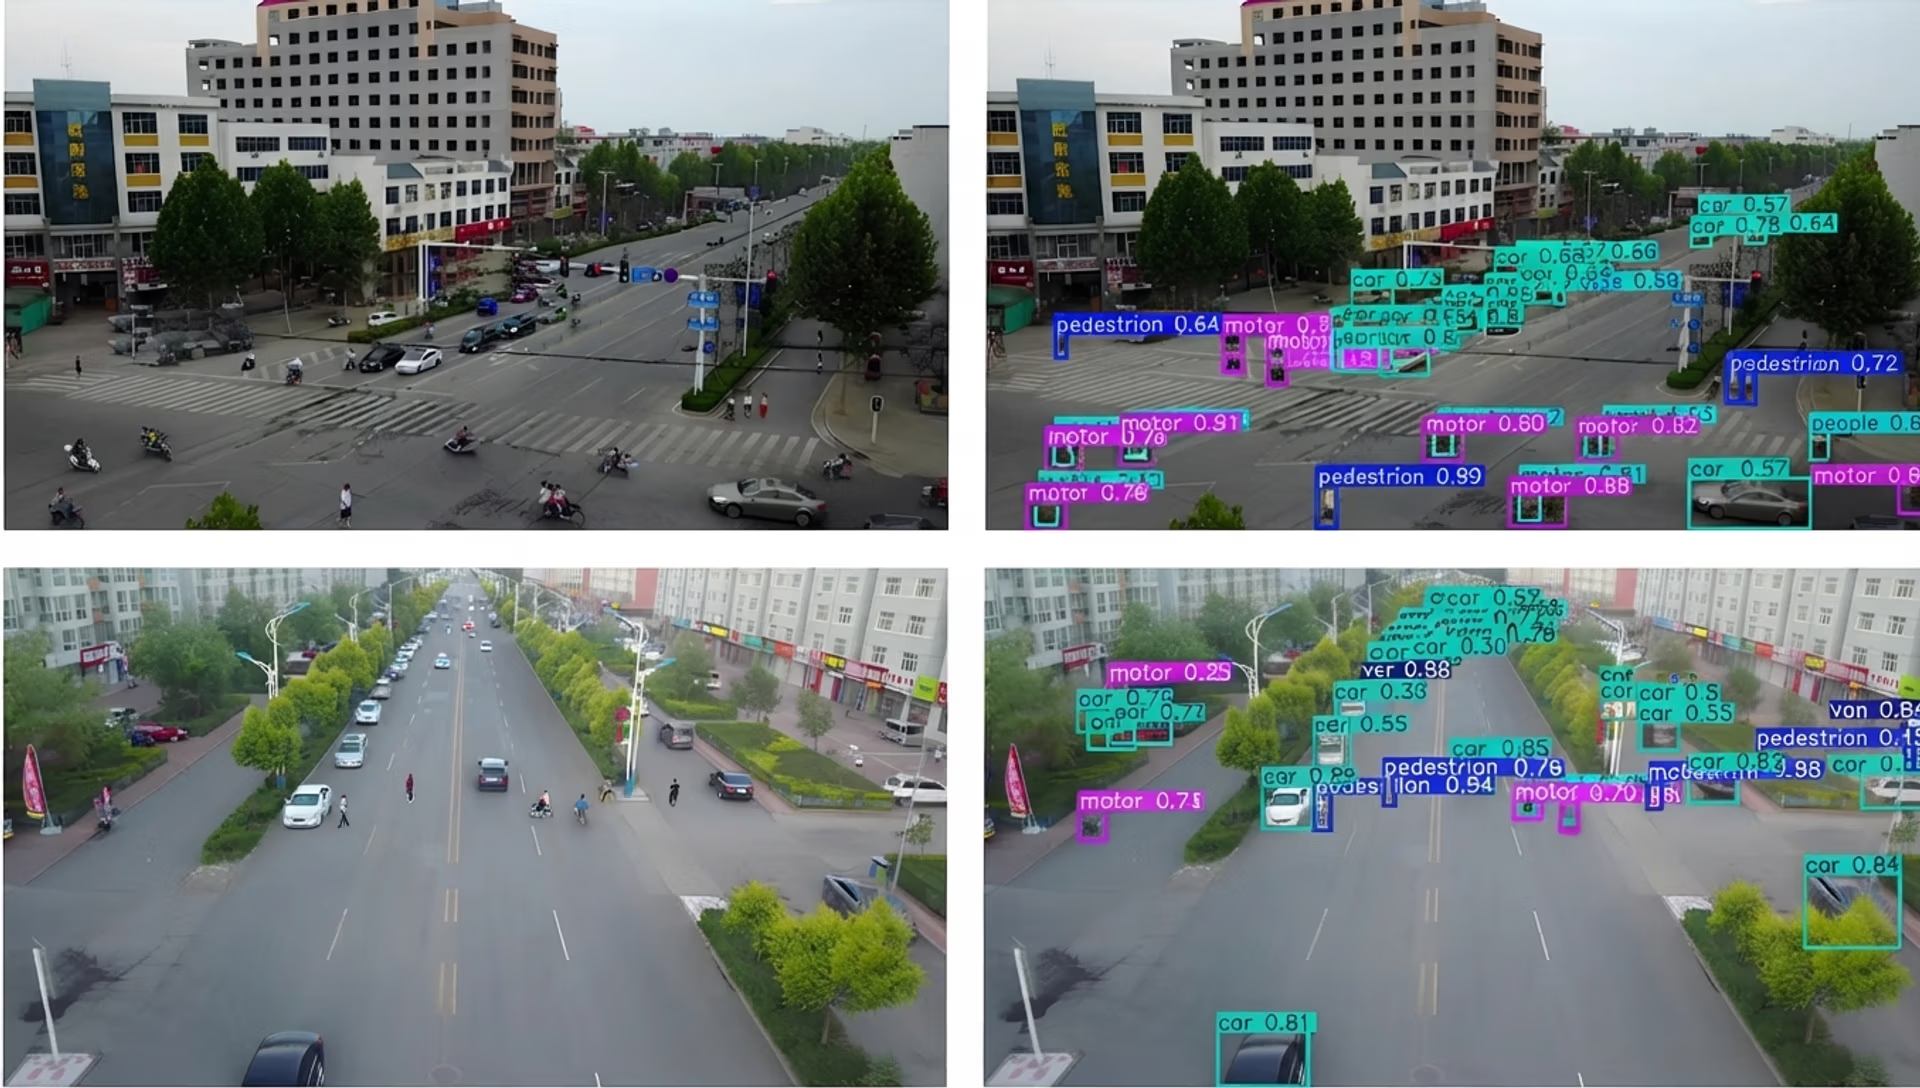
图 4. 特征提取是小物体检测的关键。(来源)
大型物体保留了足够的视觉信息,可供准确检测;而小目标只需经过几层网络,就可能丢失关键细节。发生这种情况时,模型可能难以识别小物体是否存在。这是深度目标检测模型漏掉小物体的主要原因之一。
特征金字塔网络与多尺度学习#
特征金字塔网络通常简称 FPN,旨在解决空间细节丢失问题。它作为辅助模块,整合多个层的信息,让模型更有效地检测小物体。这个过程也称为特征聚合和特征融合。
浅层提供精细的空间细节,深层则补充语义上下文,从而实现有效的多尺度特征学习。与只会放大特征图的朴素上采样不同,FPN 能保留有意义的信息并改进小物体检测。
现代方法在这一思路上进一步发展,采用自适应特征融合和上下文感知设计,进一步提升小目标检测效果。换句话说,FPN 帮助模型同时看清全局和微小细节。在物体尺寸较小时,这种优化至关重要。
目标检测模型如何演进以处理小物体#
以下简要介绍目标检测模型如何逐步演进和发展,从而更好地检测不同尺寸的物体,包括非常小的物体:
- 早期检测方法:早期目标检测方法依赖人工设计的特征和基于规则的算法,根植于经典图像处理。由于这些特征是固定的,面对不同图像时,性能会下降。
- 机器学习和深度学习的引入:机器学习和深度学习的采用,标志着目标检测研究的一次重大转变。神经网络不再依赖预设规则,而是直接从训练数据中学习视觉表示,从而提升了在不同物体尺寸和场景下的适应能力。
- 卷积网络:这类神经网络能够学习识别图像中的模式。每一层都会捕捉不同细节,从简单的边缘和颜色开始,再到形状,最终识别完整物体,因此它们对现代计算机视觉至关重要。
- 两阶段目标检测器: Faster R-CNN 等两阶段检测器由 Ren 等人提出,先生成候选区域,再对其进行分类。这种方法提高了小目标检测的准确性,但增加了计算成本并降低了实时性能。
- 单阶段目标检测器:SSD(单次检测器)和 YOLO(只看一次)系列等单阶段检测器,包括 YOLOv3、Ultralytics YOLOv5以及后来的 Ultralytics YOLOv8,只需一次处理即可完成检测。这种设计显著提升了推理速度,同时保持了有竞争力的准确度。
- 最新的先进模型:较新的目标检测模型更加注重实时性能和边缘部署。近期发布的 Ultralytics YOLO 模型(如 Ultralytics YOLO11 和 Ultralytics YOLO26)旨在兼顾高准确率和低延迟推理,因此非常适合在计算能力有限的设备上检测各种尺寸的物体,包括小目标。
使用 Ultralytics YOLO11 检测小物体的应用场景#
现在我们已经更好地了解了小物体检测的工作原理,接下来看看 Ultralytics YOLO11 可以应用于哪些现实场景。
无人机与航空成像#
想象一架无人机飞在繁忙的城市街道上空。从这个高度看,汽车、自行车甚至行人,在屏幕上都只有几个像素大小。
无人机与航空成像模块经常会拍摄这类场景,其中的目标物体很小,周围背景又杂乱,因此计算机视觉模型很难检测到它们。
在这类场景中,Ultralytics YOLO11 是理想的模型选择。例如,搭载 YOLO11 并使用 VisDrone 等航空数据集进行微调的无人机,可以实时监控交通,检测场景中移动的车辆、骑行者和行人,即使每个目标在图像中只占很小一部分也能做到。这有助于在交通管理、公共安全或城市规划等应用中更快地做出决策,并获得更准确的洞察。
机器人与自动化#
机器人通常用于对准确度和时效性要求极高的环境。在仓库、工厂和农场等场所,机器人可能需要识别非常小的物体,例如装配线上的零件、包裹上的标签,或田间刚冒出的幼苗,并迅速做出响应。
检测这类尺寸的物体可能很复杂,尤其是当它们在相机画面中只有几个像素大小,或被其他物体部分遮挡时。漏掉这些细节会拖慢自动化流程,或影响机器人完成任务的能力。
Ultralytics YOLO11 能在这类场景中发挥作用。它改进的特征提取能力和快速推理速度,让机器人能够实时检测小物体并立即采取行动。
Ultralytics YOLO11 还支持实例分割,这能帮助机器人更准确地理解物体边界和抓取点,而不只是定位大致的边界框。例如,集成 YOLO11 的机械臂可以发现传送带上的小型零件,分割出零件的精确形状,并在零件移动到抓取范围之外之前将其拾起,从而帮助系统保持高效可靠。
是什么让 Ultralytics YOLO11 擅长检测小物体#
如今有这么多计算机视觉模型可供选择,你可能会想知道 Ultralytics YOLO11 有什么突出之处。
以下是 Ultralytics YOLO11 适合用于检测小物体的应用场景的几个原因:
- 更出色的特征提取:YOLO11 采用改进的主干网络和颈部网络架构来增强特征提取,从而实现更精准的目标检测。
- 生态系统完善,易于使用:Ultralytics Python 软件包是一个库,提供了用于加载、训练、验证和部署 YOLO11 等模型的内置函数。这些工作流程只需几行代码,因此团队可以快速试验并微调小物体检测模型。
- 针对边缘部署进行了优化:Ultralytics YOLO11 可以在 NVIDIA Jetson、Raspberry Pi 和工业相机系统等边缘设备上高效运行。简单来说,它能够直接在设备上执行实时视觉 AI 任务。
使用 Ultralytics YOLO11 检测小物体的实用策略#
除了使用 Ultralytics YOLO11 之类的模型之外,标注的准备方式、整体数据集和模型训练流程也会对检测性能产生显著影响。Ultralytics 的 tile 参数也有助于检测大图像中的极小目标:高分辨率切片会以原生分辨率在重叠窗口上进行训练、验证和推理。
以下简要介绍你需要重点关注的内容:
- 适当的数据增强:缩放或裁剪等轻度数据增强有助于模型适应新图像。不过,大幅度增强可能会扭曲或移除小物体,让模型更难学习。
- 分析失败案例:分析模型漏检或误识别物体的情况,有助于建立基准,并找出问题是源于数据集、特征提取过程中的信息丢失,还是需要调整训练设置。
- 数据集构成:你的数据集应包含足够多的小物体样本,让模型能够学习有意义的模式;同时还应保持平衡,避免较大的物体在训练时掩盖较小的物体。
要点#
小物体检测很困难,因为图像在计算机视觉模型中传递时,小目标会逐渐失去细节。Ultralytics YOLO11 改进了细节保留能力,让小物体检测更加可靠,同时不牺牲实时性能。这种平衡让 YOLO11 能够在现实应用中实现准确、高效的检测。
加入我们不断壮大的社区!访问我们的 GitHub 仓库,了解更多 AI 相关内容。浏览我们的解决方案页面,探索零售领域的计算机视觉和汽车行业的 AI等创新应用。要立即开始构建计算机视觉应用,请查看我们的许可选项。
作者
评论
提出问题、分享你的结果,或帮助其他人。









