Ultralytics YOLO26 更快、优先面向边缘设备的设计所带来的影响
了解 Ultralytics YOLO26 如何在边缘设备上实现更快的运行速度,以及这对要求低延迟和高效率的新一代计算机视觉应用为何至关重要。
 Abirami Vina8 分钟阅读
本周早些时候,Ultralytics 正式推出了 Ultralytics YOLO26,这是一款更快、更轻、更小的 YOLO 模型,旨在提升计算机视觉系统在边缘端的运行表现。YOLO26 支持与以往 YOLO 模型相同的核心视觉任务,包括目标检测和实例分割。
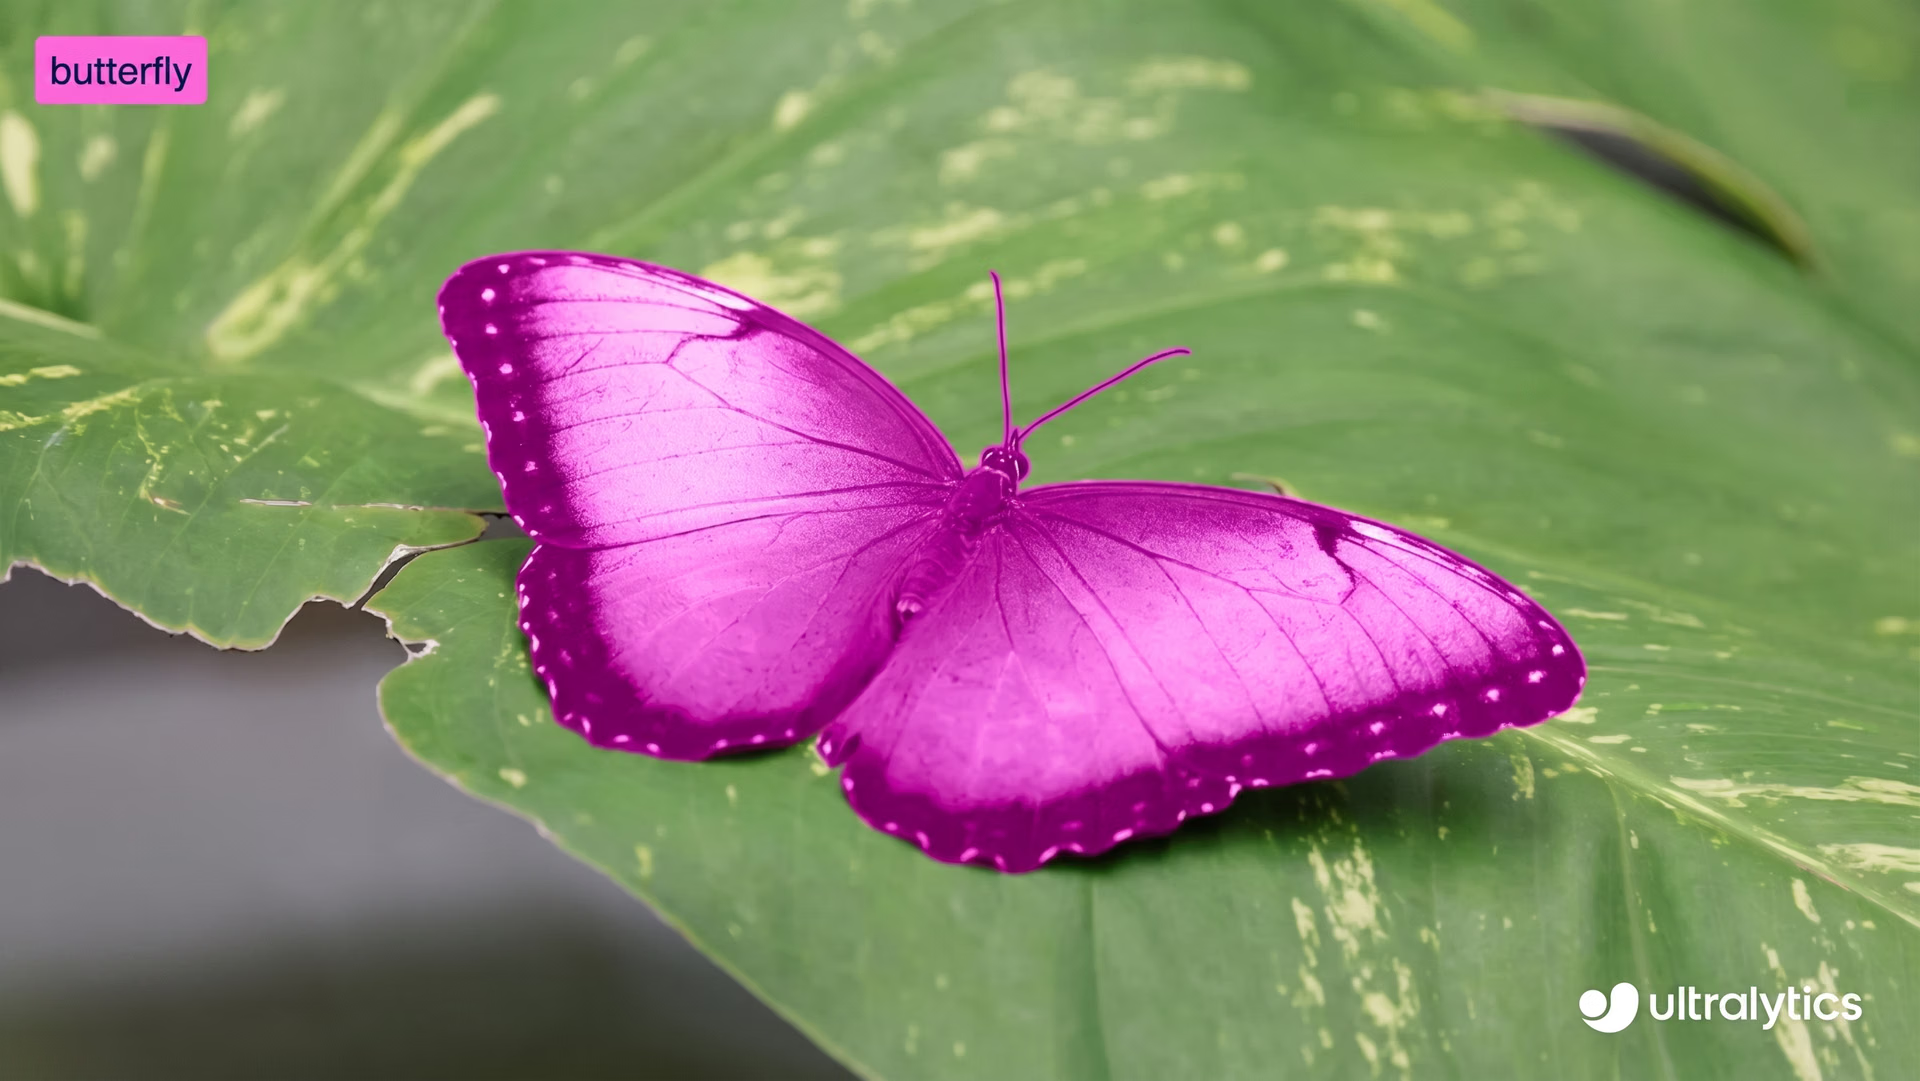
图 1. 使用 Ultralytics YOLO26 分割物体的示例。
Ultralytics YOLO26 与以往模型最显著的区别,在于它的设计目标是适应不同的运行环境。YOLO26 并非主要针对云端图形处理器(GPUs)或以基准测试为导向的性能进行优化,而是从一开始就为在边缘设备和嵌入式硬件上的真实场景部署而设计。
随着计算机视觉从研究走向生产,性能限制的现实正变得日益清晰。边缘环境受到严格的延迟预算、有限的内存、电量和散热条件,以及在各种平台上保持行为可预测等要求的制约。
在这些环境中,系统整体性能不仅取决于原始推理速度,还取决于整个流水线的运行效率。后处理开销、内存压力和特定平台的执行路径往往会成为瓶颈。
Ultralytics YOLO26 采用更快的边缘优先方案来应对这些挑战,它关注的是整个推理流水线,而非单一模型指标。通过专注于边缘优化、简化推理流水线并去除不必要的后处理步骤,YOLO26 提升了速度,从而降低延迟,并让生产环境中的表现更加可靠。
本文将探讨 Ultralytics YOLO26 的架构选择如何转化为实际性能提升,以及边缘端速度的提升为何会从根本上改变下一代计算机视觉应用的可能性。
边缘部署的现实情况#
在边缘端运行计算机视觉模型,与在云端运行这些模型截然不同。云环境中,系统通常可以使用强大的 GPU、大量内存和稳定的硬件。而在边缘端,这些假设并不成立。
大多数边缘部署使用的是多种不同的硬件架构,而非 GPU。设备通常会使用多个专用处理器来执行不同任务,这些处理器针对效率和低功耗进行了优化,而非追求云端 GPU 的原始计算能力。
延迟是另一项主要限制。边缘系统通常需要满足严格的实时限制,即使很小的延迟也可能影响响应速度或安全性。在这种情况下,端到端延迟比原始推理速度更重要。模型纸面上的速度可能很快,但加入后处理和数据传输后,实际表现仍可能不尽如人意。
内存也发挥着重要作用。许多边缘设备的内存和共享缓存有限。大型中间张量和低效的内存使用会拖慢系统,即使模型本身效率很高也不例外。
功耗和散热限制带来了更多约束。边缘设备通常没有主动冷却系统,并且功耗预算固定。性能不仅要快,还需要高效且可持续,不能只在短时间内突发提速。
除此之外,边缘部署还要求保持一致性。模型在不同设备和运行时中都必须表现一致。特定平台的代码或复杂的后处理步骤可能会带来细微差异,使系统更难部署和维护。
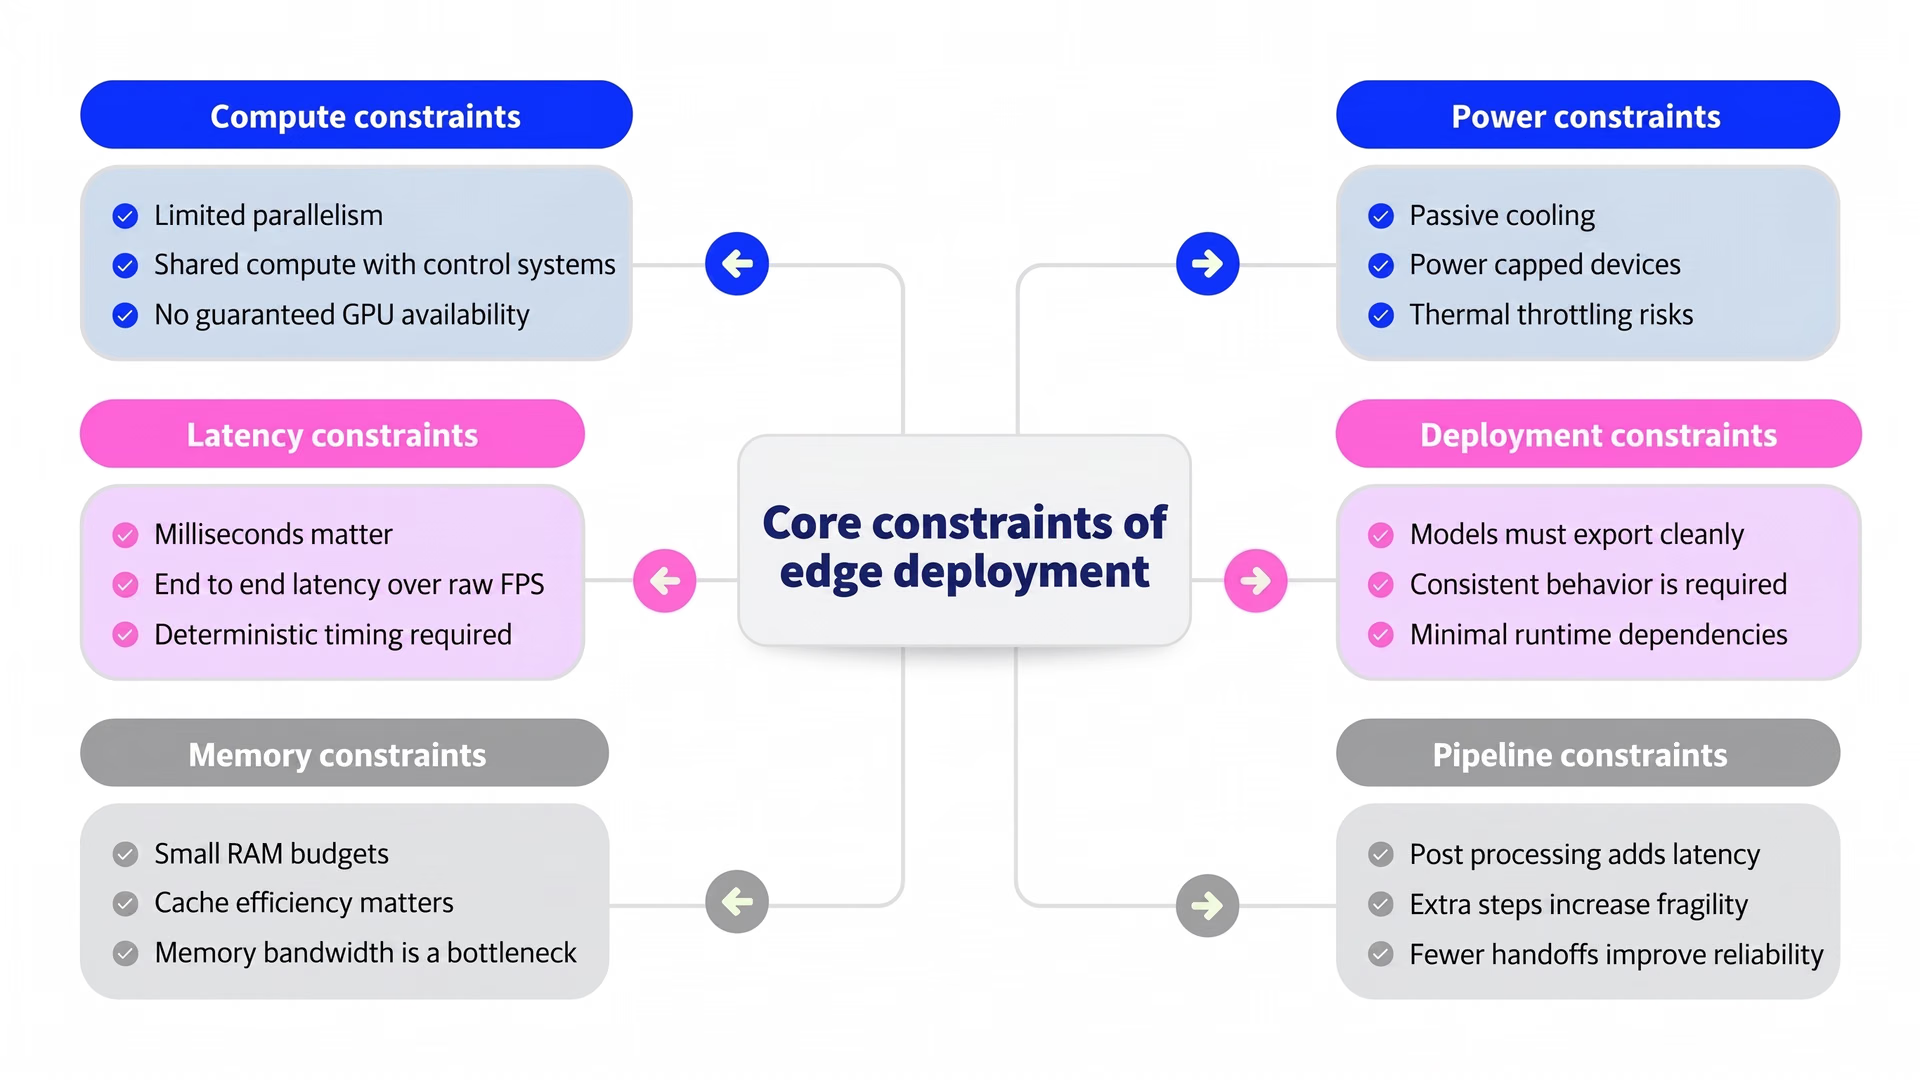
图 2. 边缘部署面临的限制一览。图片由作者提供。
这些限制决定了边缘端的性能究竟意味着什么。换句话说,性能由整个流水线决定,而不是由单一指标决定。
为什么边缘视觉需要不同的性能模型#
那么,边缘部署的限制与面向边缘构建的计算机视觉模型的要求有何关系?当模型从研究环境转移到实际系统中时,二者之间的联系就会变得清晰。
在云环境中,性能通常通过推理速度和准确率等基准指标来衡量。在边缘端,这些指标只能说明部分情况。视觉系统通常运行于异构硬件之上,神经网络推理会交由专用加速器执行,而流水线的其他部分则由通用处理器运行。
在这种情况下,模型速度还不够。模型部署后整个系统的表现才是关键。模型单独运行时看起来可能很快,但如果后处理、数据传输或特定平台的步骤增加了开销,最终表现仍可能不尽如人意。
因此,边缘视觉需要一种侧重系统级效率,而非孤立基准测试的性能模型。Ultralytics YOLO26 顺应了这一转变,专注于边缘优先优化、精简推理,以及为实际部署打造的端到端执行。
速度的基础:边缘优先设计#
在边缘端,性能取决于模型与设备实际硬件架构的匹配程度。优先面向边缘进行设计,可确保视觉系统在各种实际平台上可靠运行,不受可用处理单元具体组合的影响。
边缘优先方案重视在异构硬件上的可预测、高效执行,而不是事后调整原本针对云端 GPU 优化的模型。简单来说,这意味着优先采用易于映射到神经网络加速器的操作,尽量减少模型外的非神经网络计算,并降低可能拖慢端到端执行的不必要复杂度。
Ultralytics YOLO26 的设计考虑了这些限制。其架构追求稳定一致的性能,而非理想条件下的峰值吞吐量。通过简化执行路径并消除不必要的计算,YOLO26 降低了整个推理流水线的开销,并更充分地利用设备现有的加速能力和内存层级。
这种方法也提高了可靠性。边缘优先优化带来了更可预测的运行时间和更少的性能波动,这对实时系统至关重要。Ultralytics YOLO26 不依赖专用硬件或繁重的后处理来提升速度,而是注重提高整个推理流水线的效率。
端到端推理与后处理的成本#
你可能想知道,消除不必要的后处理步骤意味着什么。要理解这一点,我们先退一步,看看传统目标检测系统的工作方式。
在许多目标检测流水线中,模型生成预测并不意味着推理结束。相反,模型会输出大量相互重叠的边界框,在使用前还需要对其进行筛选和细化。这些清理工作会通过模型外运行的后处理步骤完成。
最常见的后处理步骤之一是非极大值抑制,即 NMS。NMS 会比较相互重叠的边界框,只保留置信度最高的检测结果,并移除指向同一物体的重复结果。这种方法虽然有效,但会在推理完成后增加额外计算。
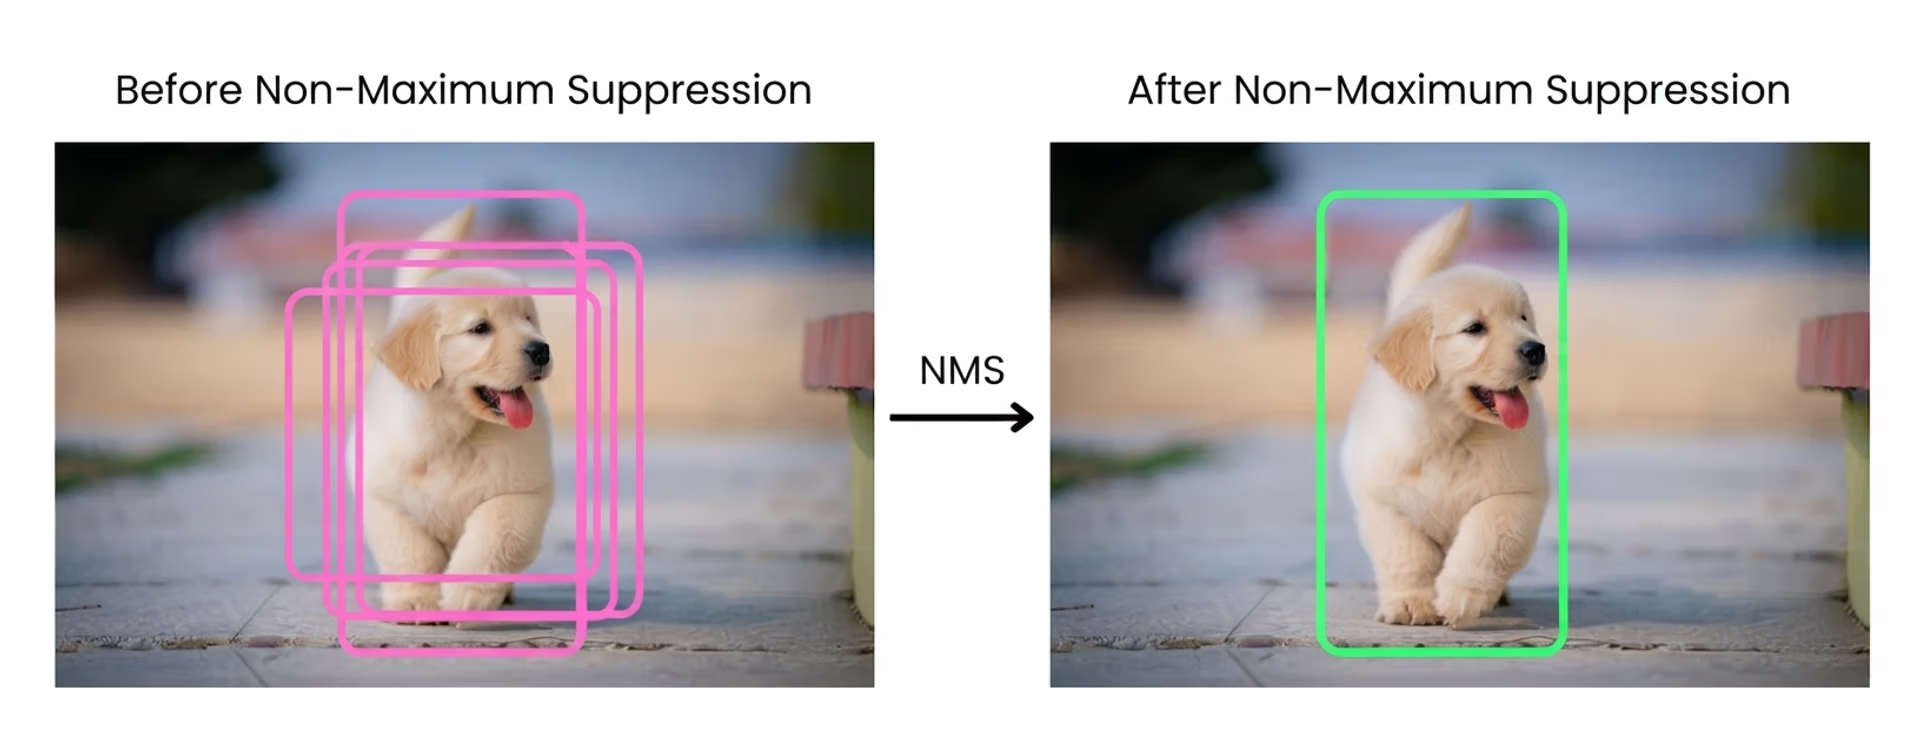
图 3. 了解 NMS。图片由作者提供。
在边缘端,这些额外工作是有代价的。NMS 等后处理步骤并不适合用于神经网络推理专用加速器,因为这类加速器针对密集神经计算进行了优化,而非控制密集型或内存密集型操作。
因此,NMS 会增加延迟和内存开销,而且检测结果数量越多,开销也越大。即使模型本身运行很快,NMS 仍可能占据总运行时间的很大一部分。
后处理还会增加系统复杂度。由于后处理位于模型之外,因此必须针对不同运行时和硬件目标分别实现。这通常会导致特定平台的代码路径、设备间行为不一致,以及更脆弱的部署流水线。
最重要的是,后处理打破了真正端到端性能的理念。模型推理速度的测量结果无法反映系统在生产环境中的实际表现。最终重要的是从输入到最终输出的总耗时,包括流水线中的每个步骤。
在这些情况下,后处理会成为边缘端隐藏的瓶颈。它会增加延迟、占用 CPU 资源并使部署复杂化,同时还在模型之外运行。
Ultralytics YOLO26 如何移除 NMS,以及这样做为何能提速#
YOLO26 移除了 NMS,方法是从重复检测的根源入手,而不是在推理后再进行清理。模型不会输出大量需要筛选的重叠预测,而是经过训练,能够直接生成数量更少、置信度更高的最终检测结果。
改变训练期间的检测学习方式,才使这一点成为可能。Ultralytics YOLO26 鼓励物体与预测之间形成更明确的一对一关系,从源头减少冗余。因此,重复检测会在网络内部得到处理,而不是依赖外部后处理。
移除 NMS 会立即提升边缘端性能。由于 NMS 不易映射到神经网络加速器,移除它可以减少内存传输,并避免开销高昂的非神经网络处理步骤。这会降低端到端延迟,让性能更加可预测,尤其是在后处理可能占用总运行时间显著比例的边缘设备上。
这也简化了推理流水线。模型外的步骤减少后,数据传输和组件间的交接也会随之减少。模型输出就是最终结果,因此执行过程更加可预测。
移除 DFL,实现真正的端到端性能#
Ultralytics YOLO26 的另一项创新是移除了分布焦点损失(DFL),这项损失曾用于早期 YOLO 模型中的边界框回归。采用 DFL 的模型不会直接预测单个坐标,而是学习可能值的分布,再根据该分布推导出最终边界框。这种方法有助于提高定位准确率,是前几代模型的一项重要进步。
不过,随着时间推移,DFL 也带来了权衡。预测分布会增加计算量并提高模型架构的复杂度,这可能拖慢 CPU 上的推理,也会让模型更难导出为不同的部署格式。DFL 还设定了固定的回归范围,这可能会限制检测超大物体时的灵活性。
Ultralytics YOLO26 通过移除 DFL,迈向更简单的端到端设计。边界框回归经过重新设计,过程更加直接,在保持准确率的同时减少了不必要的计算。这一变化与 YOLO26 无需 NMS 的设计理念一致。
CPU 推理速度提升 43% 的原因#
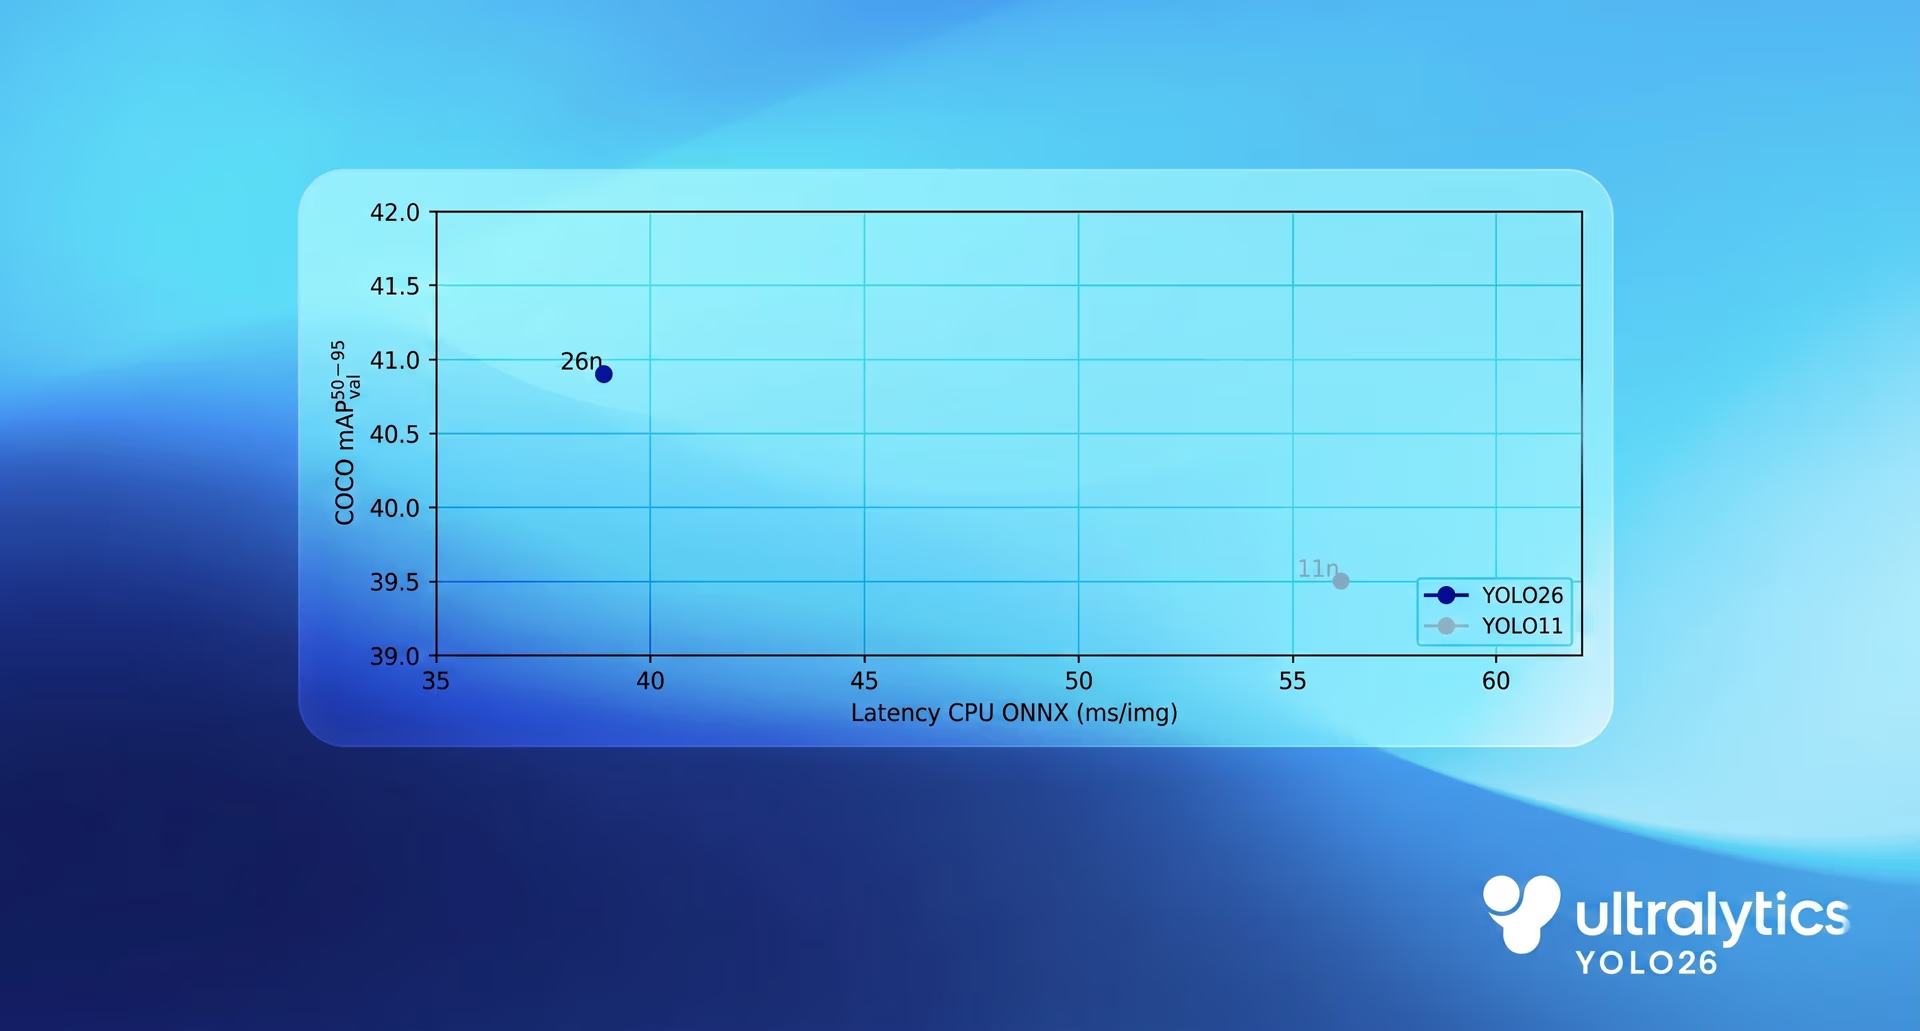
在 CPU 基准测试中,YOLO26 相较于早期 YOLO 模型展现出明显的性能提升。与 Ultralytics YOLO11 相比,YOLO26 nano 模型的 CPU 推理速度最高提升 43%,这对实际边缘部署有显著影响。
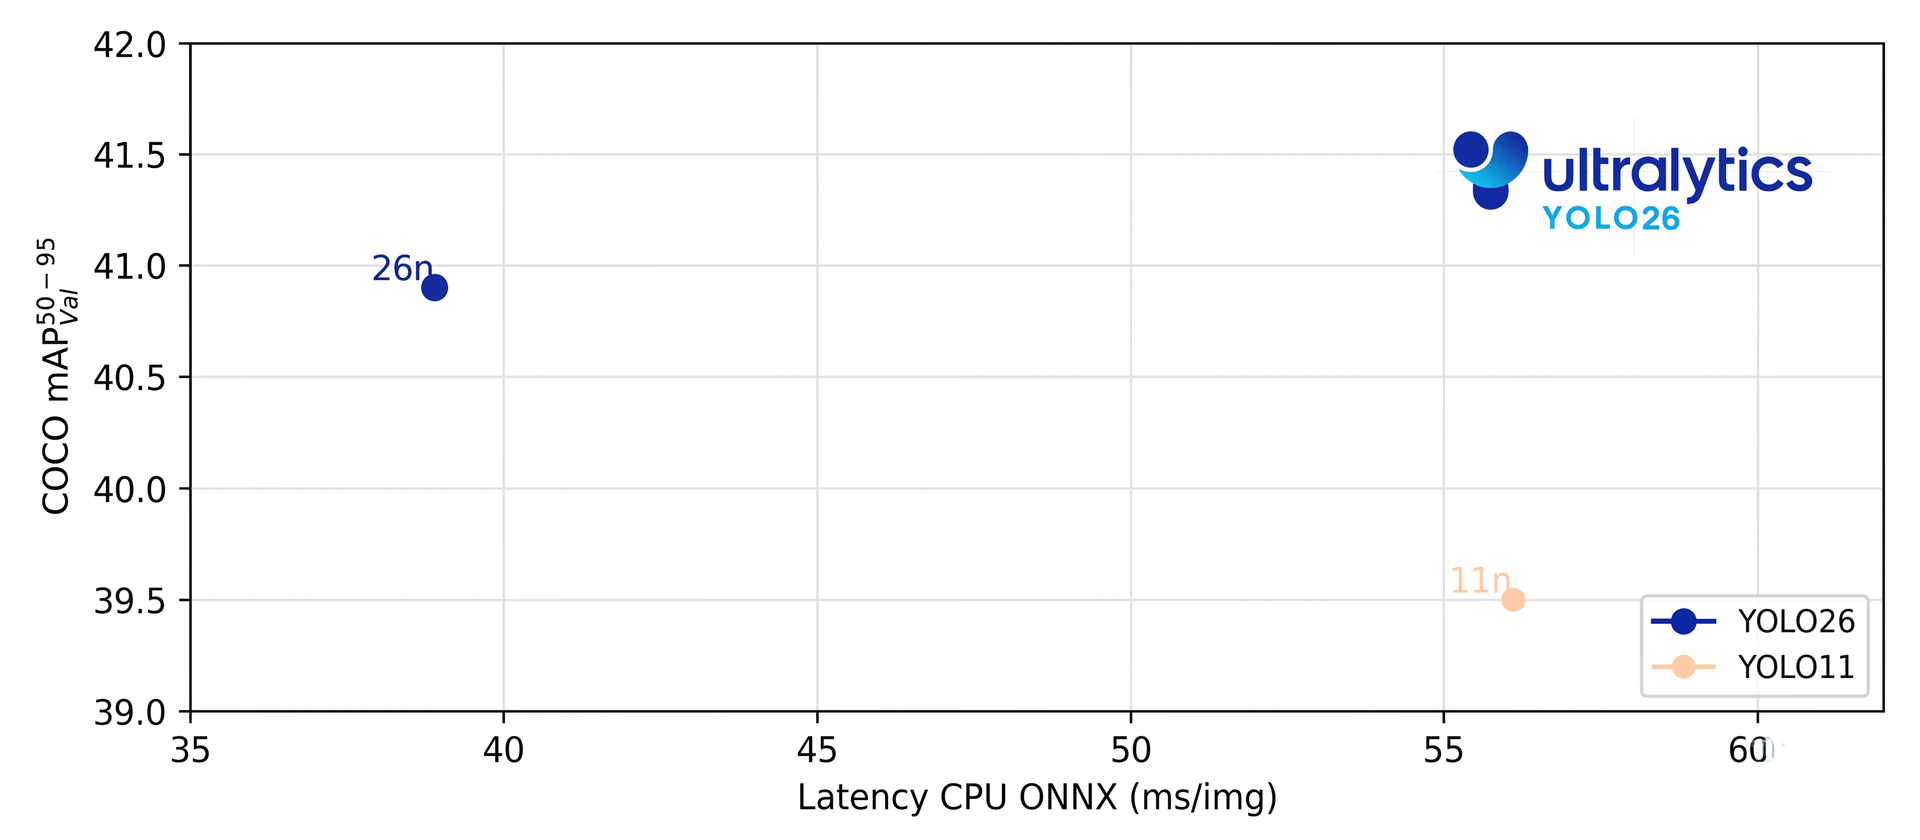
图 4. Ultralytics YOLO26 CPU 速度基准测试。
这项提升来自对整个推理流水线的简化,而非对单个组件进行优化。端到端执行消除了后处理开销,更直接的边界框回归方法减少了计算量,而以 CPU 为先的设计选择提高了通用处理器上的执行效率。
这些变化共同降低了延迟和 CPU 负载,并让实际边缘硬件上的性能更快、更稳定。
Ultralytics YOLO26 对边缘部署和模型导出的影响#
Ultralytics YOLO26 的性能提升不止于更快的推理速度。通过简化模型并降低内存开销,它变得更易部署,也能在各种边缘环境中更可靠地运行。
Ultralytics YOLO26 的端到端设计也简化了导出。辅助组件更少且无需外部后处理步骤,导出的模型完全自包含。这减少了对特定平台的依赖,并有助于确保模型在不同运行时和硬件目标上的行为一致。
实际上,这意味着你可以通过多种导出格式,更轻松地将 Ultralytics YOLO26 部署到边缘设备,例如摄像头、机器人和嵌入式系统。导出什么,就运行什么;集成步骤更少,部署偏差的风险也更低。
更快的边缘推理助力机器人和工业视觉 AI#
到目前为止,我们已经介绍了 Ultralytics YOLO26 的边缘优先设计如何提升系统级性能。不过,它的真正影响在于让视觉 AI 更容易集成到实际应用中。
例如,在机器人和工业环境中,视觉系统通常需要满足严格的实时要求。系统必须在计算资源有限且不依赖云连接的情况下,快速而稳定地做出决策。借助 Ultralytics YOLO26,这些要求变得切实可行。
机器人导航和物体操作等应用受益于更低的延迟和更可预测的推理,使机器人能够平稳地响应环境变化。同样,在工业场景中,视觉模型可以直接在生产线上运行,以检测缺陷、跟踪组件和监控流程,而不会引入延迟或增加复杂性。
通过在边缘硬件上实现快速、可靠的推理,Ultralytics YOLO26 让视觉 AI 自然融入机器人和工业系统,而不再是难以部署和维护的挑战。
要点#
Ultralytics YOLO26 专为边缘场景打造,在这里,延迟、内存和可靠性等现实限制决定了系统能力的边界。通过围绕 CPU 优先执行、端到端推理和简化部署来设计模型,YOLO26 让视觉 AI 能够切实集成到实际系统中。这种边缘优先的方法支持广泛的应用,从机器人和工业视觉到嵌入式 AI 和设备端 AI,尤其适用于性能和可预测性至关重要的场景。
加入不断壮大的社区,并探索我们的 GitHub 代码仓库,获取可上手实践的 AI 资源。现在就通过探索我们的许可选项,开始构建视觉 AI 应用。访问我们的解决方案页面,了解农业中的 AI如何改变农业,以及医疗保健中的视觉 AI如何塑造未来。
作者
评论
提出问题、分享你的结果,或帮助其他人。









