Ultralytics YOLO26 为何移除 NMS,以及这对部署有何影响
了解 Ultralytics YOLO26 如何实现真正的端到端、无 NMS 推理,以及移除后处理为何能简化模型导出和边缘部署。
 Abirami Vina8 分钟阅读
2026 年 1 月 14 日,我们发布了Ultralytics YOLO26,这是新一代计算机视觉模型。推出 YOLO26 时,我们的目标不仅是提高准确度或速度,还要重新思考如何构建目标检测模型并将其部署到真实世界系统中。
随着计算机视觉从研究走向生产,模型越来越需要在 CPU、边缘设备、摄像头、机器人和嵌入式硬件上运行。在这些环境中,可靠性、低延迟和易于部署与性能同样重要。
Ultralytics YOLO26 针对这一现实进行了设计,采用精简的端到端架构,去除了推理流程中不必要的复杂性。YOLO26 最重要的创新之一,是能够移除非极大值抑制,通常简称为 NMS。
多年来,NMS 一直是目标检测系统的标准组成部分,用作清理重复检测结果的后处理步骤。虽然这种方法有效,但也增加了额外计算开销和部署难度,尤其是在边缘硬件上。
YOLO26 采用了不同的方法。通过重新思考预测的生成和训练方式,我们实现了真正端到端、无 NMS 的推理。模型可以直接输出最终检测结果,无需依赖外部清理步骤或手工制定的规则。这让 YOLO26 更快、更易导出,也更可靠,能够部署在各种硬件平台上。
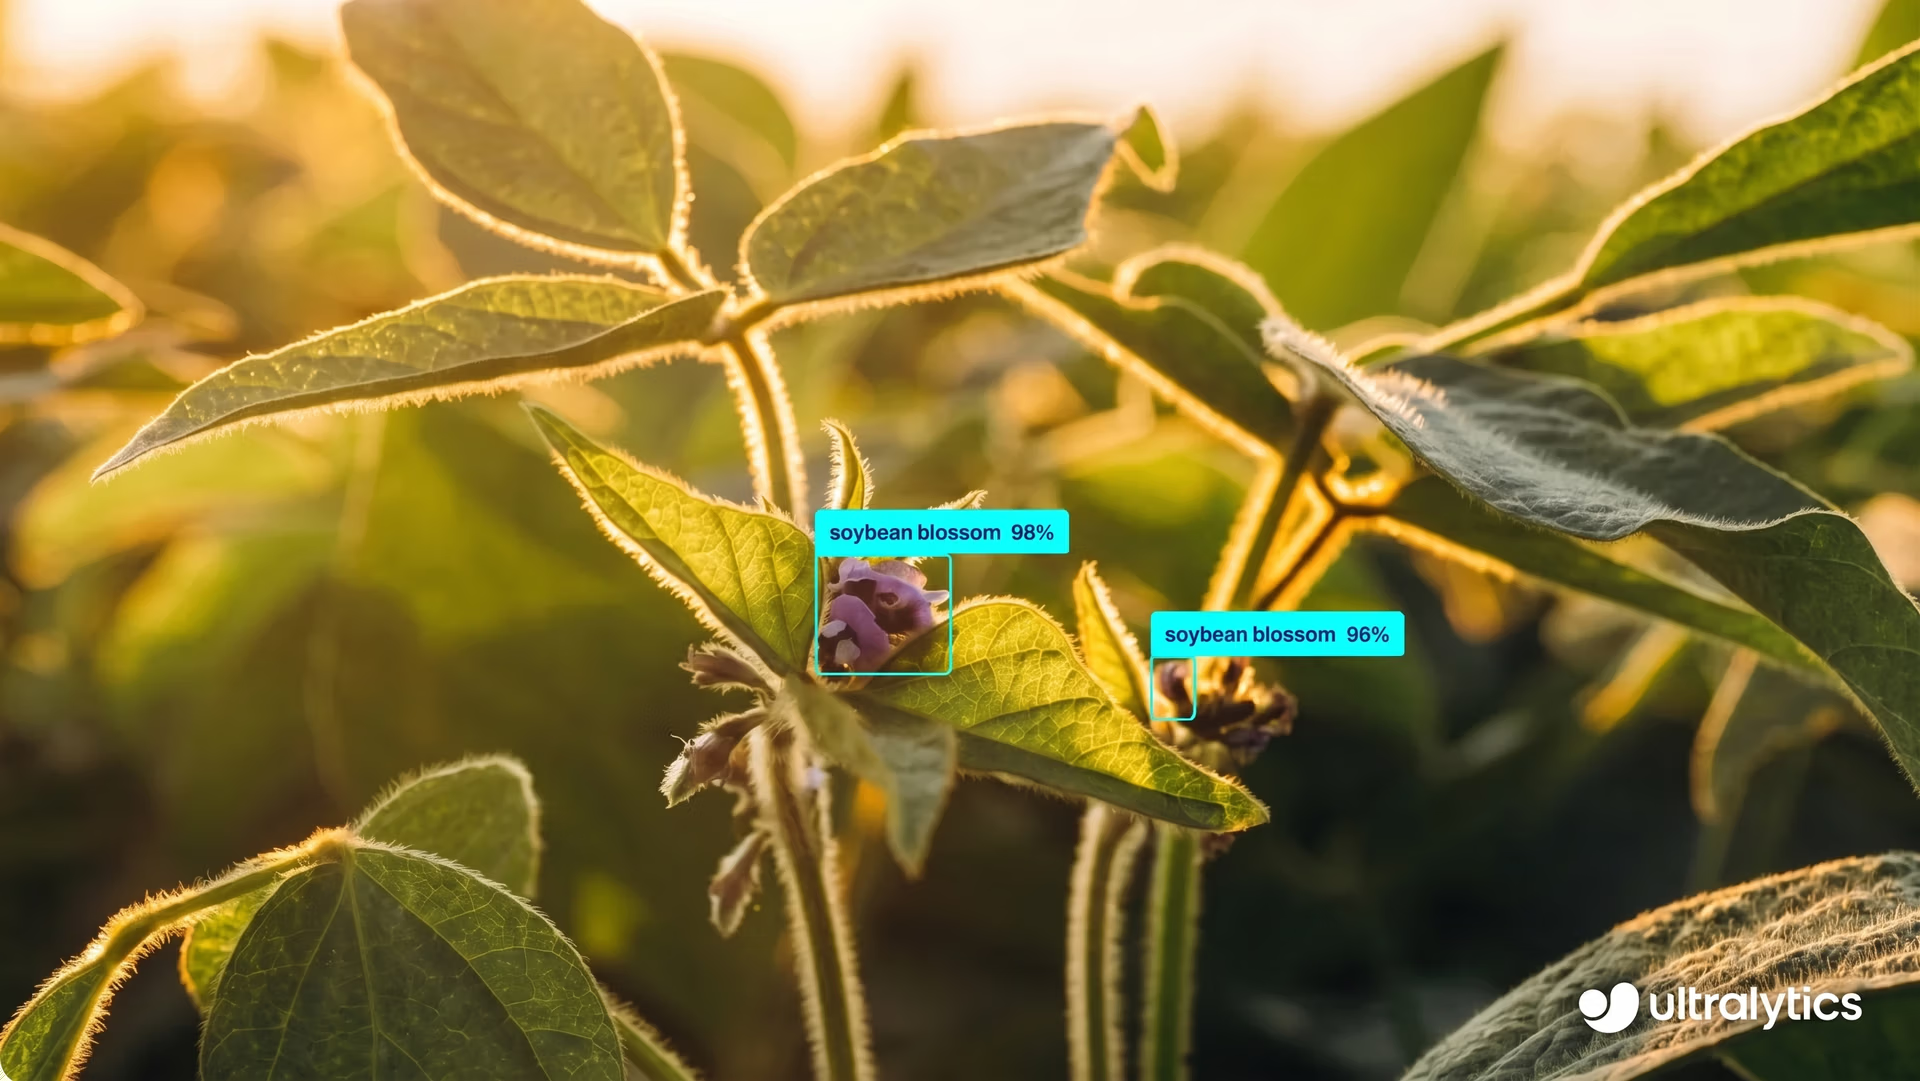
图 1. 使用 Ultralytics YOLO26 检测图像中的物体。
本文将深入探讨传统目标检测为何依赖 NMS、NMS 如何成为部署瓶颈,以及 Ultralytics YOLO26 如何消除对变通方案的需求。
传统目标检测会产生重复检测结果#
在深入了解 NMS 是什么以及我们为何在 Ultralytics YOLO26 中移除 NMS 之前,我们先退一步,看看传统目标检测模型是如何生成预测结果的。
传统目标检测模型通常会为同一个物体生成多个相互重叠的边界框。每个边界框都有自己的置信度分数,尽管它们指向图像中的同一个物体。
造成这种情况的原因有几个。首先,模型会同时在许多空间位置和不同尺度上进行预测。这有助于模型检测不同尺寸的物体,但也意味着相邻位置都可能独立识别出同一个物体。
其次,许多目标检测系统采用基于锚框的方法,会在每个位置周围生成大量候选框。虽然这提高了准确找到物体的概率,但也增加了相互重叠的预测数量。
最后,基于网格的检测本身就容易产生冗余。当物体位于多个网格单元的边界附近时,多个网格单元都可能预测出该物体的边界框,从而产生多个相互重叠的检测结果。
因此,模型的原始输出通常会为单个物体包含多个边界框。要让结果可用,就需要过滤掉这些冗余预测,只保留一个最终检测结果。
了解非极大值抑制#
当目标检测模型为同一个物体生成多个相互重叠的边界框后,需要先清理这些结果才能使用。这时就要应用非极大值抑制。
非极大值抑制是一种后处理步骤,在模型完成预测后运行。它的作用是减少重复检测结果,让每个物体只由一个最终边界框表示。
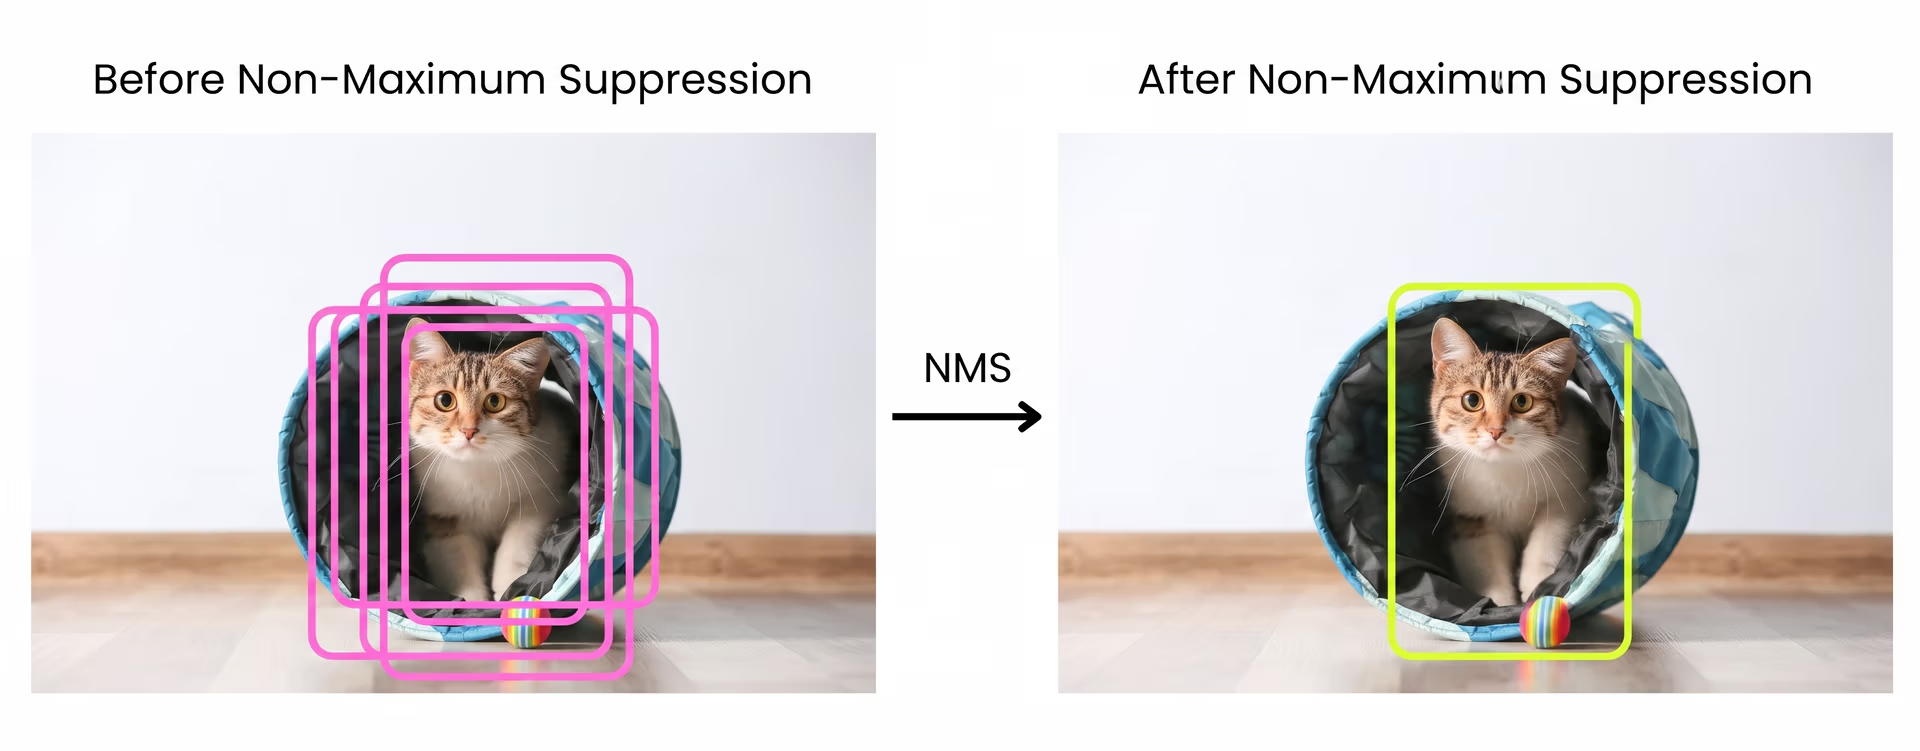
图 2. NMS 概览。图片由作者提供。
该流程会根据边界框的置信度分数以及彼此的重叠程度进行比较。置信度极低的预测会先被移除。
然后,剩余边界框会按置信度排序,并选出分数最高的边界框作为最佳检测结果。接着将这个选中的边界框与其他边界框进行比较。
如果另一个边界框与它的重叠程度过高,该边界框就会被抑制并移除。重叠程度通常使用交并比衡量,这项指标计算两个边界框的交集面积与并集面积之比。这个过程会不断重复,直到只剩下置信度最高且彼此不重叠的检测结果。
NMS 为何会增加部署难度#
非极大值抑制有助于过滤重复检测结果,但当模型从研究走向实际部署时,它也会带来更加明显的挑战。
其中一个主要问题是性能。NMS 在推理之后运行,需要比较各个边界框,判断哪些框应该保留。
这一过程计算开销大,也很难高效并行。在边缘设备和基于 CPU 的系统上,这些额外操作可能显著增加延迟,使系统更难满足实时要求。
NMS 还会增加部署复杂度。由于 NMS 不属于模型本身,因此必须通过单独的后处理代码实现。
不同的运行时和平台处理 NMS 的方式各不相同,这通常意味着要为每个目标环境维护自定义实现。在一种配置中可行的做法,在另一种配置中的表现可能略有不同,因此部署会更脆弱,也更难扩展。
硬件优化也是一项挑战。NMS 很难直接映射到专用 AI 加速器上,而这些加速器是为高效运行神经网络运算而设计的。因此,即使模型在优化硬件上运行很快,NMS 也可能成为限制整体性能的瓶颈。
除了这些因素,NMS 还依赖手动选择的参数,例如置信度阈值和重叠阈值。这些设置会显著影响结果,通常还需要针对不同的数据集、应用或硬件进行调优。这会降低生产系统中行为的可预测性,并增加额外的配置负担。
端到端目标检测推理解析#
非极大值抑制的局限性促使我们重新思考目标检测模型在推理时应如何运行。我们没有采用先生成大量重叠预测、再清理结果的方式,而是提出了一个更根本的问题。
如果模型可以直接生成最终检测结果呢?这个问题是端到端目标检测推理的核心。在端到端系统中,模型经过训练,可以从头到尾处理整个检测过程,无需依赖外部清理步骤。
模型不再生成大量候选框并在推理后进行筛选,而是学会自行生成少量置信度高、彼此不重叠的预测结果。重复检测会在网络内部解决,而不是通过后处理移除。
新型模型架构表明,这种方法既可行又实用。采用合适的训练策略后,模型可以学会让每个物体对应单个预测结果,而不是多个相互竞争的预测结果,从源头减少冗余。
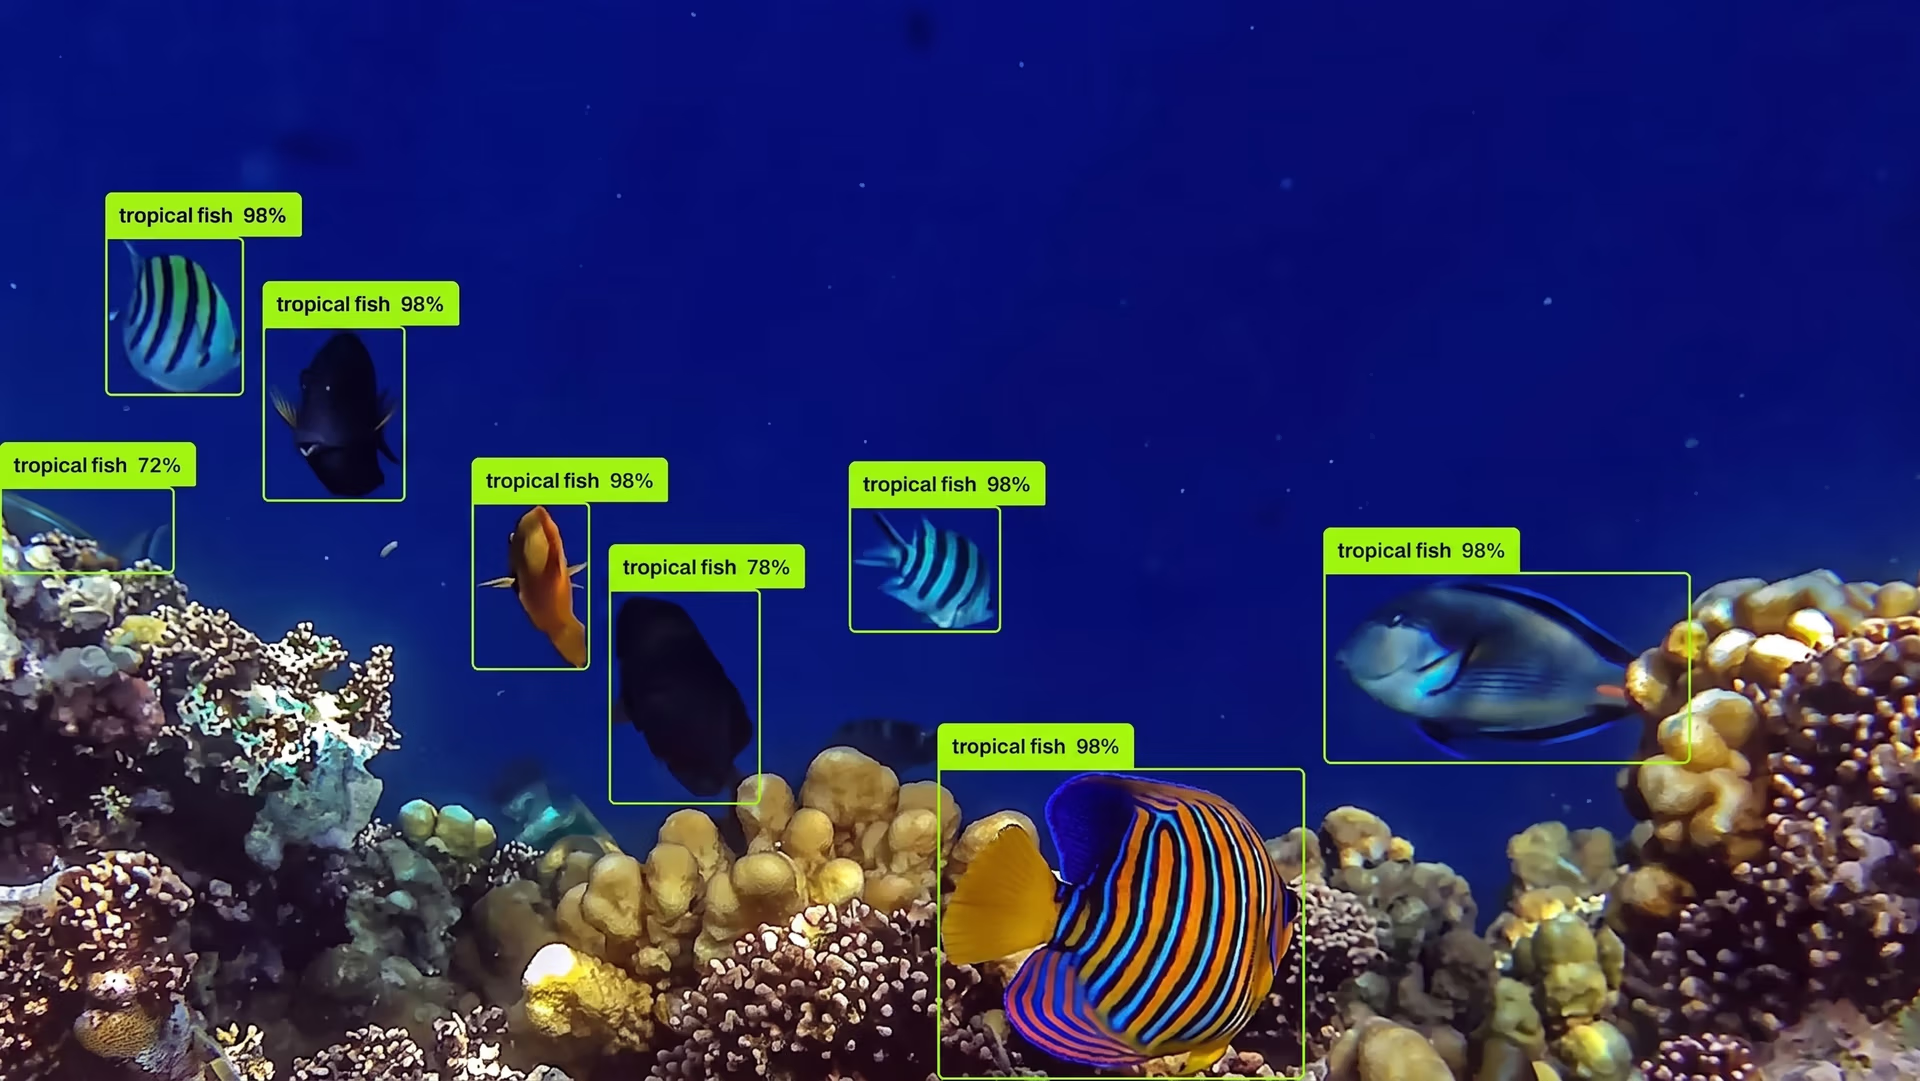
图 3. 使用 Ultralytics YOLO26 检测物体的示例。
要实现这一点,训练方式也必须改变。模型不再让多个预测结果争相匹配同一个物体,而是学会做出一个明确判断,从而生成更少且置信度更高的检测结果。
最终,推理流水线会更加简单。由于重复结果已在模型内部解决,推理时就不再需要非极大值抑制。模型输出本身就是最终检测结果。
这种端到端设计也让部署更加轻松。无需后处理步骤或针对特定平台的 NMS 实现,导出的模型便完全自包含,并且在不同推理框架和硬件目标上表现一致。
我们的首席合作工程师 Francesco Mattioli 解释道:“真正的端到端学习意味着模型应当处理从像素到预测的所有环节,而不依赖会破坏可微性并增加部署难度的手工后处理步骤。”
Ultralytics YOLO26 如何移除 NMS#
Ultralytics YOLO26 通过改变检测结果的学习和生成方式来移除非极大值抑制,而不是依赖后处理来清理结果。YOLO26 不再允许多个预测结果争相匹配同一个物体,而是经过训练,学会建立物体与输出之间清晰的一对一关系。
这部分功能得益于专用的一对一检测头。该检测头与传统的一对多检测头一同训练,可帮助模型专注于为每个对象生成一个置信度高的预测,而不是生成许多重叠候选框。每个对象只对应一个预测,因此可以自然地减少重复检测。
训练过程中的一致匹配策略进一步强化了这种行为,促使模型为每个物体做出一个有把握的判断,而不是生成相互重叠的预测结果。最终,模型生成的预测更少,但每个预测都代表一个最终检测结果。
移除 DFL 为无 NMS 检测带来了可能#
Ultralytics YOLO26 能够实现无 NMS 推理的另一项重要创新,是移除了分布焦点损失(DFL)。在早期的 YOLO 模型中,DFL 用于改进边界框回归,方法是预测多个可能的边界框位置组成的分布,而不是单个值。
这种方法虽然提高了定位准确度,但也让检测流水线更加复杂。随着模型转向真正的端到端推理,这种复杂性逐渐成为限制因素。
DFL 增加了计算量,并引入固定的回归范围,因此模型更难学习清晰的一对一物体匹配,也更加依赖非极大值抑制等后处理步骤。在 Ultralytics YOLO26 中,我们移除了 DFL,并重新设计了边界框回归,使其更加简单直接。
模型不再依赖基于分布的输出,而是学会预测准确的边界框坐标,从而支持生成更少且置信度更高的检测结果。这项改变有助于从源头减少重叠预测,并使边界框回归符合 Ultralytics YOLO26 的端到端、无 NMS 设计。
Ultralytics YOLO26 无需 NMS,易于部署#
无 NMS 设计让 Ultralytics YOLO26 成为真正的端到端模型。这对模型导出有着重要影响。
导出是指将训练好的模型转换成可在训练环境之外运行的格式,例如 ONNX、TensorRT、CoreML 或 OpenVINO。在传统流水线中,由于非极大值抑制不属于模型本身,这一过程往往会出问题。
移除 NMS 后,Ultralytics YOLO26 从根本上避免了这个问题。导出的模型已包含生成最终检测结果所需的一切内容。在当前版本的 Ultralytics 中,预测、验证或导出时,可以使用 nms=False 选择这个无 NMS 的一对一检测头;同时也可以使用默认的一对多检测头和 NMS,以获得略高的准确度;端到端检测指南介绍了这两种选项。
这样导出的模型就完全自包含,并且可以更灵活地适配不同的推理框架和硬件目标。无论部署在服务器、仅使用 CPU 的系统、嵌入式设备还是边缘加速器上,同一个模型的表现都一致。部署也会更加直接,因为导出的内容就是实际运行的内容。
这种简洁性对边缘应用尤其重要。例如,YOLO26 可以轻松部署在无人机等设备上,用于作物监测、田间巡检和植物健康分析等场景。在这些场景中,计算资源和功耗预算有限,复杂的后处理流水线并不实用。由于模型可以直接输出最终检测结果,因此无需额外处理步骤,就能在轻量级硬件上可靠运行。
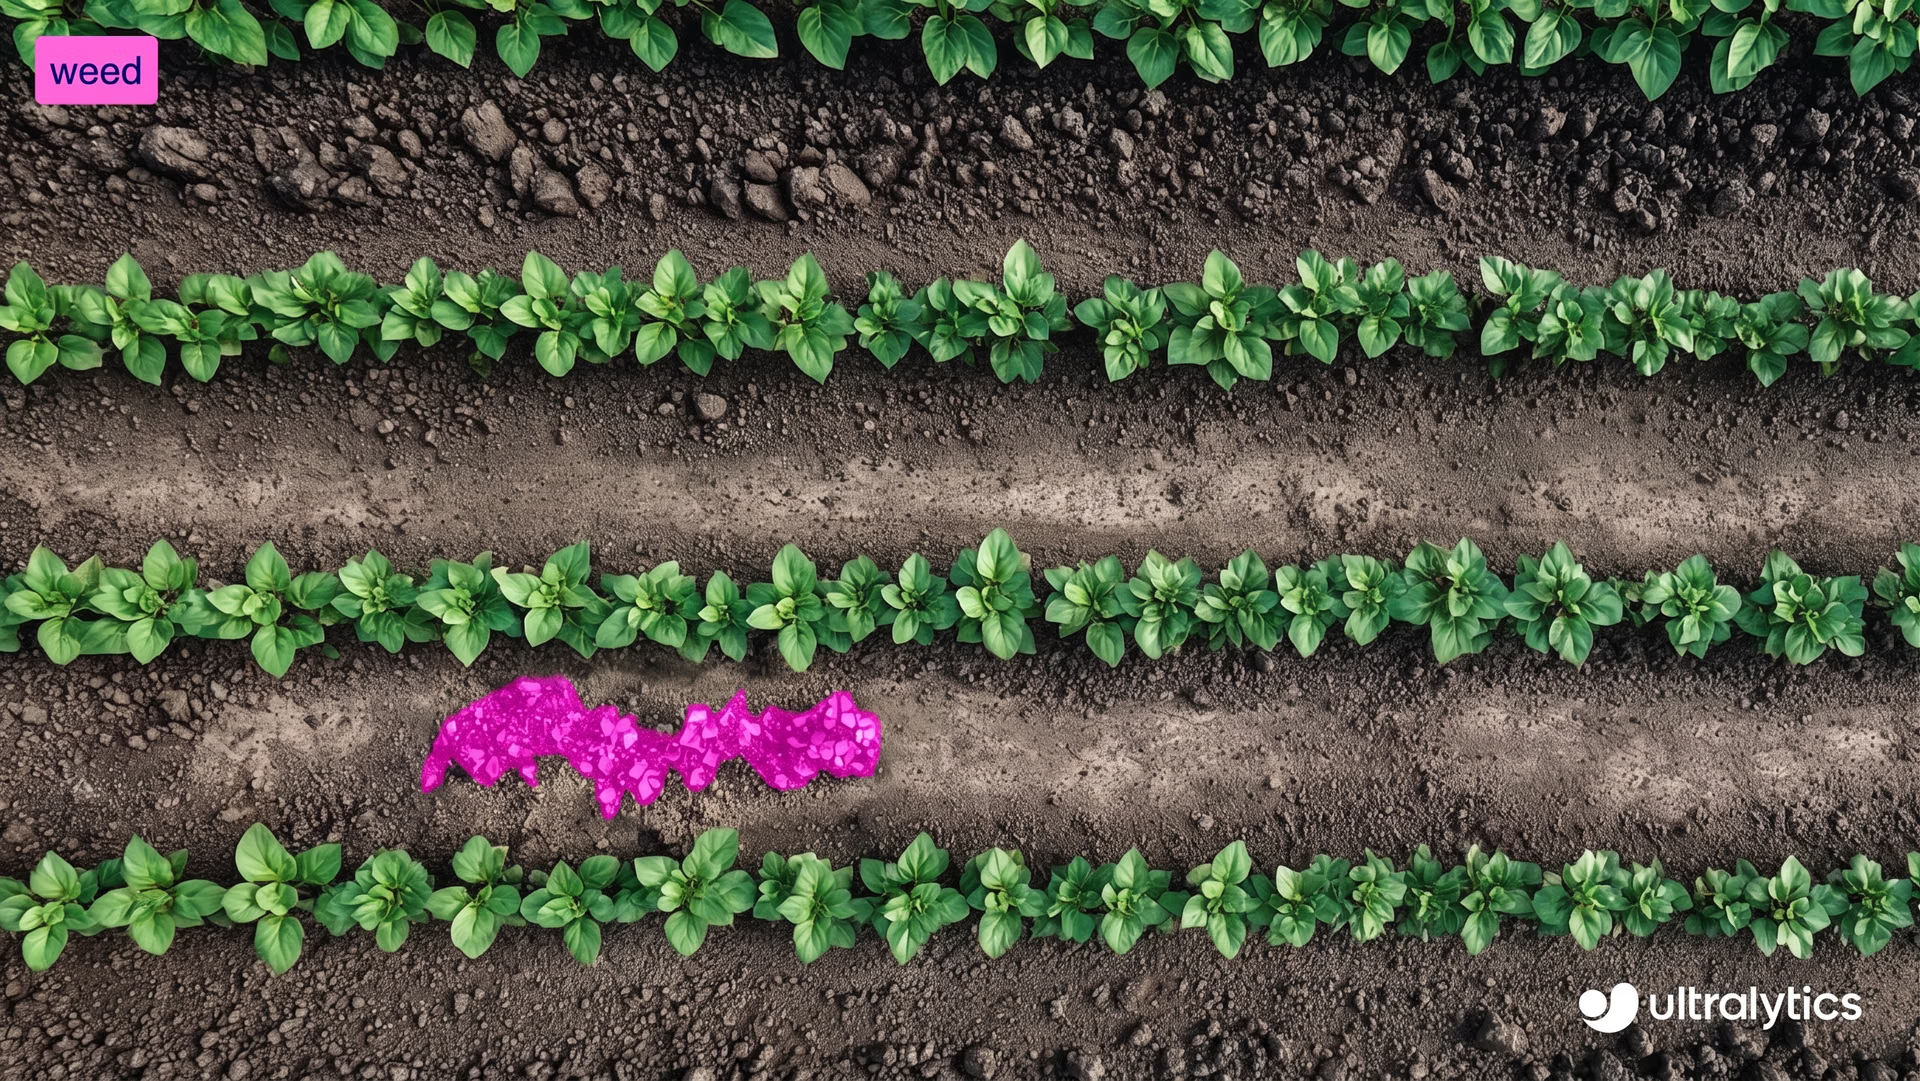
图 4. Ultralytics YOLO26 易于部署在无人机等边缘设备上。
简而言之,无 NMS 推理减少了模型导出和部署中的阻碍,有助于构建更简洁、更可靠的视觉系统。NMS 曾是一种变通方案。Ultralytics YOLO26 已不再需要变通方案。
要点#
Ultralytics YOLO26 从根本上解决重复检测问题,而不是事后清理检测结果,因此可以移除非极大值抑制。其端到端设计让模型能够直接输出最终检测结果,从而简化导出和部署,并确保模型在不同硬件上的表现更加一致。NMS 曾是早期系统的一种实用变通方案,但 YOLO26 已不再需要它。
加入我们的社区,并查看我们的 GitHub 代码仓库,进一步了解 AI。浏览我们的解决方案页面,了解 AI 在农业中的应用和计算机视觉在零售业中的应用。了解我们的许可选项,立即开始使用视觉 AI!
作者
评论
提出问题、分享你的结果,或帮助其他人。









