什么是 Mask R-CNN?它是如何工作的?
了解 Mask R-CNN 如何精准分割图像和视频中的对象,并应用于各行业的各种场景。
随着 AI 应用日益普及,仓库中的机器人、在繁忙街道上安全行驶的自动驾驶汽车、检查农作物的无人机,以及在工厂检查产品的 AI 系统都变得越来越常见。推动这些创新的一项关键技术是计算机视觉,它是 AI 的一个分支,能够让机器理解和解读视觉数据。
例如,目标检测是一项计算机视觉任务,它使用边界框帮助识别和定位图像中的物体。边界框虽然能提供有用的信息,但只能粗略估计物体的位置,无法呈现物体的确切形状或边界。因此,在需要精确识别的应用中,边界框的效果较差。
为了解决这个问题,研究人员开发了分割模型。这些模型能够捕捉物体的精确轮廓,提供像素级细节,从而实现更准确的检测和分析。
Mask R-CNN 是这类模型之一,由 Facebook 人工智能研究院 (FAIR) 于 2017 年推出。它基于早期模型发展而来,例如 R-CNN、Fast R-CNN 和 Faster R-CNN。作为计算机视觉发展史上的重要里程碑,Mask R-CNN 为 Ultralytics YOLO11 等更先进的模型铺平了道路。
本文将介绍 Mask R-CNN 的定义、工作原理和应用,以及之后出现的改进如何推动技术发展,最终促成 Ultralytics YOLO11 的诞生。
Mask R-CNN 概述#
Mask R-CNN 是 Mask Region-based Convolutional Neural Network(基于掩码的区域卷积神经网络)的缩写,是一种深度学习模型,专为目标检测和实例分割等计算机视觉任务而设计。
实例分割超越了传统目标检测:它不仅能识别图像中的物体,还能准确勾勒出每个物体的轮廓。它为每个检测到的物体分配唯一标签,并在像素级别捕捉物体的确切形状。这种细致的方法可以清楚地区分彼此重叠的物体,并准确处理复杂形状。
Mask R-CNN 基于 Faster R-CNN 构建。Faster R-CNN 可以检测并标记物体,但无法确定物体的确切形状。Mask R-CNN 通过识别构成每个物体的确切像素来改进这一点,从而实现更加细致、准确的图像分析。
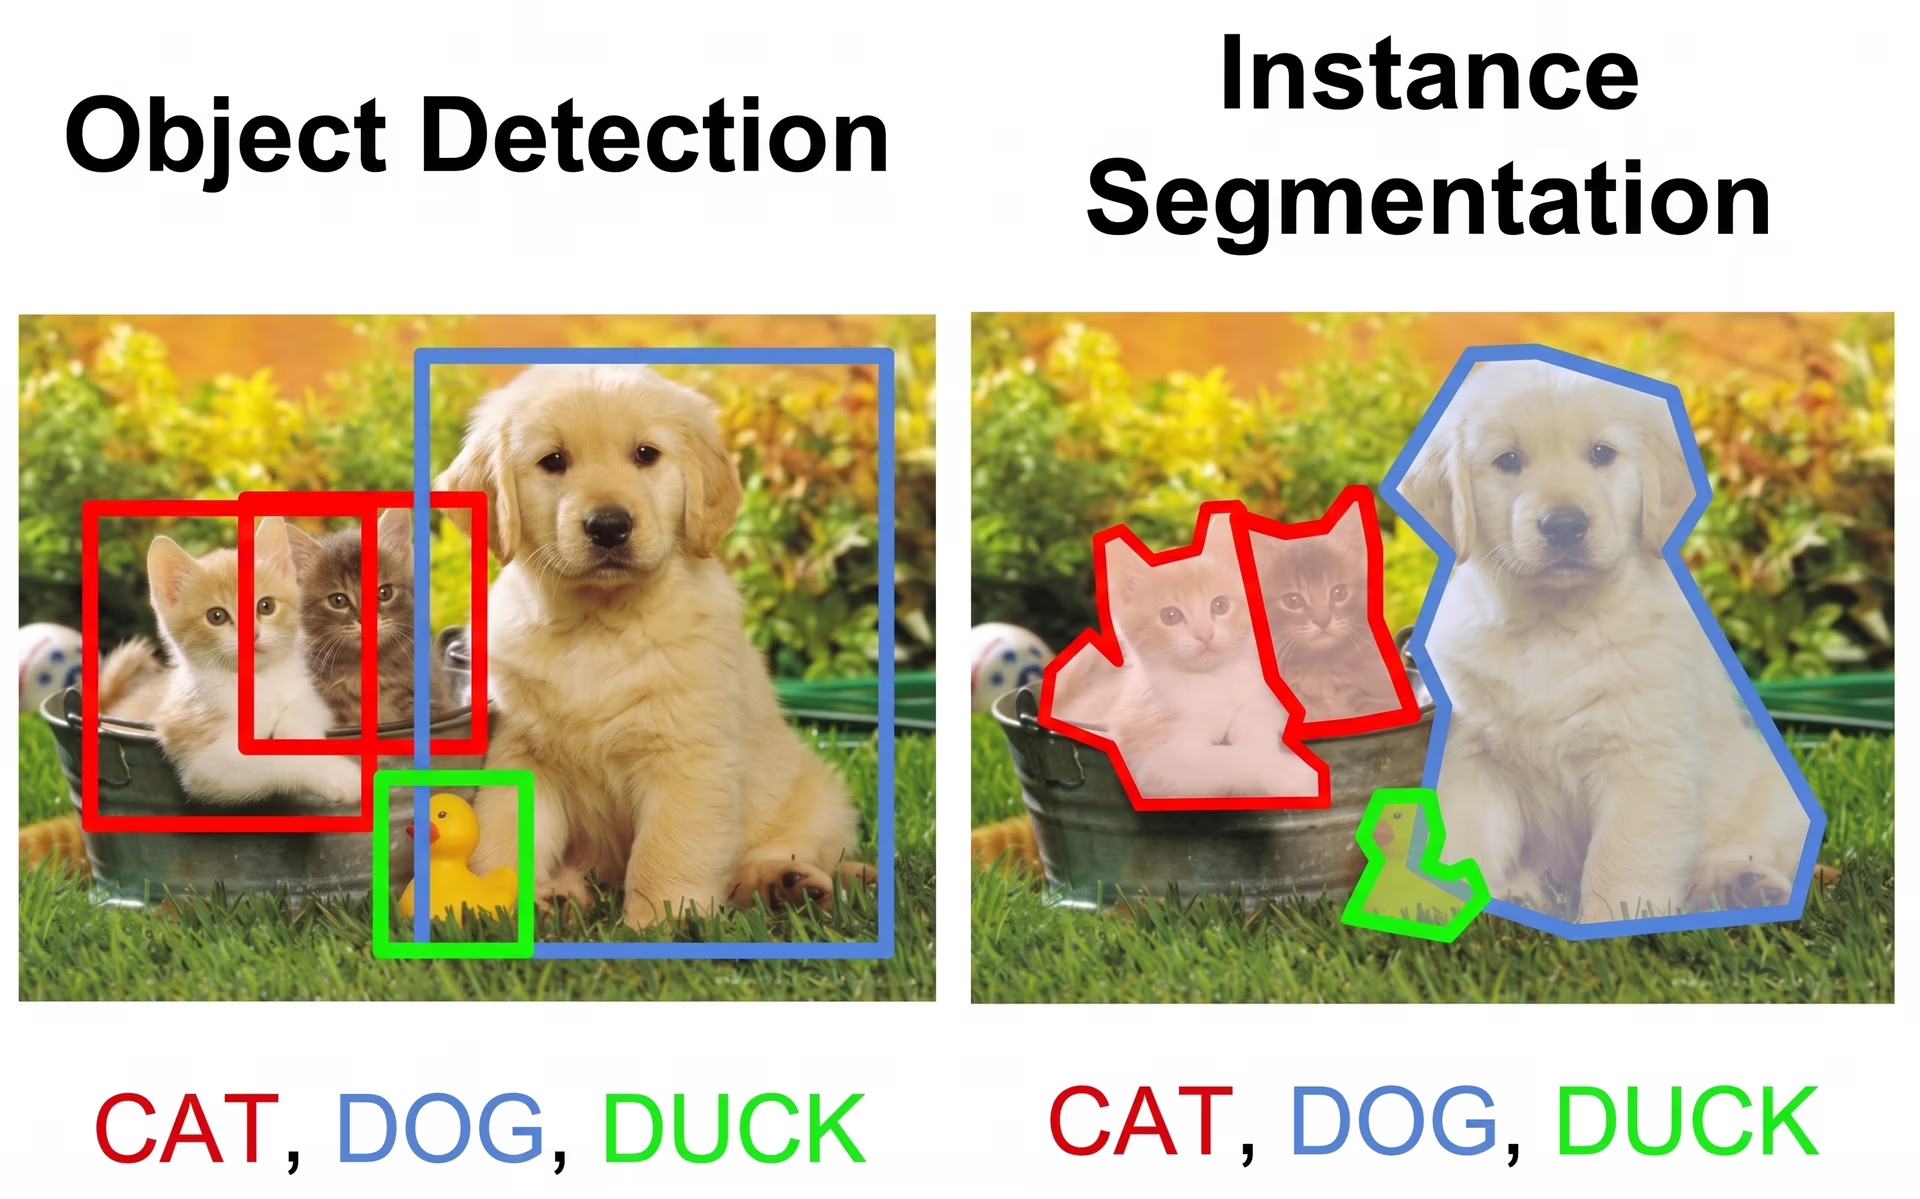
图 1. 目标检测与实例分割的比较。
深入了解 Mask R-CNN 的架构及其工作原理#
Mask R-CNN 通过逐步处理来准确检测和分割物体。它首先使用深度神经网络(能够从数据中学习的多层模型)提取关键特征,然后通过区域提议网络(用于提出可能包含物体的区域的组件)识别潜在物体区域,最后生成详细的分割掩码(物体的精确轮廓),进一步细化这些区域,从而捕捉每个物体的确切形状。
接下来,我们将逐步介绍每个环节,以便更好地了解 Mask R-CNN 的工作原理。
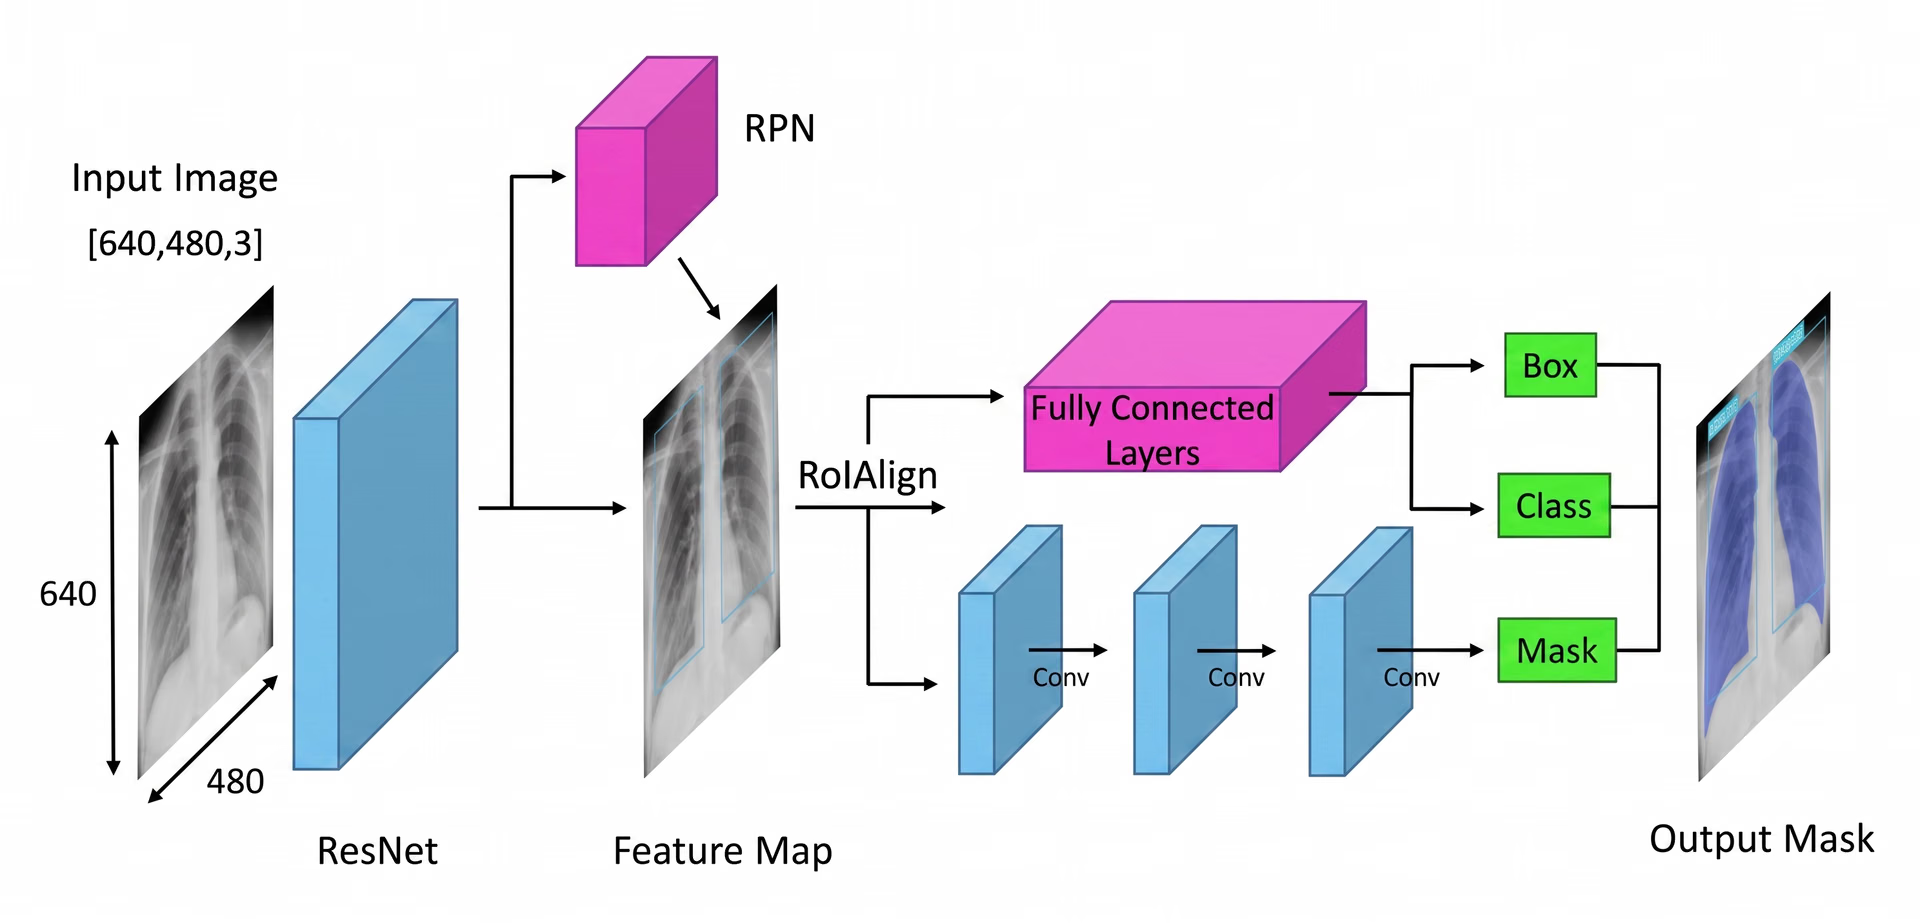
图 2. Mask R-CNN 架构概览(来源:researchgate.net)。
从特征提取开始#
Mask R-CNN 架构的第一步是将图像分解为关键部分,让模型能够理解图像内容。你可以把它想成自己看照片时,会自然留意形状、颜色和边缘等细节。模型也会执行类似的操作:它使用名为“主干网络”的深度神经网络(通常是 ResNet-50 或 ResNet-101),就像眼睛一样扫描图像并捕捉关键细节。
由于图像中的物体可能很小,也可能很大,Mask R-CNN 使用特征金字塔网络。这就像配备了不同的放大镜,让模型既能看清细节,也能把握整体,从而确保注意到各种尺寸的物体。
提取出这些重要特征后,模型便会继续定位图像中可能存在的物体,为后续分析做好准备。
提出图像中可能包含物体的区域#
图像完成关键特征处理后,区域提议网络便开始工作。模型的这一部分会检查图像,并提出可能包含物体的区域。
它通过生成多个可能的物体位置来实现这一点,这些位置称为锚框。随后,网络会评估这些锚框,并选出最有希望的锚框进行进一步分析。这样,模型只需关注最有可能包含目标的区域,而不必检查图像中的每一个位置。
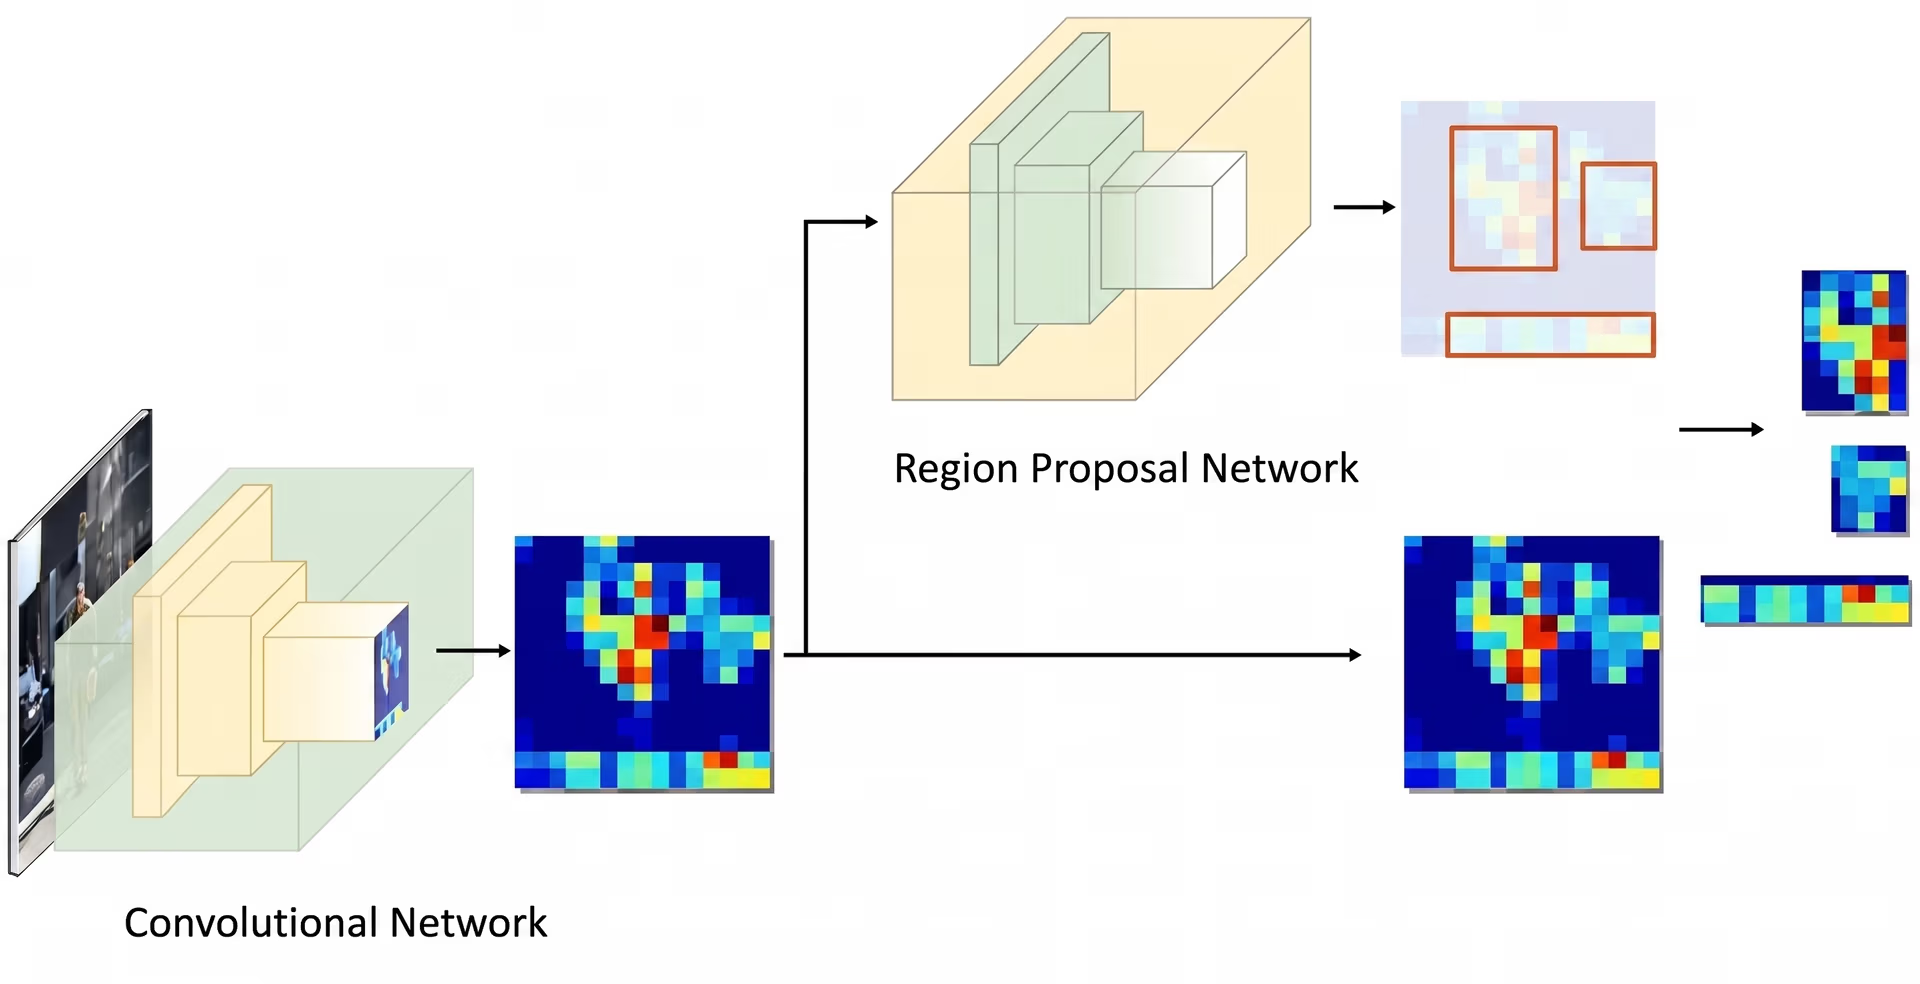
图 3. 区域提议网络示例。
改进提取出的特征#
确定关键区域后,下一步是细化从这些区域提取的细节。早期模型使用一种名为 ROI Pooling(感兴趣区域池化)的方法从各个区域提取特征,但这种技术在调整区域大小时有时会造成轻微错位,因此效果较差,尤其是在处理较小物体或彼此重叠的物体时。
Mask R-CNN 采用名为 ROI Align(感兴趣区域对齐)的技术来改进这一点。与 ROI Pooling 那样对坐标进行取整不同,ROI Align 使用双线性插值更精确地估算像素值。双线性插值会对最近的四个邻居像素的值取平均,从而计算出新的像素值,使过渡更加平滑。这种方法能使特征与原始图像保持正确对齐,从而更准确地检测和分割物体。
例如,在足球比赛中,两名站得很近的球员可能会因为边界框重叠而被误认为同一个人。ROI Align 能保持两人的形状彼此分离,帮助模型将他们区分开来。
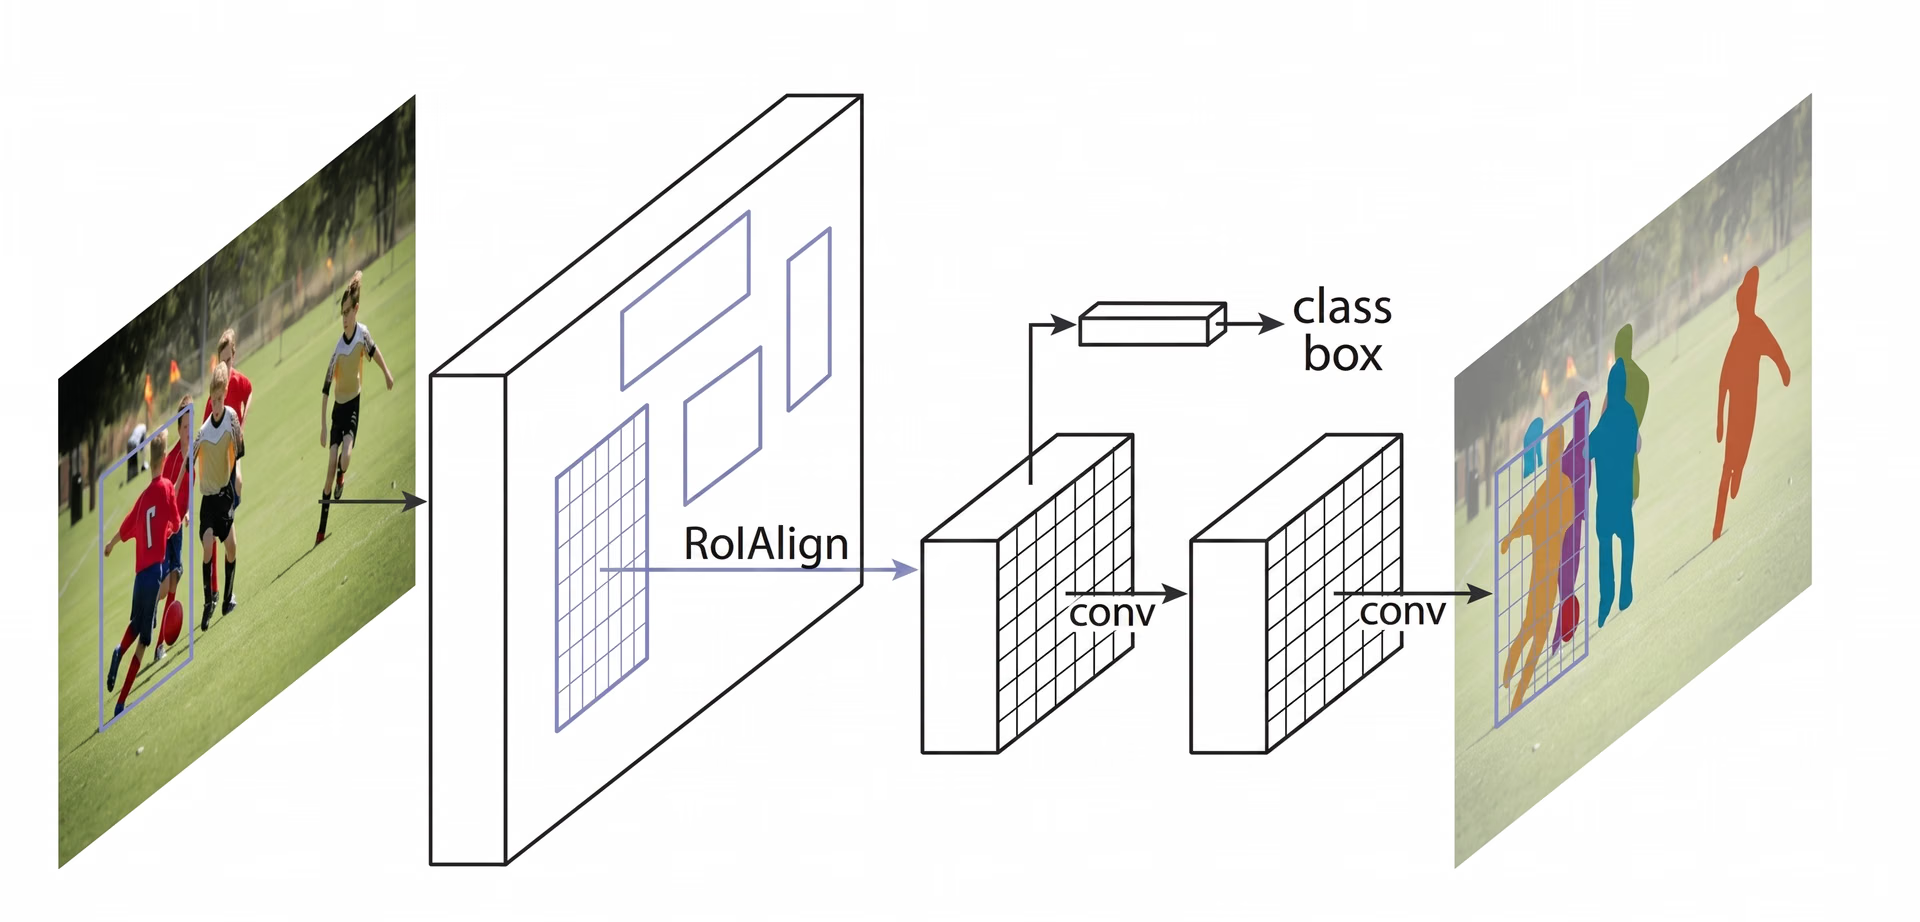
图 4。Mask R-CNN 使用 ROI Align。
对象分类与掩码预测#
ROI Align 处理完图像后,下一步是对对象进行分类并微调其位置。模型会查看每个提取出的区域,判断其中包含什么对象。模型会为不同类别分配概率分数,并选出最匹配的类别。
与此同时,模型会调整边界框,使其更贴合对象。初始框的位置可能不够理想,因此通过调整边界框使其紧密包围检测到的对象,可以提高准确率。
最后,Mask R-CNN 还会额外执行一步:并行地为每个对象生成详细的分割掩码。
Mask R-CNN 及其实时应用#
该模型问世时,AI 社区反响热烈,很快便应用于各种场景。它能够实时检测和分割对象,改变了多个行业的发展方式。
例如,在野外追踪濒危动物是一项颇具挑战的任务。许多物种会穿行于茂密的森林中,让保护工作者难以追踪它们。传统方法会使用红外相机、无人机和卫星图像,但手动筛查所有这些数据非常耗时。误认和漏检都可能拖慢保护工作。
通过识别老虎的条纹、长颈鹿的斑点或大象耳朵的形状等独特特征,Mask R-CNN 可以更准确地检测和分割图像及视频中的动物。即使动物被树木部分遮挡或彼此靠得很近,模型也能将它们区分开来并逐一识别,从而让野生动物监测更快速、更可靠。
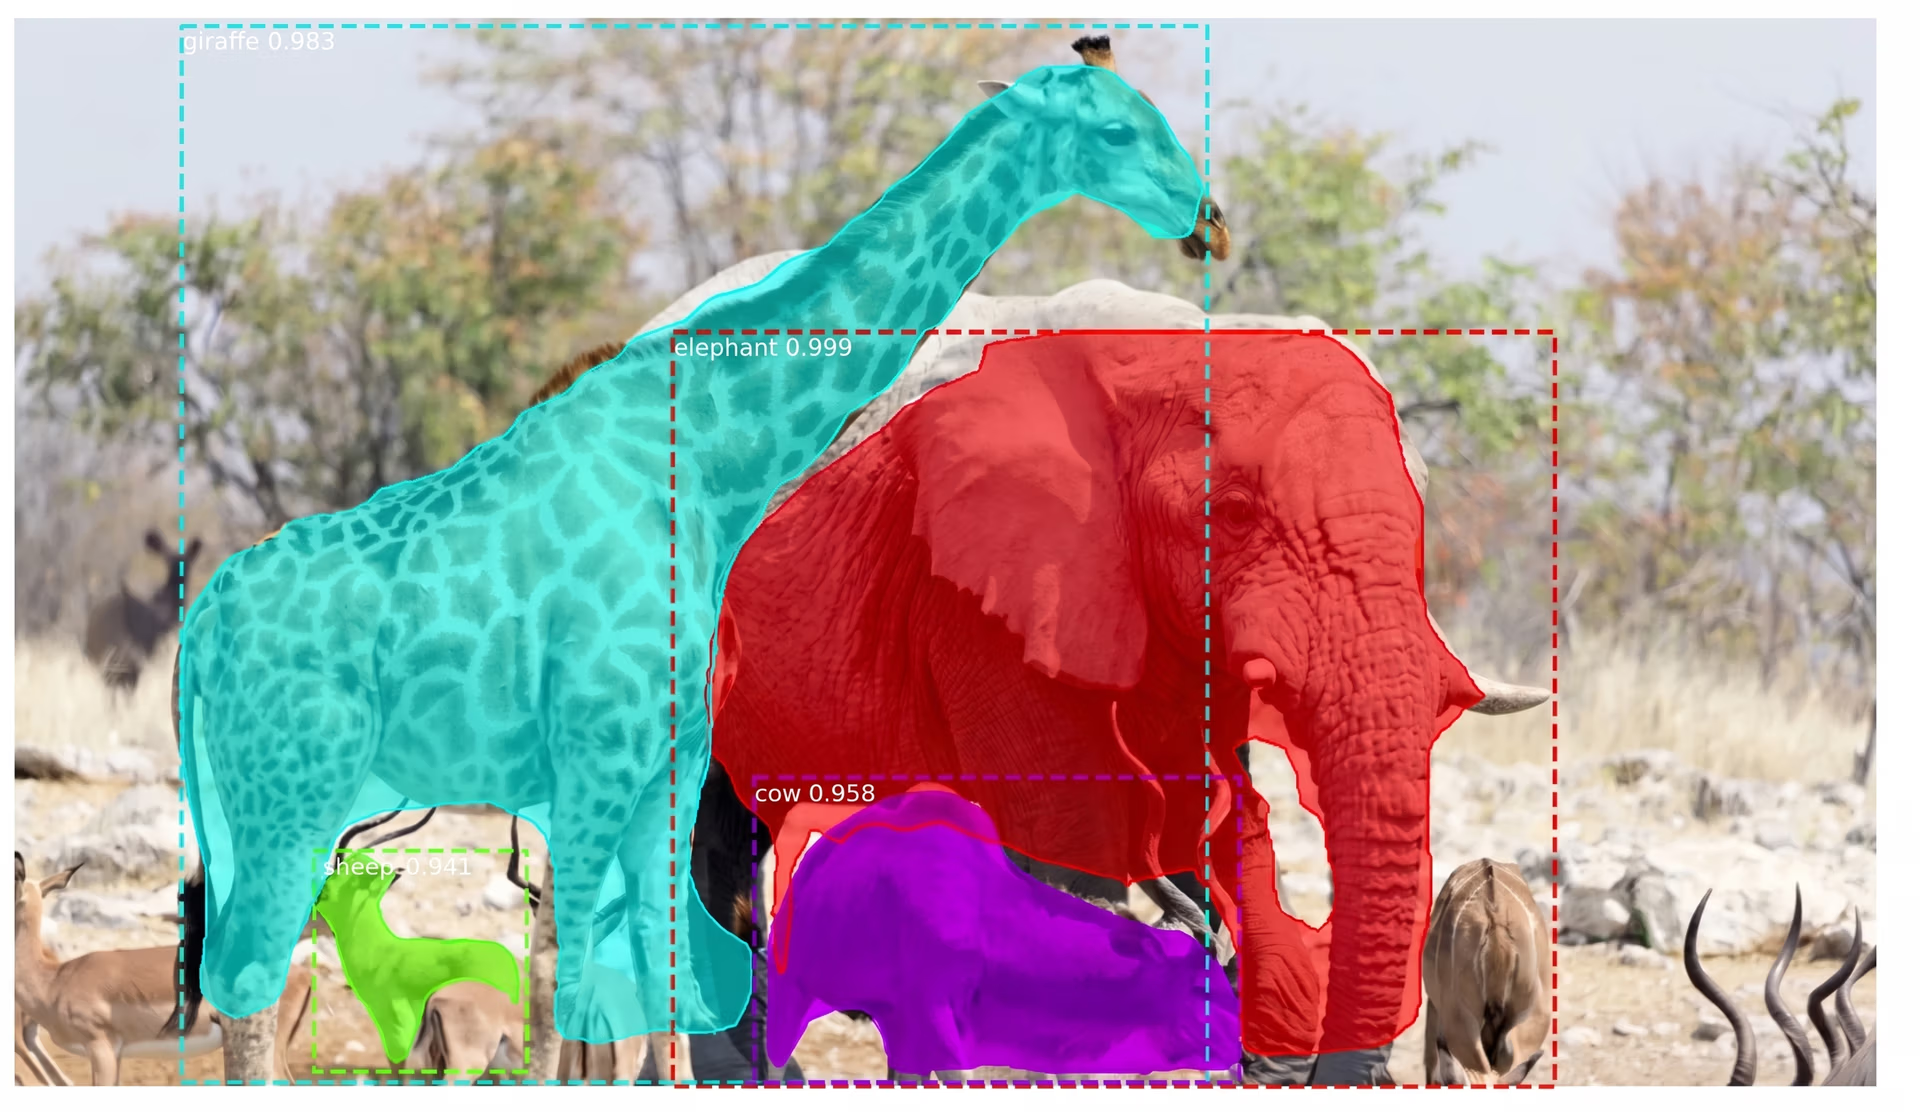
图 5. 使用 Mask R-CNN 检测和分割动物。
Mask R-CNN 的局限性#
尽管 Mask R-CNN 在目标检测和分割领域具有重要的历史意义,但它也存在一些主要缺点。以下是 Mask R-CNN 面临的一些挑战:
- 计算需求高:它依赖性能强大的 GPU,因此运行成本可能较高,处理大量数据时速度也较慢。
- 处理速度较慢:与 YOLO 等更快的实时模型相比,它的多阶段处理流程速度较慢,因此可能不适合对时间要求严格的任务。
- 依赖高质量数据:该模型在图像清晰、标注完善的情况下表现最佳。图像模糊或光线不足会显著降低其准确率。
- 实现复杂:多阶段架构可能难以配置和优化,尤其是在处理大型数据集或资源有限时。
从 Mask R-CNN 到 Ultralytics YOLO11#
Mask R-CNN 非常适合分割任务,但许多行业希望在采用计算机视觉的同时优先考虑速度和实时性能。为满足这一需求,研究人员开发了单阶段模型,只需一次处理就能检测对象,大幅提升了效率。
与 Mask R-CNN 的多步流程不同,YOLO 等单阶段计算机视觉模型专注于实时计算机视觉任务。YOLO 模型无需分别处理检测和分割,而是能够一次性分析图像。因此,YOLO 非常适合自动驾驶、医疗保健、制造业和机器人等需要快速决策的应用。
具体来说,Ultralytics YOLO11 更进一步,兼具速度和准确性。它的参数量比 YOLOv8m 少 22%,但在 COCO 数据集上的平均精度均值(mAP)仍然更高,这意味着它能更准确地检测对象。其更快的处理速度使其成为实时应用的理想选择,因为每一毫秒都很重要。
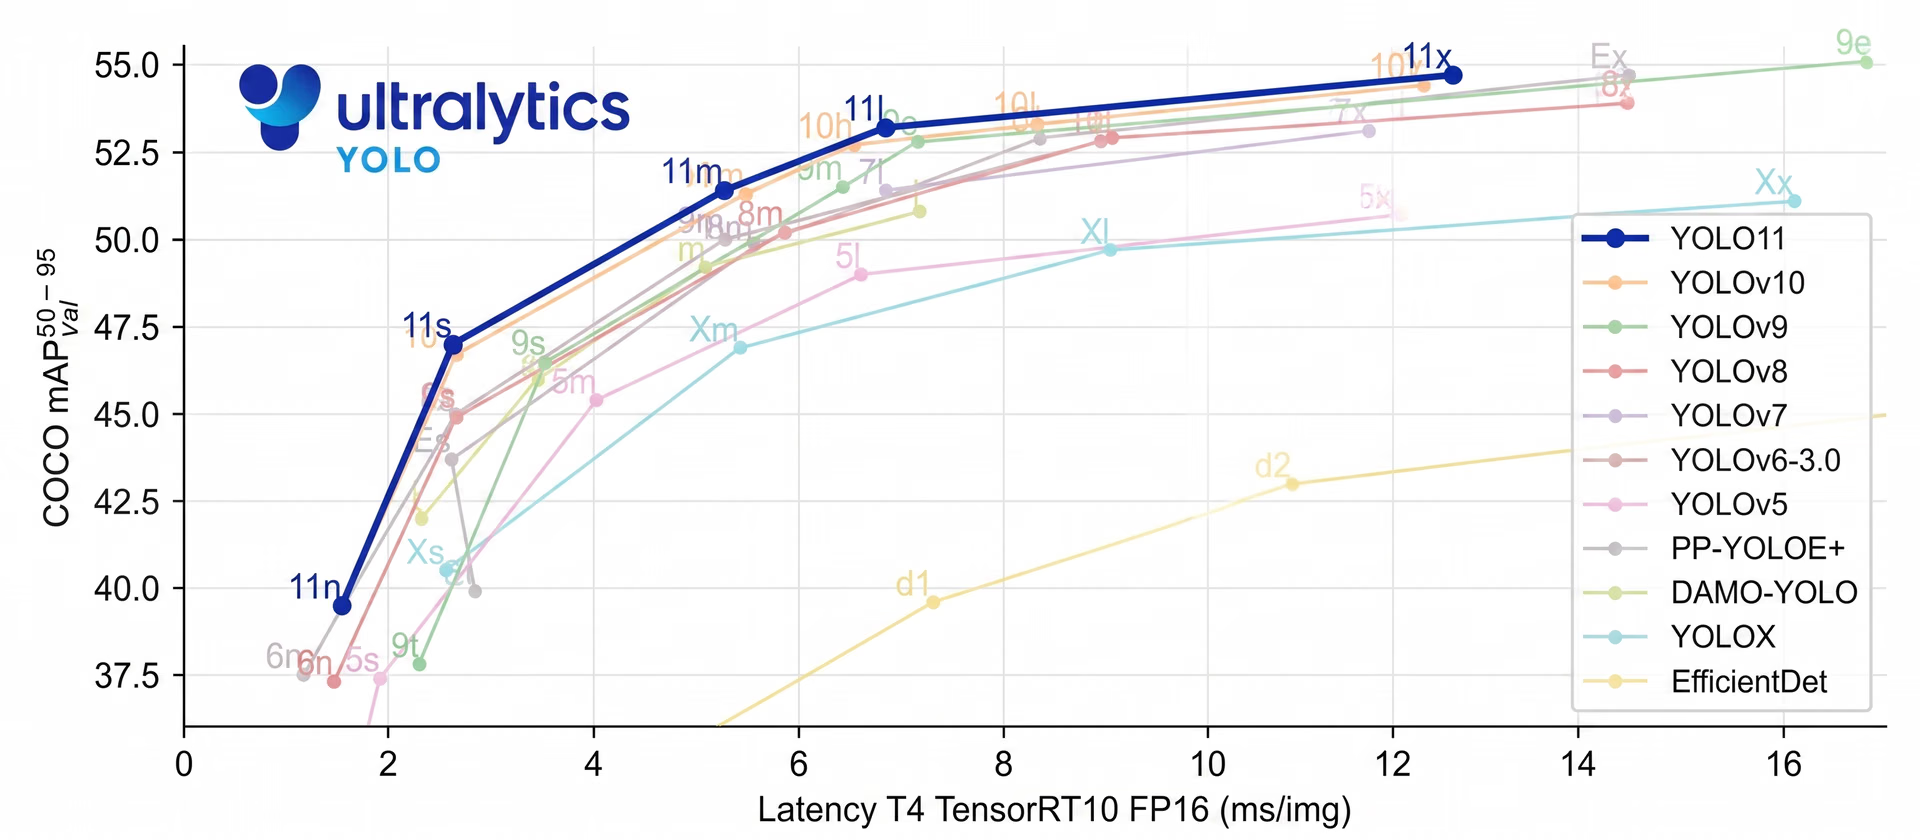
图 6。YOLO11 与其他模型的性能对比。
要点#
回顾计算机视觉的发展历程,Mask R-CNN 被视为目标检测和分割领域的一项重大突破。得益于其细致的多步处理流程,即使在复杂场景中,它也能给出非常精确的结果。
然而,同一套处理流程也让它比 YOLO 等实时模型更慢。随着人们对速度和效率的需求不断增长,许多应用现在改用 Ultralytics YOLO11 等单阶段模型,以实现快速、准确的目标检测。Mask R-CNN 对理解计算机视觉的发展历程很重要,但实时解决方案的发展趋势凸显了人们对更快速、更高效的计算机视觉解决方案日益增长的需求。
加入不断壮大的社区!访问我们的 GitHub 代码仓库,深入了解 AI。准备好启动自己的计算机视觉项目了吗?查看我们的许可选项。访问我们的解决方案页面,了解农业中的 AI和医疗保健中的视觉 AI!









