Erkennung kleiner Objekte mit Ultralytics YOLO11
Entdecke, wie Ultralytics YOLO11 schnelle und präzise Erkennung kleiner Objekte in realen Anwendungen wie Überwachung und Robotik ermöglicht.
 Abirami Vina12 Min. Lesezeit
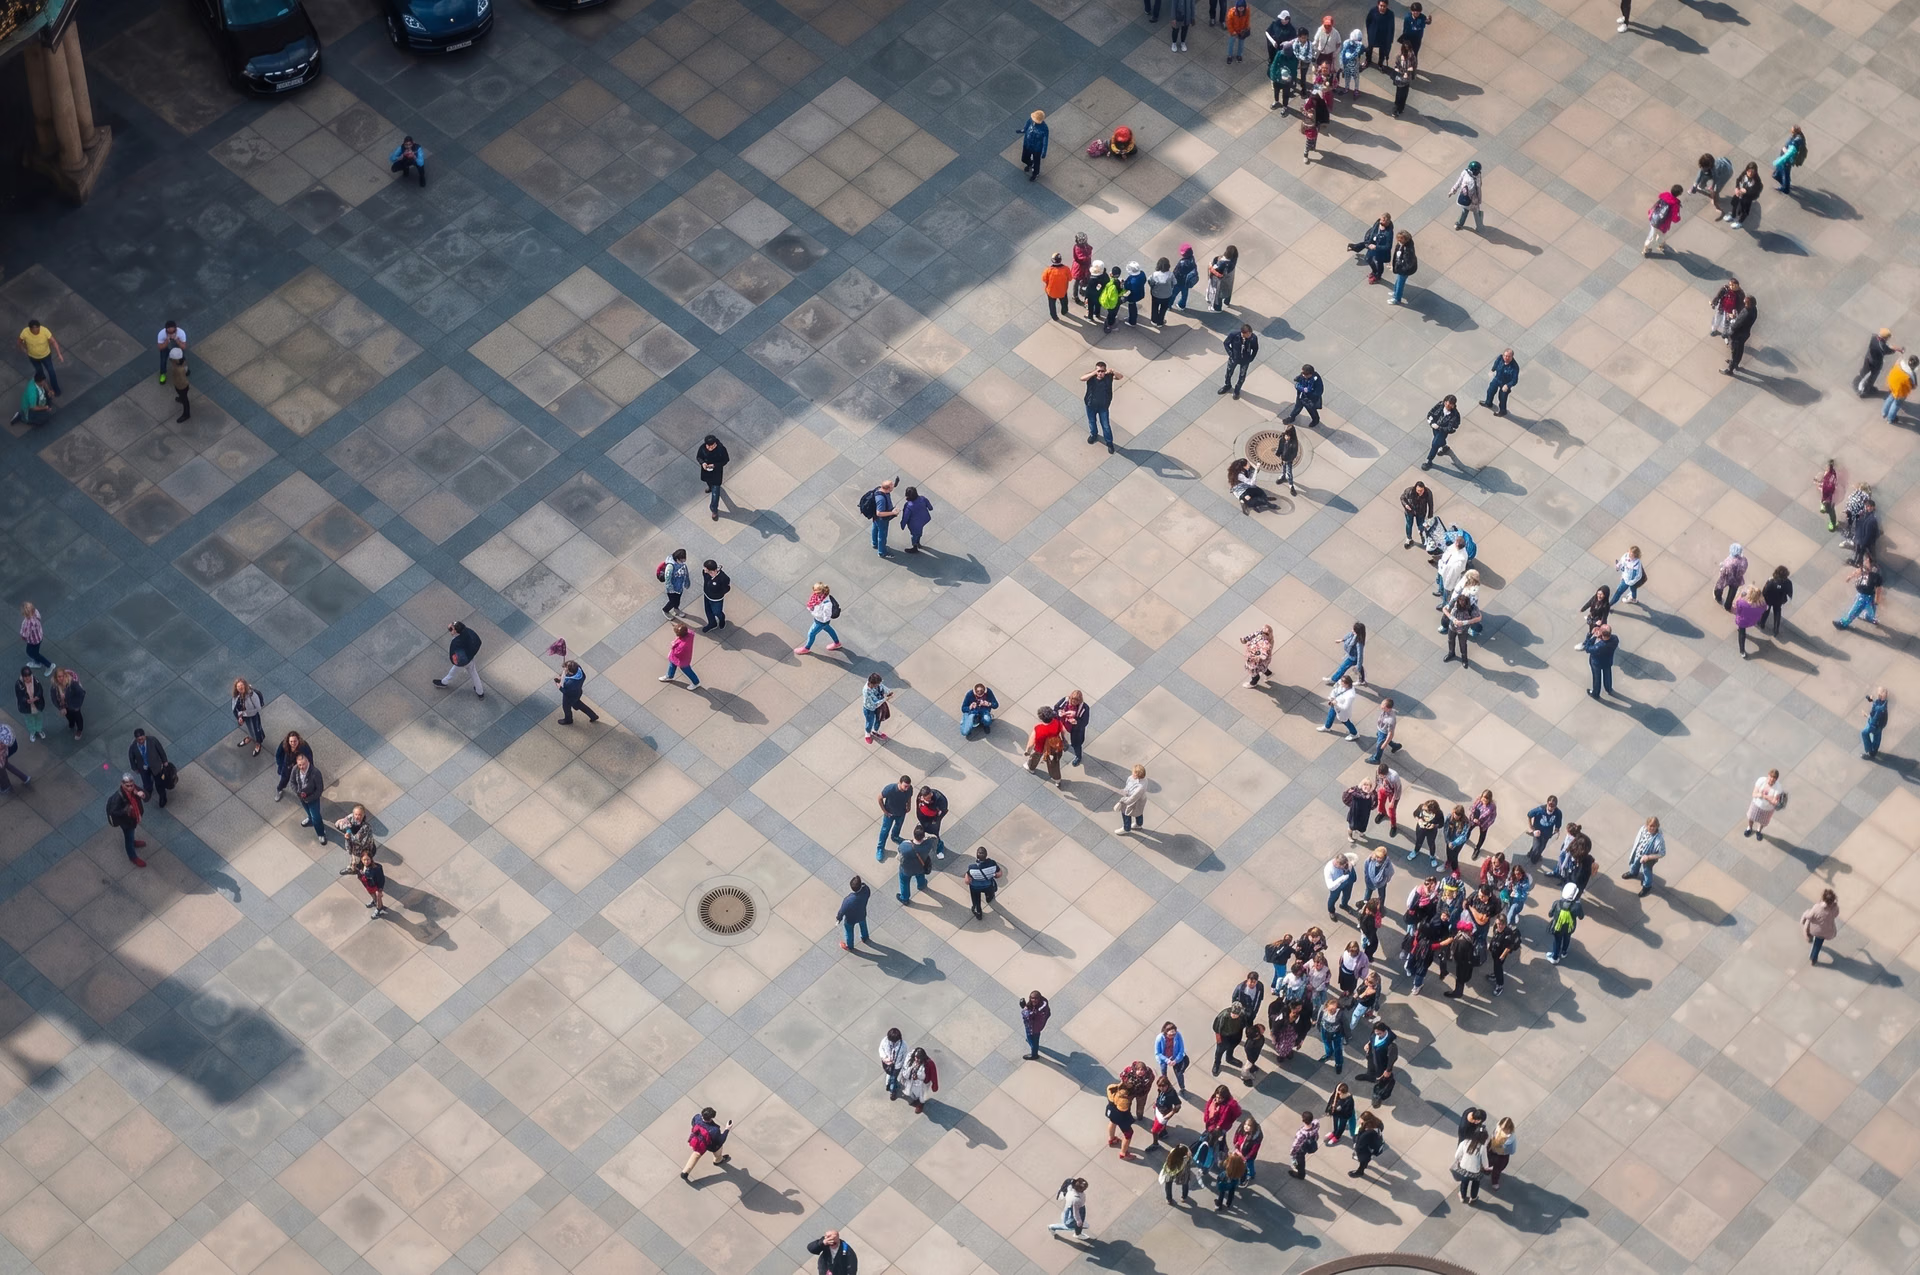
Mit visueller KI ausgestattete Drohnen können Hunderte Meter über dem Boden fliegen und sollen dennoch Personen erkennen, die im Videobild nur wenige Pixel groß sind. Das ist eine häufige Herausforderung in Bereichen wie Robotik, Überwachung und Fernerkundung, in denen Systeme sehr kleine Objekte in einem Bild identifizieren müssen.
Herkömmliche Objekterkennungsmodelle haben damit jedoch oft Schwierigkeiten. Kleine Objekte in Bildern und Videos bieten nur sehr wenige visuelle Informationen. Einfach gesagt: Wenn ein Modell sie betrachtet, gibt es nur wenige Details, aus denen es lernen oder die es erkennen kann.
Im Hintergrund verwenden diese Modelle typischerweise eine Architektur auf Basis eines Faltungsneuronalen Netzes (CNN). Bilder durchlaufen Netzwerkschichten und werden in Merkmalskarten oder vereinfachte Darstellungen umgewandelt, die relevante Muster statt der Rohpixel hervorheben.
Je tiefer das Bild durch das Netzwerk läuft, desto kleiner werden diese Merkmalskarten. Dadurch wird die Berechnung schneller, aber feine Details können auch verloren gehen.
Bei winzigen Objekten sind diese Details entscheidend. Gehen die Details verloren, kann ein Computer-Vision-Modell Schwierigkeiten haben, das Objekt zu erkennen, was zu weniger präzisen oder uneinheitlichen Begrenzungsrahmen führen kann.
Echtzeit-Computer-Vision-Systeme, die den gesamten Prozess abdecken, machen die Sache noch schwieriger. Bilder mit hoher Auflösung bewahren Details, verlangsamen aber die Inferenz und benötigen mehr GPU-Leistung. Niedrigere Auflösungen ermöglichen eine schnellere Verarbeitung, erschweren jedoch die Erkennung kleiner Objekte zusätzlich.
Dabei gilt es ständig, Geschwindigkeit, Genauigkeit und Hardwaregrenzen gegeneinander abzuwägen. Dank jüngster technologischer Fortschritte sind Computer-Vision-Modelle wie Ultralytics YOLO11 und das inzwischen veröffentlichte Ultralytics YOLO26 darauf ausgelegt, diesen Zielkonflikt wirksamer auszugleichen.
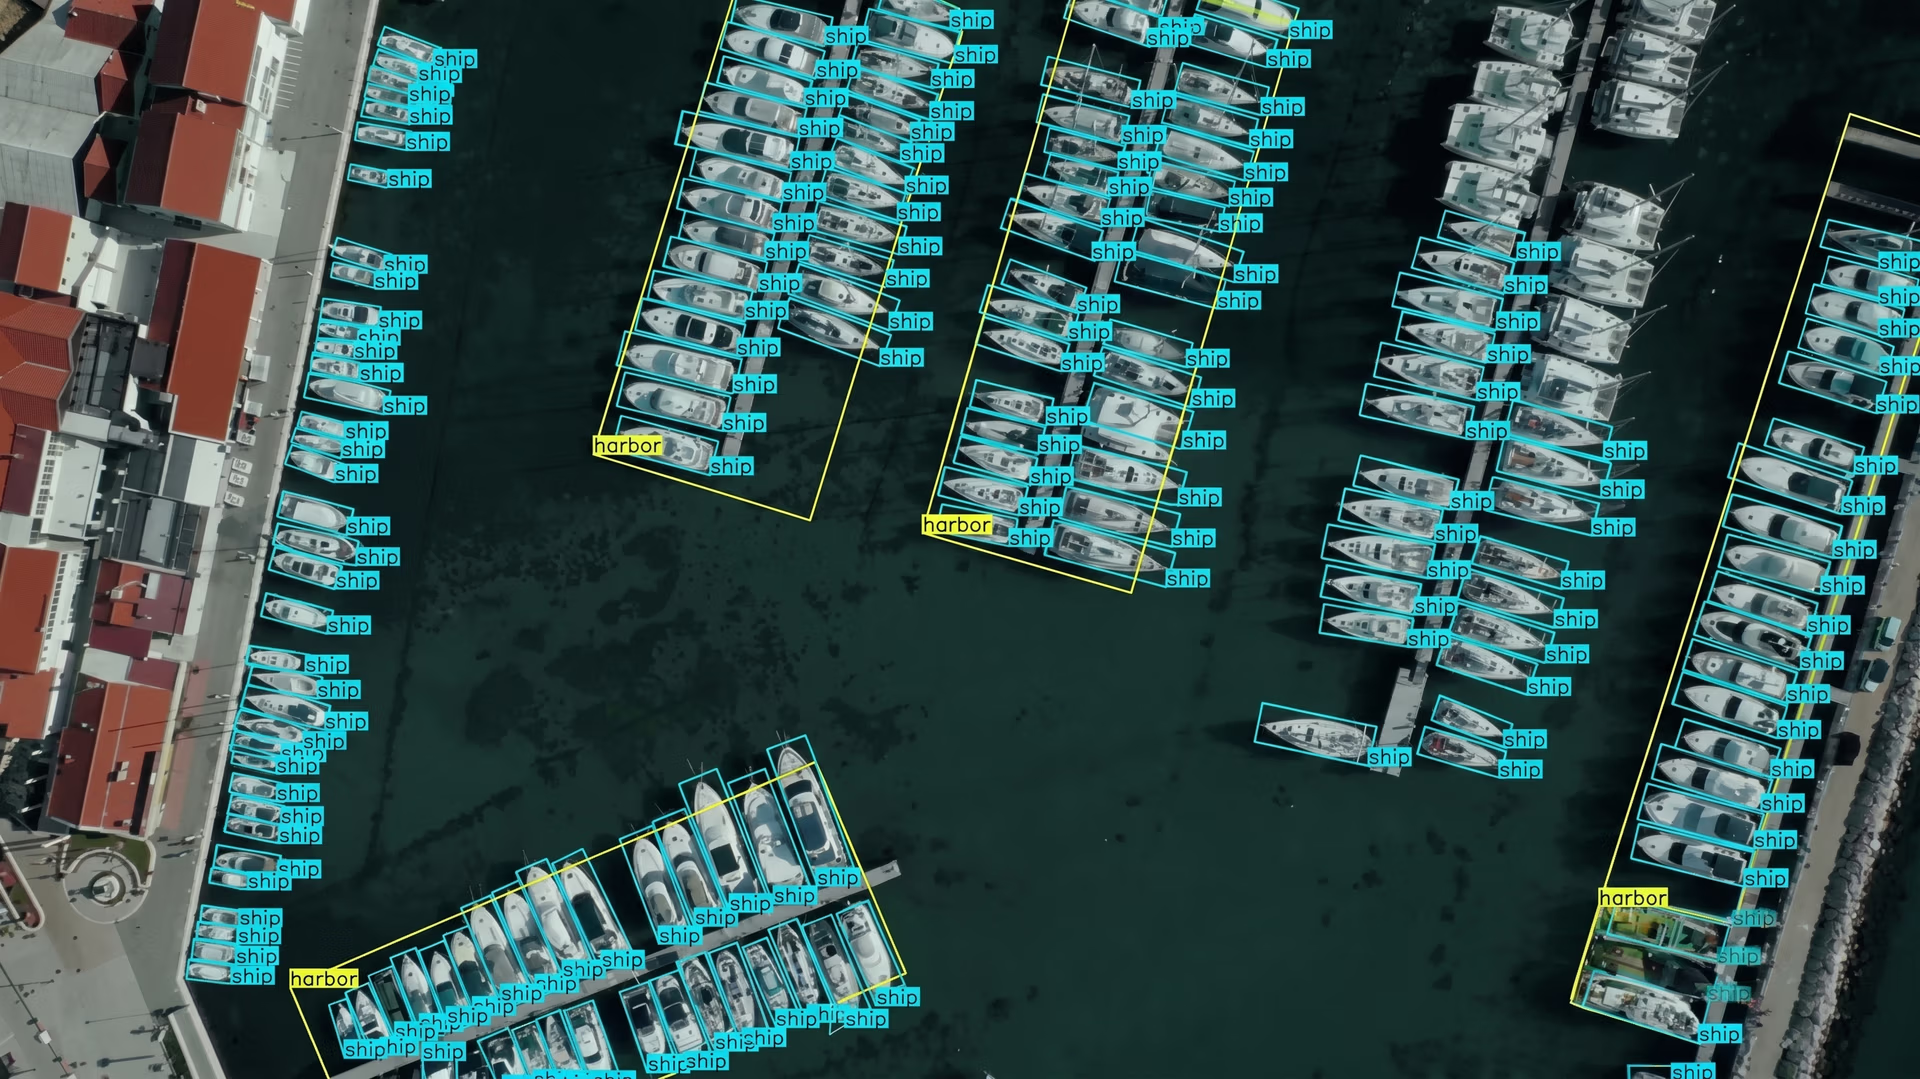
Abb. 1: Erkennung kleiner Objekte in Luftbildern mit YOLO11 (Quelle)
In diesem Artikel untersuchen wir, warum die Erkennung kleiner Objekte schwierig ist und wie Ultralytics YOLO11 sie erleichtern kann.
Was ist die Erkennung kleiner Objekte und warum ist sie wichtig?#
Die Erkennung kleiner Objekte ist eine Aufgabe der Computer Vision, einem Teilgebiet der KI. Sie konzentriert sich darauf, Objekte zu identifizieren und zu lokalisieren, die nur einen sehr kleinen Teil eines Bildes einnehmen. Diese Objekte werden im Bild oft durch eine begrenzte Anzahl von Pixeln dargestellt, den kleinsten Einheiten eines digitalen Bildes. Dadurch sind sie schwieriger zu erkennen als größere und deutlichere Ziele, die häufig mehr Pixel umfassen.
Fahrzeuge in Luftbildern, Werkzeuge in einer Fabrikhalle oder Personen, die von Weitwinkel-Überwachungskameras aufgenommen werden, können beispielsweise alle als kleine Objekte im Bild erscheinen. Ihre Erkennung ist wichtig, weil sie oft entscheidende Informationen enthalten und viele Anwendungen in der Praxis, etwa Überwachungssysteme, auf diese Erkennungen angewiesen sind, um korrekt zu funktionieren.
Werden kleine Objekte übersehen, kann das die Systemleistung und die Entscheidungsfindung beeinträchtigen. Die Überwachung mit unbemannten Luftfahrzeugen (UAV) ist ein gutes Beispiel: Wird ein kleines, sich am Boden bewegendes Objekt übersehen, kann das die Navigations- oder Verfolgungsgenauigkeit beeinträchtigen.
Herausforderungen bei der Erkennung kleiner Objekte#
Frühere Systeme verwendeten manuell entwickelte Merkmale und herkömmliche Computer-Vision-Verfahren, die in überladenen oder abwechslungsreichen Szenen Schwierigkeiten hatten. Auch heute, obwohl Deep-Learning-Modelle deutlich leistungsfähiger sind, bleibt die Erkennung kleiner Ziele schwierig, wenn sie nur einen winzigen Teil des Bildes einnehmen.
Sehen wir uns nun einige häufige Herausforderungen an, die bei der Erkennung kleiner Objekte in verschiedenen Situationen der Praxis auftreten.
Größe, Pixel und Informationsverlust#
Kleine Objekte bestehen aus sehr wenigen Pixeln. Dadurch stehen einem Modell in Phasen wie der Merkmalsextraktion nur wenige visuelle Details zum Lernen zur Verfügung. Muster wie Kanten, Formen und Texturen lassen sich deshalb schwieriger erkennen, sodass kleine Objekte eher mit dem Hintergrund verschmelzen.
Wenn Bilder die Faltungsschichten eines neuronalen Netzes durchlaufen, werden die visuellen Informationen der Pixel schrittweise zu Merkmalskarten komprimiert. Das sorgt für eine effiziente Verarbeitung, bedeutet aber auch, dass feine Details verblassen.
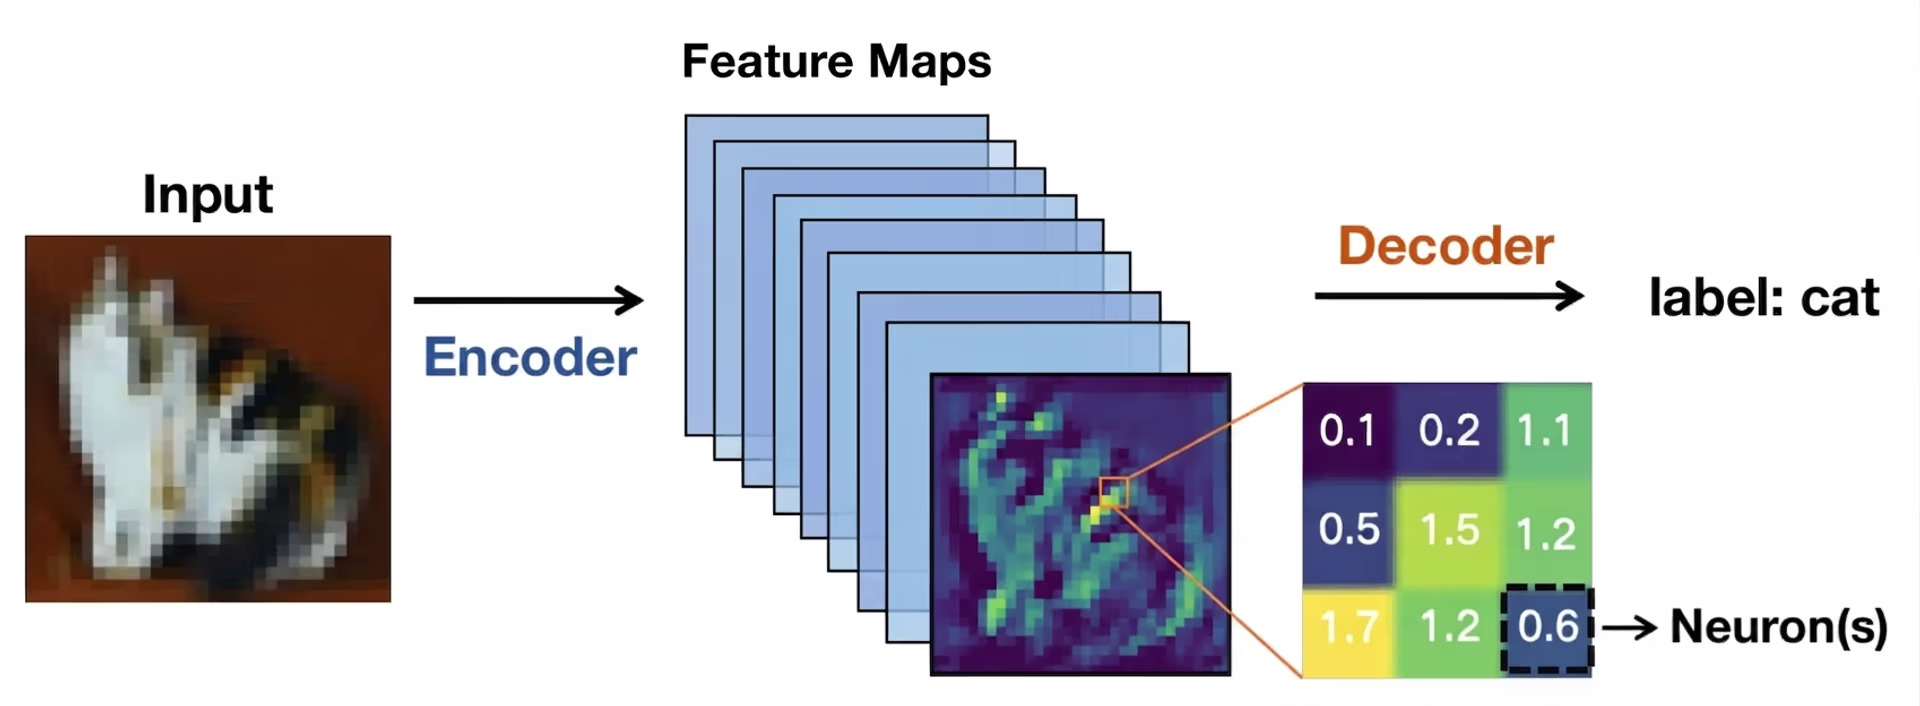
Abb. 2: Merkmalskarten stellen visuelle Muster in einem Bild dar (Quelle)
Bei kleinen Zielen können wichtige Hinweise verschwinden, bevor das Erkennungsnetzwerk überhaupt reagieren kann. Dann wird die Lokalisierung unzuverlässiger, und Begrenzungsrahmen können verrutschen, sich überlappen oder die Zielobjekte ganz verfehlen.
Verdeckung, Größenvariation und Kontext#
Herausforderungen im Zusammenhang mit der Größe entstehen oft auch durch Verdeckungen. Eine Verdeckung liegt vor, wenn Objekte – insbesondere kleinere – teilweise von anderen Objekten in der Szene verdeckt werden.
Dadurch ist weniger von einem Ziel sichtbar, was die dem Objektdetektor zur Verfügung stehenden Informationen einschränkt. Selbst eine geringfügige Verdeckung kann Erkennungsnetzwerke verwirren, insbesondere in Verbindung mit Eingabedaten niedriger Auflösung. Ein interessantes Beispiel dafür bieten UAV-Datensätze wie VisDrone, in denen Fußgänger, Fahrräder oder Fahrzeuge teilweise durch Gebäude, Bäume oder andere bewegte Objekte verdeckt sein können.
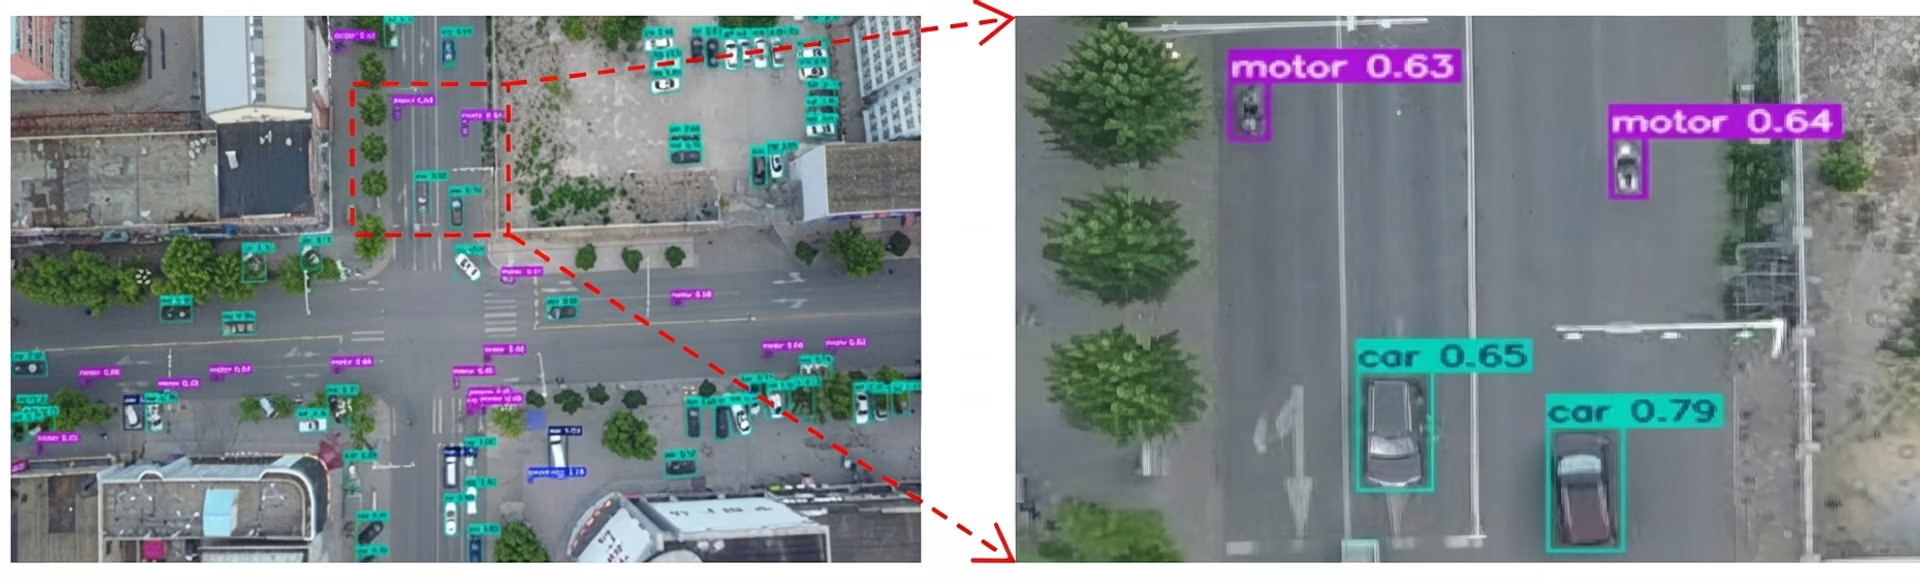
Abb. 3: Beispiel für kleine Objekte aus dem VisDrone-Datensatz (Quelle)
Auch Größenvariationen erschweren die Erkennung: Dasselbe Objekt kann je nach Entfernung und Kameraposition sehr klein oder relativ groß erscheinen. Trotz dieser Hürden müssen Erkennungsalgorithmen kleine Objekte in verschiedenen Größen erkennen, ohne an Genauigkeit zu verlieren.
Auch der Kontext spielt bei der Erkennung eine wichtige Rolle. Große Objekte erscheinen beispielsweise meist vor einer klar erkennbaren Umgebung, die hilfreiche visuelle Hinweise liefert. Kleine Ziele hingegen bieten oft nur wenige Kontextinformationen, was die Mustererkennung erschwert.
Das verborgene Metrikproblem bei der Erkennung kleiner Objekte#
Gängige Bewertungsmetriken wie Intersection over Union (IoU) messen, wie stark sich ein vorhergesagter Begrenzungsrahmen mit dem Referenzrahmen überlappt. IoU funktioniert bei größeren Objekten gut, verhält sich bei kleinen Objekten jedoch ganz anders.
Kleine Objekte nehmen nur wenige Pixel ein. Schon eine geringfügige Verschiebung des vorhergesagten Rahmens kann daher einen großen relativen Fehler verursachen und den IoU-Wert deutlich senken. Das bedeutet, dass kleine Objekte den üblichen IoU-Schwellenwert, anhand dessen eine Vorhersage als korrekt gilt, oft nicht erreichen – selbst wenn das Objekt im Bild sichtbar ist.
Infolgedessen werden Lokalisierungsfehler eher als falsch positive oder falsch negative Ergebnisse eingestuft. Diese Einschränkungen haben Forschende dazu veranlasst, die Bewertung und Verarbeitung kleiner, schwer erkennbarer Ziele durch Objekterkennungssysteme zu überdenken.
Merkmale auf mehreren Maßstabsebenen: der Schlüssel zur Echtzeiterkennung kleiner Objekte#
Als Forschende daran arbeiteten, die Erkennung kleiner Objekte zu verbessern, wurde deutlich, dass es entscheidend ist, visuelle Informationen über mehrere Maßstäbe hinweg zu erhalten und darzustellen. Diese Erkenntnis spiegelt sich in aktuellen Forschungsarbeiten auf arXiv und in Beiträgen wider, die auf Veranstaltungen wie IEEE International Conferences und der European Conference on Computer Vision (ECCV) vorgestellt wurden.
Je tiefer Bilder ein neuronales Netz durchlaufen, desto mehr Details kleiner Objekte können verloren gehen oder ganz verschwinden. Deshalb legen moderne Computer-Vision-Modelle wie Ultralytics YOLO11 großen Wert auf eine verbesserte Merkmalsextraktion. Sehen wir uns nun die grundlegenden Konzepte hinter Merkmalskarten und Merkmals-Pyramidennetzwerken an, um sie besser zu verstehen.
Merkmalskarten und Darstellung auf mehreren Maßstabsebenen#
Wenn ein Eingabebild, etwa ein Fernerkundungsbild, in ein neuronales Netz gelangt, wird es schrittweise in Merkmalskarten umgewandelt. Dabei handelt es sich um vereinfachte Darstellungen des Bildes, die visuelle Muster wie Kanten, Formen und Texturen hervorheben.
Je tiefer das Netzwerk wird, desto kleiner wird die räumliche Größe der Merkmalskarten. Diese Verkleinerung sorgt für eine effiziente Verarbeitung und hilft dem Modell, sich auf übergeordnete Informationen zu konzentrieren. Durch die Verkleinerung und die Tiefe der Merkmalskarten gehen jedoch auch räumliche Details verloren.
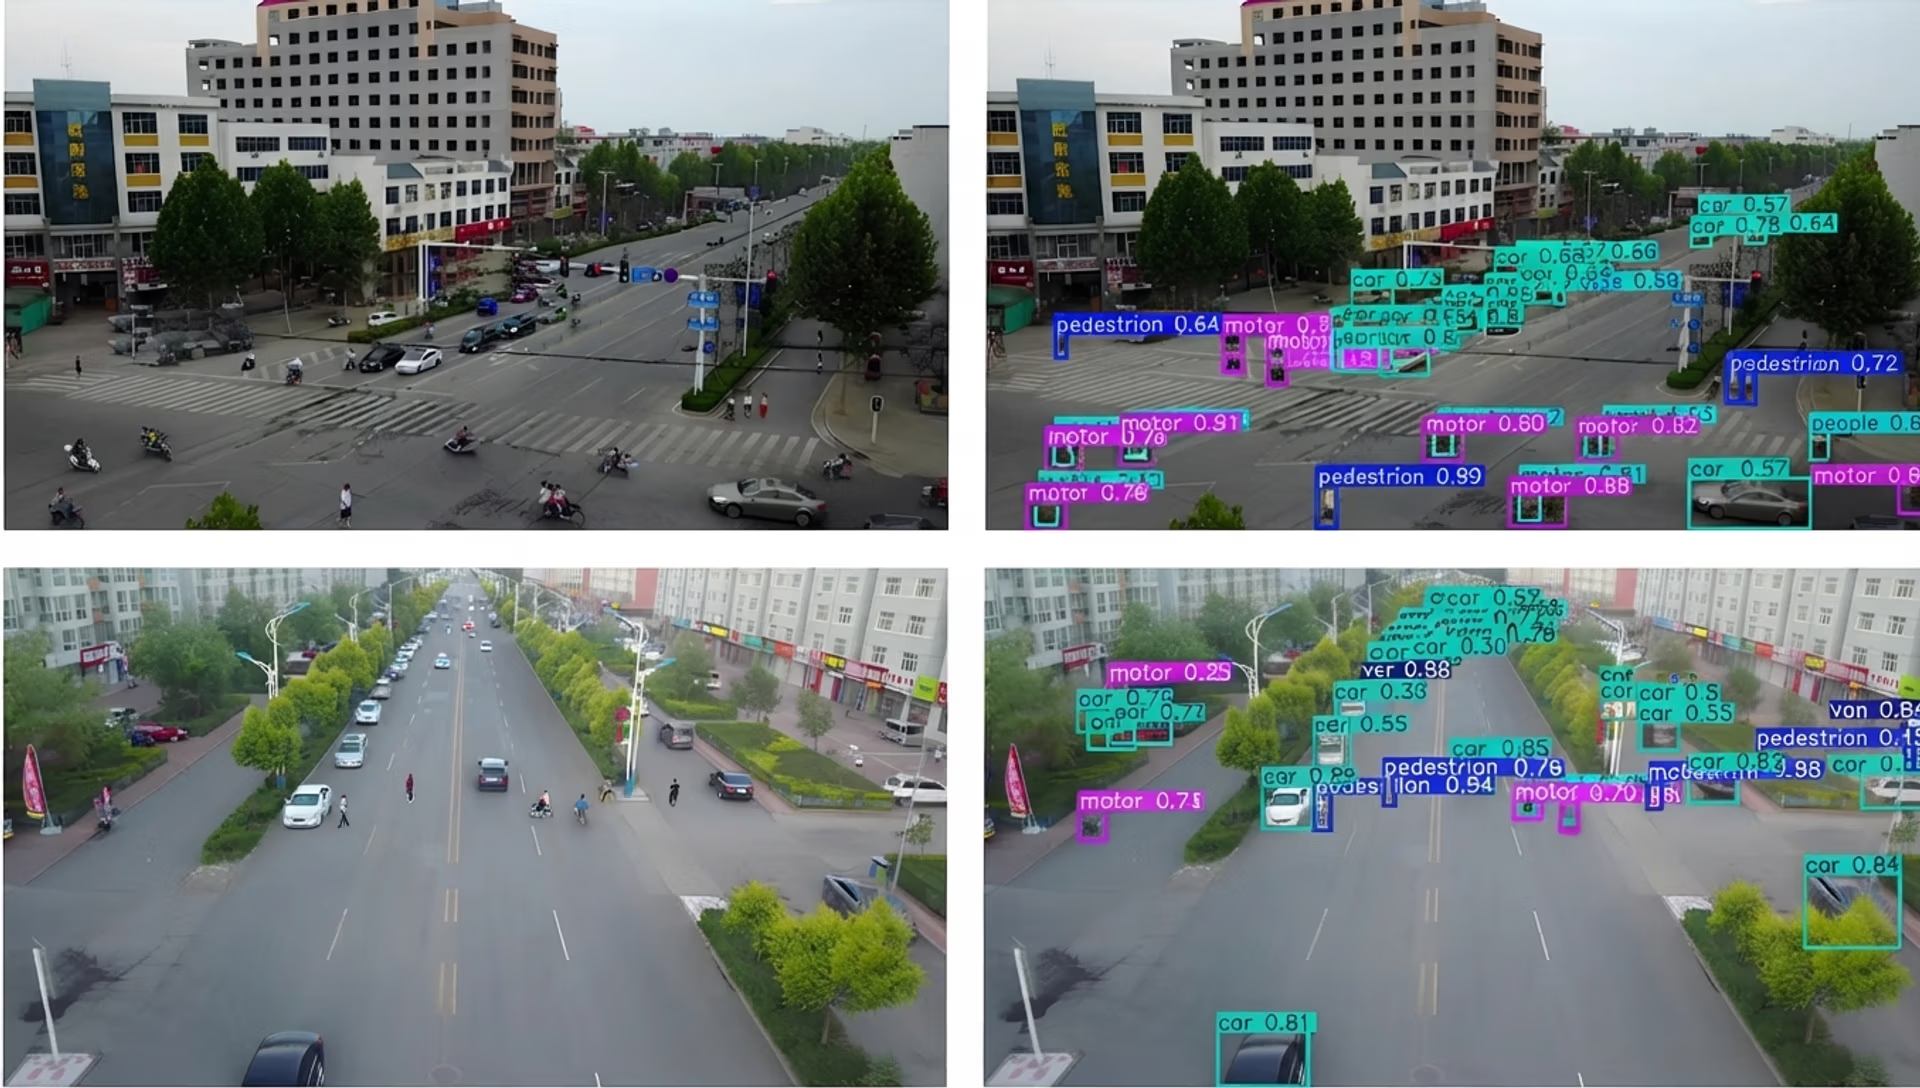
Abb. 4: Merkmalsextraktion ist entscheidend für die Erkennung kleiner Objekte. (Quelle)
Große Objekte behalten genügend visuelle Informationen für eine genaue Erkennung, doch kleine Ziele können bereits nach wenigen Netzwerkschichten entscheidende Details verlieren. In diesem Fall erkennt ein Modell möglicherweise nicht einmal, dass ein kleines Objekt vorhanden ist. Das ist einer der Hauptgründe, warum kleine Objekte in tiefen Objekterkennungsmodellen übersehen werden.
Merkmals-Pyramidennetzwerke und Lernen auf mehreren Maßstabsebenen#
Merkmals-Pyramidennetzwerke, oft als FPN bezeichnet, wurden entwickelt, um den Verlust räumlicher Details auszugleichen. Als unterstützendes Modul kombinieren sie Informationen aus mehreren Schichten, damit Modelle kleine Objekte effektiver erkennen können. Dieser Prozess wird auch Merkmalsaggregation und Merkmalsfusion genannt.
Flache Schichten liefern feine räumliche Details, während tiefere Schichten semantischen Kontext hinzufügen. So wird ein effektives Lernen von Merkmalen auf mehreren Maßstabsebenen ermöglicht. Im Gegensatz zum naiven Hochskalieren, bei dem Merkmalskarten lediglich vergrößert werden, bewahrt FPN aussagekräftige Informationen und verbessert die Erkennung kleiner Objekte.
Moderne Ansätze bauen auf dieser Idee auf und verbessern die Erkennung kleiner Ziele zusätzlich durch adaptive Merkmalsfusion und kontextbezogene Architekturen. Anders gesagt: FPN hilft Modellen, gleichzeitig das Gesamtbild und kleinste Details zu erfassen. Diese Optimierung ist wichtig, wenn Objekte klein sind.
Wie sich Objekterkennungsmodelle für den Umgang mit kleinen Objekten weiterentwickelt haben#
Hier ein kurzer Überblick darüber, wie sich Objekterkennungsmodelle im Laufe der Zeit weiterentwickelt haben, um Objekte unterschiedlicher Größe – auch sehr kleine – besser zu erkennen:
- Frühe Erkennungsverfahren: Frühe Ansätze zur Objekterkennung stützten sich auf manuell entwickelte Merkmale und regelbasierte Algorithmen aus der klassischen Bildverarbeitung. Da diese Merkmale fest vorgegeben waren, nahm die Leistung bei unterschiedlichen Bildern ab.
- Einführung von maschinellem Lernen und Deep Learning: Die Einführung von maschinellem Lernen und Deep Learning markierte einen grundlegenden Wandel in der Forschung zur Objekterkennung. Statt sich auf vorgegebene Regeln zu stützen, lernten neuronale Netze visuelle Repräsentationen direkt aus Trainingsdaten. Dadurch konnten sie sich besser an unterschiedliche Objektgrößen und Szenen anpassen.
- Faltungsnetze: Diese neuronalen Netze lernen, Muster in Bildern zu erkennen. Jede Schicht erfasst andere Details: Zuerst einfache Kanten und Farben, dann Formen und schließlich ganze Objekte. Damit sind sie für die moderne Computer Vision unverzichtbar.
- Zweistufige Objektdetektoren: Zweistufige Detektoren wie Faster R-CNN, vorgestellt von Ren et al., erzeugten zunächst mögliche Regionen und klassifizierten diese anschließend. Dieser Ansatz verbesserte die Genauigkeit bei kleinen Objekten, erhöhte jedoch den Rechenaufwand und verringerte die Echtzeitfähigkeit.
- Einstufige Objektdetektoren: Einstufige Detektoren wie SSD (Ein-Schuss-Detektor) und die YOLO-Familie (You Only Look Once), darunter YOLOv3, Ultralytics YOLOv5 und das spätere Ultralytics YOLOv8, führen die Erkennung in einem einzigen Durchlauf aus. Dieses Design verbessert die Inferenzgeschwindigkeit deutlich und bietet zugleich eine konkurrenzfähige Genauigkeit.
- Aktuelle Spitzenmodelle: Neuere Objekterkennungsmodelle legen mehr Wert auf Echtzeitleistung und den Einsatz am Netzwerkrand. Aktuelle Ultralytics-YOLO-Modellversionen wie Ultralytics YOLO11 und Ultralytics YOLO26 sind darauf ausgelegt, hohe Genauigkeit mit geringer Inferenzlatenz zu verbinden. Dadurch eignen sie sich gut zur Erkennung von Objekten jeder Größe, auch kleiner Ziele, auf Geräten mit begrenzter Rechenleistung.
Ultralytics YOLO11 für Anwendungsfälle zur Erkennung kleiner Objekte#
Nachdem wir nun besser verstehen, wie die Erkennung kleiner Objekte funktioniert, sehen wir uns einige Anwendungen aus der Praxis an, für die sich Ultralytics YOLO11 einsetzen lässt.
UAVs und Luftbildaufnahmen#
Stell dir eine Drohne vor, die hoch über einer belebten Straße in der Stadt fliegt. Aus dieser Höhe schrumpfen Autos, Fahrräder und sogar Menschen auf wenige Pixel auf dem Bildschirm.
Module für UAVs und Luftbildaufnahmen erfassen oft solche Szenen, in denen die interessierenden Objekte winzig und von unübersichtlichen Hintergründen umgeben sind. Dadurch sind sie für Computer-Vision-Modelle schwer zu erkennen.
In solchen Szenarien kann Ultralytics YOLO11 eine ideale Modellwahl sein. Eine mit einem Modell wie YOLO11 ausgestattete Drohne, das anhand von Luftbilddatensätzen wie VisDrone feinabgestimmt wurde, könnte beispielsweise den Verkehr in Echtzeit überwachen und Fahrzeuge, Radfahrer sowie Fußgänger erkennen, während sie sich durch die Szene bewegen – selbst wenn jedes Objekt nur einen kleinen Teil des Bildes einnimmt. Das ermöglicht schnellere Entscheidungen und genauere Erkenntnisse für Anwendungen wie Verkehrsmanagement, öffentliche Sicherheit oder Stadtplanung.
Robotik und Automatisierung#
Roboter kommen oft in Umgebungen zum Einsatz, in denen Genauigkeit und Timing entscheidend sind. In Lagerhallen, Fabriken und auf landwirtschaftlichen Betrieben muss ein Roboter möglicherweise sehr kleine Objekte erkennen, etwa ein Bauteil am Fließband, ein Etikett auf einem Paket oder einen kleinen Pflanzentrieb auf einem Feld, und schnell darauf reagieren.
Objekte dieser Größe zu erkennen, kann schwierig sein – insbesondere, wenn sie im Kamerabild nur aus wenigen Pixeln bestehen oder teilweise von anderen Objekten verdeckt werden. Werden diese kleinen Details übersehen, kann das die Automatisierung verlangsamen oder die Fähigkeit des Roboters beeinträchtigen, eine Aufgabe abzuschließen.
Ultralytics YOLO11 kann in solchen Situationen einen Unterschied machen. Die verbesserte Merkmalsextraktion und die schnelle Inferenz ermöglichen es Robotern, kleine Objekte in Echtzeit zu erkennen und sofort zu handeln.
Ultralytics YOLO11 unterstützt außerdem die Instanzsegmentierung. Dadurch können Roboter Objektgrenzen und Greifpunkte präziser bestimmen, anstatt nur allgemeine Begrenzungsrahmen zu lokalisieren. Ein mit YOLO11 integrierter Roboterarm könnte beispielsweise kleine Bauteile auf einem Förderband erkennen, ihre genaue Form segmentieren und sie greifen, bevor sie außer Reichweite geraten. So bleibt das System effizient und zuverlässig.
Was Ultralytics YOLO11 bei der Erkennung kleiner Objekte so leistungsfähig macht#
Bei der großen Auswahl an Computer-Vision-Modellen fragst du dich vielleicht, wodurch sich Ultralytics YOLO11 auszeichnet.
Hier sind einige Gründe, warum Ultralytics YOLO11 eine gute Wahl für Anwendungen ist, bei denen kleine Objekte erkannt werden müssen:
- Verbesserte Merkmalsextraktion: YOLO11 verwendet eine verbesserte Backbone- und Neck-Architektur, um die Merkmalsextraktion zu optimieren und so eine präzisere Objekterkennung zu ermöglichen.
- Ökosystem und einfache Bedienung: Das Ultralytics-Python-Paket ist eine Bibliothek mit integrierten Funktionen zum Laden, Trainieren, Validieren und Bereitstellen von Modellen wie YOLO11. Da diese Arbeitsabläufe nur wenige Codezeilen benötigen, können Teams schnell experimentieren und Modelle für die Erkennung kleiner Objekte feinabstimmen.
- Für den Einsatz auf Edge-Geräten optimiert: Ultralytics YOLO11 läuft effizient auf Edge-Geräten wie NVIDIA Jetson, Raspberry Pi und industriellen Kamerasystemen. Einfach gesagt: Damit lassen sich Aufgaben im Bereich Vision AI direkt auf dem Gerät in Echtzeit ausführen.
Bewährte Strategien für die Erkennung kleiner Objekte mit Ultralytics YOLO11#
Neben dem Einsatz eines Modells wie Ultralytics YOLO11 können auch die Vorbereitung deiner Annotationen, der gesamte Datensatz und das Modelltraining einen erheblichen Unterschied bei der Erkennungsleistung bewirken. Während der Inferenz kann außerdem die gekachelte Inferenz mit SAHI dabei helfen, sehr kleine Objekte in hochauflösenden Bildern zu erkennen.
Hier ein kurzer Überblick, worauf du achten solltest:
- Sinnvolle Datenerweiterung: Eine moderate Datenerweiterung, etwa durch Skalieren oder Zuschneiden, kann dem Modell helfen, auf neue Bilder zu verallgemeinern. Eine aggressive Erweiterung mit starken Größenänderungen kann kleine Objekte jedoch verzerren oder entfernen und dem Modell das Lernen erschweren.
- Fehlerfälle untersuchen: Analysen dazu, wo das Modell Objekte übersieht oder falsch identifiziert, helfen dabei, eine Ausgangsbasis zu schaffen und festzustellen, ob die Probleme auf den Datensatz, den Informationsverlust bei der Merkmalsextraktion oder notwendige Anpassungen der Trainingseinstellungen zurückzuführen sind.
- Zusammensetzung des Datensatzes: Dein Datensatz sollte genügend Beispiele kleiner Objekte enthalten, damit das Modell aussagekräftige Muster lernen kann. Er sollte außerdem ausgewogen bleiben, damit größere Objekte kleinere während des Trainings nicht in den Hintergrund drängen.
Die wichtigsten Erkenntnisse#
Die Erkennung kleiner Objekte ist schwierig, weil kleine Ziele Details verlieren, während Bilder ein Computer-Vision-Modell durchlaufen. Ultralytics YOLO11 verbessert die Bewahrung dieser Details und macht die Erkennung kleiner Objekte zuverlässiger, ohne die Echtzeitleistung zu beeinträchtigen. Dank dieser ausgewogenen Leistung eignet sich YOLO11 für eine genaue und effiziente Erkennung in Anwendungen der Praxis.
Werde Teil unserer wachsenden Community! In unserem GitHub-Repository erfährst du mehr über KI. Entdecke auf unseren Lösungsseiten Innovationen wie Computer Vision im Einzelhandel und KI in der Automobilindustrie. Wenn du noch heute mit Computer Vision loslegen möchtest, sieh dir unsere Lizenzoptionen an.
Verfasst von
Content Creator · Ultralytics
Kommentare
Stelle eine Frage, teile deine Ergebnisse oder hilf anderen.









