Ein Blick auf die Claude 3 Model Card: Was sie für Vision-KI bedeutet
Entdecke die Modellkarte von Claude 3 und ihre Auswirkungen auf die Entwicklung von Vision-KI.
In den vergangenen Jahren hat die visuelle KI große Fortschritte gemacht und Branchen von der Gesundheitsversorgung bis zum Einzelhandel revolutioniert. Um diese Fortschritte wirksam nutzen zu können, ist es wichtig, die zugrunde liegenden Modelle und ihre Dokumentation zu verstehen. Eine wichtige Ressource im Werkzeugkasten von Entwicklern im Bereich der künstlichen Intelligenz (AI) ist die Modellkarte, die einen umfassenden Überblick über die Eigenschaften und die Leistung eines KI-Modells bietet.
In diesem Artikel betrachten wir die von Anthropic entwickelte Modellkarte zu Claude 3 und ihre Bedeutung für die Entwicklung visueller KI. Claude 3 ist eine neue Familie großer multimodaler Modelle mit drei Varianten: Claude 3 Opus, das leistungsfähigste Modell; Claude 3 Sonnet, das Leistung und Geschwindigkeit ausgewogen kombiniert; und Claude 3 Haiku, die schnellste und kostengünstigste Option. Alle Modelle verfügen nun über visuelle Fähigkeiten, mit denen sie Bilddaten verarbeiten und analysieren können.
Überblick über die Modellkarte zu Claude 3#
Was genau ist eine Modellkarte? Eine Modellkarte ist ein ausführliches Dokument, das Einblicke in die Entwicklung, das Training und die Bewertung eines maschinellen Lernmodells bietet. Sie soll Transparenz, Verantwortlichkeit und den ethischen Einsatz von KI fördern, indem sie klare Informationen über die Funktionsweise des Modells, vorgesehene Anwendungsfälle und mögliche Einschränkungen bereitstellt. Dazu können detaillierte Angaben zum Modell gemacht werden, etwa zu seinen Bewertungskennzahlen sowie zu Vergleichen mit früheren Modellen und anderen Konkurrenzmodellen.
Bewertungskennzahlen#
Bewertungskennzahlen sind entscheidend, um die Leistung eines Modells zu beurteilen. Die Modellkarte zu Claude 3 führt Kennzahlen wie Genauigkeit, Präzision, Trefferquote und F1-Wert auf und vermittelt so ein klares Bild von den Stärken und Verbesserungsmöglichkeiten des Modells. Diese Kennzahlen werden anhand von Branchenstandards verglichen und zeigen die konkurrenzfähige Leistung von Claude 3.
Darüber hinaus baut Claude 3 auf den Stärken seiner Vorgängermodelle auf und integriert Fortschritte bei Architektur und Trainingstechniken. Die Modellkarte vergleicht Claude 3 mit früheren Versionen und hebt Verbesserungen bei Genauigkeit, Effizienz und Eignung für neue Anwendungsfälle hervor.
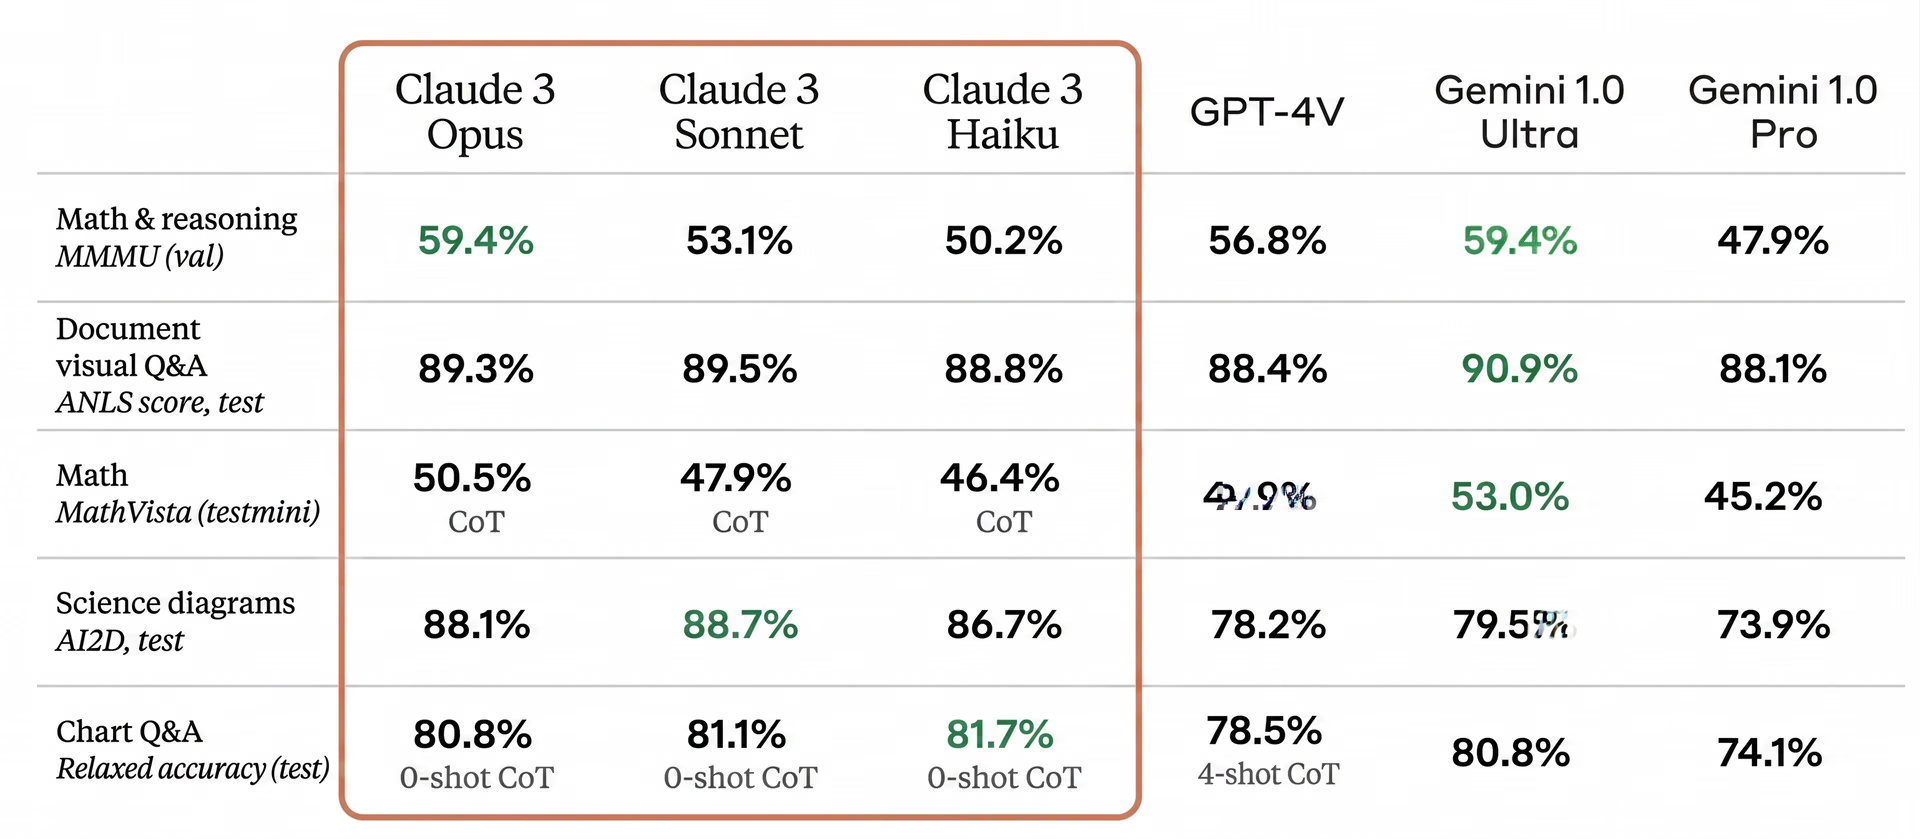
Abb. 1. Tabelle zum Vergleich von Claude-3-Modellen mit anderen Modellen bei verschiedenen Aufgaben.
Wie wirkt sich Claude 3 auf die Entwicklung visueller KI aus?#
Die Architektur und der Trainingsprozess von Claude 3 sorgen für zuverlässige Ergebnisse bei verschiedenen Aufgaben der natürlichen Sprachverarbeitung (NLP) und visuellen Aufgaben. Das Modell erzielt bei Benchmarks durchgehend starke Ergebnisse und beweist damit, dass es komplexe Sprachanalysen effektiv durchführen kann.
Das Training von Claude 3 mit vielfältigen Datensätzen und der Einsatz von Datenerweiterungsverfahren sorgen für Robustheit und ermöglichen die Verallgemeinerung auf unterschiedliche Szenarien. Dadurch ist das Modell vielseitig und für ein breites Spektrum an Anwendungen geeignet.
Obwohl die Ergebnisse bemerkenswert sind, handelt es sich bei Claude 3 im Kern um ein großes Sprachmodell (LLM). Große Sprachmodelle (LLMs) wie Claude 3 können zwar verschiedene Aufgaben der Computer Vision bewältigen, wurden jedoch nicht speziell für Aufgaben wie Objekterkennung, Erstellung von Begrenzungsrahmen und Bildsegmentierung entwickelt. Daher erreichen sie in diesen Bereichen möglicherweise nicht die Genauigkeit von Modellen, die eigens für Computer Vision entwickelt wurden, etwa Ultralytics YOLOv8. Dennoch sind große Sprachmodelle in anderen Bereichen besonders leistungsfähig. Das gilt vor allem für die natürliche Sprachverarbeitung (NLP), in der Claude 3 seine Stärken ausspielt, indem es einfache visuelle Aufgaben mit menschlichem Schlussfolgern verbindet.
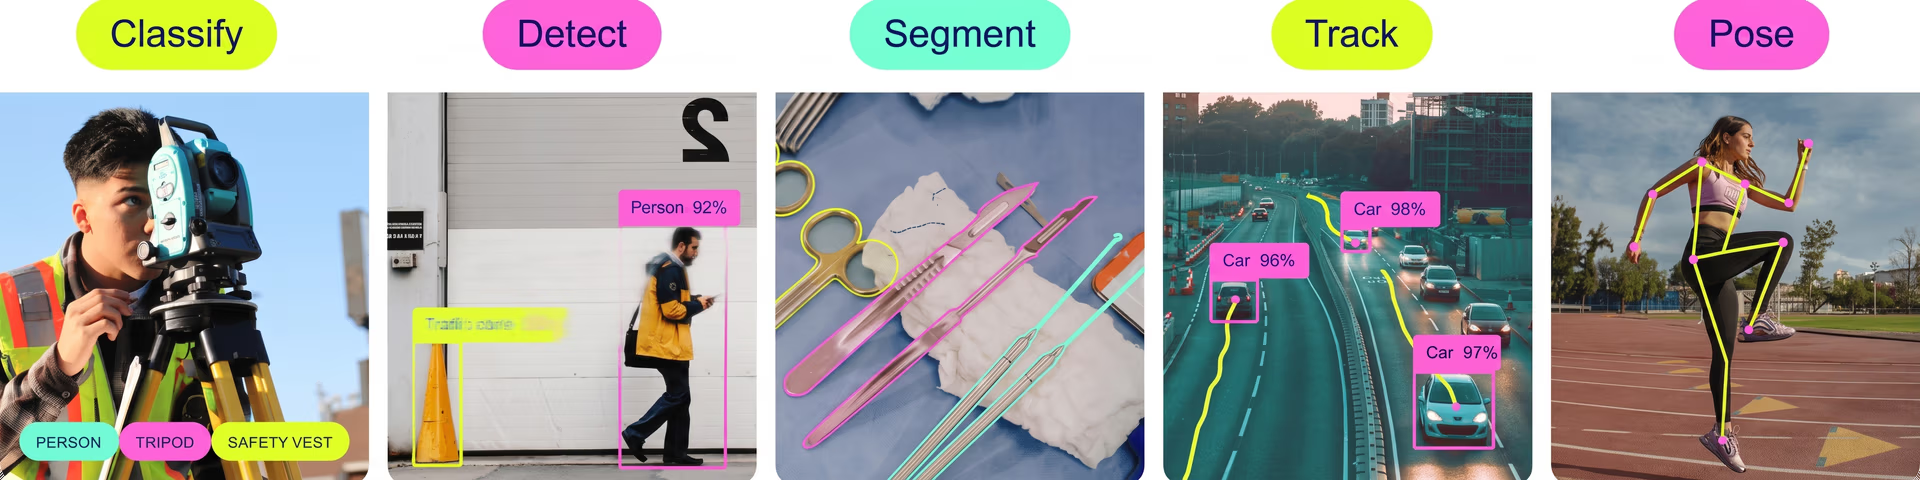
Abb. 2: Überblick über Klassifizierung, Erkennung, Segmentierung, Verfolgung und Posenschätzung von Objekten mit Ultralytics YOLOv8.
Fähigkeiten in der natürlichen Sprachverarbeitung (NLP) bezeichnen die Fähigkeit eines KI-Modells, menschliche Sprache zu verstehen und darauf zu reagieren. Claude 3 nutzt diese Fähigkeit in visuellen Anwendungsbereichen umfassend: Das Modell kann kontextreiche Beschreibungen liefern, komplexe visuelle Daten interpretieren und die Gesamtleistung bei Aufgaben der visuellen KI verbessern.
Bilder in Text umwandeln#
Eine der beeindruckenden Fähigkeiten von Claude 3, insbesondere bei Aufgaben der visuellen KI, ist die Verarbeitung und Umwandlung von Bildern mit geringer Qualität und schwer lesbarer Handschrift in Text. Diese Funktion verdeutlicht die fortschrittliche Verarbeitungsleistung und die Fähigkeiten des Modells zum multimodalen Schlussfolgern. In diesem Abschnitt untersuchen wir, wie Claude 3 diese Aufgabe bewältigt, und beleuchten die zugrunde liegenden Mechanismen sowie die Bedeutung für die Entwicklung visueller KI.
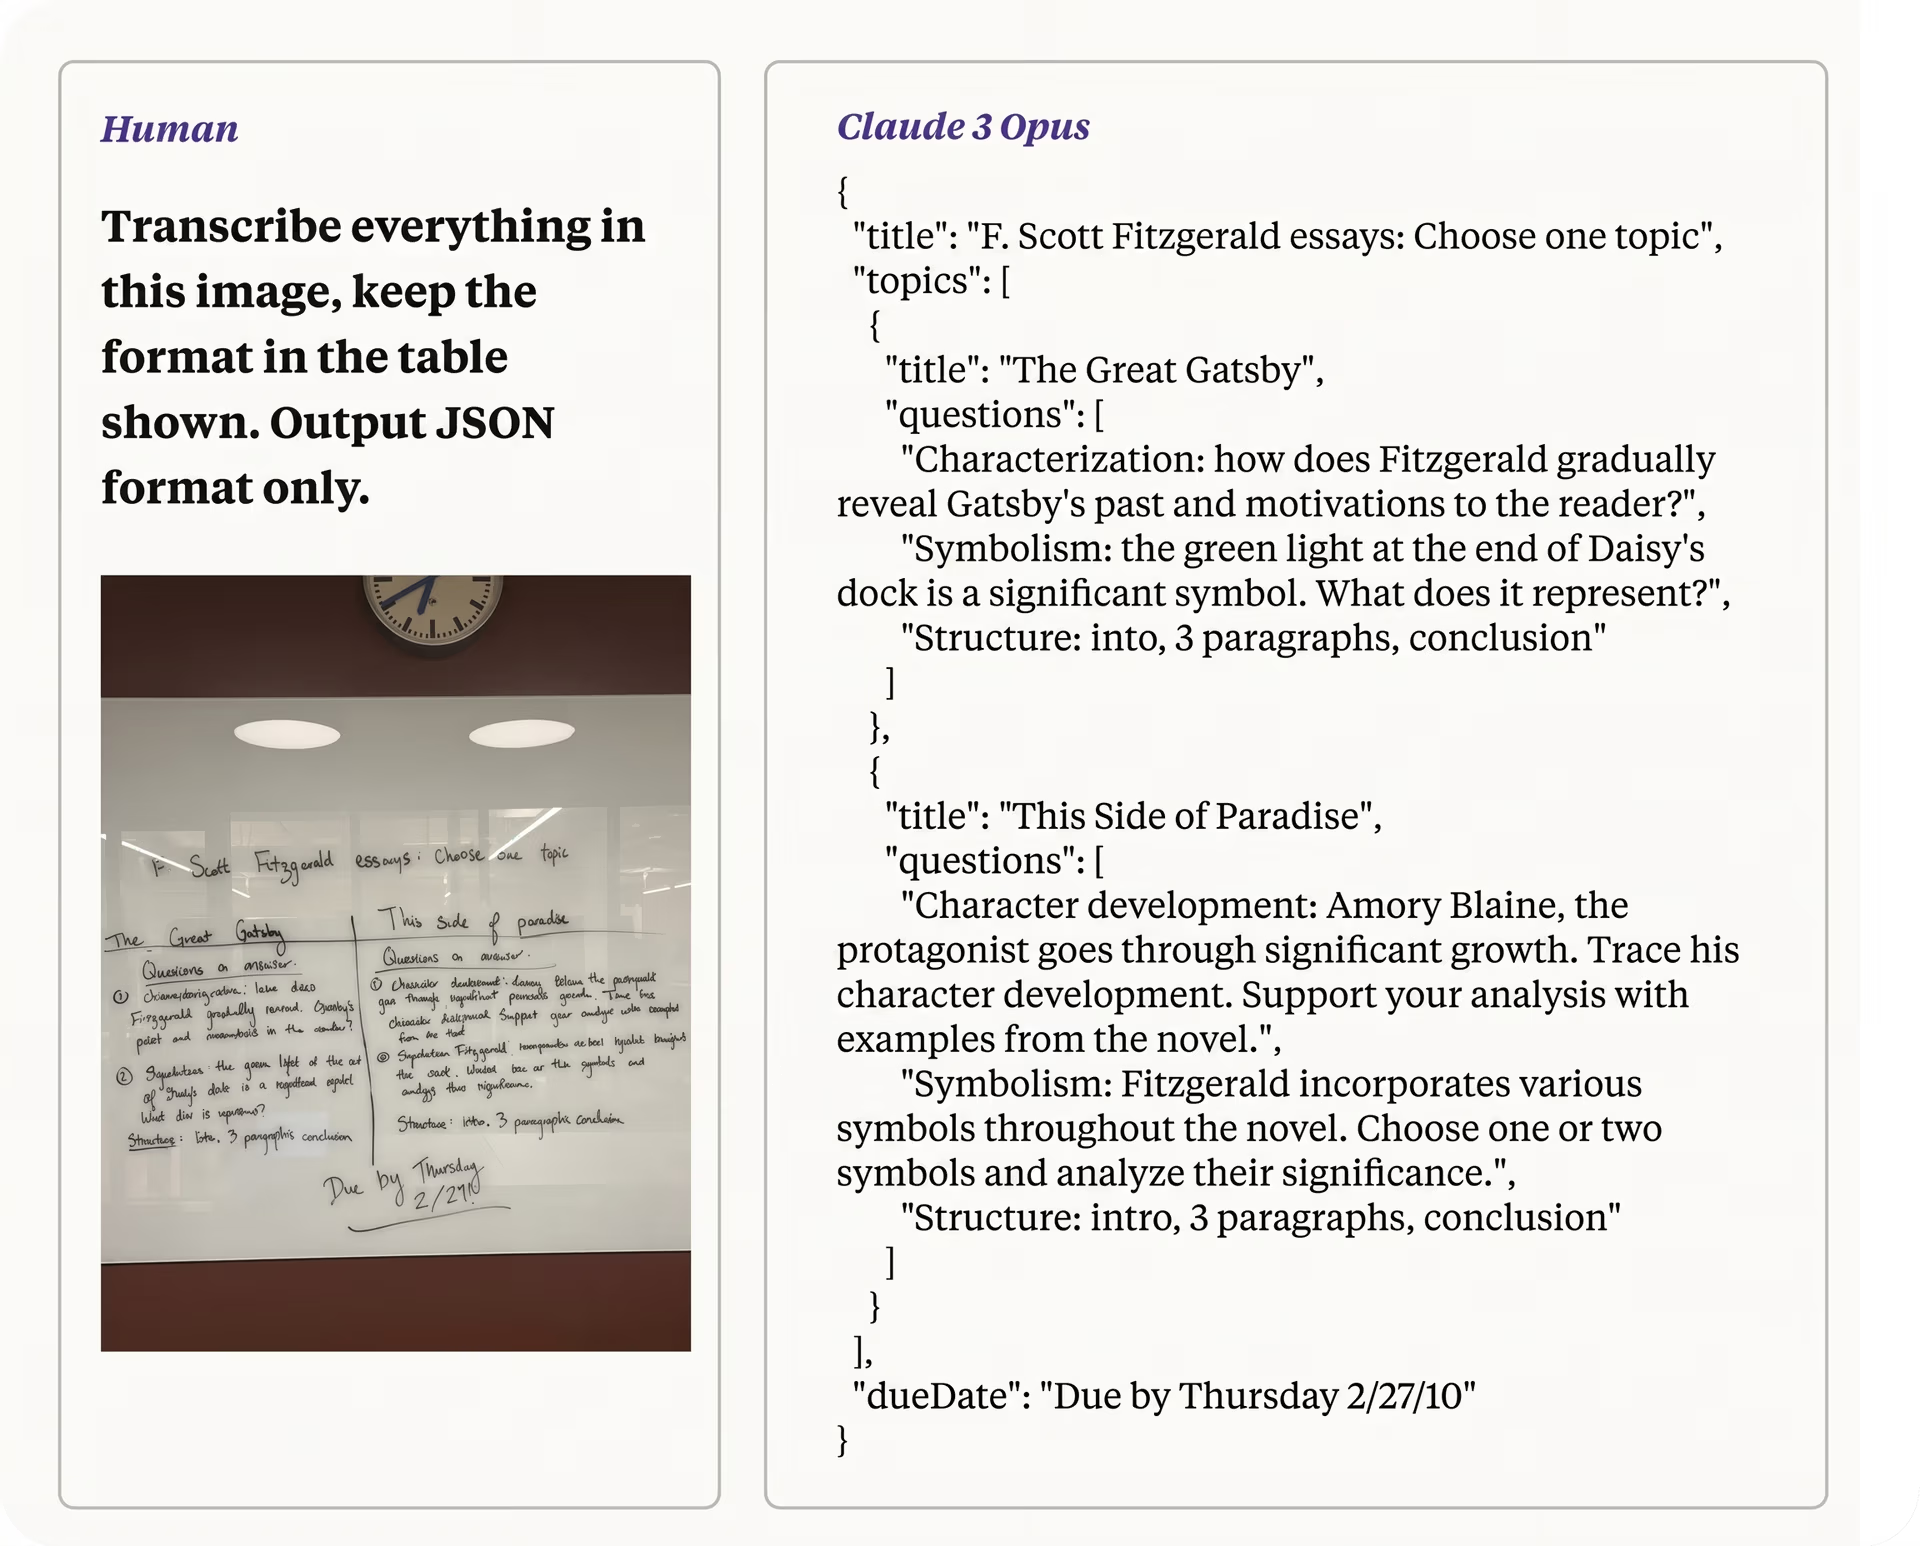
Abb. 3. Claude 3 Opus wandelt ein Foto geringer Qualität mit schwer lesbarer Handschrift in Text um.
Die Herausforderung verstehen#
Die Umwandlung eines Fotos geringer Qualität mit schwer lesbarer Handschrift in Text ist eine komplexe Aufgabe, bei der mehrere Herausforderungen zu bewältigen sind:
- Bildqualität: Eine niedrige Auflösung, Bildrauschen und schlechte Lichtverhältnisse können Details im Bild verdecken.
- Variabilität der Handschrift: Handschriften unterscheiden sich zwischen einzelnen Personen erheblich. Dadurch fällt es Modellen schwer, den Text zu erkennen und zu interpretieren.
- Kontextverständnis: Für die präzise Umwandlung von Handschrift in Text muss der Kontext verstanden werden, um Mehrdeutigkeiten aufzulösen.
Wie bereits erwähnt, begegnen Claude-3-Modelle diesen Herausforderungen mit einer Kombination fortschrittlicher Verfahren aus Computer Vision und natürlicher Sprachverarbeitung (NLP).
Schlussfolgern anhand visueller Daten (multimodal)#
Die Architektur von Claude 3 ermöglicht komplexes Schlussfolgern anhand visueller Eingaben. Wie in Abbildung 1 gezeigt, kann das Modell beispielsweise Diagramme und Grafiken interpretieren, etwa die G7-Länder in einer Grafik zur Internetnutzung identifizieren, relevante Daten extrahieren und Berechnungen zur Analyse von Trends durchführen. Solche mehrstufigen Schlussfolgerungen – zum Beispiel die Berechnung statistischer Unterschiede bei der Internetnutzung verschiedener Altersgruppen – verbessern die Genauigkeit und den Nutzen des Modells in realen Anwendungen.
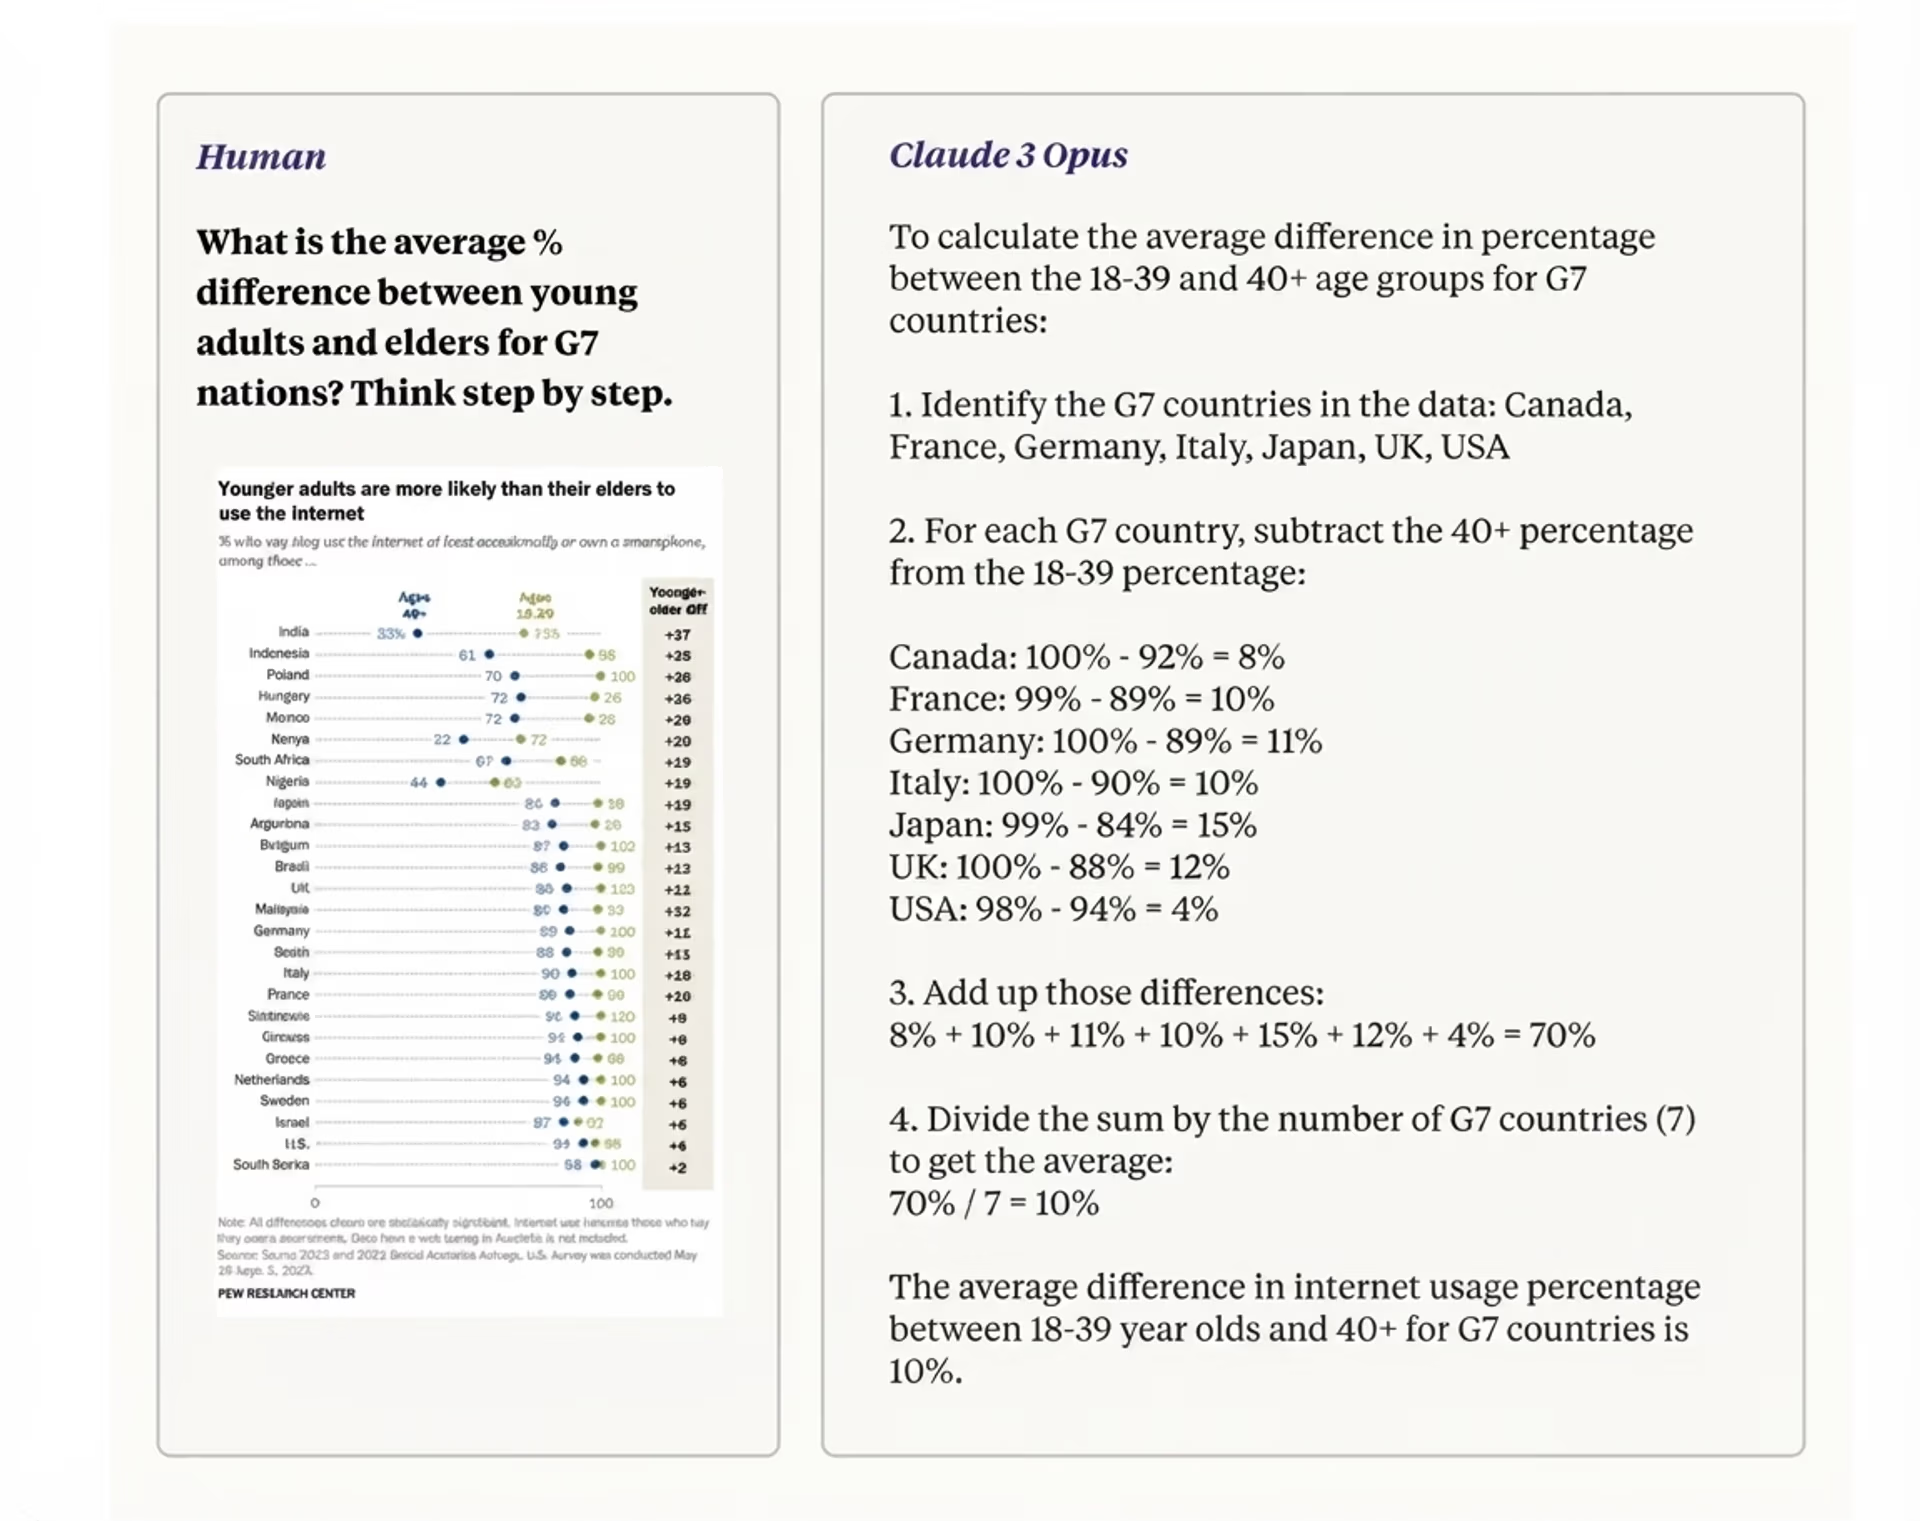
Abb. 4. Claude 3 Opus führt mehrere Schlussfolgerungen anhand eines visuellen Diagramms durch.
Bilder beschreiben#
Claude 3 kann Bilder hervorragend in detaillierte Beschreibungen umwandeln und stellt damit seine leistungsstarken Fähigkeiten in den Bereichen Computer Vision und natürliche Sprachverarbeitung unter Beweis. Bei der Eingabe eines Bildes nutzt Claude 3 zunächst faltende neuronale Netze (CNNs), um wichtige Merkmale zu extrahieren und Objekte, Muster sowie kontextuelle Elemente in den visuellen Daten zu erkennen.
Anschließend analysieren Transformer-Schichten diese Merkmale und nutzen Aufmerksamkeitsmechanismen, um Beziehungen und Zusammenhänge zwischen verschiedenen Bildelementen zu erfassen. Dank dieses multimodalen Ansatzes kann Claude 3 präzise, kontextreiche Beschreibungen erstellen: Das Modell erkennt nicht nur Objekte, sondern versteht auch ihre Wechselwirkungen und ihre Bedeutung innerhalb der Szene.
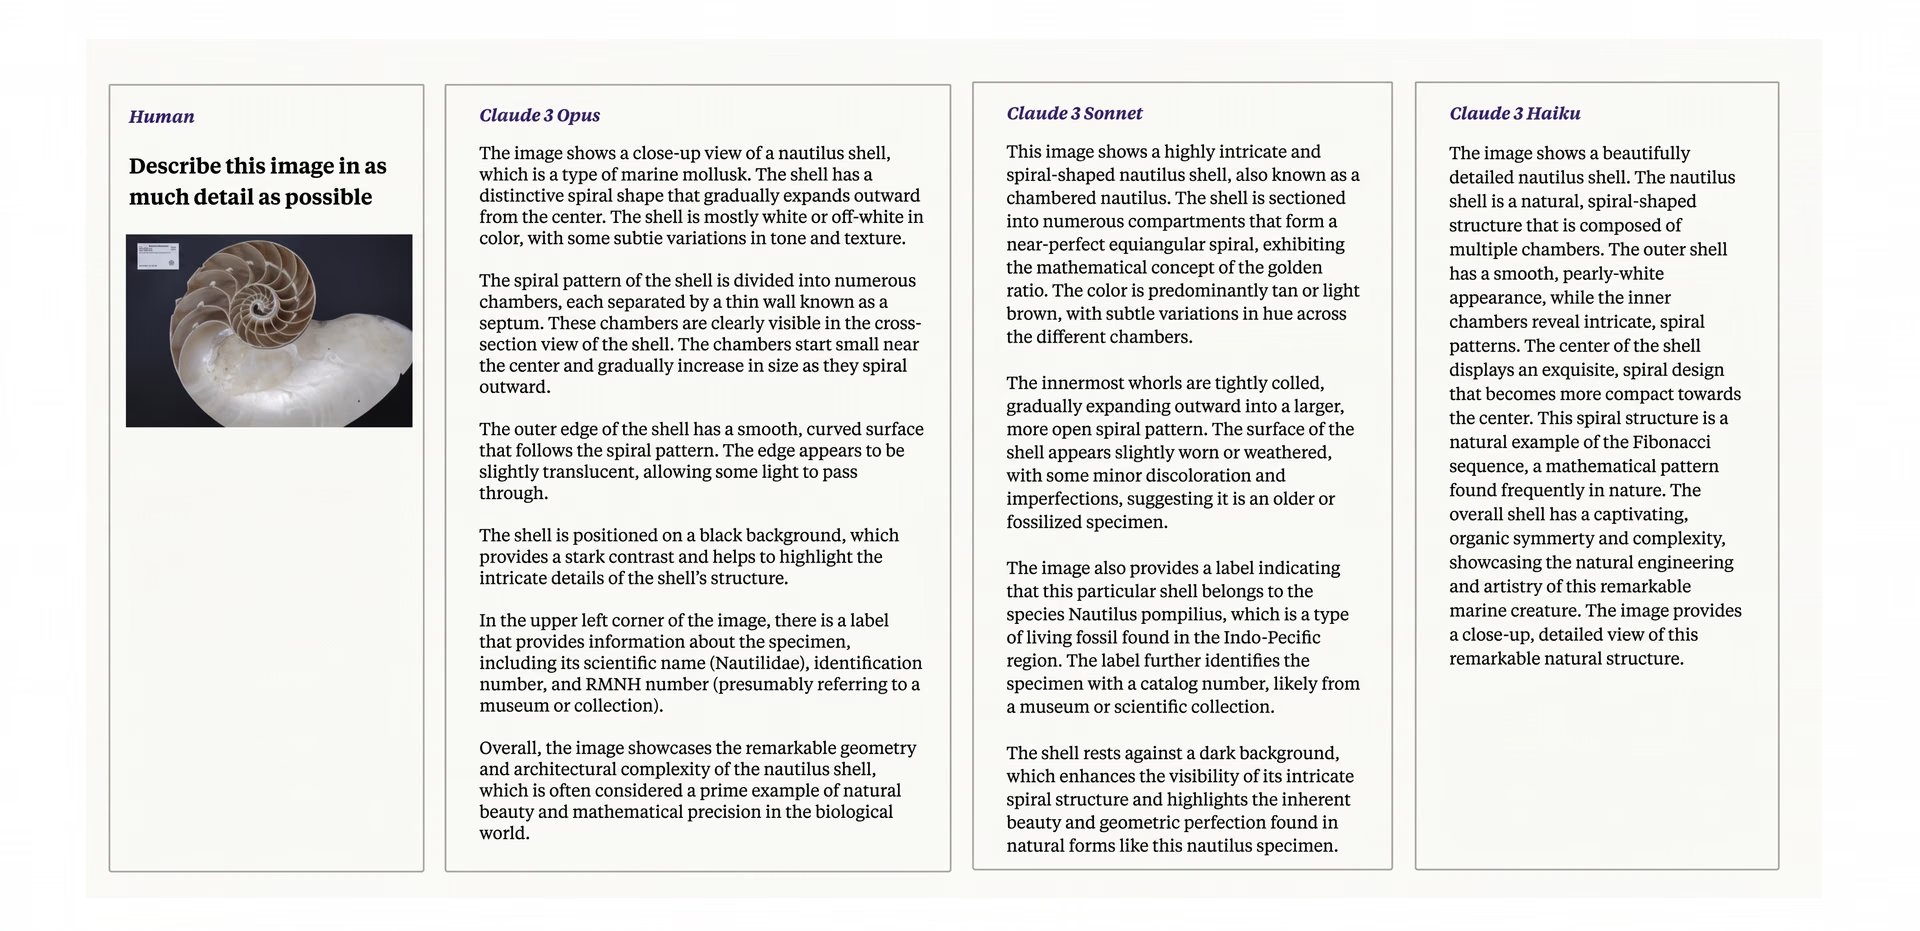
Abb. 5. Claude-3-Modelle erkennen visuelle Objekte in einem Bild und beschreiben sie in verständlicher Sprache.
Herausforderungen und Rückschläge bei Claude-3-Modellen in der Computer Vision#
Nicht auf Computer Vision ausgerichtet#
Große Sprachmodelle (LLMs) wie Claude 3 zeichnen sich durch die Verarbeitung natürlicher Sprache aus, nicht durch Computer Vision. Sie können zwar Bilder beschreiben, aber Aufgaben wie Objekterkennung und Bildsegmentierung lassen sich besser mit auf visuelle Aufgaben ausgerichteten Modellen wie Ultralytics YOLOv8 lösen. Diese spezialisierten Modelle sind für visuelle Aufgaben optimiert und bieten eine bessere Leistung bei der Analyse von Bildern. Darüber hinaus kann das Modell keine Aufgaben wie das Erstellen von Begrenzungsrahmen ausführen.
Komplexität der Integration#
Die Kombination von Claude 3 mit Computer-Vision-Systemen kann komplex sein und zusätzliche Verarbeitungsschritte erfordern, um die Lücke zwischen Text- und visuellen Daten zu überbrücken.
Einschränkungen der Trainingsdaten#
Claude 3 wird hauptsächlich mit großen Mengen an Textdaten trainiert. Daher fehlen dem Modell die umfangreichen visuellen Datensätze, die für eine hohe Leistung bei Computer-Vision-Aufgaben erforderlich sind. Claude 3 kann zwar Texte sehr gut verstehen und generieren, verfügt aber nicht über die Fähigkeit, Bilder zu analysieren – zumindest nicht mit der gleichen Leistungsfähigkeit wie Modelle, die speziell für visuelle Daten entwickelt wurden. Diese Einschränkung macht Claude 3 weniger geeignet für Anwendungen, bei denen visuelle Inhalte interpretiert oder generiert werden müssen.
Das zukünftige Potenzial von Claude 3 im Bereich Vision-KI#
Wie andere große Sprachmodelle wird auch Claude 3 kontinuierlich weiterentwickelt. Künftige Verbesserungen werden sich wahrscheinlich auf visuelle Aufgaben wie Bilderkennung und Objekterkennung sowie auf Fortschritte bei der Verarbeitung natürlicher Sprache konzentrieren. Dadurch lassen sich Objekte und Szenen sowie ähnliche Inhalte präziser und detaillierter beschreiben.
Schließlich wird die laufende Forschung zu Claude 3 darauf ausgerichtet sein, die Interpretierbarkeit zu verbessern, Verzerrungen zu verringern und die Generalisierungsfähigkeit über verschiedene Datensätze hinweg zu erhöhen. Diese Maßnahmen sollen eine robuste Leistung des Modells in unterschiedlichen Anwendungen sicherstellen und Vertrauen in seine Ergebnisse schaffen.
Abschließende Gedanken#
Die Modellkarte von Claude 3 ist eine wertvolle Ressource für Entwickler und andere Beteiligte im Bereich Vision-KI. Sie bietet detaillierte Einblicke in die Architektur, Leistung und ethischen Aspekte des Modells. Indem sie Transparenz und Verantwortlichkeit fördert, trägt sie zu einem verantwortungsvollen und effektiven Einsatz von KI-Technologien bei. Mit der Weiterentwicklung von Vision-KI werden Modellkarten wie die von Claude 3 eine entscheidende Rolle dabei spielen, die Entwicklung zu lenken und Vertrauen in KI-Systeme zu schaffen.
Wir bei Ultralytics setzen uns mit Leidenschaft für die Weiterentwicklung der KI-Technologie ein. Entdecke unsere KI-Lösungen und bleib über unsere neuesten Innovationen auf dem Laufenden: Besuche unser GitHub-Repository. Werde Teil unserer Community auf Discord und erfahre, wie wir Branchen wie selbstfahrende Autos und die Fertigung verändern! 🚀









