Warum Annotationen mit menschlicher Beteiligung entscheidend sind
Erfahre, wie von Menschen annotierte Daten die Genauigkeit von Computer-Vision-Modellen verbessern und warum menschliches Fachwissen für zuverlässige Systeme visueller KI weiterhin unverzichtbar ist.
 Abirami Vina9 Min. Lesezeit
Vor zwanzig Jahren hätte es ziemlich abwegig geklungen, wenn jemand gesagt hätte, er überlege, sich einen Roboter für die Hausarbeit anzuschaffen. Doch wir erleben gerade den KI-Boom, und Roboter werden in ähnlichen Szenarien getestet.
Ein wichtiges KI-Forschungsgebiet, das diesen Fortschritt vorantreibt, ist Computer Vision, das Maschinen die Fähigkeit verleiht, Bilder und Videos zu verstehen. Anders ausgedrückt: Computer-Vision-Modelle wie Ultralytics YOLO11 und das neuere Ultralytics YOLO26 können mit Datensätzen trainiert werden, die aus visuellen Daten und Annotationen bestehen.
Diese Annotationen helfen dem Modell, die visuellen Daten zu verstehen. Bei Datensätzen zur Objekterkennung markieren beispielsweise Begrenzungsrahmen Objekte von Interesse mit Rechtecken. Dadurch kann das Modell diese Objekte in neuen Bildern erkennen und lokalisieren, selbst wenn die Szene unübersichtlich oder das Objekt teilweise verdeckt ist.
Andere Computer-Vision-Aufgaben beruhen auf unterschiedlichen Arten von Annotationen. Bei Segmentierungsdatensätzen wird die genaue Kontur eines Objekts auf Pixelebene markiert, während Keypoint-Datensätze bestimmte Orientierungspunkte wie Gelenke einer Person kennzeichnen.
Bei all diesen Formaten sind jedoch Qualität und Einheitlichkeit der Labels entscheidend. Modelle lernen direkt aus den Daten, mit denen sie trainiert werden. Sind die Labels also uneinheitlich oder falsch, übernimmt das Modell diese Fehler häufig in seine Vorhersagen.
Auch bei automatisierten Verfahren bleiben von Menschen annotierte Datensätze entscheidend, insbesondere in Bereichen mit hohem Risiko wie der medizinischen Bildgebung. Kleine Fehler bei der Annotation, etwa eine ungenaue Tumorgrenze oder eine übersehene Auffälligkeit, können dem Modell ein falsches Muster beibringen und später zu unsicheren Vorhersagen führen. Fachleute liefern die korrekten Referenzdaten und das Urteilsvermögen, die diese Anwendungen erfordern.
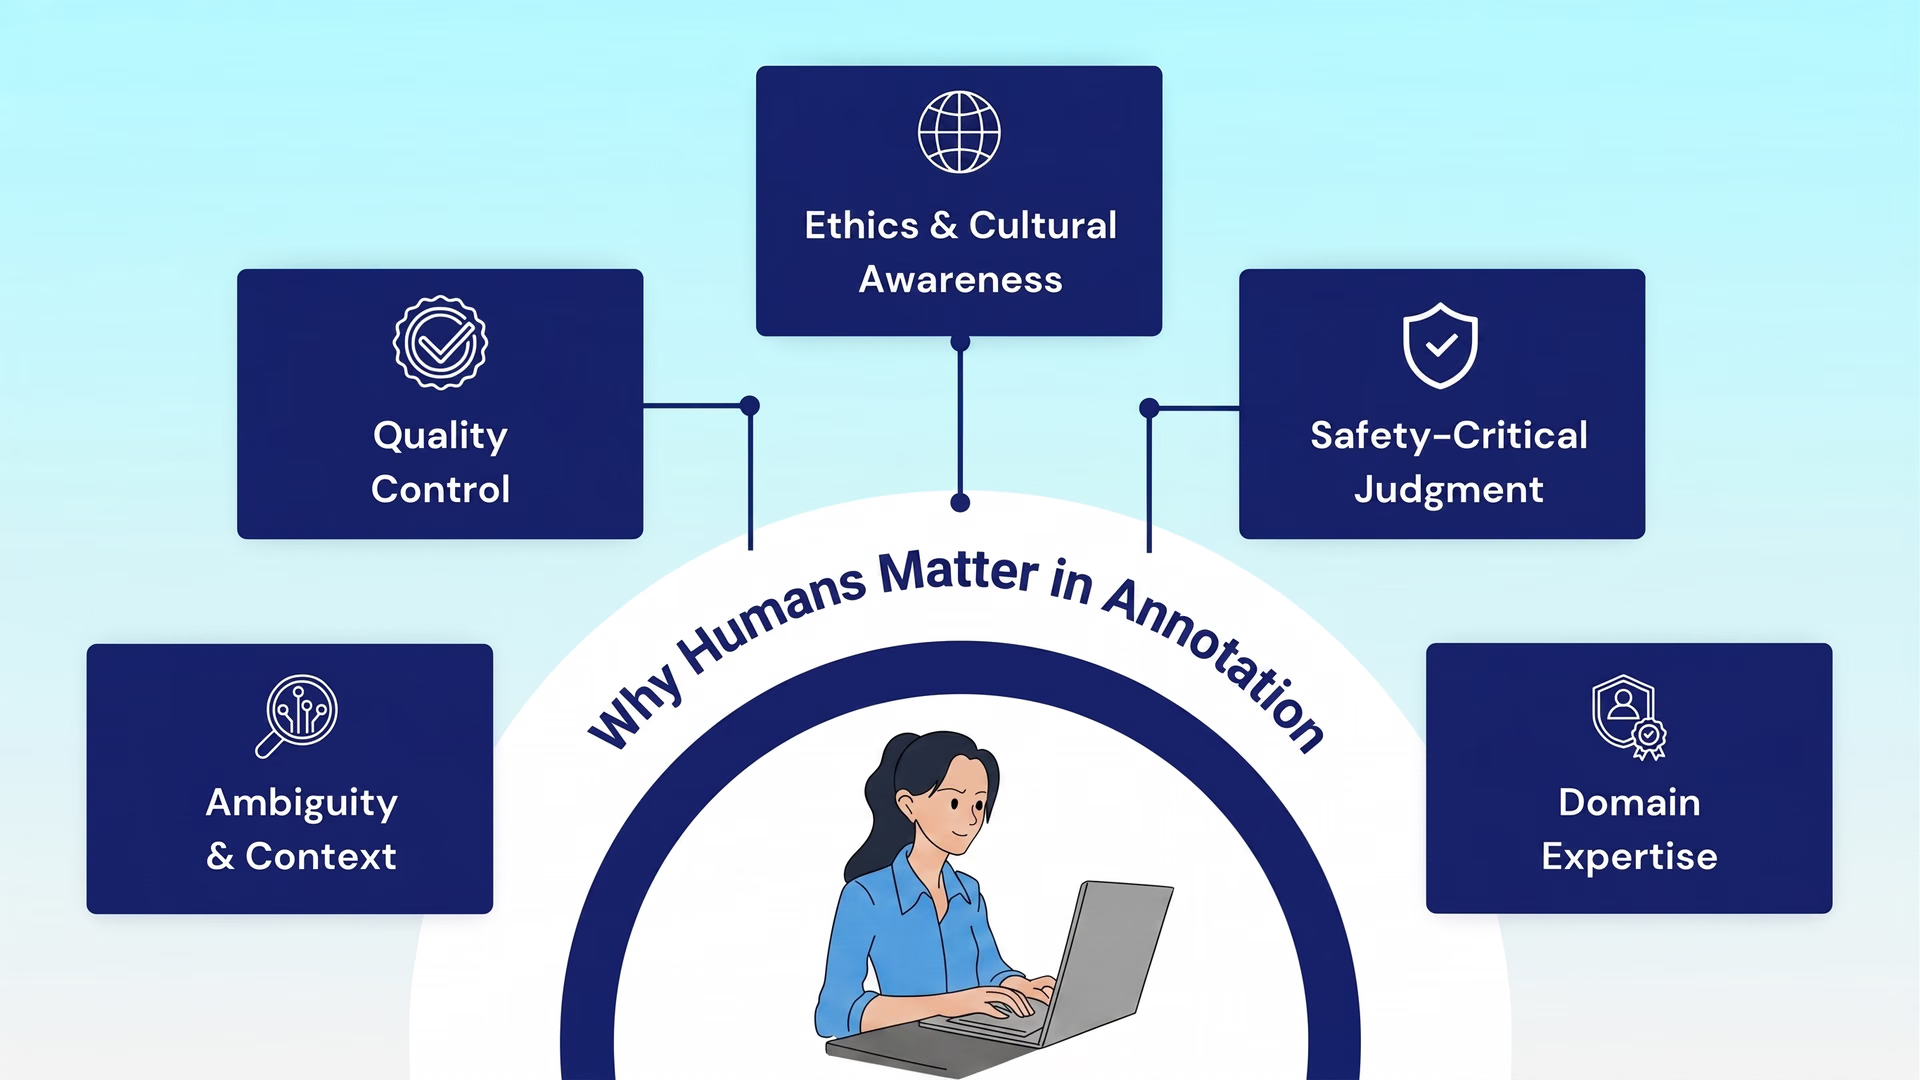
Abb. 1. Datensätze mit Annotationen von Menschen sind notwendig. Bild vom Autor.
In diesem Artikel sehen wir uns genauer an, warum von Menschen annotierte Daten unverzichtbar sind, auch während sich die KI weiterentwickelt.
Warum Bild- und Videoannotation notwendig sind#
Computer-Vision-Modelle lernen ähnlich wie wir: indem sie viele Beispiele sehen. Der Unterschied besteht darin, dass sie durch das Training mit großen Bilddatensätzen und Videos lernen, die Menschen zuvor annotiert haben. Diese Labels dienen als Referenz und vermitteln dem Modell beispielsweise, dass dies ein Fußgänger ist, wo sich die Grenze eines Tumors befindet oder dass es sich bei jenem Objekt um ein Auto handelt.
Visuelles Material aus der realen Welt ist selten sauber oder einheitlich. Die Beleuchtung kann sich ändern und denselben Gegenstand anders aussehen lassen. Menschen und Fahrzeuge können sich überschneiden oder teilweise verdeckt sein. Hintergründe können unruhig und ablenkend sein. Wenn Datensätze für solche Situationen sorgfältige, einheitliche Labels enthalten, sind Modelle viel besser auf das vorbereitet, was sie außerhalb kontrollierter Umgebungen erwartet.
Datenannotation bedeutet mehr, als nur Begrenzungsrahmen zu zeichnen oder Umrisse nachzuzeichnen. Dazu gehört, Richtlinien anzuwenden und praktische Entscheidungen darüber zu treffen, was als Objekt gilt, wo seine Grenze verlaufen sollte und wie mit unklaren Fällen umzugehen ist. Dieses menschliche Urteilsvermögen sorgt dafür, dass die Daten präzise und nutzbar bleiben.
Letztlich ist ein Computer-Vision-System nur so leistungsfähig wie die annotierten Daten, aus denen es lernt. Bei Anwendungen mit weitreichenden Folgen, etwa beim Erkennen von Krebs in Scans oder von Gefahren auf der Straße für selbstfahrende Autos, machen präzise Labels von erfahrenen Fachkräften einen echten Unterschied für Genauigkeit und Sicherheit.
Der Aufstieg der Automatisierung bei der Datenannotation#
Mit der zunehmenden Skalierung von Computer Vision und dem Wachstum der Datensätze wird Automatisierung immer häufiger eingesetzt, um Annotationen schneller zu erstellen. Statt alles von Hand zu beschriften, nutzen Teams KI-Modelle, um zunächst einen ersten Satz von Annotationen zu erzeugen.
Anschließend prüfen Menschen die Ergebnisse, beheben Fehler und bearbeiten Fälle, die das Modell nicht mit ausreichender Sicherheit labeln kann. Dieser Ansatz beschleunigt die Annotation und hält gleichzeitig die Qualität hoch.
Hier sind einige typische Möglichkeiten, wie Automatisierung bei der Datenannotation hilft:
- Automatische Segmentierung: Modelle können Objektumrisse oder Masken auf Pixelebene automatisch vorschlagen. Dadurch müssen Annotatoren weniger Umrisse von Hand nachzeichnen.
- Tracking mit optischem Fluss: Bei Videos können Trackingverfahren ein bewegtes Objekt über mehrere Frames verfolgen und sein Label übernehmen, sodass die Annotationen im Zeitverlauf einheitlich bleiben.
- Frame-Interpolation: Werkzeuge können anhand von Bewegungs- und Trackinghinweisen Labels für Frames zwischen zwei gelabelten Frames ergänzen. So müssen Annotierende nicht jeden einzelnen Frame labeln.
- Aktives Lernen: Trainingspipelines können Beispiele erkennen, bei denen das Modell unsicher ist oder die ungewöhnlich sind, und diese zuerst an Menschen weiterleiten. So fließt der manuelle Aufwand in die Daten, die die Leistung am stärksten verbessern.
Warum menschliche Datenannotation nach wie vor so wichtig ist#
Automatisierung kann das Labeln zwar beschleunigen, doch KI-Modelle sind weiterhin auf menschliches Urteilsvermögen angewiesen, um präzise und zuverlässig zu bleiben.
Hier sind einige wichtige Bereiche, in denen menschliches Fachwissen bei der Datenannotation einen Unterschied macht:
- Kontext verstehen: Reale Bilder und Videos sind oft unübersichtlich. Schatten, Spiegelungen, Bewegungsunschärfe und überlappende Objekte können automatisierte Werkzeuge verwirren. Menschliche Annotierende können interpretieren, was tatsächlich geschieht, und dadurch genauere Labels erstellen.
- Einheitliche Labels beibehalten: Wenn Datensätze wachsen, können automatisierte Labels abweichen oder sich zwischen Datenpaketen unterscheiden. Menschen können Labels prüfen, korrigieren und angleichen, damit der Datensatz vom Anfang bis zum Ende einheitlich bleibt.
- Verzerrungen und Schäden verringern: Menschen erkennen sensible Inhalte, kulturelle Nuancen und Muster, die zu Verzerrungen führen könnten, besser. Ihre Aufsicht trägt zu faireren Datensätzen bei und hilft, unbeabsichtigte Schäden zu vermeiden.
- Fachwissen anwenden: Manche Aufgaben erfordern Domänenwissen, etwa das Erkennen medizinischer Auffälligkeiten oder industrieller Mängel. Fachleute können präzise Labels vergeben und mehrdeutige Fälle klären, damit das Modell die richtigen Details lernt.
Ein Überblick über Annotation mit menschlicher Beteiligung#
Annotationswerkzeuge und Plattformen wie Roboflow integrieren Automatisierung, um die Beschriftung zu beschleunigen. Häufig kommen dabei Basismodelle wie das Segment Anything Model 3, kurz SAM 3, zum Einsatz. SAM 3 ist Metas promptgesteuertes Segmentierungsbasismodell.
Das Modell kann Objekte in Bildern und Videos anhand einfacher Eingaben wie Klicks, Begrenzungsrahmen oder kurzen Textbeschreibungen erkennen, segmentieren und verfolgen. Dabei erstellt es Segmentierungsmasken für passende Objekte, ohne dass für jede neue Kategorie ein eigenes Training erforderlich ist.
Auch bei diesen fortschrittlichen Ansätzen müssen Fachleute die Annotationen weiterhin überprüfen und fertigstellen. Wenn automatisierte Werkzeuge einen ersten Entwurf erstellen und Menschen ihn überprüfen, korrigieren und verfeinern, wird dieser Arbeitsablauf als Annotation mit Einbindung von Menschen bezeichnet. So bleibt die Annotation schnell, während zugleich sichergestellt wird, dass die endgültigen Kennzeichnungen genau und einheitlich genug sind, um zuverlässige Modelle zu trainieren.
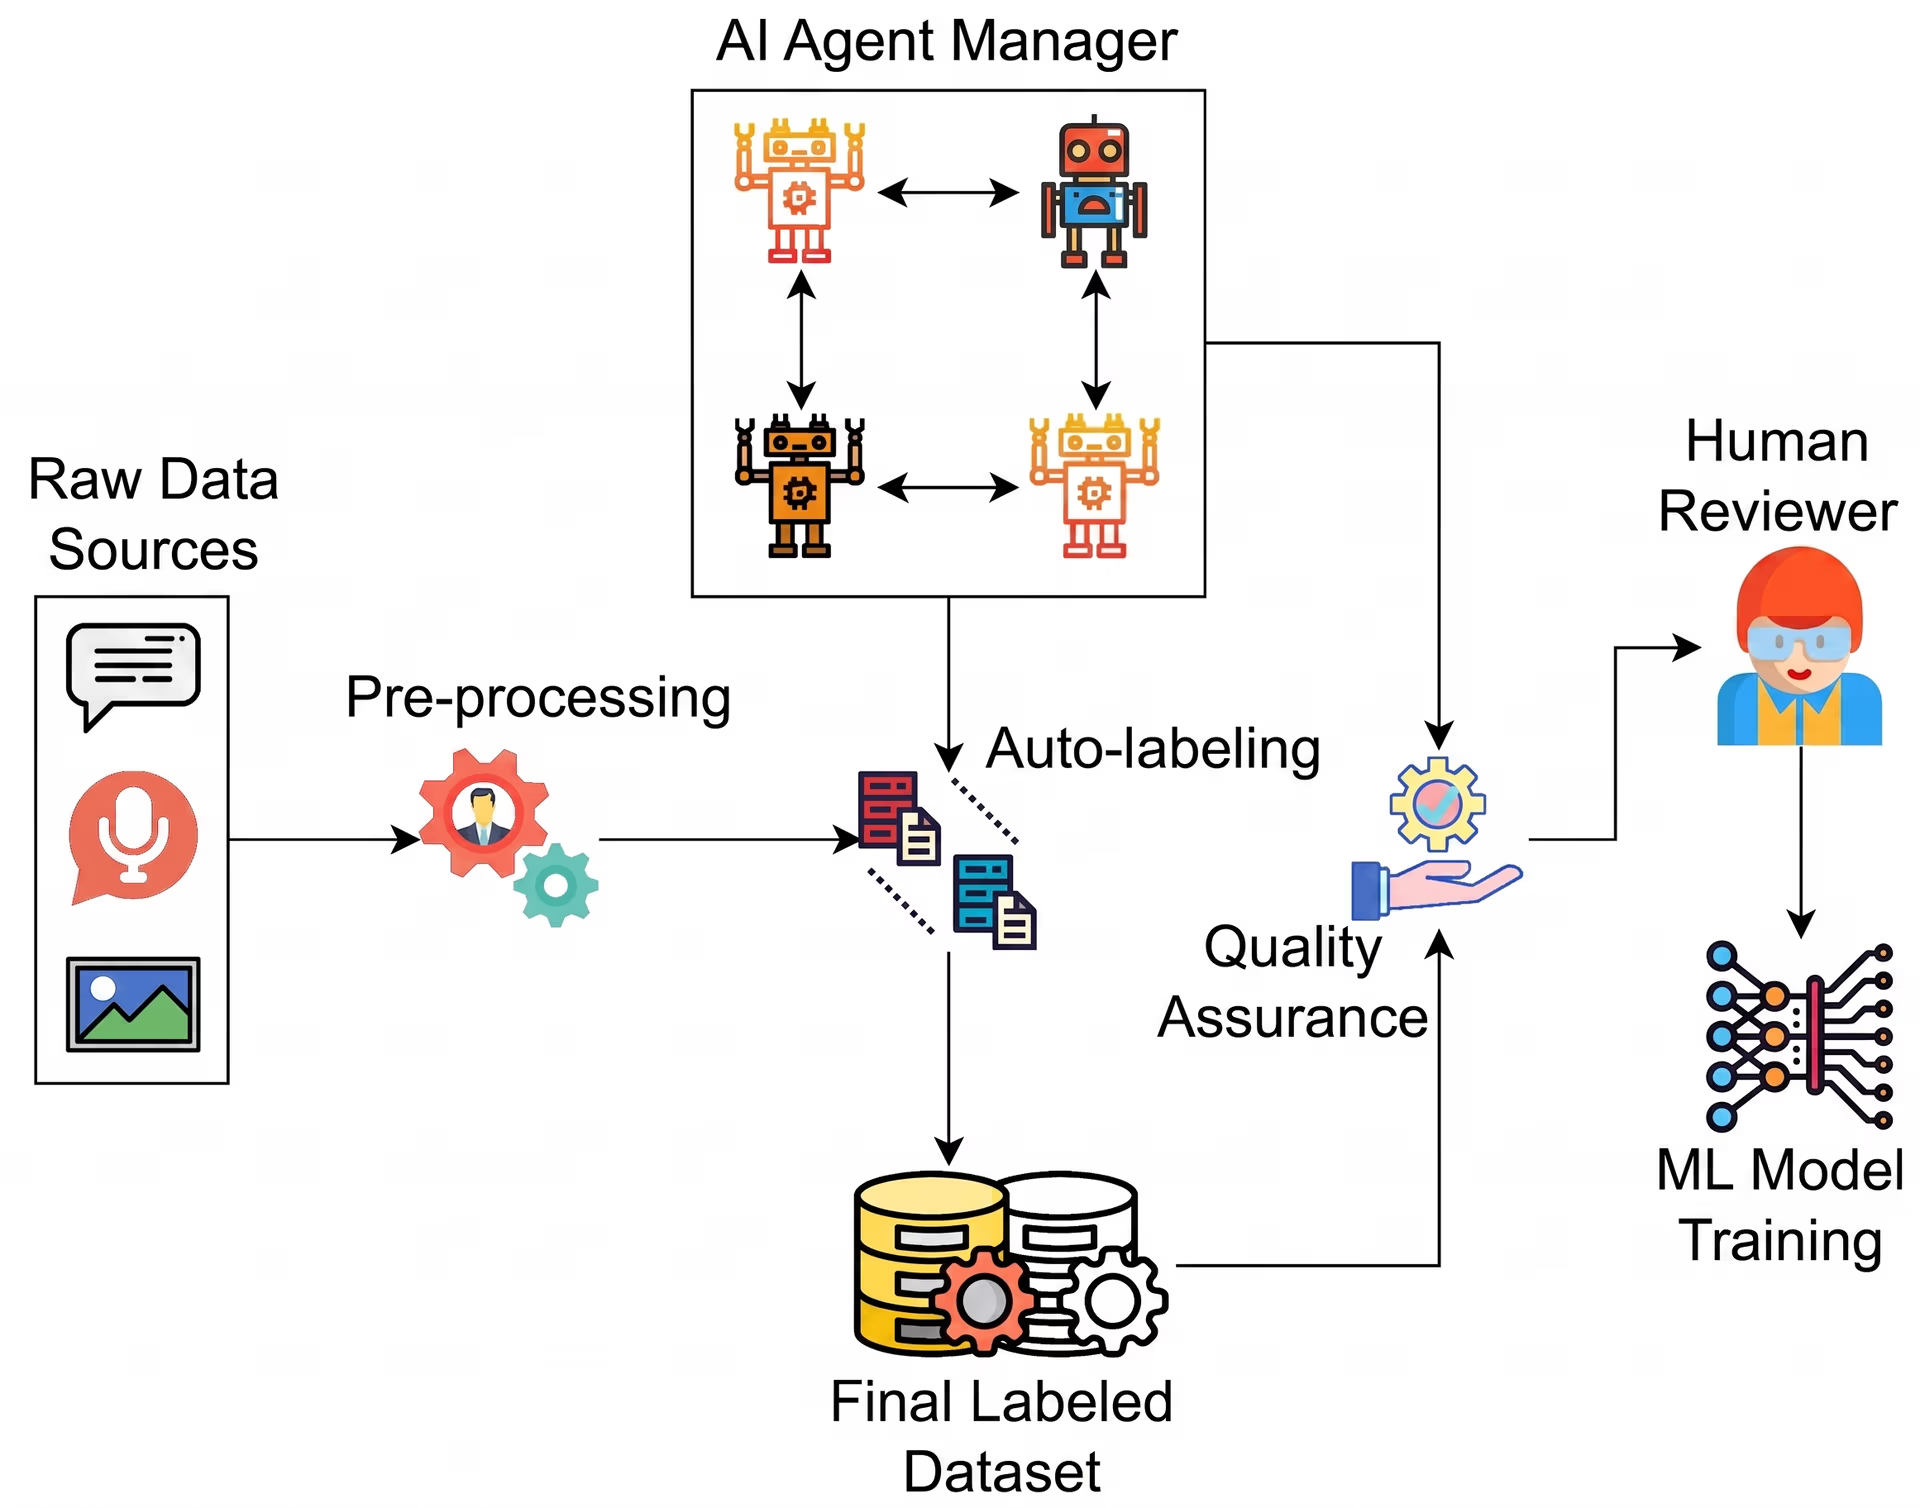
Abb. 2. Einblick in Annotation mit menschlicher Beteiligung. (Quelle)
Wann Automatisierung bei der Annotation funktioniert – und wann nicht#
Automatisierte Annotation funktioniert am besten bei Daten aus kontrollierten Umgebungen. Bilder aus Fabriken, Lagerhäusern oder Verkaufsgängen haben meist eine gleichmäßige Beleuchtung und klare Ansichten der Objekte. Dadurch können automatisierte Werkzeuge sie präzise labeln und Teams mit weniger manueller Arbeit schneller skalieren.
Daten aus weniger kontrollierten Umgebungen sind komplexer. Außenaufnahmen verändern sich je nach Tageszeit und Wetter, und Szenen auf Straßen oder in Wohnungen enthalten oft Unordnung, Bewegungsunschärfe, einander verdeckende Objekte und zahlreiche Überlappungen. Kleine Objekte, feine Konturen oder seltene Situationen schaffen noch mehr Fehlermöglichkeiten. Ein Modell, das bei sauberen Innenaufnahmen gut funktioniert, kann bei unübersichtlichem Bildmaterial aus der realen Welt dennoch Schwierigkeiten haben.
Deshalb ist menschliche Beteiligung weiterhin wichtig. Menschen können eingreifen, wenn das Modell unsicher ist, knifflige Kontexte interpretieren und Fehler beheben, bevor sie im endgültigen Datensatz landen. Annotation mit menschlicher Beteiligung verankert die Automatisierung in realen Bedingungen und sorgt dafür, dass Modelle auch nach der Bereitstellung zuverlässig bleiben.
Wo kann Annotation mit menschlicher Beteiligung einen Unterschied machen?#
Nachdem wir gesehen haben, wo Automatisierung gut funktioniert und wo ihre Grenzen liegen, schauen wir uns einige Anwendungsbereiche an, in denen Annotation mit menschlicher Beteiligung eine wichtige Rolle spielt.
Fehlererkennung in der Fertigung#
Stell dir ein Fabrikförderband vor, auf dem jede Minute Hunderte Teile an einer Kamera vorbeilaufen. Die meisten Mängel sind offensichtlich, doch hin und wieder tritt ein feiner Riss in einem ungewöhnlichen Winkel oder im Lichtreflex einer Lampe auf. Ein automatisiertes System könnte ihn übersehen oder als harmlose Oberflächenstruktur einstufen. Eine menschliche prüfende Person kann den Fehler jedoch erkennen, die Annotation korrigieren und dafür sorgen, dass das Modell den Unterschied lernt.
Das ist die Aufgabe der Annotation mit menschlicher Beteiligung bei der industriellen Inspektion. Die Automatisierung kann häufige Fehlerarten vorab labeln und große Bildmengen schnell bearbeiten. Menschen müssen die Ergebnisse jedoch weiterhin prüfen, Konturen präzisieren und seltene Fehlerfälle behandeln, die in den Trainingsdaten nicht oft vorkommen.
Autonome Fahrzeuge und intelligenter Verkehr#
Auch autonome Fahrzeuge nutzen Computer Vision, um Fußgänger zu erkennen, Schilder zu lesen und sich im Verkehr zurechtzufinden. Doch die Straßenverhältnisse sind unvorhersehbar. So kann beispielsweise eine Person, die nachts hinter einem geparkten Auto hervortritt, teilweise verdeckt und wegen Blendlichts schwer zu erkennen sein.
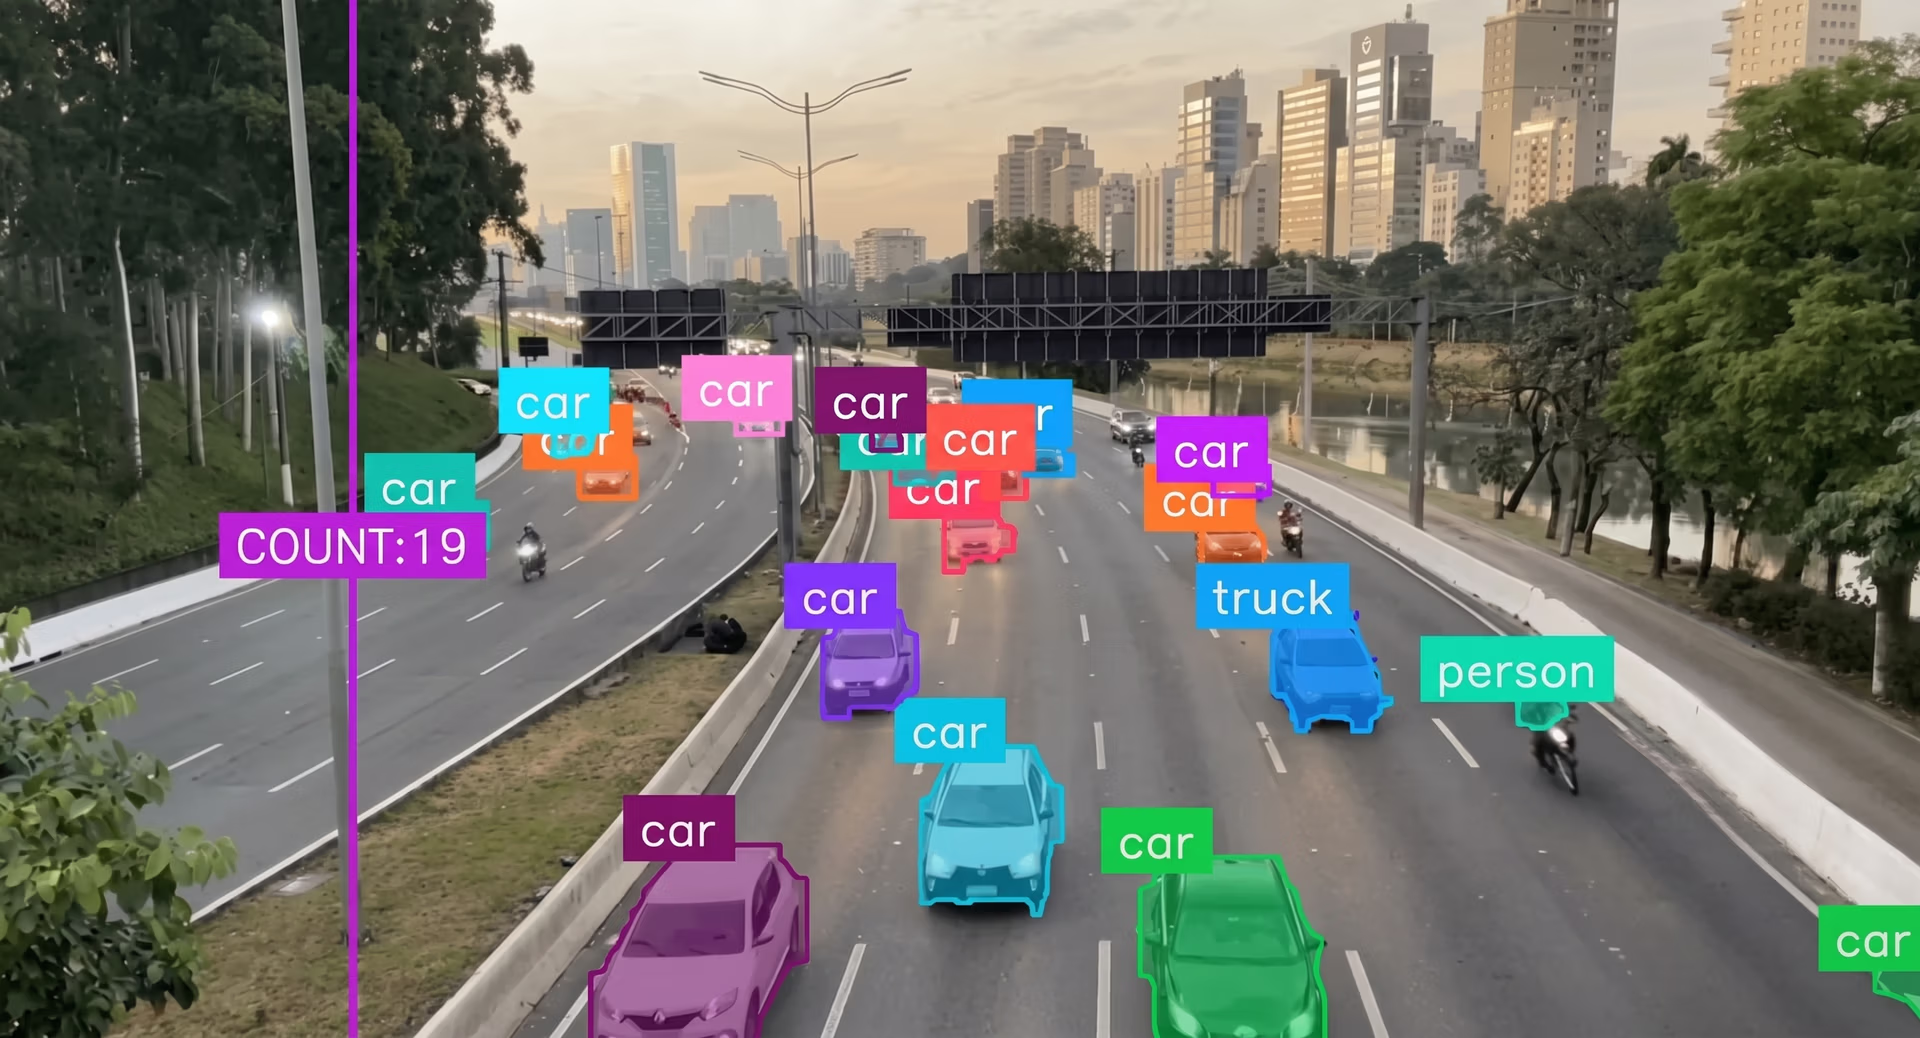
Abb. 3. Beispiel für die Analyse des Verkehrs mit Computer Vision. (Quelle)
Menschliche Annotierende können solche seltenen, sicherheitskritischen Grenzfälle während des Trainings labeln, damit Modelle die richtige Reaktion lernen – nicht nur unter normalen Bedingungen, sondern auch in den entscheidenden Momenten. Dieser Schritt mit menschlicher Beteiligung ist wichtig, um Systemen den Umgang mit seltenen Ereignissen beizubringen, die sich nur schwer allein mit Automatisierung erfassen lassen.
Die Zukunft menschlich annotierter Datensätze#
Mit dem technologischen Fortschritt wird Annotation mit menschlicher Beteiligung immer kooperativer. Interessanterweise werden Bild-Sprach-Modelle (VLMs), die sowohl aus Bildern als auch aus Text lernen, inzwischen eingesetzt, um erste Labels zu erstellen und anhand einfacher Eingaben Korrekturen vorzuschlagen.
Statt jedes Bild manuell zu prüfen und zu entscheiden, was gelabelt werden soll, kann ein annotierender Mensch einem VLM eine Vorgabe wie „Alle Fußgänger, Autos und Ampeln labeln“ oder „Alle Defekte an diesem Teil segmentieren“ geben und einen Entwurf der Annotationen zur Überprüfung erhalten. Auf der Ultralytics Platform können Teams Erkennungsdatensätze mithilfe von Vision-Language-Modellen automatisch annotieren. Die VLM Leaderboard vergleicht, wie genau die einzelnen Modelle Bilder aus der realen Welt labeln.
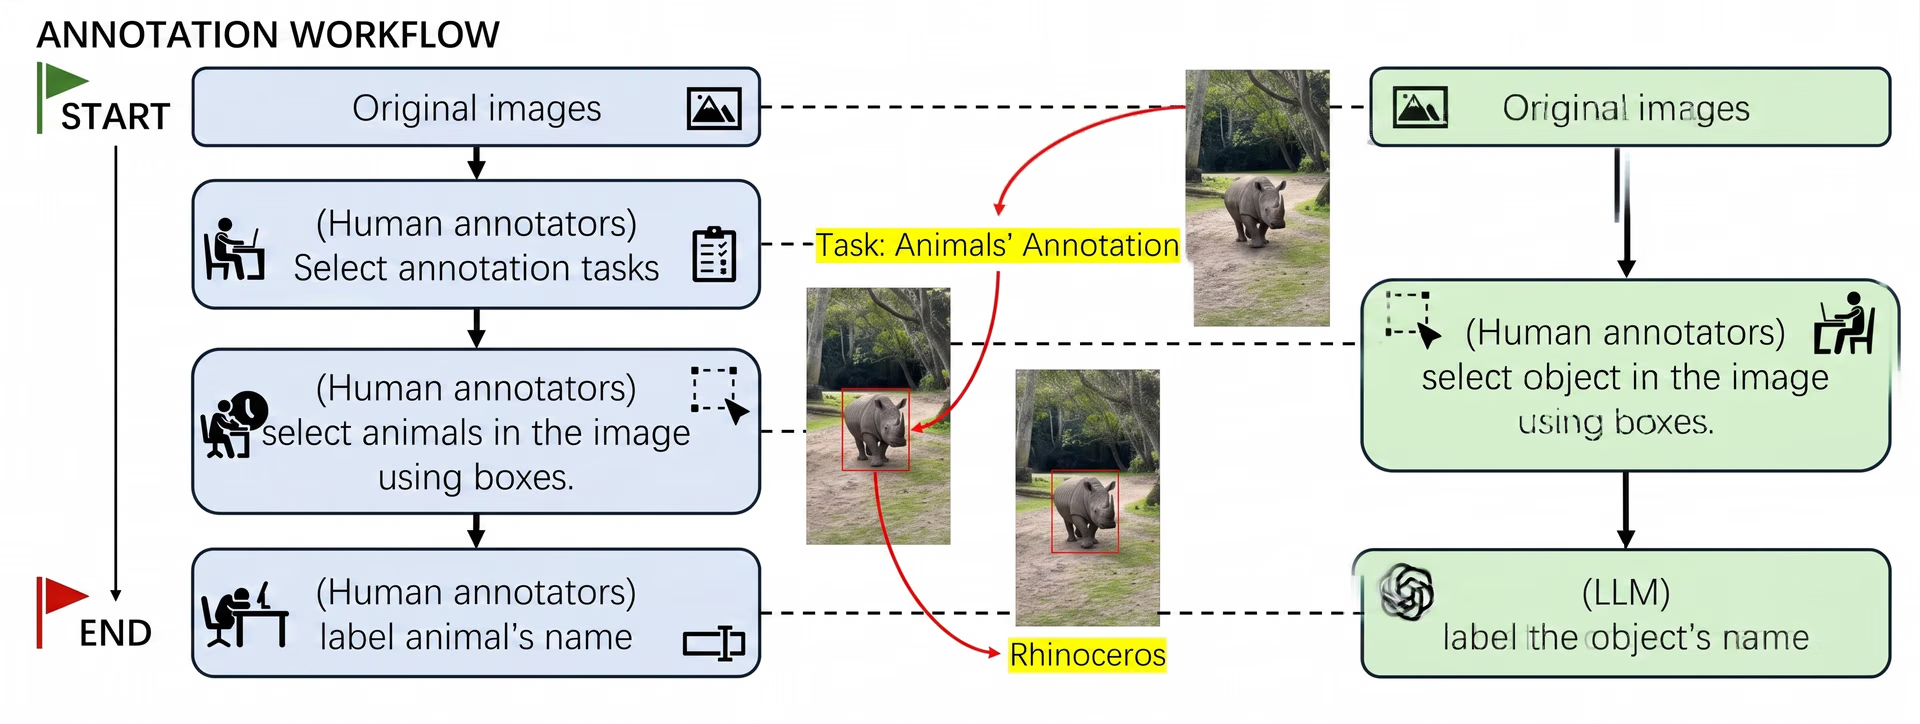
Abb. 4. Große multimodale Modelle können mit menschlichen Annotierenden zusammenarbeiten (Quelle)
Das verkürzt die Annotationszeit, da das Modell viele einfache Fälle vorab bearbeiten kann. Menschen können sich so darauf konzentrieren, Ergebnisse zu prüfen, knifflige Beispiele zu korrigieren und den Datensatz einheitlich zu halten. Große multimodale Modelle beginnen außerdem, Annotierende zu den unsichersten Beispielen zu führen. Dadurch wird der menschliche Aufwand gezielter eingesetzt und die Gesamtqualität des Datensatzes verbessert.
Die wichtigsten Erkenntnisse#
Computer Vision hilft Maschinen, das Gesehene zu interpretieren und darauf zu reagieren, funktioniert aber am besten mit menschlichem Fachwissen im Prozess. Von Menschen annotierte Daten verankern Modelle in realen Bedingungen und verbessern die Zuverlässigkeit ihrer Leistung. Wenn Automatisierung und menschliches Urteilsvermögen Hand in Hand arbeiten, können Teams wirkungsvolle Bildverarbeitungssysteme entwickeln.
Werde Teil unserer aktiven Community und entdecke Innovationen wie KI in der Logistik und Vision AI in der Robotik. Besuche unser GitHub-Repository, um mehr zu erfahren. Wenn du heute mit Computer Vision loslegen möchtest, sieh dir unsere Lizenzoptionen an.
Verfasst von
Content Creator · Ultralytics
Kommentare
Stelle eine Frage, teile deine Ergebnisse oder hilf anderen.









