Vision-Language-Modelle und ihre Anwendungen verstehen
Erfahre mehr über Vision-Language-Modelle, ihre Funktionsweise und ihre vielfältigen Anwendungen in der KI. Entdecke, wie diese Modelle visuelle Fähigkeiten und Sprachverständnis kombinieren.
In einem früheren Artikel haben wir untersucht, wie GPT-4o Bilder verstehen und mit Worten beschreiben kann. Diese Fähigkeit sehen wir auch bei anderen neuen Modellen wie Google Gemini und Claude 3. Heute gehen wir näher auf dieses Konzept ein und erklären, wie Vision-Language-Modelle funktionieren und visuelle mit textuellen Daten kombinieren.
Diese Modelle können für eine Reihe beeindruckender Aufgaben eingesetzt werden, etwa zum Erstellen detaillierter Bildbeschreibungen, zum Beantworten von Fragen zu Bildern und sogar zum Erzeugen neuer visueller Inhalte anhand textueller Beschreibungen. Durch die nahtlose Verknüpfung visueller und sprachlicher Informationen verändern Vision-Language-Modelle die Art, wie wir mit Technologie interagieren und die Welt um uns herum verstehen.
So funktionieren Vision-Language-Modelle#
Bevor wir uns ansehen, wo Vision-Language-Modelle (VLMs) eingesetzt werden können, wollen wir verstehen, was sie sind und wie sie funktionieren. VLMs sind fortschrittliche KI-Modelle, die die Fähigkeiten von Bildverarbeitungs- und Sprachmodellen kombinieren, um sowohl Bilder als auch Text zu verarbeiten. Sie erhalten Bilder zusammen mit den dazugehörigen Textbeschreibungen und lernen, beides miteinander zu verknüpfen. Der Bildverarbeitungsteil des Modells erfasst Details aus den Bildern, während der Sprachteil den Text versteht. Durch dieses Zusammenspiel können VLMs sowohl Bilder als auch Text verstehen und analysieren.
Hier sind die wichtigsten Fähigkeiten von Vision-Language-Modellen:
- Bildbeschriftung: Erstellen beschreibender Texte auf Grundlage des Bildinhalts.
- Visuelle Fragebeantwortung (VQA): Beantworten von Fragen zum Inhalt eines Bildes.
- Text-zu-Bildgenerierung: Erstellen von Bildern anhand textueller Beschreibungen.
- Text-Bild-Suche: Finden relevanter Bilder zu einer Textabfrage und umgekehrt.
- Multimodale Inhaltserstellung: Kombinieren von Bildern und Text zum Erzeugen neuer Inhalte.
- Szenenverständnis undObjekterkennung: Erkennen und Kategorisieren von Objekten und Details in einem Bild.
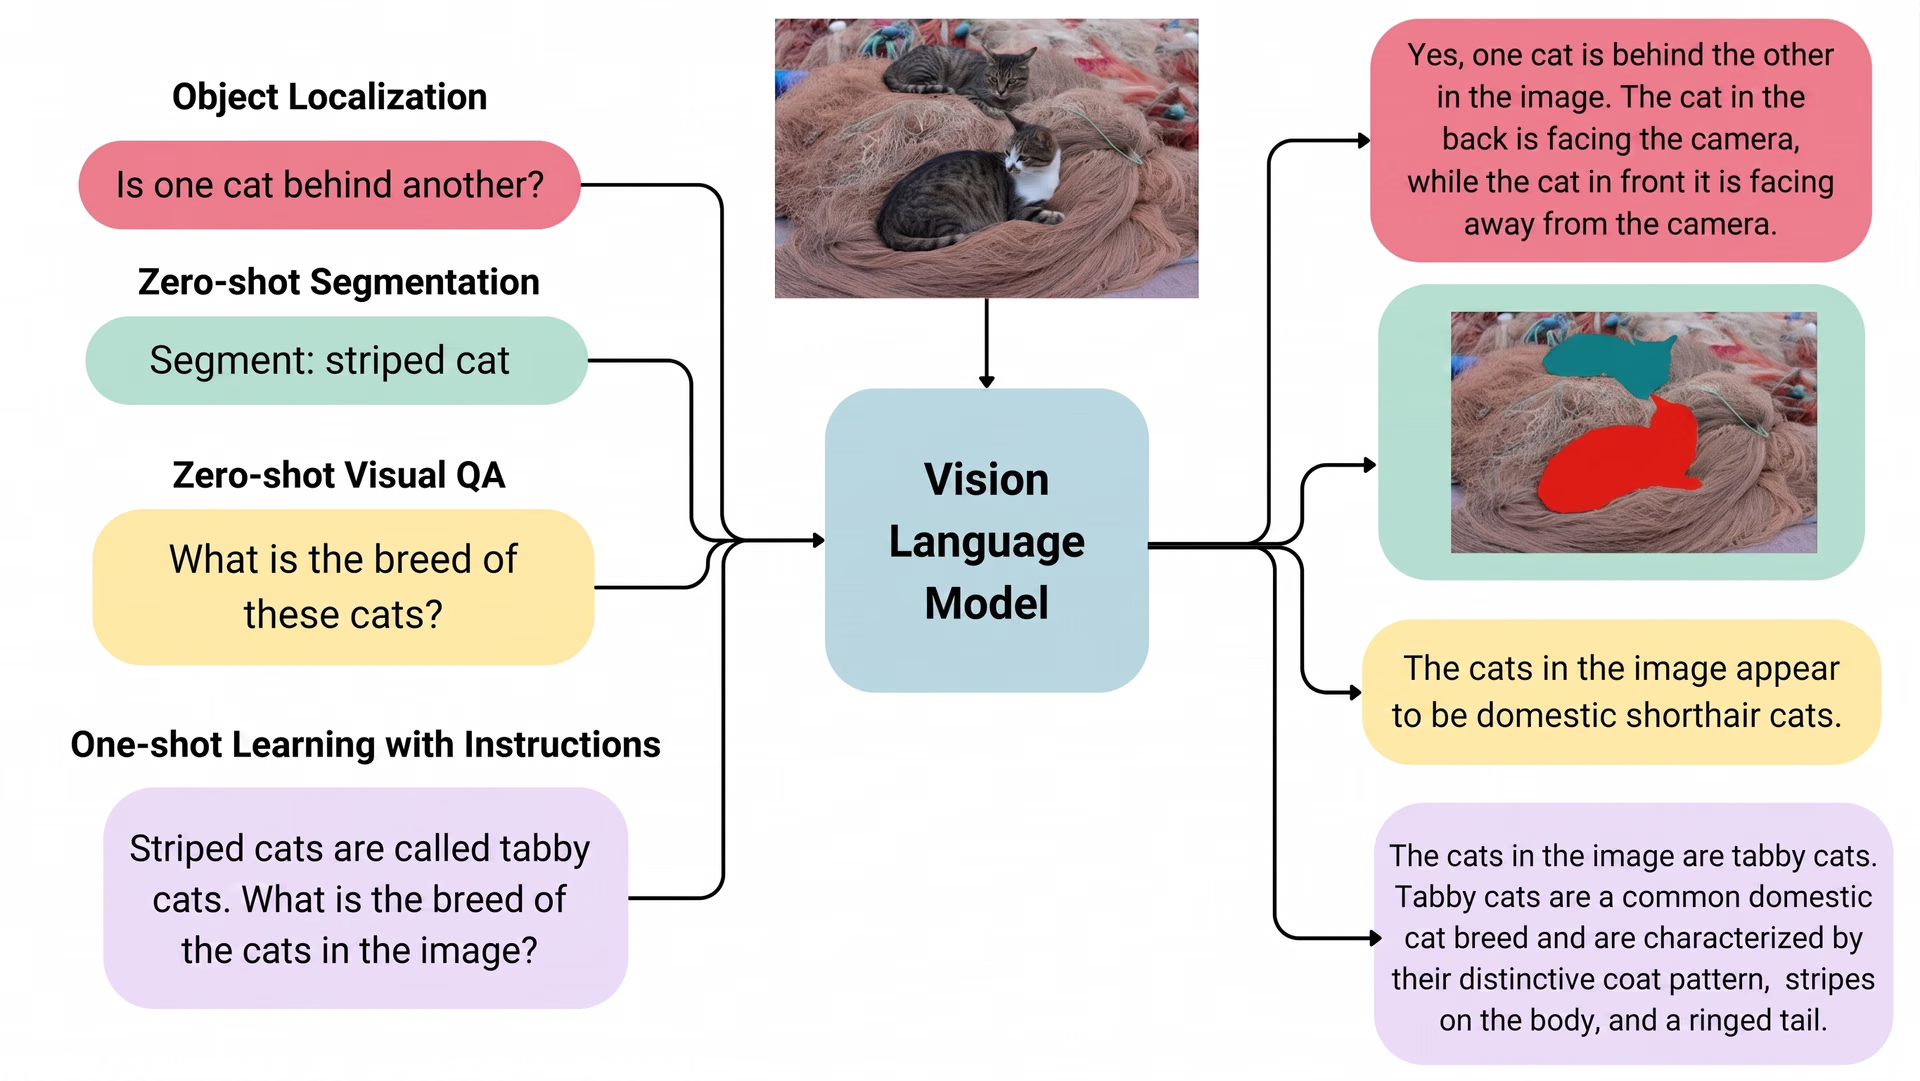
Abb. 1 Ein Beispiel für die Fähigkeiten eines Vision-Language-Modells.
Als Nächstes sehen wir uns gängige VLM-Architekturen und Lernverfahren an, die von bekannten Modellen wie CLIP, SimVLM und VisualGPT verwendet werden.
Kontrastives Lernen#
Kontrastives Lernen ist ein Verfahren, mit dem Modelle durch den Vergleich von Unterschieden zwischen Datenpunkten lernen. Es berechnet, wie ähnlich oder verschieden die Beispiele sind, und zielt darauf ab, den kontrastiven Verlust zu minimieren, der diese Unterschiede misst. Das Verfahren ist besonders beim halbüberwachten Lernen nützlich, bei dem eine kleine Menge gelabelter Beispiele dem Modell dabei hilft, neue, ungesehene Daten zu beschriften. Um beispielsweise zu verstehen, wie eine Katze aussieht, vergleicht das Modell sie mit ähnlichen Katzen- und Hundebildern. Anhand von Merkmalen wie Gesichtsform, Körpergröße und Fell können kontrastive Lernverfahren zwischen einer Katze und einem Hund unterscheiden.
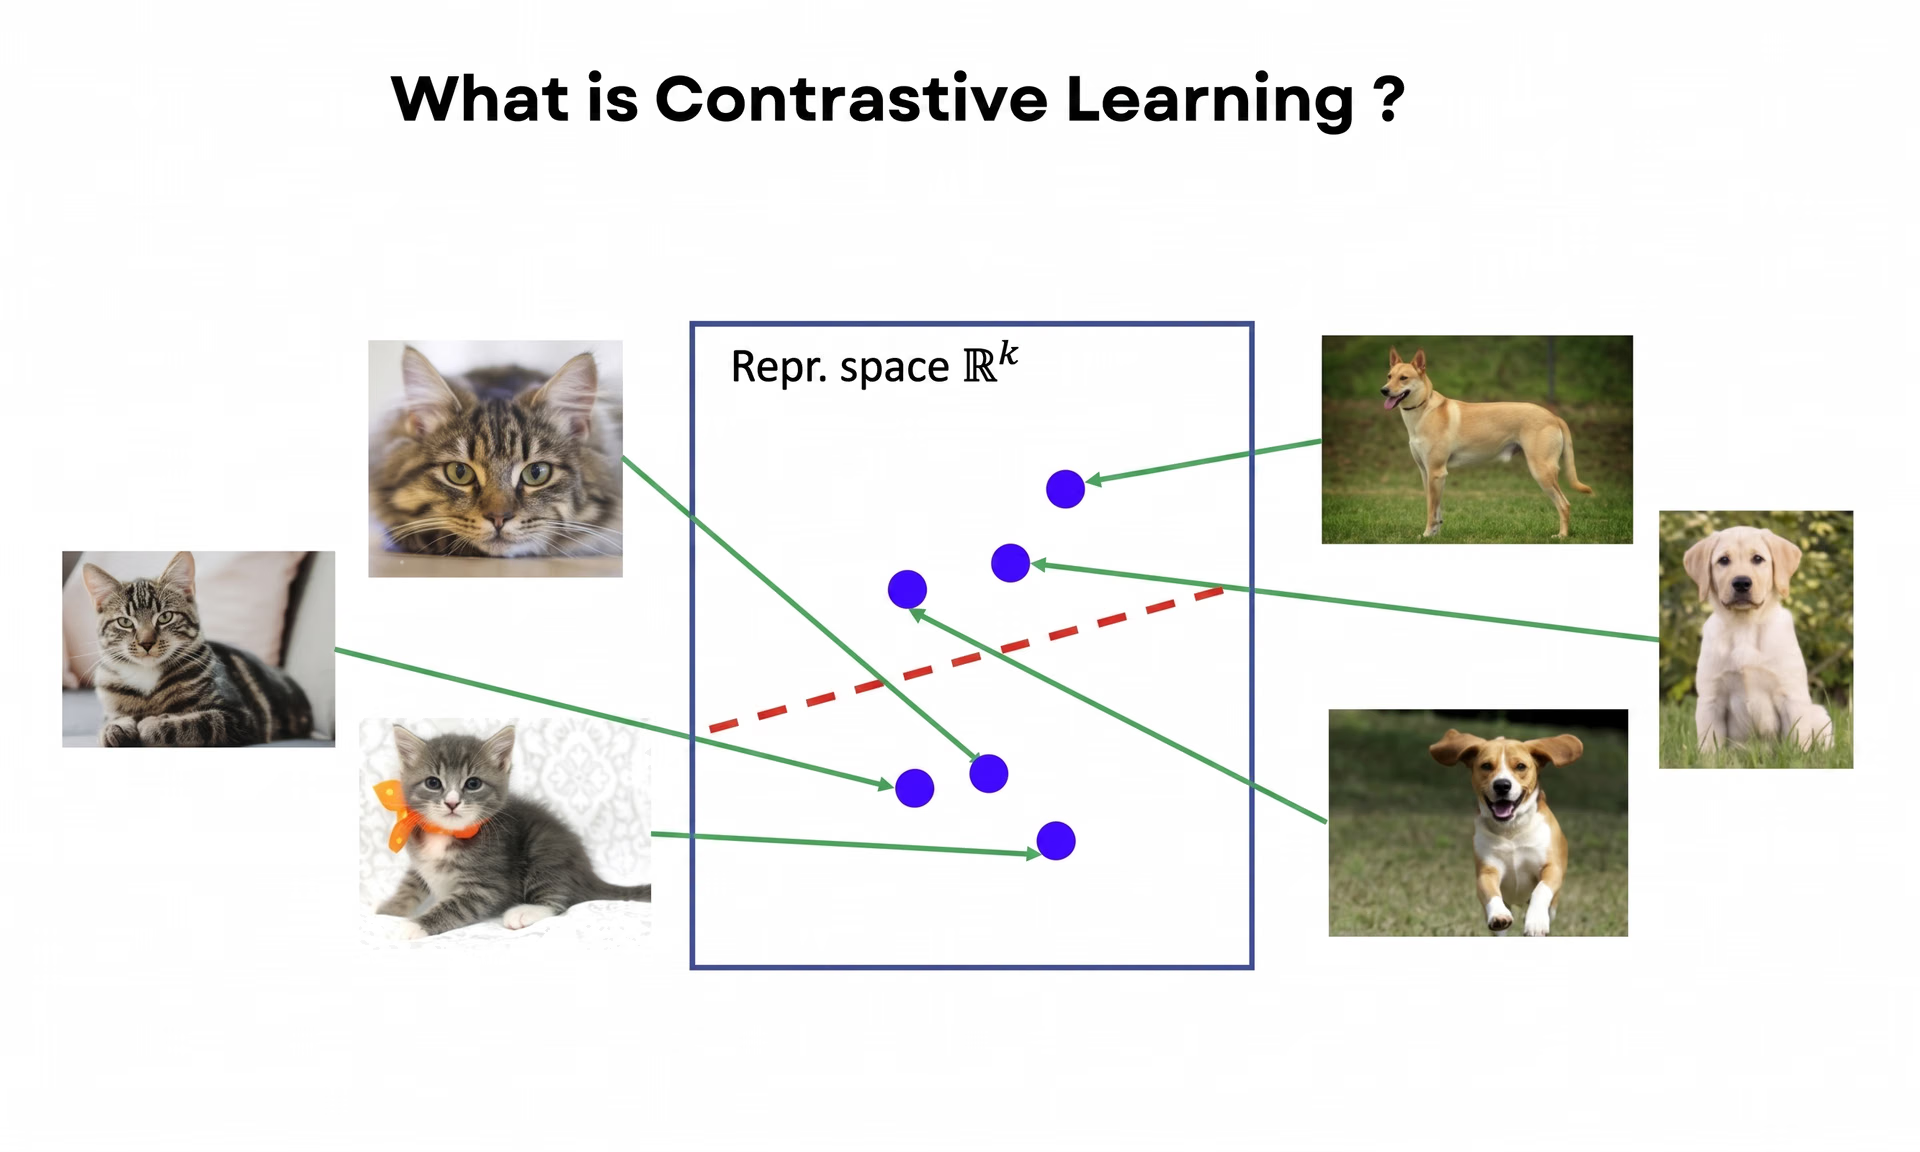
Abb. 2 So funktioniert kontrastives Lernen.
CLIP ist ein Vision-Language-Modell, das kontrastives Lernen verwendet, um Textbeschreibungen Bildern zuzuordnen. Das Verfahren umfasst drei einfache Schritte. Zuerst trainiert es die Modellteile, die sowohl Text als auch Bilder verstehen. Zweitens wandelt es die Kategorien in einem Datensatz in Textbeschreibungen um. Drittens ermittelt es die am besten passende Beschreibung für ein bestimmtes Bild. Dank dieser Methode kann das CLIP-Modell auch bei Aufgaben genaue Vorhersagen treffen, für die es nicht speziell trainiert wurde.
PrefixLM#
PrefixLM ist ein Verfahren der Verarbeitung natürlicher Sprache (NLP), das zum Trainieren von Modellen verwendet wird. Es beginnt mit einem Satzteil (einem Präfix) und lernt, das nächste Wort vorherzusagen. In Vision-Language-Modellen hilft PrefixLM dem Modell dabei, auf Grundlage eines Bildes und eines vorgegebenen Textteils die nächsten Wörter vorherzusagen. Dabei kommt ein Vision-Transformer (ViT) zum Einsatz, der ein Bild in kleine Ausschnitte zerlegt, von denen jeder einen Teil des Bildes darstellt, und diese nacheinander verarbeitet.
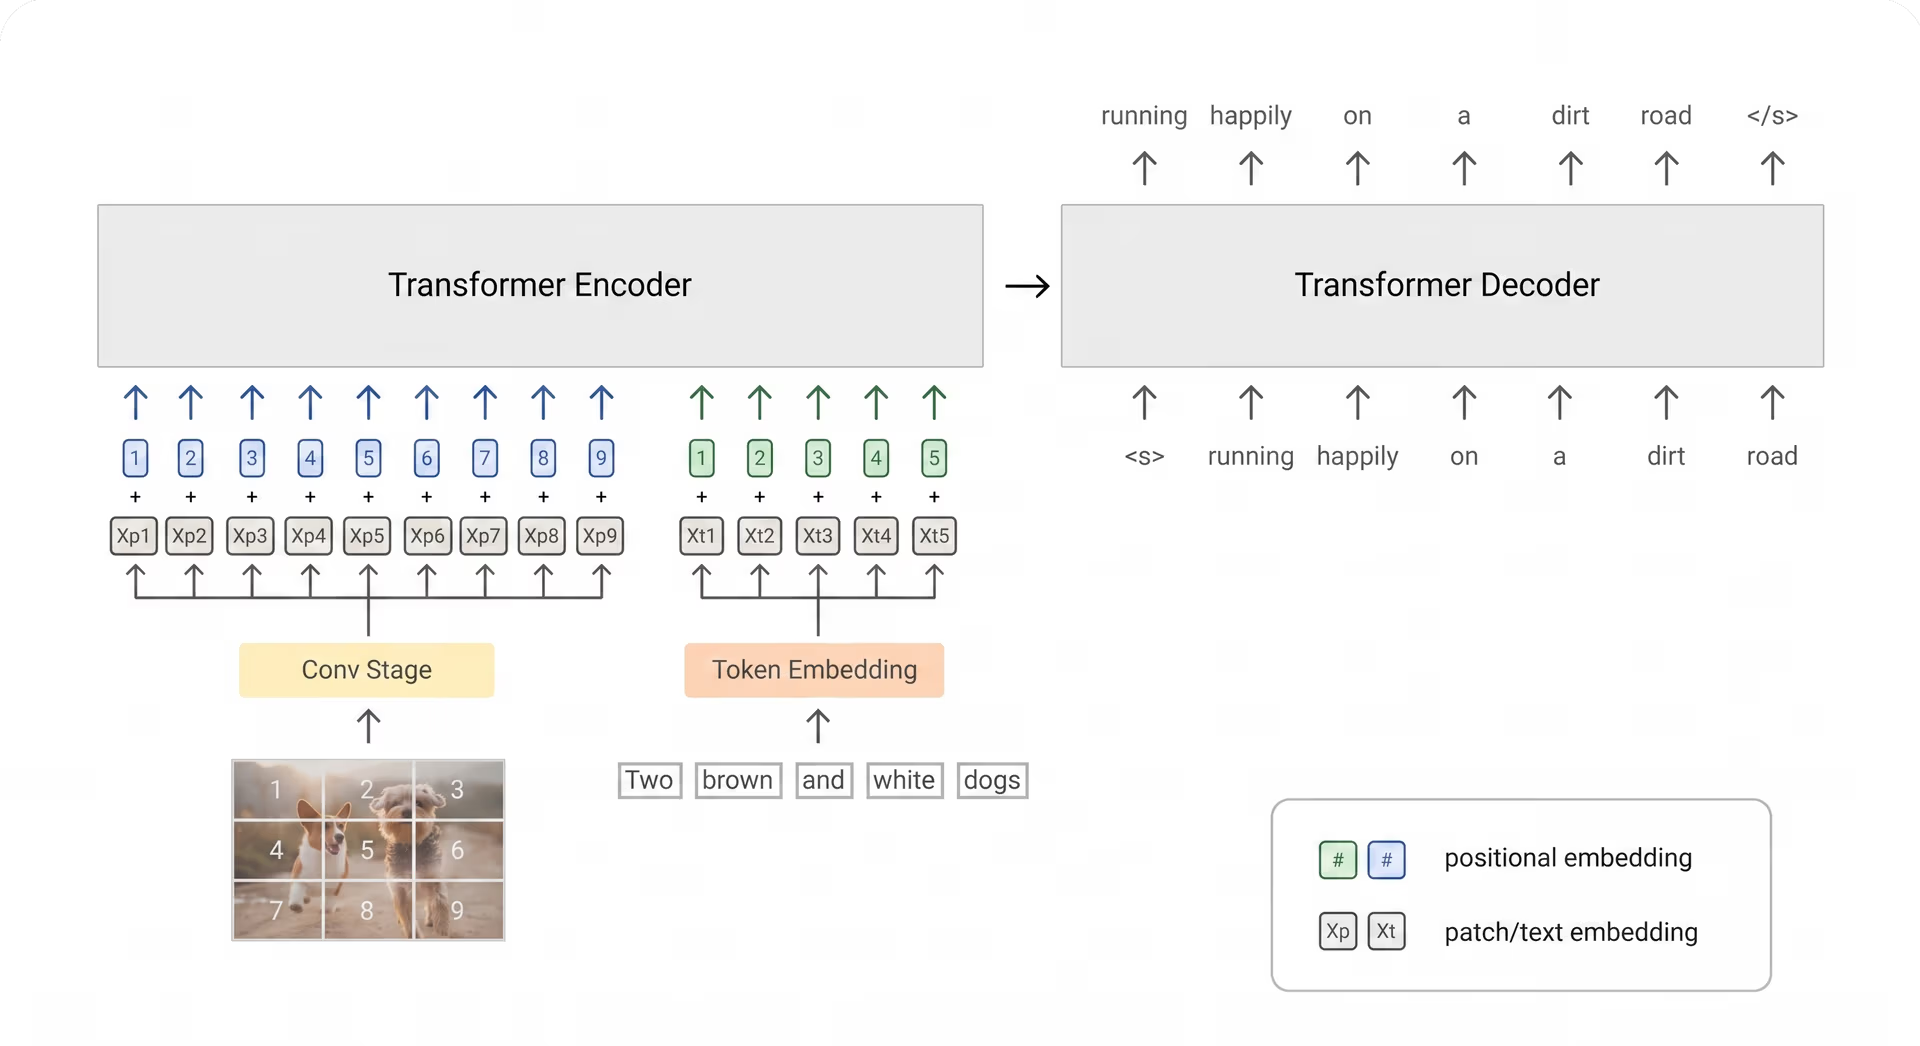
Abb. 3 Ein Beispiel für das Training eines VLM mit der PrefixLM-Technik.
SimVLM ist ein VLM, das die PrefixLM-Lerntechnik verwendet. Es nutzt eine einfachere Transformer-Architektur als frühere Modelle und erzielt dennoch bessere Ergebnisse in verschiedenen Tests. Die Modellarchitektur lernt, Bilder mithilfe eines Transformer-Encoders mit Textpräfixen zu verknüpfen, und erzeugt anschließend Text mit einem Transformer-Decoder.
Multimodale Fusion mit Cross-Attention#
Die multimodale Fusion mit Cross-Attention ist ein Verfahren, das die Fähigkeit eines vortrainierten Vision-Language-Modells verbessert, visuelle Daten zu verstehen und zu verarbeiten. Dazu werden dem Modell Cross-Attention-Schichten hinzugefügt, die es ihm ermöglichen, gleichzeitig sowohl visuelle als auch textuelle Informationen zu berücksichtigen.
So funktioniert es:
- Wichtige Objekte in einem Bild werden erkannt und hervorgehoben.
- Die hervorgehobenen Objekte werden von einem visuellen Encoder verarbeitet, der die visuellen Informationen in ein für das Modell verständliches Format überführt.
- Die visuellen Informationen werden an einen Decoder weitergegeben, der das Bild mithilfe des Wissens aus dem vortrainierten Sprachmodell interpretiert.
VisualGPT ist ein gutes Beispiel für ein Modell, das dieses Verfahren verwendet. Es enthält eine besondere Funktion namens selbstwiederherstellende Aktivierungseinheit (SRAU), die dem Modell hilft, ein häufiges Problem namens verschwindende Gradienten zu vermeiden. Verschwindende Gradienten können dazu führen, dass Modelle während des Trainings wichtige Informationen verlieren, doch SRAU sorgt für eine stabile Leistung des Modells.
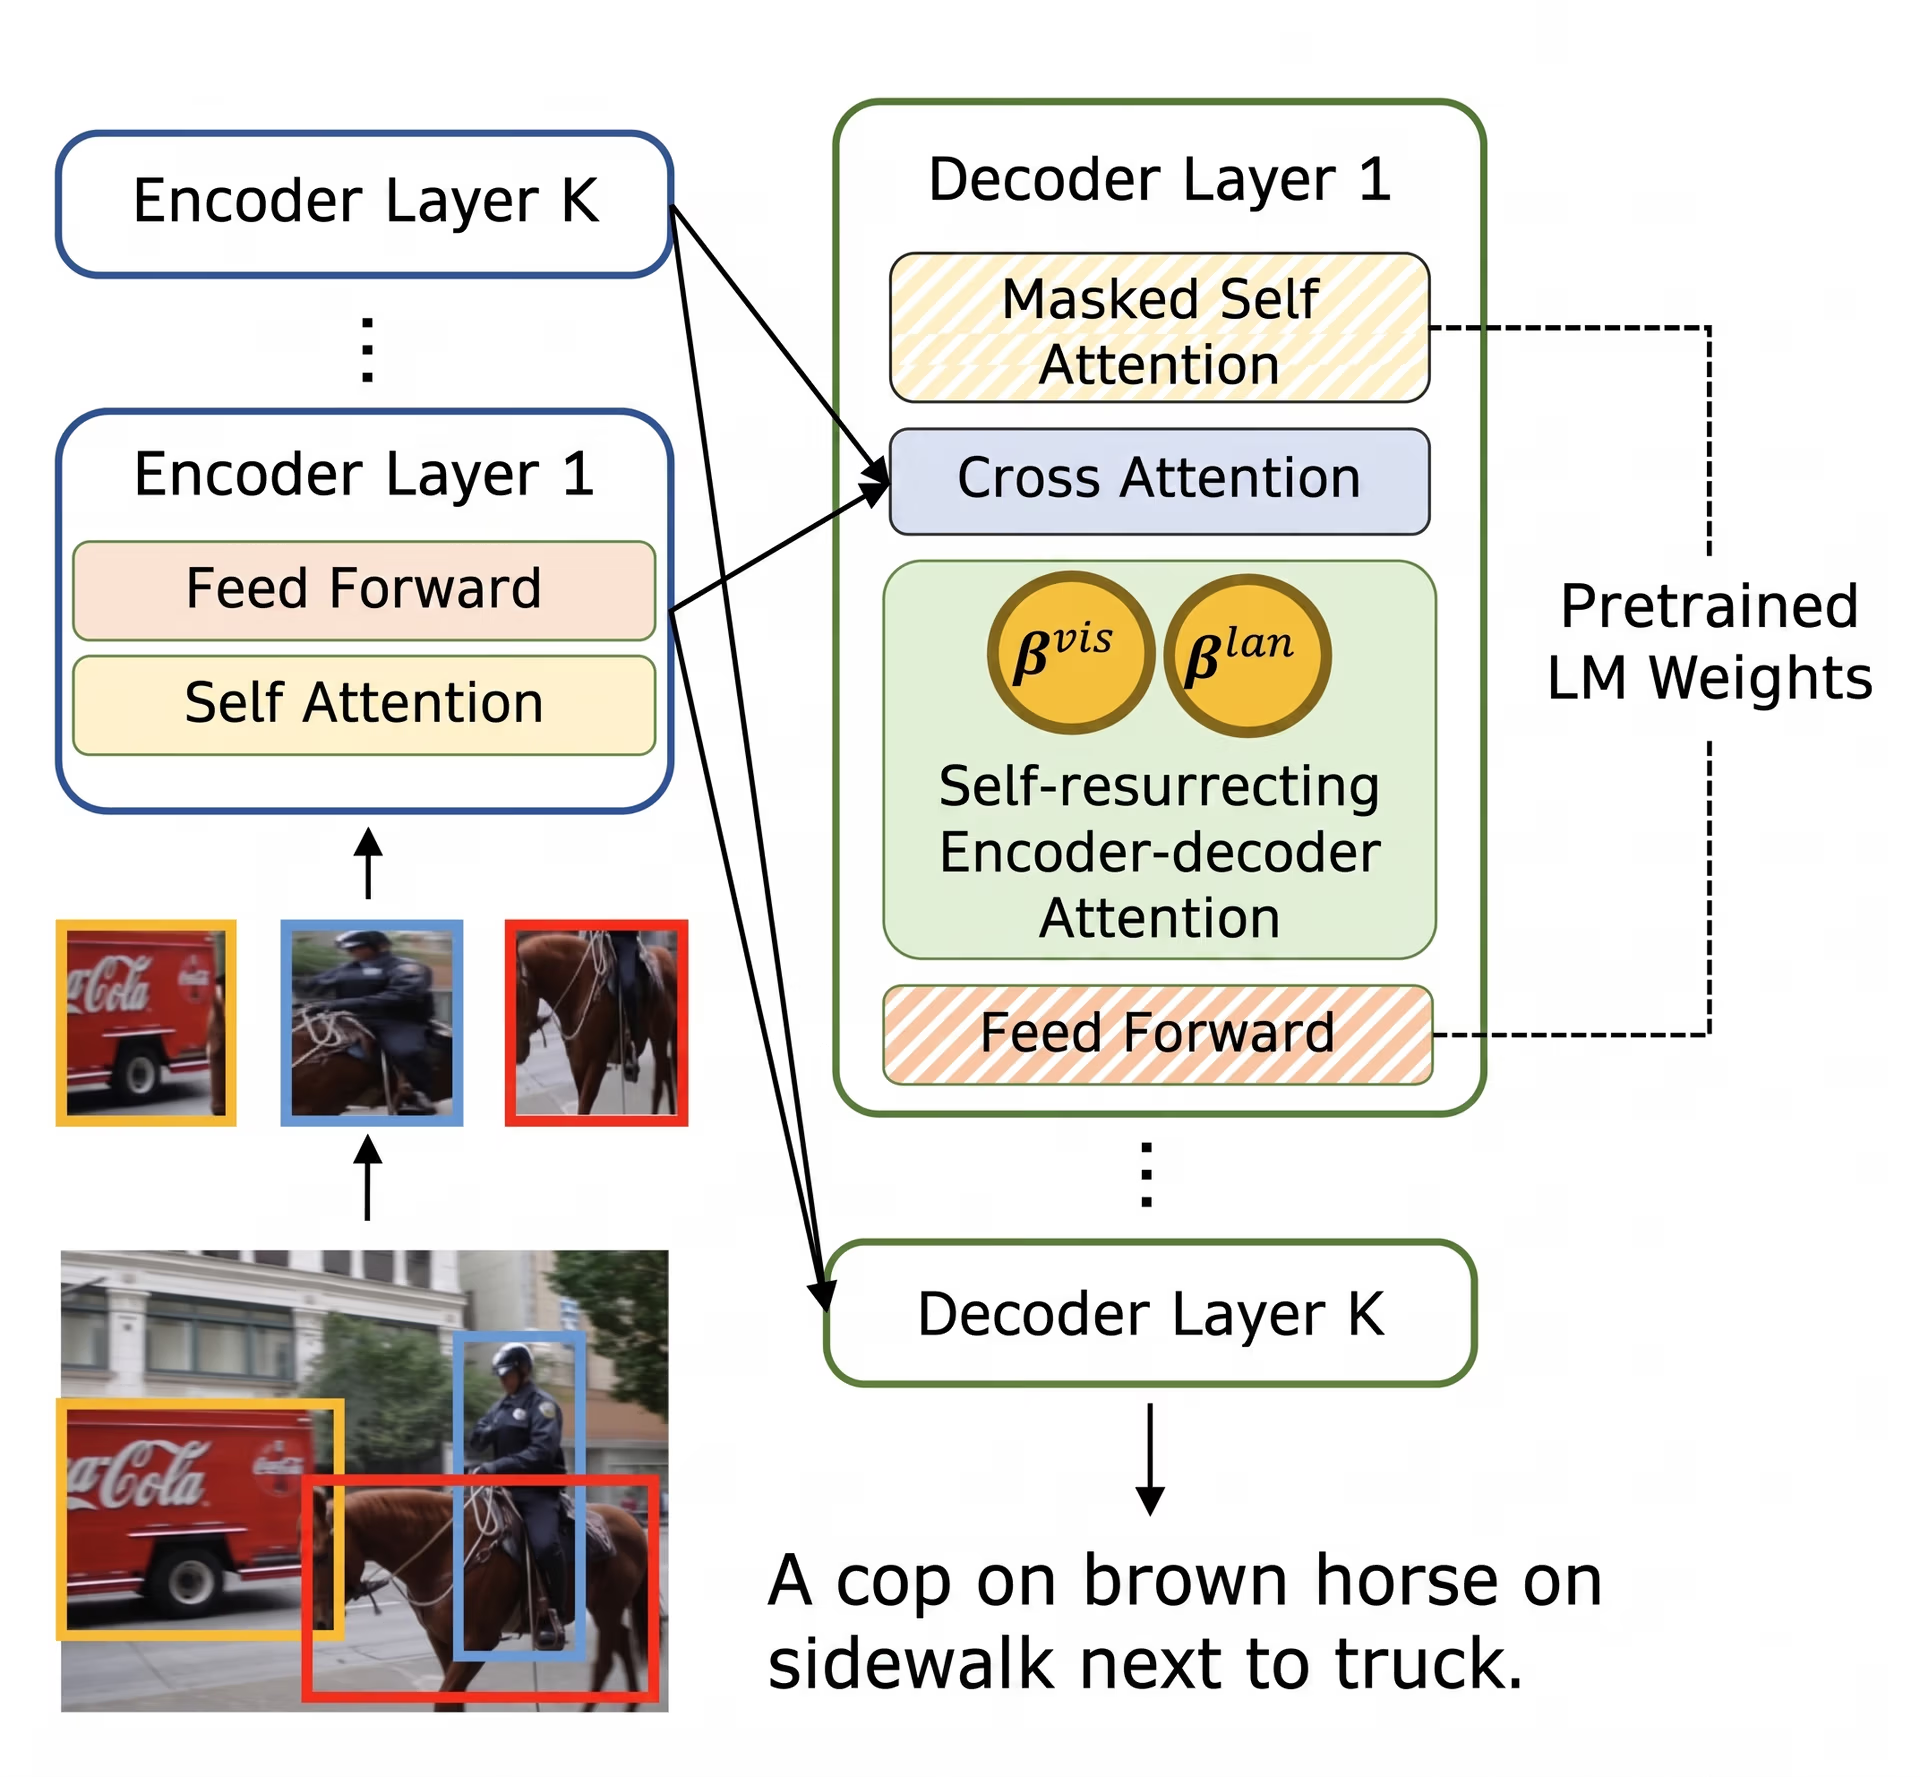
Abb. 4 VisualGPT-Modellarchitektur.
Anwendungen von Vision-Language-Modellen#
Vision-Language-Modelle wirken sich auf zahlreiche Branchen aus. Von der Verbesserung von E-Commerce-Plattformen bis hin zu einem leichter zugänglichen Internet sind die möglichen Einsatzgebiete von VLMs vielversprechend. Sehen wir uns einige dieser Anwendungen an.
Produktbeschreibungen erstellen#
Beim Online-Shopping siehst du detaillierte Beschreibungen zu jedem Produkt, doch deren Erstellung kann zeitaufwendig sein. VLMs vereinfachen diesen Prozess, indem sie die Beschreibungen automatisch erstellen. Onlinehändler können mit Vision-Language-Modellen direkt aus Produktbildern detaillierte und präzise Beschreibungen erstellen.
Hochwertige Produktbeschreibungen helfen Suchmaschinen, Produkte anhand der darin genannten Eigenschaften zu erkennen. Eine Beschreibung mit den Angaben „langärmelig“ und „Baumwollkragen“ hilft Kunden beispielsweise dabei, leichter ein „langärmeliges Baumwollhemd“ zu finden. Außerdem können Kunden schneller finden, wonach sie suchen, was wiederum den Umsatz und die Kundenzufriedenheit steigert.
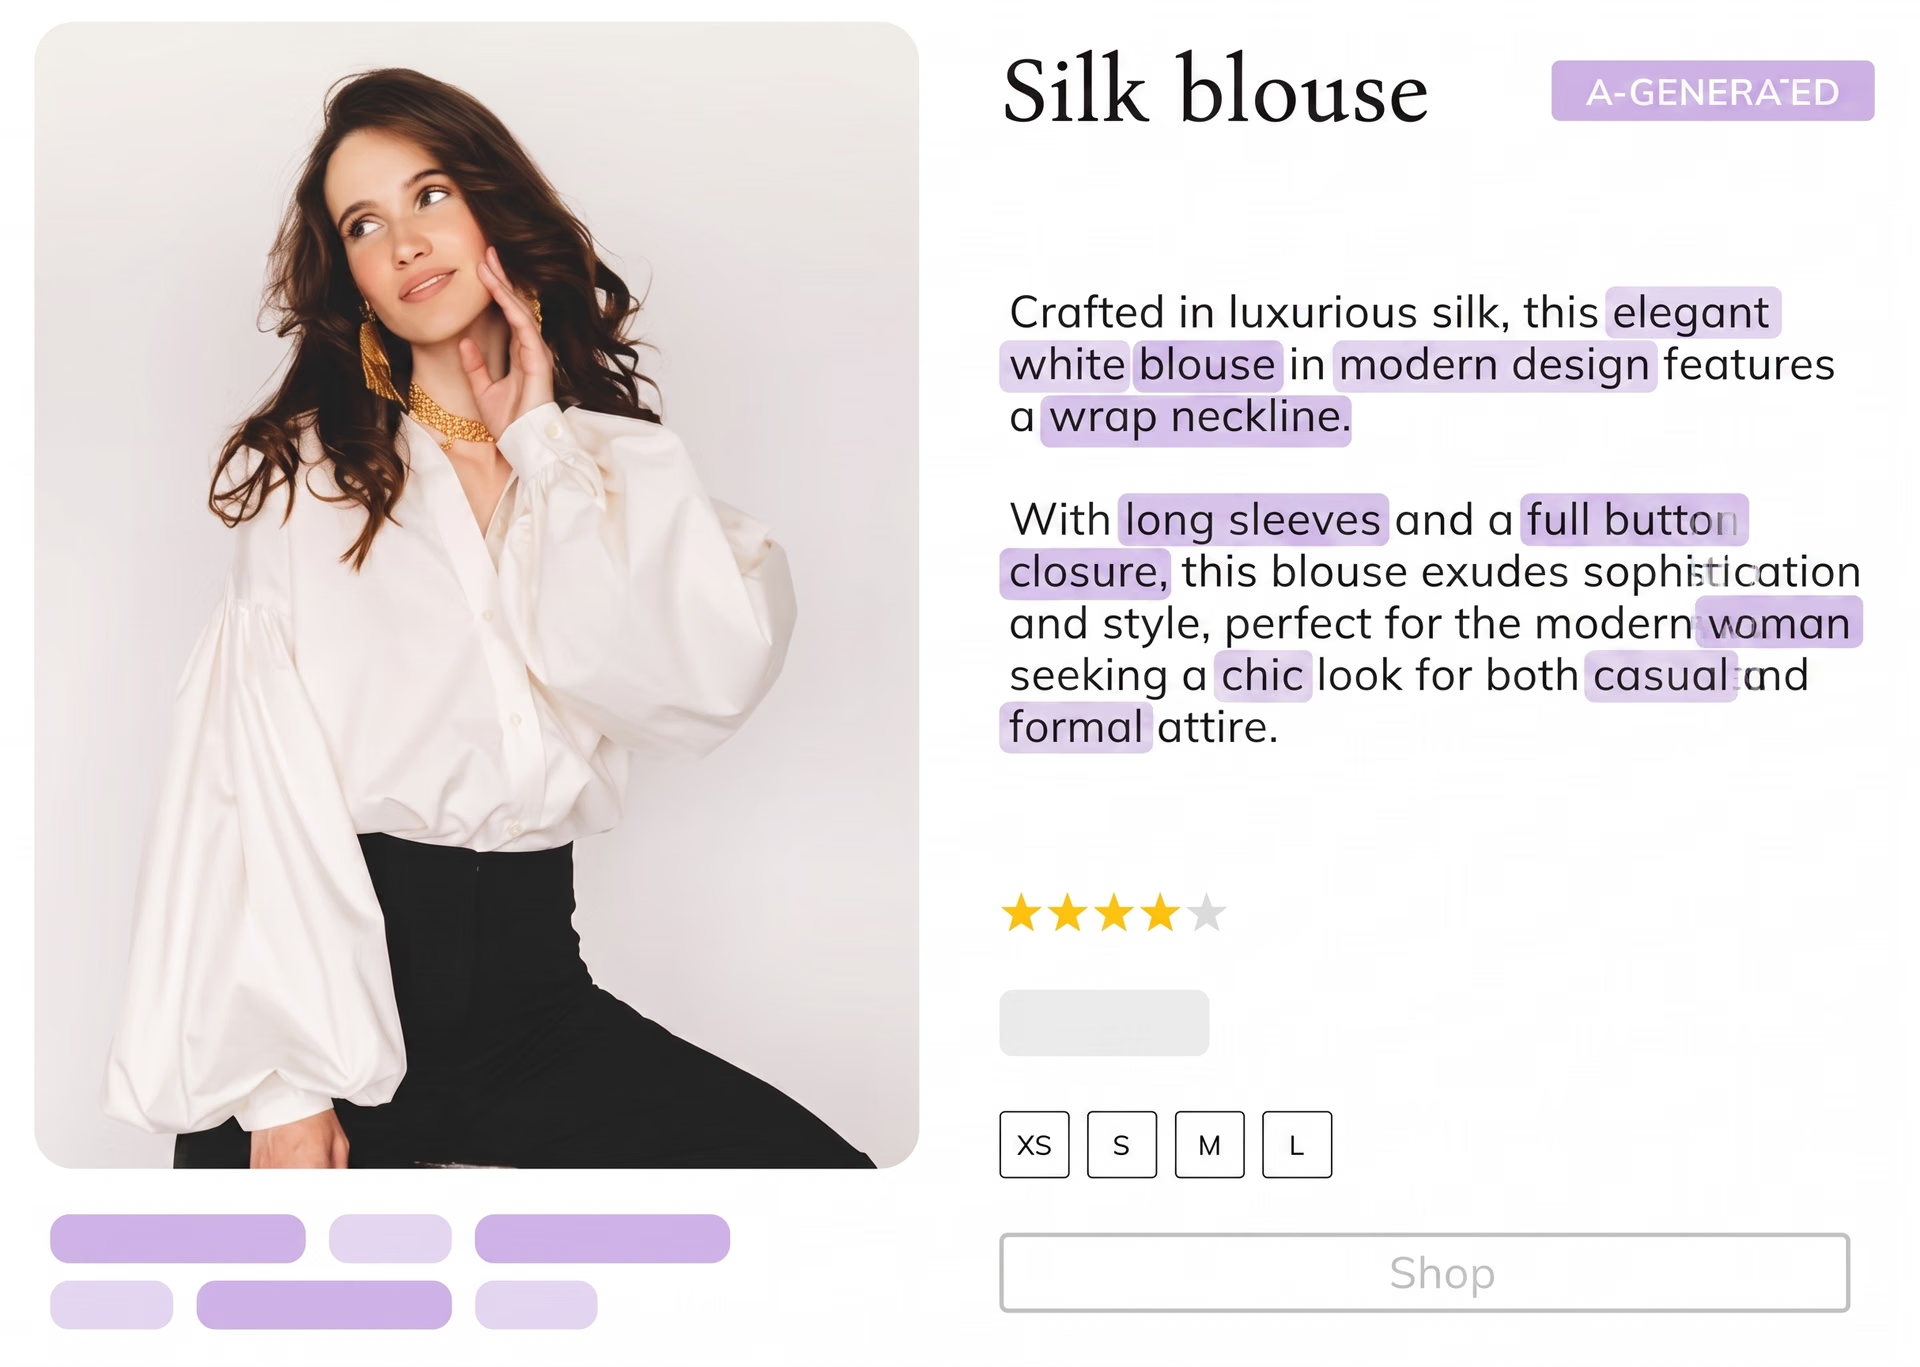
Abb. 5 Beispiel einer von KI erstellten Produktbeschreibung.
Modelle der generativen KI wie BLIP-2 sind Beispiele für hochentwickelte VLMs, die Produkteigenschaften direkt aus Bildern vorhersagen können. BLIP-2 verwendet mehrere Komponenten, um E-Commerce-Produkte präzise zu verstehen und zu beschreiben. Zuerst verarbeitet und erfasst ein Bildencoder die visuellen Merkmale des Produkts. Anschließend interpretiert ein Abfrage-Transformer diese visuellen Informationen im Zusammenhang mit bestimmten Fragen oder Aufgaben. Schließlich erstellt ein großes Sprachmodell detaillierte und präzise Produktbeschreibungen.
Das Internet zugänglicher machen#
Vision-Language-Modelle können das Internet durch Bildbeschriftungen zugänglicher machen, insbesondere für Menschen mit Sehbehinderung. Traditionell müssen Nutzer Beschreibungen visueller Inhalte auf Websites und in sozialen Medien eingeben. Wenn du beispielsweise etwas auf Instagram postest, kannst du Alternativtext für Screenreader hinzufügen. VLMs können diesen Vorgang jedoch automatisieren.
Wenn ein VLM ein Bild einer auf einem Sofa sitzenden Katze sieht, kann es die Bildunterschrift „Eine Katze sitzt auf einem Sofa“ erstellen und damit die Szene für sehbehinderte Nutzer verständlich machen. VLMs nutzen Verfahren wie Few-Shot-Prompting, bei dem sie anhand einiger Bild-Beschriftungs-Paare lernen, und Chain-of-Thought-Prompting, das ihnen hilft, komplexe Szenen logisch aufzuschlüsseln. Diese Verfahren sorgen dafür, dass die erstellten Bildunterschriften zusammenhängender und detaillierter sind.
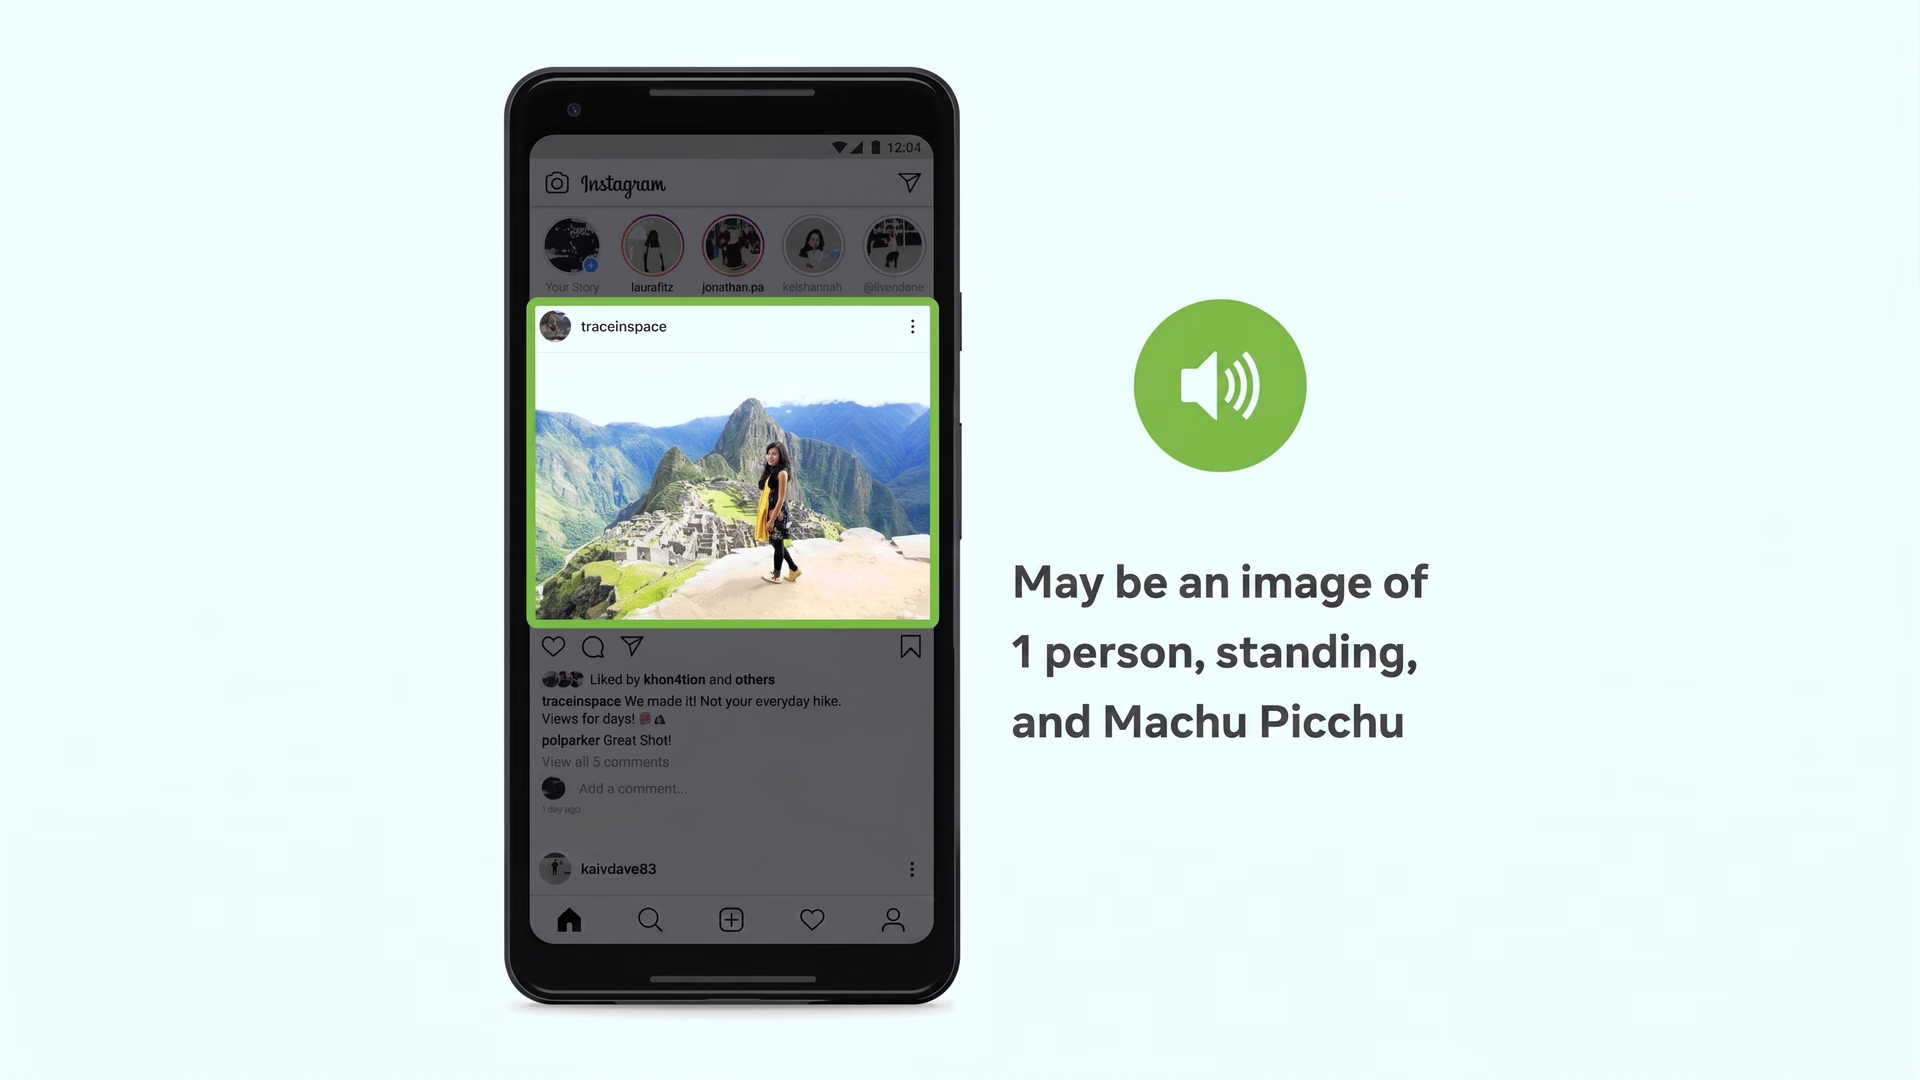
Abb. 6 Mit KI Bildunterschriften erstellen.
Zu diesem Zweck erstellt Googles Funktion „Bildbeschreibungen von Google abrufen“ in Chrome automatisch Beschreibungen für Bilder ohne Alternativtext. Diese von KI erstellten Beschreibungen sind möglicherweise nicht so detailliert wie von Menschen verfasste, bieten aber dennoch wertvolle Informationen.
Vorteile und Einschränkungen von Vision-Language-Modellen#
Vision-Language-Modelle (VLMs) bieten zahlreiche Vorteile, da sie visuelle und textuelle Daten kombinieren. Zu den wichtigsten Vorteilen gehören:
- Verbesserte Interaktion zwischen Mensch und Maschine: Systeme können sowohl visuelle als auch textuelle Eingaben verstehen und darauf reagieren, wodurch virtuelle Assistenten, Chatbots und Robotik verbessert werden.
- Fortschrittliche Diagnostik und Analyse: Unterstützung im medizinischen Bereich durch Bildanalysen und das Erstellen von Beschreibungen, Zweitmeinungen für Fachkräfte im Gesundheitswesen sowie die Erkennung von Anomalien.
- Interaktives Geschichtenerzählen und Unterhaltung: Durch die Kombination visueller und textueller Eingaben lassen sich fesselnde Erzählungen erstellen, die das Nutzererlebnis bei Spielen und in der virtuellen Realität verbessern.
Trotz ihrer beeindruckenden Fähigkeiten haben Vision-Language-Modelle auch einige Einschränkungen. Bei VLMs solltest du Folgendes beachten:
- Hoher Rechenbedarf: Das Trainieren und Bereitstellen von VLMs erfordert erhebliche Rechenressourcen, wodurch sie kostspielig und weniger zugänglich sind.
- Abhängigkeit von Daten und Voreingenommenheit: Werden VLMs mit wenig vielfältigen oder verzerrten Datensätzen trainiert, können sie voreingenommene Ergebnisse liefern und so Stereotype und Fehlinformationen weiterverbreiten.
- Begrenztes Kontextverständnis: VLMs haben möglicherweise Schwierigkeiten, den größeren Zusammenhang oder Kontext zu verstehen, und erzeugen zu stark vereinfachte oder falsche Ausgaben.
Die wichtigsten Erkenntnisse#
Vision-Language-Modelle bieten enormes Potenzial in vielen Bereichen, etwa im E-Commerce und im Gesundheitswesen. Durch die Kombination visueller und textueller Daten können sie Innovationen vorantreiben und Branchen verändern. Es ist jedoch entscheidend, diese Technologien verantwortungsvoll und ethisch zu entwickeln, damit sie fair eingesetzt werden. Mit ihrer Weiterentwicklung werden VLMs Aufgaben wie die bildbasierte Suche verbessern und assistive Technologien unterstützen.
Bleib auf dem Laufenden über KI und tausche dich mit unserer Community aus! Sieh dir unser GitHub-Repository an und entdecke, wie wir mit KI innovative Lösungen in Bereichen wie der Fertigung und dem Gesundheitswesen entwickeln. 🚀









