Lerne Metas Llama 3 kennen
Erfahre mehr über Metas Llama 3, das im April 2024 veröffentlichte LLM mit offenen Gewichten: seine Varianten mit 8B und 70B Parametern, die Architektur, das Training im großen Maßstab und die Benchmark-Ergebnisse.
 Abirami Vina8 Min. Lesezeit
Als wir die (KI)-Innovationen des ersten Quartals 2024 zusammenfassten, stellten wir fest, dass verschiedene Organisationen laufend LLMs, also große Sprachmodelle, veröffentlichten. Dieser Entwicklung folgend veröffentlichte Meta am 18. April 2024 Llama 3, ein Open-Source-LLM der nächsten Generation auf dem neuesten Stand der Technik.
Vielleicht denkst du: Das ist doch nur ein weiteres LLM. Warum ist die KI-Community so begeistert davon?
Du kannst zwar Modelle wie GPT-3 oder Gemini für individuelle Antworten feinabstimmen, sie bieten jedoch keine vollständige Transparenz hinsichtlich ihrer internen Funktionsweise, etwa ihrer Trainingsdaten, Modellparameter oder Algorithmen. Im Gegensatz dazu ist Meta's Llama 3 transparenter, denn seine Architektur und Gewichte stehen zum Download bereit. Für die KI-Community bedeutet das mehr Freiheit zum Experimentieren.
In diesem Artikel erfahren wir, was Llama 3 kann, wie es entstanden ist und welche Auswirkungen es auf den Bereich der AI hat.
Die Entwicklung der Llama-Modelle von Meta#
Bevor wir uns Llama 3 genauer ansehen, werfen wir einen Blick auf die früheren Versionen.
Meta brachte Llama 1 im Februar 2023 auf den Markt. Es gab vier Varianten mit einer Parameterzahl von 7 bis 65 Milliarden. Im maschinellen Lernen bezeichnet „Parameter“ die Elemente eines Modells, die anhand der Trainingsdaten erlernt werden. Aufgrund seiner geringeren Parameterzahl hatte Llama 1 manchmal Schwierigkeiten, feine Bedeutungsunterschiede zu erfassen, und lieferte uneinheitliche Antworten.
Kurz nach Llama 1 brachte Meta im Juli 2023 Llama 2 auf den Markt. Das Modell wurde mit 2 Billionen Token trainiert. Ein Token steht für einen Textabschnitt, etwa ein Wort oder einen Wortteil, der als grundlegende Dateneinheit für die Verarbeitung im Modell dient. Das Modell verfügte außerdem über Verbesserungen wie ein auf 4096 Token verdoppeltes Kontextfenster, um längere Textpassagen zu verstehen, sowie über mehr als 1 Million menschliche Annotationen zur Verringerung von Fehlern. Trotz dieser Verbesserungen benötigte Llama 2 weiterhin viel Rechenleistung – ein Problem, das Meta mit Llama 3 beheben wollte.
Meta's Llama 3 im Überblick#
Llama 3 umfasst vier Varianten, die mit beeindruckenden 15 Billionen Tokens trainiert wurden. Mehr als 5 % der Trainingsdaten bestanden aus hochwertigen nicht englischsprachigen Daten aus über 30 Sprachen. Alle Llama-3-Varianten lassen sich auf verschiedenen Arten handelsüblicher Hardware ausführen und haben eine Kontextlänge von 8.000 Tokens.
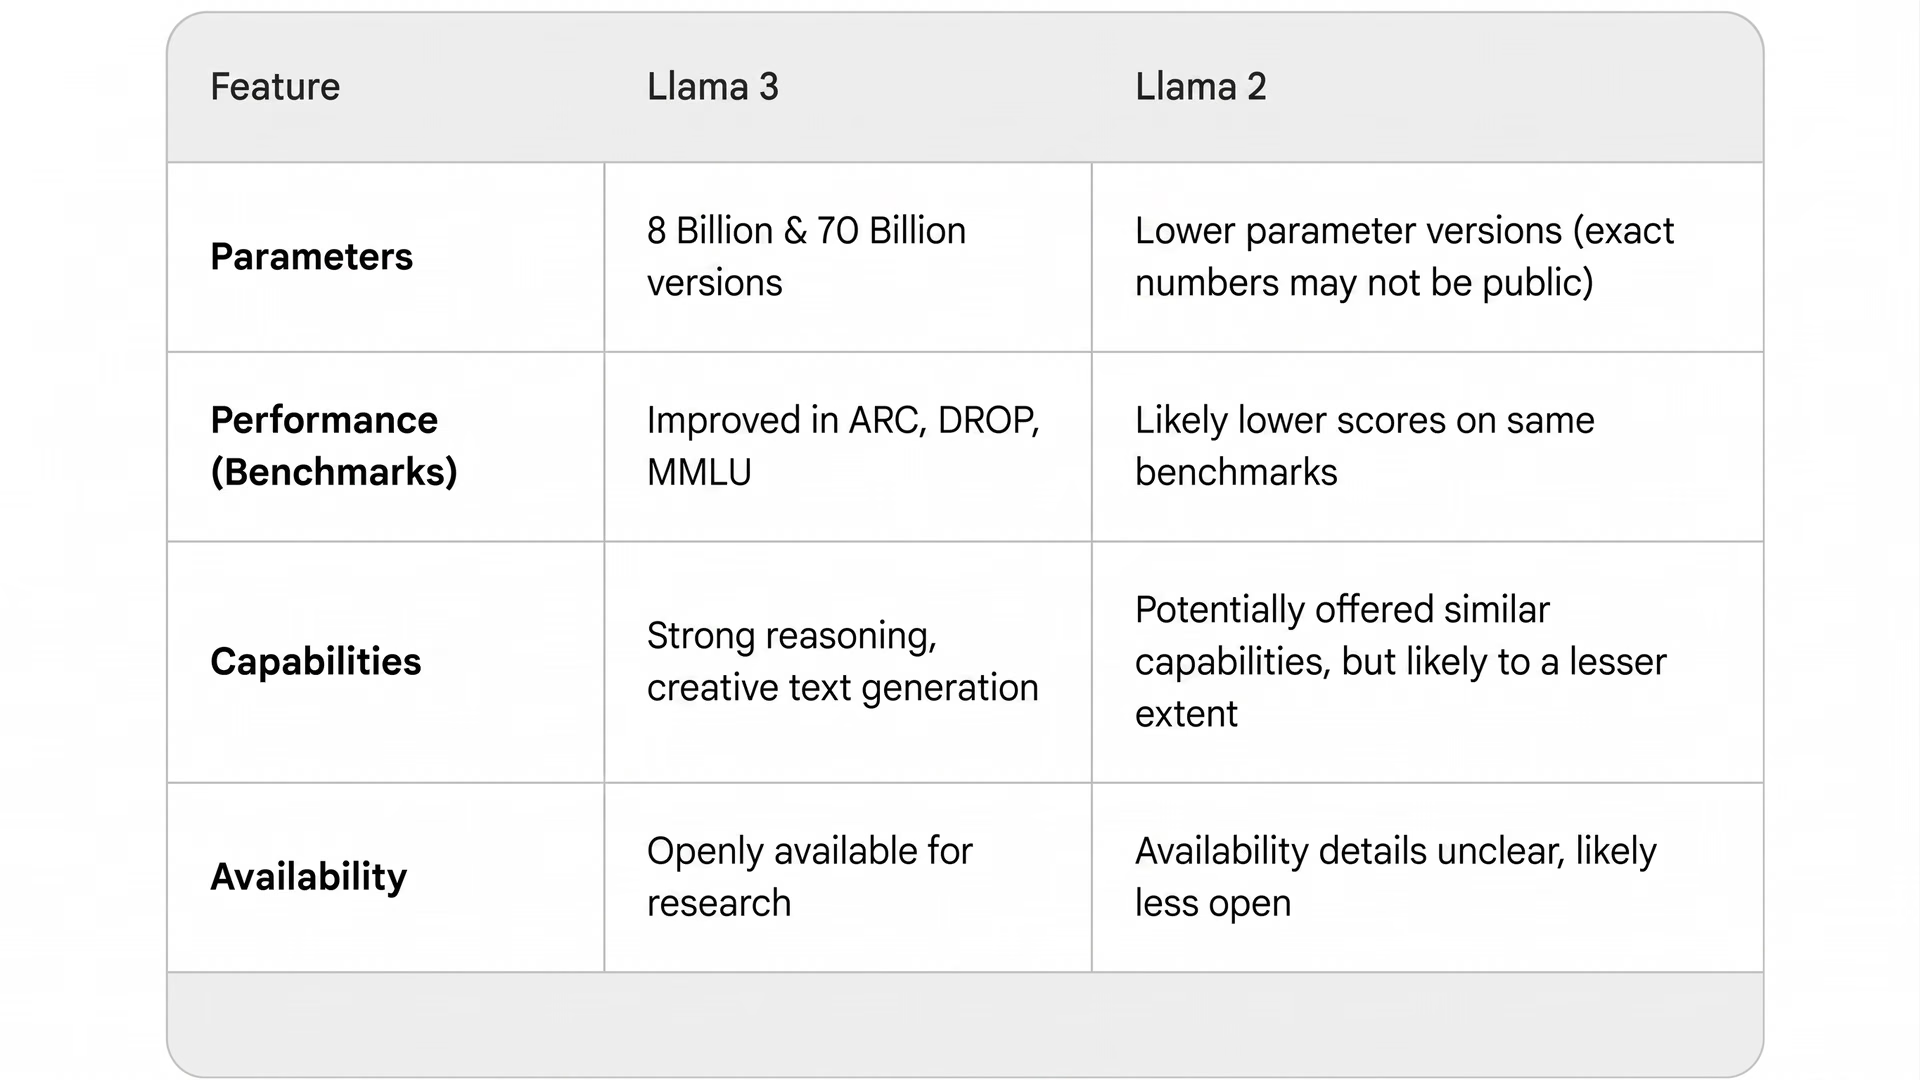
Abb. 1. Llama 3 im Vergleich zu Llama 2.
Die Modellvarianten sind in zwei Größen erhältlich: 8B und 70B, also mit 8 Milliarden beziehungsweise 70 Milliarden Parametern. Es gibt außerdem jeweils eine Basis- und eine Instruct-Version. „Base“ bezeichnet die standardmäßig vortrainierte Version. „Instruct“ ist eine Version, die darauf abgestimmt wurde, Anweisungen zu befolgen und sich für Dialoganwendungen eignet.
Hier sind die Varianten des Llama-3-Modells:
- Meta-Llama-3-8b: Das 8B-Basismodell bietet grundlegende KI-Funktionen und eignet sich ideal für allgemeine Aufgaben wie die Entwicklung von Chatbots für den Kundenservice.
- Meta-Llama-3-8b-instruct: Eine für bestimmte Aufgaben optimierte, feinabgestimmte Instruct-Version des 8B-Modells. Sie kann beispielsweise für die Entwicklung von Lernwerkzeugen verwendet werden, die komplexe Themen erklären.
- Meta-Llama-3-70b: Das 70B-Basismodell ist für leistungsstarke KI-Anwendungen ausgelegt. Es eignet sich gut für Anwendungen wie die Verarbeitung umfangreicher biomedizinischer Fachliteratur zur Arzneimittelforschung.
- Meta-Llama-3-70b-instruct: Diese Version wurde anhand des 70B-Modells feinabgestimmt und eignet sich für Anwendungen, bei denen höchste Präzision entscheidend ist, etwa bei der Analyse juristischer oder medizinischer Dokumente.
Die Architektur des Llama-3-Modells von Meta#
Wie bei allen anderen KI-Neuerungen von Meta wurden auch bei der Entwicklung von Llama 3 strenge Maßnahmen zur Qualitätskontrolle ergriffen, um die Datenintegrität zu wahren und Verzerrungen zu minimieren. So entstand ein leistungsstarkes Modell, das verantwortungsvoll entwickelt wurde.
Die Architektur des Llama-3-Modells zeichnet sich durch ihren Fokus auf Effizienz und Leistung bei Aufgaben der natürlichen Sprachverarbeitung aus. Sie basiert auf einem Transformer-Framework und legt besonderen Wert auf Recheneffizienz, vor allem bei der Textgenerierung, indem sie eine reine Decoder-Architektur verwendet.
Das Modell erzeugt Ausgaben ausschließlich auf Grundlage des vorangehenden Kontexts und verzichtet auf einen separaten Encoder. Dadurch bleibt die Textgenerierung effizient.
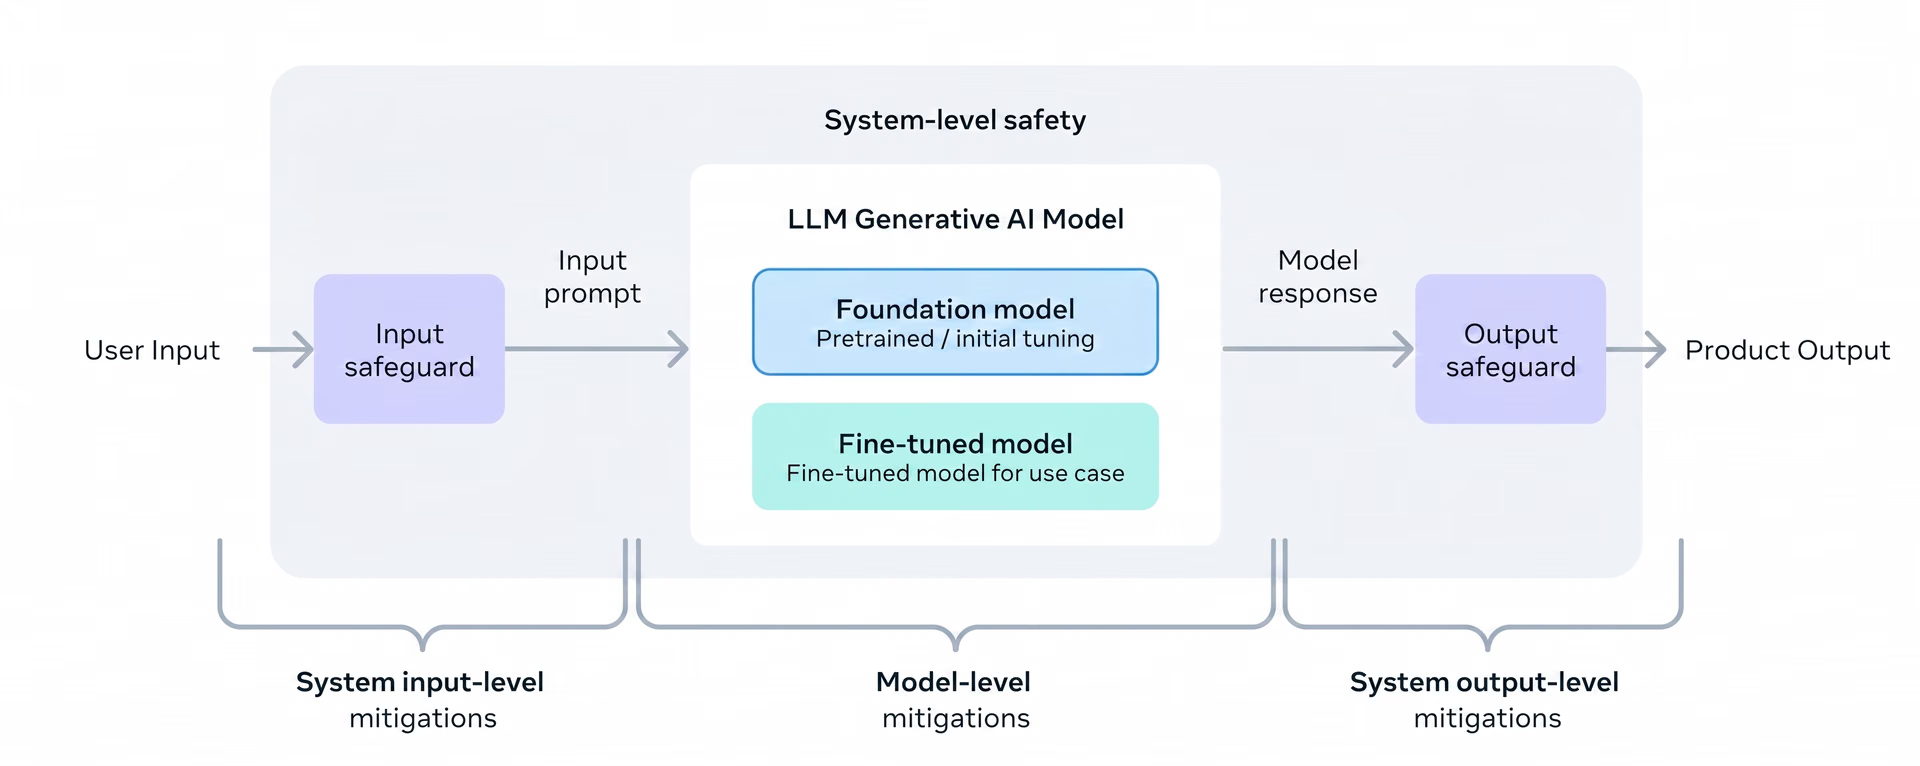
Abb. 2. Verantwortungsvolle Modellarchitektur von Llama 3.
Die Llama-3-Modelle verfügen über einen Tokenizer mit einem Vokabular von 128K Tokens. Ein größeres Vokabular ermöglicht es den Modellen, Text besser zu verstehen und zu verarbeiten. Außerdem nutzen die Modelle jetzt Grouped-Query-Attention (GQA), um die Inferenz effizienter zu gestalten. Bei GQA teilen sich Gruppen von Attention-Heads dieselben Schlüssel und Werte. Das reduziert den Speicherbedarf und beschleunigt die Textgenerierung bei nur geringem Qualitätsverlust.
Hier sind weitere interessante Details zur Architektur des Llama-3-Modells:
- Dokumentverarbeitung unter Berücksichtigung von Grenzen: Llama 3 sorgt für Klarheit an Dokumentgrenzen, was für Aufgaben wie Zusammenfassungen wichtig ist.
- Verbessertes Codeverständnis: Die Trainingsdaten von Llama 3 enthalten viermal so viele Codebeispiele, wodurch sich seine Programmierfähigkeiten verbessern.
- Zuverlässige Qualitätskontrolle: Strenge Maßnahmen, darunter heuristische Filter und das Entfernen nicht jugendfreier Inhalte, gewährleisten die Datenintegrität und minimieren Verzerrungen.
Llama 3 verändert unseren Ansatz beim Modelltraining#
Für das Training der größten Llama-3-Modelle wurden drei Arten der Parallelisierung kombiniert: Datenparallelisierung, Modellparallelisierung und Pipeline-Parallelisierung.
Bei der Datenparallelisierung werden die Trainingsdaten auf mehrere GPUs verteilt, während bei der Modellparallelisierung die Modellarchitektur aufgeteilt wird, damit die Rechenleistung jeder GPU genutzt werden kann. Bei der Pipeline-Parallelisierung wird der Trainingsprozess in aufeinanderfolgende Phasen unterteilt, um Berechnungen und Kommunikation zu optimieren.
Die effizienteste Implementierung erreichte eine hohe Rechenauslastung von mehr als 400 TFLOPS pro GPU, während das Modell gleichzeitig auf 16.000 GPUs trainiert wurde. Diese Trainingsläufe wurden auf zwei speziell entwickelten GPU-Clustern mit jeweils 24.000 GPUs durchgeführt. Diese umfangreiche Recheninfrastruktur stellte die nötige Leistung bereit, um die großen Llama-3-Modelle effizient zu trainieren.
Um die Verfügbarkeit der GPUs zu maximieren, wurde ein moderner Trainings-Stack entwickelt, der die Fehlererkennung, Fehlerbehandlung und Wartung automatisiert. Die Zuverlässigkeit der Hardware und die Erkennungsmechanismen wurden erheblich verbessert, um das Risiko unbemerkter Datenbeschädigung zu verringern. Außerdem wurden neue skalierbare Speichersysteme entwickelt, um den Aufwand für Checkpointing und Rollbacks zu reduzieren.
Dank dieser Verbesserungen lag die effektive Trainingszeit bei über 95 %. Zusammengenommen steigerten sie die Effizienz des Trainings von Llama 3 im Vergleich zu Llama 2 um etwa das Dreifache. Diese Effizienz eröffnet neue Möglichkeiten für Trainingsmethoden im Bereich der AI.
Neue Möglichkeiten mit Llama 3#
Da Llama 3 quelloffen ist, können Forschende und Studierende den Code untersuchen, Experimente durchführen und sich mit ethischen Fragen und Verzerrungen auseinandersetzen. Llama 3 richtet sich jedoch nicht nur an die Wissenschaft. Es kommt auch in praktischen Anwendungen zum Einsatz. Das Modell wird zur Grundlage der Meta-AI-Chatoberfläche und ist in Plattformen wie Facebook, Instagram, WhatsApp und Messenger integriert. Mit Meta AI können Nutzer natürliche Gespräche führen, personalisierte Empfehlungen erhalten, Aufgaben erledigen und sich mühelos mit anderen vernetzen.
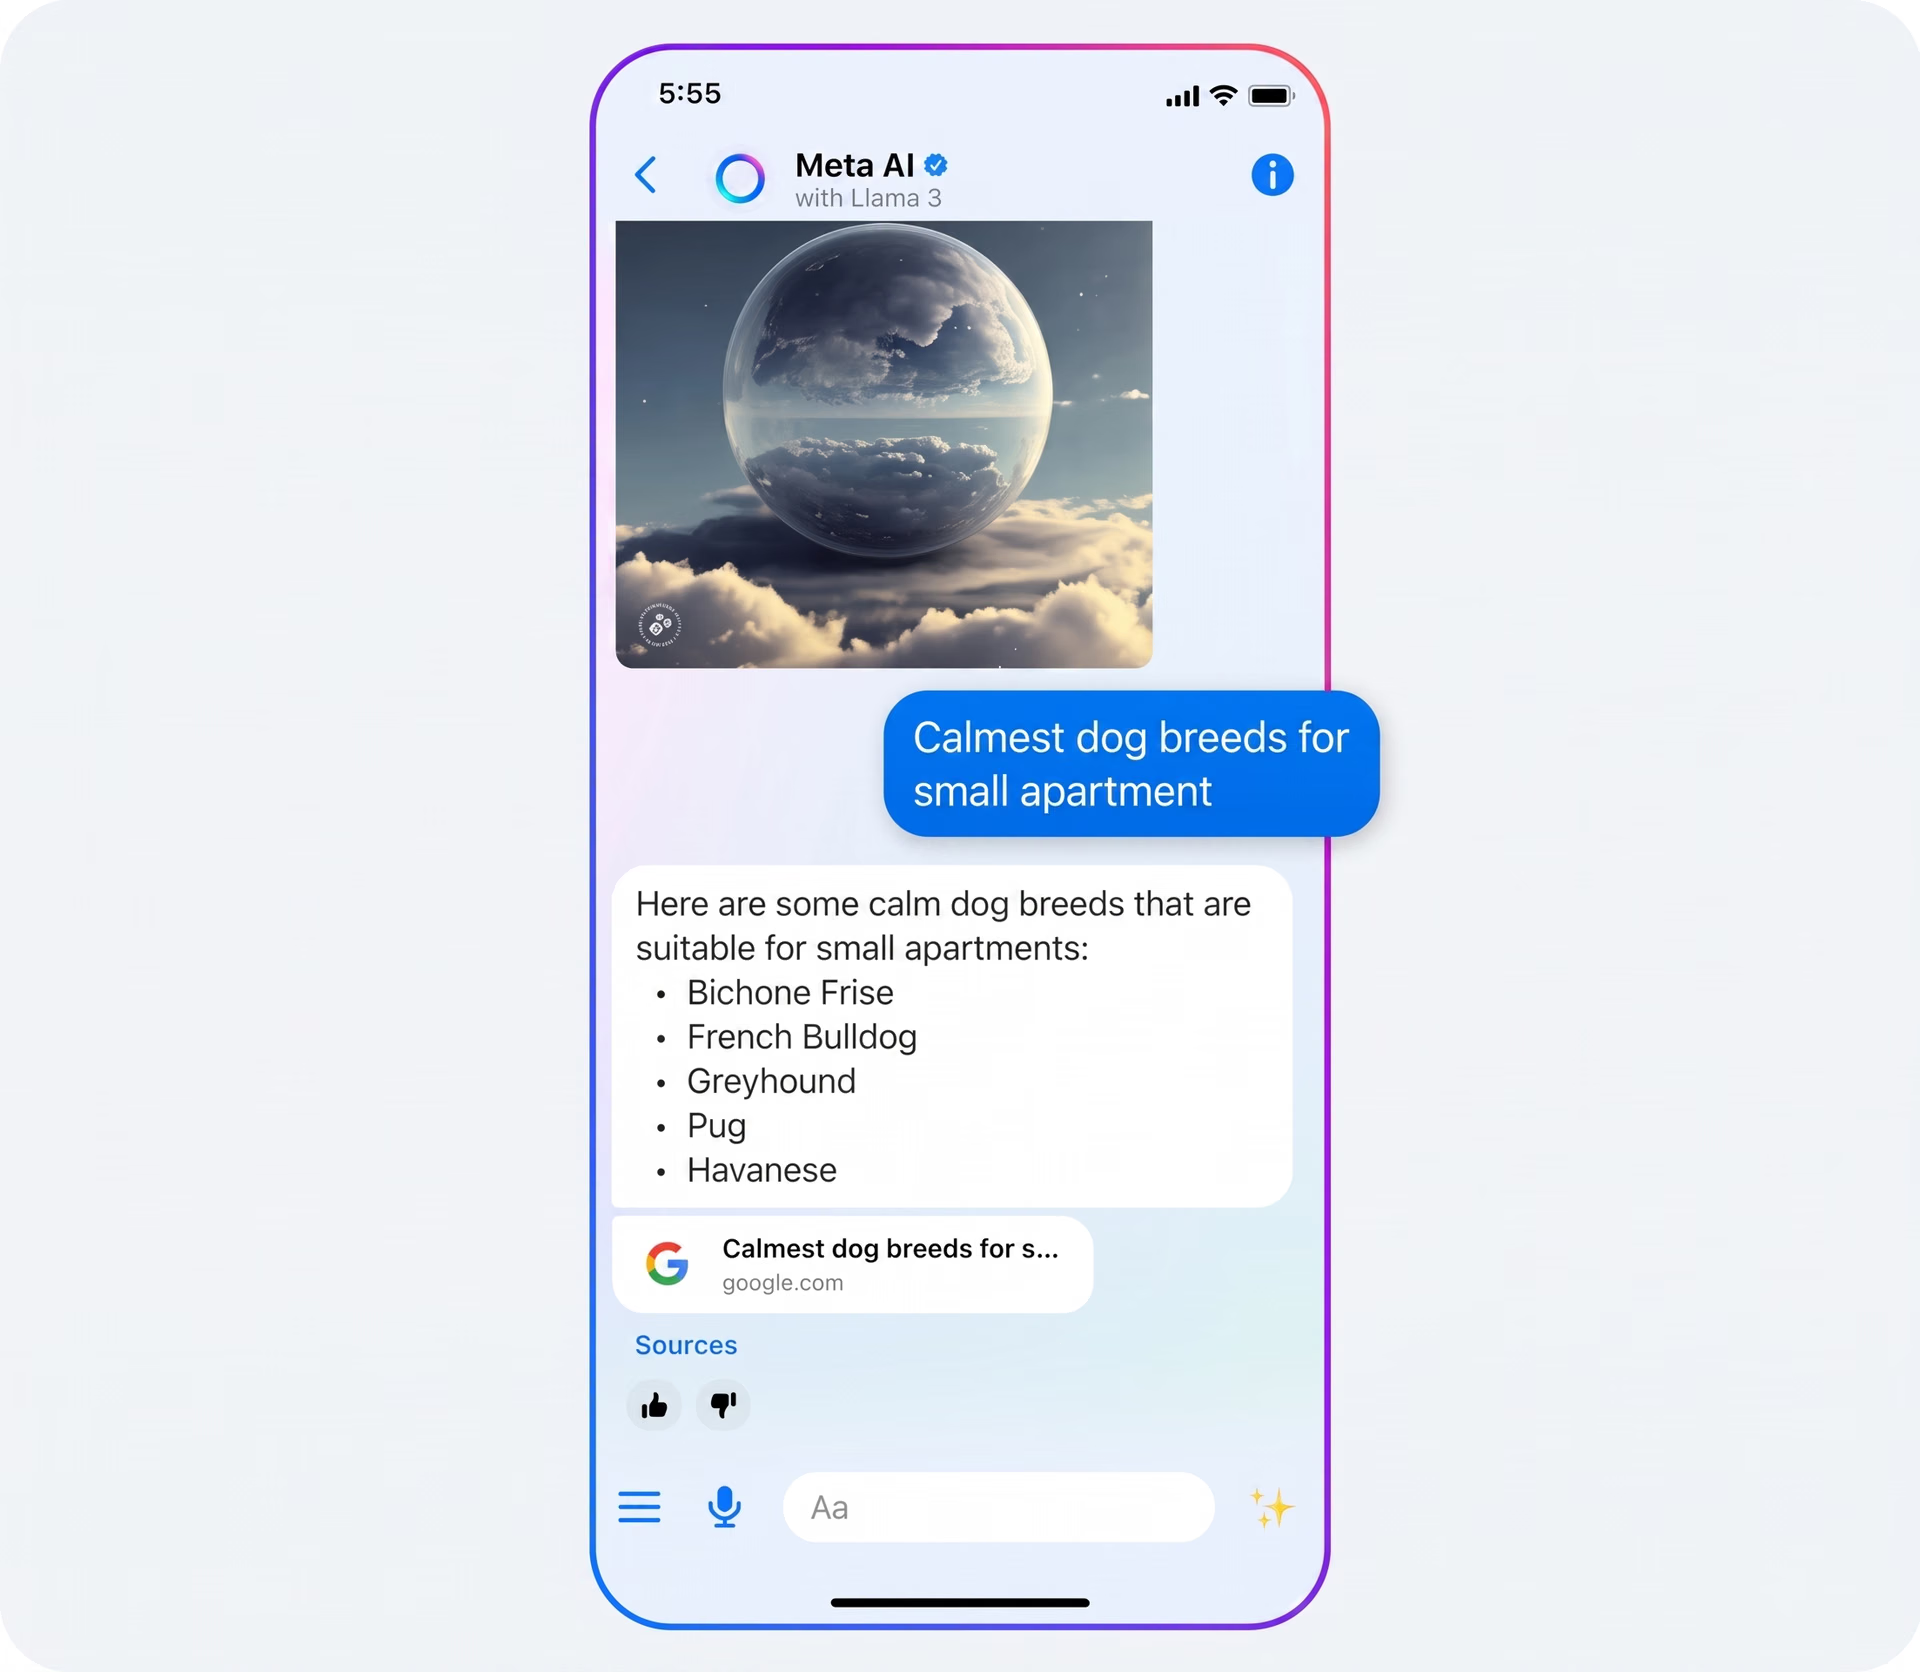
Abb. 3. Meta AI mit Llama 3.
Llama 3 im Vergleich zu anderen LLMs#
Llama 3 erzielt gute Ergebnisse bei mehreren wichtigen Benchmarks, mit denen komplexes Sprachverständnis und Schlussfolgerungsfähigkeiten bewertet werden. Hier sind einige Benchmarks, die verschiedene Aspekte der Fähigkeiten von Llama 3 prüfen:
- Massives mehrdimensionales Sprachverständnis (MMLU) – Misst das Wissen des Modells in verschiedenen Fachgebieten.
- Fragen und Antworten auf Graduiertenniveau, die sich nicht durch Google beantworten lassen (GPQA) – Bewertet die Fähigkeit des Modells, anspruchsvolle Fragen auf Graduiertenniveau in Biologie, Physik und Chemie zu beantworten.
- HumanEval – Konzentriert sich auf Programmier- und Problemlösungsaufgaben und prüft, ob das Modell funktionsfähigen Programmcode erzeugen und algorithmische Herausforderungen bewältigen kann.
Die starken Ergebnisse von Llama 3 in diesen Tests heben das Modell deutlich von Mitbewerbern wie Googles Gemma 7B, Mistrals Mistral 7B und Anthropics Claude 3 Sonnet ab. Den veröffentlichten Statistiken zufolge übertrifft insbesondere das 70B-Modell von Llama 3 die genannten Modelle in allen oben aufgeführten Benchmarks.
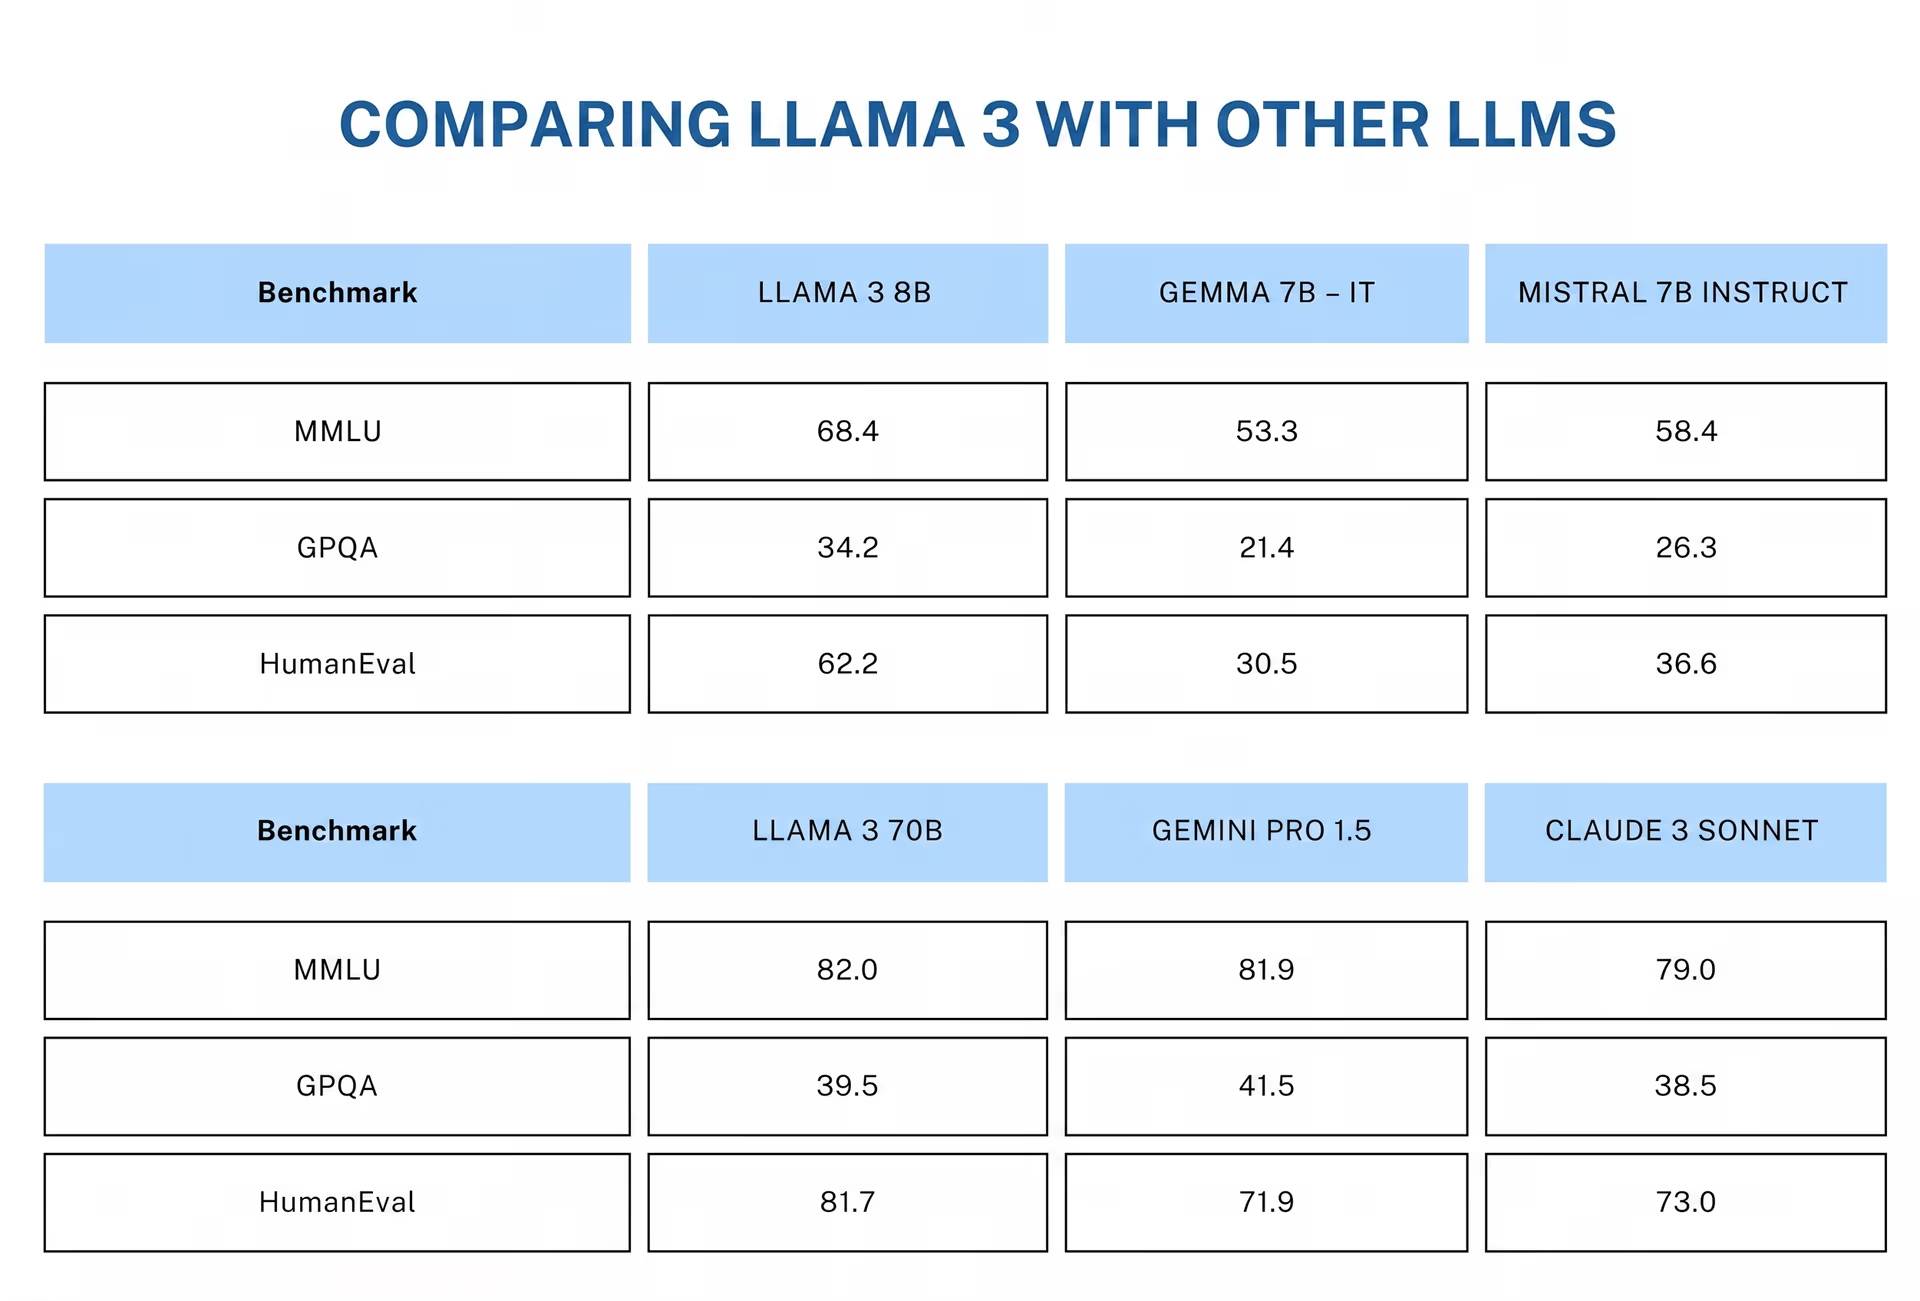
Abb. 4. Vergleich von Llama 3 mit anderen LLMs.
Meta macht Llama 3 weithin zugänglich#
Meta vergrößert die Reichweite von Llama 3, indem das Modell auf einer Vielzahl von Plattformen für allgemeine Nutzer und Entwickler verfügbar gemacht wird. Für den Alltag ist Llama 3 in beliebte Meta-Plattformen wie WhatsApp, Instagram, Facebook und Messenger integriert. Nutzer können direkt in diesen Apps auf erweiterte Funktionen wie die Suche in Echtzeit und die Erstellung kreativer Inhalte zugreifen.
Llama 3 wird auch in tragbare Technologien wie die Smart Glasses Ray-Ban Meta und das VR-Headset Meta Quest integriert, um interaktive Erlebnisse zu ermöglichen.
Für Entwickler ist Llama 3 auf einer Vielzahl von Plattformen verfügbar, darunter AWS, Databricks, Google Cloud, Hugging Face, Kaggle, IBM WatsonX, Microsoft Azure, NVIDIA NIM und Snowflake. Du kannst direkt bei Meta auf diese Modelle zugreifen. Die große Auswahl erleichtert Entwicklern die Integration dieser fortschrittlichen KI-Funktionen in ihre Projekte – ganz gleich, ob sie direkt mit Meta oder über andere beliebte Plattformen arbeiten möchten.
Das Wichtigste auf einen Blick#
Fortschritte im maschinellen Lernen verändern weiterhin, wie wir jeden Tag mit Technologie interagieren. Meta's Llama 3 zeigt, dass große Sprachmodelle längst nicht mehr nur Texte erzeugen. Sie bewältigen komplexe Probleme und verarbeiten mehrere Sprachen. Insgesamt macht Llama 3 KI anpassungsfähiger und zugänglicher als je zuvor. Die geplanten Verbesserungen für Llama 3 versprechen weitere Fähigkeiten wie Multimodalität und längere Kontextfenster.
Sieh dir unser GitHub-Repository an und werde Teil unserer Community, um mehr über KI zu erfahren. Auf unseren Lösungsseiten erfährst du, wie KI in Bereichen wie der Fertigung und der Landwirtschaft eingesetzt wird.
Verfasst von
Content Creator · Ultralytics
Kommentare
Stelle eine Frage, teile deine Ergebnisse oder hilf anderen.









