Знакомство с Llama 3 от Meta
Узнай о Llama 3 от Meta — LLM с открытыми весами, выпущенной в апреле 2024 года: о версиях на 8B и 70B параметров, архитектуре, масштабном обучении и результатах тестирования.
 Abirami Vina7 мин. чтения
Подводя итоги инноваций в области искусственного интеллекта (AI) за первый квартал 2024 года, мы заметили, что разные организации одна за другой выпускали LLM, или большие языковые модели. Продолжая эту тенденцию, 18 апреля 2024 года Meta выпустила Llama 3 — передовую LLM нового поколения с открытым исходным кодом.
Возможно, ты думаешь: Это же просто очередная LLM. Почему сообщество ИИ так ею воодушевлено?
Модели вроде GPT-3 или Gemini можно дообучать для получения персонализированных ответов, но они не обеспечивают полной прозрачности своих внутренних механизмов, например обучающих данных, параметров модели и алгоритмов. В отличие от них, Meta Llama 3 прозрачнее: её архитектуру и веса можно скачать. Для сообщества ИИ это означает больше свободы для экспериментов.
В этой статье мы узнаем, что умеет Llama 3, как она появилась и какое влияние оказала на область AI.
Эволюция моделей Llama от Meta#
Прежде чем перейти к Llama 3, давай вспомним её предыдущие версии.
В феврале 2023 года Meta выпустила Llama 1 в четырёх вариантах с количеством параметров от 7 до 65 миллиардов. В машинном обучении «параметры» — это элементы модели, которые она усваивает на обучающих данных. Из-за меньшего количества параметров Llama 1 иногда с трудом улавливала тонкие нюансы и давала непоследовательные ответы.
Вскоре после Llama 1 компания Meta выпустила Llama 2 в июле 2023 года. Модель обучили на 2 триллионах токенов. Токен — это фрагмент текста, например слово или его часть, который служит основной единицей данных для обработки моделью. В модели также появились улучшения: контекстное окно увеличили вдвое, до 4096 токенов, чтобы она могла понимать более длинные фрагменты текста, а более 1 миллиона аннотаций, подготовленных людьми, помогли снизить число ошибок. Несмотря на эти улучшения, Llama 2 по-прежнему требовала больших вычислительных мощностей — проблему, которую Meta стремилась решить с помощью Llama 3.
Представляем Llama 3 от Meta#
Llama 3 представлена в четырех вариантах, обученных на впечатляющем объеме — 15 триллионах токенов. Более 5% обучающих данных составляли высококачественные данные не на английском языке, охватывающие более 30 языков. Все варианты Llama 3 можно запускать на различных типах потребительского оборудования; длина контекстного окна составляет 8 тыс. токенов.
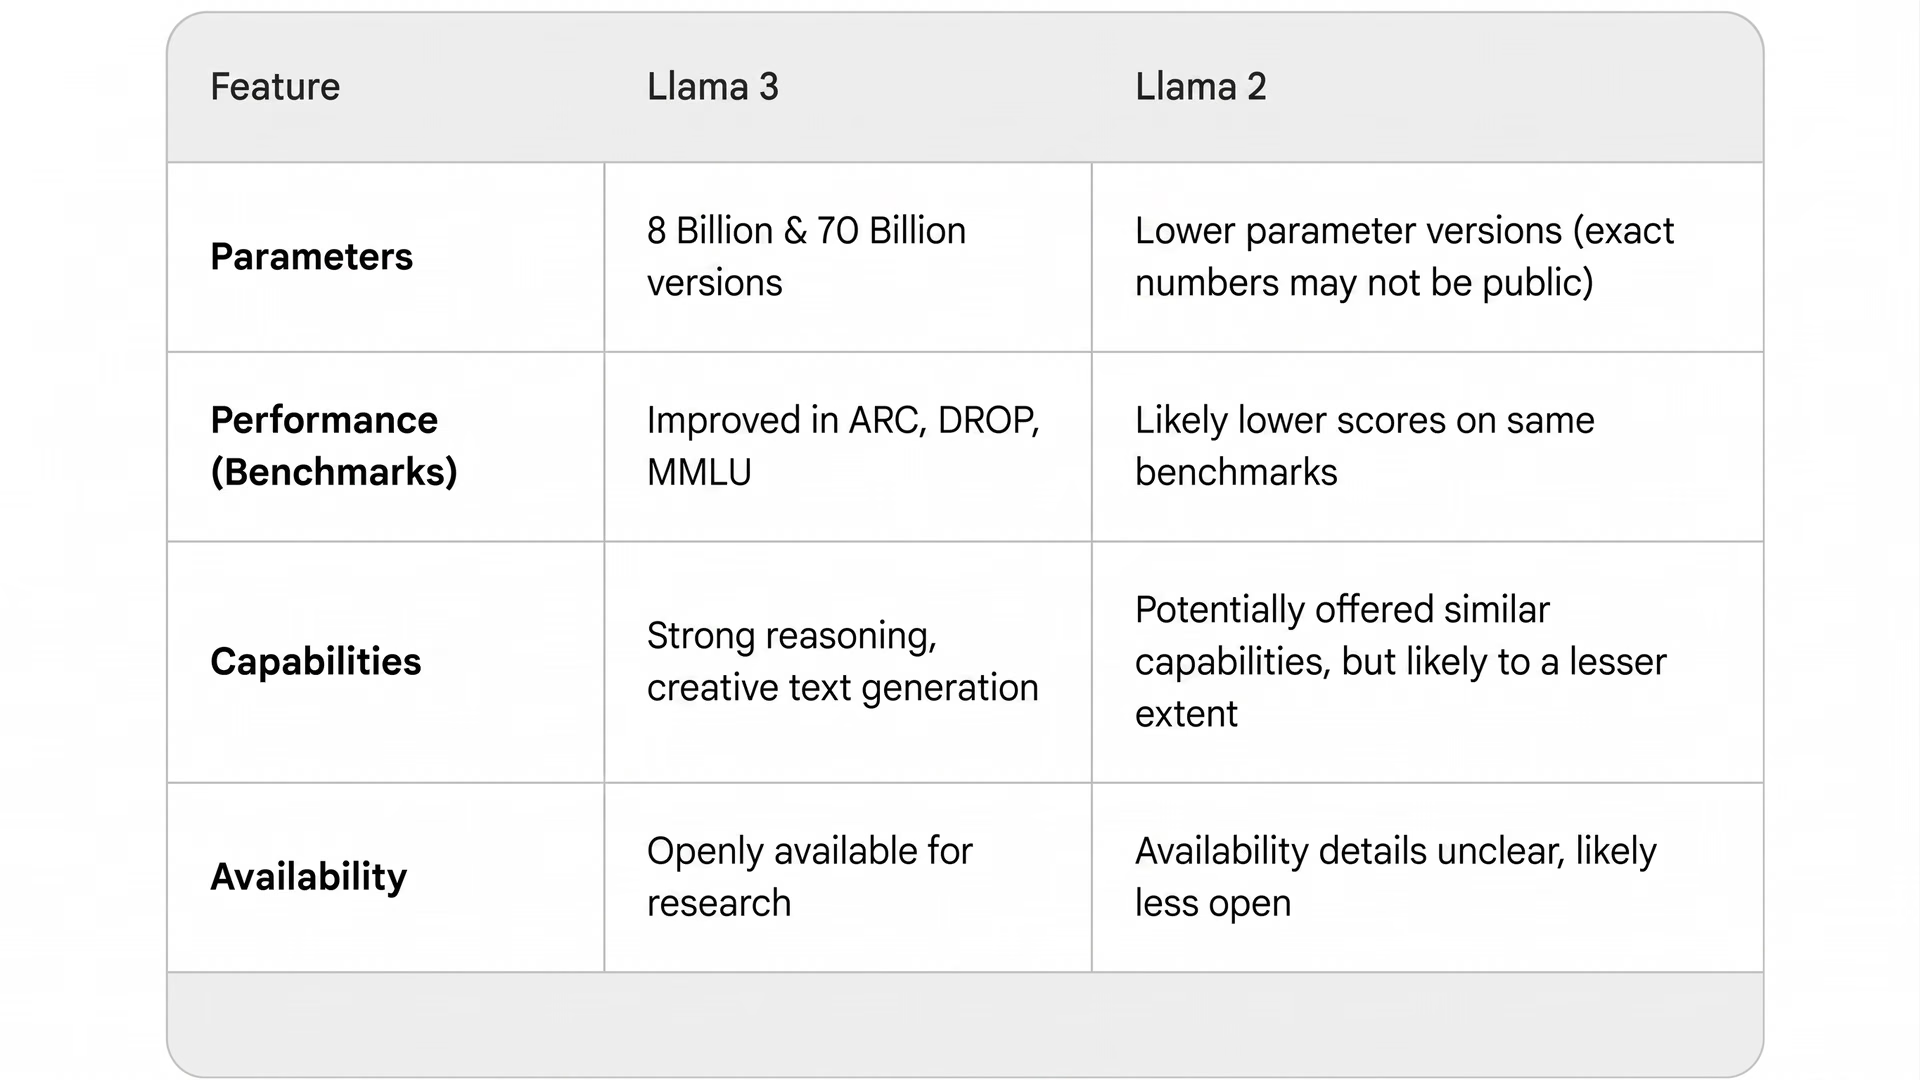
Рис. 1. Llama 3 и Llama 2: сравнение.
Модели представлены в двух размерах: 8B и 70B, что соответствует 8 и 70 миллиардам параметров. Также есть две версии: базовая и instruct. «Базовая» — это стандартная предварительно обученная версия. Версия «instruct» дополнительно настроена для выполнения инструкций и оптимизирована для диалоговых задач.
Вот варианты моделей Llama 3:
- Meta-Llama-3-8b: базовая модель 8B предоставляет основные возможности ИИ и подходит для общих задач, например разработки чат-ботов службы поддержки.
- Meta-Llama-3-8b-instruct: версия модели 8B, дообученная в формате instruct и оптимизированная для конкретных задач. Например, её можно использовать для создания обучающих инструментов, объясняющих сложные темы.
- Meta-Llama-3-70b: базовая модель 70B разработана для высокопроизводительных приложений ИИ. Она хорошо подойдёт для таких задач, как обработка обширной биомедицинской литературы в целях поиска лекарств.
- Meta-Llama-3-70b-instruct: эта версия дообучена на основе модели 70B для задач, требующих высокой точности, например анализа юридических или медицинских документов.
Архитектура модели Llama 3 от Meta#
Как и при разработке других ИИ-решений Meta, при создании Llama 3 применялись строгие меры контроля качества, чтобы сохранить целостность данных и свести предвзятость к минимуму. В результате получилась мощная модель, созданная ответственно.
Архитектура Llama 3 выделяется эффективностью и высокой производительностью при решении задач обработки естественного языка. Она построена на базе Transformer и ориентирована на вычислительную эффективность, особенно при генерации текста, благодаря архитектуре только с декодером.
Модель генерирует результаты исключительно на основе предшествующего контекста, без отдельного энкодера, что повышает эффективность генерации текста.
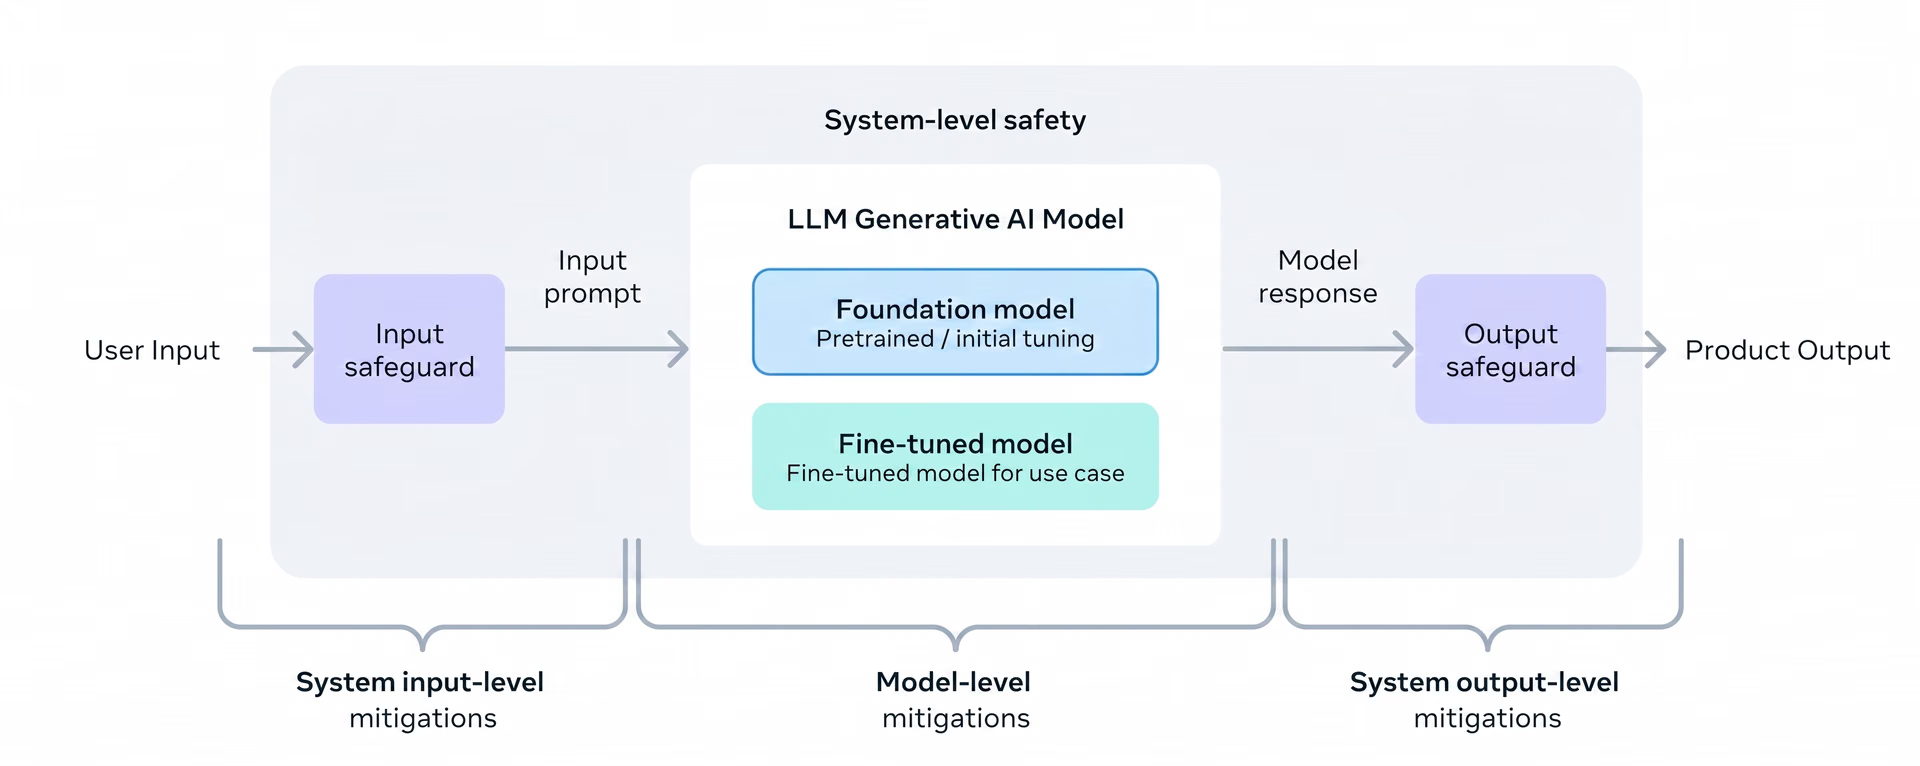
Рис. 2. Архитектура ответственной модели Llama 3.
В моделях Llama 3 используется токенизатор со словарём из 128K токенов. Более широкий словарь позволяет моделям лучше понимать и обрабатывать текст. Кроме того, для повышения эффективности инференса модели теперь используют внимание с групповыми запросами (GQA). GQA позволяет группам голов внимания использовать общие ключи и значения, что сокращает расход памяти и ускоряет генерацию текста с незначительной потерей качества.
Вот ещё несколько интересных подробностей об архитектуре Llama 3:
- Обработка документов с учётом границ: Llama 3 сохраняет ясность при переходе между документами, что важно для таких задач, как суммаризация.
- Улучшенное понимание кода: обучающие данные Llama 3 включают в четыре раза больше примеров кода, что расширяет возможности модели в программировании.
- Надёжный контроль качества: строгие меры, включая эвристические фильтры и удаление материалов NSFW, помогают сохранить целостность данных и свести предвзятость к минимуму.
Llama 3 меняет подход к обучению моделей#
Для обучения крупнейших моделей Llama 3 объединили три вида параллелизации: параллелизацию данных, моделей и конвейера.
Параллелизация данных распределяет обучающие данные между несколькими GPU, а параллелизация моделей разбивает архитектуру модели, чтобы задействовать вычислительные мощности каждого GPU. Параллелизация конвейера делит процесс обучения на последовательные этапы, оптимизируя вычисления и обмен данными.
Самая эффективная реализация обеспечила высокую утилизацию вычислительных ресурсов: при параллельном обучении на 16 000 GPU производительность превысила 400 TFLOPS на GPU. Обучение проводилось на двух специально созданных кластерах GPU, каждый из которых включал 24 000 GPU. Эта мощная вычислительная инфраструктура обеспечила ресурсы, необходимые для эффективного обучения крупномасштабных моделей Llama 3.
Чтобы максимально увеличить время бесперебойной работы GPU, разработали новый продвинутый стек для обучения, который автоматизировал обнаружение и устранение ошибок, а также обслуживание. Надёжность оборудования и механизмы обнаружения значительно улучшили, чтобы снизить риск незаметного повреждения данных. Кроме того, разработали новые масштабируемые системы хранения, чтобы сократить накладные расходы на создание контрольных точек и откат.
Благодаря этим улучшениям эффективное время обучения превысило 95%. В совокупности они примерно втрое повысили эффективность обучения Llama 3 по сравнению с Llama 2. Такая эффективность открывает новые возможности для методов обучения AI.
Новые возможности с Llama 3#
Поскольку Llama 3 имеет открытый исходный код, исследователи и студенты могут изучать её код, проводить эксперименты и обсуждать этические вопросы и предвзятость. Однако Llama 3 предназначена не только для академической среды — её используют и на практике. Она становится основой чат-интерфейса Meta AI, встроенного в такие платформы, как Facebook, Instagram, WhatsApp и Messenger. С помощью Meta AI пользователи могут вести диалоги на естественном языке, получать персональные рекомендации, выполнять задачи и легко общаться с другими.
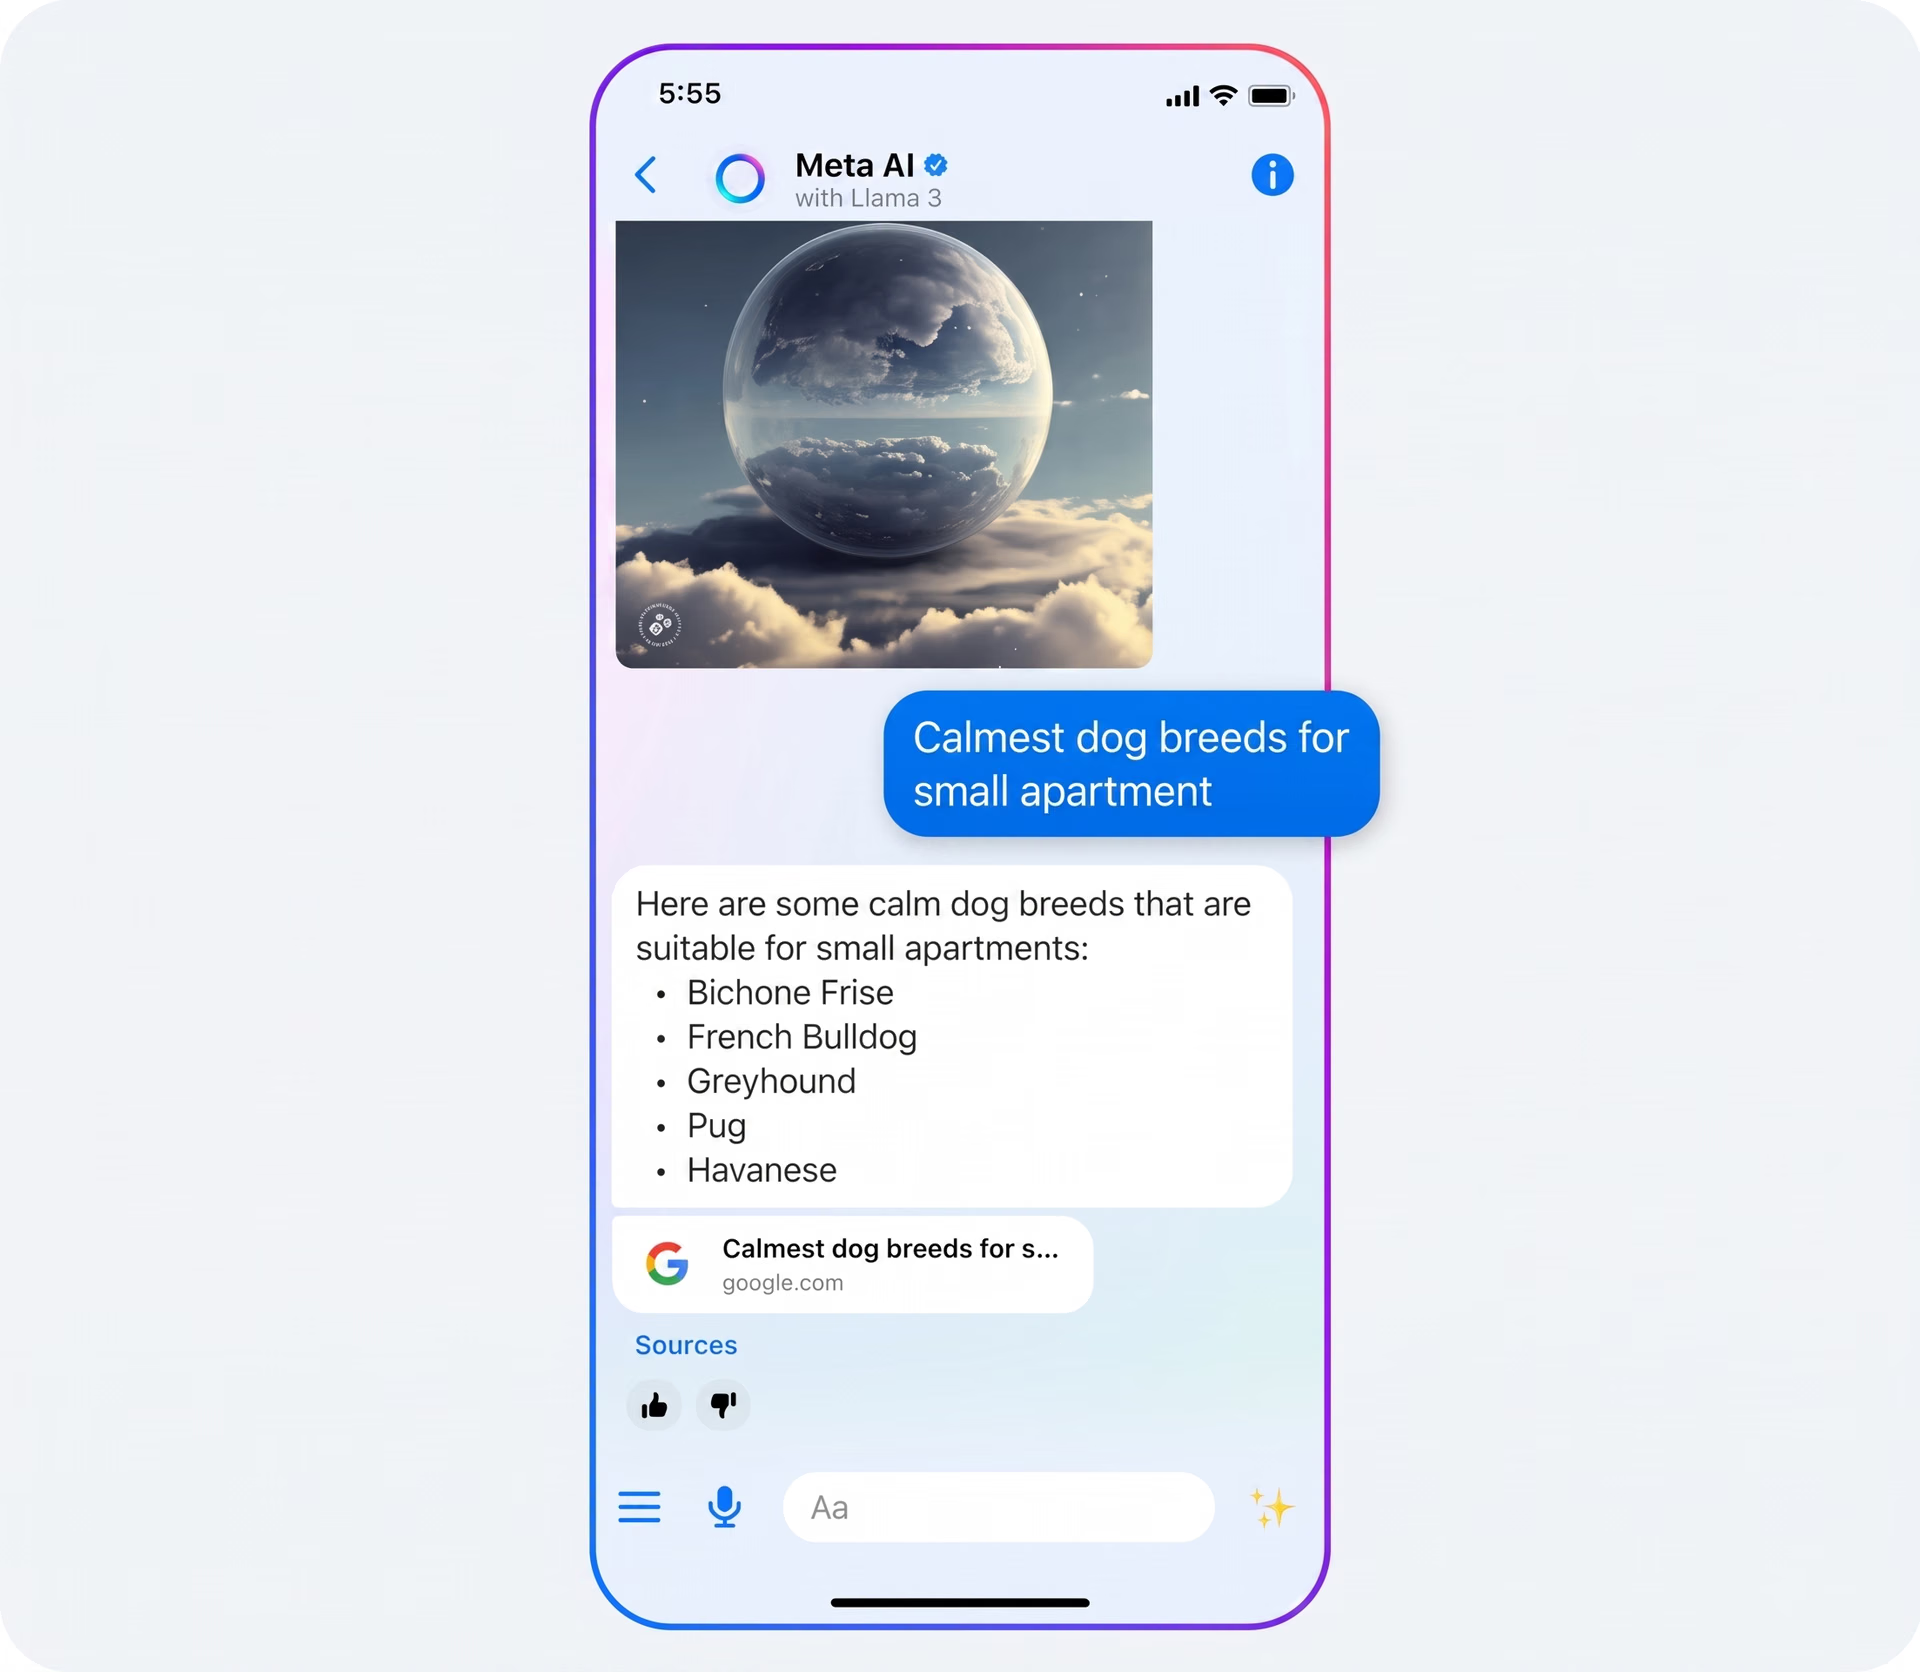
Рис. 3. Meta AI на базе Llama 3.
Сравнение Llama 3 с другими LLM#
Llama 3 показывает высокие результаты в нескольких ключевых бенчмарках, оценивающих сложное понимание языка и способности к рассуждению. Вот некоторые бенчмарки, проверяющие различные возможности Llama 3:
- Комплексная оценка знаний и понимания языка (MMLU) — измеряет знания модели в различных областях.
- Вопросы и ответы для аспирантов, защищённые от поиска Google (GPQA) — оценивает способность модели отвечать на сложные вопросы аспирантского уровня по биологии, физике и химии.
- HumanEval — проверяет навыки программирования и решения задач, оценивая способность модели генерировать рабочий код и решать алгоритмические задачи.
Высокие результаты Llama 3 в этих тестах явно отличают её от конкурентов, таких как Gemma 7B от Google, Mistral 7B от Mistral и Claude 3 Sonnet от Anthropic. Согласно опубликованной статистике, Llama 3, особенно модель 70B, превосходит эти модели во всех перечисленных выше бенчмарках.
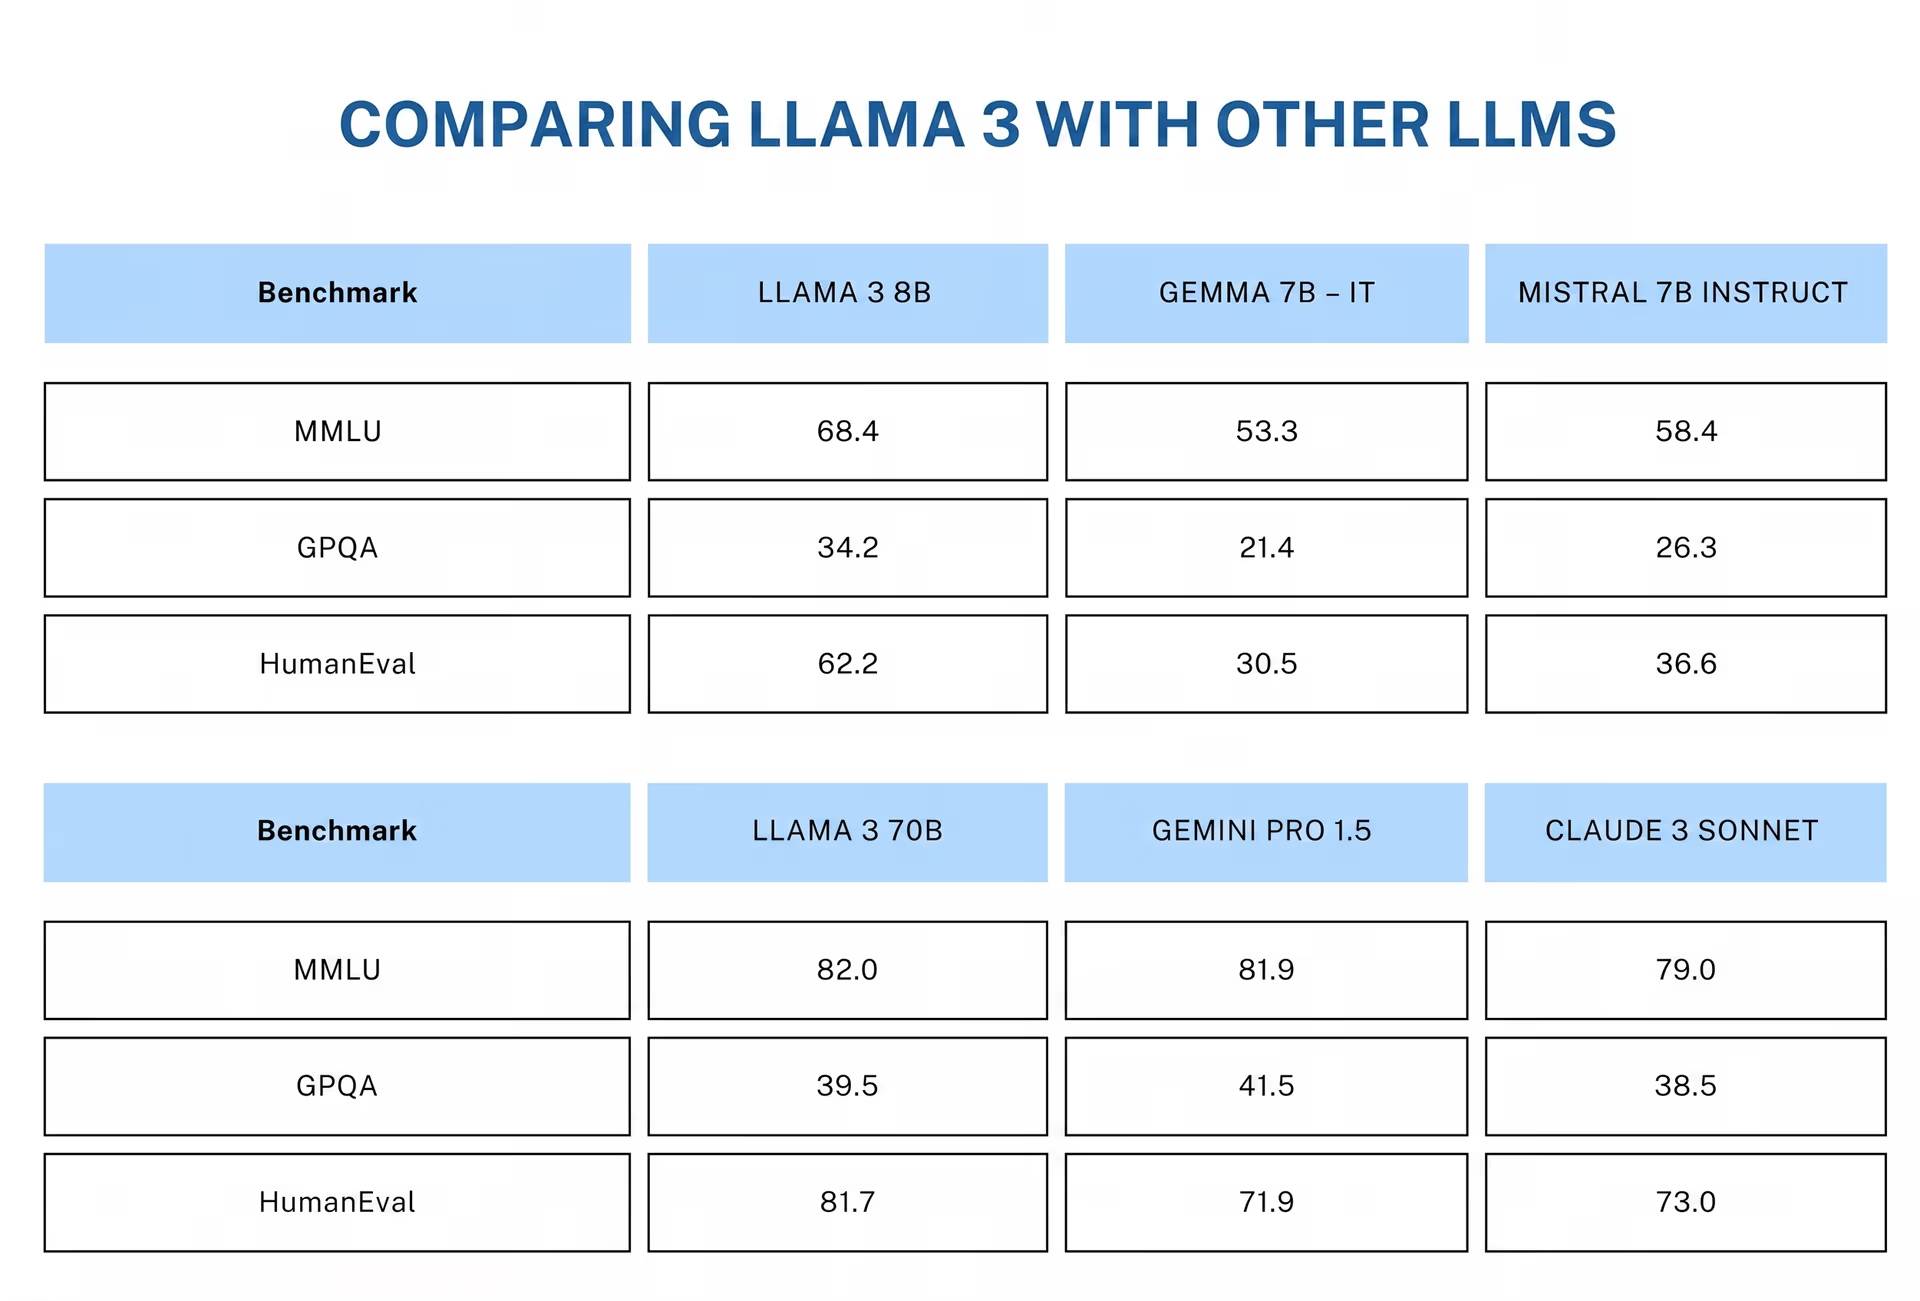
Рис. 4. Сравнение Llama 3 с другими LLM.
Meta делает Llama 3 широко доступной#
Meta расширяет доступность Llama 3, предлагая её на различных платформах для обычных пользователей и разработчиков. Для повседневного использования Llama 3 интегрирована в популярные платформы Meta, такие как WhatsApp, Instagram, Facebook и Messenger. Пользователи могут прямо в этих приложениях пользоваться расширенными функциями, например поиском в реальном времени и генерацией творческого контента.
Llama 3 также внедряют в носимые устройства, например умные очки Ray-Ban Meta и VR-гарнитуру Meta Quest, чтобы обеспечить интерактивное взаимодействие.
Разработчики могут использовать Llama 3 на различных платформах, включая AWS, Databricks, Google Cloud, Hugging Face, Kaggle, IBM WatsonX, Microsoft Azure, NVIDIA NIM и Snowflake. Также к этим моделям можно получить прямой доступ через Meta. Широкий выбор вариантов позволяет разработчикам легко интегрировать передовые возможности этих моделей ИИ в свои проекты — напрямую через Meta или с помощью других популярных платформ.
Главное#
Развитие машинного обучения продолжает менять то, как мы ежедневно взаимодействуем с технологиями. Llama 3 от Meta показывает, что большие языковые модели (LLM) уже не ограничиваются генерацией текста: они решают сложные задачи и поддерживают множество языков. В целом Llama 3 делает ИИ адаптивнее и доступнее, чем когда-либо. В будущих обновлениях Llama 3 появятся новые возможности, например мультимодальность и более длинные контекстные окна.
Загляни в наш репозиторий GitHub и присоединяйся к нашему сообществу, чтобы узнать больше об ИИ. Посети страницы с нашими решениями и посмотри, как ИИ применяется в таких сферах, как производство и сельское хозяйство.
Автор
Создатель контента · Ultralytics
Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.









