Découvrir Llama 3 de Meta
Découvre Llama 3 de Meta, le LLM à poids ouverts lancé en avril 2024 : ses variantes 8B et 70B, son architecture, son entraînement à grande échelle et ses résultats aux benchmarks.
 Abirami Vina9 min de lecture
Quand nous avons fait le point sur les innovations de l’intelligence artificielle (AI) du premier trimestre 2024, nous avons constaté que des LLM, ou grands modèles de langage, étaient lancés à tout-va par différentes organisations. Dans la continuité de cette tendance, le 18 avril 2024, Meta a publié Llama 3, un LLM open source de pointe de nouvelle génération.
Tu te demandes peut-être : Ce n’est qu’un autre LLM. Pourquoi la communauté de l’IA est-elle si enthousiaste ?
Tu peux affiner des modèles comme GPT-3 ou Gemini pour obtenir des réponses personnalisées, mais ils n’offrent pas une transparence totale sur leur fonctionnement interne, notamment sur leurs données d’entraînement, leurs paramètres ou leurs algorithmes. En revanche, Llama 3 de Meta est plus transparent : son architecture et ses poids sont disponibles au téléchargement. Pour la communauté de l’IA, cela signifie une plus grande liberté d’expérimentation.
Dans cet article, nous verrons ce que Llama 3 peut faire, comment il a vu le jour et quelle est son incidence sur le domaine de l’IA.
L’évolution des modèles Llama de Meta#
Avant d’examiner Llama 3, revenons sur ses versions précédentes.
Meta a lancé Llama 1 en février 2023. Le modèle se déclinait en quatre variantes comptant de 7 à 65 milliards de paramètres. En apprentissage automatique, les « paramètres » désignent les éléments du modèle appris à partir des données d’entraînement. Comme il comptait moins de paramètres, Llama 1 avait parfois du mal à saisir les nuances et produisait des réponses incohérentes.
Peu après Llama 1, Meta a lancé Llama 2 en juillet 2023. Ce modèle a été entraîné sur 2 000 milliards de jetons. Un jeton représente un fragment de texte, comme un mot ou une partie de mot, utilisé comme unité de base des données traitées par le modèle. Le modèle comportait également des améliorations, comme une fenêtre de contexte doublée à 4 096 jetons pour comprendre des passages plus longs, ainsi que plus d’un million d’annotations humaines pour réduire les erreurs. Malgré ces améliorations, Llama 2 nécessitait toujours beaucoup de puissance de calcul, un problème que Meta cherchait à résoudre avec Llama 3.
Présentation de Llama 3 de Meta#
Llama 3 se décline en quatre variantes entraînées sur un impressionnant total de 15 000 milliards de tokens. Plus de 5 % des données d’entraînement étaient des données non anglaises de haute qualité couvrant plus de 30 langues. Toutes les variantes de Llama 3 peuvent fonctionner sur différents types de matériel grand public et ont une fenêtre de contexte de 8 000 tokens.
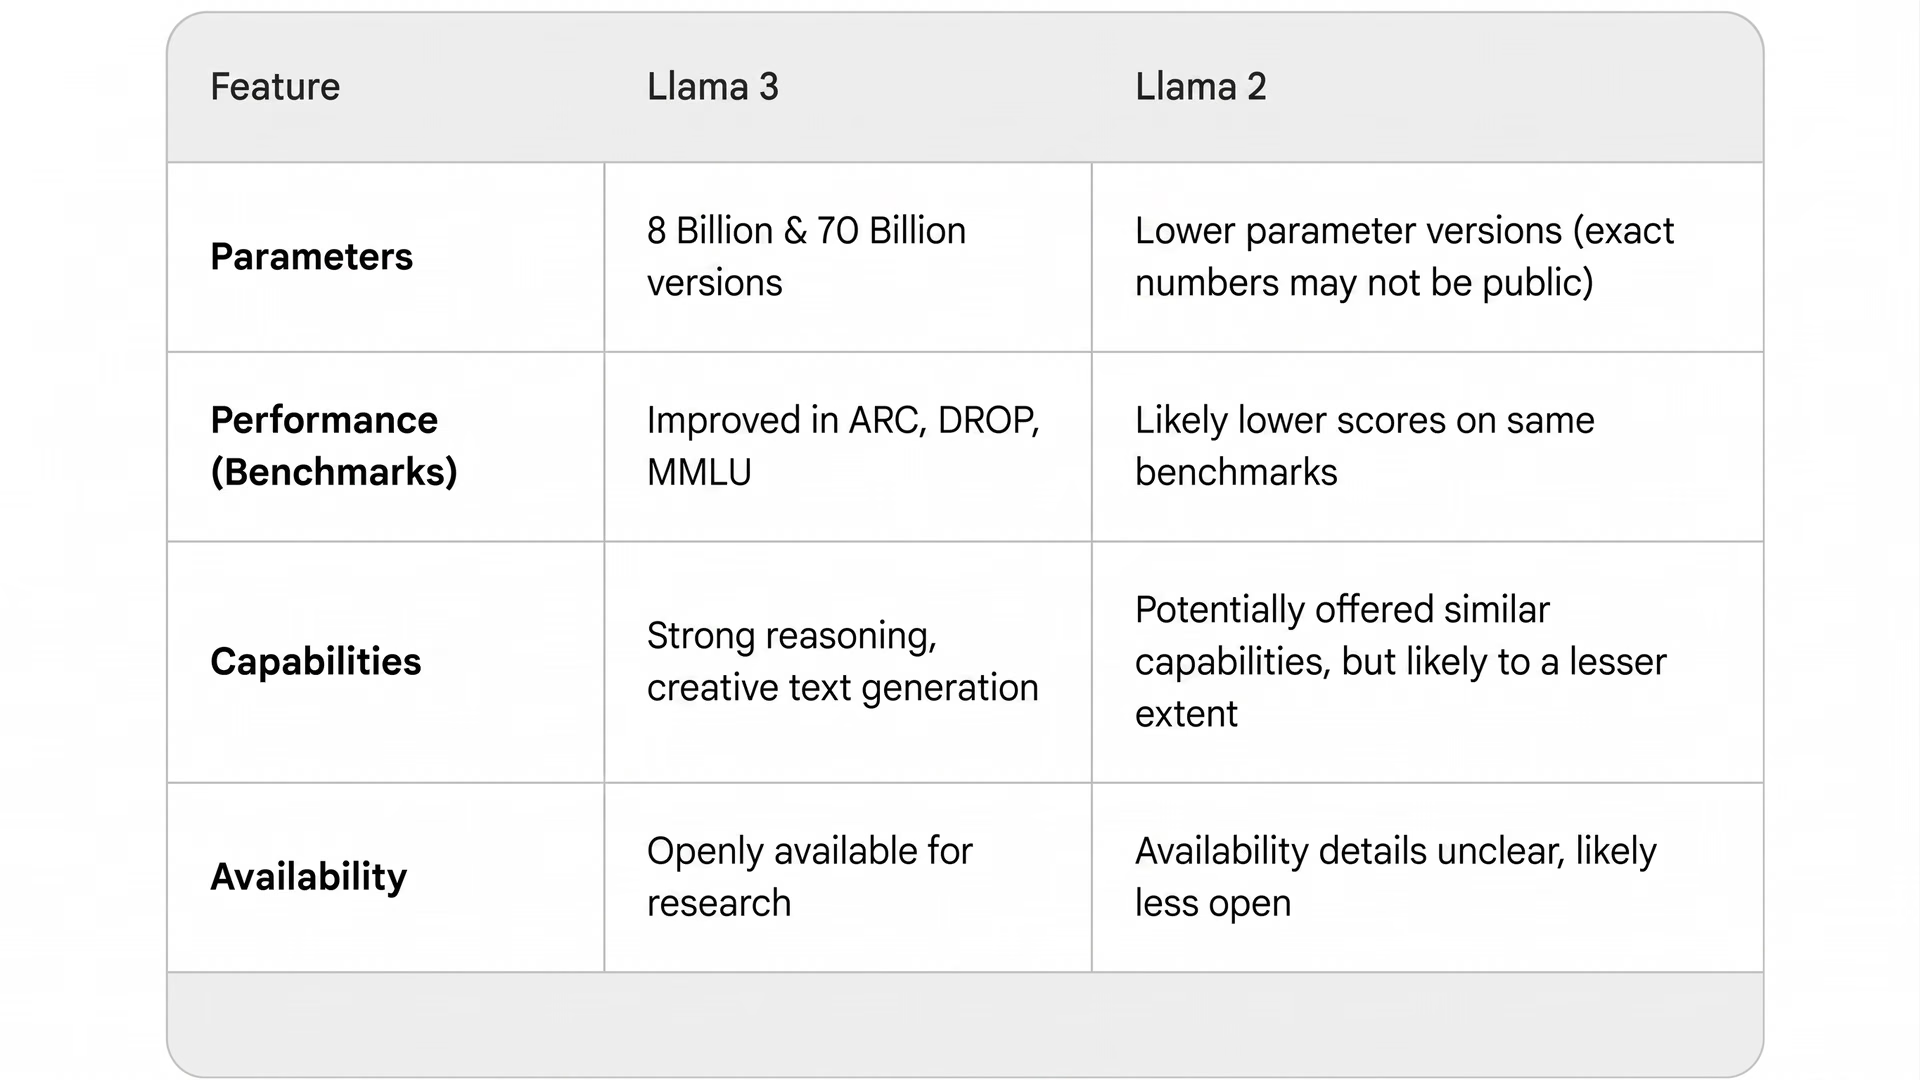
Fig. 1. Llama 3 comparé à Llama 2.
Les variantes du modèle sont proposées en deux tailles : 8B et 70B, soit respectivement 8 milliards et 70 milliards de paramètres. Il existe également deux versions : base et instruct. « Base » désigne la version pré-entraînée standard. « Instruct » désigne une version affinée pour suivre des consignes et optimisée pour les cas d’usage conversationnels.
Voici les variantes du modèle Llama 3 :
- Meta-Llama-3-8b : le modèle de base 8B offre des capacités d’IA fondamentales et convient parfaitement aux tâches générales, comme la création de chatbots pour le service client.
- Meta-Llama-3-8b-instruct : une version instruct affinée du modèle 8B, optimisée pour des tâches spécifiques. Elle peut, par exemple, servir à créer des outils pédagogiques qui expliquent des sujets complexes.
- Meta-Llama-3-70b : le modèle de base 70B est conçu pour les applications d’IA hautes performances. Il conviendrait aux applications qui traitent de vastes corpus de littérature biomédicale pour la découverte de médicaments.
- Meta-Llama-3-70b-instruct : cette version est issue du réglage fin du modèle 70B pour des applications exigeant une grande précision, comme l’analyse de documents juridiques ou médicaux, où l’exactitude est essentielle.
L’architecture du modèle Llama 3 de Meta#
Comme pour toute autre avancée de Meta en matière d’IA, des mesures rigoureuses de contrôle qualité ont été mises en place pendant le développement de Llama 3 afin de préserver l’intégrité des données et de réduire les biais. Le résultat est donc un modèle puissant créé de manière responsable.
L’architecture du modèle Llama 3 se distingue par l’importance qu’elle accorde à l’efficacité et aux performances dans les tâches de traitement automatique du langage naturel. Fondée sur une architecture Transformer, elle privilégie l’efficacité des calculs, notamment pendant la génération de texte, grâce à une architecture avec décodeur uniquement.
Le modèle génère des résultats uniquement à partir du contexte précédent, sans encodeur distinct, ce qui rend la génération de texte efficace.
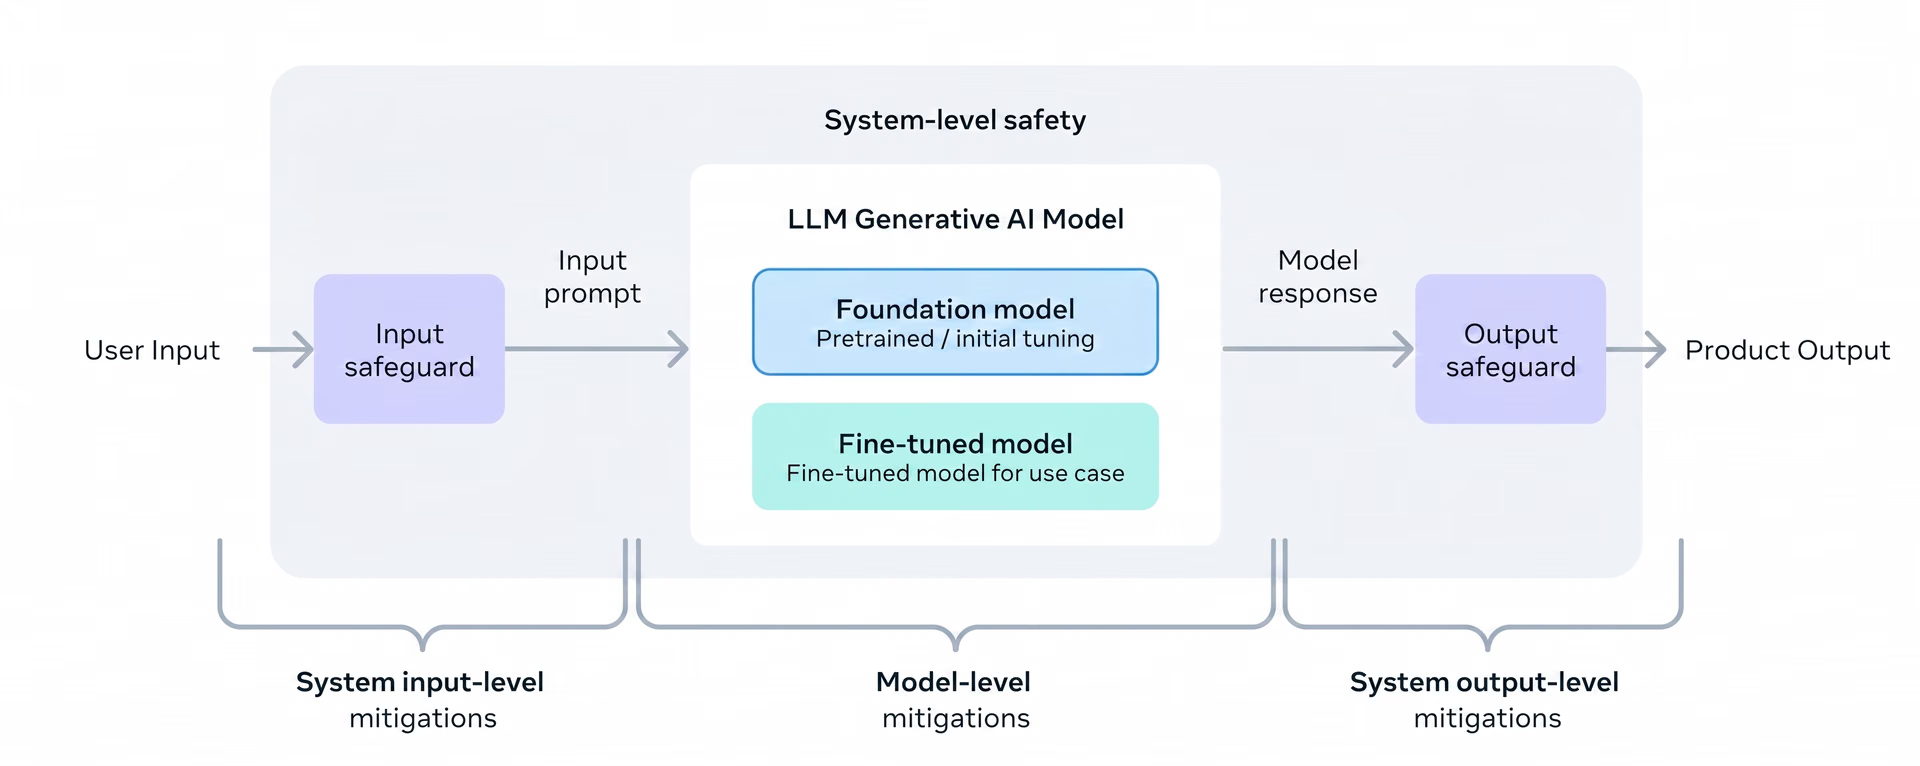
Fig. 2. Architecture responsable de Llama 3.
Les modèles Llama 3 sont dotés d’un tokenizer avec un vocabulaire de 128K tokens. Un vocabulaire plus étendu leur permet de mieux comprendre et traiter le texte. De plus, les modèles utilisent désormais l’attention à requêtes groupées (GQA) pour améliorer l’efficacité de l’inférence. GQA permet à des groupes de têtes d’attention de partager les mêmes clés et valeurs, ce qui réduit l’utilisation de la mémoire et accélère la génération de texte avec une faible perte de qualité.
Voici quelques autres détails intéressants sur l’architecture du modèle Llama 3 :
- Traitement des documents tenant compte des limites : Llama 3 préserve la clarté d’un document à l’autre, ce qui est essentiel pour des tâches comme la synthèse.
- Meilleure compréhension du code : les données d’entraînement de Llama 3 contiennent quatre fois plus d’exemples de code, ce qui améliore ses capacités de programmation.
- Contrôle qualité rigoureux : des mesures strictes, notamment des filtres heuristiques et la suppression des contenus NSFW, préservent l’intégrité des données et réduisent les biais.
Llama 3 transforme notre approche de l’entraînement des modèles#
Pour entraîner les plus grands modèles Llama 3, trois types de parallélisation ont été combinés : la parallélisation des données, celle du modèle et celle des pipelines.
La parallélisation des données répartit les données d’entraînement sur plusieurs GPU, tandis que la parallélisation du modèle partitionne l’architecture du modèle afin d’exploiter la puissance de calcul de chaque GPU. La parallélisation des pipelines divise le processus d’entraînement en étapes séquentielles, ce qui optimise les calculs et les communications.
L’implémentation la plus efficace a atteint une forte utilisation des ressources de calcul, dépassant les 400 TFLOPS par GPU lors d’un entraînement simultané sur 16 000 GPU. Ces entraînements ont été effectués sur deux clusters de GPU conçus sur mesure, composés chacun de 24 000 GPU. Cette importante infrastructure de calcul a fourni la puissance nécessaire pour entraîner efficacement les modèles Llama 3 à grande échelle.
Pour maximiser le temps de fonctionnement des GPU, une nouvelle pile d’entraînement avancée a été développée afin d’automatiser la détection et la gestion des erreurs ainsi que la maintenance. La fiabilité du matériel et les mécanismes de détection ont été considérablement améliorés pour atténuer les risques de corruption silencieuse des données. De nouveaux systèmes de stockage évolutifs ont également été développés pour réduire les coûts liés aux points de contrôle et aux retours en arrière.
Ces améliorations ont permis d’atteindre une durée d’entraînement effective supérieure à 95 %. Ensemble, elles ont multiplié par environ trois l’efficacité de l’entraînement de Llama 3 par rapport à Llama 2. Cette efficacité ouvre de nouvelles perspectives pour les méthodes d’entraînement de l’IA.
Ouvrir de nouvelles perspectives avec Llama 3#
Comme Llama 3 est open source, les chercheurs et les étudiants peuvent étudier son code, mener des expériences et discuter des questions éthiques et des biais. Cependant, Llama 3 ne s’adresse pas uniquement au milieu universitaire. Il est aussi utilisé dans des applications pratiques. Il devient le socle de l’interface de chat Meta AI, intégrée à des plateformes comme Facebook, Instagram, WhatsApp et Messenger. Avec Meta AI, les utilisateurs peuvent converser en langage naturel, accéder à des recommandations personnalisées, effectuer des tâches et communiquer facilement avec d’autres personnes.
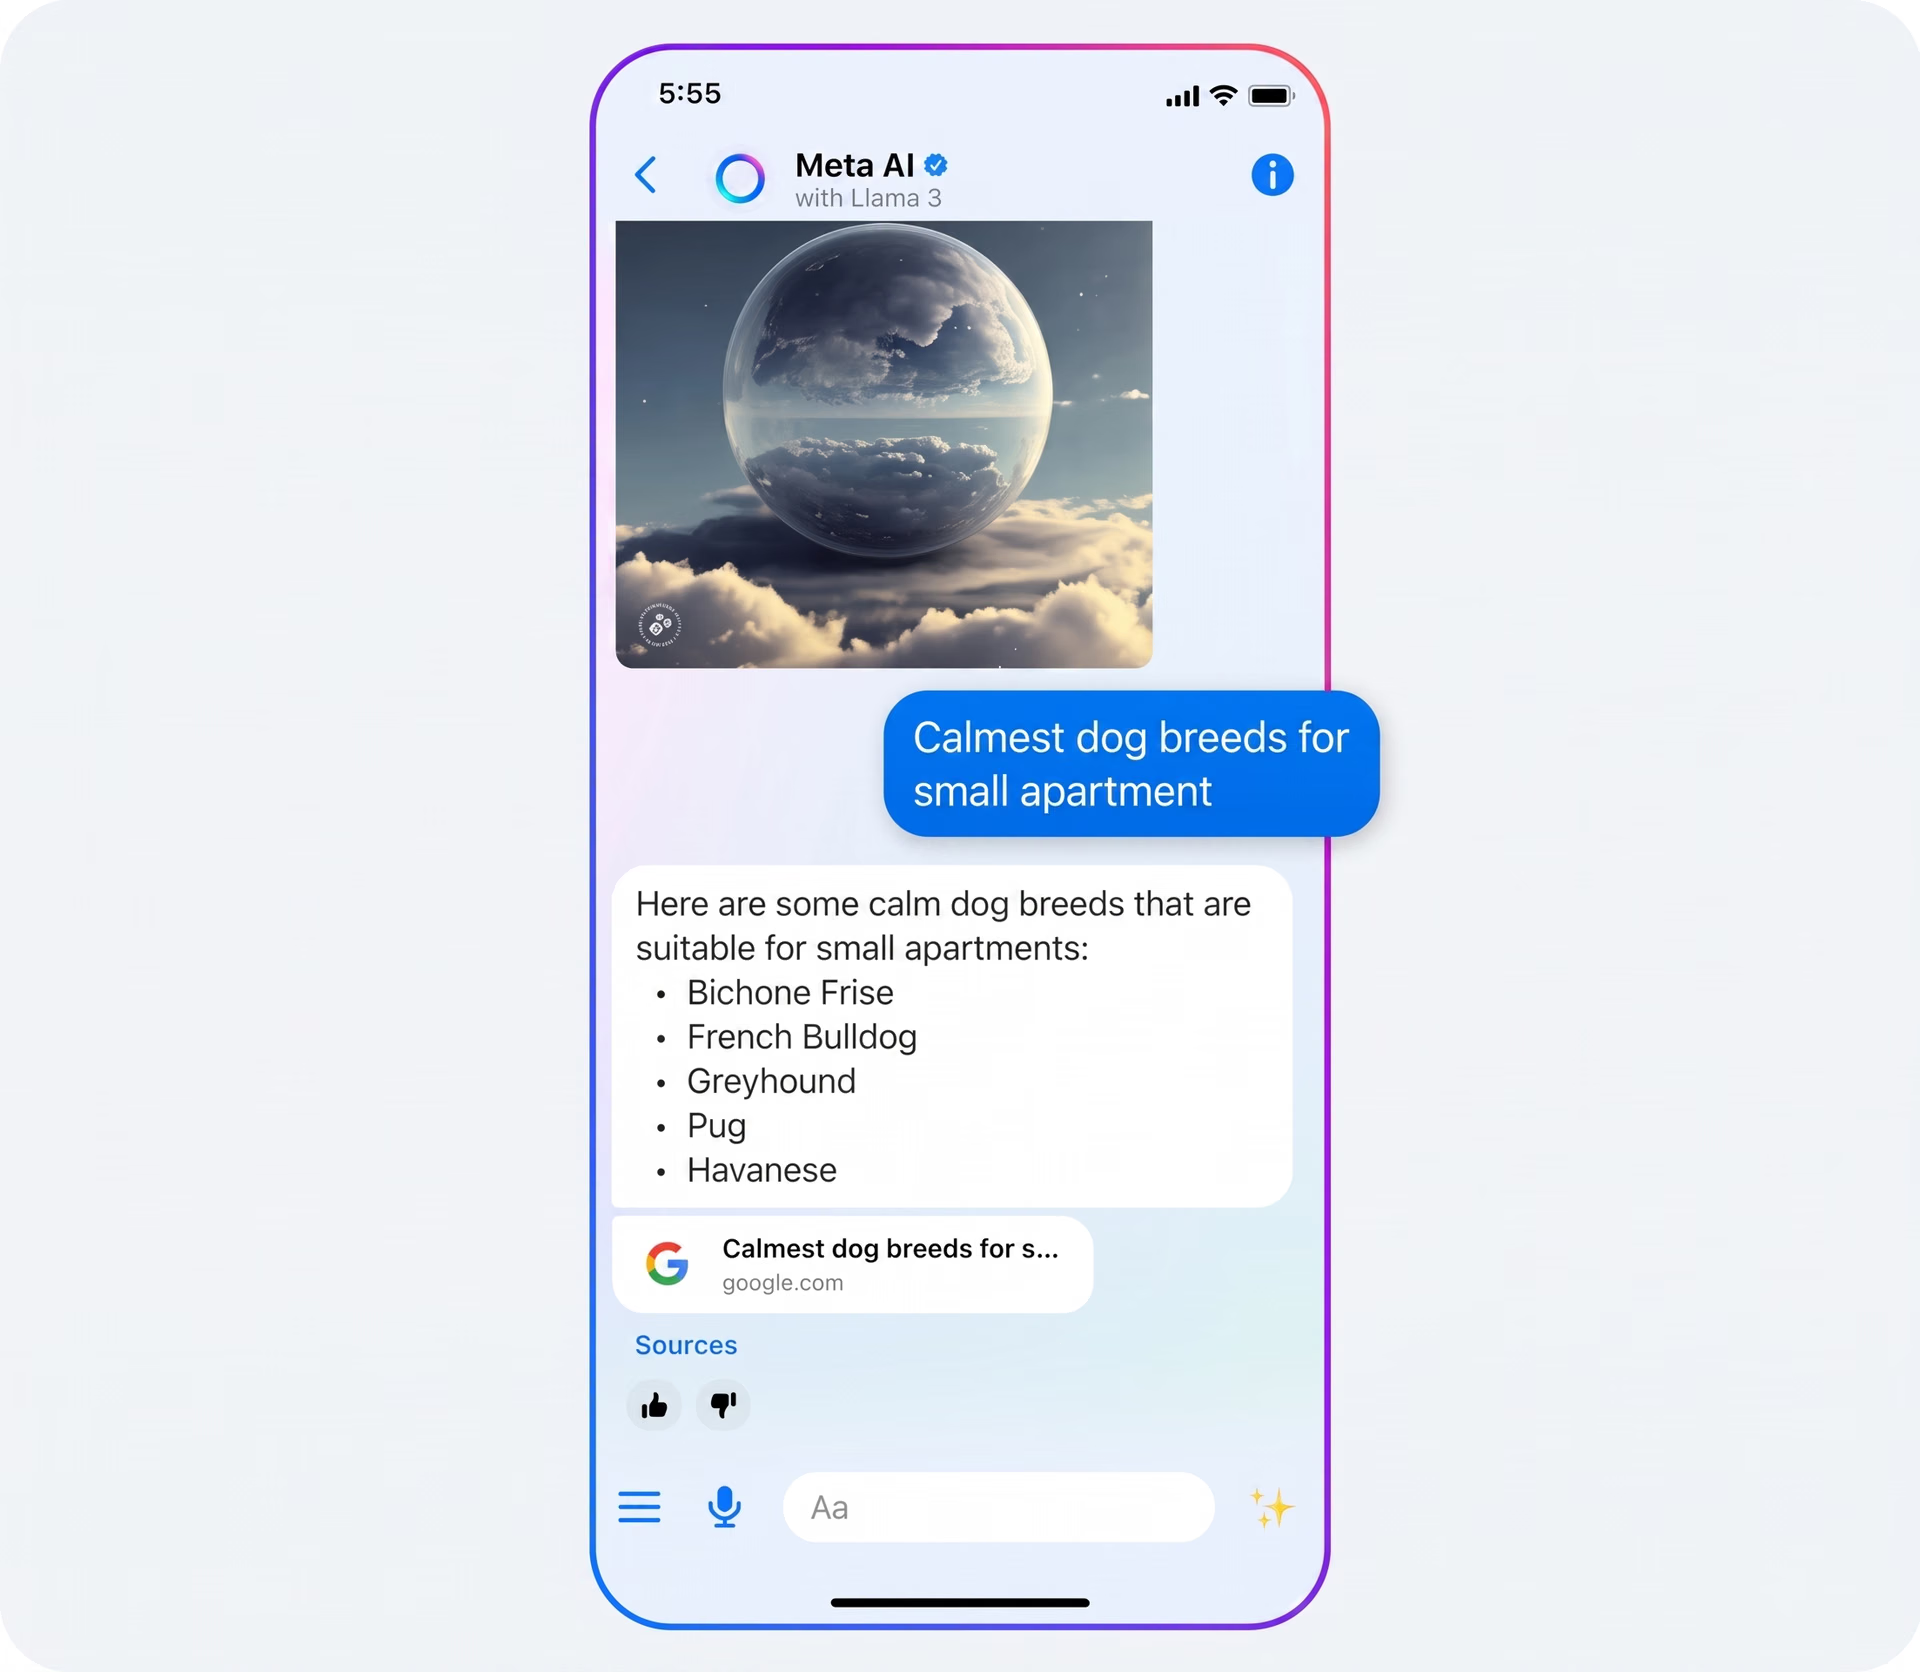
Fig. 3. Meta AI : propulsé par Llama 3.
Comparaison de Llama 3 avec d’autres LLM#
Llama 3 obtient de bons résultats sur plusieurs benchmarks clés qui évaluent la compréhension du langage complexe et les capacités de raisonnement. Voici quelques benchmarks qui testent différents aspects des capacités de Llama 3 :
- Compréhension multitâche de la langue (MMLU) - Mesure ses connaissances dans différents domaines.
- Questions-réponses de niveau universitaire difficiles à résoudre par Google ( GPQA) - Évalue la capacité du modèle à répondre à des questions complexes de niveau universitaire en biologie, en physique et en chimie.
- HumanEval - Évalue les tâches de programmation et de résolution de problèmes en testant la capacité du modèle à générer du code fonctionnel et à résoudre des défis algorithmiques.
Les excellents résultats de Llama 3 à ces tests le distinguent clairement de concurrents comme Gemma 7B de Google, Mistral 7B de Mistral et Claude 3 Sonnet d’Anthropic. Selon les statistiques publiées, Llama 3, en particulier le modèle 70B, surpasse ces modèles dans tous les benchmarks mentionnés ci-dessus.
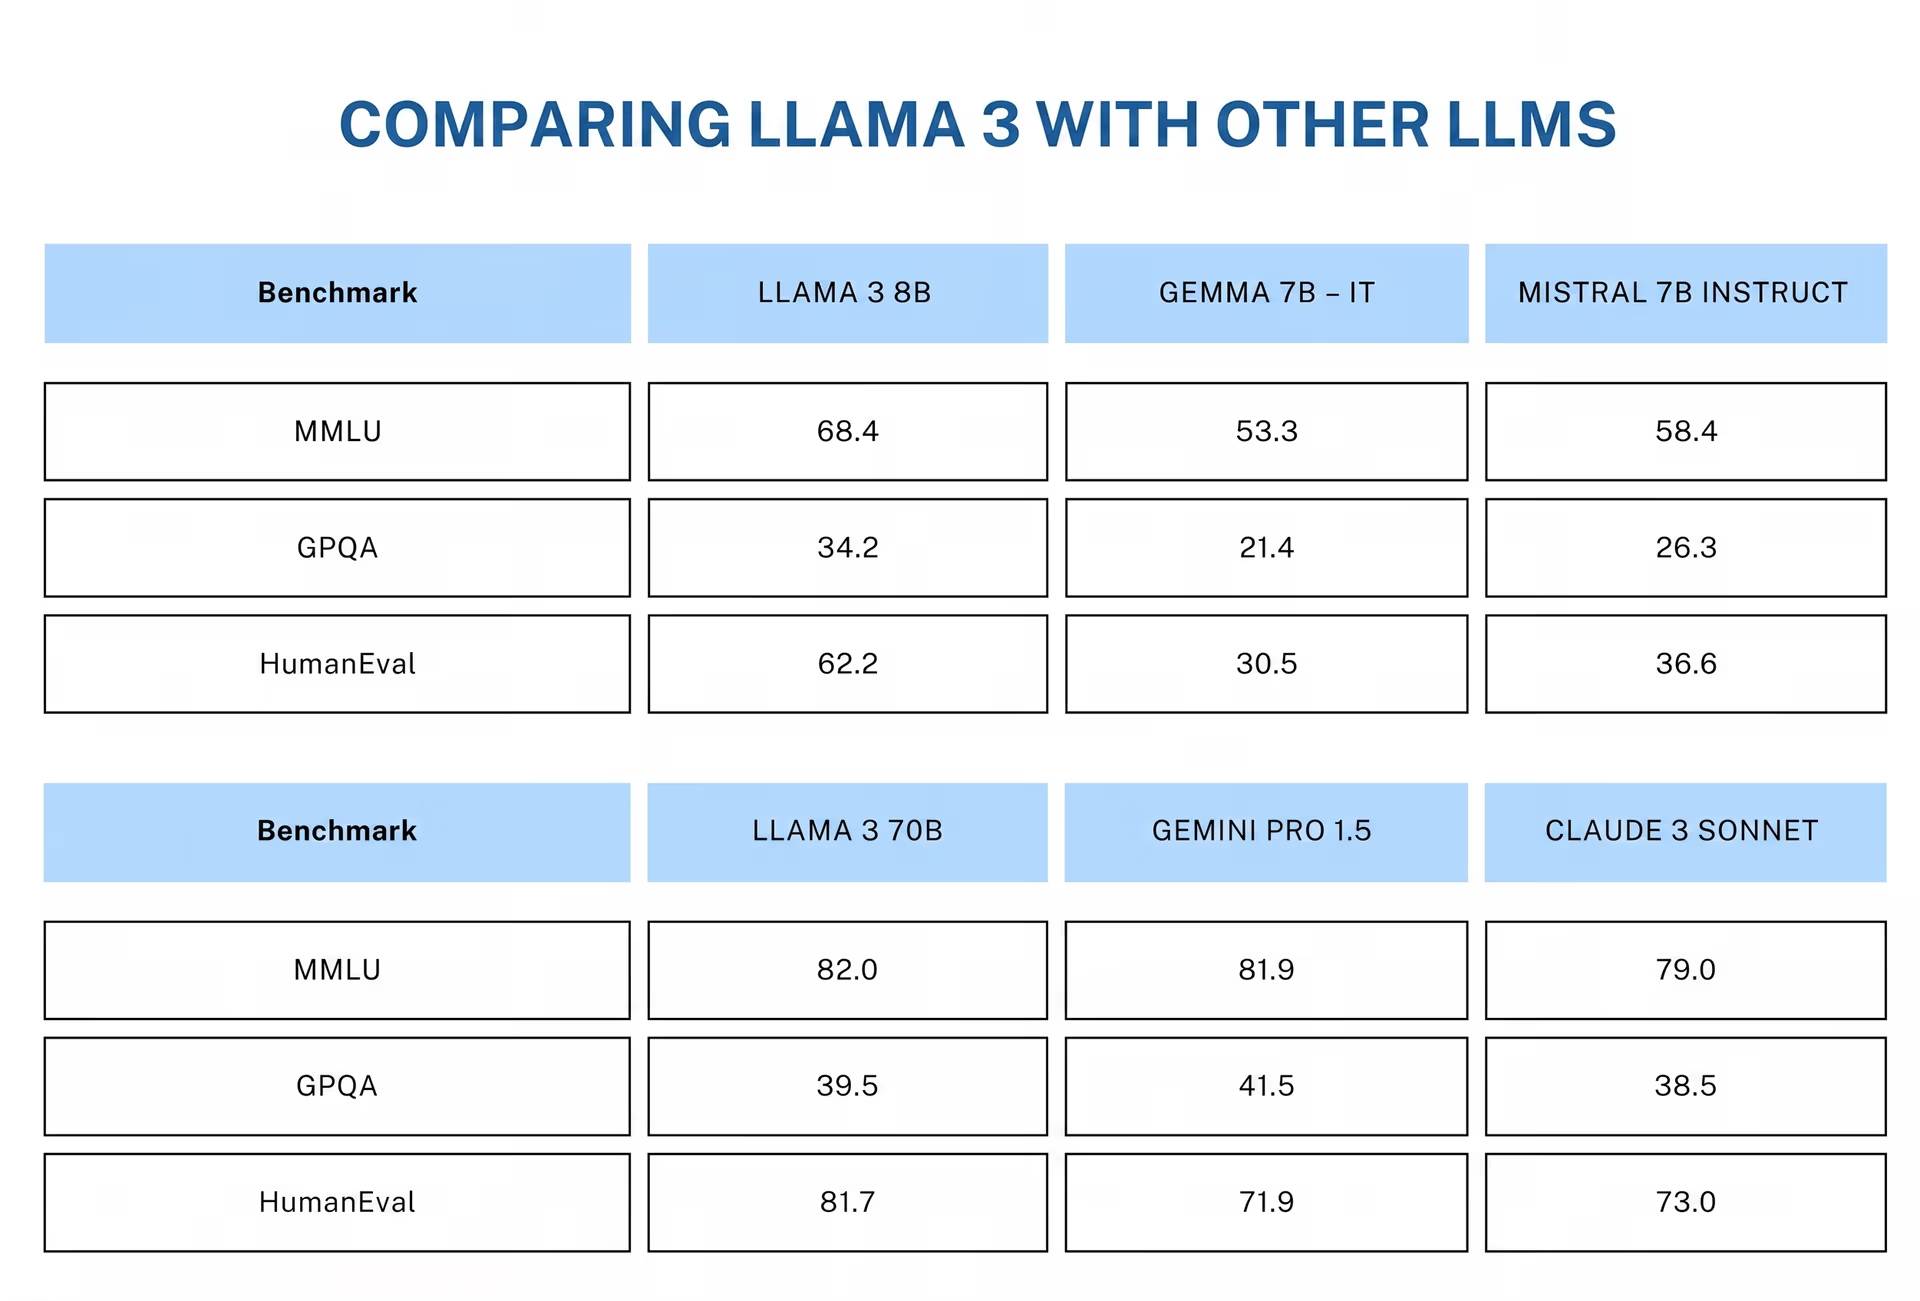
Fig. 4. Comparaison de Llama 3 avec d’autres grands modèles de langage.
Meta rend Llama 3 largement accessible#
Meta étend la portée de Llama 3 en le proposant sur différentes plateformes, tant aux utilisateurs qu’aux développeurs. Pour les utilisateurs au quotidien, Llama 3 est intégré aux plateformes populaires de Meta, telles que WhatsApp, Instagram, Facebook et Messenger. Les utilisateurs peuvent profiter de fonctionnalités avancées, comme la recherche en temps réel et la génération de contenu créatif, directement dans ces applications.
Llama 3 est également intégré à des technologies portables, comme les lunettes connectées Ray-Ban Meta et le casque de réalité virtuelle Meta Quest, pour offrir des expériences interactives.
Llama 3 est disponible sur différentes plateformes destinées aux développeurs, notamment AWS, Databricks, Google Cloud, Hugging Face, Kaggle, IBM WatsonX, Microsoft Azure, NVIDIA NIM et Snowflake. Tu peux aussi accéder directement à ces modèles auprès de Meta. Ce large éventail d’options permet aux développeurs d’intégrer facilement ces capacités avancées des modèles d’IA à leurs projets, qu’ils préfèrent travailler directement avec Meta ou passer par d’autres plateformes populaires.
À retenir#
Les progrès de l’apprentissage automatique continuent de transformer nos interactions quotidiennes avec la technologie. Llama 3 de Meta montre que les LLM ne servent plus uniquement à générer du texte. Les LLM s’attaquent à des problèmes complexes et prennent en charge plusieurs langues. Dans l’ensemble, Llama 3 rend l’IA plus adaptable et plus accessible que jamais. À l’avenir, les améliorations prévues pour Llama 3 promettent encore plus de capacités, comme le traitement multimodal et des fenêtres de contexte plus longues.
Consulte notre dépôt GitHub et rejoins notre communauté pour en apprendre davantage sur l’IA. Consulte nos pages consacrées aux solutions pour découvrir comment l’IA est utilisée dans des secteurs comme l’industrie manufacturière et l’agriculture.
Écrit par
Créateur de contenu · Ultralytics
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









