MetaのLlama 3を知る
2024年4月にリリースされたMetaのオープンウェイトLLM、Llama 3をご紹介します。8Bおよび70Bのバリエーション、アーキテクチャ、大規模トレーニング、ベンチマーク結果を取り上げます。
 Abirami Vina9 分で読めます
2024年第1四半期の人工知能 (AI)のイノベーションを振り返ったところ、さまざまな組織からLLM、つまり大規模言語モデルが次々とリリースされていました。この流れを受け、2024年4月18日、Metaは次世代の最先端オープンソースLLMであるLlama 3をリリースしました。
こう思うかもしれません。ただの新しいLLMでは?なぜAIコミュニティはこれほど盛り上がっているのでしょうか?
GPT-3やGeminiのようなモデルをファインチューニングして応答をカスタマイズすることはできますが、学習データ、モデルパラメーター、アルゴリズムなど、内部の仕組みについて完全な透明性はありません。それに対してMetaのLlama 3は、アーキテクチャと重みをダウンロードでき、より透明性が高くなっています。AIコミュニティにとって、これは実験の自由度が高まることを意味します。
この記事では、Llama 3でできること、誕生の経緯、AI分野への影響について解説します。
MetaのLlamaモデルの進化#
Llama 3の説明に入る前に、以前のバージョンを振り返ってみましょう。
Metaは2023年2月にLlama 1をリリースしました。Llama 1には、70億から650億までのパラメーター数を持つ4つのバリエーションがありました。機械学習において「パラメーター」とは、学習データから学習されるモデルの要素を指します。パラメーター数が少なかったため、Llama 1は微妙なニュアンスの理解に苦労し、一貫性のない応答を返すことがありました。
Llama 1のリリースから間もなく、Metaは2023年7月にLlama 2を発表しました。Llama 2は2兆トークンで学習されました。トークンとは、モデルでデータを処理する際の基本単位として使われる、単語や単語の一部などのテキストの断片です。また、より長い文章を理解できるよう、コンテキストウィンドウを4096トークンに倍増し、エラーを減らすために100万件を超える人手によるアノテーションを追加するなどの強化も行われました。こうした改善にもかかわらず、Llama 2は依然として多くの計算能力を必要としており、MetaはLlama 3でこの課題の解決を目指しました。
MetaのLlama 3の紹介#
Llama 3には4種類のバリエーションがあり、驚異的な15兆トークンを用いてトレーニングされました。そのトレーニングデータの5%超は、30以上の言語を含む高品質な非英語データでした。すべてのLlama 3バリエーションは、さまざまな種類の一般消費者向けハードウェアで実行でき、コンテキスト長は8kトークンです。
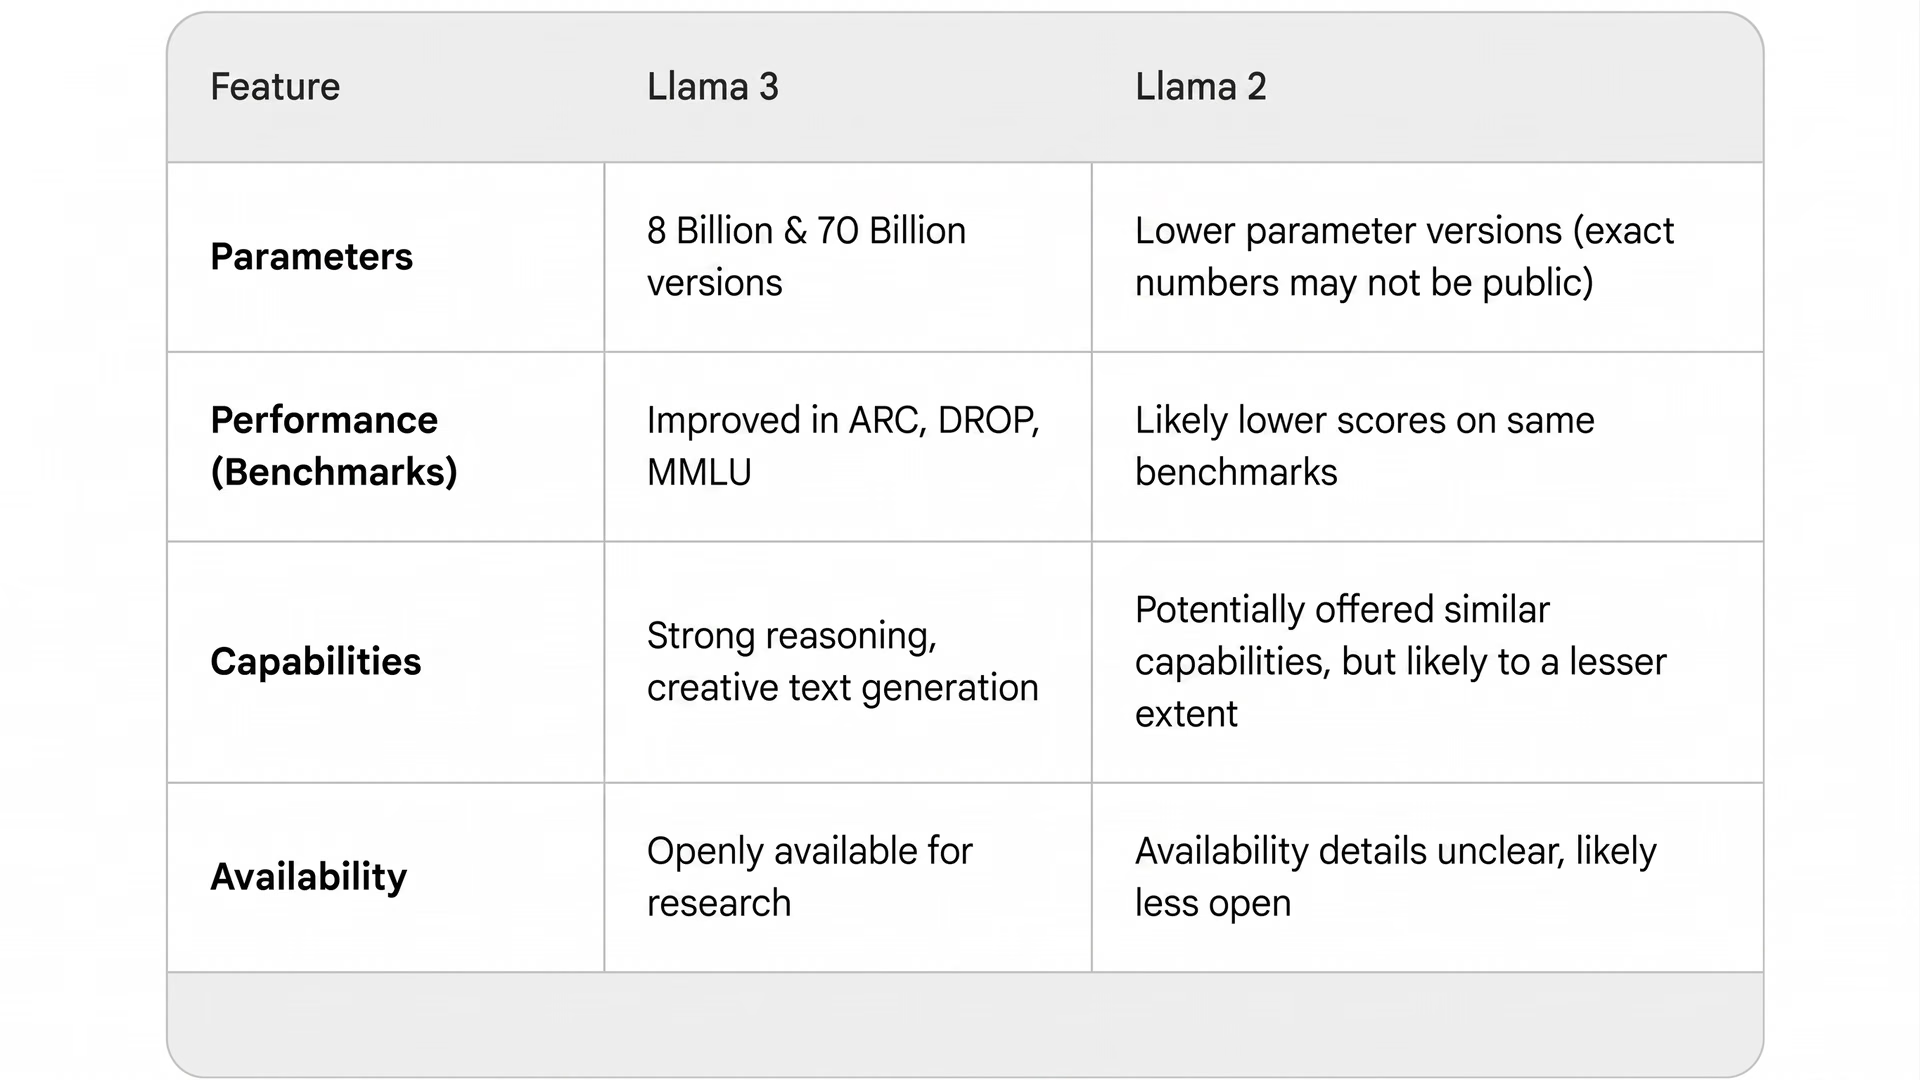
図1. Llama 3とLlama 2の比較。
モデルのバリエーションには8Bと70Bの2つのサイズがあり、それぞれ80億個と700億個のパラメーターを示します。また、baseとinstructの2種類があります。「Base」は標準的な事前トレーニング済みバージョンを指します。「Instruct」は、指示に従うようにファインチューニングされ、対話用途向けに最適化されたバージョンです。
Llama 3のモデルバリエーションは次のとおりです。
- Meta-Llama-3-8b:baseの8Bモデルは基本的なAI機能を提供し、カスタマーサービス用チャットボットの開発など、一般的なタスクに最適です。
- Meta-Llama-3-8b-instruct:8Bモデルを特定のタスク向けに最適化した、instruct形式のファインチューニング済みバージョンです。たとえば、複雑なテーマを説明する教育ツールの作成に利用できます。
- Meta-Llama-3-70b:baseの70Bモデルは、高性能なAIアプリケーション向けに設計されています。創薬に向けた膨大な生物医学文献の処理などに適しています。
- Meta-Llama-3-70b-instruct:このバージョンは70Bモデルをファインチューニングしたもので、精度が重要となる法律文書や医療文書の分析など、高い精度が求められる用途に適しています。
MetaのLlama 3モデルアーキテクチャ#
Metaの他のAI開発と同様に、Llama 3の開発ではデータの完全性を維持し、バイアスを最小限に抑えるため、厳格な品質管理対策が講じられました。その結果、責任ある方法で開発された高性能モデルが完成しました。
Llama 3のモデルアーキテクチャは、自然言語処理タスクにおける効率性と性能を重視している点が特徴です。Transformerベースのフレームワークを基盤とし、特にテキスト生成時の計算効率を高めるため、デコーダーのみのアーキテクチャを採用しています。
このモデルは、独立したエンコーダーを使わず、直前までのコンテキストだけに基づいて出力を生成するため、テキスト生成を効率的に行えます。
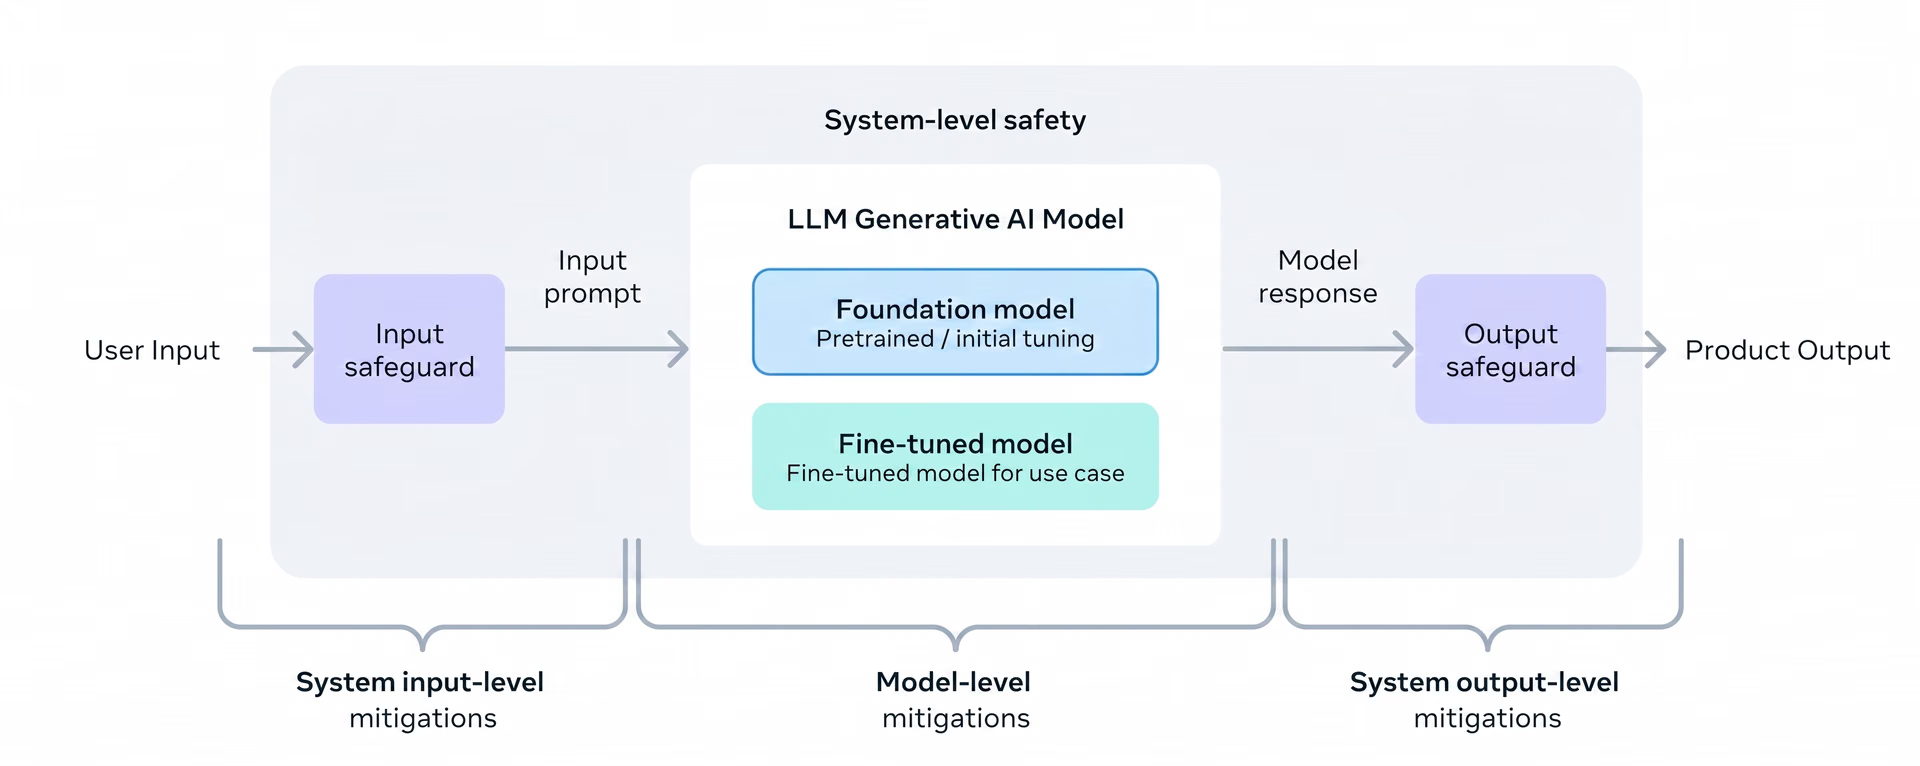
図2. Llama 3のモデルアーキテクチャ。
Llama 3モデルは、128Kトークンの語彙を持つトークナイザーを搭載しています。語彙が豊富になることで、モデルはテキストをより適切に理解し、処理できるようになります。また、推論効率を高めるため、モデルにはグループ化クエリアテンション(GQA)が採用されています。GQAでは、複数のアテンションヘッドのグループが同じキーと値を共有するため、メモリ使用量を削減し、品質をほとんど損なわずにテキスト生成を高速化できます。
Llama 3のモデルアーキテクチャに関する興味深い詳細を、さらにいくつか紹介します。
- 文書境界を考慮した処理:Llama 3は文書の境界をまたいでも明瞭さを保ちます。これは要約などのタスクで重要です。
- コード理解の向上:Llama 3の学習データには、コードサンプルが4倍多く含まれており、コーディング能力が向上しています。
- 堅牢な品質管理:ヒューリスティックフィルターやNSFWコンテンツの除去を含む厳格な対策により、データの完全性を確保し、バイアスを最小限に抑えています。
Llama 3がモデル学習への取り組み方を変革#
最大規模のLlama 3モデルを学習するため、データ並列化、モデル並列化、パイプライン並列化の3種類の並列化を組み合わせました。
データ並列化では複数のGPUに学習データを分割し、モデル並列化では各GPUの計算能力を活用できるようにモデルアーキテクチャを分割します。パイプライン並列化では学習プロセスを順次実行する段階に分け、計算と通信を最適化します。
最も効率的な実装では、高い計算リソース使用率を達成し、16,000基のGPUで同時にトレーニングした際、GPUあたり400 TFLOPSを超えました。これらのトレーニングは、それぞれ24,000基のGPUを備えた2つのカスタムGPUクラスターで実施されました。この大規模な計算インフラにより、大規模なLlama 3モデルを効率的にトレーニングするために必要な処理能力が確保されました。
GPUの稼働時間を最大化するため、エラーの検出、対応、メンテナンスを自動化する高度な新しい学習スタックが開発されました。サイレントデータ破損のリスクを軽減するため、ハードウェアの信頼性と検出機構も大幅に改善されました。また、チェックポイントの保存やロールバックにかかるオーバーヘッドを減らすため、スケーラブルな新しいストレージシステムが開発されました。
これらの改善により、実効トレーニング時間は95%を超えました。これらを組み合わせることで、Llama 3のトレーニング効率はLlama 2と比較して約3倍に向上しました。この効率化により、AIのトレーニング手法に新たな可能性が広がります。
Llama 3が切り開く新たな可能性#
Llama 3はオープンソースであるため、研究者や学生はコードを調査し、実験を行い、倫理的な懸念やバイアスについて議論できます。ただし、Llama 3は学術関係者だけを対象としているわけではありません。実用的なアプリケーションでも利用されています。Facebook、Instagram、WhatsApp、Messengerなどのプラットフォームに統合されたMeta AIチャットインターフェースの基盤になりつつあります。Meta AIを使うと、ユーザーは自然言語で会話し、パーソナライズされたおすすめを受け取り、タスクを実行し、ほかの人と簡単につながることができます。
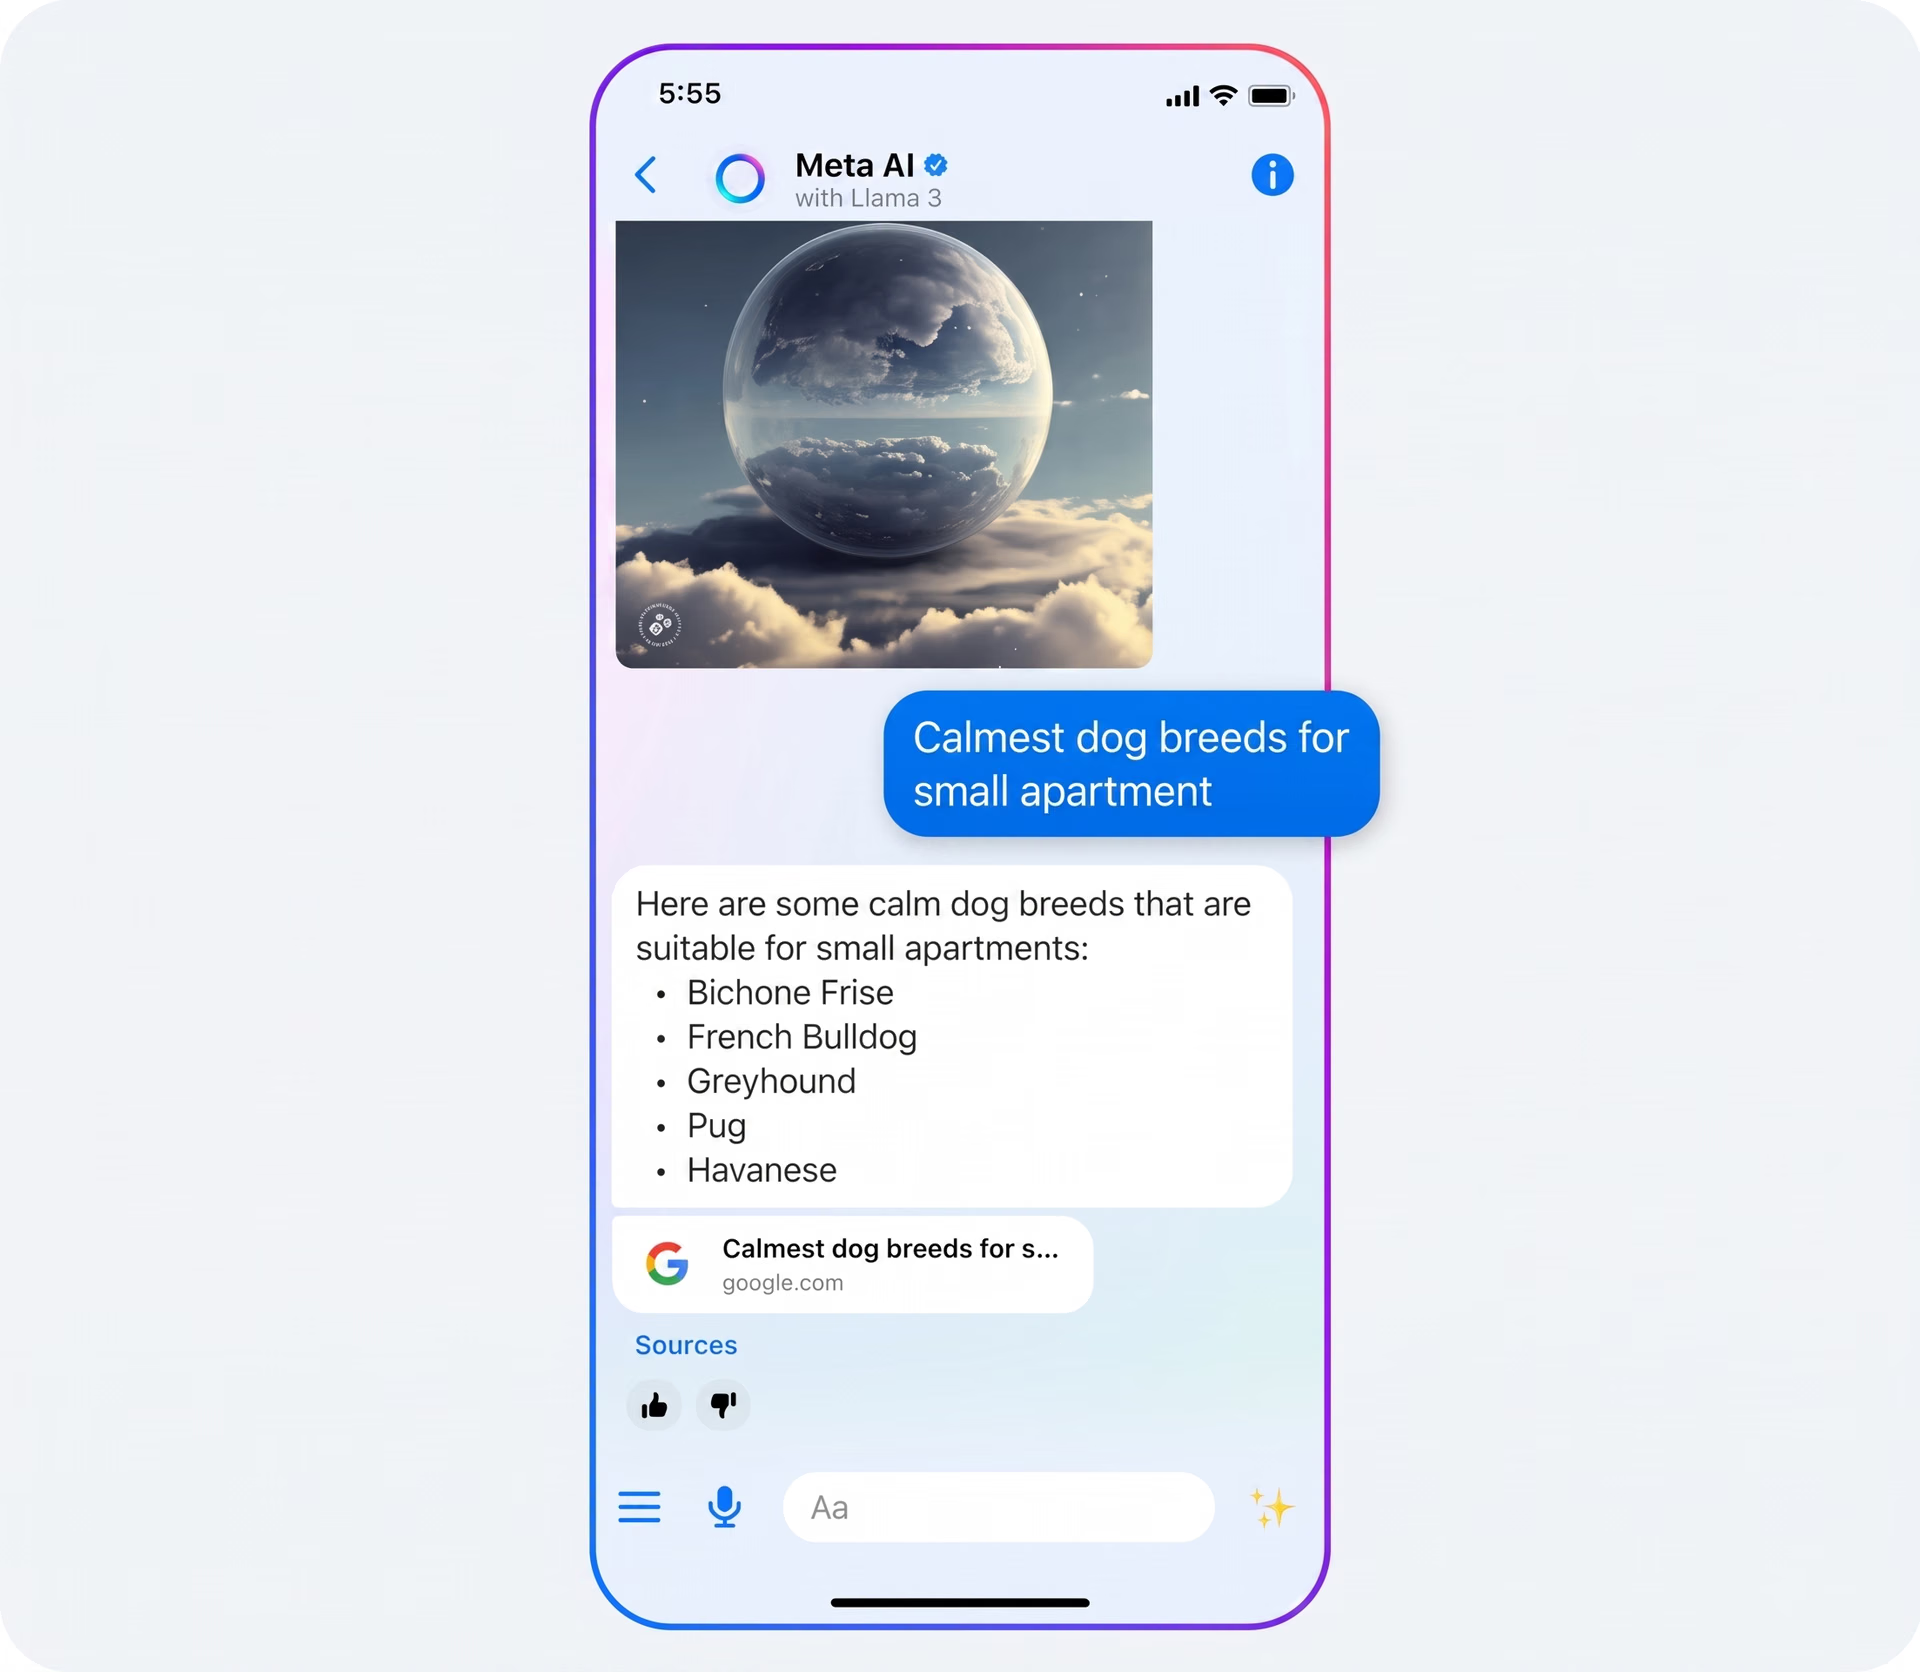
図3. Meta AI:Llama 3を活用。
Llama 3と他のLLMの比較#
Llama 3は、複雑な言語理解や推論能力を評価する複数の主要ベンチマークで優れた性能を示しています。Llama 3のさまざまな能力を検証するベンチマークを以下に紹介します。
- 大規模マルチタスク言語理解 (MMLU) - さまざまな分野にわたる知識を測定します。
- 大学院レベルのGoogle検索では答えにくい質疑応答(GPQA)- 生物学、物理学、化学分野の難易度の高い大学院レベルの質問に回答するモデルの能力を評価します。
- HumanEval - コーディングと問題解決のタスクに焦点を当て、実用的なプログラムコードを生成し、アルゴリズム上の課題を解決するモデルの能力をテストします。
これらのテストにおけるLlama 3の優れた結果は、GoogleのGemma 7B、MistralのMistral 7B、AnthropicのClaude 3 Sonnetなどの競合モデルとの違いを明確に示しています。公開された統計によると、特に70Bモデルは、上記のすべてのベンチマークでこれらのモデルを上回っています。
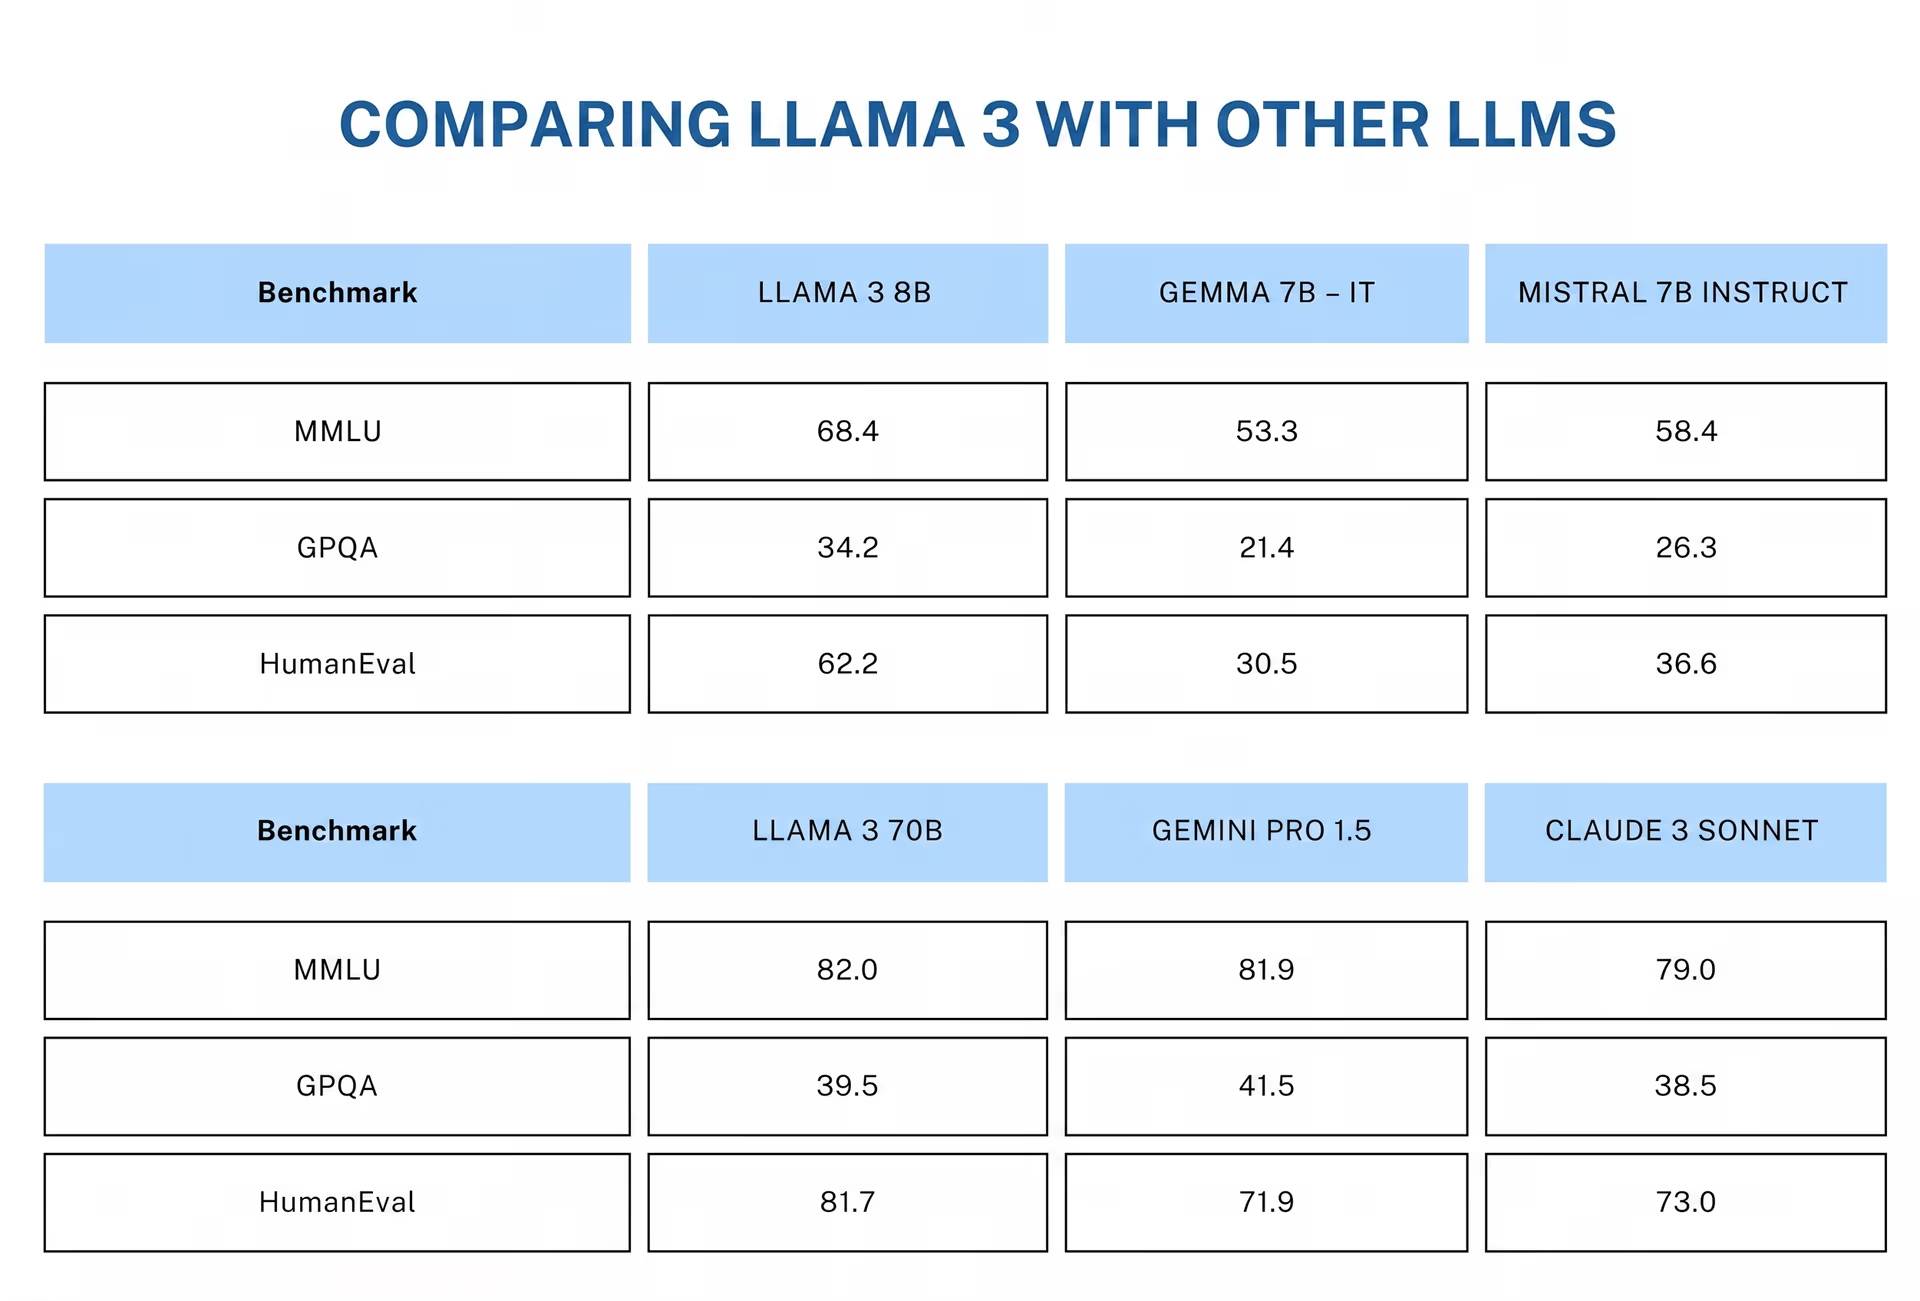
図4. Llama 3とほかのLLMの比較。
Meta Llama 3を幅広く利用可能に#
Metaは、一般ユーザーと開発者の両方が利用できるよう、さまざまなプラットフォームでLlama 3を提供し、その利用範囲を拡大しています。一般ユーザー向けには、WhatsApp、Instagram、Facebook、MessengerなどのMetaの人気プラットフォームにLlama 3が統合されています。ユーザーは、リアルタイム検索やクリエイティブなコンテンツの生成などの高度な機能を、これらのアプリ内で直接利用できます。
Llama 3は、インタラクティブな体験を提供するため、Ray-Ban MetaスマートグラスやMeta Quest VRヘッドセットなどのウェアラブル技術にも導入されています。
Llama 3は、AWS、Databricks、Google Cloud、Hugging Face、Kaggle、IBM WatsonX、Microsoft Azure、NVIDIA NIM、Snowflakeなど、開発者向けのさまざまなプラットフォームで利用できます。Metaからこれらのモデルに直接アクセスすることもできます。幅広い選択肢があるため、Metaを直接利用する場合でも、他の人気プラットフォームを利用する場合でも、開発者は高度なAIモデルの機能をプロジェクトに簡単に統合できます。
要点#
機械学習の進歩は、日々テクノロジーとの関わり方を変え続けています。MetaのLlama 3は、LLMがもはやテキスト生成だけのものではないことを示しています。LLMは複雑な問題に取り組み、複数の言語を扱っています。全体として、Llama 3はAIをこれまで以上に柔軟で利用しやすいものにしています。今後予定されているLlama 3のアップグレードでは、マルチモーダル対応やより長いコンテキストウィンドウなど、さらなる機能が期待されます。
AIについて詳しく知るには、GitHubリポジトリをご覧になり、コミュニティにご参加ください。AIが製造業や農業などの分野でどのように活用されているか、ソリューションページをご覧ください。
執筆者
コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。









