Tìm hiểu về Llama 3 của Meta
Tìm hiểu về Llama 3 của Meta, LLM có trọng số mở được phát hành vào tháng 4 năm 2024: các phiên bản 8B và 70B, kiến trúc, huấn luyện ở quy mô lớn và kết quả benchmark.
 Abirami Vina11 phút đọc
Khi tổng kết các đổi mới về trí tuệ nhân tạo trong quý đầu tiên của năm 2024, chúng ta thấy nhiều tổ chức liên tục phát hành LLM, hay mô hình ngôn ngữ lớn. Tiếp nối xu hướng này, ngày 18 tháng 4 năm 2024, Meta phát hành Llama 3, một LLM mã nguồn mở thế hệ mới, hiện đại nhất.
Có thể bạn đang nghĩ: Chỉ là một LLM khác thôi mà. Vì sao cộng đồng AI lại hào hứng đến vậy?
Bạn có thể fine-tune các model như GPT-3 hoặc Gemini để tạo phản hồi tùy chỉnh, nhưng chúng không hoàn toàn minh bạch về cách hoạt động bên trong, chẳng hạn như dữ liệu huấn luyện, tham số model hoặc thuật toán. Ngược lại, Llama 3 của Meta minh bạch hơn, với kiến trúc và trọng số có thể tải xuống. Đối với cộng đồng AI, điều này đồng nghĩa với sự tự do lớn hơn để thử nghiệm.
Trong bài viết này, chúng ta sẽ tìm hiểu Llama 3 có thể làm gì, quá trình phát triển model này và tác động của nó đối với lĩnh vực AI.
Quá trình phát triển các model Llama của Meta#
Trước khi tìm hiểu sâu về Llama 3, hãy cùng nhìn lại các phiên bản trước đó.
Meta ra mắt Llama 1 vào tháng 2 năm 2023 với bốn biến thể có số lượng tham số từ 7 tỷ đến 65 tỷ. Trong machine learning, “tham số” là các thành phần của model được học từ dữ liệu huấn luyện. Do có ít tham số hơn, Llama 1 đôi khi gặp khó khăn trong việc hiểu các sắc thái và đưa ra phản hồi thiếu nhất quán.
Không lâu sau Llama 1, Meta ra mắt Llama 2 vào tháng 7 năm 2023. Model này được huấn luyện trên 2 nghìn tỷ token. Token là một phần văn bản, chẳng hạn như một từ hoặc một phần của từ, được dùng làm đơn vị dữ liệu cơ bản để xử lý trong model. Model này cũng có những cải tiến như cửa sổ ngữ cảnh được tăng gấp đôi lên 4096 token để hiểu các đoạn văn dài hơn, cùng hơn 1 triệu chú thích do con người thực hiện nhằm giảm lỗi. Dù có những cải tiến này, Llama 2 vẫn cần rất nhiều năng lực tính toán, và Meta hướng đến việc khắc phục điều đó với Llama 3.
Giới thiệu Llama 3 của Meta#
Llama 3 có bốn biến thể, được huấn luyện trên con số đáng kinh ngạc là 15 nghìn tỷ token. Hơn 5% dữ liệu huấn luyện là dữ liệu chất lượng cao bằng các ngôn ngữ không phải tiếng Anh, bao gồm hơn 30 ngôn ngữ. Tất cả biến thể Llama 3 đều có thể chạy trên nhiều loại phần cứng dành cho người dùng phổ thông và có độ dài ngữ cảnh 8k token.
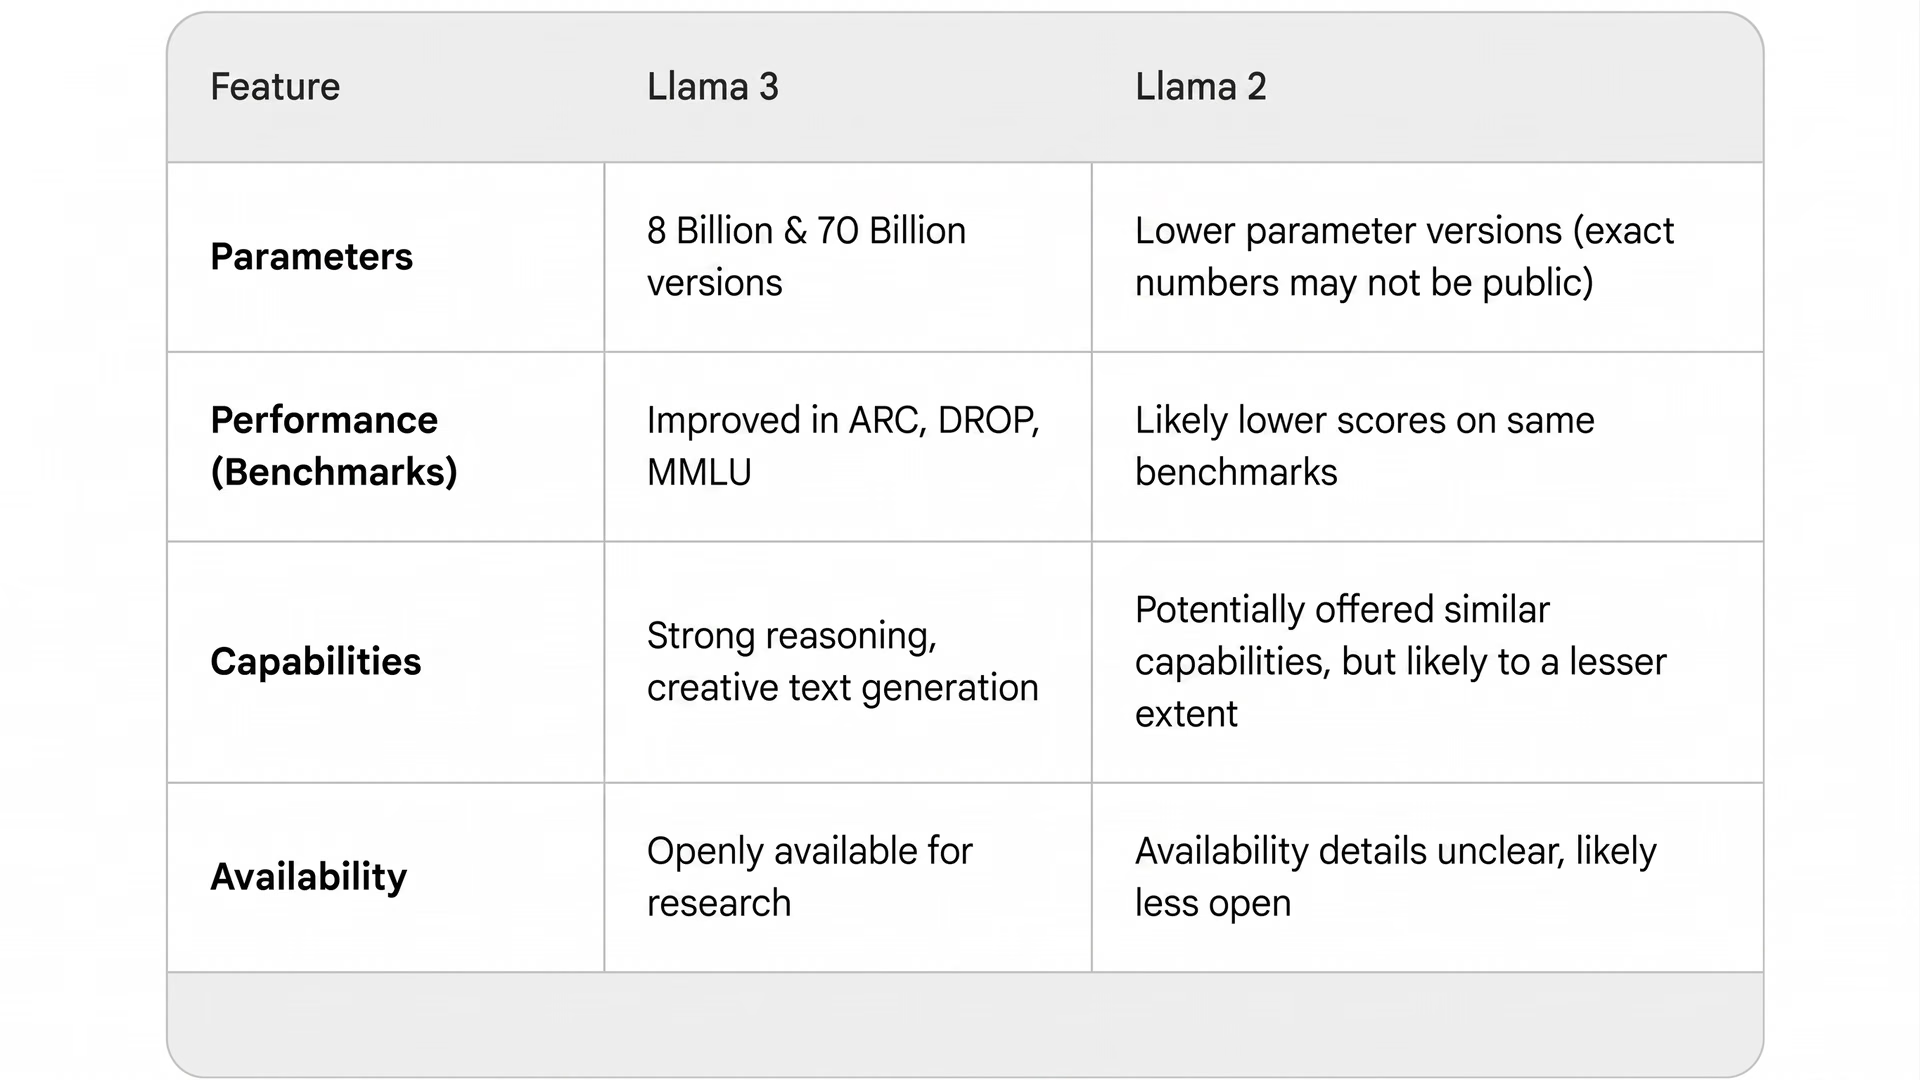
Hình 1. Llama 3 so với Llama 2.
Các biến thể model có hai kích thước: 8B và 70B, lần lượt tương ứng với 8 tỷ và 70 tỷ tham số. Ngoài ra còn có hai phiên bản: base và instruct. "Base" là phiên bản được huấn luyện trước tiêu chuẩn. "Instruct" là phiên bản được tinh chỉnh để làm theo hướng dẫn và tối ưu hóa cho các trường hợp sử dụng hội thoại.
Các biến thể model Llama 3 gồm:
- Meta-Llama-3-8b: Model base 8B cung cấp các năng lực AI cơ bản và lý tưởng cho những tác vụ phổ thông như phát triển chatbot dịch vụ khách hàng.
- Meta-Llama-3-8b-instruct: Phiên bản instruct của model 8B được fine-tune để tối ưu hóa cho các tác vụ cụ thể. Ví dụ, model có thể được dùng để tạo các công cụ giáo dục giải thích những chủ đề phức tạp.
- Meta-Llama-3-70b: Model base 70B được thiết kế cho các ứng dụng AI hiệu năng cao. Model này phù hợp với các ứng dụng như xử lý kho tài liệu y sinh học đồ sộ phục vụ khám phá thuốc.
- Meta-Llama-3-70b-instruct: Phiên bản này được tinh chỉnh từ model 70B cho các ứng dụng đòi hỏi độ chính xác cao, chẳng hạn như phân tích tài liệu pháp lý hoặc y tế, nơi độ chính xác là yếu tố then chốt.
Kiến trúc model Llama 3 của Meta#
Tương tự những tiến bộ AI khác của Meta, các biện pháp kiểm soát chất lượng nghiêm ngặt được áp dụng để duy trì tính toàn vẹn của dữ liệu và giảm thiểu thiên lệch trong quá trình phát triển Llama 3. Vì vậy, sản phẩm cuối cùng là một model mạnh mẽ được tạo ra một cách có trách nhiệm.
Kiến trúc model Llama 3 nổi bật nhờ tập trung vào hiệu quả và hiệu năng trong các tác vụ xử lý ngôn ngữ tự nhiên. Được xây dựng trên framework dựa trên Transformer, kiến trúc này chú trọng hiệu quả tính toán, đặc biệt trong quá trình tạo văn bản, bằng cách sử dụng kiến trúc chỉ có bộ giải mã.
Model chỉ tạo đầu ra dựa trên ngữ cảnh đứng trước, không cần encoder riêng, nhờ đó quá trình tạo văn bản vẫn hiệu quả.
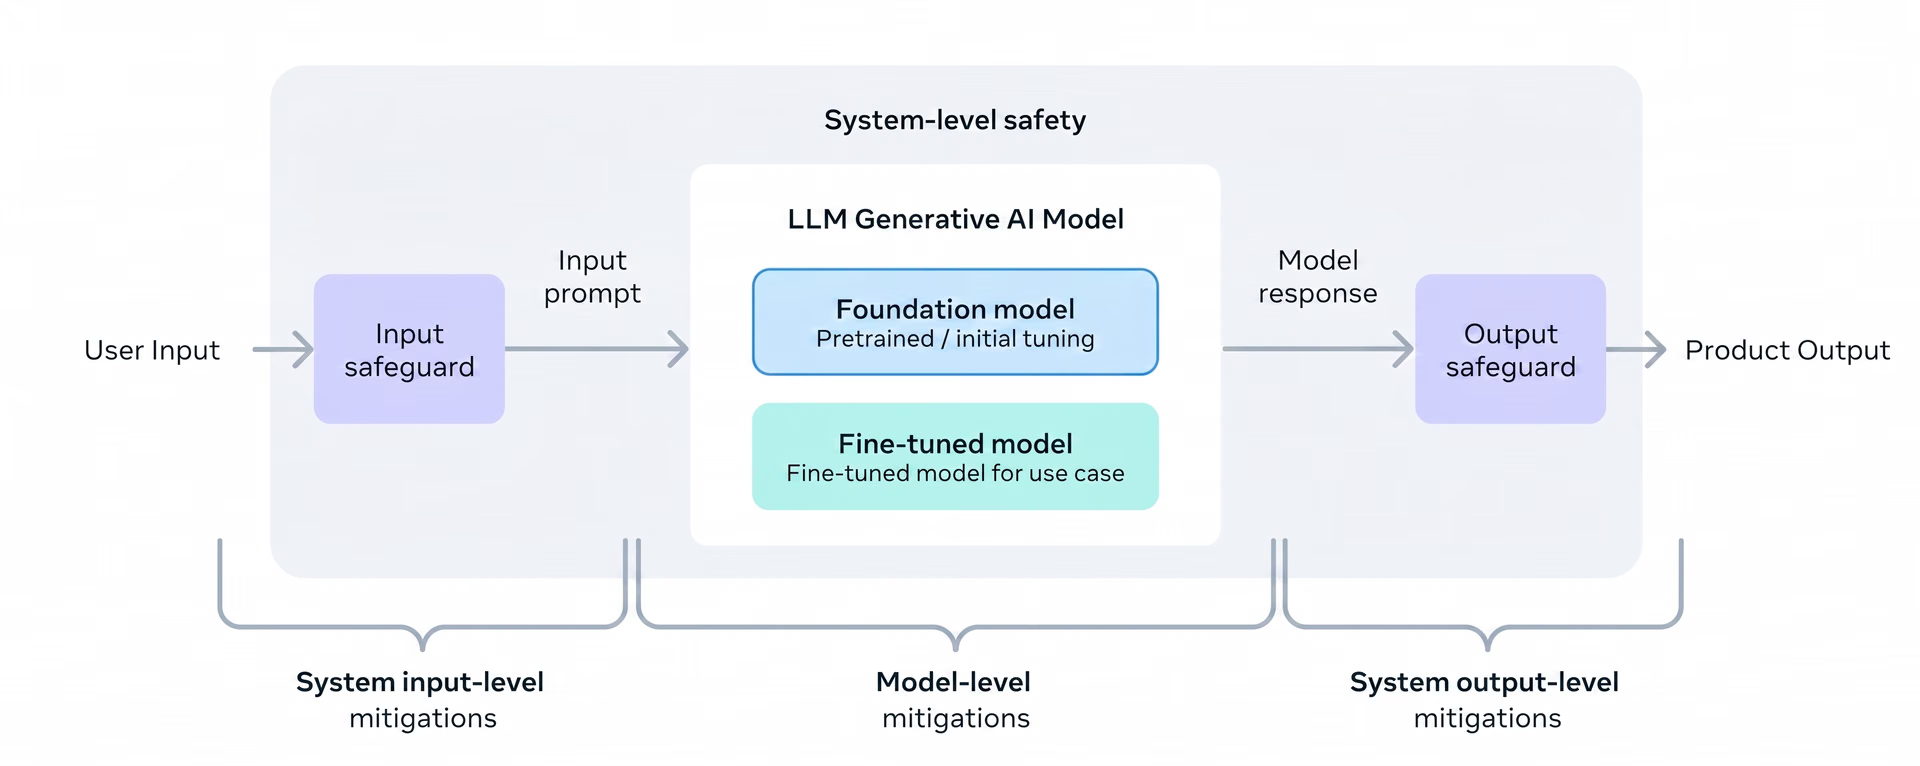
Hình 2. Kiến trúc model có trách nhiệm của Llama 3.
Các model Llama 3 có tokenizer với vốn từ vựng gồm 128K token. Vốn từ vựng lớn hơn giúp model hiểu và xử lý văn bản tốt hơn. Ngoài ra, hiện các model sử dụng chú ý truy vấn nhóm (GQA) để cải thiện hiệu quả suy luận. GQA cho phép các nhóm attention head dùng chung key và value, giúp giảm mức sử dụng bộ nhớ và tăng tốc độ tạo văn bản mà chỉ ảnh hưởng nhỏ đến chất lượng.
Dưới đây là một số chi tiết thú vị khác về kiến trúc model Llama 3:
- Xử lý tài liệu nhận biết ranh giới: Llama 3 duy trì tính mạch lạc xuyên suốt các ranh giới tài liệu, yếu tố then chốt trong những tác vụ như tóm tắt.
- Hiểu code tốt hơn: Dữ liệu huấn luyện của Llama 3 có số lượng mẫu code gấp bốn lần, giúp nâng cao năng lực lập trình của model.
- Kiểm soát chất lượng chặt chẽ: Các biện pháp nghiêm ngặt, bao gồm bộ lọc heuristic và loại bỏ nội dung NSFW, đảm bảo tính toàn vẹn của dữ liệu và giảm thiểu thiên lệch.
Llama 3 đang thay đổi cách chúng ta tiếp cận việc huấn luyện model#
Để huấn luyện các model Llama 3 lớn nhất, ba hình thức song song hóa đã được kết hợp: song song hóa dữ liệu, song song hóa model và song song hóa pipeline.
Song song hóa dữ liệu phân chia dữ liệu huấn luyện trên nhiều GPU, còn song song hóa model phân vùng kiến trúc model để tận dụng năng lực tính toán của từng GPU. Song song hóa pipeline chia quá trình huấn luyện thành các giai đoạn tuần tự, tối ưu hóa việc tính toán và giao tiếp.
Bản triển khai hiệu quả nhất đạt mức sử dụng năng lực tính toán cao, vượt 400 TFLOPS trên mỗi GPU khi huấn luyện đồng thời trên 16.000 GPU. Các đợt huấn luyện này được thực hiện trên hai cụm GPU tùy chỉnh, mỗi cụm gồm 24.000 GPU. Cơ sở hạ tầng tính toán quy mô lớn này cung cấp năng lực cần thiết để huấn luyện hiệu quả các model Llama 3 quy mô lớn.
Để tối đa hóa thời gian hoạt động của GPU, một stack huấn luyện nâng cao mới đã được phát triển nhằm tự động hóa việc phát hiện, xử lý lỗi và bảo trì. Độ tin cậy của phần cứng và các cơ chế phát hiện đã được cải thiện đáng kể để giảm thiểu nguy cơ lỗi dữ liệu âm thầm. Ngoài ra, các hệ thống lưu trữ có khả năng mở rộng mới được phát triển để giảm chi phí ghi checkpoint và khôi phục.
Những cải tiến này giúp thời gian huấn luyện hiệu quả đạt hơn 95%. Kết hợp lại, chúng nâng hiệu quả huấn luyện Llama 3 lên khoảng gấp ba lần so với Llama 2. Hiệu quả này mở ra những khả năng mới cho các phương pháp huấn luyện AI.
Mở ra những cơ hội mới với Llama 3#
Vì Llama 3 là mã nguồn mở, các nhà nghiên cứu và sinh viên có thể nghiên cứu code, tiến hành thử nghiệm và thảo luận về các mối quan ngại đạo đức cũng như thiên kiến. Tuy nhiên, Llama 3 không chỉ dành cho giới học thuật. Model này còn được sử dụng trong các ứng dụng thực tế. Llama 3 đang trở thành nền tảng cho giao diện trò chuyện Meta AI, được tích hợp vào các nền tảng như Facebook, Instagram, WhatsApp và Messenger. Với Meta AI, người dùng có thể trò chuyện bằng ngôn ngữ tự nhiên, nhận đề xuất cá nhân hóa, thực hiện tác vụ và dễ dàng kết nối với người khác.
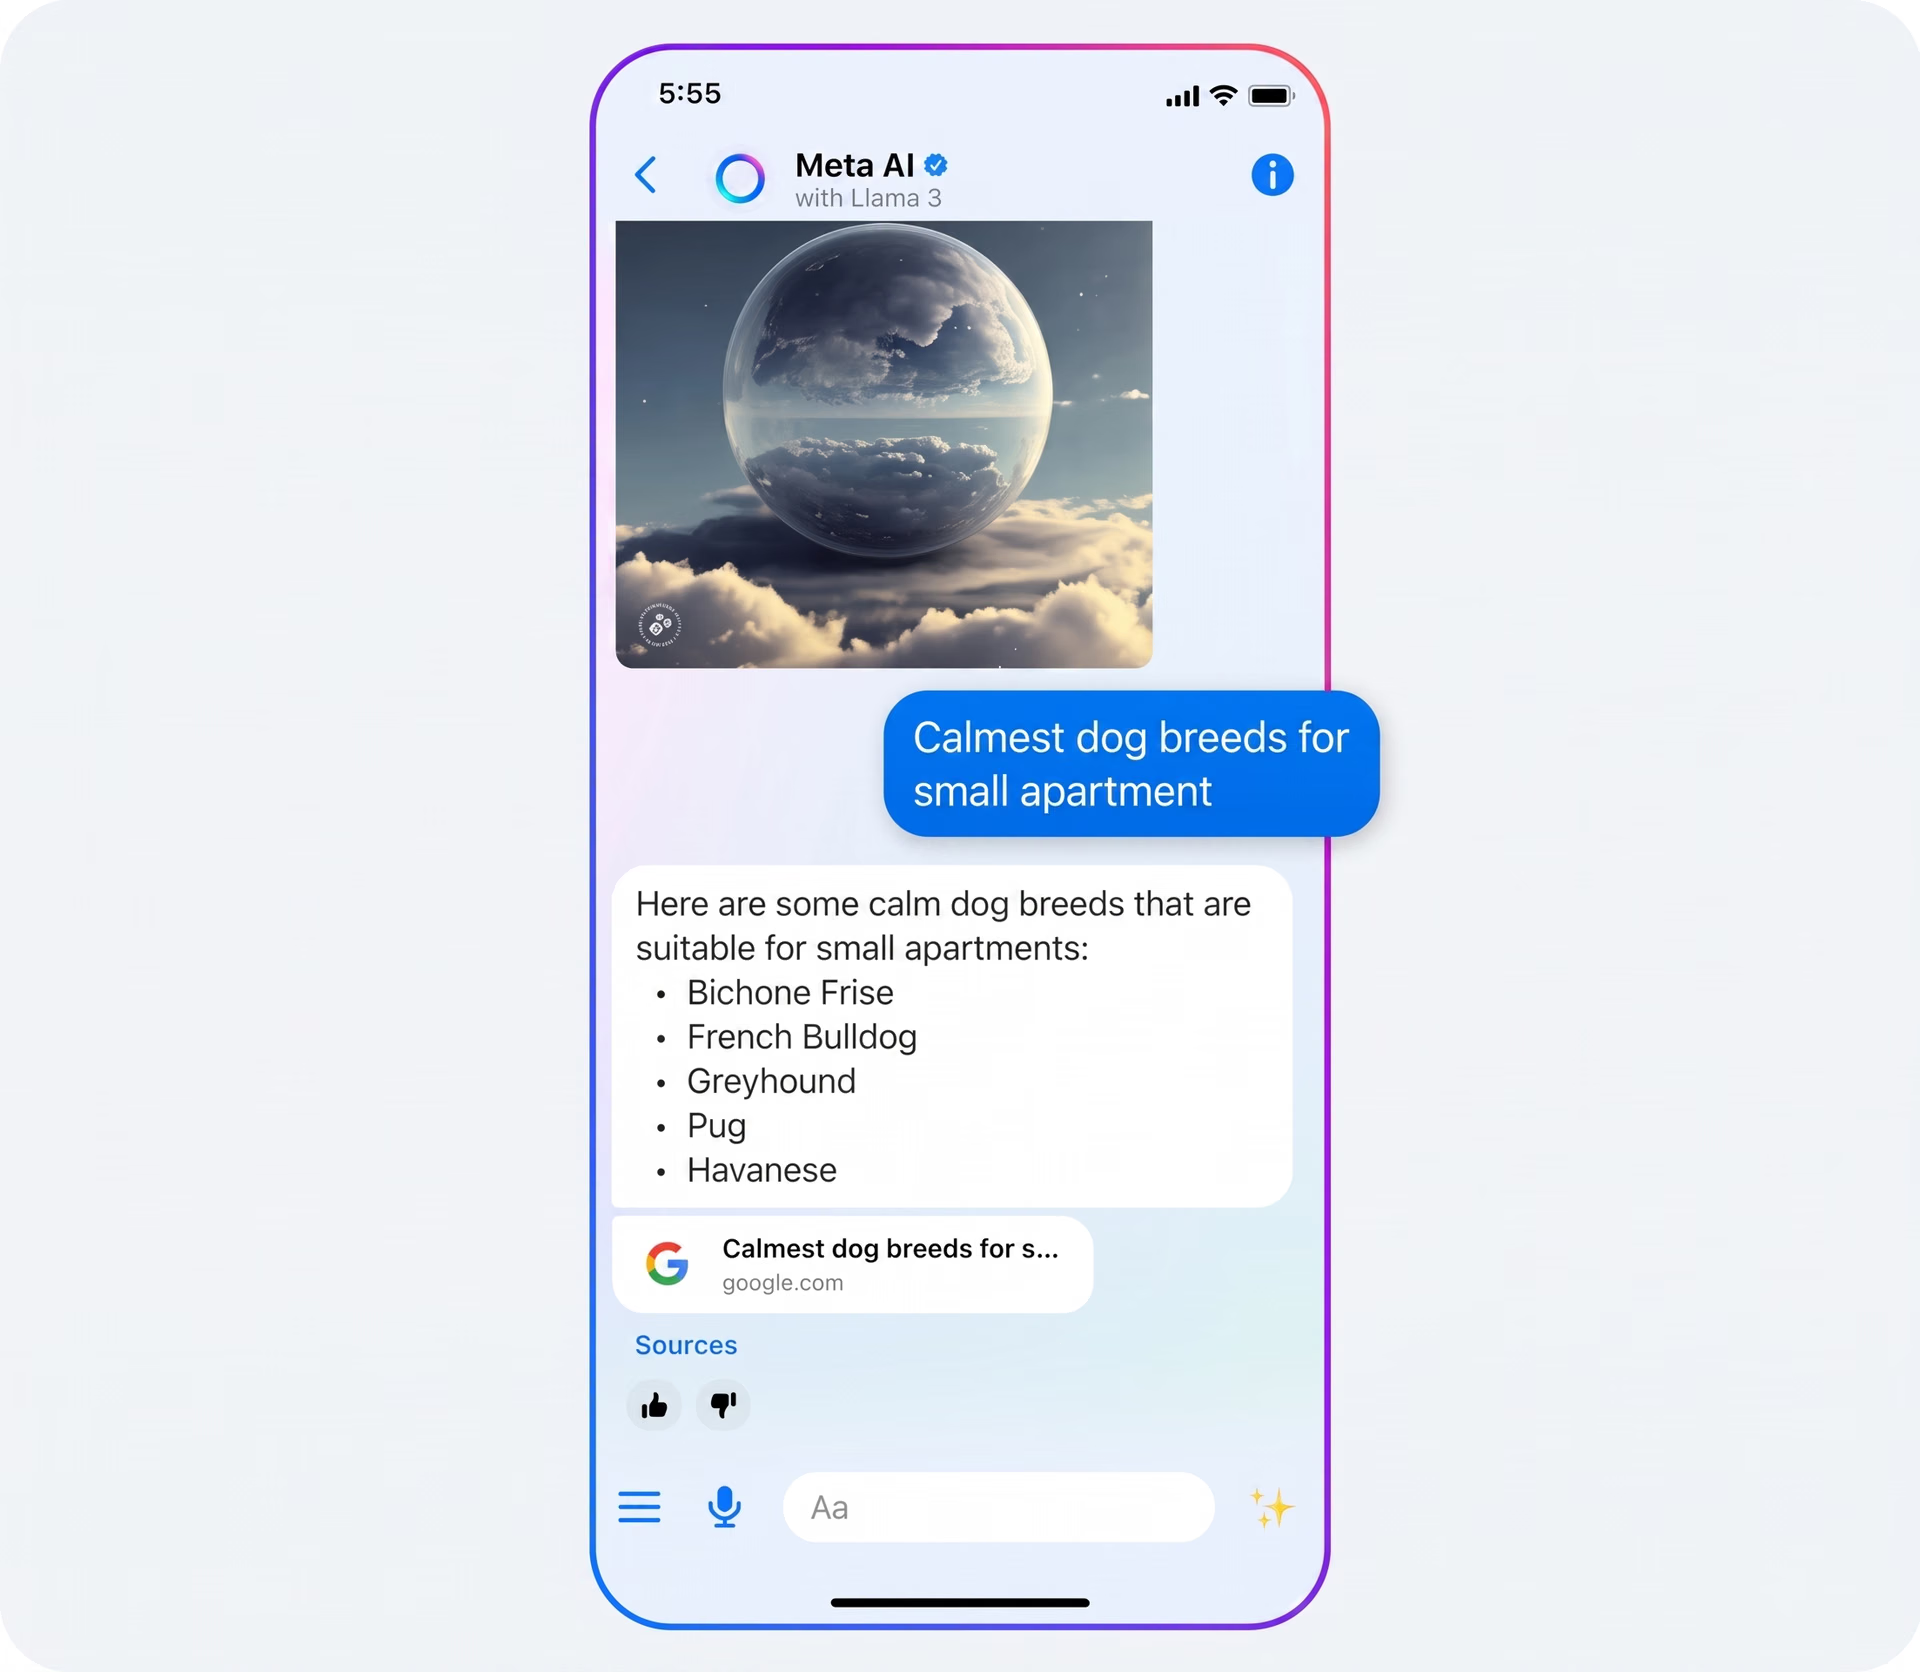
Hình 3. Meta AI: Được hỗ trợ bởi Llama 3.
So sánh Llama 3 với các LLM khác#
Llama 3 đạt kết quả tốt trên một số benchmark quan trọng đánh giá khả năng hiểu ngôn ngữ phức tạp và suy luận. Dưới đây là một số benchmark kiểm tra nhiều khía cạnh khác nhau trong năng lực của Llama 3:
- Đánh giá mức độ hiểu biết ngôn ngữ đa nhiệm quy mô lớn (MMLU) - Đo lường kiến thức của model trên nhiều lĩnh vực.
- Hỏi đáp trình độ sau đại học khó tra cứu trên Google (GPQA) - Đánh giá khả năng trả lời các câu hỏi hóc búa ở trình độ sau đại học trong các lĩnh vực sinh học, vật lý và hóa học của model.
- HumanEval - Tập trung vào các tác vụ lập trình và giải quyết vấn đề, kiểm tra khả năng tạo code lập trình có thể chạy và giải các thử thách thuật toán của model.
Kết quả nổi bật của Llama 3 trong các bài kiểm tra này giúp phân biệt rõ model với những đối thủ như Gemma 7B của Google, Mistral 7B của Mistral và Claude 3 Sonnet của Anthropic. Theo số liệu đã công bố, đặc biệt là model 70B, Llama 3 vượt trội hơn các model này trên tất cả benchmark nêu trên.
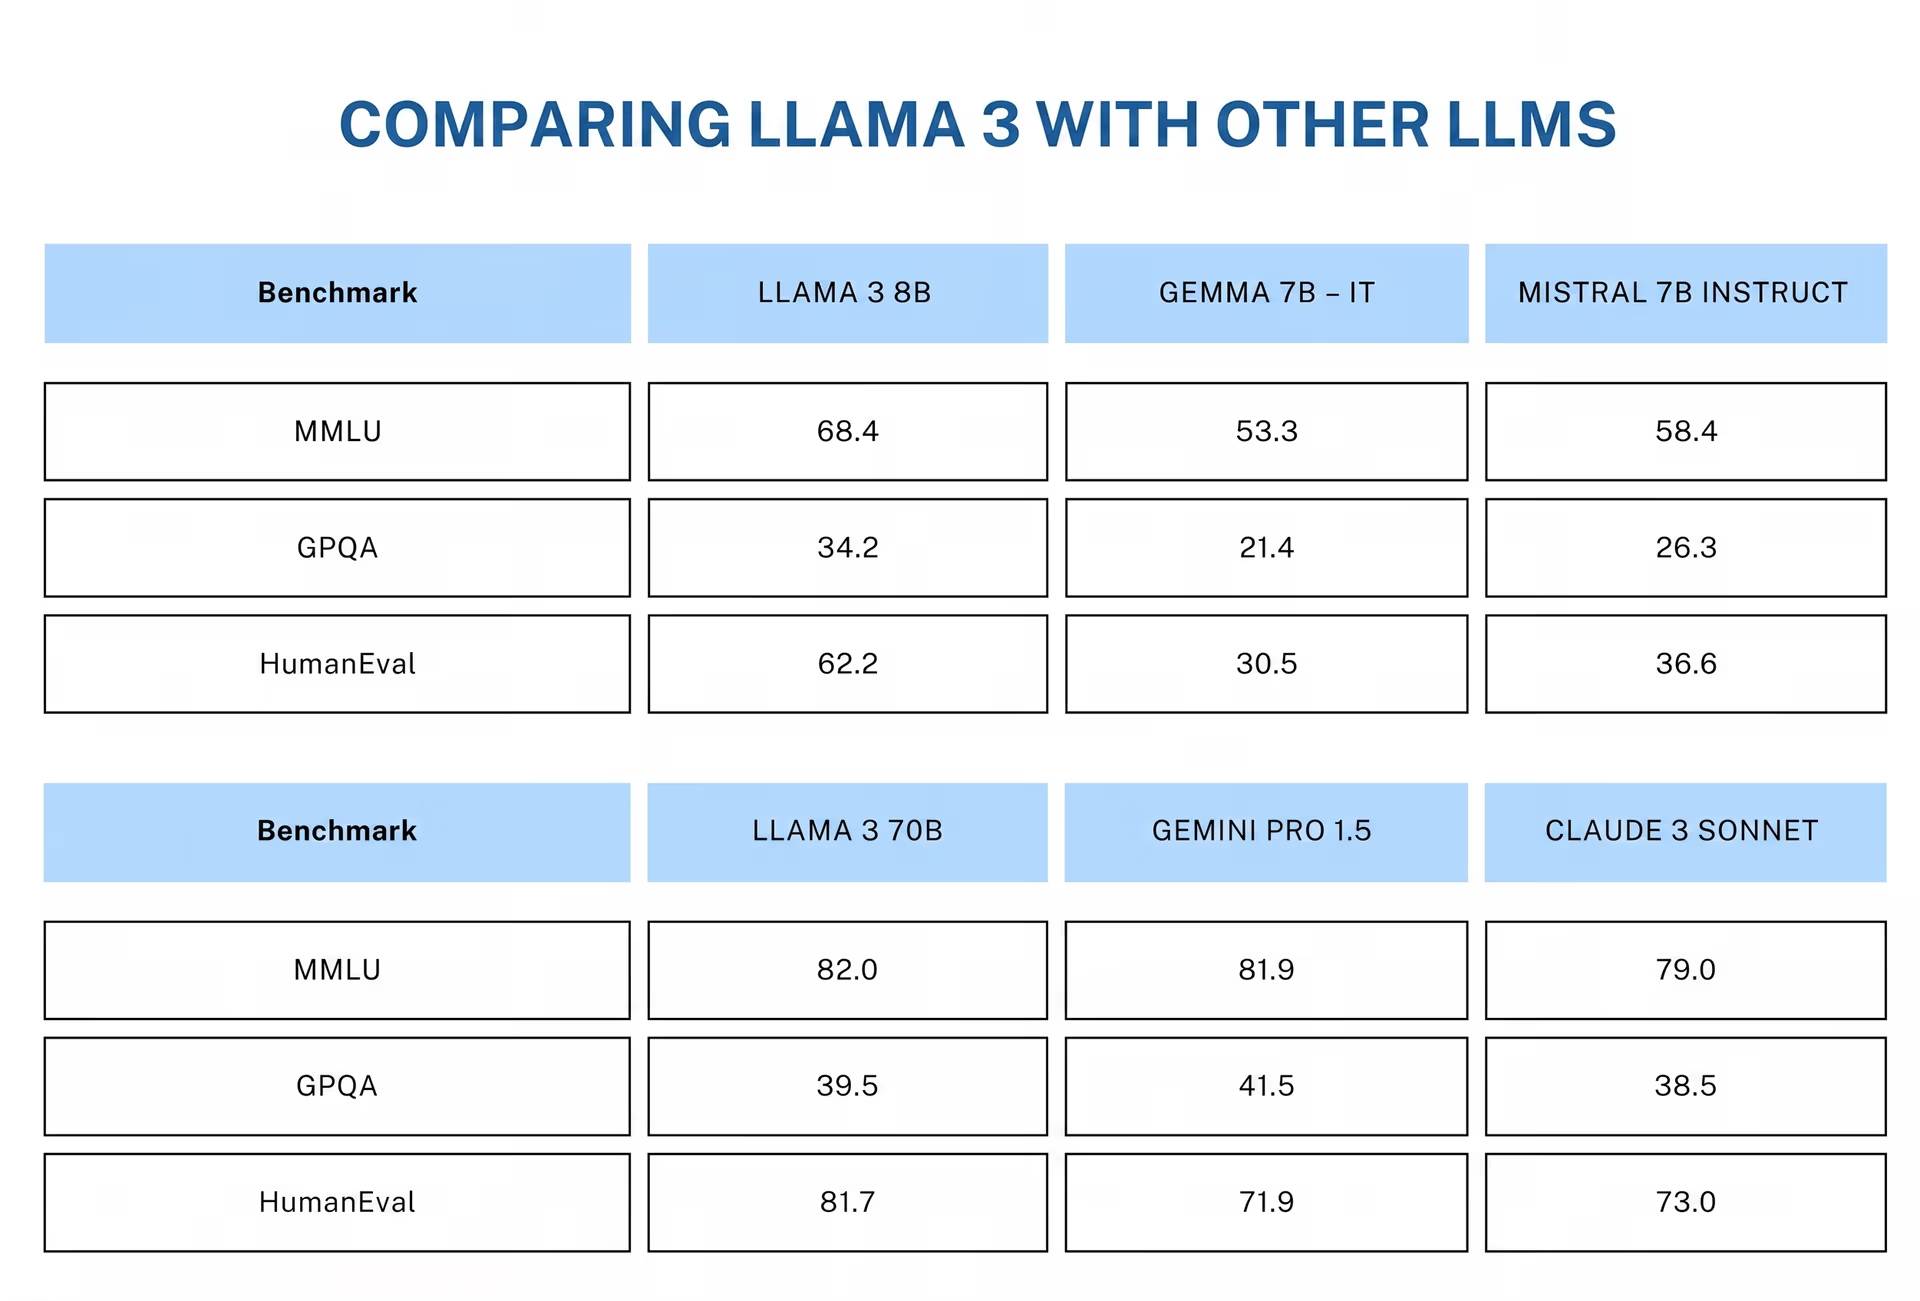
Hình 4. So sánh Llama 3 với các LLM khác.
Meta đang giúp Llama 3 được phổ biến rộng rãi#
Meta đang mở rộng phạm vi tiếp cận của Llama 3 bằng cách cung cấp model trên nhiều nền tảng cho cả người dùng phổ thông lẫn developer. Với người dùng hằng ngày, Llama 3 được tích hợp vào các nền tảng phổ biến của Meta như WhatsApp, Instagram, Facebook và Messenger. Người dùng có thể truy cập các tính năng nâng cao như tìm kiếm theo thời gian thực và tạo nội dung sáng tạo ngay trong những ứng dụng này.
Llama 3 cũng đang được tích hợp vào các thiết bị đeo như kính thông minh Ray-Ban Meta và kính thực tế ảo Meta Quest để mang lại trải nghiệm tương tác.
Llama 3 được cung cấp trên nhiều nền tảng dành cho developer, bao gồm AWS, Databricks, Google Cloud, Hugging Face, Kaggle, IBM WatsonX, Microsoft Azure, NVIDIA NIM và Snowflake. Bạn cũng có thể truy cập trực tiếp các model này từ Meta. Nhiều lựa chọn đa dạng giúp developer dễ dàng tích hợp các năng lực AI tiên tiến này vào dự án, dù họ muốn làm việc trực tiếp với Meta hay thông qua các nền tảng phổ biến khác.
Điểm chính cần nhớ#
Những tiến bộ trong học máy tiếp tục thay đổi cách chúng ta tương tác với công nghệ mỗi ngày. Llama 3 của Meta cho thấy LLM không còn chỉ dùng để tạo văn bản. LLM đang giải quyết các vấn đề phức tạp và xử lý nhiều ngôn ngữ. Nhìn chung, Llama 3 đang giúp AI thích ứng và dễ tiếp cận hơn bao giờ hết. Trong tương lai, những nâng cấp dự kiến cho Llama 3 hứa hẹn mang đến nhiều năng lực hơn, chẳng hạn như đa phương thức và cửa sổ ngữ cảnh dài hơn.
Khám phá repository GitHub và tham gia cộng đồng của chúng tôi để tìm hiểu thêm về AI. Truy cập các trang giải pháp để xem cách AI được ứng dụng trong các lĩnh vực như sản xuất và nông nghiệp.
Được viết bởi
Nhà sáng tạo nội dung · Ultralytics
Bình luận
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.









