Alla scoperta di Llama 3 di Meta
Scopri Llama 3 di Meta, il modello LLM open-weight rilasciato nell’aprile 2024: le varianti 8B e 70B, l’architettura, l’addestramento su larga scala e i risultati dei benchmark.
 Abirami Vina9 min di lettura
Quando abbiamo fatto il punto sulle innovazioni dell'intelligenza artificiale (AI) del primo trimestre del 2024, abbiamo visto che diverse organizzazioni pubblicavano continuamente LLM, ovvero modelli linguistici di grandi dimensioni. Proseguendo su questa scia, il 18 aprile 2024 Meta ha rilasciato Llama 3, un LLM open source di nuova generazione all'avanguardia.
Forse ti starai chiedendo: È solo un altro LLM. Perché la community dell'AI ne è così entusiasta?
Puoi ottimizzare modelli come GPT-3 o Gemini per ottenere risposte personalizzate, ma questi non offrono piena trasparenza sul loro funzionamento interno, come i dati di addestramento, i parametri del modello o gli algoritmi. Llama 3 di Meta, invece, è più trasparente: la sua architettura e i suoi pesi sono disponibili per il download. Per la community dell'AI, questo significa maggiore libertà di sperimentare.
In questo articolo scopriremo cosa può fare Llama 3, come è nato e quale impatto ha avuto nel campo dell’AI.
L'evoluzione dei modelli Llama di Meta#
Prima di approfondire Llama 3, ripercorriamo le sue versioni precedenti.
Meta ha lanciato Llama 1 a febbraio 2023, in quattro varianti con un numero di parametri compreso tra 7 e 65 miliardi. Nel machine learning, i "parametri" sono gli elementi del modello appresi dai dati di addestramento. A causa del numero inferiore di parametri, a volte Llama 1 faticava a cogliere le sfumature e forniva risposte incoerenti.
Poco dopo Llama 1, Meta ha lanciato Llama 2 nel luglio 2023. È stato addestrato su 2.000 miliardi di token. Un token rappresenta una porzione di testo, come una parola o parte di una parola, utilizzata come unità di base dei dati elaborati dal modello. Il modello includeva anche miglioramenti come una finestra di contesto raddoppiata, pari a 4096 token, per comprendere passaggi più lunghi, e oltre 1 milione di annotazioni umane per ridurre gli errori. Nonostante questi miglioramenti, Llama 2 richiedeva ancora una notevole potenza di calcolo, un aspetto che Meta intendeva risolvere con Llama 3.
Ecco Llama 3 di Meta#
Llama 3 comprende quattro varianti, addestrate su ben 15.000 miliardi di token. Oltre il 5% dei dati di addestramento era costituito da dati non in inglese di alta qualità, che coprivano più di 30 lingue. Tutte le varianti di Llama 3 possono essere eseguite su diversi tipi di hardware di consumo e hanno una finestra di contesto di 8.000 token.
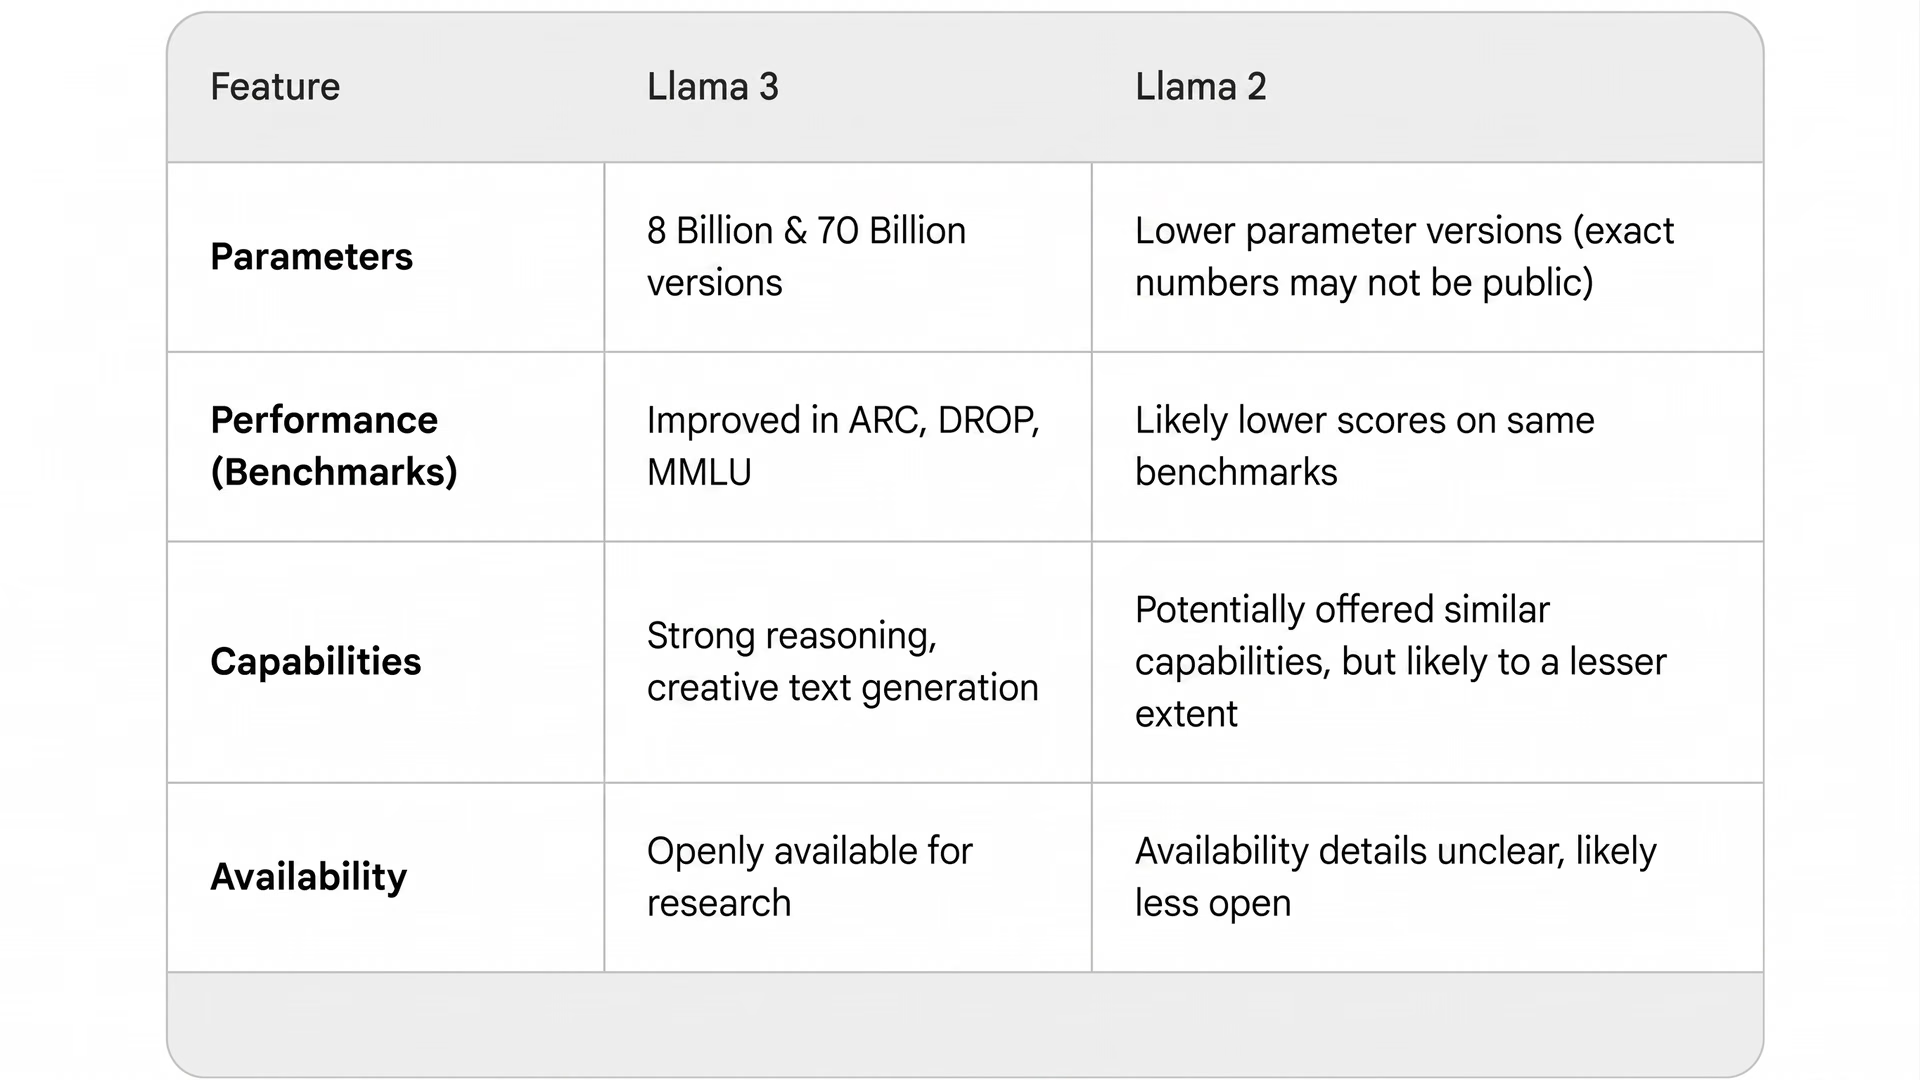
Fig. 1. Llama 3 a confronto con Llama 2.
Le varianti del modello sono disponibili in due dimensioni: 8B e 70B, che indicano rispettivamente 8 e 70 miliardi di parametri. Esistono anche due versioni: base e instruct. «Base» indica la versione standard preaddestrata. «Instruct» è una versione sottoposta a fine-tuning per seguire le istruzioni e ottimizzata per i casi d'uso conversazionali.
Ecco le varianti del modello Llama 3:
- Meta-Llama-3-8b: il modello base 8B offre funzionalità fondamentali di AI ed è ideale per attività generiche, come lo sviluppo di chatbot per il servizio clienti.
- Meta-Llama-3-8b-instruct: una versione instruct del modello 8B ottimizzata tramite fine-tuning per attività specifiche. Ad esempio, può essere usata per creare strumenti didattici che spiegano argomenti complessi.
- Meta-Llama-3-70b: il modello base 70B è progettato per applicazioni di AI ad alte prestazioni. È adatto ad applicazioni come l'analisi di vaste raccolte di letteratura biomedica per la scoperta di farmaci.
- Meta-Llama-3-70b-instruct: questa versione è stata ottimizzata a partire dal modello 70B per applicazioni che richiedono grande precisione, come l’analisi di documenti legali o medici, in cui l’accuratezza è fondamentale.
L'architettura del modello Llama 3 di Meta#
Come per ogni altro progresso di Meta nell'AI, durante lo sviluppo di Llama 3 sono state adottate rigorose misure di controllo qualità per preservare l'integrità dei dati e ridurre al minimo i bias. Il risultato è quindi un modello potente, realizzato responsabilmente.
L'architettura del modello Llama 3 si distingue per l'attenzione all'efficienza e alle prestazioni nelle attività di elaborazione del linguaggio naturale. Basata su un framework Transformer, punta all'efficienza computazionale, soprattutto durante la generazione di testo, grazie a un'architettura composta solo da un decoder.
Il modello genera risultati basandosi esclusivamente sul contesto precedente, senza un encoder separato, rendendo efficiente la generazione del testo.
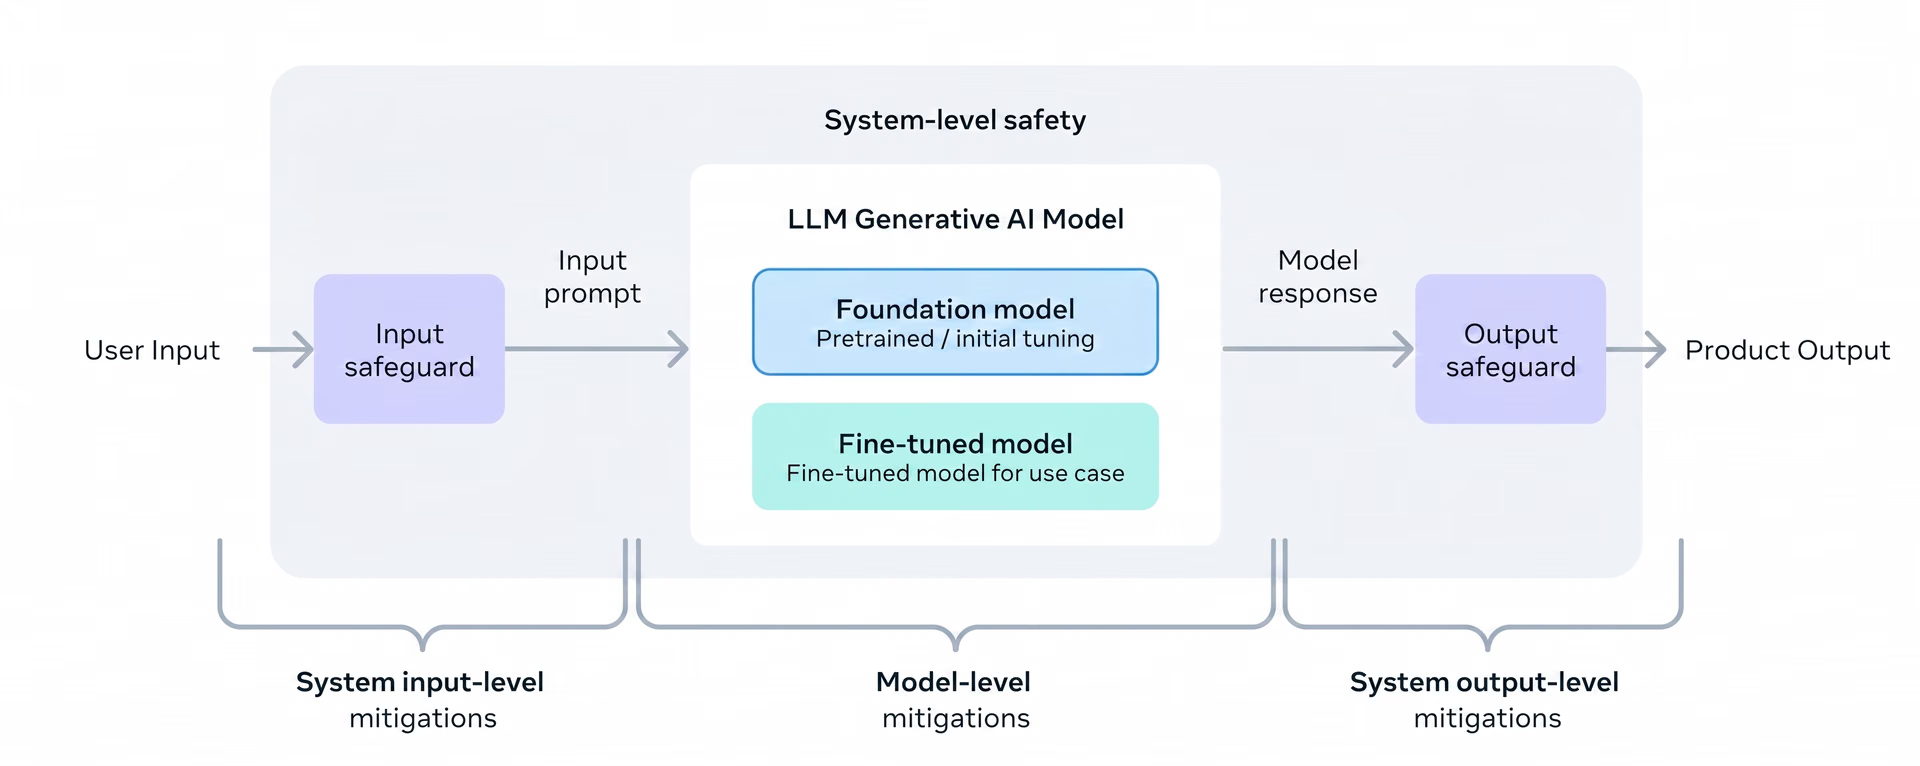
Fig. 2. Architettura responsabile di Llama 3.
I modelli Llama 3 utilizzano un tokenizzatore con un vocabolario di 128K token. Un vocabolario più ampio consente ai modelli di comprendere ed elaborare meglio il testo. Inoltre, ora i modelli utilizzano la grouped query attention (GQA) per migliorare l’efficienza dell’inferenza. GQA consente a gruppi di teste di attenzione di condividere le stesse chiavi e gli stessi valori, riducendo l’uso della memoria e accelerando la generazione del testo con una perdita di qualità minima.
Ecco altri dettagli interessanti sull'architettura del modello Llama 3:
- Elaborazione dei documenti consapevole dei confini: Llama 3 mantiene la chiarezza tra i confini dei documenti, un aspetto fondamentale per attività come la sintesi.
- Migliore comprensione del codice: i dati di addestramento di Llama 3 includono una quantità di esempi di codice quattro volte superiore, potenziando le capacità di programmazione del modello.
- Controllo qualità rigoroso: misure rigorose, tra cui filtri euristici e la rimozione di contenuti NSFW, garantiscono l'integrità dei dati e riducono al minimo i bias.
Llama 3 sta trasformando il nostro approccio all'addestramento dei modelli#
Per addestrare i modelli Llama 3 più grandi sono stati combinati tre tipi di parallelismo: parallelismo dei dati, parallelismo del modello e parallelismo della pipeline.
Il parallelismo dei dati distribuisce i dati di addestramento su più GPU, mentre il parallelismo del modello suddivide l'architettura del modello per sfruttare la potenza di calcolo di ogni GPU. Il parallelismo della pipeline suddivide il processo di addestramento in fasi sequenziali, ottimizzando il calcolo e la comunicazione.
L’implementazione più efficiente ha raggiunto un elevato utilizzo computazionale, superando i 400 TFLOPS per GPU durante l’addestramento simultaneo su 16.000 GPU. Queste sessioni di addestramento sono state eseguite su due cluster di GPU realizzati su misura, ciascuno composto da 24.000 GPU. Questa imponente infrastruttura computazionale ha fornito la potenza necessaria per addestrare in modo efficiente i modelli Llama 3 su larga scala.
Per massimizzare il tempo di operatività delle GPU è stato sviluppato un nuovo stack di addestramento avanzato, in grado di automatizzare il rilevamento e la gestione degli errori e la manutenzione. L'affidabilità dell'hardware e i meccanismi di rilevamento sono stati notevolmente migliorati per mitigare i rischi di corruzione silenziosa dei dati. Sono stati inoltre sviluppati nuovi sistemi di archiviazione scalabili per ridurre il sovraccarico dovuto ai checkpoint e al ripristino.
Questi miglioramenti hanno portato a un tempo di addestramento effettivo superiore al 95%. Nel complesso, hanno aumentato di circa tre volte l’efficienza dell’addestramento di Llama 3 rispetto a Llama 2. Questa efficienza apre nuove possibilità per i metodi di addestramento dell’AI.
Nuove possibilità con Llama 3#
Poiché Llama 3 è open source, ricercatori e studenti possono esaminarne il codice, condurre esperimenti e discutere delle questioni etiche e dei pregiudizi. Tuttavia, Llama 3 non è destinato solo al mondo accademico: viene utilizzato anche in applicazioni pratiche. Sta diventando la base dell’interfaccia di chat Meta AI, integrata in piattaforme come Facebook, Instagram, WhatsApp e Messenger. Con Meta AI, gli utenti possono conversare in linguaggio naturale, accedere a consigli personalizzati, svolgere attività e connettersi facilmente con altre persone.
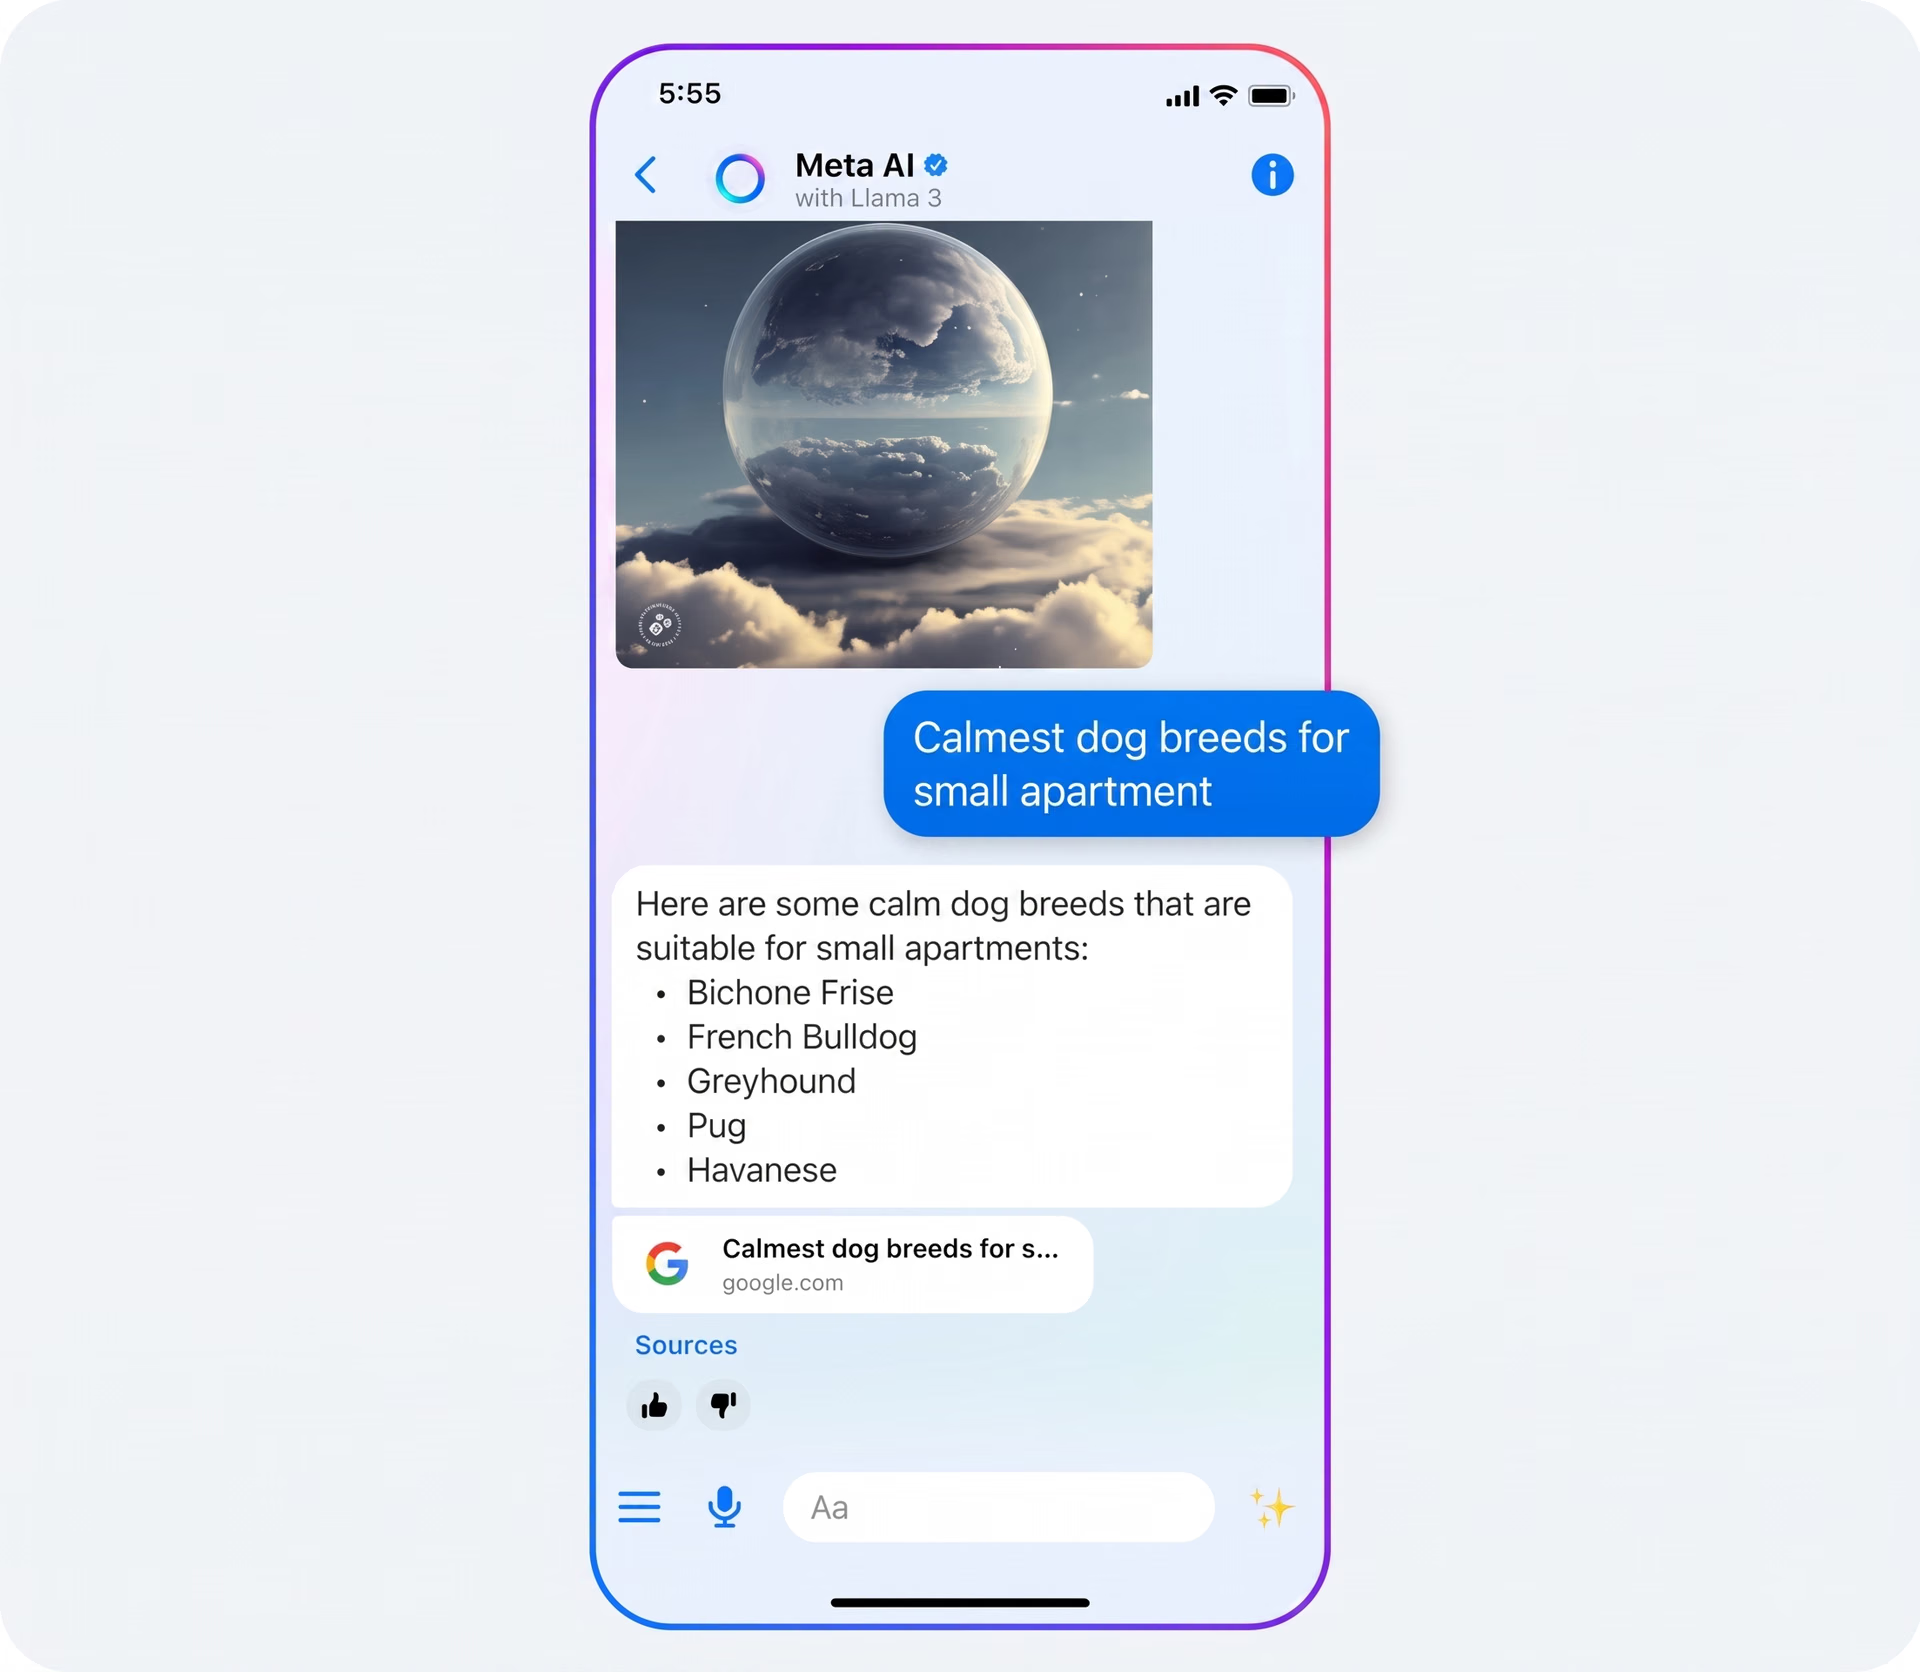
Fig. 3. Meta AI: basata su Llama 3.
Confronto tra Llama 3 e altri LLM#
Llama 3 ottiene buoni risultati in diversi benchmark chiave che valutano la comprensione del linguaggio complesso e le capacità di ragionamento. Ecco alcuni benchmark che mettono alla prova diversi aspetti delle capacità di Llama 3:
- Comprensione del linguaggio su vasta gamma di attività (MMLU) - Misura le conoscenze del modello in diversi ambiti.
- Domande e risposte di livello universitario difficili anche per Google (GPQA) - Valuta la capacità del modello di rispondere a domande complesse di livello universitario in biologia, fisica e chimica.
- HumanEval - Si concentra sulle attività di programmazione e risoluzione dei problemi, verificando la capacità del modello di generare codice funzionale e risolvere sfide algoritmiche.
Gli ottimi risultati di Llama 3 in questi test lo distinguono nettamente da concorrenti come Gemma 7B di Google, Mistral 7B di Mistral e Claude 3 Sonnet di Anthropic. Secondo le statistiche pubblicate, in particolare il modello 70B di Llama 3 supera questi modelli in tutti i benchmark citati.
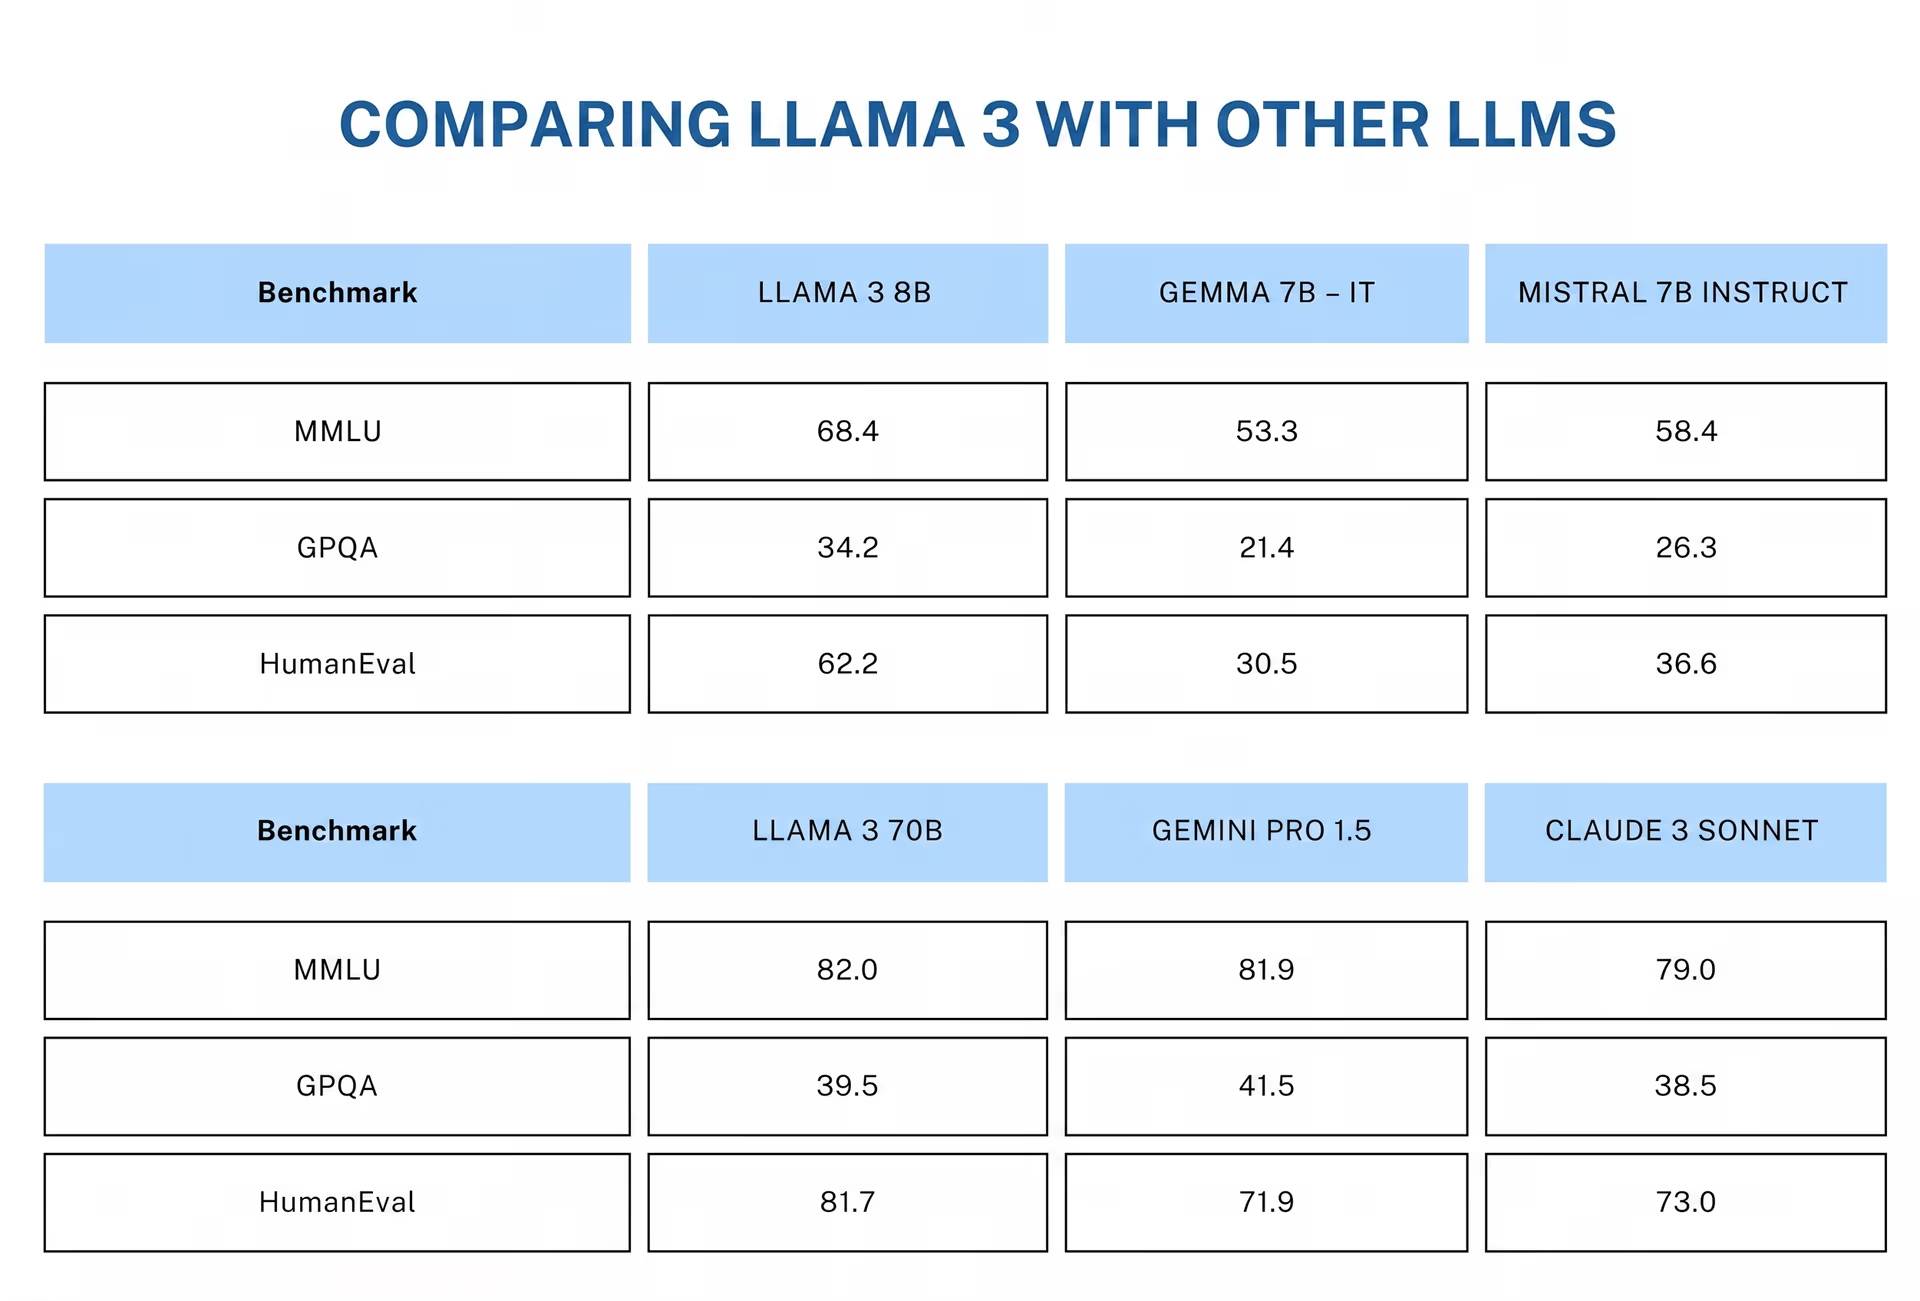
Fig. 4. Confronto tra Llama 3 e altri LLM.
Meta rende Llama 3 ampiamente accessibile#
Meta sta ampliando la portata di Llama 3 rendendolo disponibile su diverse piattaforme, sia per gli utenti comuni sia per gli sviluppatori. Per gli utenti di tutti i giorni, Llama 3 è integrato nelle piattaforme più diffuse di Meta, come WhatsApp, Instagram, Facebook e Messenger. Gli utenti possono accedere a funzionalità avanzate come la ricerca in tempo reale e la generazione di contenuti creativi direttamente da queste app.
Llama 3 viene integrato anche in tecnologie indossabili come gli occhiali smart Ray-Ban Meta e il visore VR Meta Quest, per offrire esperienze interattive.
Llama 3 è disponibile su diverse piattaforme per sviluppatori, tra cui AWS, Databricks, Google Cloud, Hugging Face, Kaggle, IBM WatsonX, Microsoft Azure, NVIDIA NIM e Snowflake. Puoi anche accedere direttamente a questi modelli da Meta. L'ampia gamma di opzioni consente agli sviluppatori di integrare facilmente queste funzionalità avanzate dei modelli di AI nei propri progetti, scegliendo di lavorare direttamente con Meta o tramite altre piattaforme diffuse.
In sintesi#
I progressi dell'apprendimento automatico continuano a trasformare il nostro modo di interagire con la tecnologia ogni giorno. Llama 3 di Meta dimostra che gli LLM non servono più soltanto a generare testo: affrontano problemi complessi e gestiscono più lingue. Nel complesso, Llama 3 rende l'AI più adattabile e accessibile che mai. Guardando al futuro, gli aggiornamenti previsti per Llama 3 promettono capacità ancora maggiori, come la multimodalità e finestre di contesto più ampie.
Dai un'occhiata al nostro repository GitHub e unisciti alla nostra community per saperne di più sull'AI. Visita le nostre pagine dedicate alle soluzioni per scoprire come viene applicata l'AI in settori come la manifattura e l'agricoltura.
Scritto da
Creatore di contenuti · Ultralytics
Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.









