Meta'nın Llama 3 modeliyle tanış
Meta'nın Llama 3 modeli kısa süre önce yayımlandı ve yapay zekâ topluluğunda büyük heyecan yarattı. Meta'nın yapay zekâ alanındaki en yeni gelişmesi Llama 3 hakkında daha fazla bilgi edinelim.
2024'ün ilk çeyreğindeki yapay zeka (AI) yeniliklerini değerlendirdiğimizde, farklı kuruluşların büyük dil modellerini (LLM'ler) peş peşe yayımladığını gördük. Bu eğilimi sürdüren Meta, 18 Nisan 2024'te yeni nesil, son teknoloji açık kaynaklı bir LLM olan Llama 3'ü yayımladı.
Şöyle düşünüyor olabilirsin: Bu da başka bir LLM işte. Yapay zeka topluluğu neden bu kadar heyecanlı?
GPT-3 veya Gemini gibi modelleri özelleştirilmiş yanıtlar vermeleri için ince ayarlayabilirsin; ancak bu modeller, eğitim verileri, model parametreleri veya algoritmaları gibi iç işleyişleri konusunda tam şeffaflık sunmaz. Buna karşılık Meta'nın Llama 3 modeli daha şeffaftır; mimarisi ve ağırlıkları indirilebilir. Yapay zeka topluluğu için bu, denemeler yapma özgürlüğünün artması anlamına gelir.
Bu makalede Llama 3'ün neler yapabildiğini, nasıl ortaya çıktığını ve yapay zeka alanına etkisini öğreneceğiz. Hemen başlayalım!
Meta'nın Llama modellerinin gelişimi#
Llama 3'e geçmeden önce önceki sürümlerine göz atalım.
Meta, Şubat 2023'te 7 milyar ile 65 milyar arasında değişen parametre sayılarına sahip dört farklı sürümle Llama 1'i piyasaya sürdü. Makine öğrenmesinde "parametreler", eğitim verilerinden öğrenilen model bileşenlerini ifade eder. Parametre sayısının daha az olması nedeniyle Llama 1, incelikli anlamları kavramakta zaman zaman zorlanıyor ve tutarsız yanıtlar veriyordu.
Llama 1'den kısa süre sonra Meta, Temmuz 2023'te Llama 2'yi piyasaya sürdü. Model, 2 trilyon token üzerinde eğitildi. Token, modelde işleme için temel veri birimi olarak kullanılan sözcük veya sözcük parçası gibi bir metin bölümünü ifade eder. Modelde ayrıca daha uzun metinleri anlayabilmek için bağlam penceresinin 4096 tokene çıkarılması ve hataları azaltmak için 1 milyondan fazla insan açıklamasından yararlanılması gibi iyileştirmeler de vardı. Bu iyileştirmelere rağmen Llama 2 hâlâ çok fazla işlem gücüne ihtiyaç duyuyordu; Meta, Llama 3 ile bu sorunu çözmeyi amaçladı.
Meta'nın Llama 3 modeliyle tanış#
Llama 3, toplamda 15 trilyon token üzerinde eğitilmiş dört sürümle geliyor. Eğitim verilerinin %5'inden fazlası (yaklaşık 800 milyon token), 30 farklı dildeki verilerden oluşuyordu. Llama 3'ün tüm sürümleri çeşitli tüketici donanımlarında çalıştırılabiliyor ve 8 bin tokenlık bağlam uzunluğuna sahip.
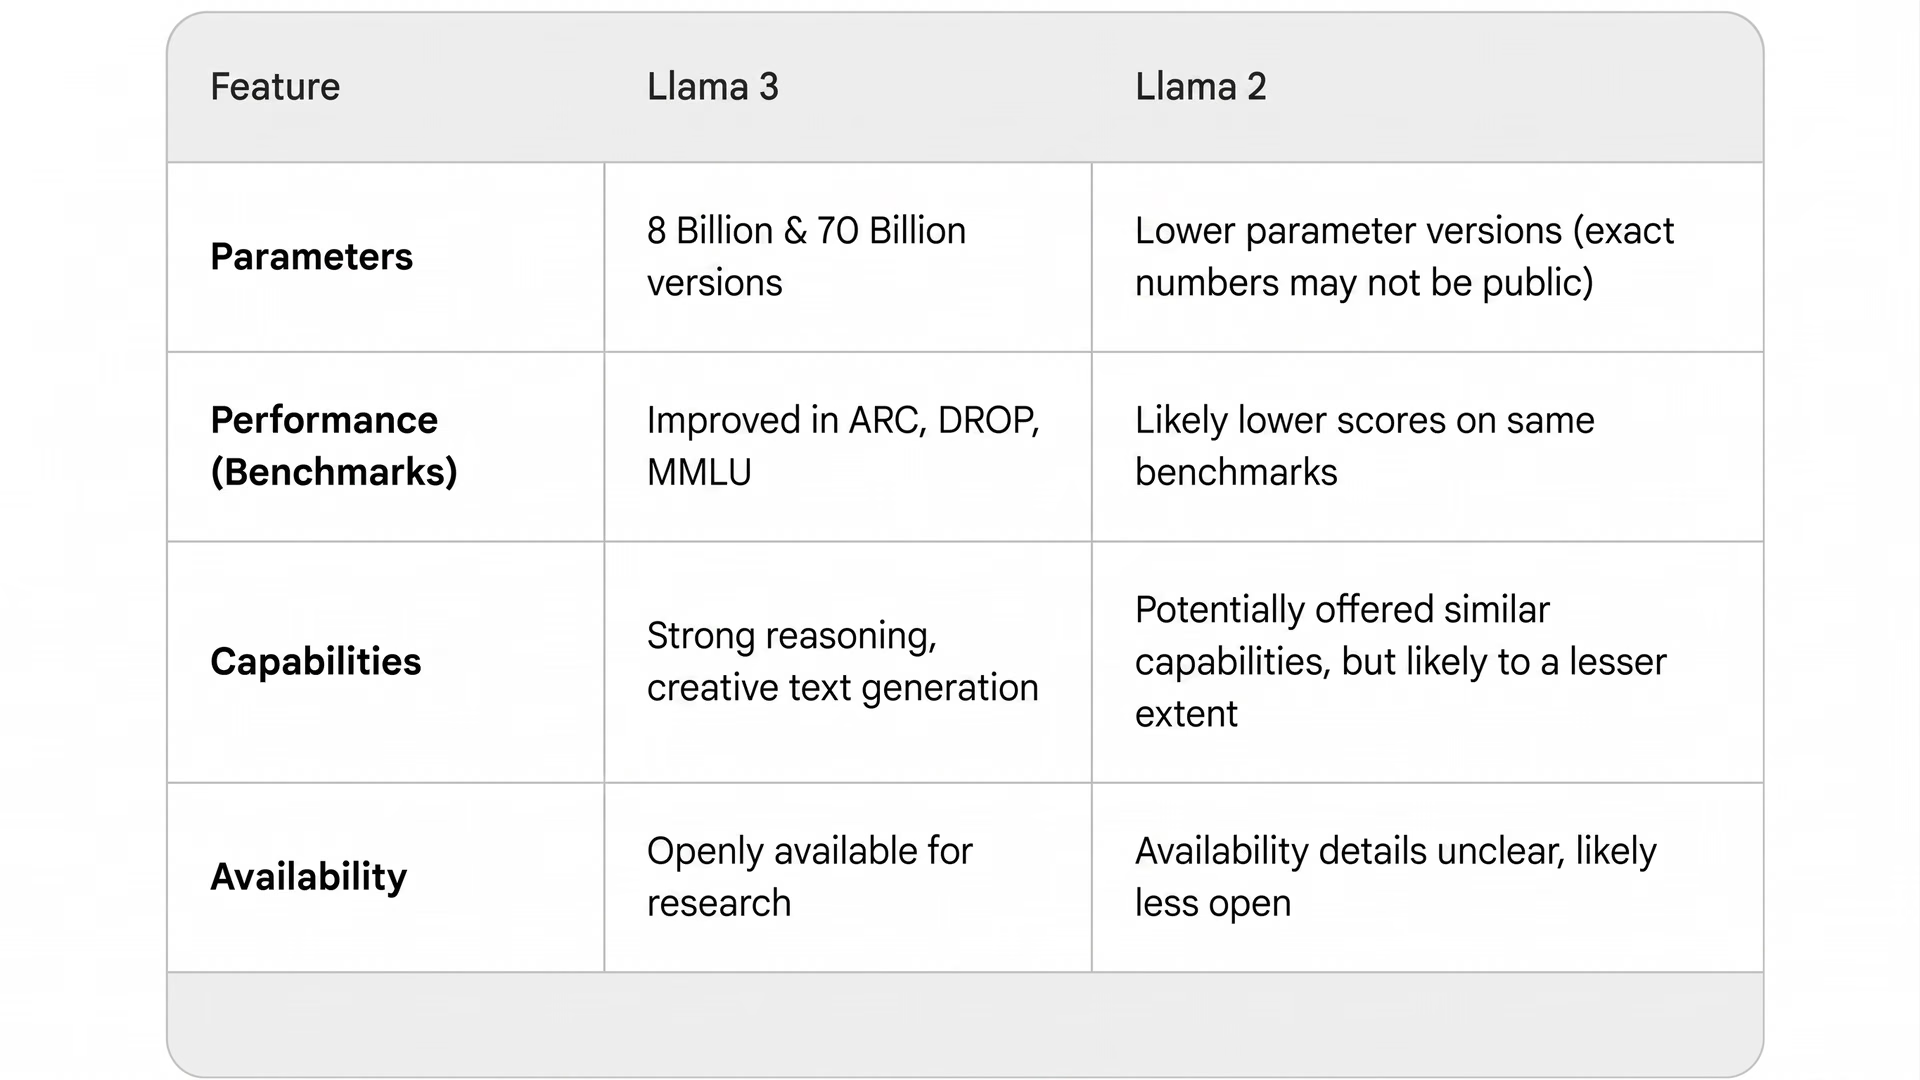
Şekil 1. Llama 3 ve Llama 2 karşılaştırması.
Modelin iki boyutu bulunuyor: sırasıyla 8 milyar ve 70 milyar parametreyi ifade eden 8B ve 70B. Ayrıca temel ve talimat izleyen olmak üzere iki sürüm de var. "Temel", standart ön eğitimli sürümü ifade eder. "Talimat izleyen" ise ilgili verilerle ek eğitim yapılarak belirli uygulamalar veya alanlar için optimize edilmiş, ince ayarlı bir sürümdür.
Llama 3 modelinin sürümleri şunlardır:
- Meta-Llama-3-8b: Temel 8B modeli, temel yapay zeka yetenekleri sunar ve müşteri hizmetleri sohbet robotları geliştirmek gibi genel görevler için idealdir.
- Meta-Llama-3-8b-instruct: Belirli görevler için optimize edilmiş, 8B modelinin talimat izleme odaklı ince ayarlı sürümüdür. Örneğin karmaşık konuları açıklayan eğitim araçları oluşturmak için kullanılabilir.
- Meta-Llama-3-70b: Temel 70B modeli, yüksek performanslı yapay zeka uygulamaları için tasarlanmıştır. Bu model, ilaç keşfi için kapsamlı biyomedikal literatürü işlemek gibi uygulamalarda iyi sonuç verir.
- Meta-Llama-3-70b-instruct: Bu sürüm, doğruluğun kritik olduğu hukuki veya tıbbi belgeleri analiz etmek gibi yüksek hassasiyet gerektiren uygulamalar için 70B modelinin ince ayarlanmış hâlidir.
Meta'nın Llama 3 model mimarisi#
Diğer Meta AI gelişmelerinde olduğu gibi, Llama 3 geliştirilirken veri bütünlüğünü korumak ve önyargıları en aza indirmek için sıkı kalite kontrol önlemleri uygulandı. Böylece sorumlu bir şekilde oluşturulmuş güçlü bir model ortaya çıktı.
Llama 3 model mimarisi, doğal dil işleme görevlerinde verimlilik ve performansa odaklanmasıyla öne çıkar. Transformer tabanlı bir çerçeve üzerine kurulan model, özellikle metin oluşturma sırasında hesaplama verimliliğine önem verir ve yalnızca kod çözücüden oluşan bir mimari kullanır.
Model, girdileri kodlayan bir kodlayıcı olmadan yalnızca önceki bağlama dayanarak çıktılar üretir; bu da onu çok daha hızlı hâle getirir.
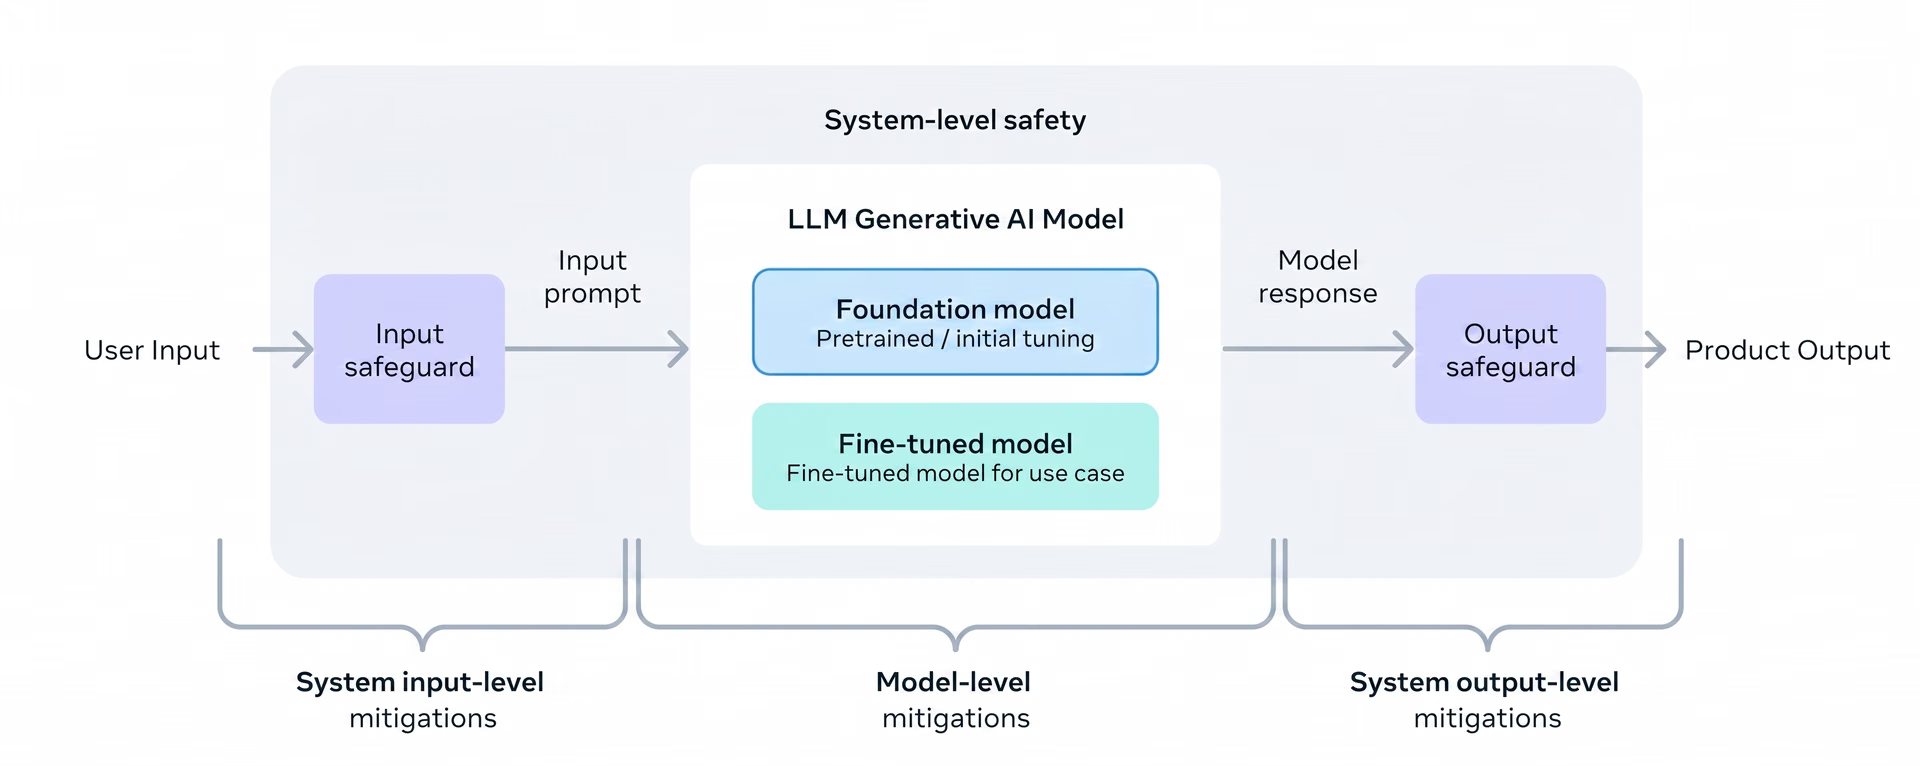
Şekil 2. Llama 3'ün sorumlu model mimarisi.
Llama 3 modellerinde 128 bin tokenlık söz varlığına sahip bir tokenizer bulunur. Daha geniş bir söz varlığı, modellerin metni daha iyi anlamasını ve işlemesini sağlar. Ayrıca modeller artık çıkarım verimliliğini artırmak için gruplandırılmış sorgu dikkatini (GQA) kullanıyor. GQA'yı, modellerin daha hızlı ve doğru yanıtlar üretmek için girdi verilerinin ilgili bölümlerine odaklanmasına yardımcı olan bir spot ışığı gibi düşünebilirsin.
Llama 3'ün model mimarisiyle ilgili birkaç ilginç ayrıntı daha:
- Belge Sınırlarına Duyarlı İşleme: Llama 3, özetleme gibi görevler için önemli olan belge sınırları boyunca tutarlılığı korur.
- Gelişmiş Kod Anlama: Llama 3'ün eğitim verilerinde dört kat daha fazla kod örneği bulunur; bu da kodlama becerilerini geliştirir.
- Sağlam Kalite Kontrolü: Sezgisel filtreler ve uygunsuz içeriklerin kaldırılması dahil olmak üzere sıkı önlemler, veri bütünlüğünü sağlar ve önyargıları en aza indirir.
Llama 3, model eğitimine yaklaşımımızı dönüştürüyor#
En büyük Llama 3 modellerini eğitmek için üç paralelleştirme türü bir arada kullanıldı: veri paralelleştirme, model paralelleştirme ve işlem hattı paralelleştirmesi.
Veri paralelleştirme, eğitim verilerini birden fazla GPU'ya dağıtırken model paralelleştirme, her GPU'nun işlem gücünden yararlanmak için model mimarisini bölümlere ayırır. İşlem hattı paralelleştirmesi ise hesaplama ve iletişimi optimize etmek için eğitim sürecini sıralı aşamalara böler.
En verimli uygulama, aynı anda 16.000 GPU üzerinde eğitim yapılırken GPU başına 400 TFLOPS'u aşarak dikkat çekici bir hesaplama kullanımı sağladı. Bu eğitim çalışmaları, her biri 24.000 GPU'dan oluşan özel olarak tasarlanmış iki GPU kümesinde yürütüldü. Bu kapsamlı hesaplama altyapısı, büyük ölçekli Llama 3 modellerini verimli bir şekilde eğitmek için gereken gücü sağladı.
GPU'ların çalışma süresini en üst düzeye çıkarmak için hata tespitini, hata yönetimini ve bakımı otomatikleştiren gelişmiş, yeni bir eğitim yığını geliştirildi. Sessiz veri bozulması riskini azaltmak için donanım güvenilirliği ve tespit mekanizmaları önemli ölçüde iyileştirildi. Ayrıca kontrol noktası oluşturma ve geri alma maliyetlerini azaltmak için yeni ölçeklenebilir depolama sistemleri geliştirildi.
Bu iyileştirmeler, genel eğitim sürecinin %95'ten fazla verimlilikle tamamlanmasını sağladı. Bir araya geldiklerinde Llama 3'ün eğitim verimliliğini Llama 2'ye kıyasla yaklaşık üç kat artırdılar. Bu verimlilik yalnızca etkileyici olmakla kalmıyor; yapay zeka eğitim yöntemleri için yeni olanaklar da sunuyor.
Llama 3 ile yeni kapılar açılıyor#
Llama 3 açık kaynaklı olduğundan araştırmacılar ve öğrenciler kodunu inceleyebilir, deneyler yapabilir, etik kaygılar ve önyargılar hakkında tartışmalara katılabilir. Ancak Llama 3 yalnızca akademik çevrelere yönelik değil. Pratik uygulamalarda da ses getiriyor. Meta AI Sohbet Arayüzü'nün temelini oluşturmaya başladı ve Facebook, Instagram, WhatsApp ve Messenger gibi platformlarla sorunsuzca bütünleşiyor. Meta AI sayesinde kullanıcılar doğal dilde sohbet edebilir, kişiselleştirilmiş öneriler alabilir, görevlerini yerine getirebilir ve başkalarıyla kolayca bağlantı kurabilir.
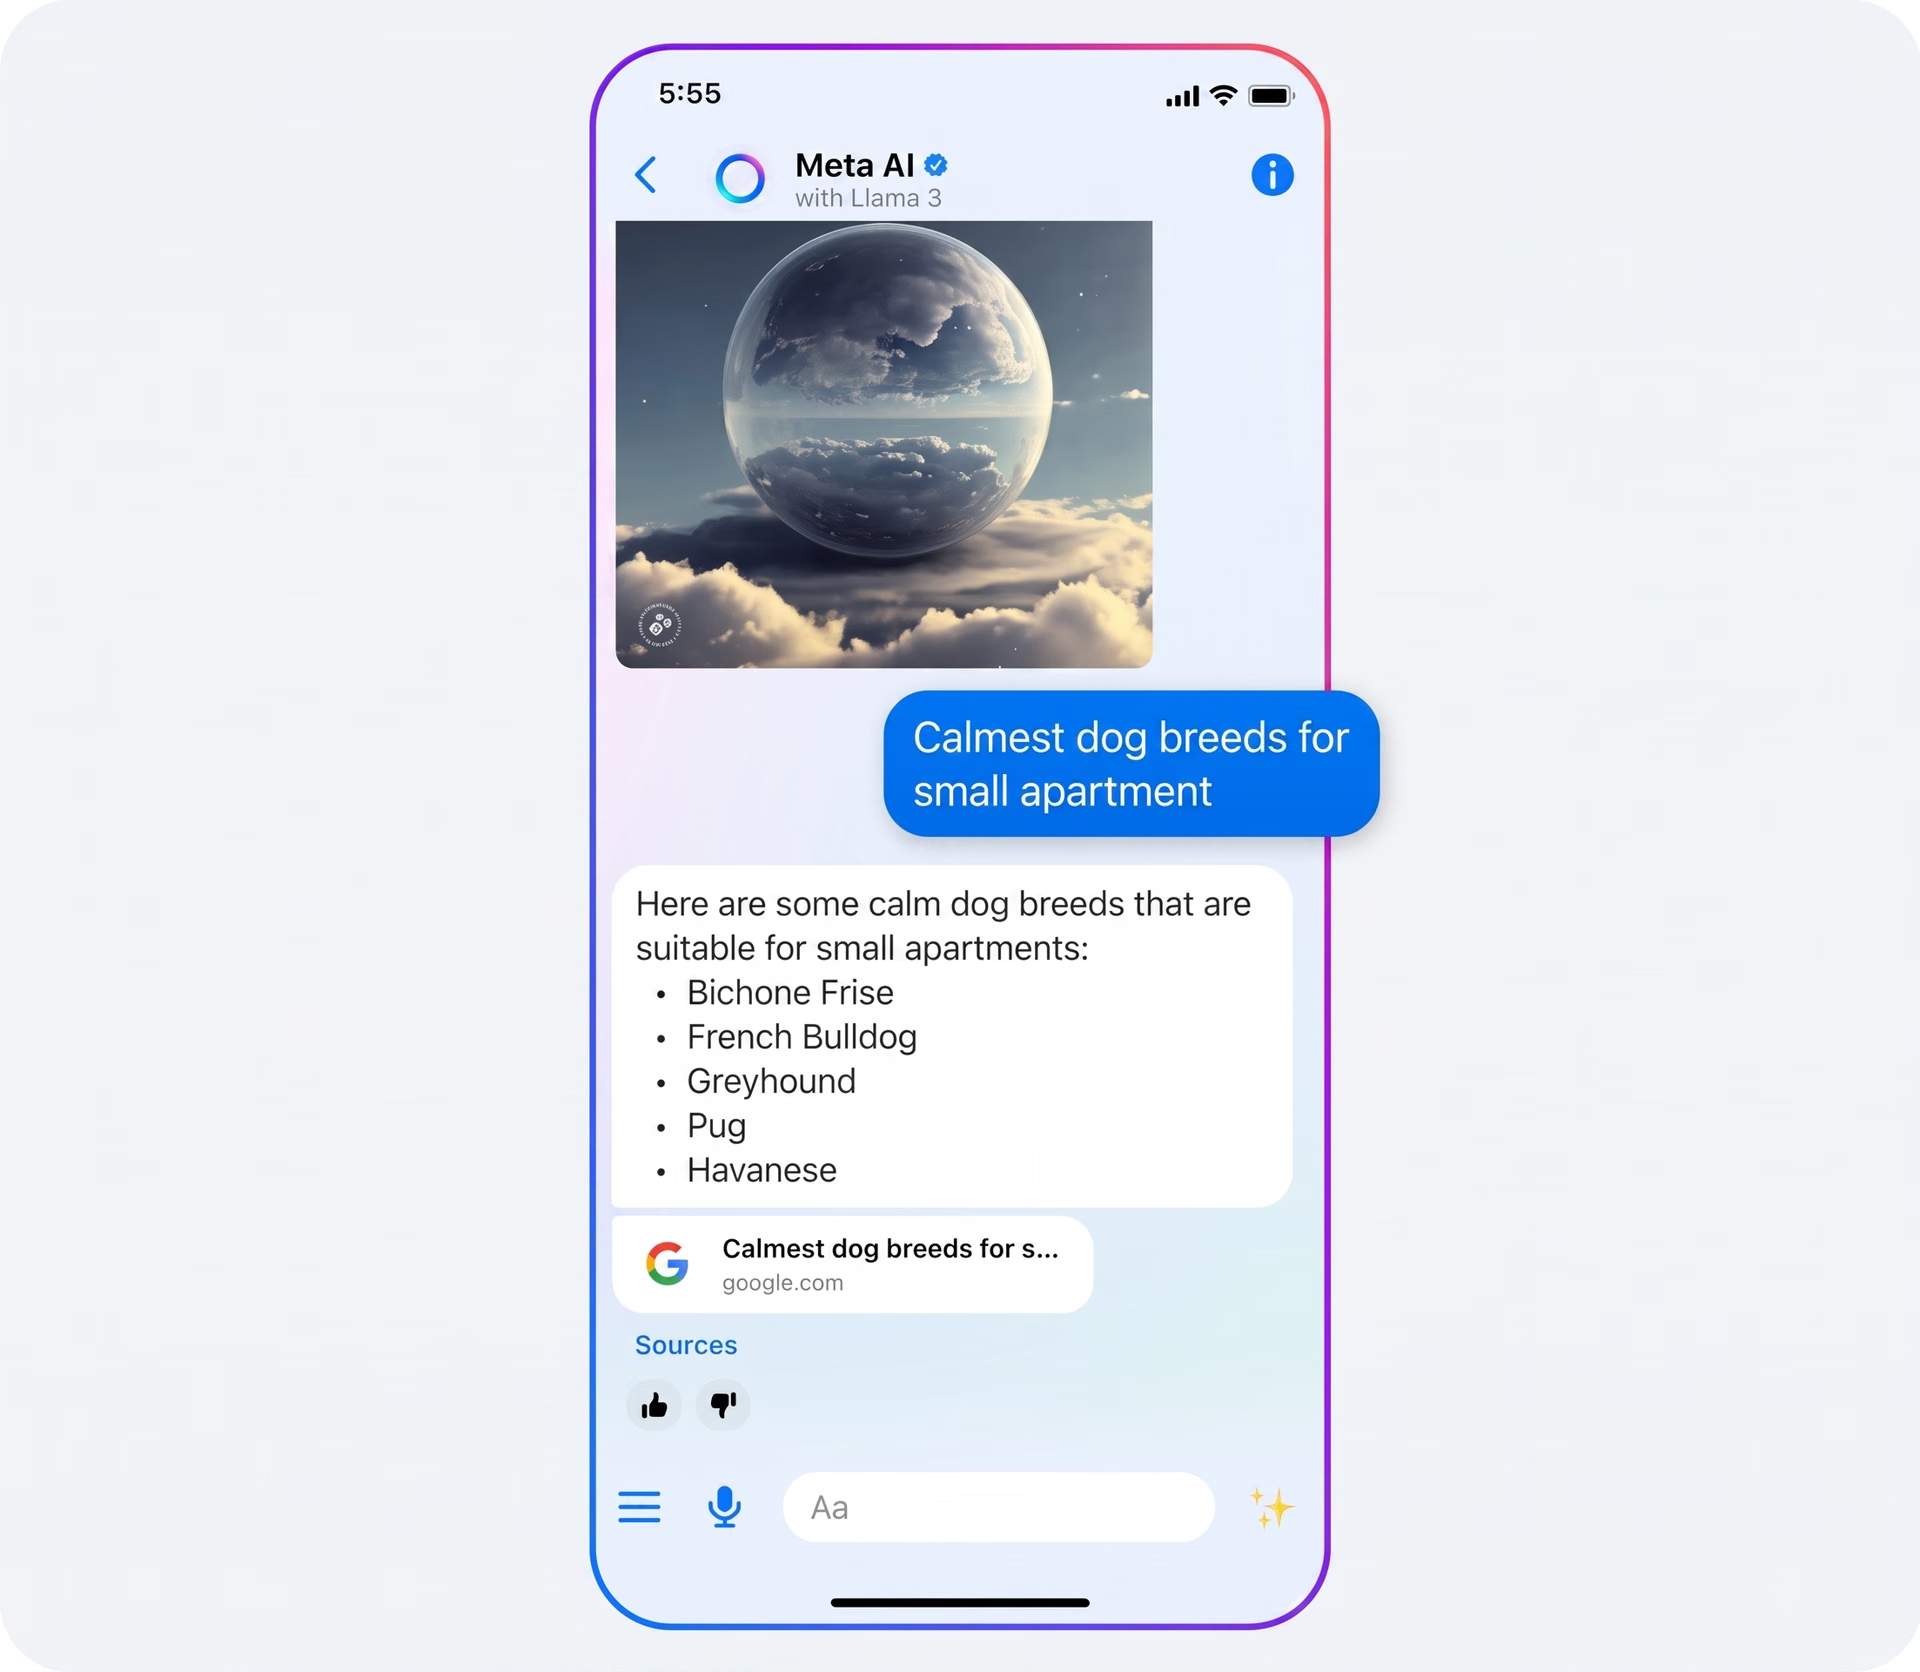
Şekil 3. Meta AI: Llama 3 destekli.
Llama 3'ün diğer LLM'lerle karşılaştırması#
Llama 3, karmaşık dil anlama ve akıl yürütme becerilerini değerlendiren birçok önemli kıyaslama testinde olağanüstü performans gösteriyor. Llama 3'ün yeteneklerinin çeşitli yönlerini sınayan kıyaslama testlerinden bazıları şunlardır:
- Çoklu Görevlerde Kapsamlı Dil Anlama (MMLU) - Çeşitli alanlardaki bilgisini ölçer.
- Genel Amaçlı Soru Yanıtlama (GPQA) - Modelin çok çeşitli genel kültür sorularına tutarlı ve doğru yanıtlar üretme becerisini değerlendirir.
- HumanEval - Kodlama ve problem çözme görevlerine odaklanır; modelin işlevsel programlama kodu üretme ve algoritmik zorlukları çözme becerisini sınar.
Llama 3'ün bu testlerdeki olağanüstü sonuçları, onu Google'ın Gemma 7B, Mistral'ın Mistral 7B ve Anthropic'in Claude 3 Sonnet gibi rakiplerinden açıkça ayırıyor. Yayımlanmış istatistiklere göre Llama 3, özellikle 70B modeli, yukarıdaki kıyaslama testlerinin tümünde bu modellerden daha iyi performans gösteriyor.
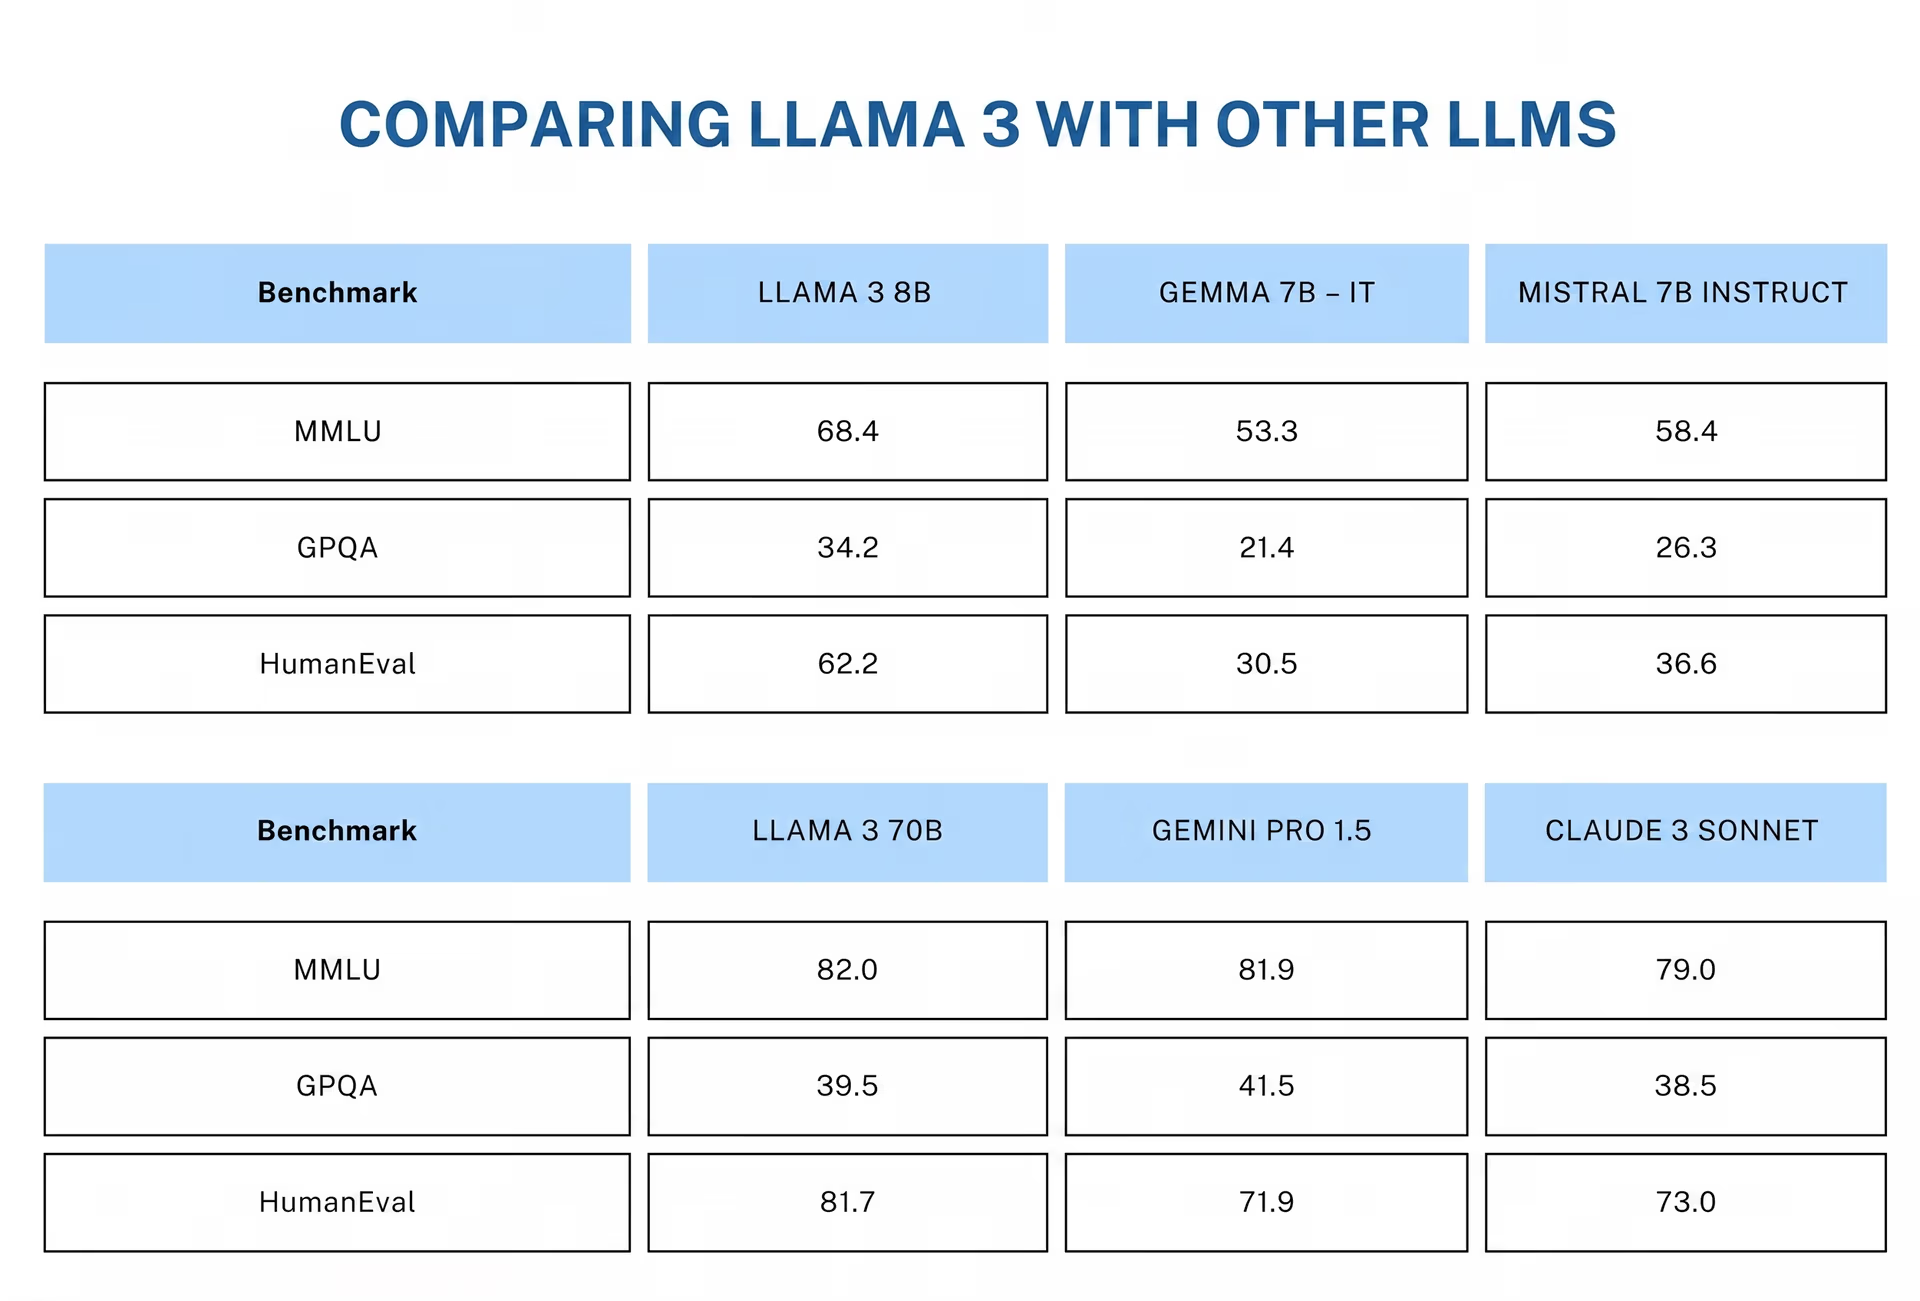
Şekil 4. Llama 3'ün diğer LLM'lerle karşılaştırması.
Meta Llama 3 geniş ölçekte erişime açılıyor#
Meta, Llama 3'ü hem genel kullanıcıların hem de geliştiricilerin kullanabileceği çeşitli platformlarda sunarak erişimini genişletiyor. Günlük kullanıcılar için Llama 3; WhatsApp, Instagram, Facebook ve Messenger gibi Meta'nın popüler platformlarına entegre ediliyor. Kullanıcılar gerçek zamanlı arama ve doğrudan bu uygulamalarda yaratıcı içerik oluşturma gibi gelişmiş özelliklere erişebiliyor.
Llama 3, etkileşimli deneyimler sunmak için Ray-Ban Meta akıllı gözlükleri ve Meta Quest VR başlığı gibi giyilebilir teknolojilere de ekleniyor.
Llama 3; AWS, Databricks, Google Cloud, Hugging Face, Kaggle, IBM WatsonX, Microsoft Azure, NVIDIA NIM ve Snowflake dahil olmak üzere çeşitli platformlarda geliştiricilerin kullanımına sunuluyor. Bu modellere doğrudan Meta üzerinden de erişebilirsin. Geniş seçenek yelpazesi, geliştiricilerin ister doğrudan Meta'yla ister diğer popüler platformlar üzerinden çalışmayı tercih etsin, bu gelişmiş yapay zeka modeli yeteneklerini projelerine kolayca entegre etmelerini sağlıyor.
Özet#
Makine öğrenmesindeki gelişmeler, her gün teknolojiyle etkileşim kurma biçimimizi dönüştürmeye devam ediyor. Meta'nın Llama 3'ü, LLM'lerin artık yalnızca metin üretmekten ibaret olmadığını gösteriyor. LLM'ler karmaşık sorunları ele alıyor ve birden fazla dili işliyor. Genel olarak Llama 3, yapay zekayı her zamankinden daha uyarlanabilir ve erişilebilir hâle getiriyor. Geleceğe baktığımızda, Llama 3 için planlanan yükseltmeler birden fazla modeli yönetme ve daha geniş bağlamları anlama gibi daha fazla yetenek vadediyor.
Yapay zeka hakkında daha fazla bilgi edinmek için GitHub depomuza göz at ve topluluğumuza katıl. Yapay zekanın üretim ve tarım gibi alanlarda nasıl kullanıldığını görmek için çözüm sayfalarımızı ziyaret et.









