Conoce mejor Llama 3 de Meta
Descubre Llama 3 de Meta, el LLM de pesos abiertos publicado en abril de 2024: sus variantes de 8B y 70B, su arquitectura, su entrenamiento a gran escala y los resultados de los benchmarks.
 Abirami Vina9 min de lectura
Al hacer balance de las innovaciones en inteligencia artificial (AI) del primer trimestre de 2024, vimos que distintas organizaciones publicaban modelos de lenguaje grandes (LLM) por todas partes. En esa misma línea, el 18 de abril de 2024, Meta publicó Llama 3, un LLM de código abierto de última generación y vanguardia.
Puede que pienses: Es solo otro LLM. ¿Por qué entusiasma tanto a la comunidad de IA?
Aunque puedes ajustar modelos como GPT-3 o Gemini para obtener respuestas personalizadas, estos no ofrecen total transparencia sobre su funcionamiento interno, como los datos de entrenamiento, los parámetros del modelo o los algoritmos. En cambio, Llama 3 de Meta es más transparente, ya que su arquitectura y sus pesos están disponibles para descargar. Para la comunidad de IA, esto supone una mayor libertad para experimentar.
En este artículo, veremos qué puede hacer Llama 3, cómo surgió y qué impacto tiene en el campo de la AI.
La evolución de los modelos Llama de Meta#
Antes de profundizar en Llama 3, repasemos sus versiones anteriores.
Meta lanzó Llama 1 en febrero de 2023, con cuatro variantes cuyos parámetros iban de 7.000 a 65.000 millones. En aprendizaje automático, los «parámetros» son los elementos del modelo que se aprenden a partir de los datos de entrenamiento. Debido a su menor número de parámetros, Llama 1 a veces tenía dificultades para captar matices y daba respuestas incoherentes.
Poco después de Llama 1, Meta lanzó Llama 2 en julio de 2023. Se entrenó con 2 billones de tokens. Un token representa un fragmento de texto, como una palabra o parte de una palabra, que se utiliza como unidad básica de datos para procesarlos en el modelo. El modelo también incorporó mejoras, como una ventana de contexto duplicada de 4096 tokens para comprender pasajes más largos y más de 1 millón de anotaciones humanas para reducir los errores. A pesar de estas mejoras, Llama 2 seguía necesitando mucha potencia de cálculo, algo que Meta pretendía solucionar con Llama 3.
Presentamos Llama 3 de Meta#
Llama 3 cuenta con cuatro variantes entrenadas con la asombrosa cifra de 15 billones de tokens. Más del 5 % de esos datos de entrenamiento eran datos de alta calidad en idiomas distintos del inglés, que abarcaban más de 30 idiomas. Todas las variantes de Llama 3 pueden ejecutarse en distintos tipos de hardware de consumo y tienen una ventana de contexto de 8 000 tokens.
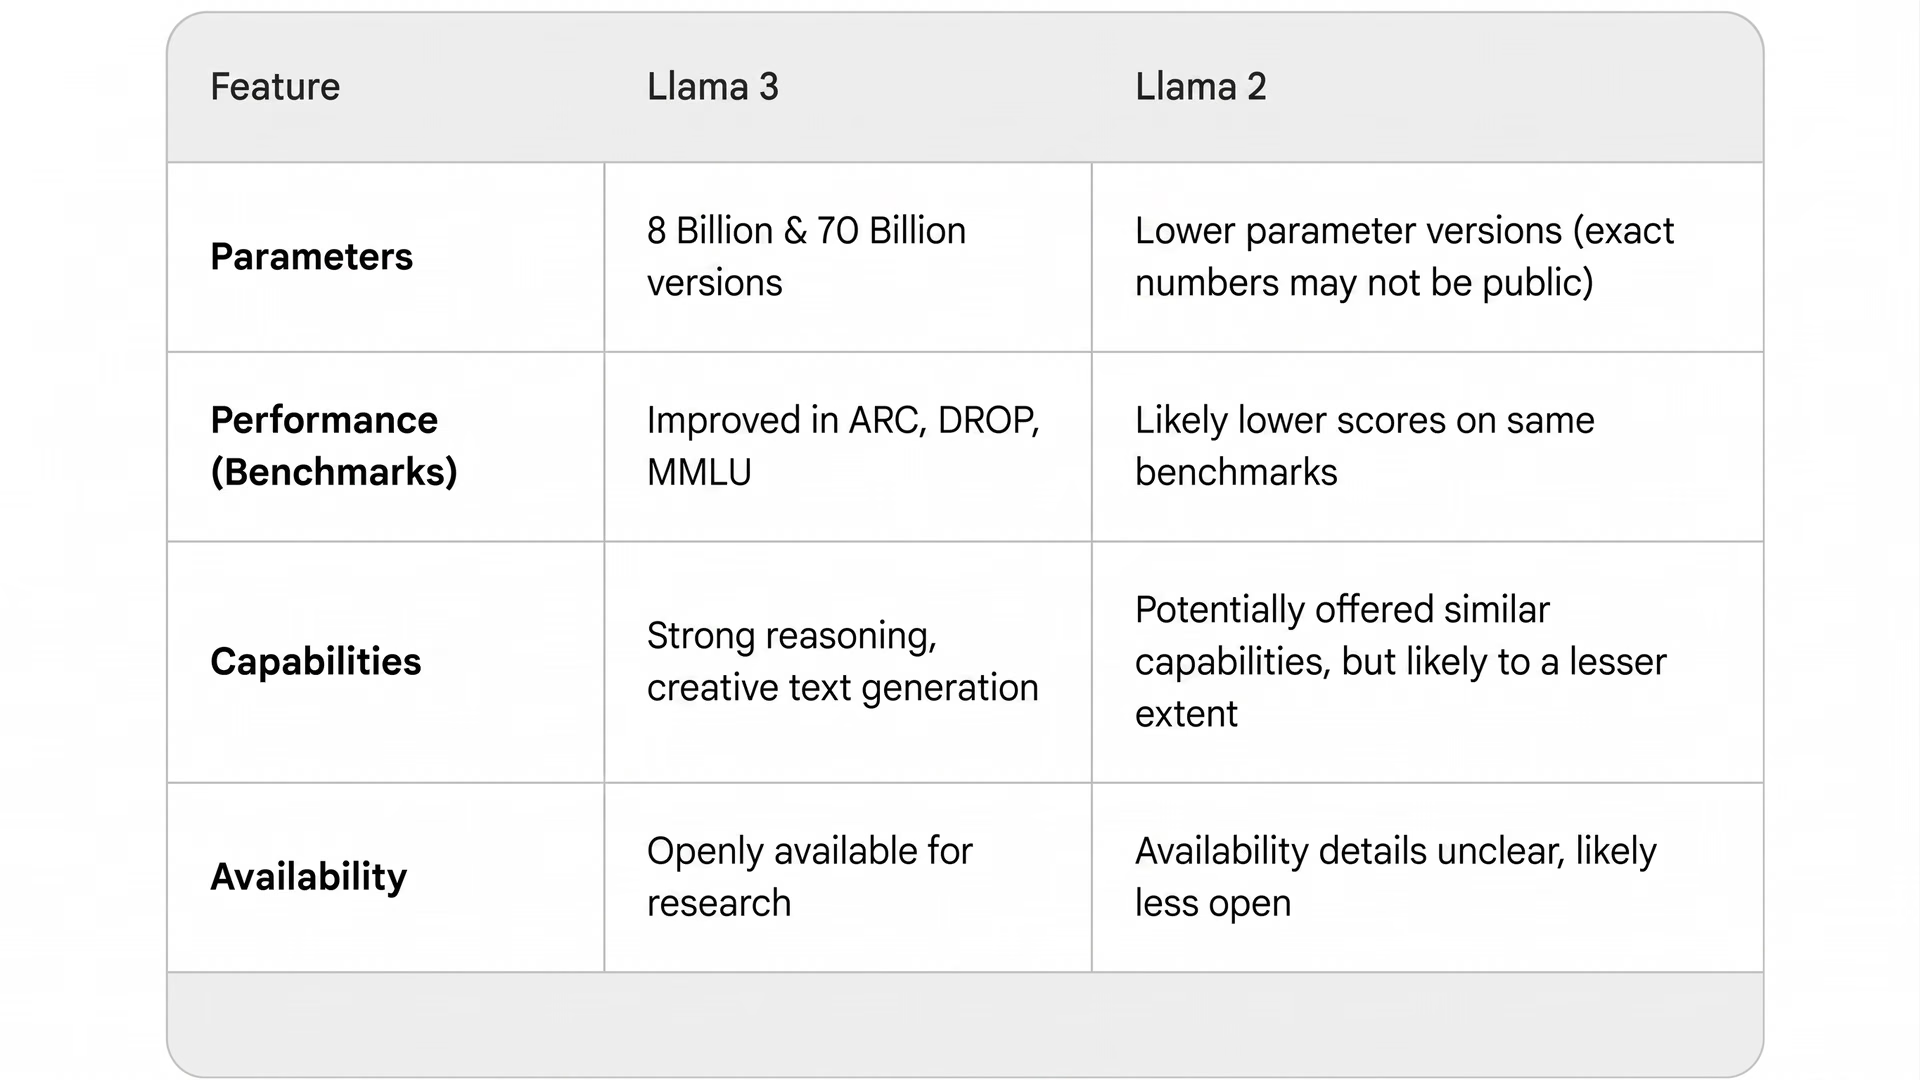
Fig. 1. Llama 3 frente a Llama 2.
Las variantes del modelo están disponibles en dos tamaños: 8B y 70B, que indican 8 000 millones y 70 000 millones de parámetros, respectivamente. También hay dos versiones: base e instruct. «Base» se refiere a la versión estándar preentrenada. «Instruct» es una versión ajustada para seguir instrucciones y optimizada para casos de uso conversacionales.
Estas son las variantes del modelo Llama 3:
- Meta-Llama-3-8b: el modelo base 8B ofrece capacidades fundamentales de IA y es ideal para tareas generales, como desarrollar chatbots de atención al cliente.
- Meta-Llama-3-8b-instruct: una versión instruct del modelo 8B, ajustada y optimizada para tareas específicas. Por ejemplo, puede utilizarse para crear herramientas educativas que expliquen temas complejos.
- Meta-Llama-3-70b: el modelo base 70B está diseñado para aplicaciones de IA de alto rendimiento. Este modelo sería adecuado para aplicaciones como procesar abundante literatura biomédica para el descubrimiento de fármacos.
- Meta-Llama-3-70b-instruct: Esta versión se ajusta a partir del modelo 70B para aplicaciones que requieren una gran precisión, como el análisis de documentos legales o médicos.
Arquitectura del modelo Llama 3 de Meta#
Como ocurre con cualquier otro avance de Meta en IA, durante el desarrollo de Llama 3 se aplicaron rigurosas medidas de control de calidad para mantener la integridad de los datos y minimizar los sesgos. Así, el resultado es un modelo potente creado de forma responsable.
La arquitectura del modelo Llama 3 destaca por su enfoque en la eficiencia y el rendimiento en tareas de procesamiento del lenguaje natural. Está basada en una estructura Transformer y prioriza la eficiencia computacional, sobre todo al generar texto, mediante una arquitectura que solo utiliza un decodificador.
El modelo genera resultados basándose únicamente en el contexto anterior, sin un codificador independiente, lo que permite generar texto de forma eficiente.
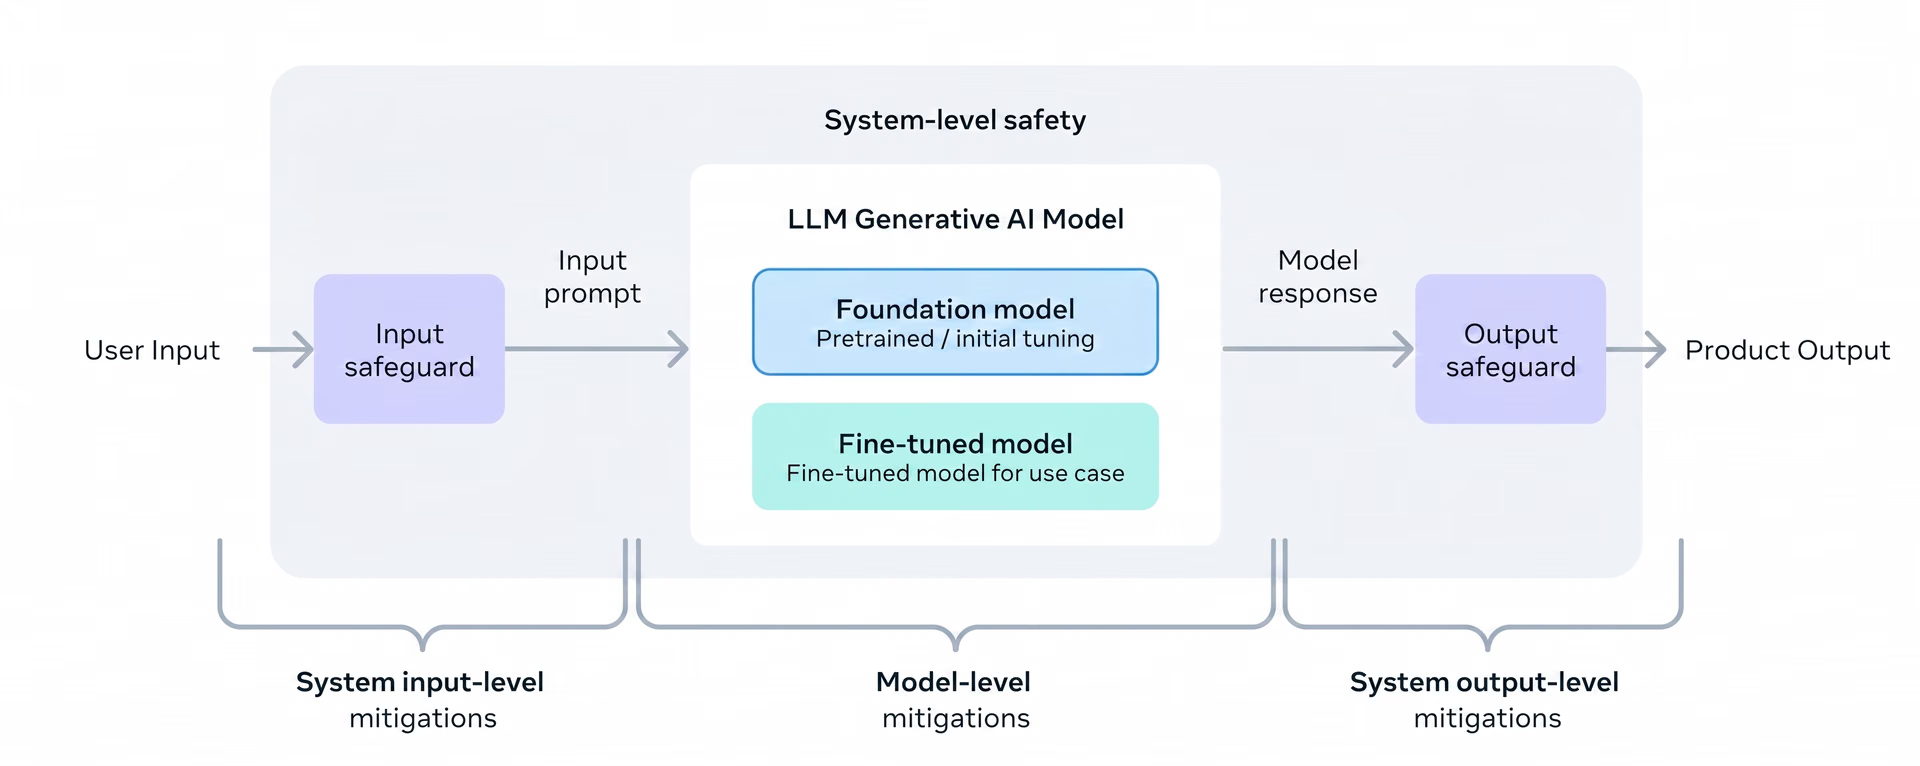
Fig. 2. Arquitectura responsable de Llama 3.
Los modelos Llama 3 incluyen un tokenizador con un vocabulario de 128K tokens. Un vocabulario más amplio permite que los modelos comprendan y procesen mejor el texto. Además, ahora utilizan la atención de consultas agrupadas (GQA) para mejorar la eficiencia de la inferencia. GQA permite que grupos de cabezas de atención compartan las mismas claves y valores, lo que reduce el uso de memoria y acelera la generación de texto con una pequeña pérdida de calidad.
Estos son algunos detalles más interesantes sobre la arquitectura del modelo Llama 3:
- Procesamiento de documentos consciente de los límites: Llama 3 mantiene la claridad entre los límites de los documentos, algo fundamental para tareas como la síntesis.
- Mejor comprensión del código: los datos de entrenamiento de Llama 3 incluyen cuatro veces más muestras de código, lo que potencia sus capacidades de programación.
- Control de calidad sólido: medidas rigurosas, como filtros heurísticos y la eliminación de contenido NSFW, garantizan la integridad de los datos y minimizan los sesgos.
Llama 3 está transformando nuestro enfoque del entrenamiento de modelos#
Para entrenar los modelos Llama 3 más grandes, se combinaron tres tipos de paralelización: de datos, de modelos y de canalización.
La paralelización de datos distribuye los datos de entrenamiento entre varias GPU, mientras que la paralelización de modelos divide la arquitectura del modelo para aprovechar la potencia de cálculo de cada GPU. La paralelización de canalización divide el proceso de entrenamiento en etapas secuenciales y optimiza el cálculo y la comunicación.
La implementación más eficiente logró una alta utilización de la capacidad de cálculo y superó los 400 TFLOPS por GPU durante el entrenamiento simultáneo con 16 000 GPU. Estas sesiones de entrenamiento se llevaron a cabo en dos clústeres de GPU diseñados a medida, cada uno formado por 24 000 GPU. Esta considerable infraestructura de cálculo aportó la potencia necesaria para entrenar eficientemente los modelos Llama 3 a gran escala.
Para maximizar el tiempo de actividad de las GPU, se desarrolló una nueva pila de entrenamiento avanzada que automatiza la detección y gestión de errores, así como el mantenimiento. Se mejoraron considerablemente la fiabilidad del hardware y los mecanismos de detección para mitigar los riesgos de corrupción silenciosa de datos. También se desarrollaron nuevos sistemas de almacenamiento escalables para reducir los costes de creación de puntos de control y reversión.
Estas mejoras permitieron alcanzar un tiempo de entrenamiento efectivo superior al 95 %. En conjunto, aumentaron aproximadamente tres veces la eficiencia del entrenamiento de Llama 3 respecto a Llama 2. Esta eficiencia abre nuevas posibilidades para los métodos de entrenamiento de AI.
Nuevas posibilidades con Llama 3#
Como Llama 3 es de código abierto, investigadores y estudiantes pueden estudiar su código, realizar experimentos y debatir sobre cuestiones éticas y sesgos. Sin embargo, Llama 3 no está pensado únicamente para el ámbito académico. También se utiliza en aplicaciones prácticas. Se está convirtiendo en la base de la interfaz de chat de Meta AI y está integrado en plataformas como Facebook, Instagram, WhatsApp y Messenger. Con Meta AI, los usuarios pueden mantener conversaciones en lenguaje natural, acceder a recomendaciones personalizadas, realizar tareas y conectar con otras personas fácilmente.
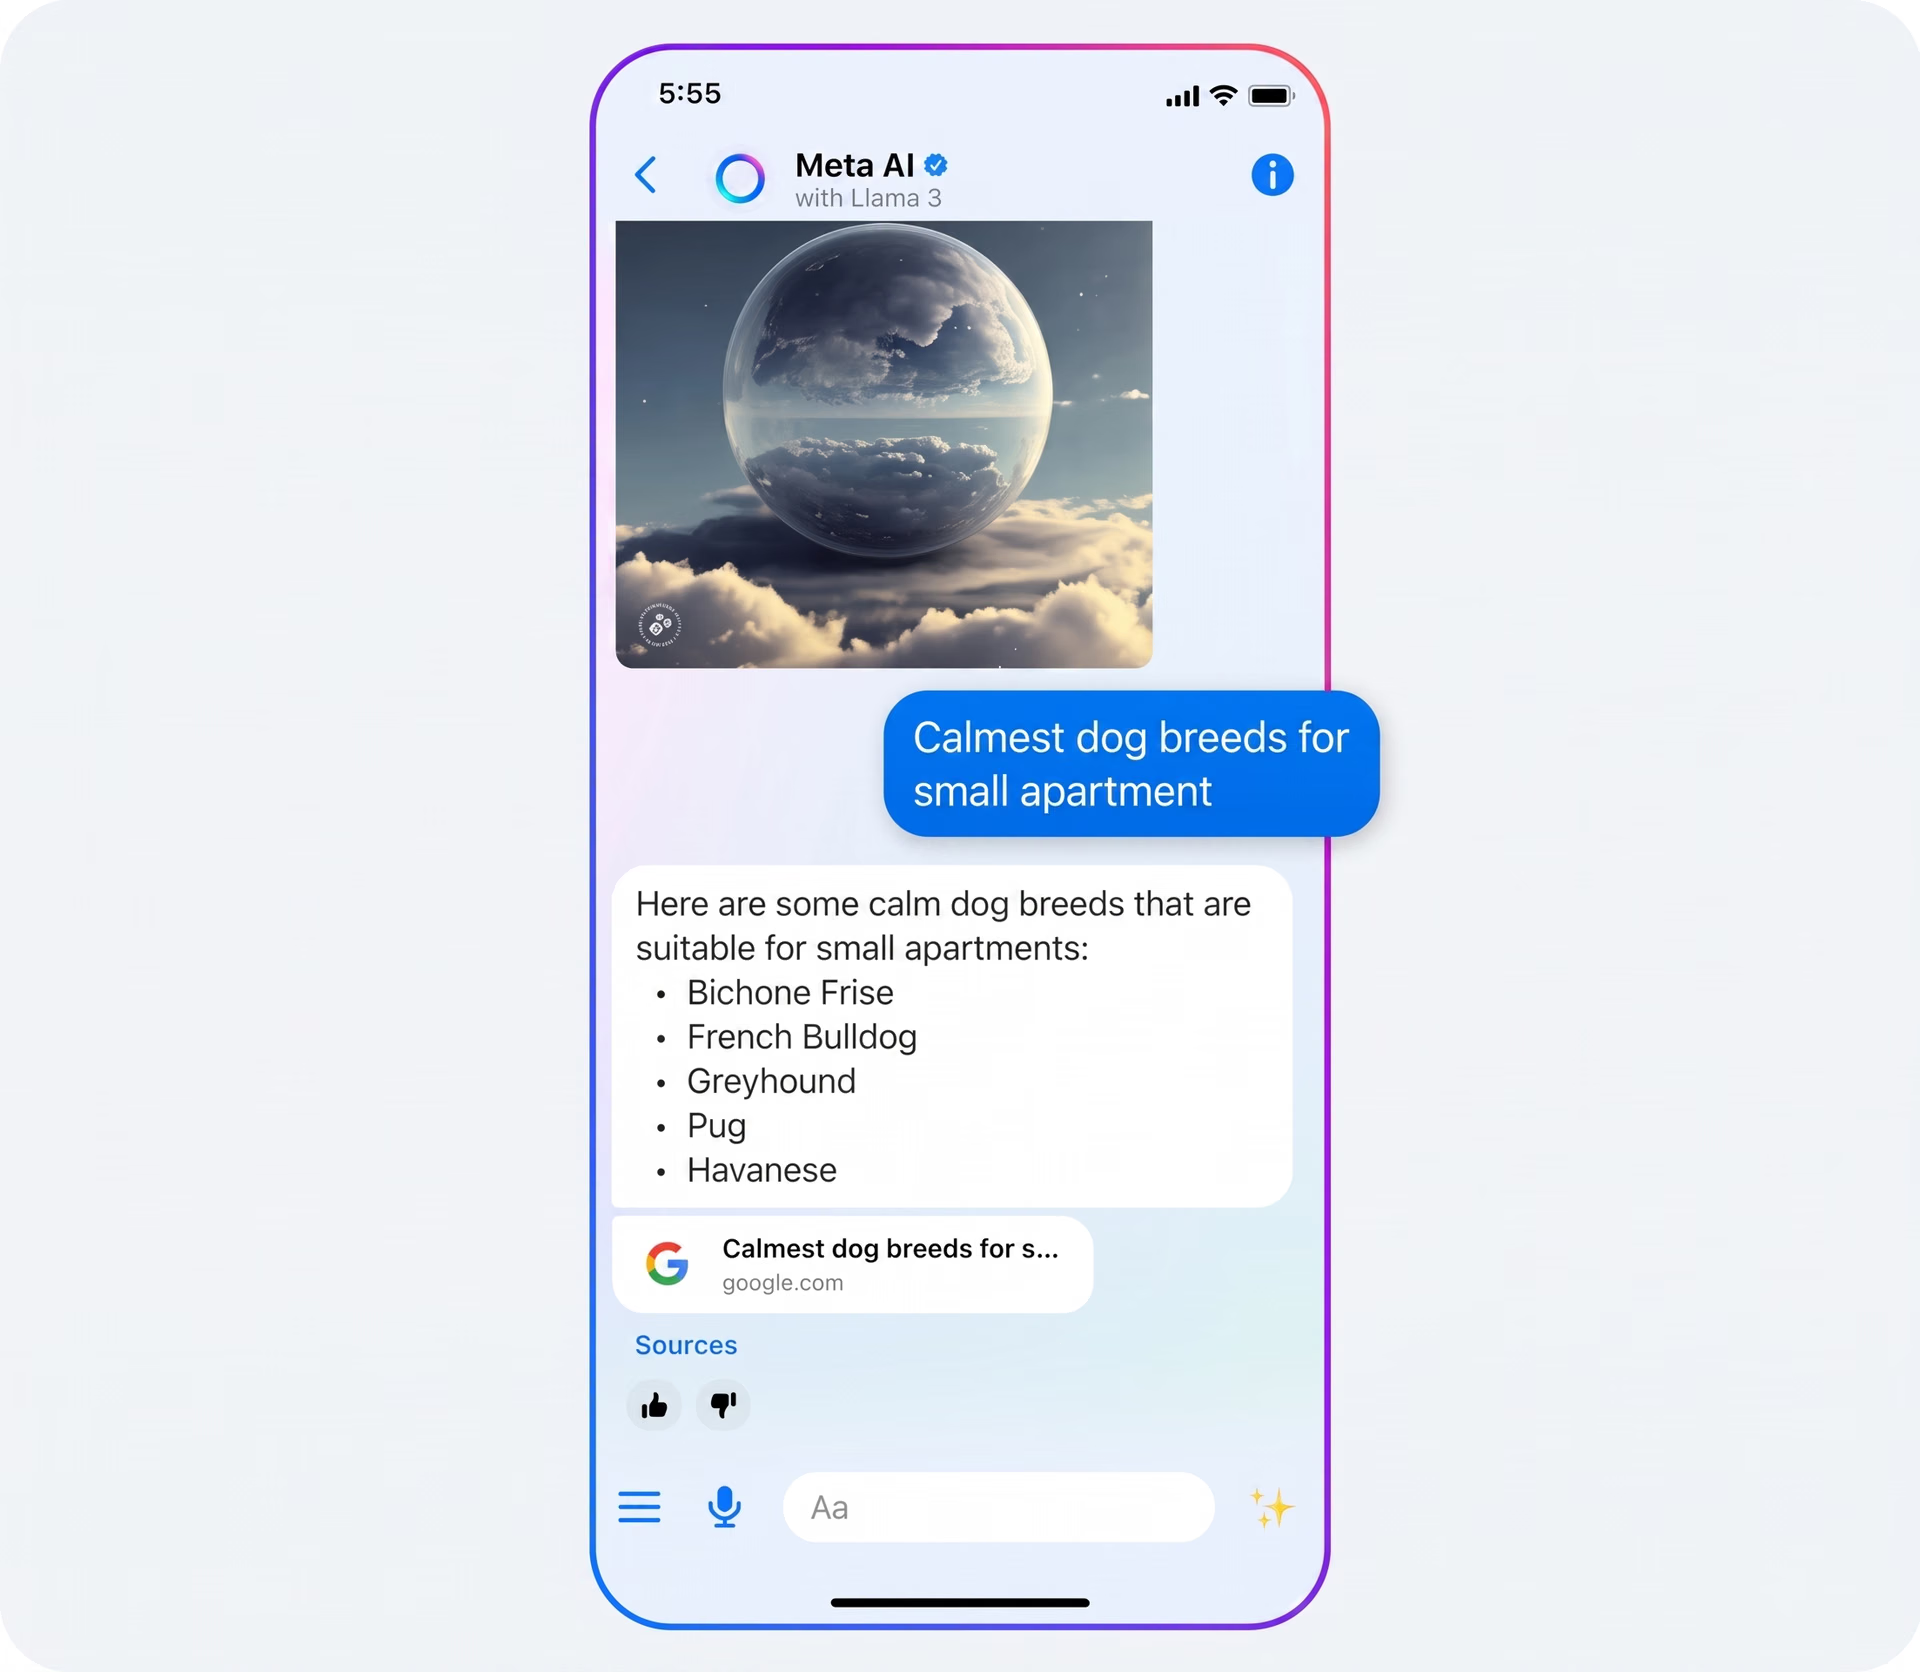
Fig. 3. Meta AI: con tecnología de Llama 3.
Comparación de Llama 3 con otros LLM#
Llama 3 obtiene buenos resultados en varios parámetros de referencia clave que evalúan la comprensión del lenguaje complejo y la capacidad de razonamiento. Estos son algunos de los parámetros que ponen a prueba distintos aspectos de las capacidades de Llama 3:
- Comprensión masiva del lenguaje multitarea (MMLU): mide sus conocimientos en distintos ámbitos.
- Preguntas y respuestas de nivel de posgrado a prueba de Google (GPQA): evalúa la capacidad del modelo para responder preguntas complejas de nivel de posgrado sobre biología, física y química.
- HumanEval: se centra en tareas de programación y resolución de problemas, y evalúa la capacidad del modelo para generar código funcional y resolver retos algorítmicos.
Los buenos resultados de Llama 3 en estas pruebas lo distinguen claramente de competidores como Gemma 7B de Google, Mistral 7B de Mistral y Claude 3 Sonnet de Anthropic. Según las estadísticas publicadas, Llama 3, en particular el modelo 70B, supera a estos modelos en todos los parámetros de referencia mencionados.
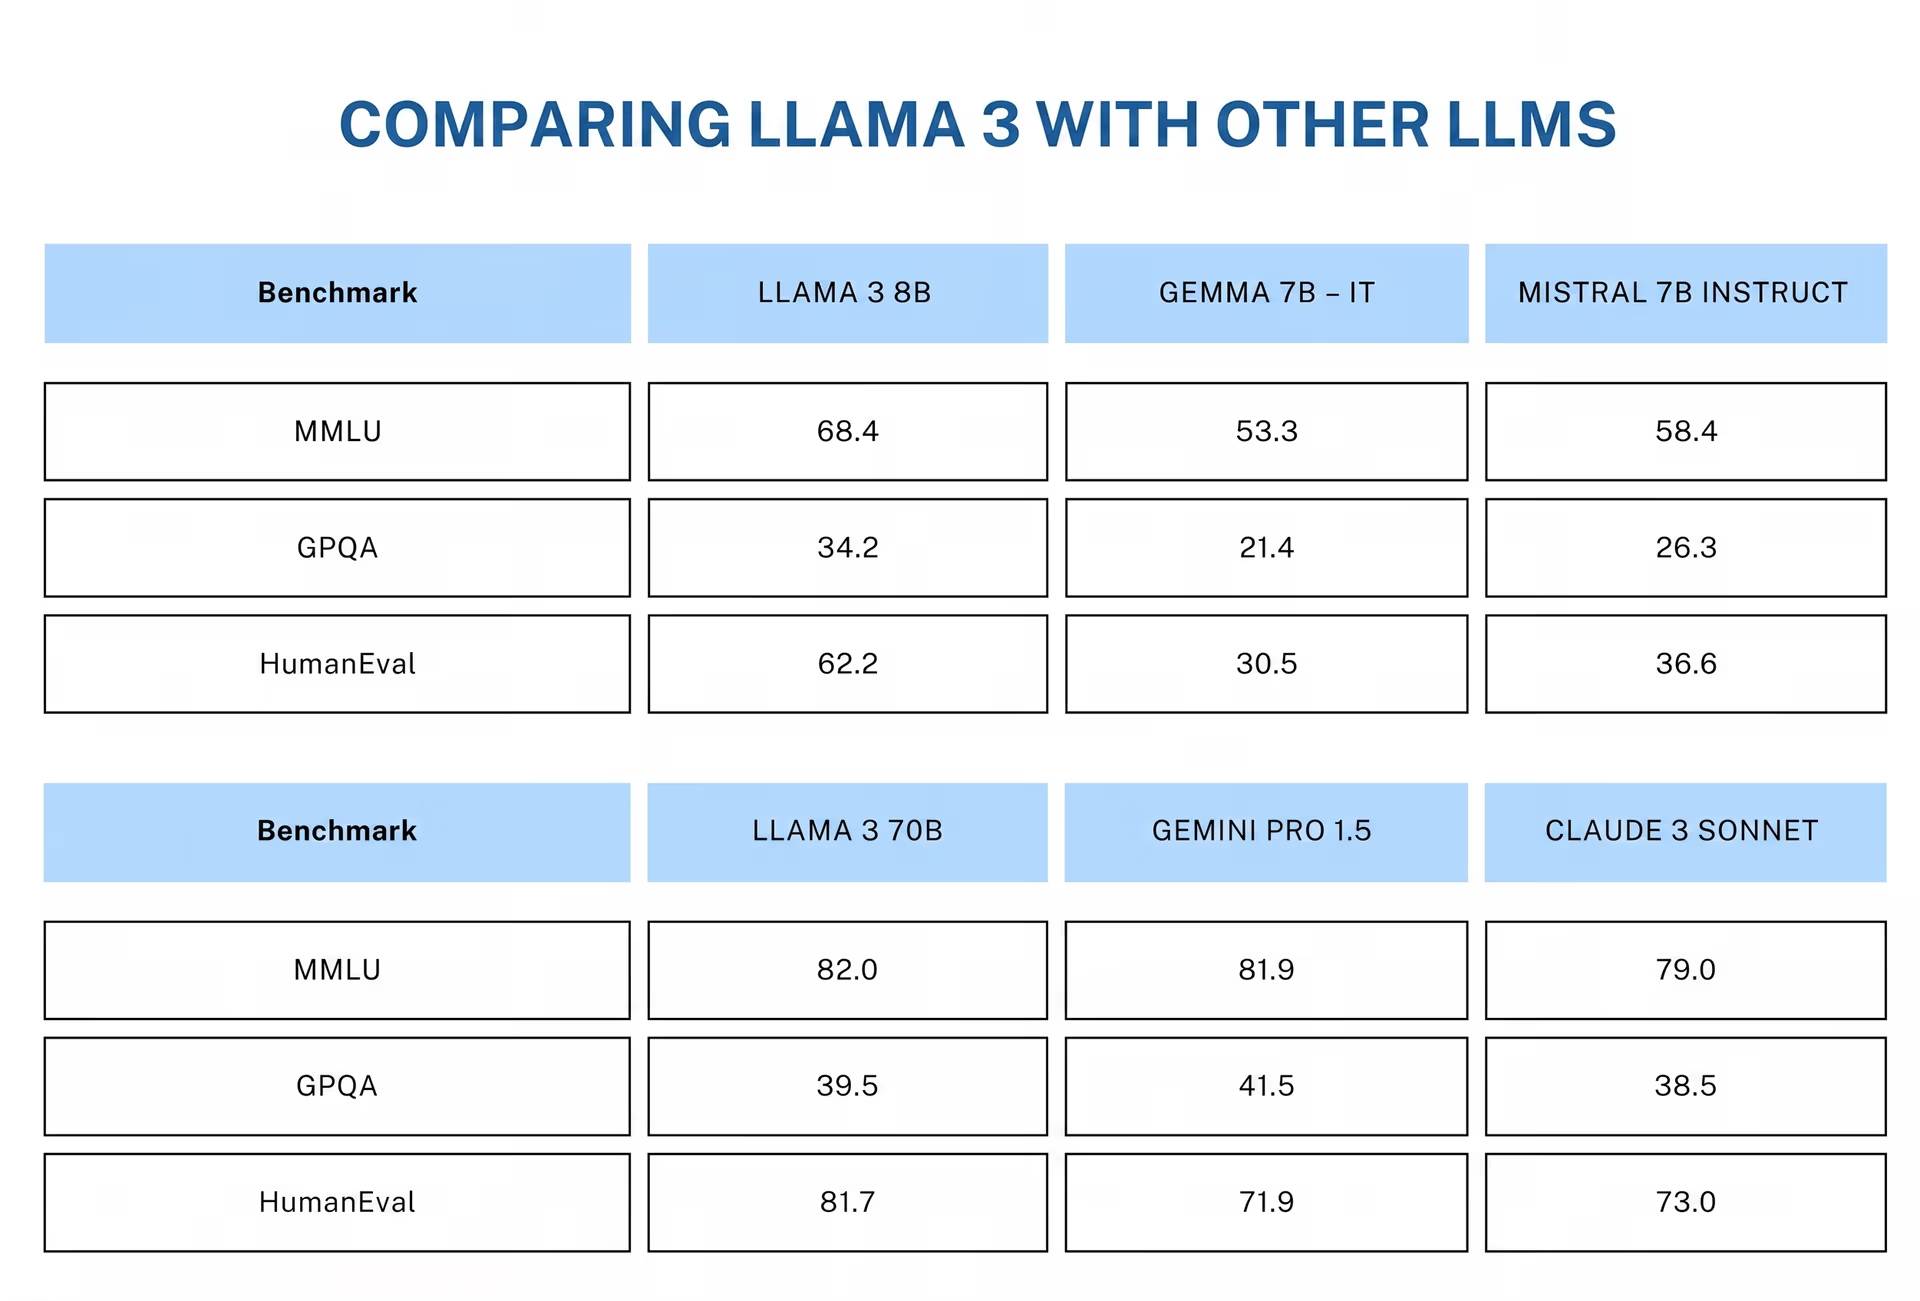
Fig. 4. Comparación de Llama 3 con otros LLM.
Meta está poniendo Llama 3 al alcance de todos#
Meta está ampliando el alcance de Llama 3 y ofreciéndolo en varias plataformas tanto para usuarios generales como para desarrolladores. Para el día a día, Llama 3 está integrado en plataformas populares de Meta, como WhatsApp, Instagram, Facebook y Messenger. Los usuarios pueden acceder a funciones avanzadas, como la búsqueda en tiempo real y la generación de contenido creativo, directamente desde estas aplicaciones.
Llama 3 también se está incorporando a tecnologías ponibles, como las gafas inteligentes Ray-Ban Meta y el casco de realidad virtual Meta Quest, para ofrecer experiencias interactivas.
Llama 3 está disponible para desarrolladores en varias plataformas, como AWS, Databricks, Google Cloud, Hugging Face, Kaggle, IBM WatsonX, Microsoft Azure, NVIDIA NIM y Snowflake. También puedes acceder a estos modelos directamente desde Meta. Esta amplia variedad de opciones facilita que los desarrolladores integren las capacidades avanzadas de estos modelos de IA en sus proyectos, tanto si prefieren trabajar directamente con Meta como si optan por otras plataformas populares.
Conclusión#
Los avances en aprendizaje automático siguen transformando nuestra forma de interactuar con la tecnología en el día a día. Llama 3 de Meta demuestra que los LLM ya no se limitan a generar texto. Los LLM abordan problemas complejos y procesan varios idiomas. En general, Llama 3 está haciendo que la IA sea más adaptable y accesible que nunca. De cara al futuro, las mejoras previstas para Llama 3 prometen aún más capacidades, como la multimodalidad y ventanas de contexto más largas.
Echa un vistazo a nuestro repositorio de GitHub y únete a nuestra comunidad para aprender más sobre IA. Visita nuestras páginas de soluciones para descubrir cómo se aplica la IA en sectores como la fabricación y la agricultura.
Escrito por
Creador de contenido · Ultralytics
Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.









