Ultralytics YOLO11 mithilfe der PaddlePaddle-Integration exportieren
Erfahre, wie du Ultralytics YOLO-Modelle wie Ultralytics YOLO11 mit PaddlePaddle exportierst, um sie effizient auf Edge-, Mobil- und Cloud-Plattformen bereitzustellen.
Mit den Fortschritten der künstlichen Intelligenz (KI) lernen Maschinen immer besser, ihre Umgebung zu verstehen. Ein wichtiger Bereich, der diese Entwicklung vorantreibt, ist Computer Vision, ein Teilgebiet der KI, das Maschinen ermöglicht, visuelle Daten zu interpretieren und darauf basierend Entscheidungen zu treffen.
Ob Autos Verkehrszeichen erkennen oder Regale im Einzelhandel kontrollieren – Computer Vision steckt mittlerweile in vielen alltäglichen Anwendungen. Diese Aufgaben übernehmen Computer-Vision-Modelle, die Fotos oder Videos schnell auswerten und Wichtiges erkennen können.
Im Laufe der Zeit sind diese Modelle schneller und genauer geworden und finden in Bereichen wie Landwirtschaft, Gesundheitswesen, Sicherheit und Einzelhandel Verwendung. Ultralytics YOLO11 ist beispielsweise ein Modell, das eine Vielzahl von Computer-Vision-Aufgaben schnell und präzise bewältigt. Es kann Objekte erkennen und klassifizieren, Bewegungen verfolgen und Körperhaltungen schätzen.
Ein entscheidender Schritt, um Computer Vision aus der Forschung in die Praxis zu bringen, ist die Bereitstellung. Sobald ein Modell trainiert ist, besteht der nächste Schritt darin, es auf Geräten wie Smartphones, Edge-Geräten oder Cloud-Servern auszuführen.
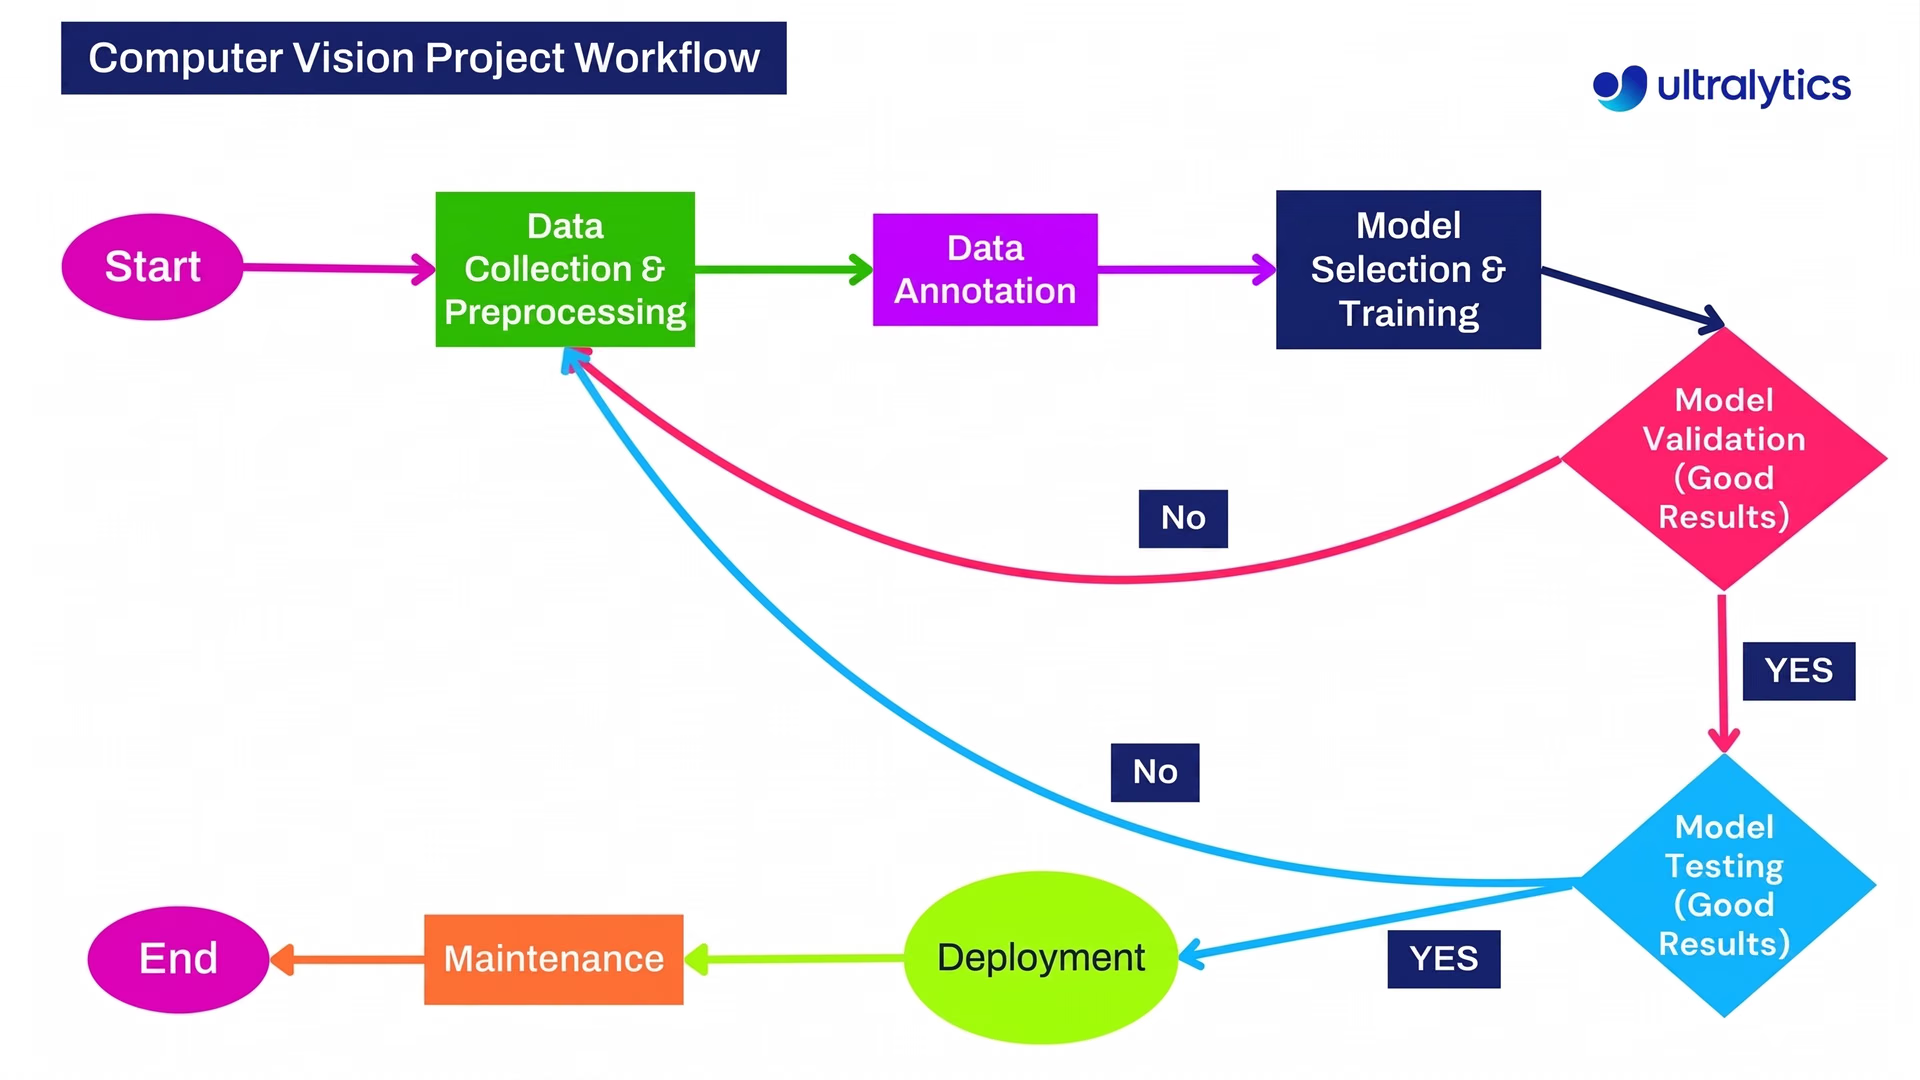
Abb. 1. Die Bereitstellung eines Modells ist ein wichtiger Bestandteil jedes Computer-Vision-Projekts.
Dafür lassen sich Ultralytics YOLO-Modelle wie YOLO11 je nach Zielplattform in verschiedene Formate exportieren. Eines davon ist PaddlePaddle, ein quelloffenes KI-Framework, das eine effiziente Bereitstellung und Inferenz von Modellen auf einer Vielzahl von Geräten und Systemen ermöglicht.
In diesem Artikel zeigen wir, wie sich Ultralytics YOLO11 mithilfe der von Ultralytics unterstützten PaddlePaddle-Integration exportieren lässt, um eine effiziente Bereitstellung auf verschiedenen Plattformen zu ermöglichen.
Was ist PaddlePaddle?#
Die Bereitstellung von KI-Modellen außerhalb der Forschung, etwa auf Mobilgeräten oder Edge-Hardware, kann manchmal schwierig sein – besonders, wenn die Modelle effizient laufen und nur wenige Ressourcen benötigen sollen. PaddlePaddle ist ein Deep-Learning-Framework, das genau dabei helfen soll.
PaddlePaddle ist eine quelloffene chinesische Plattform. Der Name steht für Parallel Distributed Deep Learning. Entwickelt wurde sie von Baidu, einem Unternehmen, das für seine Arbeit im Bereich KI und Softwareinfrastruktur bekannt ist. PaddlePaddle wurde speziell für praktische Anwendungen und nicht nur für die Forschung geschaffen.
Entwickler können Modelle im PaddlePaddle-Format auf Servern, Edge-Geräten und sogar Mobilgeräten ausführen. Die Plattform unterstützt außerdem Werkzeuge, die die KI-Entwicklung vereinfachen, darunter Optionen mit wenig oder ganz ohne Programmierung. Sie verfügt über eine starke Entwickler-Community mit mehr als 4,7 Millionen Nutzern und wird in zahlreichen Branchen eingesetzt, darunter im Gesundheitswesen, in der Landwirtschaft, der Fertigung und im Finanzwesen.
Wichtige Funktionen von PaddlePaddle#
Hier sind einige wichtige Funktionen, mit denen PaddlePaddle Modelle effizienter auf Geräten in der Praxis ausführt:
- Umwandlung dynamischer in statische Graphen: Diese Funktion wandelt ein flexibles Modell in eine feste Version um, die reibungsloser und vorhersehbarer läuft. Ein festes Modell lässt sich leichter optimieren und erstellt Vorhersagen schneller.
- Operatorfusion: PaddlePaddle kann mehrere Schritte eines Modells zu einem zusammenfassen. Dadurch benötigt das Modell weniger Speicher und läuft schneller. Stell es dir so vor, als würdest du mehrere Aufgaben zu einem einzigen Schritt zusammenfassen, um Zeit zu sparen.
- Quantisierung: Dabei wird das Modell verkleinert, indem einfachere Zahlen verwendet werden (zum Beispiel durch Runden auf weniger Dezimalstellen). So kann das Modell auch auf Geräten mit begrenzter Rechenleistung, etwa Smartphones oder intelligenten Kameras, laufen, ohne viel Genauigkeit einzubüßen.
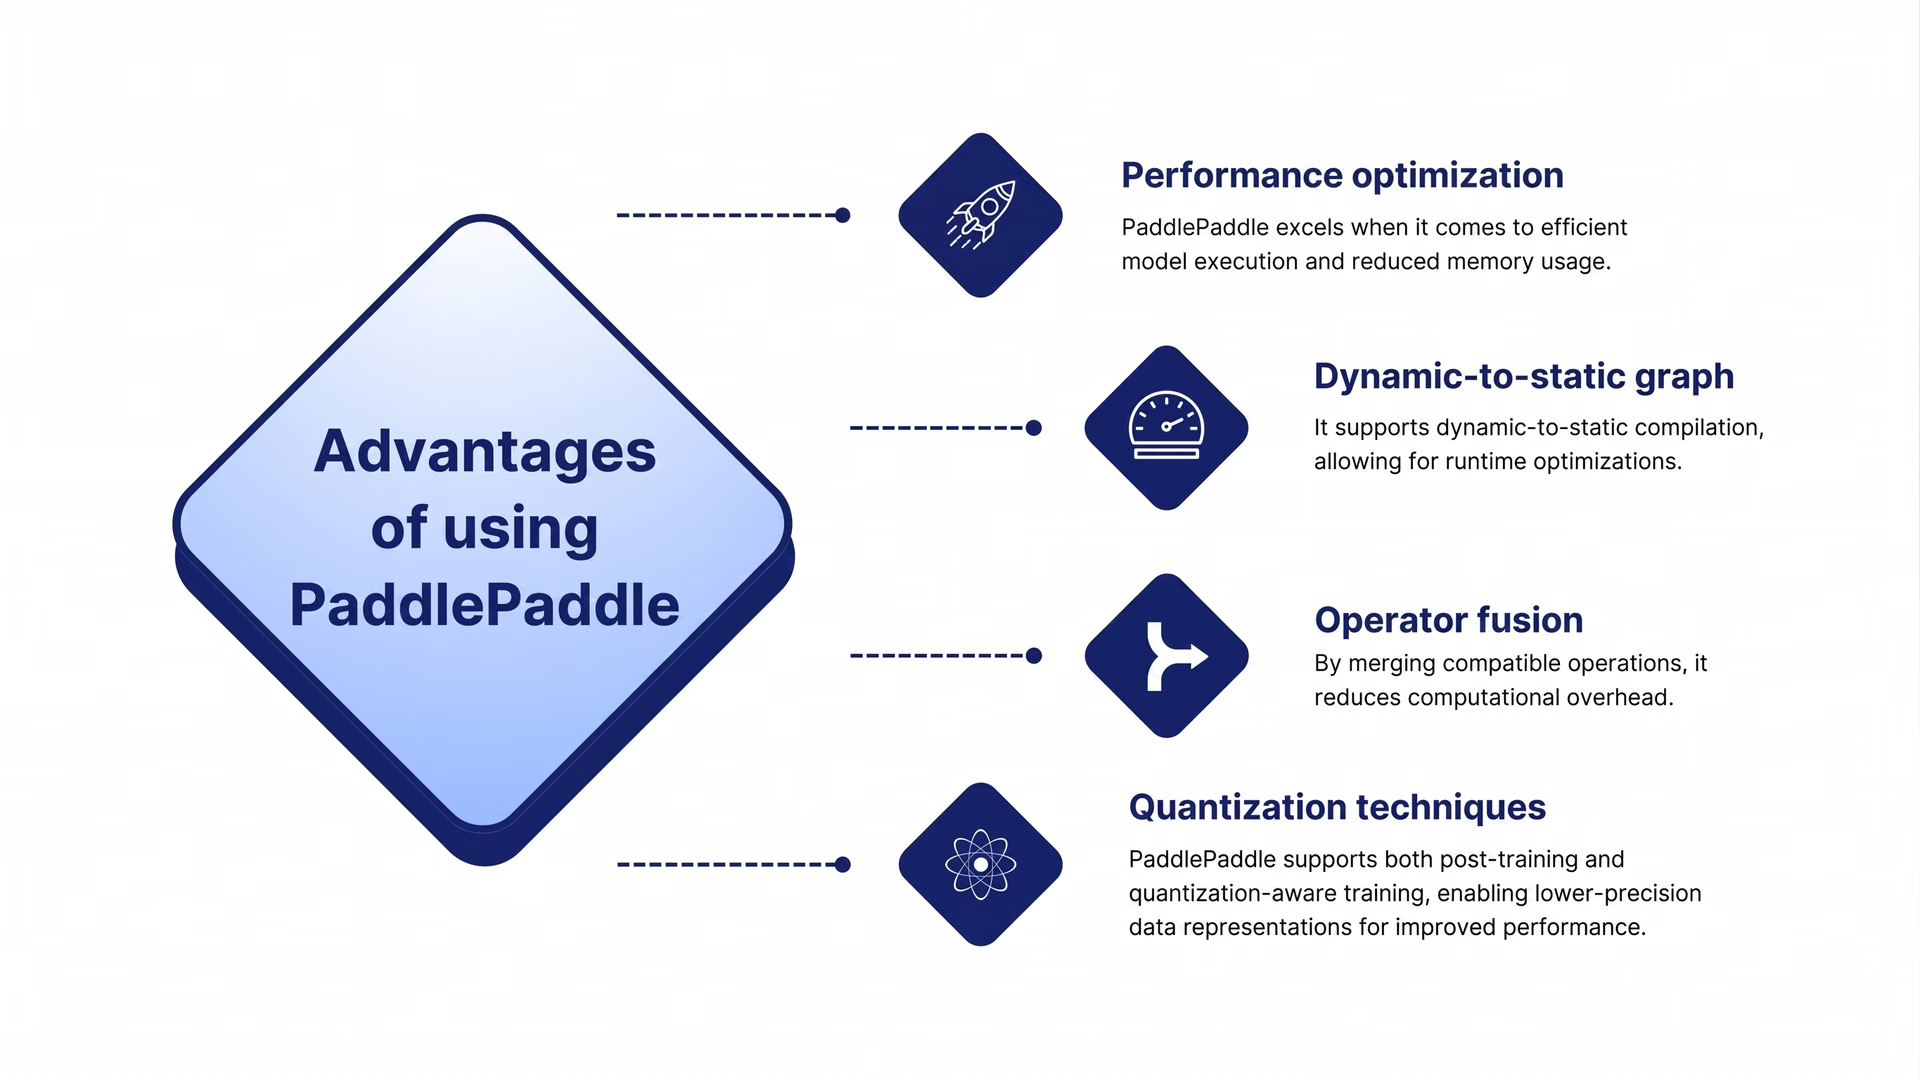
Abb. 2. Vorteile von PaddlePaddle. Bild vom Autor.
Überblick über die Bereitstellung von Ultralytics YOLO11 mit PaddlePaddle#
Die von Ultralytics unterstützte PaddlePaddle-Integration erleichtert den Übergang vom Training zur Bereitstellung. Entwickler, die bereits PaddlePaddle-Werkzeuge verwenden, können YOLO11 leichter in ihre Arbeitsabläufe integrieren.
Das Ultralytics-Python-Paket unterstützt den direkten Export von YOLO11-Modellen ins PaddlePaddle-Format. So können Entwickler trainierte Modelle ohne zusätzliche Werkzeuge oder manuelle Konvertierungsschritte bereitstellen.
Der Export lässt sich entweder über die Befehlszeile oder mit Python-Code durchführen. Entwickler können daher die Methode wählen, die am besten zu ihrem Arbeitsablauf passt. Das hält den Prozess einfach und verringert das Risiko von Einrichtungsproblemen. Nach dem Export lässt sich das Modell für Computer-Vision-Aufgaben wie Objekterkennung, Bildklassifizierung, Posenschätzung und Instanzsegmentierung verwenden.
Das ist eine gute Wahl für die Bereitstellung auf Geräten mit wenig Speicher oder hohem Bedarf an schneller Verarbeitung. Die exportierten Modelle sind für einen effizienten Betrieb optimiert, selbst auf Systemen mit begrenzten Ressourcen.
So exportierst du Ultralytics YOLO11-Modelle ins PaddlePaddle-Format#
Der Export von Ultralytics YOLO11 ins PaddlePaddle-Format erfordert nur wenige Schritte.
Installiere zuerst das Ultralytics-Python-Paket mit einem Paketmanager wie „pip“. Führe dazu in der Eingabeaufforderung oder im Terminal den Befehl „pip install ultralytics“ aus.
Das Ultralytics-Paket bietet Werkzeuge zum Trainieren, Evaluieren, Feinabstimmen, Exportieren und Bereitstellen von Modellen für zahlreiche Computer-Vision-Aufgaben. Falls bei der Installation Probleme auftreten, findest du in der Anleitung zu häufigen Problemen Tipps zur Fehlerbehebung.
Sobald deine Umgebung eingerichtet ist, kannst du ein vortrainiertes YOLO11-Modell wie „yolo11n.pt“ laden und exportieren, wie unten gezeigt. Du kannst auch dein eigenes, benutzerdefiniert trainiertes YOLO11-Modell exportieren.
from ultralytics import YOLO

model = YOLO("yolo11n.pt")
model.export(format="paddle")
Nachdem du dein Modell ins PaddlePaddle-Format konvertiert hast, kannst du es in verschiedenen Szenarien und auf unterschiedlichen Hardwaretypen bereitstellen.
Im folgenden Beispiel laden wir ein Ultralytics YOLO11-Modell, das ins PaddlePaddle-Format exportiert wurde, und verwenden es für eine Vorhersage. Dieser Vorgang, Inferenz genannt, bedeutet einfach, dass das Modell neue Daten analysiert. Hier testen wir es mit einem Bild von zwei Hunden.
paddle_model = YOLO("./yolo11n_paddle_model")
paddle_model("https://images.pexels.com/photos/33287/dog-viszla-close.jpg", save=True)
Nach der Ausführung des Codes wird das Ausgabebild mit den Vorhersagen des Modells automatisch im Ordner „runs/detect/predict“ gespeichert.
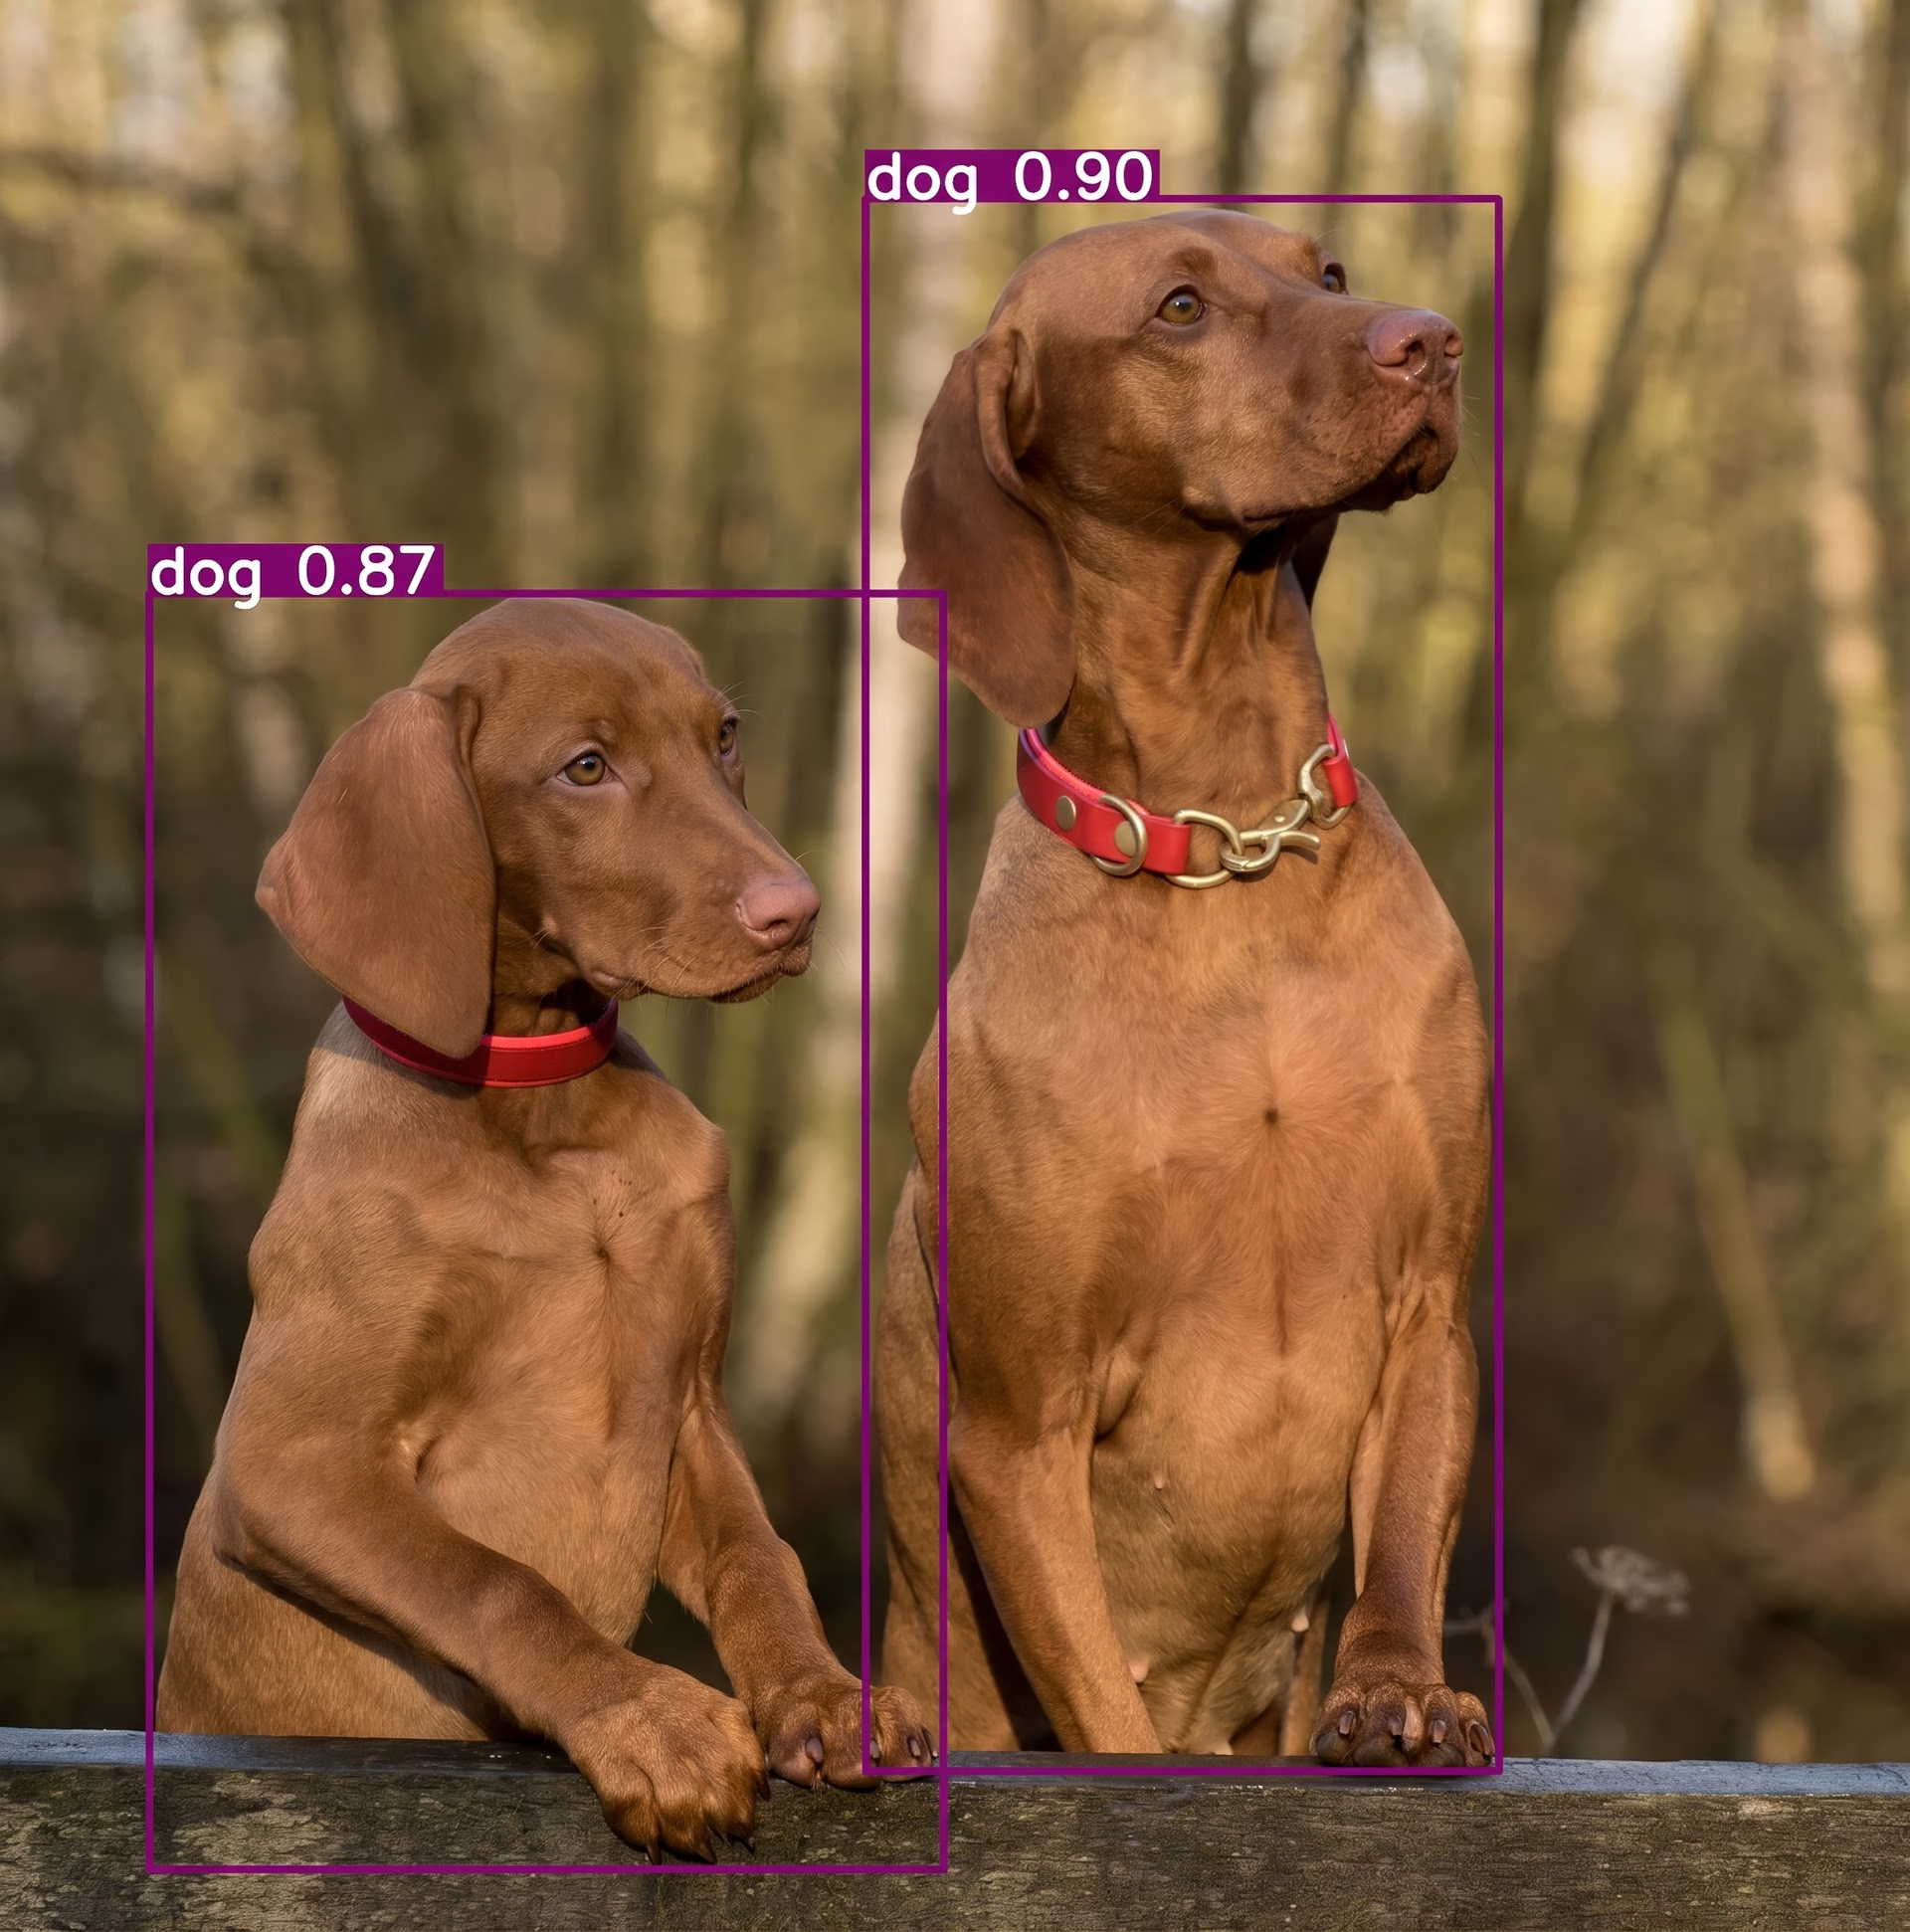
Abb. 3. Objekterkennung in einem Bild mit dem exportierten Ultralytics YOLO11-Modell. Bild vom Autor.
Ultralytics YOLO11 mit dem PaddlePaddle-Framework bereitstellen#
PaddlePaddle bietet verschiedene Werkzeuge für die Bereitstellung, die sich für unterschiedliche Geräte und Anwendungsfälle eignen, etwa Cloud-Umgebungen, eingebettete Systeme und Webanwendungen. Hier sind einige der wichtigsten Bereitstellungsoptionen:
- Paddle Serving: Damit lassen sich Modelle als REST-APIs bereitstellen. Das ist eine gute Wahl für Cloud- oder Serverumgebungen, die Funktionen wie Versionsverwaltung und Online-Tests benötigen.
- Paddle Inference API: Sie bietet mehr Kontrolle über die Ausführung von Modellen. Das ist hilfreich, wenn du die Leistung feinabstimmen oder eigene Anwendungslogik erstellen möchtest.
- Paddle Lite: Diese Lösung ist für die schlanke Bereitstellung auf Mobilgeräten, Tablets und eingebetteten Systemen konzipiert. Sie ist für kleinere Modelle und eine schnellere Inferenz auf Hardware mit begrenzten Ressourcen optimiert.
- Paddle.js: Damit kannst du KI-Modelle in Webbrowsern mit Technologien wie WebGL und WebAssembly ausführen. Das ist nützlich für interaktive Demos und browserbasierte Werkzeuge.
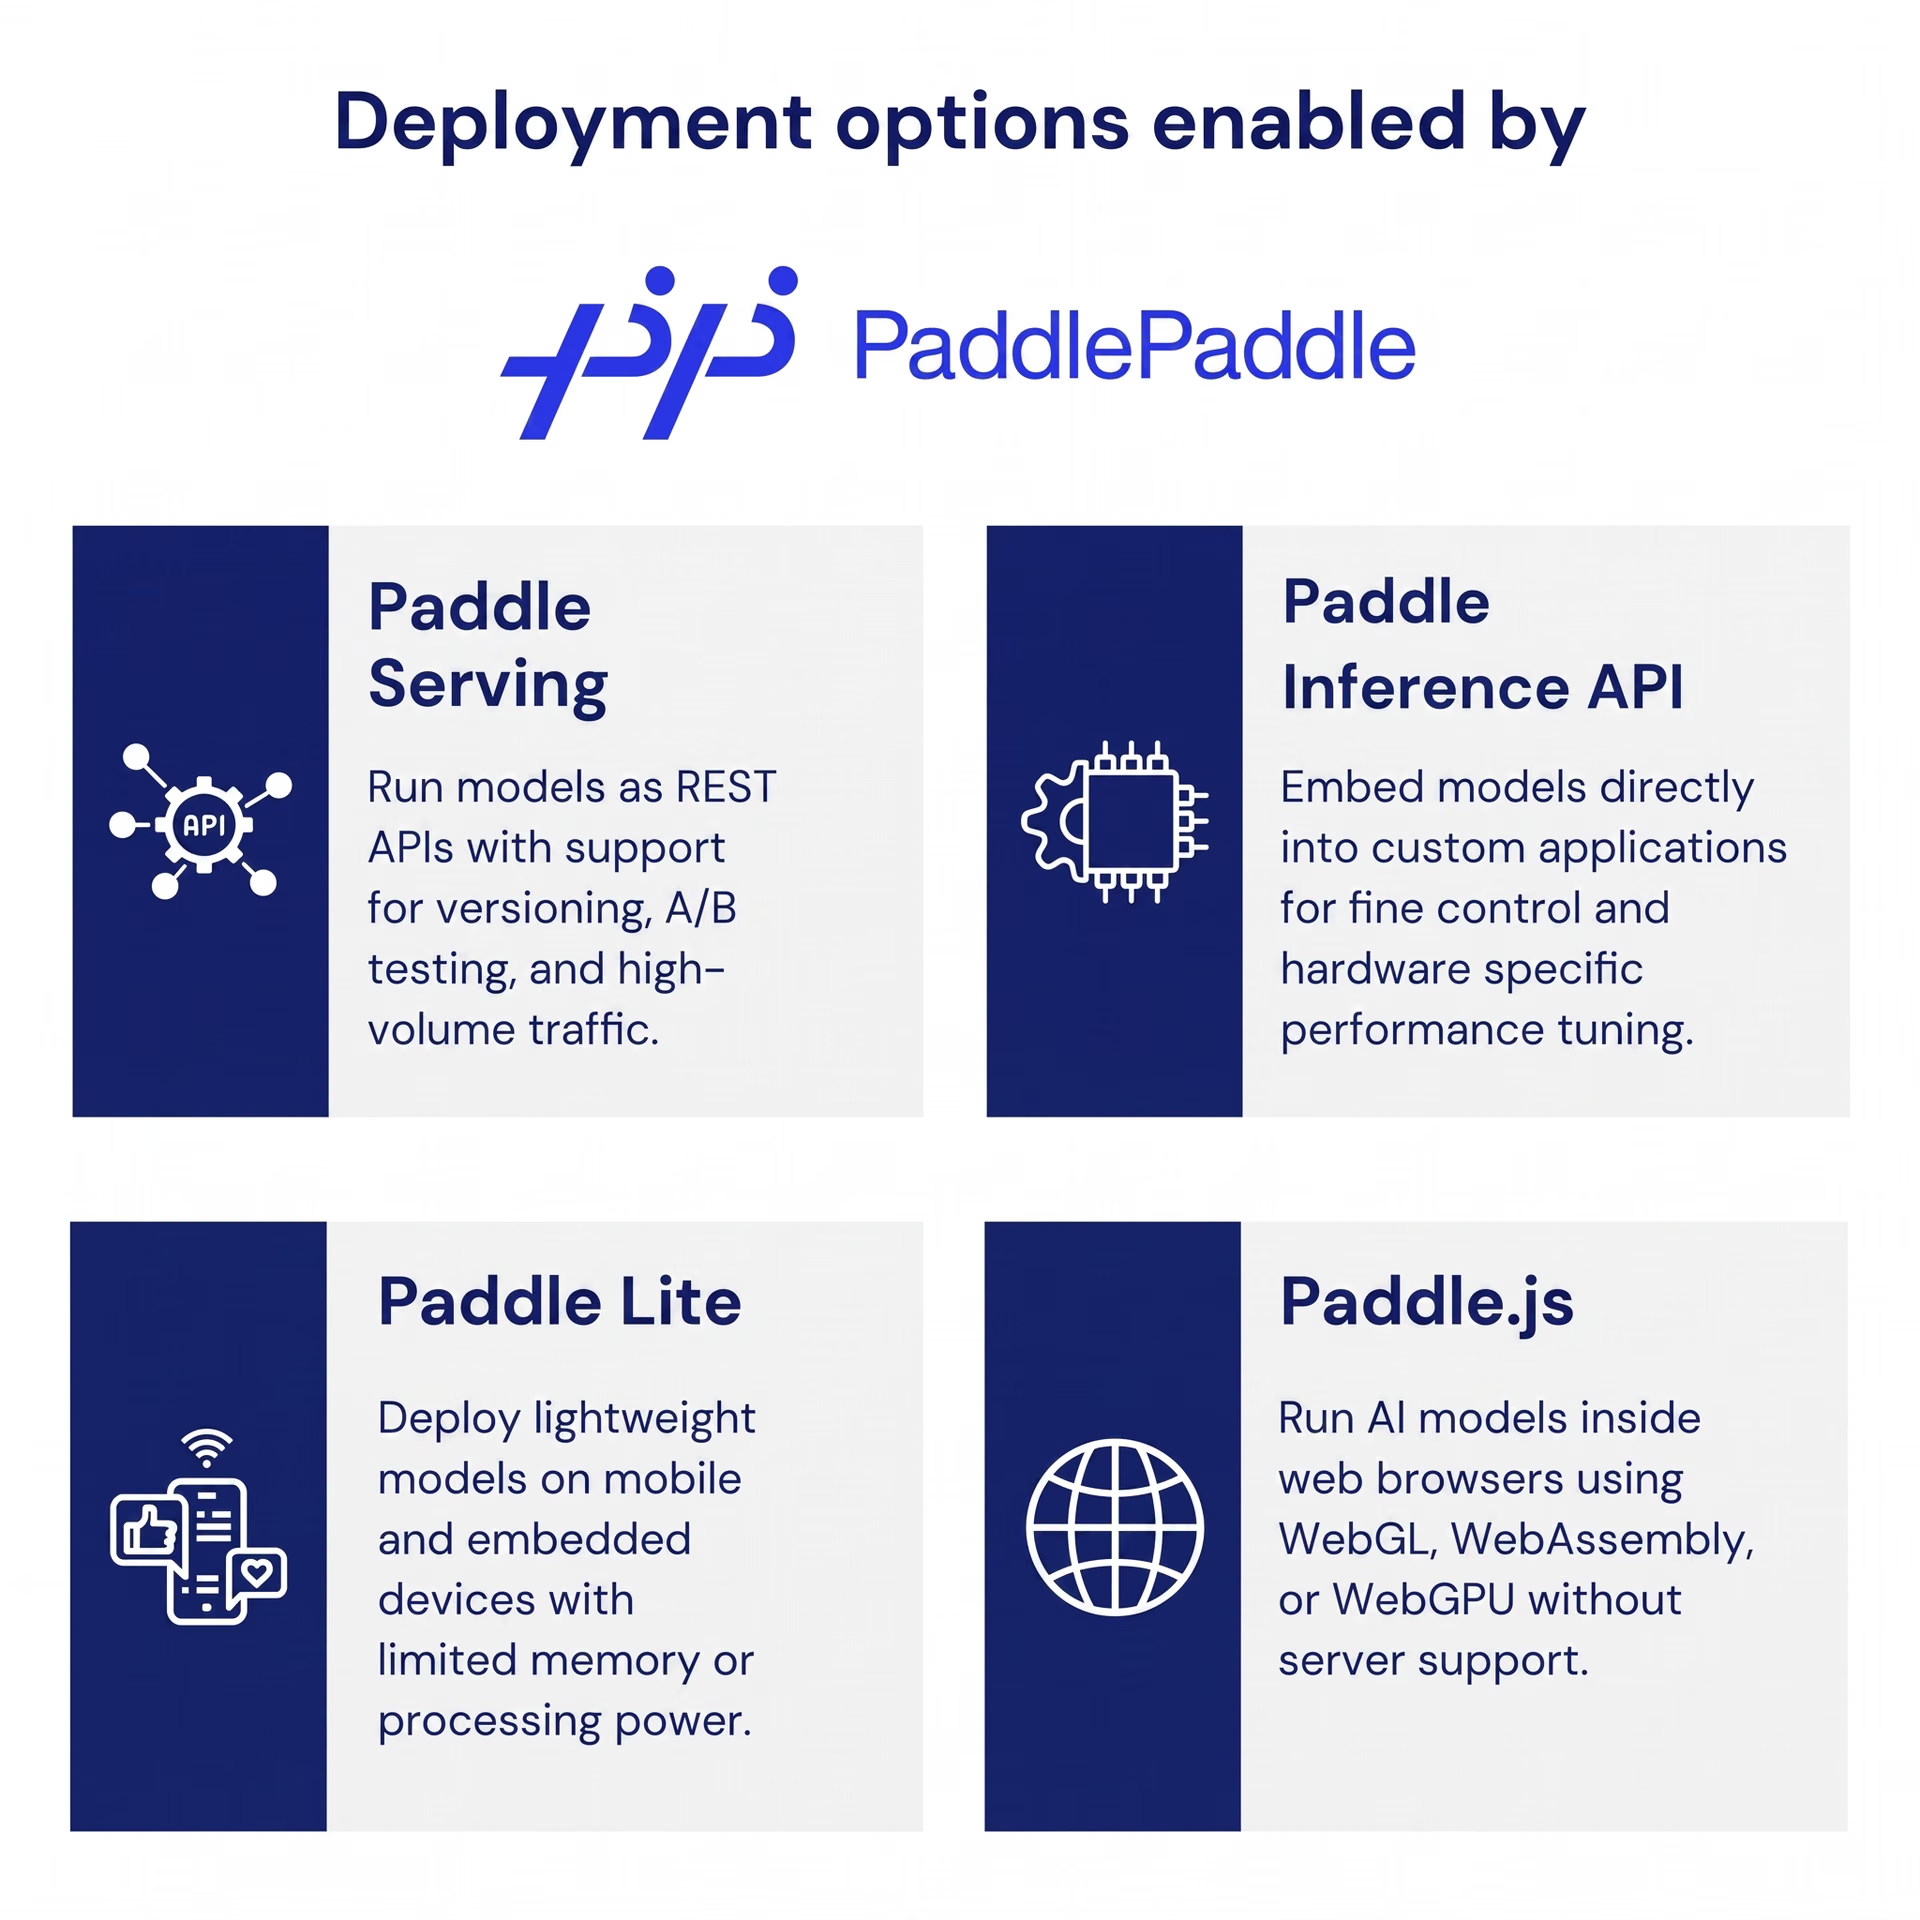
Abb. 4. Mit PaddlePaddle verfügbare Bereitstellungsoptionen. Bild vom Autor.
Sobald du das passende Werkzeug für deine Umgebung ausgewählt hast, kannst du das exportierte Modell laden. Die PaddlePaddle-Engine übernimmt die nächsten Schritte: Sie lädt das Modell, verarbeitet das Eingabebild und gibt die Ergebnisse zurück.
Wann solltest du die PaddlePaddle-Integration wählen?#
Das Ultralytics-Python-Paket unterstützt auch verschiedene andere Exportformate. Vielleicht fragst du dich deshalb: Wann ist PaddlePaddle die richtige Wahl?
PaddlePaddle ist eine zuverlässige Option, wenn du Modelle auf Geräten mit begrenzten Ressourcen bereitstellen möchtest, etwa auf Smartphones, eingebetteten Systemen oder Edge-Hardware. Die Plattform eignet sich auch gut für Echtzeitanwendungen, die eine schnelle und effiziente Ausführung erfordern, zum Beispiel Objekterkennung in mobilen Apps, visuelle Überwachung mit intelligenten Kameras oder Posenschätzung direkt auf dem Gerät ohne Cloud-Unterstützung.
Wenn dein Projekt außerdem offline oder in Umgebungen mit schlechter Verbindung laufen muss, kannst du die PaddlePaddle-Integration in Betracht ziehen. Anwendungen wie visuelle Prüfwerkzeuge in der Fertigung, tragbare Geräte für Geländeerhebungen oder KI-gestützte Scanner im Einzelhandel profitieren von der schlanken Laufzeitumgebung und den flexiblen Bereitstellungsoptionen von PaddlePaddle.
Einschränkungen von PaddlePaddle, die du beachten solltest#
PaddlePaddle bietet zwar interessante Möglichkeiten für die Bereitstellung, doch solltest du einige Einschränkungen kennen:
- Kleinere weltweite Community: Außerhalb Chinas ist die Zahl der Nutzer und Mitwirkenden relativ gering. Dadurch kann es schwieriger sein, Unterstützung aus der Community, gelöste GitHub-Probleme oder Antworten auf Stack Overflow zu finden.
- Steilere Lernkurve bei Werkzeugen außerhalb des Baidu-Ökosystems: PaddlePaddle lässt sich reibungslos in das Ökosystem von Baidu integrieren. Außerhalb dieses Umfelds kann die Verwendung jedoch zusätzliche Konfigurations- und Einrichtungsschritte erfordern.
- Weniger Integrationen mit gängigen ML-Werkzeugen: PaddlePaddle ist nur eingeschränkt mit verbreiteten Werkzeugen wie Hugging Face Transformers, MLflow oder Kubernetes-nativen KI-Diensten kompatibel.
Die wichtigsten Erkenntnisse#
Die von Ultralytics unterstützte PaddlePaddle-Integration erleichtert den Export und die Bereitstellung von YOLO11-Modellen auf verschiedensten Geräten. Besonders nützlich ist sie für Projekte, die eine effiziente Ausführung direkt auf dem Gerät erfordern – etwa mobile Apps, intelligente Kameras oder eingebettete Systeme.
Mit wenigen Schritten kannst du leistungsstarke Computer-Vision-Modelle in praktische Anwendungen integrieren. Computer Vision entwickelt sich ständig weiter, und Werkzeuge wie YOLO und PaddlePaddle machen es einfacher denn je, schnelle und intelligente Systeme zu entwickeln – von Verbrauchergeräten bis hin zu Industrielösungen.
Werde noch heute Teil unserer wachsenden Community! Tauche tiefer in die KI ein und sieh dir unser GitHub-Repository an. Möchtest du eigene Computer-Vision-Projekte entwickeln? Informiere dich über unsere Lizenzoptionen. Erfahre, wie Computer Vision im Gesundheitswesen die Effizienz steigert, und entdecke auf unseren Lösungsseiten die Auswirkungen von KI im Einzelhandel!









