Una panoramica rapida della Vision AI e del suo funzionamento
Esplora come la Vision AI trasforma immagini e video in analisi in tempo reale utilizzando modelli, dataset e workflow end-to-end all'avanguardia in tutti i settori.
Ogni giorno, le fotocamere presenti in fabbriche, ospedali, città, veicoli e dispositivi di consumo acquisiscono enormi quantità di immagini e video. Questo flusso costante di dati visivi crea nuove possibilità, ma rende anche difficile capire cosa sta accadendo e agire rapidamente.
Per esempio, gli incroci trafficati o gli spazi pubblici affollati possono cambiare da un momento all’altro. Monitorare manualmente questi ambienti è lento e spesso impreciso, soprattutto quando servono decisioni rapide e affidabili.
Per gestire situazioni di questo tipo, i sistemi devono poter comprendere le informazioni visive nel momento in cui vengono acquisite e rispondere in tempo reale. La visione artificiale lo rende possibile, consentendo alle macchine di analizzare immagini e video, riconoscere schemi ed estrarre informazioni utili.
I primi sistemi di visione artificiale si basavano su regole fisse, efficaci in ambienti controllati, ma spesso inaffidabili quando cambiavano condizioni come l’illuminazione o l’angolazione delle fotocamere. La moderna IA per la visione migliora questo approccio utilizzando l’intelligenza artificiale e il machine learning.
Invece di limitarsi ad acquisire o archiviare immagini, questi sistemi analizzano i dati visivi in tempo reale, apprendono dagli esempi e si adattano agli ambienti in evoluzione. Questo rende l’IA per la visione più efficace nelle situazioni reali e le consente di migliorare nel tempo man mano che viene utilizzata in più applicazioni.
In questo articolo analizzeremo più da vicino cos’è l’IA per la visione e come può essere utilizzata per creare workflow intelligenti end-to-end. Iniziamo!
Che cos’è l’IA per la visione?#
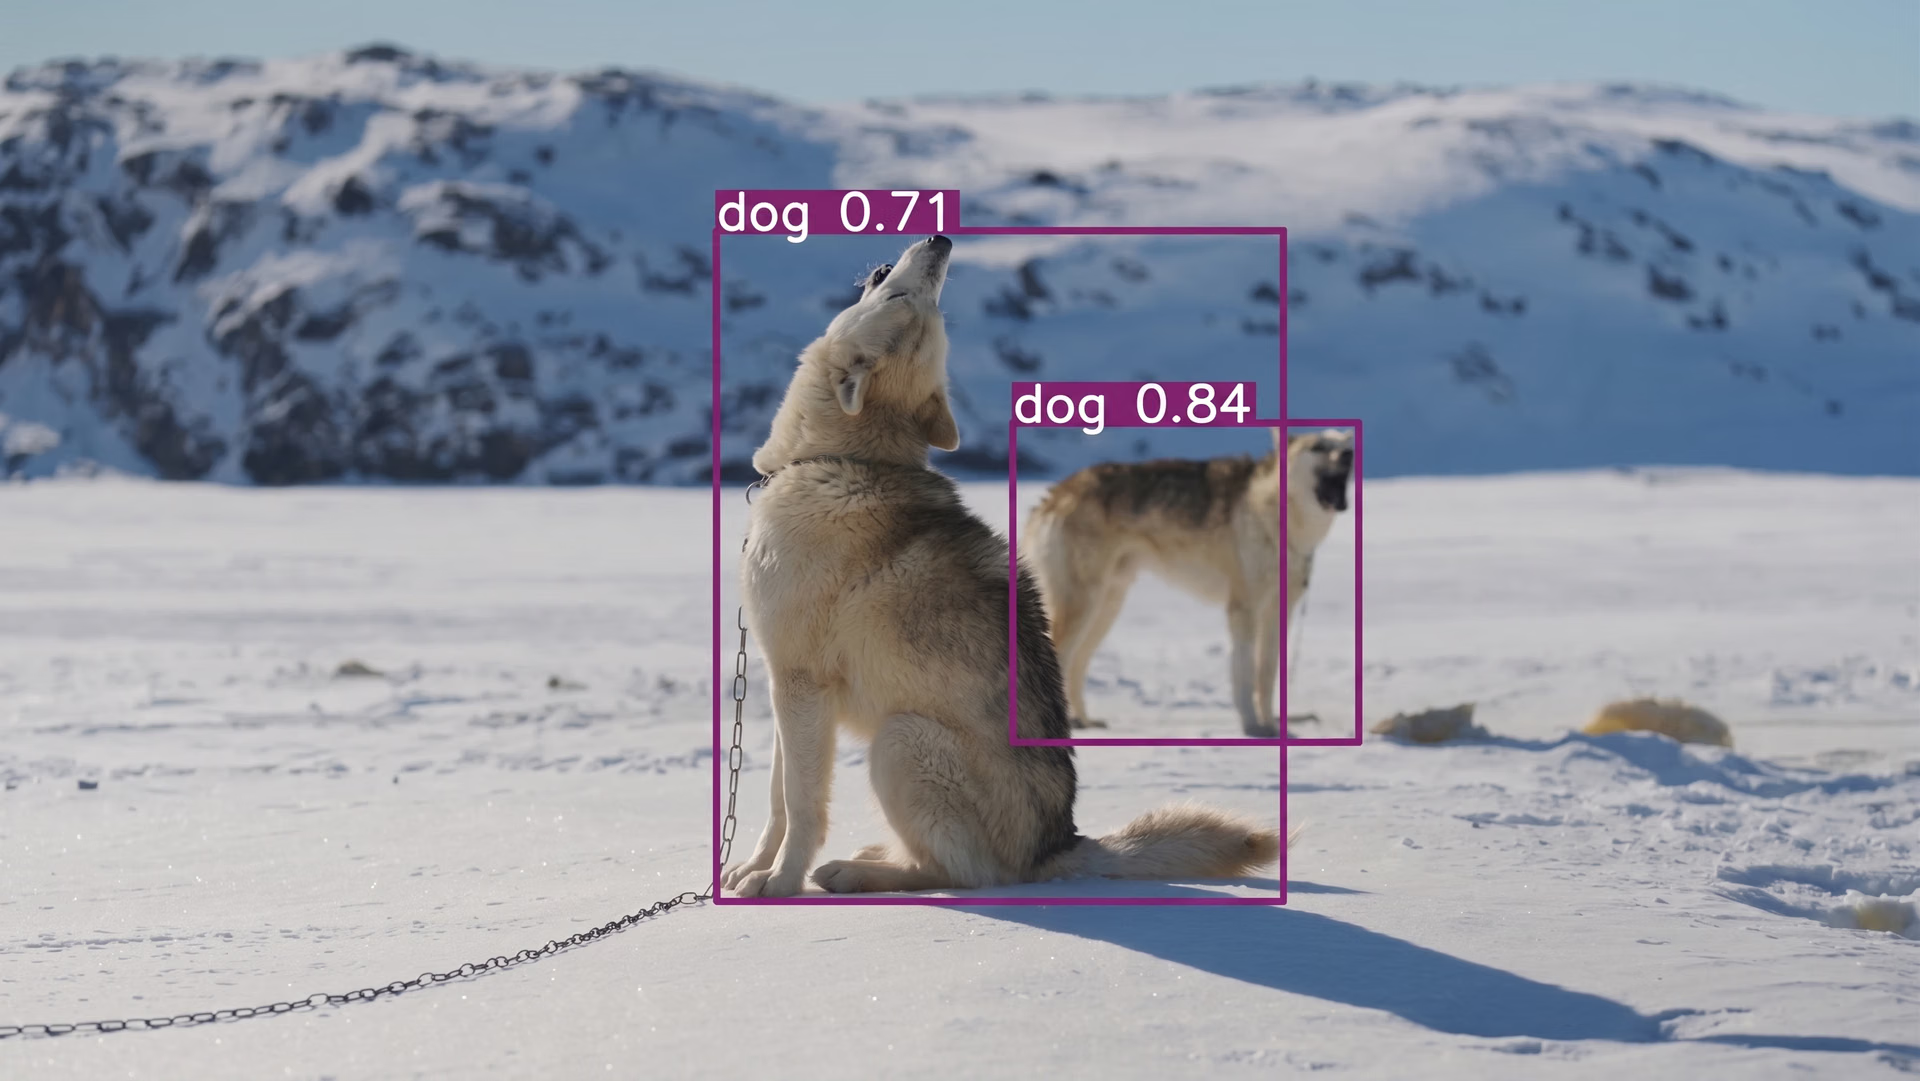
L’IA per la visione è un ramo dell’intelligenza artificiale che consente alle macchine di comprendere e interpretare immagini e video. In altre parole, i sistemi di IA per la visione analizzano ciò che vedono e utilizzano queste informazioni per supportare azioni, ottimizzare previsioni o prendere decisioni all’interno di un workflow più ampio. A differenza dell’IA generativa, che crea nuovi contenuti, l’IA per la visione si concentra sulla comprensione e sull’estrazione di informazioni dai dati visivi esistenti.
Per esempio, monitorare l’attività in uno stabilimento o in uno spazio pubblico per lunghi periodi richiede una velocità e una coerenza difficili da mantenere manualmente. I sistemi di IA per la visione possono affrontare questa sfida applicando tecniche di machine learning e deep learning per riconoscere schemi, identificare dettagli rilevanti e rispondere alla comparsa di nuove informazioni visive.
Fig. 1. Un esempio di utilizzo dell’IA per la visione per rilevare oggetti in un’immagine (Fonte)
Poiché immagini e video vengono spesso generati in grandi quantità e ad alta velocità, i sistemi di IA per la visione possono elaborare continuamente i dati visivi e applicare le stesse regole a ogni fotogramma. Questo rende i risultati più coerenti e aiuta i team a migliorare le operazioni mantenendo l’accuratezza al variare delle condizioni.
Nell’uso reale, l’IA per la visione fa solitamente parte di un sistema di IA end-to-end. Collega i modelli di IA per la visione alla logica decisionale e ad altri strumenti che agiscono sui risultati. Trasformando gli input visivi in informazioni utili, l’IA per la visione può automatizzare le attività di routine e supportare decisioni più rapide e sicure in numerose applicazioni di visione artificiale.
Come funziona l’IA per la visione: dai dati visivi a informazioni utili per agire#
Quindi, come fa un sistema o una macchina a passare dalla visualizzazione di un’immagine o di un video alla comprensione di ciò che sta accadendo e alla decisione su cosa fare dopo?
Il processo inizia con input visivi provenienti dal mondo reale, come foto, clip video, flussi video in diretta dalle fotocamere o flussi di dati dei sensori. Poiché la qualità, l’illuminazione e l’angolazione della fotocamera possono variare notevolmente, questi dati devono generalmente essere preparati prima dell’analisi.
Questa preparazione può includere il ridimensionamento delle immagini, la regolazione dell’illuminazione e l’organizzazione dei fotogrammi video in un formato coerente. Spesso vengono inclusi anche dati contestuali aggiuntivi, come i timestamp o la posizione della fotocamera, per supportare un’analisi più accurata.
I dati preparati vengono quindi utilizzati all’interno di un framework di apprendimento che consente al sistema di riconoscere gli schemi visivi. Addestrandosi su immagini e video annotati, un modello di IA per la visione apprende come appaiono oggetti, schemi ed eventi in condizioni diverse.
Questa comprensione appresa costituisce la base di molte attività comuni di visione artificiale, come il rilevamento degli oggetti (identificazione e localizzazione degli oggetti all’interno di un’immagine) e la segmentazione delle istanze (separazione ed etichettatura dei singoli oggetti a livello di pixel). I modelli di IA per la visione all’avanguardia, come Ultralytics YOLO26, sono progettati per supportare queste attività mantenendo velocità e accuratezza negli ambienti reali.
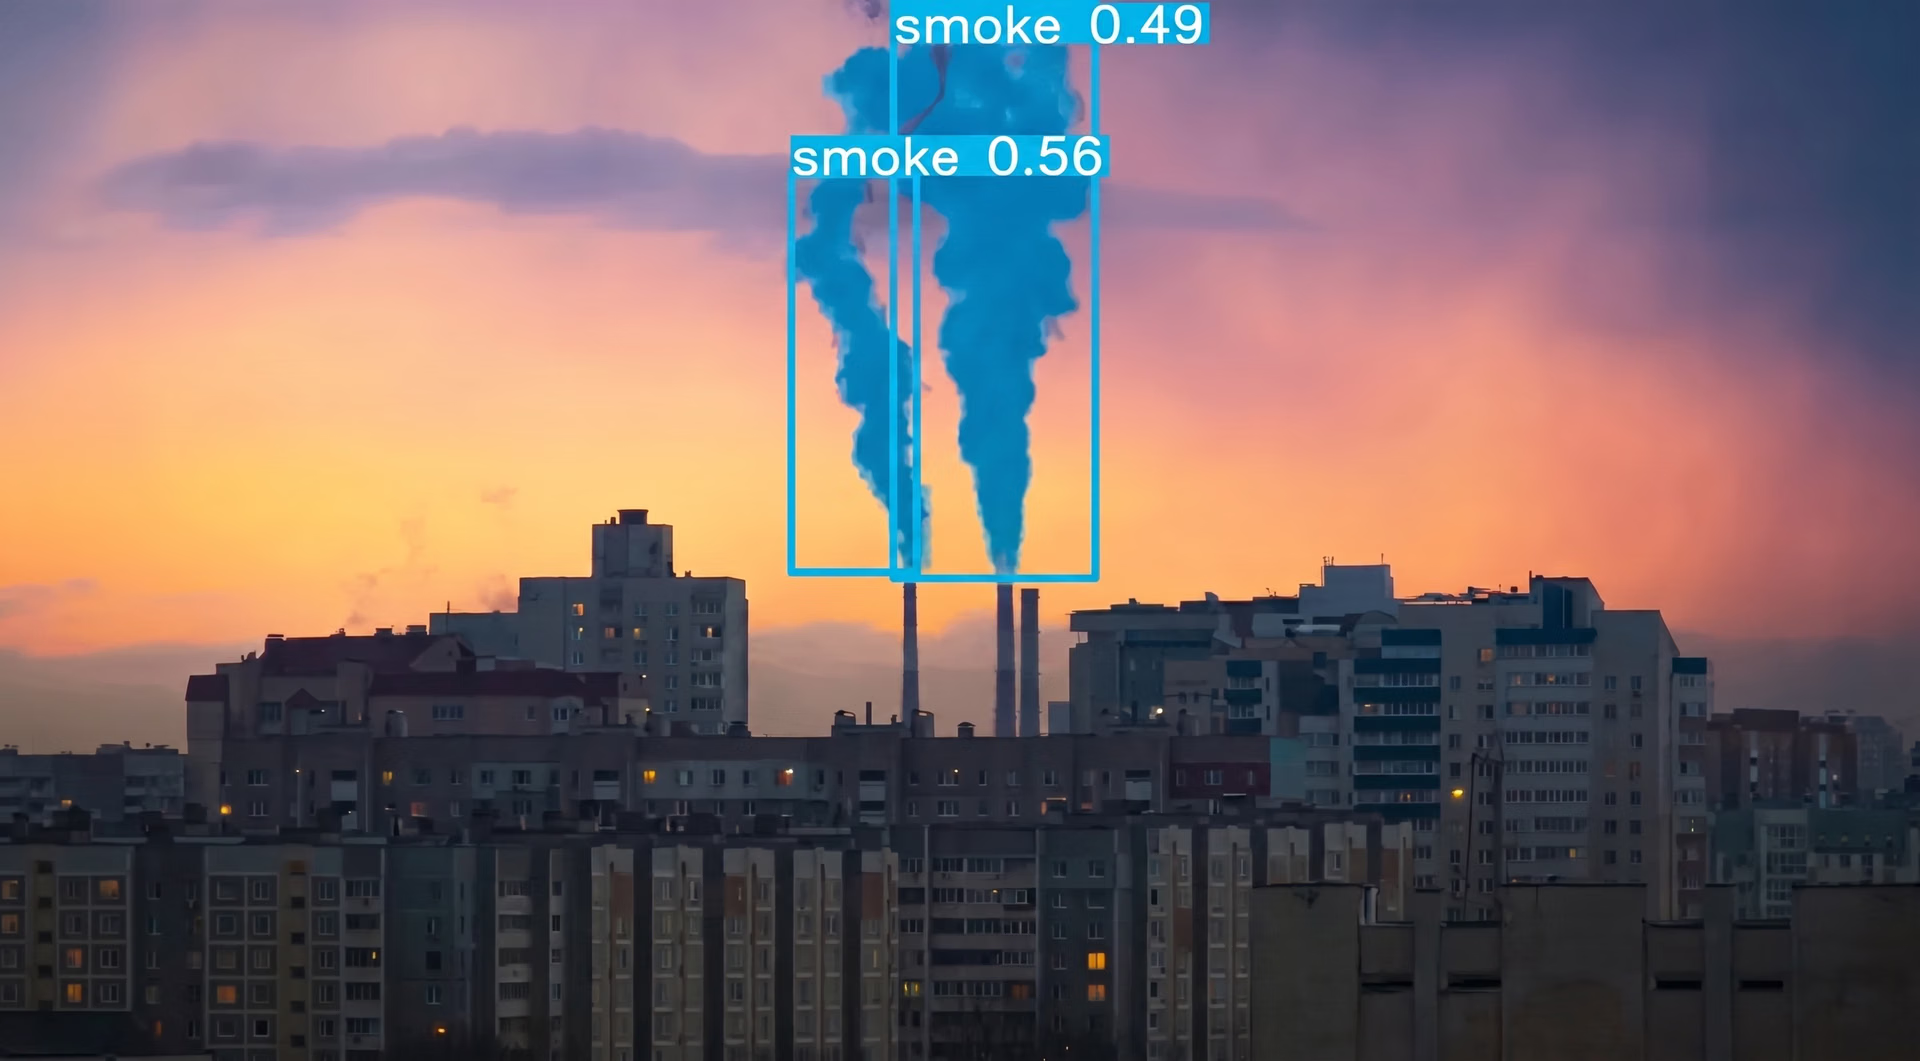
Fig. 2. Uno sguardo all’utilizzo di YOLO per la segmentazione delle istanze (Fonte)
Una volta implementato il sistema, gli input visivi vengono elaborati continuamente come parte di un workflow end-to-end. Il modello analizza immagini e video e invia i propri output a dashboard, strumenti di automazione o altri sistemi di IA. In alcuni casi, gli agenti di IA per la visione utilizzano questi risultati per attivare azioni o supportare il processo decisionale, trasformando la comprensione visiva in informazioni pratiche e utili per agire.
L’evoluzione dei modelli e delle architetture per la visione#
Man mano che impari a conoscere meglio l’IA per la visione, potresti chiederti perché i modelli e le architetture siano importanti e come influiscano sulle prestazioni del sistema. I modelli di IA per la visione sono fondamentali per le innovazioni odierne nel campo della visione artificiale.
La maggior parte dei sistemi di IA per la visione si basa su un modello che determina come vengono analizzati immagini e video. Il modello definisce ciò che il sistema è in grado di riconoscere in una scena e le prestazioni che può raggiungere in condizioni diverse.
Con la crescita e la diversificazione delle applicazioni di IA per la visione, i relativi modelli e le architetture sottostanti hanno continuato a evolversi per stare al passo e risultare più facili da usare. I primi sistemi di visione artificiale richiedevano agli ingegneri di definire manualmente cosa dovesse cercare il sistema, come bordi, colori o forme specifiche.
Questi approcci basati su regole funzionavano bene negli ambienti controllati, ma spesso fallivano quando cambiava l’illuminazione, variava la qualità della fotocamera o le scene diventavano più complesse. I moderni modelli di IA per la visione adottano un approccio diverso.
Molti modelli open source apprendono gli schemi visivi direttamente dai dati, il che li rende più flessibili e più adatti agli ambienti reali, dove le condizioni sono imprevedibili. I progressi nell’architettura dei modelli hanno inoltre semplificato l’elaborazione di immagini e video, rendendo questi sistemi più facili da implementare e integrare in piattaforme pratiche di IA per la visione.
I modelli Ultralytics YOLO sono un ottimo esempio di questo cambiamento. Modelli come YOLO26 sono ampiamente utilizzati per attività di rilevamento degli oggetti che richiedono velocità e coerenza, soprattutto nelle applicazioni video in diretta.
Esplorazione delle principali attività dell’IA per la visione#
Ecco alcune delle principali attività di visione artificiale su cui fanno affidamento i sistemi di visione basati sull’IA per comprendere le informazioni visive e ottimizzare gli ambienti reali:
- Rilevamento degli oggetti: questa attività consente a un sistema di identificare quali oggetti sono presenti in un’immagine o in un video e di determinarne la posizione, in genere disegnando riquadri di delimitazione attorno a ciascun oggetto.
- Classificazione delle immagini: con questo approccio, un’intera immagine viene analizzata e associata a una o più etichette in base al suo contenuto complessivo, contribuendo a organizzare gli elementi visivi e a supportare le decisioni.
- Segmentazione delle istanze: per le attività che richiedono maggiore precisione, questa attività scompone un’immagine a livello di pixel per separare gli oggetti o le regioni all’interno di una scena.
- Tracciamento degli oggetti: nelle applicazioni basate sui video, questa funzionalità consente di seguire gli oggetti tra i fotogrammi preservandone l’identità e il movimento nel tempo.
- Stima della posa: identifica i punti chiave su persone o oggetti, come articolazioni o punti di riferimento, per determinarne posizione, postura e movimento in ambienti dinamici.
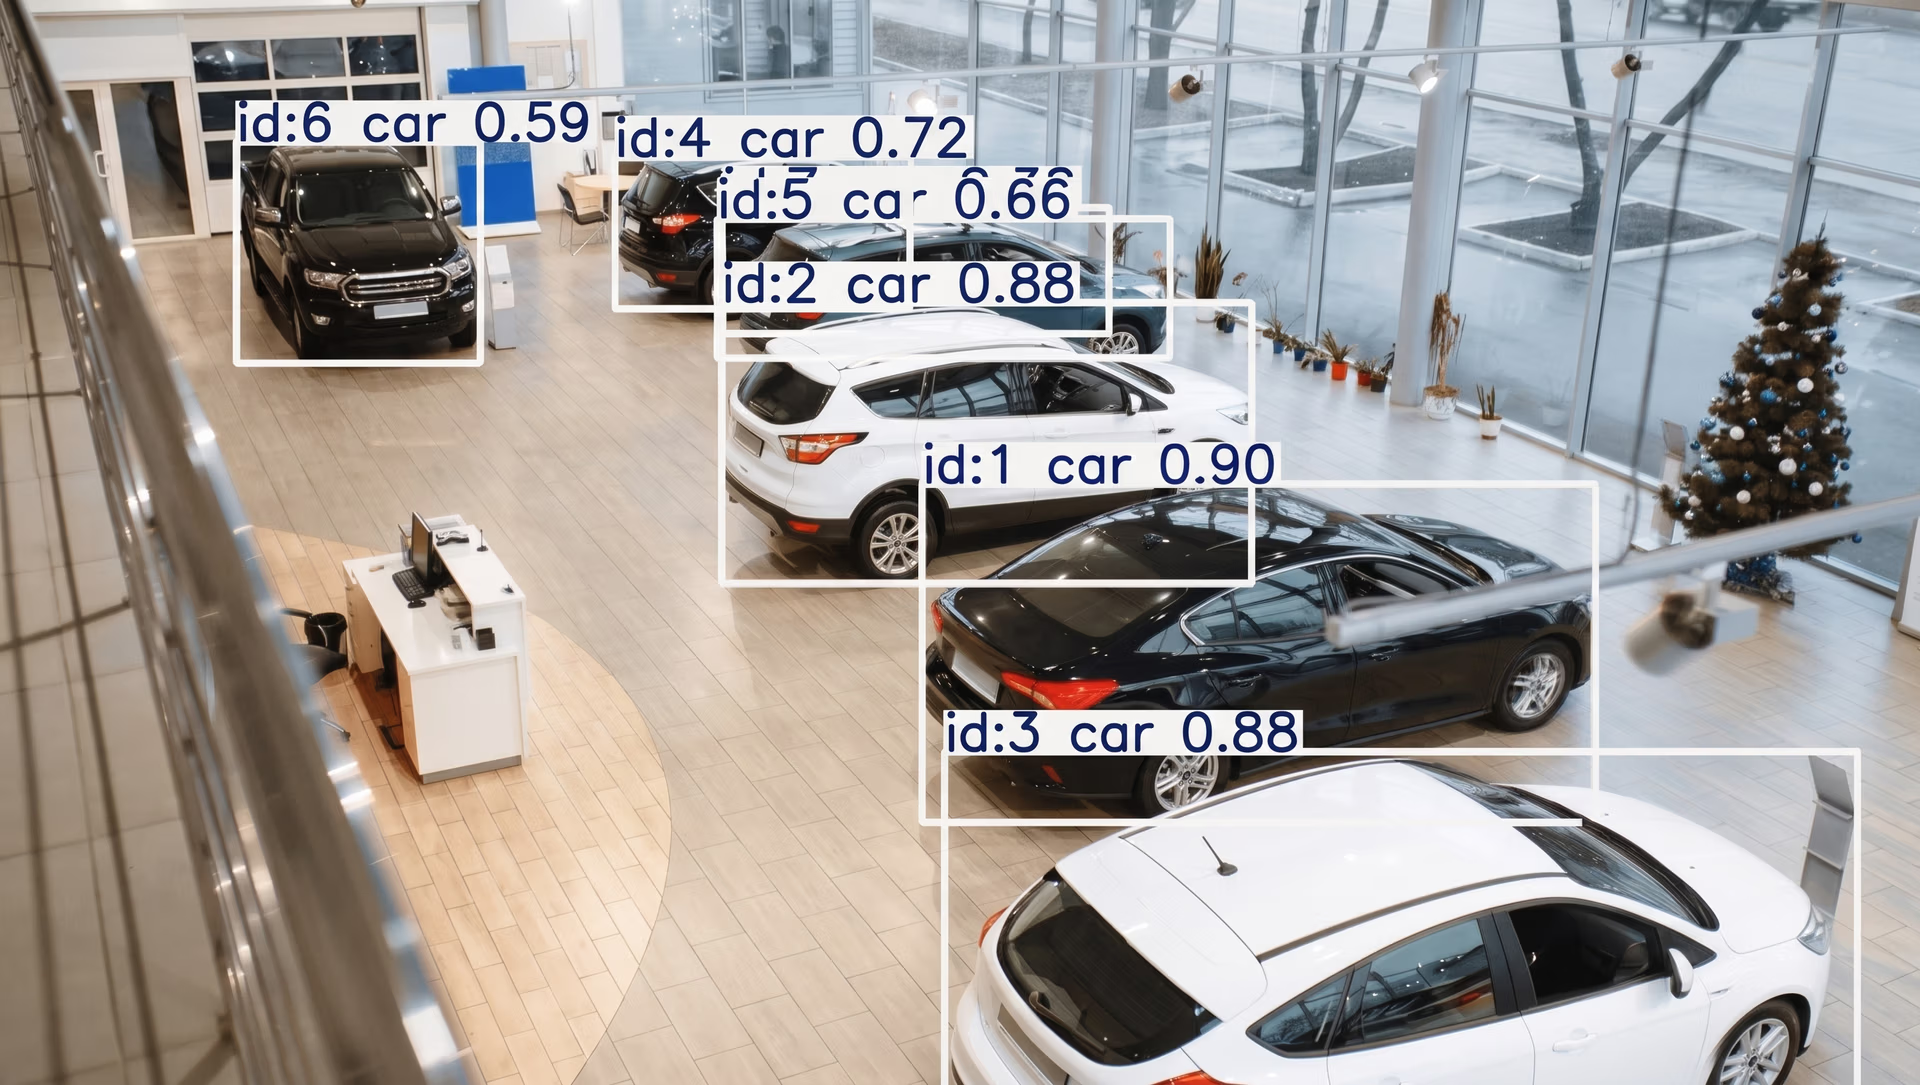
Fig. 3. Rilevamento e tracciamento dei veicoli utilizzando YOLO (Fonte)
Il ruolo dei dataset nell’IA per la visione#
Alla base di ogni sistema efficace di IA per la visione c’è un dataset curato con attenzione. Questi dataset per l’IA per la visione forniscono le immagini e i video da cui apprendono i modelli di IA per la visione, aiutandoli a riconoscere oggetti, schemi e scene negli ambienti reali.
La qualità dei dati influisce direttamente sull’accuratezza e sull’affidabilità del sistema. Per rendere efficaci i dati visivi, i dataset vengono annotati. Ciò significa aggiungere dettagli importanti a ogni immagine o video, ad esempio etichettando gli oggetti, evidenziando aree specifiche o assegnando categorie.
Oltre alle etichette, è possibile includere metadati aggiuntivi come orario, posizione o tipo di scena per organizzare i dati e migliorarne la comprensione. I dataset vengono inoltre comunemente suddivisi in set di addestramento, convalida e test, così da poter valutare i sistemi su elementi visivi che non hanno mai visto prima.
I dataset più diffusi, come ImageNet, COCO e Open Images, hanno svolto un ruolo importante nel progresso dell’IA per la visione, fornendo raccolte ampie e diversificate di immagini annotate. Tuttavia, raccogliere dati dal mondo reale è ancora difficile.
Pregiudizi, lacune nella copertura e ambienti in costante cambiamento rendono difficile creare dataset che riflettano davvero le condizioni reali. Ottenere il giusto equilibrio di dati su larga scala è fondamentale per costruire sistemi affidabili di IA per la visione.
Panoramica di diversi casi d’uso dell’IA per la visione#
Ora che abbiamo compreso meglio come funziona l’IA per la visione, vediamo come viene utilizzata nelle applicazioni del mondo reale. In molti settori, l’IA per la visione aiuta i team a gestire attività visive su larga scala, portando a risposte più rapide e operazioni più efficienti.
Ecco alcuni modi comuni in cui l’IA per la visione viene utilizzata nei diversi settori:
- Produzione: nello stabilimento, l’IA per la visione può essere utilizzata per monitorare i prodotti mentre attraversano ogni fase della produzione. Può individuare tempestivamente difetti, componenti mancanti o incoerenze, aiutando i team a ridurre le rilavorazioni, mantenere la qualità ed evitare fermi macchina imprevisti.
- Vendita al dettaglio: negli spazi commerciali, le soluzioni di IA per la visione possono tenere traccia dell’inventario, controllare le condizioni degli scaffali e ridurre le perdite. Analizzando gli elementi visivi all’interno del negozio, questi sistemi aiutano il personale a capire più facilmente cosa sta accadendo nell’area di vendita e ad apportare modifiche più rapide per mantenere fluide le operazioni.
- Assistenza sanitaria: l’IA per la visione può supportare i professionisti sanitari aiutandoli nell’analisi di immagini mediche, come scansioni o risultati di esami. Può segnalare le aree che potrebbero richiedere un’attenzione maggiore, consentendo ai medici di lavorare in modo più efficiente, lasciando comunque le decisioni finali alle persone.
- Trasporti e città intelligenti: sulle strade e negli spazi pubblici, l’IA per la visione aiuta le città a monitorare il flusso del traffico, rilevare gli incidenti e migliorare ulteriormente la sicurezza. L’analisi in tempo reale dei flussi video delle fotocamere consente di rispondere più rapidamente alle condizioni mutevoli e supporta una gestione migliore delle infrastrutture urbane.
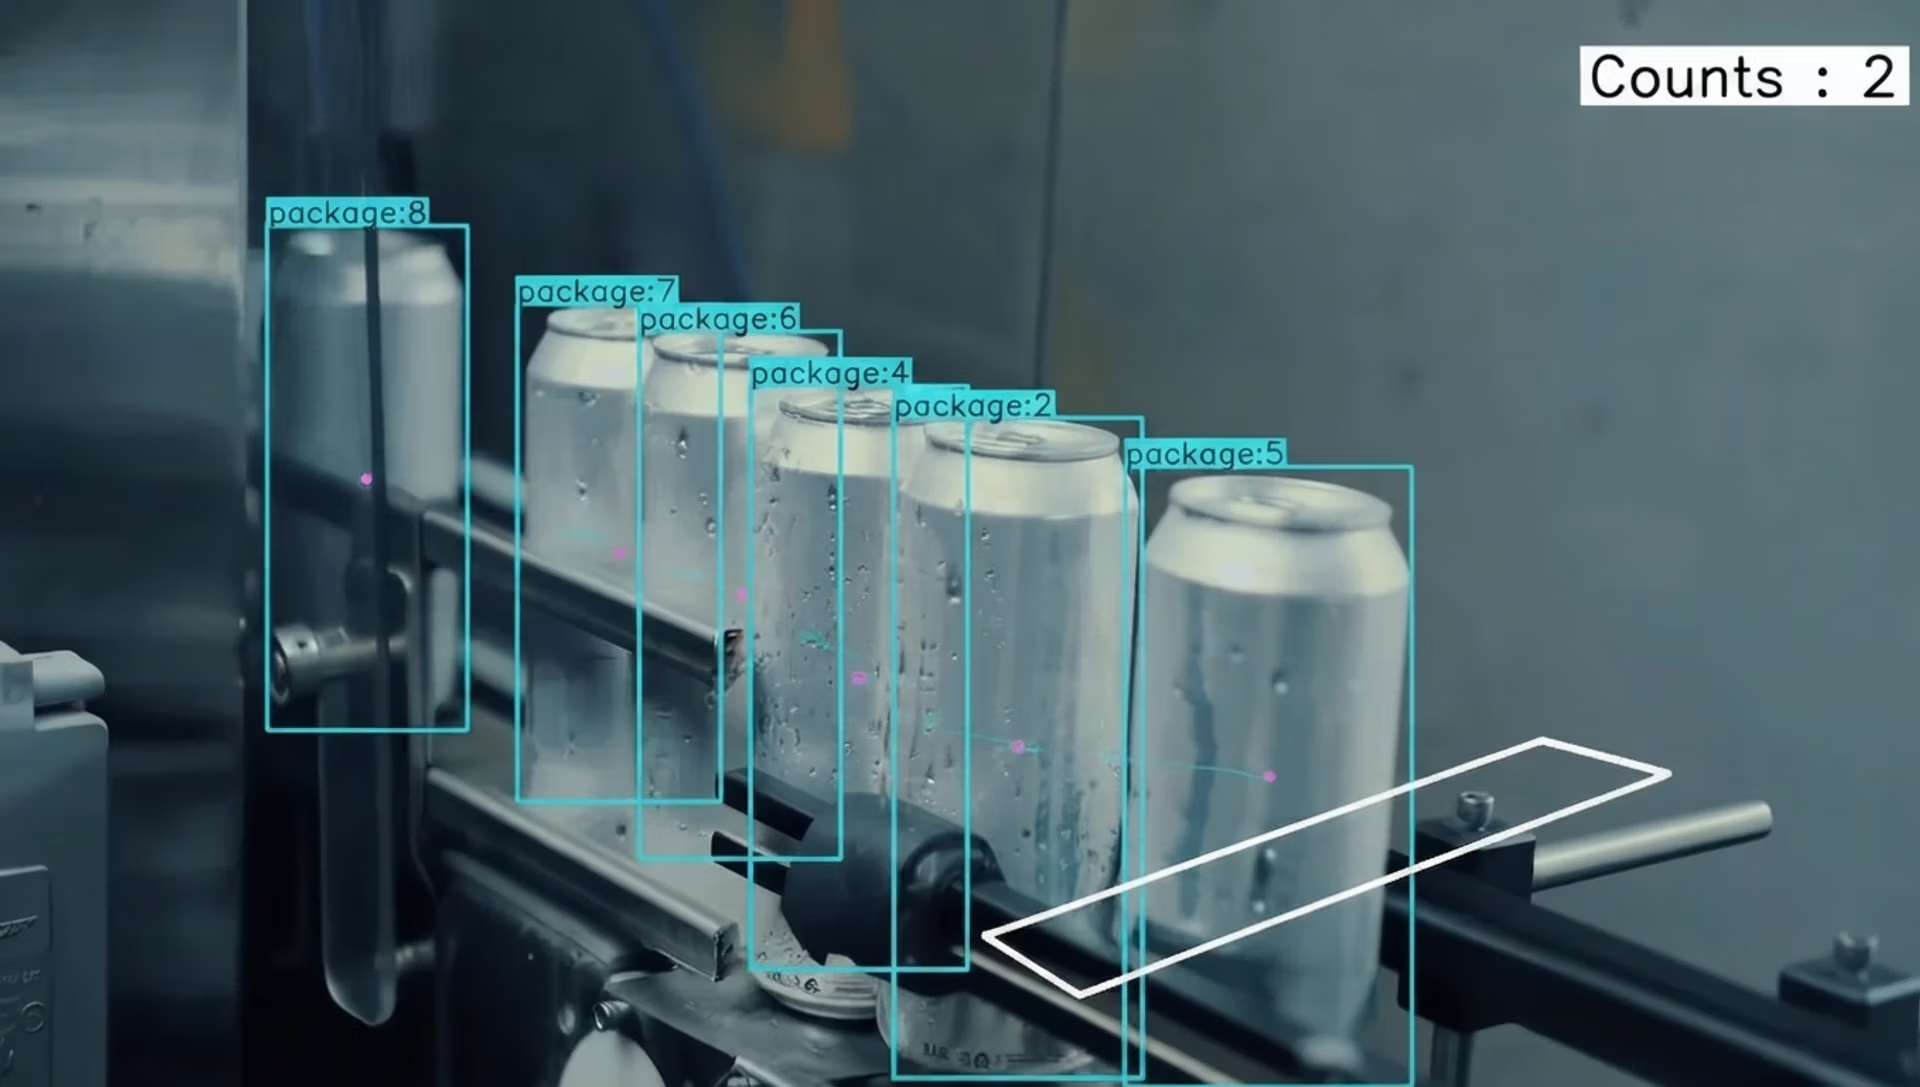
Fig. 4. Monitoraggio automatizzato dei prodotti utilizzando l’IA per la visione nella produzione (Fonte)
Vantaggi e svantaggi degli strumenti di IA per la visione#
Ecco alcuni dei principali vantaggi dell’utilizzo dell’IA per la visione nelle applicazioni del mondo reale:
- Si adatta a diversi casi d’uso: una volta addestrati, i sistemi di IA per la visione possono essere implementati in più sedi o applicazioni con modifiche minime.
- Assistenza IA più rapida: analizzando immagini e video mentre vengono acquisiti, i sistemi basati sull’IA per la visione possono fornire informazioni in tempo reale che supportano risposte più rapide e decisioni migliori.
- Si integra facilmente nei workflow esistenti: gli output dell’IA per la visione possono essere collegati a sistemi downstream, dashboard o pipeline di automazione.
Nonostante questi vantaggi, esistono limitazioni che possono influire sulle prestazioni dei sistemi di IA per la visione. Ecco alcuni fattori da tenere presenti:
- Dipendenza dalla qualità e dalla disponibilità dei dati: i sistemi di IA per la visione dipendono fortemente da dataset ampi e preparati con cura. Raccogliere e mantenere dati visivi di alta qualità può richiedere molto tempo ed essere costoso.
- Sensibilità ai cambiamenti ambientali: le prestazioni possono diminuire quando le fotocamere si spostano, l’illuminazione cambia o le scene variano significativamente senza un nuovo addestramento o un adattamento.
- Requisiti di calcolo e infrastruttura: eseguire modelli di IA per la visione, soprattutto in tempo reale o su larga scala, può richiedere notevoli risorse di calcolo e hardware specializzato.
Punti chiave#
L’IA per la visione trasforma immagini e video in informazioni significative che i sistemi possono comprendere e utilizzare. Questo aiuta ad automatizzare le attività visive e supporta decisioni più rapide e affidabili. La sua efficacia dipende dalla combinazione di modelli capaci, dataset di alta qualità e workflow ben progettati che operano insieme.
Ti interessa l’IA per la visione? Unisciti alla nostra community e scopri di più sulla visione artificiale nell’agricoltura e sull’IA per la visione nel settore automobilistico. Dai un’occhiata alle nostre opzioni di licenza per iniziare a lavorare con la visione artificiale. Visita il nostro repository GitHub per continuare a esplorare l’IA.








