Explorando o cartão do modelo Claude 3: o que isso significa para a IA de visão
Explore o cartão do modelo Claude 3 da Anthropic: o desempenho do Opus, do Sonnet e do Haiku em benchmarks de visão e as limitações nas tarefas de visão computacional.
 Mostafa Ibrahim8 min de leitura
Nos últimos anos, a IA de visão avançou significativamente e transformou setores que vão da saúde ao varejo. Entender os modelos subjacentes e sua documentação é essencial para aproveitar esses avanços com eficácia. Uma ferramenta indispensável para desenvolvedores de IA é o cartão do modelo, que oferece uma visão abrangente das características e do desempenho de um modelo de IA.
Neste artigo, vamos explorar o cartão do modelo Claude 3, desenvolvido pela Anthropic, e suas implicações para o desenvolvimento de IA visual. Claude 3 é uma nova família de modelos multimodais de grande porte, composta por três variantes: Claude 3 Opus, o modelo mais capaz; Claude 3 Sonnet, que equilibra desempenho e velocidade; e Claude 3 Haiku, a opção mais rápida e econômica. Todos os modelos agora contam com recursos de visão, que permitem processar e analisar dados de imagem.
Visão geral do cartão do modelo Claude 3#
Mas, afinal, o que é um cartão de modelo? Um cartão de modelo é um documento detalhado que fornece informações sobre o desenvolvimento, o treinamento e a avaliação de um modelo de aprendizado de máquina. Seu objetivo é promover transparência, responsabilidade e uso ético da IA, apresentando informações claras sobre a funcionalidade do modelo, os casos de uso previstos e as possíveis limitações. Isso é feito fornecendo dados detalhados sobre o modelo, como os resultados da avaliação e a comparação com modelos anteriores e concorrentes.
Métricas de avaliação#
As métricas de avaliação são essenciais para analisar o desempenho dos modelos. O cartão do modelo Claude 3 informa as pontuações em benchmarks padrão do setor, oferecendo uma visão clara dos pontos fortes do modelo e dos aspectos a melhorar. Essas pontuações são comparadas às de outros modelos de destaque, demonstrando o desempenho competitivo do Claude 3.
Além disso, Claude 3 se baseia nos pontos fortes de seus antecessores e incorpora avanços na arquitetura e nas técnicas de treinamento. O cartão do modelo compara Claude 3 com versões anteriores e destaca melhorias na acurácia, na eficiência e na aplicabilidade a novos casos de uso.
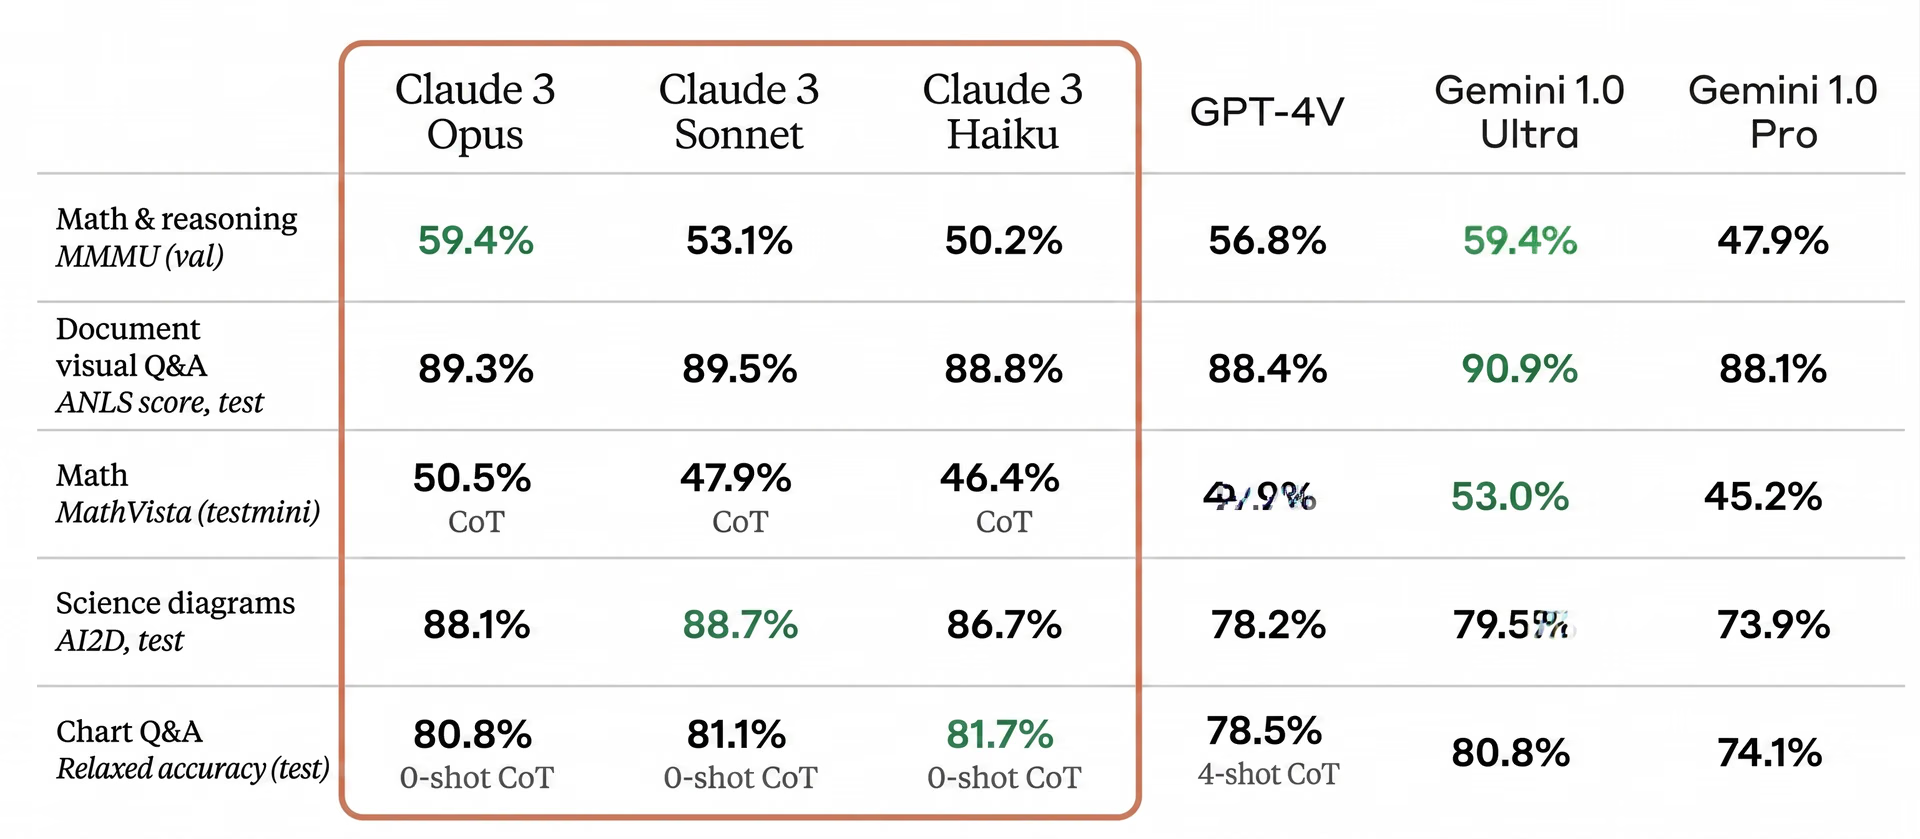
Fig. 1. Tabela que compara os modelos Claude 3 com outros modelos em várias tarefas.
Como Claude 3 está afetando o desenvolvimento de IA visual#
A arquitetura e o processo de treinamento do Claude 3 resultam em um desempenho confiável em várias tarefas de Processamento de Linguagem Natural (NLP) e tarefas visuais. O modelo apresenta resultados consistentemente sólidos em benchmarks, demonstrando sua capacidade de realizar análises linguísticas complexas com eficácia.
O treinamento do Claude 3 com conjuntos de dados diversos garante sua robustez e capacidade de generalização em diferentes cenários. Isso torna o modelo versátil e eficaz em uma ampla variedade de aplicações.
Embora seus resultados sejam notáveis, Claude 3 é fundamentalmente um Modelo de Linguagem de Grande Escala (LLM). Embora LLMs como Claude 3 possam executar várias tarefas de visão computacional, eles não foram projetados especificamente para tarefas como detecção de objetos, criação de caixas delimitadoras e segmentação de imagens. Por isso, a precisão nessas áreas pode não se equiparar à de modelos criados especificamente para visão computacional, como o Ultralytics YOLOv8. Ainda assim, os LLMs se destacam em outros domínios, especialmente no Processamento de Linguagem Natural (NLP), área em que Claude 3 demonstra grande capacidade ao combinar tarefas visuais simples com o raciocínio humano.
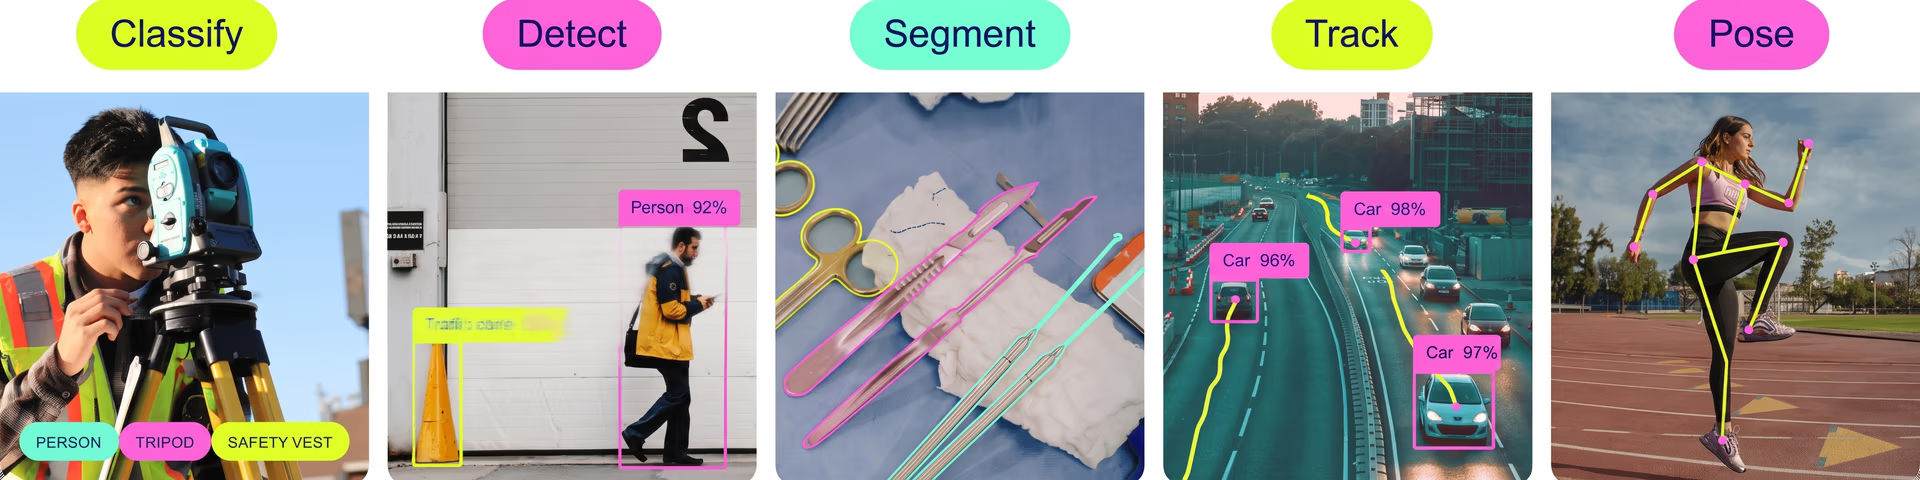
Fig. 2. Visão geral da classificação, detecção, segmentação e rastreamento de objetos e da estimativa de pose usando Ultralytics YOLOv8.
Os recursos de NLP referem-se à capacidade de um modelo de IA de entender e responder à linguagem humana. Claude 3 aproveita amplamente esse recurso em suas aplicações no campo visual, o que lhe permite gerar descrições ricas em contexto, interpretar dados visuais complexos e melhorar o desempenho geral em tarefas de IA visual.
Conversão de imagem em texto#
Um dos recursos impressionantes do Claude 3, especialmente em tarefas de IA visual, é sua capacidade de processar e converter em texto imagens de baixa qualidade com escrita à mão difícil de ler. Esse recurso demonstra o poder avançado de processamento e as capacidades de raciocínio multimodal do modelo. Nesta seção, vamos explorar como Claude 3 realiza essa tarefa, destacando os mecanismos subjacentes e as implicações para o desenvolvimento de IA visual.
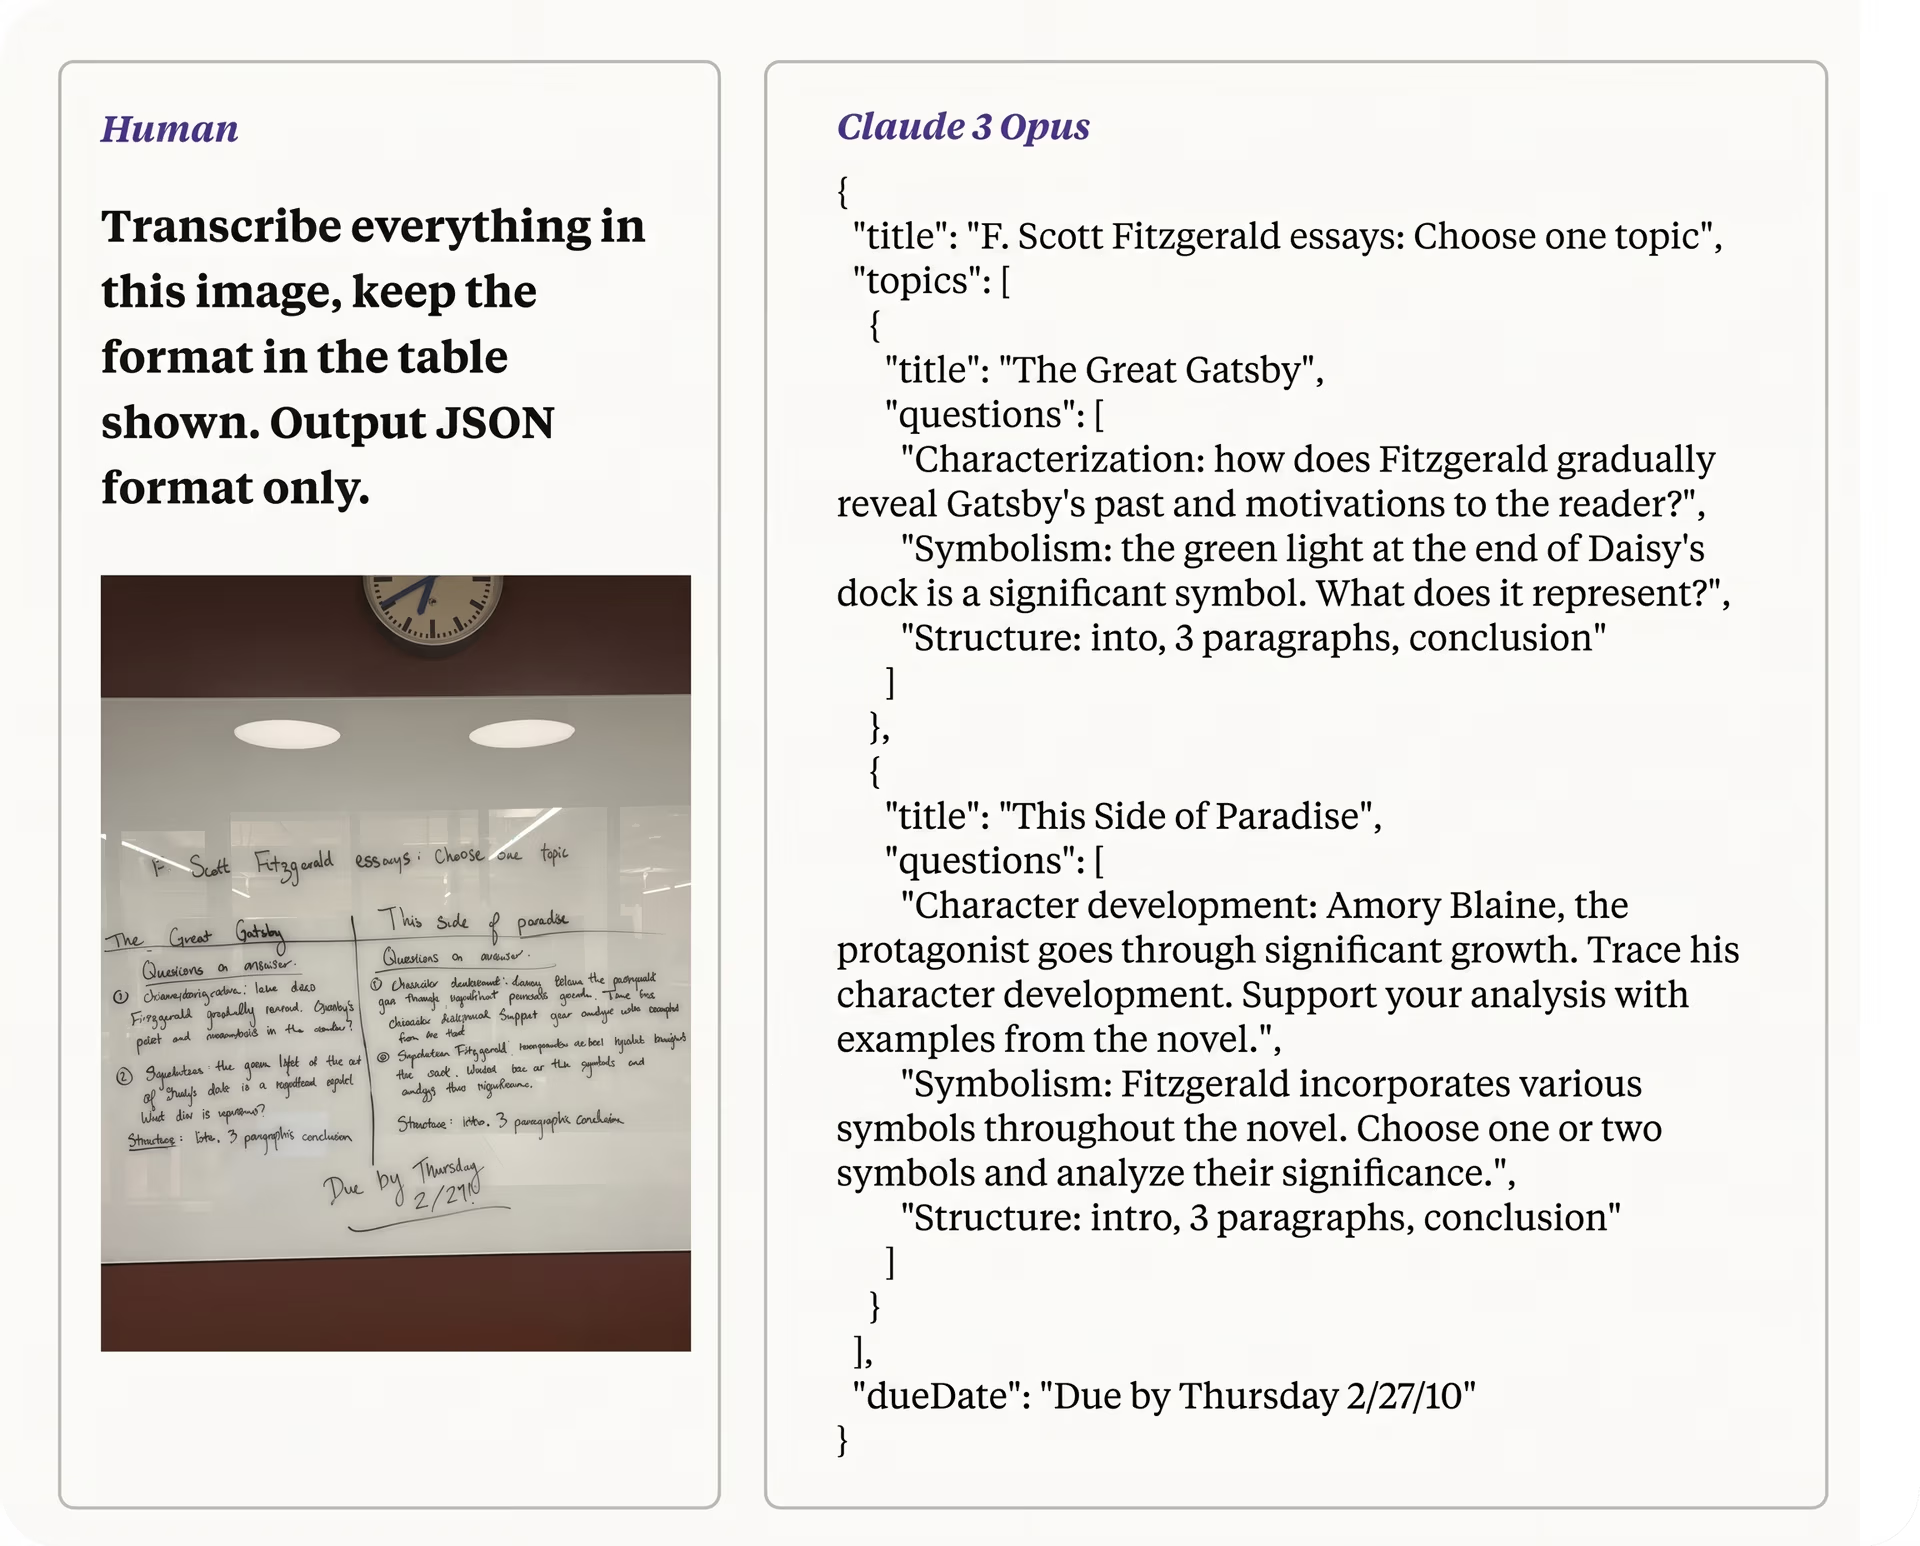
Fig. 3. Claude 3 Opus convertendo em texto uma foto de baixa qualidade com escrita à mão difícil de ler.
Entendendo o desafio#
Converter em texto uma foto de baixa qualidade com escrita à mão difícil de ler é uma tarefa complexa que envolve vários desafios:
- Qualidade da imagem: baixa resolução, ruído e iluminação inadequada podem ocultar detalhes da imagem.
- Variação da escrita à mão: os estilos de escrita à mão variam bastante entre as pessoas, dificultando o reconhecimento e a interpretação do texto pelos modelos.
- Compreensão contextual: converter a escrita à mão em texto com precisão exige entender o contexto para resolver ambiguidades.
Como mencionado anteriormente, os modelos Claude 3 enfrentam esses desafios combinando técnicas avançadas de visão computacional e processamento de linguagem natural (NLP).
Raciocínio visual (multimodal)#
A arquitetura do Claude 3 permite executar tarefas complexas de raciocínio usando entradas visuais. Por exemplo, como mostra a Fig. 4, o modelo pode interpretar gráficos e diagramas, identificar países do G7 em um gráfico sobre o uso da internet, extrair dados relevantes e fazer cálculos para analisar tendências. Esse raciocínio em várias etapas, como calcular diferenças estatísticas no uso da internet entre faixas etárias, aumenta a precisão e a utilidade do modelo em aplicações do mundo real.
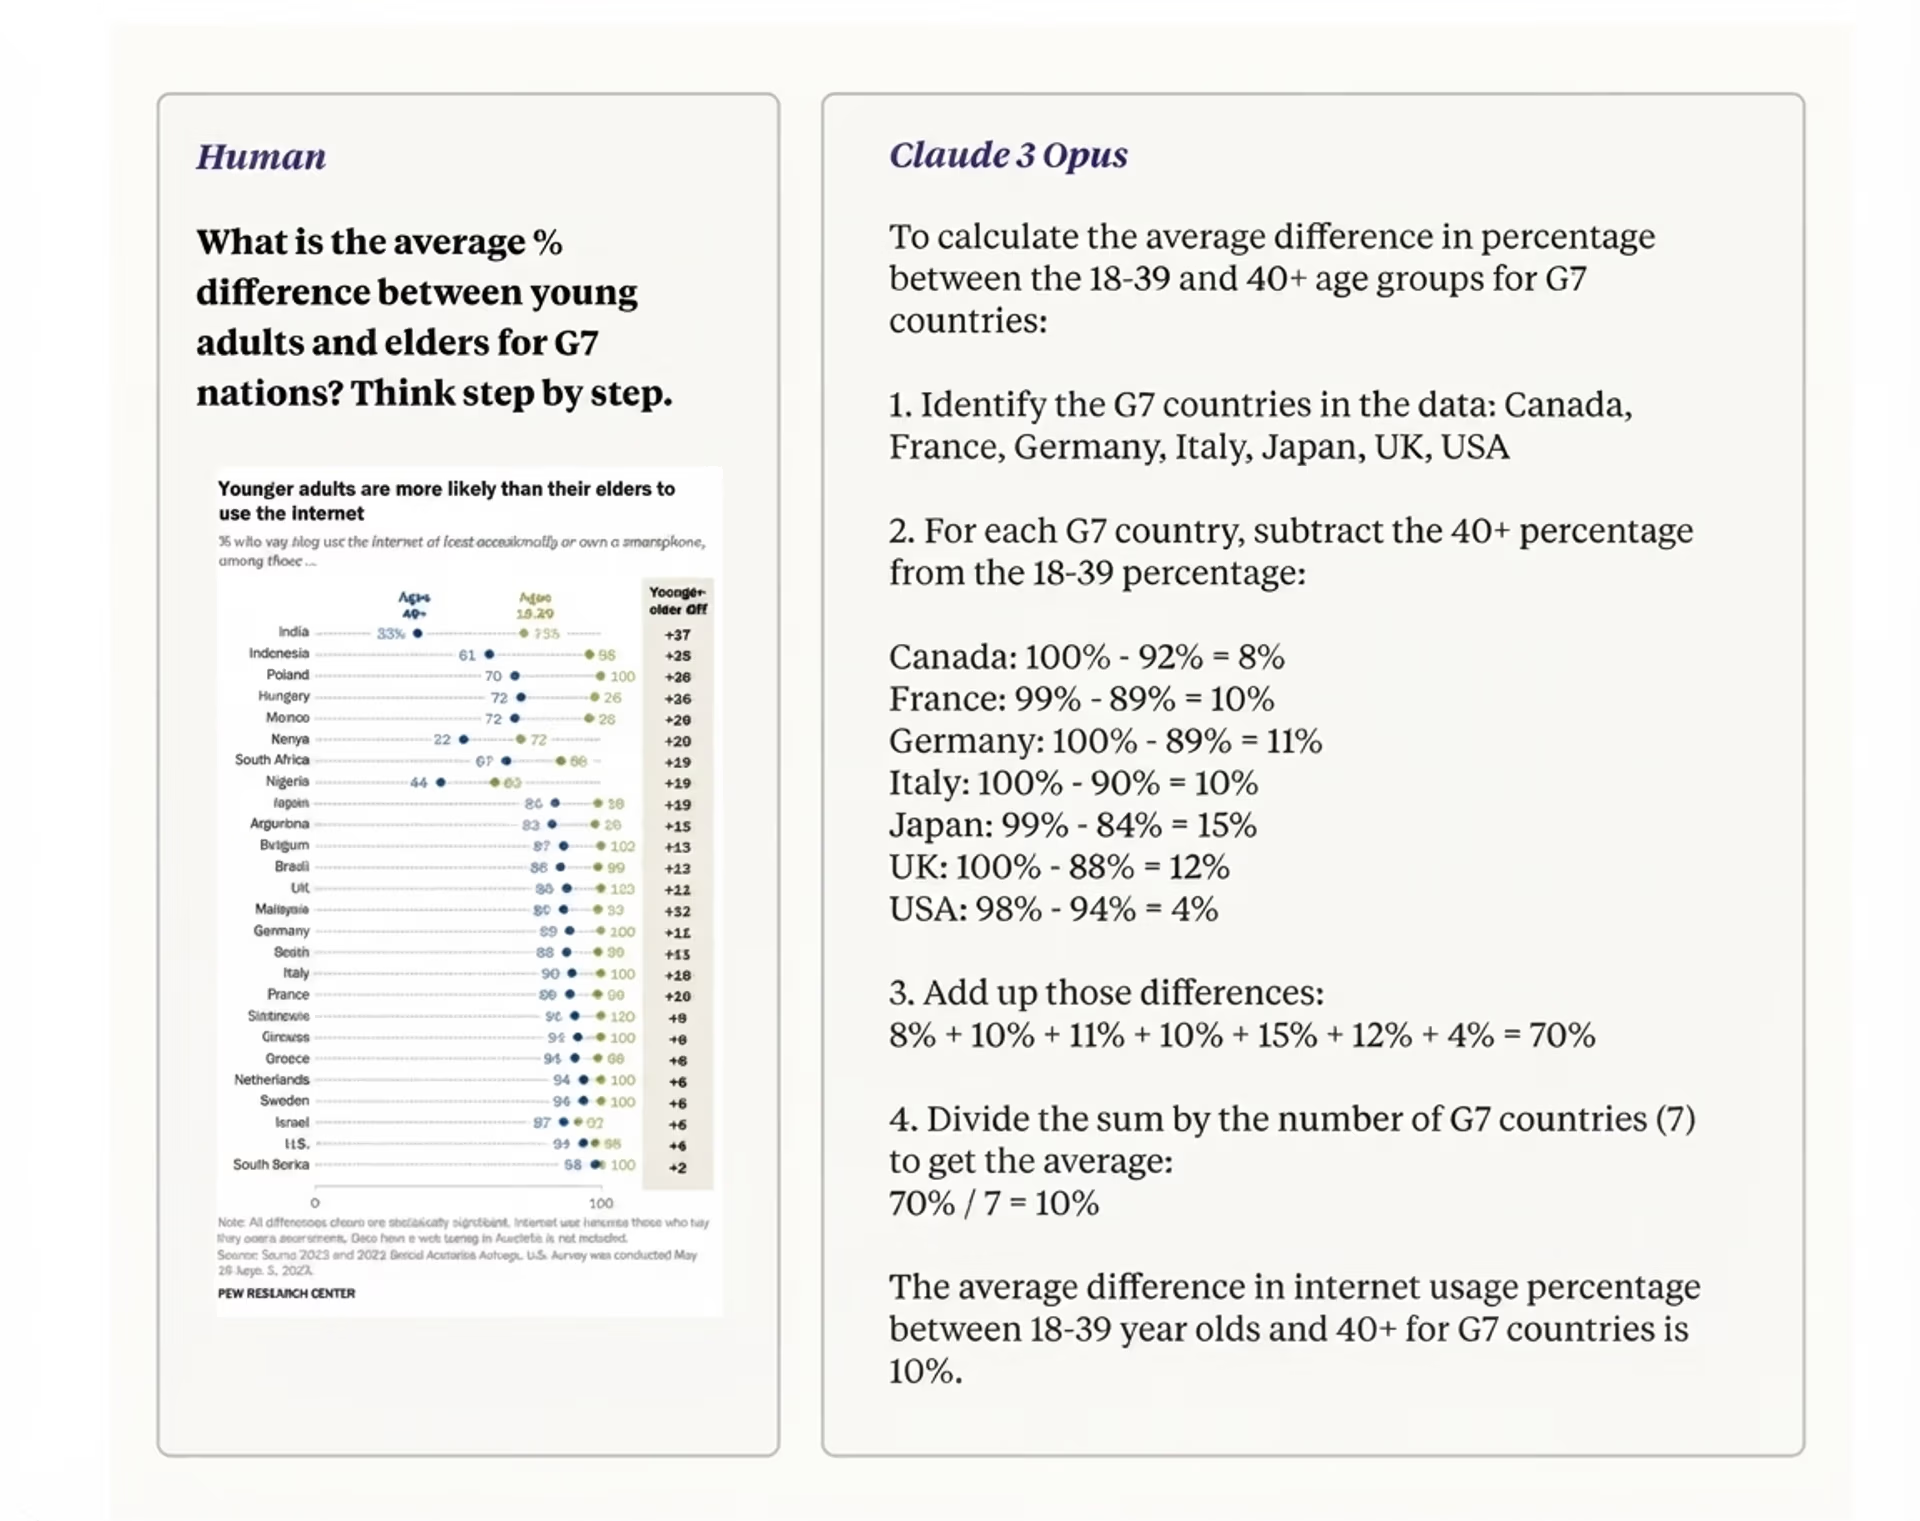
Fig. 4. Claude 3 Opus realizando tarefas de raciocínio em várias etapas com um gráfico visual.
Descrevendo imagens#
O Claude 3 se destaca por transformar imagens em descrições detalhadas, demonstrando seus recursos avançados tanto em visão computacional quanto em processamento de linguagem natural. Ele consegue gerar descrições precisas e ricas em contexto não apenas identificando objetos, mas também compreendendo as interações entre eles e sua importância na cena.
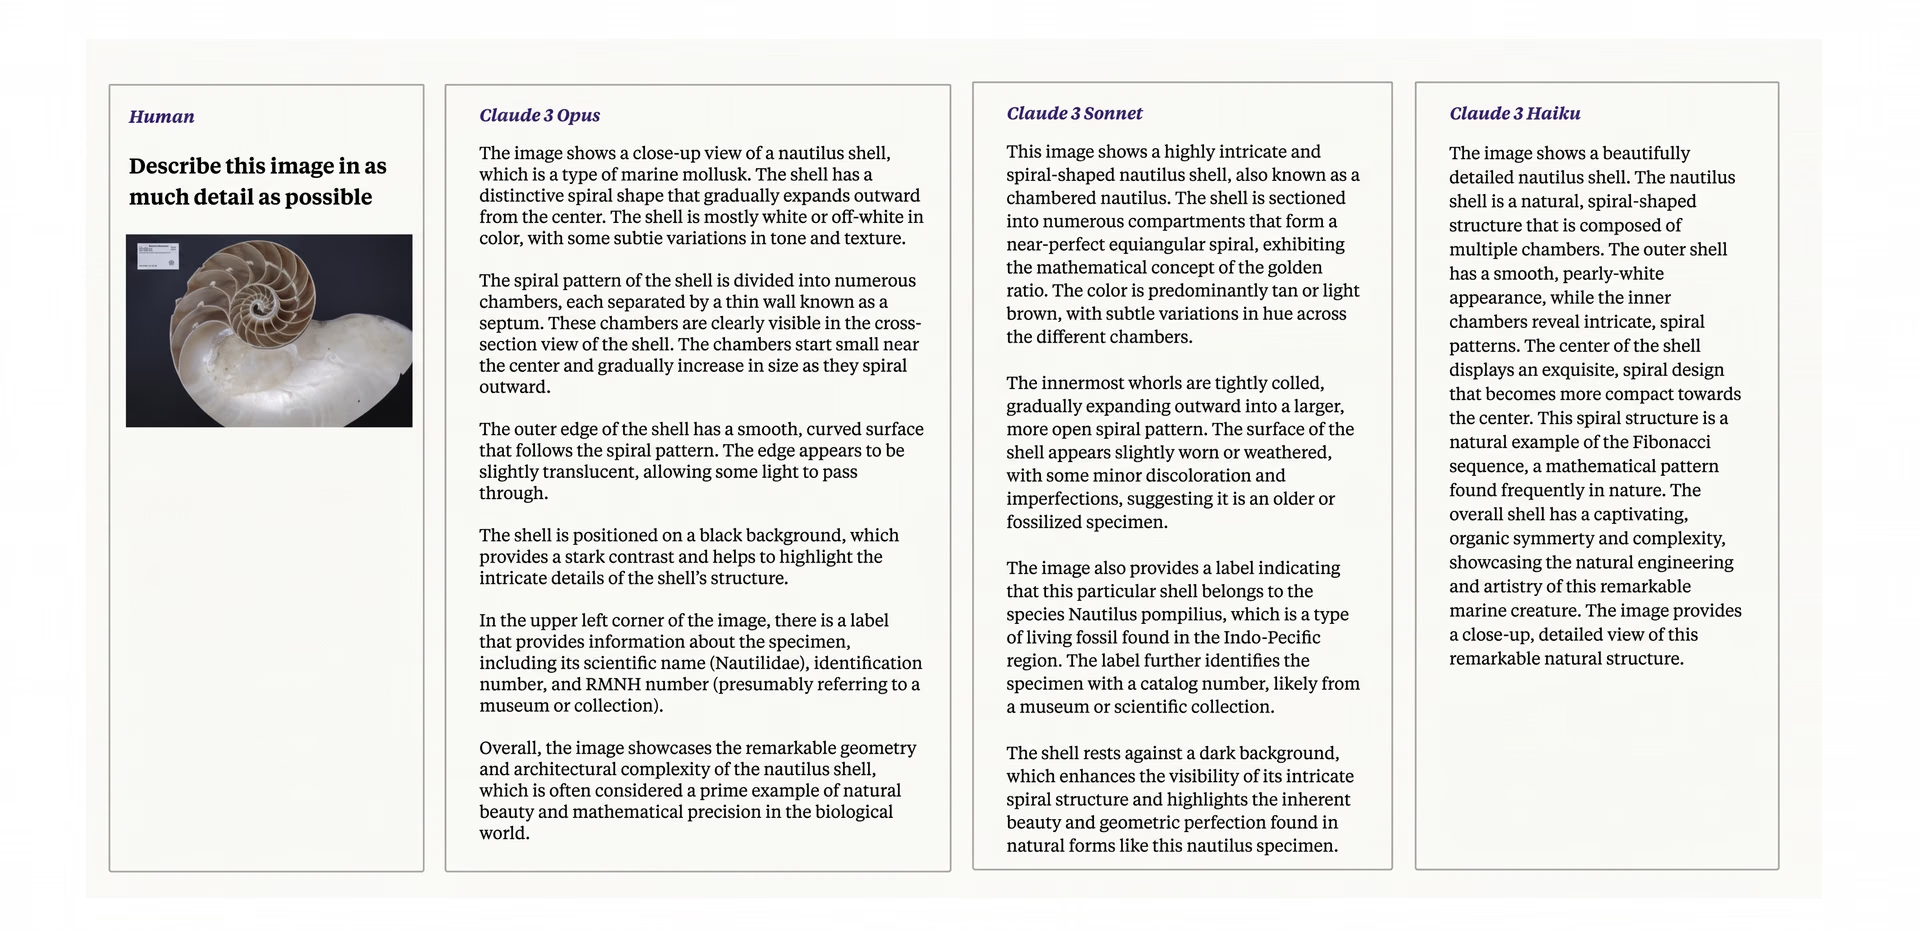
Fig. 5. Modelos Claude 3 reconhecendo objetos visuais em uma imagem e descrevendo-os em linguagem compreensível para as pessoas.
Desafios e limitações dos modelos Claude 3 em visão computacional#
Não é voltado para visão computacional#
Modelos de linguagem de grande escala (LLMs), como Claude 3, se destacam no processamento de linguagem natural, não em visão computacional. Embora possam descrever imagens, tarefas como detecção de objetos e segmentação de imagens são mais adequadas a modelos voltados à visão, como o Ultralytics YOLOv8. Esses modelos especializados são otimizados para tarefas visuais e oferecem melhor desempenho na análise de imagens. Além disso, Claude 3 não consegue executar tarefas como criar caixas delimitadoras.
Complexidade de integração#
Combinar o Claude 3 com sistemas de visão computacional pode ser complexo e exigir etapas adicionais de processamento para preencher a lacuna entre dados textuais e visuais.
Limitações dos dados de treinamento#
Claude 3 é treinado principalmente com grandes quantidades de dados textuais, o que significa que não dispõe dos extensos conjuntos de dados visuais necessários para alcançar alto desempenho em tarefas de visão computacional. Assim, embora Claude 3 se destaque na compreensão e geração de texto, ele não consegue processar ou analisar imagens com a mesma proficiência de modelos projetados especificamente para dados visuais. Essa limitação o torna menos eficaz em aplicações que exigem interpretar ou gerar conteúdo visual.
O potencial futuro do Claude 3 na IA para visão#
Assim como outros modelos de linguagem grandes, Claude 3 deve continuar evoluindo. As melhorias futuras provavelmente se concentrarão em tarefas visuais melhores, como detecção de imagens e reconhecimento de objetos, além de avanços em tarefas de processamento de linguagem natural. Isso permitirá descrições mais precisas e detalhadas de objetos e cenas, entre outras tarefas semelhantes. Modelos Claude mais recentes, como Claude Opus 5.5 e Claude Haiku 5.5, conseguem detectar objetos com caixas delimitadoras, e os resultados do benchmark VLM mostram como se comparam a outros modelos de linguagem visual.
Por fim, as pesquisas em andamento sobre o Claude 3 priorizarão o aumento da interpretabilidade, a redução de vieses e a melhoria da generalização em diversos conjuntos de dados. Esses esforços garantirão o desempenho robusto do modelo em várias aplicações e promoverão confiança e confiabilidade nos resultados.
Considerações finais#
O cartão do modelo Claude 3 é um recurso valioso para desenvolvedores e partes interessadas em IA para visão, pois fornece informações detalhadas sobre a arquitetura, o desempenho e as considerações éticas do modelo. Ao promover transparência e responsabilidade, ele ajuda a garantir o uso responsável e eficaz das tecnologias de IA. À medida que a IA para visão continua evoluindo, cartões de modelo como o do Claude 3 serão fundamentais para orientar o desenvolvimento e promover a confiança nos sistemas de IA.
Na Ultralytics, somos apaixonados por avançar a tecnologia de IA. Para conhecer nossas soluções de IA e acompanhar as nossas inovações mais recentes, visite nosso repositório do GitHub. Participe da nossa comunidade no Discord e descubra como estamos transformando setores como o de carros autônomos e o de manufatura!
Escrito por
Engenheiro de software e redator técnico · Freelancer
Comentários
Faça uma pergunta, compartilhe seus resultados ou ajude alguém.









