Como treinar Ultralytics YOLO26 com dados personalizados para segmentação de instâncias
Saiba como treinar Ultralytics YOLO26 com dados personalizados para segmentação de instâncias, na qual o modelo identifica e separa cada objeto individual usando máscaras em nível de pixel.
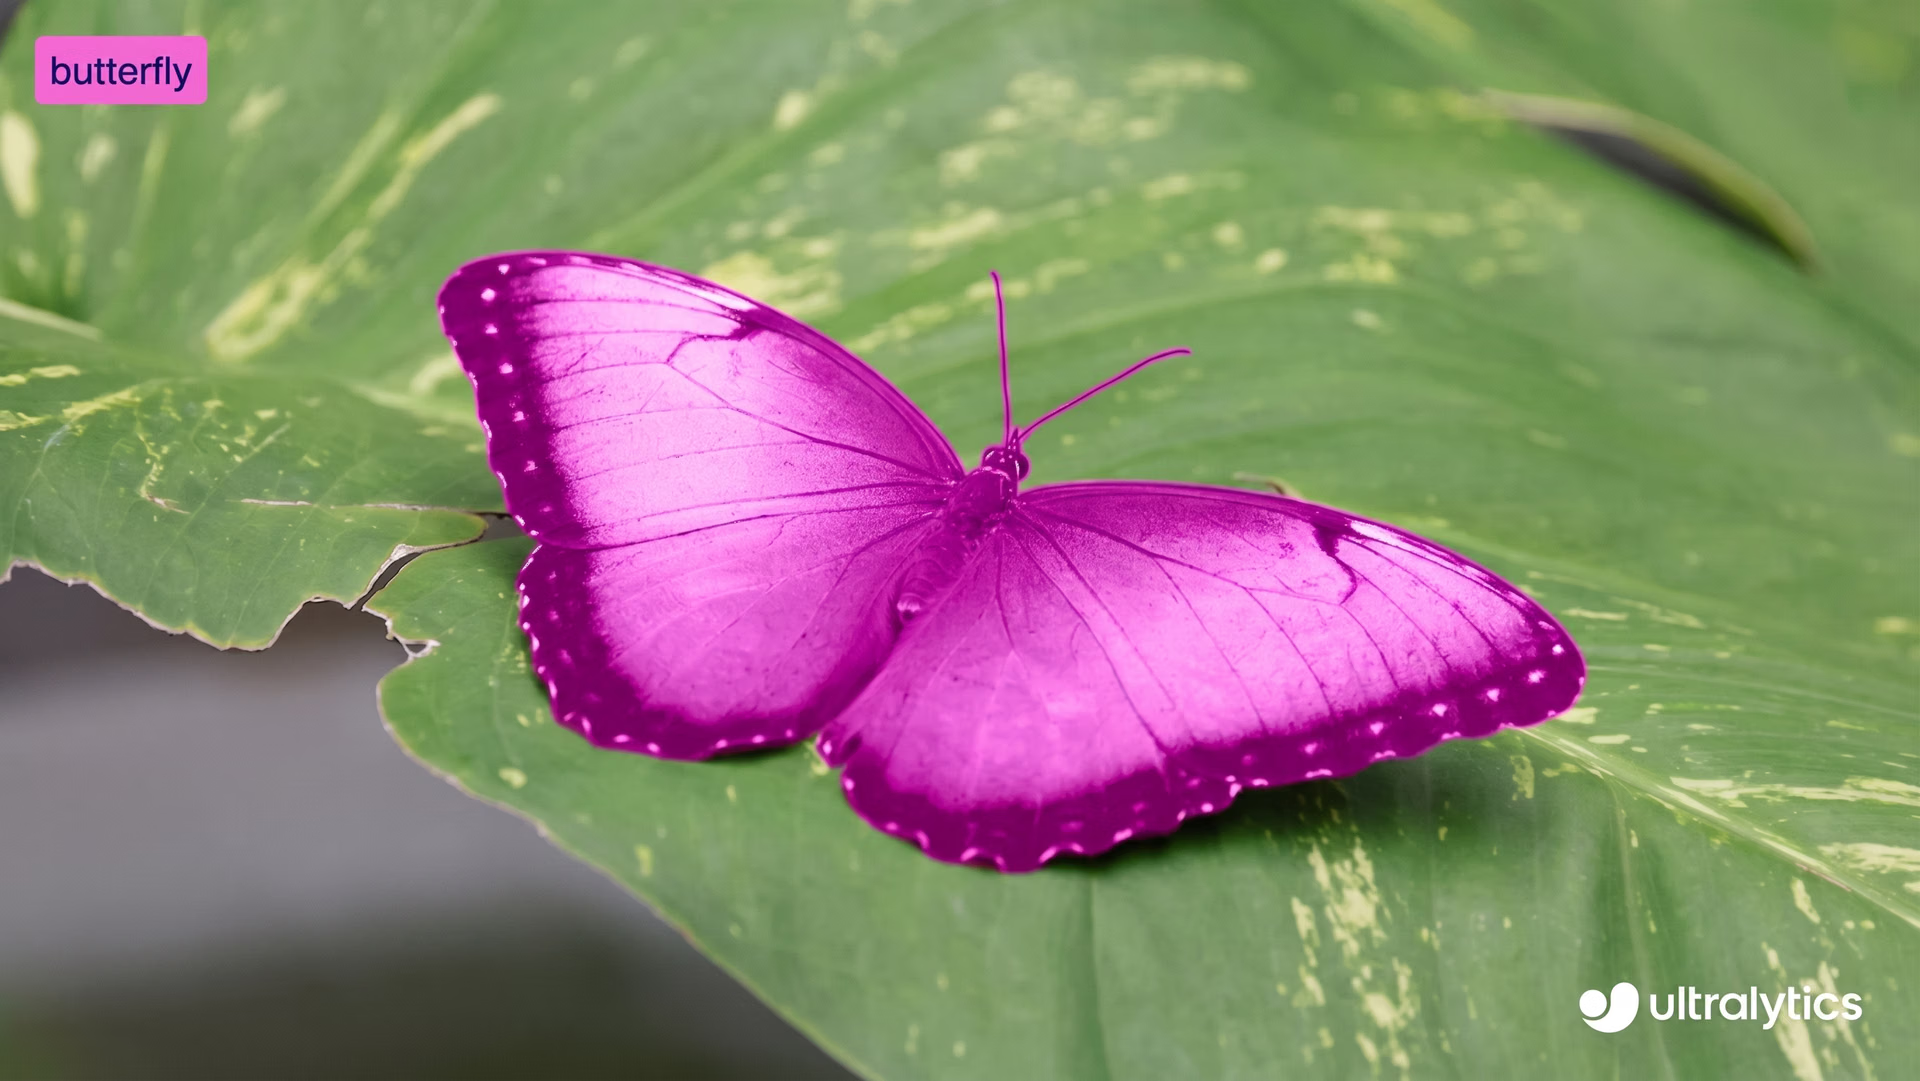
Graças aos avanços tecnológicos recentes, muitos sistemas inteligentes que têm um papel discreto, mas importante, em nossas vidas são alimentados por IA. Por exemplo, quando um carro ultrapassa o sinal vermelho e uma câmera registra automaticamente a infração, ou quando um sistema automatizado de inspeção de qualidade detecta um defeito de fabricação em uma linha de produção, é a IA que trabalha nos bastidores.
Em particular, um ramo da IA conhecido como visão computacional permite que as máquinas interpretem e compreendam imagens e vídeos. A visão computacional permite que os sistemas reconheçam objetos, rastreiem movimentos e analisem detalhes visuais em tempo real, tornando-a essencial para aplicações como monitoramento do trânsito, inspeção industrial e robótica.
Esses recursos são possíveis graças a modelos de visão computacional, como o Ultralytics YOLO26, que oferece suporte a várias tarefas de visão, incluindo detecção de objetos e segmentação de instâncias. Enquanto a detecção de objetos identifica objetos usando caixas delimitadoras simples, a segmentação de instâncias vai além e contorna cada objeto no nível do pixel, permitindo resultados mais precisos e confiáveis em situações do mundo real.
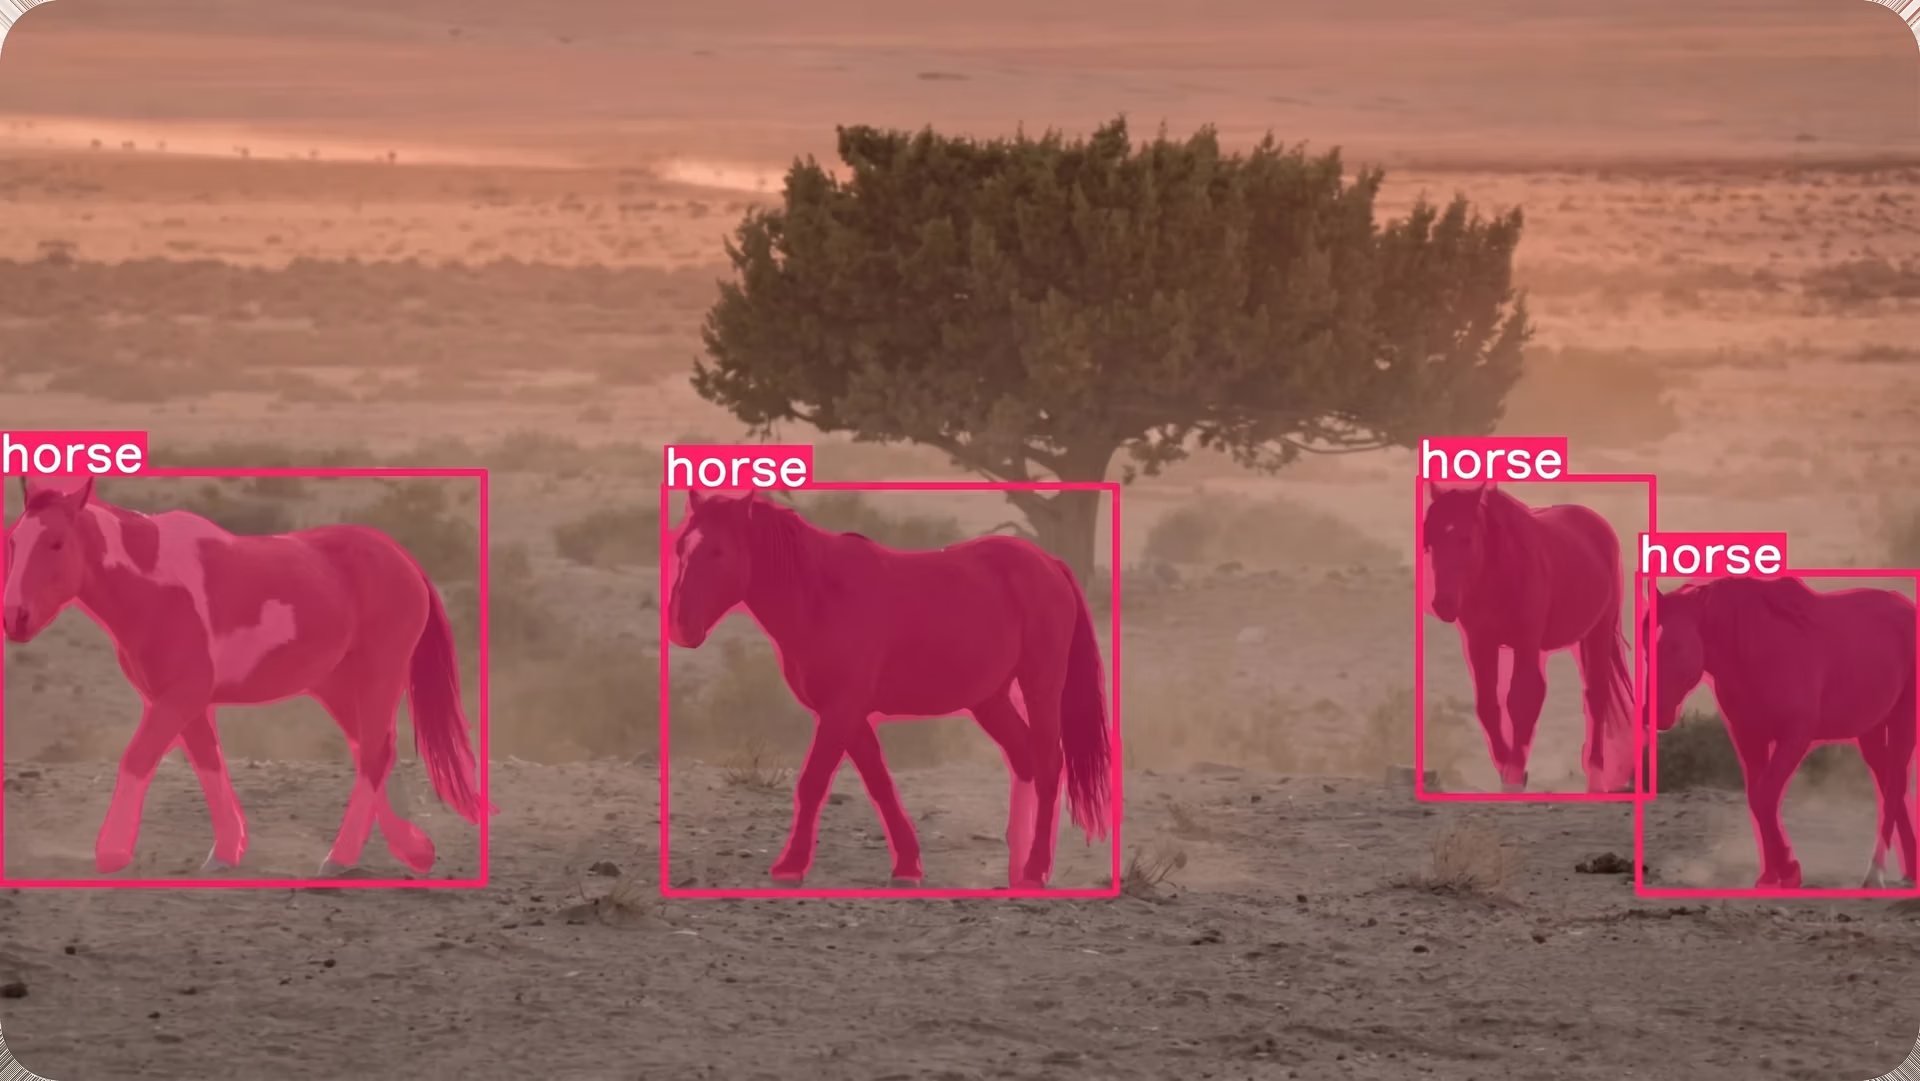
Fig. 1. Segmentação de objetos em uma imagem usando o Ultralytics YOLO26
Modelos como o Ultralytics YOLO26 são pré-treinados e já conseguem segmentar objetos do dia a dia, como pessoas, carros e animais. No entanto, eles também podem ser treinados de forma personalizada para aplicações mais específicas. Em outras palavras, os modelos podem aprender a reconhecer a aparência dos objetos e a contorná-los com precisão.
Neste artigo, vamos mostrar como treinar o Ultralytics YOLO26 de forma personalizada para segmentação de instâncias. Vamos começar!
O que é a segmentação de instâncias?#
Antes de entrarmos no treinamento de modelos, vamos dar um passo atrás e entender o que realmente significa segmentação de instâncias.
A segmentação de instâncias é uma tarefa de visão computacional que permite a um modelo encontrar cada objeto individual em uma imagem e contornar seu formato exato. Em vez de apenas identificar a presença de um objeto, o modelo analisa cada pixel da imagem e decide se ele pertence a um objeto específico.
Isso significa que ele consegue separar objetos mesmo quando estão sobrepostos ou muito próximos uns dos outros. Um conceito fundamental que facilita a visualização da segmentação de instâncias é a máscara.
Uma máscara é um contorno no nível do pixel que cobre apenas a área de um objeto. Você pode imaginá-la como se estivesse colorindo o objeto com um marca-texto, sem tocar em mais nada.
Cada objeto recebe sua própria máscara, o que permite ao modelo distingui-lo dos demais, mesmo quando são do mesmo tipo, como dois carros ou duas pessoas lado a lado.
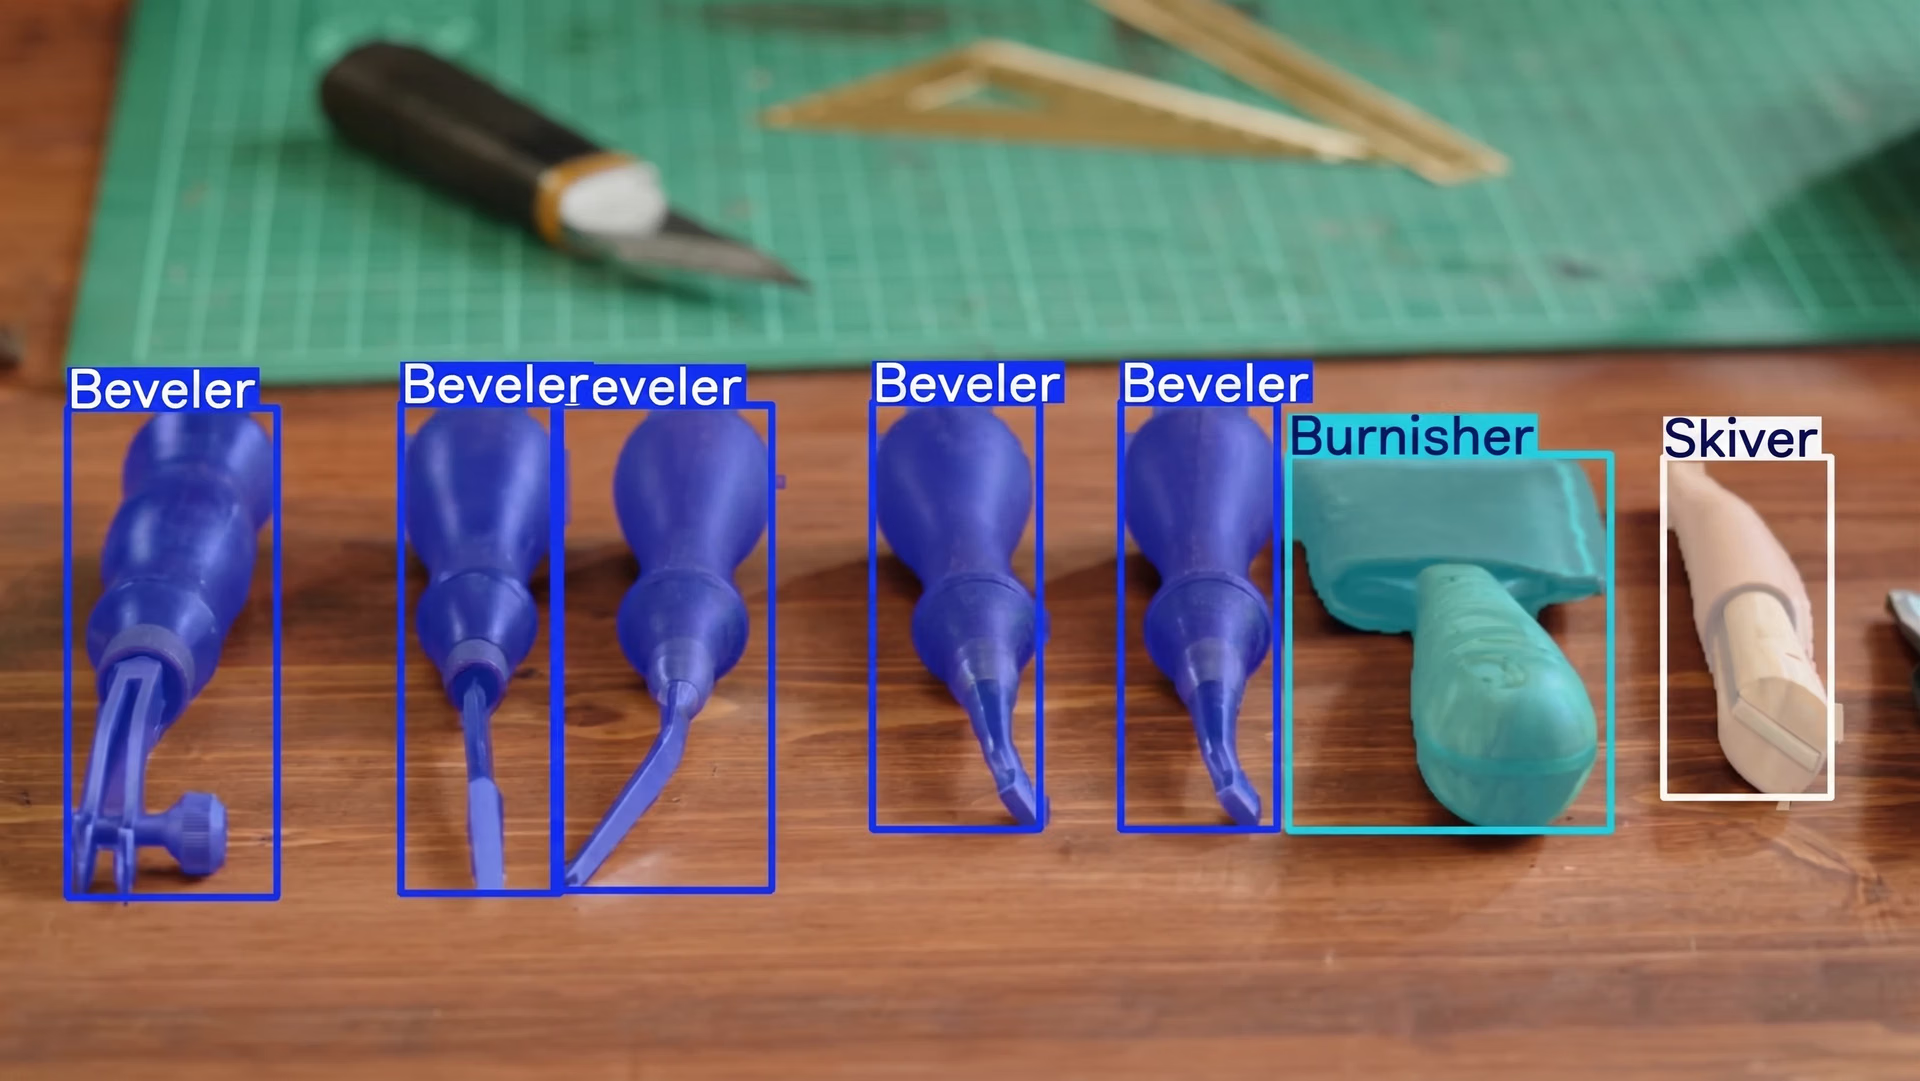
Fig. 2. Um exemplo de segmentação de instâncias
Para entender melhor o que é segmentação de instâncias, podemos compará-la com outras tarefas comuns de visão computacional. A detecção de objetos usa caixas delimitadoras, que são retângulos simples desenhados ao redor dos objetos. As caixas delimitadoras são rápidas e úteis, mas não capturam o formato exato de um objeto.
Já a segmentação semântica classifica cada pixel da imagem por categoria, mas não distingue objetos separados da mesma classe. A segmentação de instâncias combina o melhor das duas abordagens: identifica as categorias dos objetos e atribui uma máscara separada a cada objeto individual.
Como a segmentação de instâncias fornece informações tão detalhadas, ela é especialmente útil em aplicações do mundo real, como inspeção automatizada de qualidade, diagnóstico por imagem e robótica. Tarefas que exigem medições precisas, limites exatos ou separação de objetos podem se beneficiar dessa compreensão no nível do pixel.
O Ultralytics YOLO26 oferece suporte à segmentação de instâncias#
O Ultralytics YOLO26 é um modelo de visão computacional de ponta, de ponta a ponta e sem supressão não máxima (NMS), projetado para lidar com tarefas visuais do mundo real de forma rápida e eficiente. Ele faz parte da família de modelos de detecção YOLO da Ultralytics, capazes de processar imagens e vídeos em tempo real e fornecer resultados precisos.
O Ultralytics YOLO26 oferece suporte a várias tarefas de visão em um único framework, incluindo detecção de objetos, estimativa de pose, classificação de imagens, detecção de caixas delimitadoras orientadas (detecção OBB) e segmentação de instâncias.
O Ultralytics YOLO26 já vem pré-treinado, ou seja, aprendeu a reconhecer objetos comuns, como pessoas, veículos e itens do dia a dia, usando grandes conjuntos de dados amplamente utilizados, como COCO e ImageNet. Você pode começar a usar o modelo imediatamente, sem nenhum treinamento adicional.
No entanto, quando sua aplicação envolve objetos únicos, ambientes específicos ou condições de iluminação incomuns, o treinamento personalizado de modelos pode melhorar significativamente os resultados. Ao treinar o Ultralytics YOLO26 com suas próprias imagens anotadas, você pode ensinar ao modelo exatamente o que procurar e como contornar os objetos com mais precisão para seu caso de uso específico.
Esse processo também é chamado de ajuste fino. Em vez de treinar um modelo do zero, o ajuste fino começa com um modelo Ultralytics YOLO26 pré-treinado e o adapta gradualmente usando seus próprios dados. Como o modelo já entende padrões visuais gerais, como bordas, formas e texturas, ele precisa de muito menos imagens anotadas e de bem menos tempo para aprender a reconhecer seus objetos específicos.
Em resumo, o ajuste fino é mais rápido, eficiente e acessível do que treinar um modelo desde o início. O treinamento personalizado do Ultralytics YOLO26 é uma opção prática até mesmo para iniciantes ou equipes com dados e recursos computacionais limitados.
Conheça as aplicações de segmentação de instâncias do Ultralytics YOLO26#
Então, em quais situações a segmentação de instâncias pode ser útil? Nos casos em que é importante distinguir os objetos e entender seus formatos exatos, especialmente quando há aglomeração ou sobreposição.
Veja alguns fluxos de trabalho comuns nos quais a segmentação de instâncias faz diferença:
- Imagens aéreas e de drones: essa tarefa permite que drones separem objetos como edifícios, veículos e vegetação em imagens aéreas para mapeamento, inspeção e levantamento topográfico.
- Análise esportiva: a segmentação de instâncias ajuda a analisar os movimentos e as interações dos jogadores ao separar cada atleta do plano de fundo durante jogos ou sessões de treinamento.
- Monitoramento de construções e infraestrutura: ajuda a identificar elementos estruturais, rachaduras ou áreas danificadas em edifícios, pontes e estradas para o planejamento da manutenção.
- Saúde e diagnóstico por imagem: a segmentação de instâncias permite contornar com precisão células, tecidos ou instrumentos médicos, contribuindo para análises e diagnósticos mais precisos.
- Agricultura e monitoramento ambiental: ela pode identificar e separar plantações, frutas ou doenças nas plantas, facilitando a estimativa da produtividade e a aplicação de tratamentos direcionados.
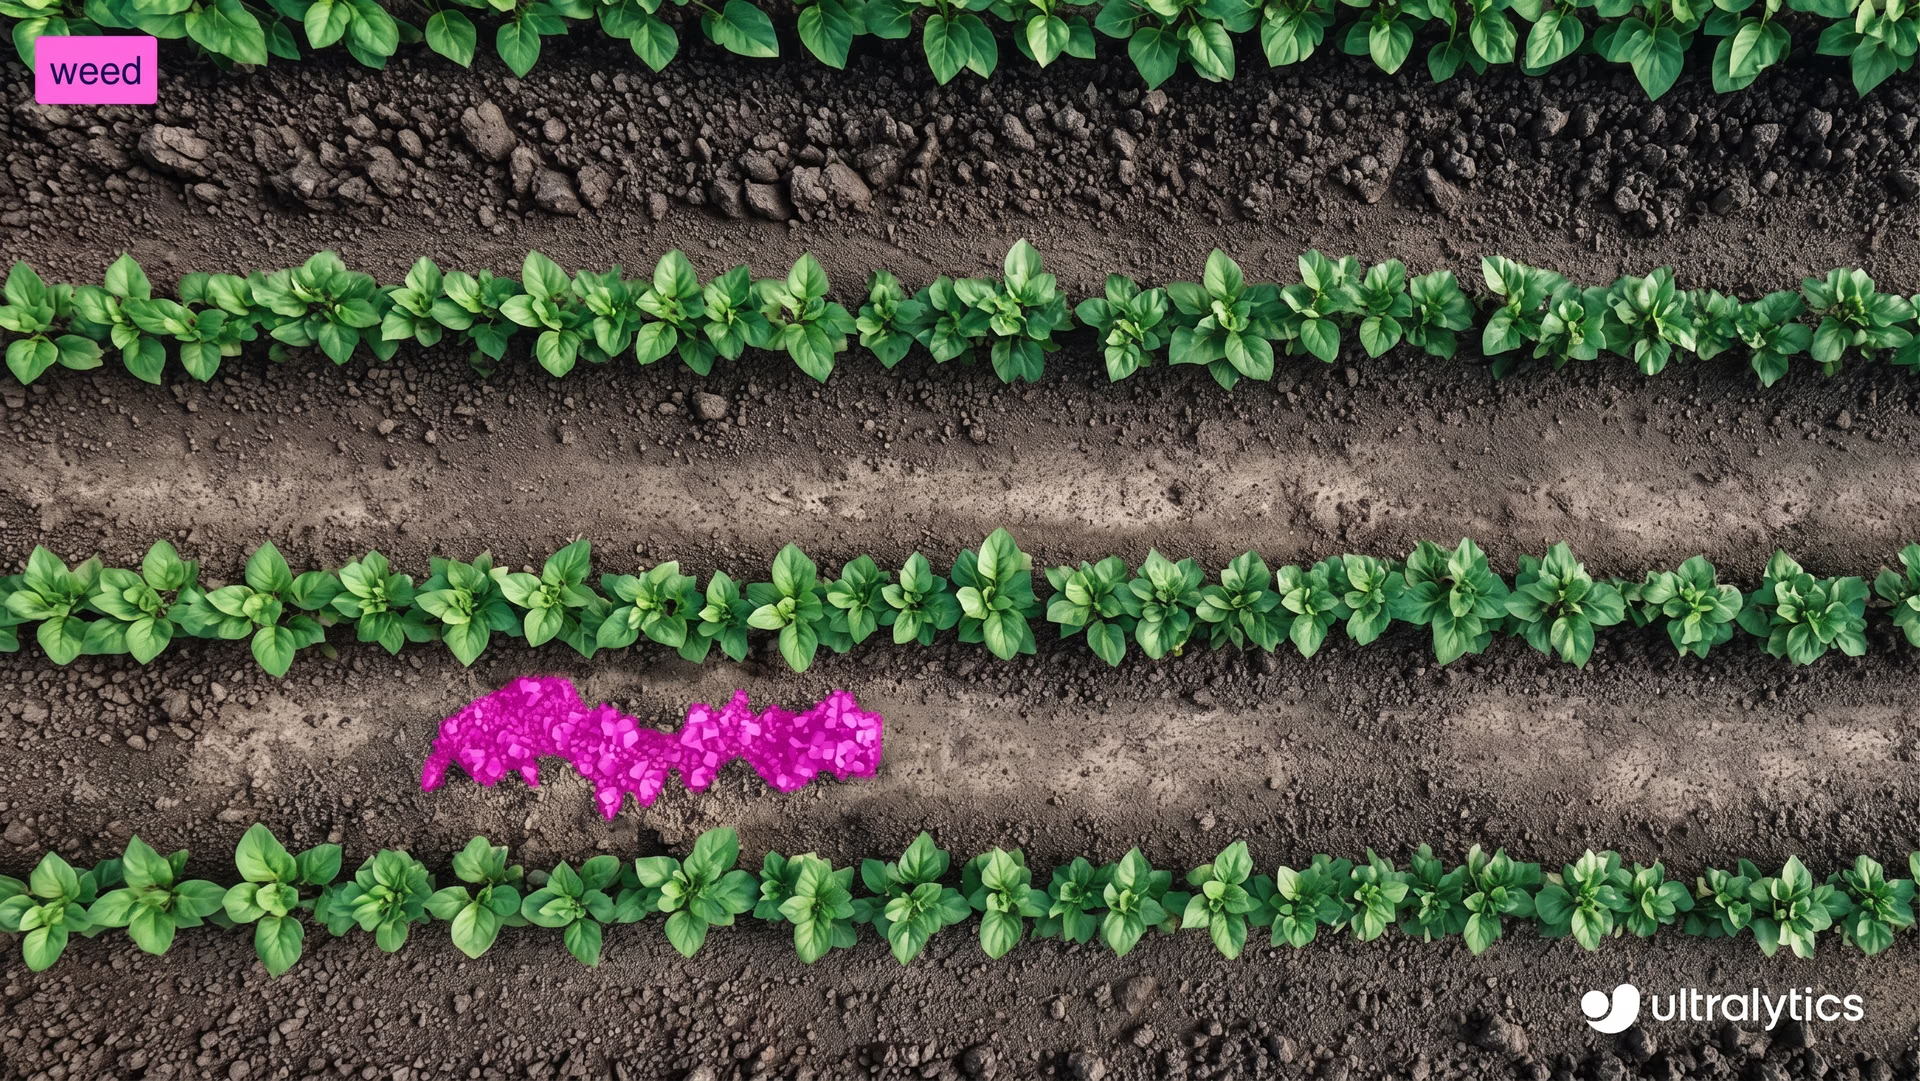
Fig. 3. Exemplo de segmentação de ervas daninhas usando o YOLO26 (Fonte)
Como funciona o treinamento personalizado do Ultralytics YOLO26 para segmentação de instâncias#
Agora, vamos falar sobre como funciona o treinamento personalizado. Embora treinar um modelo possa parecer algo técnico, o processo geral é simples.
Você pode preparar suas imagens, anotar os objetos que quer ensinar o modelo a reconhecer, configurar um pequeno arquivo de definições e, em seguida, treinar o YOLO26 usando o pacote Python da Ultralytics. O pacote Python da Ultralytics é uma biblioteca de software que oferece ferramentas prontas para treinar, testar e implantar modelos YOLO, sem que você precise criar tudo do zero.
Etapa 1: prepare seu conjunto de dados personalizado#
O primeiro passo é preparar o teu conjunto de dados de segmentação personalizado. Um conjunto de dados é simplesmente uma coleção de imagens que mostram os objetos que queres que o modelo aprenda.
Tenta incluir imagens que representem condições do mundo real, como diferentes ângulos, iluminação, fundos e tamanhos de objetos. Quanto mais variadas forem as tuas imagens, melhor será o desempenho do modelo.
Para a segmentação de instâncias, as tuas imagens também precisam de anotações. A anotação consiste em etiquetar os objetos em cada imagem para que o modelo saiba o que aprender. Em vez de desenhares caixas simples, vais traçar contornos detalhados (polígonos) à volta de cada objeto para marcar a sua forma exata. Esses contornos tornam-se as máscaras que o modelo aprende a prever.
Existem várias ferramentas de anotação de código aberto que podes usar para criar estas etiquetas. Muitas destas ferramentas oferecem interfaces fáceis de usar, onde podes carregar imagens e desenhar contornos de objetos diretamente sobre elas.
Quando as tuas imagens e anotações estiverem prontas, podes organizá-las em pastas de treino e validação. Uma divisão típica reserva 80% das imagens para treino e 20% para validação, embora também seja comum usar 70% para treino e 30% para validação, dependendo do tamanho do conjunto de dados. O conjunto de treino ensina o modelo, enquanto o conjunto de validação é usado para medir o seu desempenho em imagens que ainda não viu.
É importante manter esta divisão equilibrada e garantir que ambas as pastas contêm uma variedade de exemplos. Um conjunto de dados limpo e bem etiquetado, com uma divisão adequada entre treino e validação, é a base de um modelo robusto de segmentação de instâncias.
Passo 2: criar um ficheiro YAML do conjunto de dados#
Depois de preparares as imagens e as anotações, o passo seguinte é criar um ficheiro YAML do conjunto de dados. Este ficheiro indica onde se encontra o conjunto de dados e quais as classes de objetos que o modelo deve aprender durante o treino.
Neste ficheiro, podes definir o diretório raiz do conjunto de dados, os caminhos para as pastas de imagens de treino e validação e a lista de nomes das classes. Os nomes das classes têm de ser listados pela mesma ordem que os números das classes usados nos ficheiros de anotação, para que tudo corresponda corretamente.
Se tiveres dúvidas sobre o formato exato, consulta a documentação oficial da Ultralytics para obteres mais detalhes.
Passo 3: instalar o pacote Ultralytics Python#
Agora que o teu conjunto de dados e o ficheiro YAML estão prontos, o passo seguinte é instalar o pacote Ultralytics Python.
Este pacote inclui as ferramentas necessárias para treinar, validar, executar inferências e exportar modelos Ultralytics YOLO26. Oferece uma forma simplificada de trabalhar com modelos YOLO sem criar pipelines de treino complexos do zero.
Antes de instalar o pacote Ultralytics Python, também é importante escolher onde queres executar o teu código. Podes trabalhar com o pacote Ultralytics em vários ambientes de desenvolvimento, como:
- Interface de linha de comandos (CLI): é um ambiente baseado em texto no qual interages com o computador escrevendo comandos. Em vez de clicares em botões ou navegares por menus, como farias numa interface gráfica, introduzes instruções escritas para executar programas e realizar tarefas diretamente.
- Jupyter Notebooks: um ambiente interativo onde escreves e executas código em pequenas secções e vês imediatamente o resultado. É útil para experimentar e aprender.
- Google Colab: uma plataforma de notebooks baseada na nuvem que não requer instalação local e oferece acesso opcional a unidades de processamento gráfico (GPUs). Esta costuma ser a opção mais fácil para principiantes.
Depois de escolheres o teu ambiente, podes instalar o pacote Ultralytics Python. Para o instalar, executa o seguinte comando:
pip install ultralytics
Se estiveres a usar um ambiente baseado em notebooks, como o Google Colab ou o Jupyter Notebook, adiciona um ponto de exclamação no início do comando. Se tiveres problemas durante a instalação, consulta a documentação da Ultralytics ou o guia de resolução de problemas para ver soluções comuns e sugestões de configuração do ambiente.
Após a instalação, estarás pronto para carregar um modelo de segmentação Ultralytics YOLO26 pré-treinado e começar o treino.
Passo 4: treinar o Ultralytics YOLO26 para segmentação de instâncias#
Antes de começar o treino, tens de escolher o tamanho do modelo. Os modelos Ultralytics YOLO26 estão disponíveis em vários tamanhos: Nano (n), Small (s), Medium (m), Large (l) e Extra Large (x).
Os modelos mais pequenos são treinados mais depressa e funcionam com maior eficiência em unidades centrais de processamento (CPUs) ou dispositivos de edge, enquanto os modelos maiores costumam oferecer maior precisão, mas precisam de mais memória e beneficiam da aceleração por GPU. Se estás a começar ou tens hardware limitado, a versão Nano (YOLO26n) é uma opção prática.
Depois de selecionares o tamanho do modelo, o passo seguinte é carregar um modelo de segmentação pré-treinado e começar a treiná-lo com o teu conjunto de dados personalizado. Para isso, tens de especificar o ficheiro do modelo pré-treinado, o caminho para o ficheiro YAML do conjunto de dados, o número de épocas e o tamanho da imagem, como mostrado abaixo.
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
results = model.train(data="path/to/file.yaml", epochs=100, imgsz=640)
O número de épocas determina quantas vezes o modelo percorre todo o conjunto de dados de treino. Em cada época, o modelo faz previsões, compara-as com as anotações corretas, calcula os erros e atualiza os seus parâmetros internos para melhorar o desempenho.
Se o treino começar corretamente, a configuração do modelo, a análise do conjunto de dados e o progresso do treino serão apresentados no terminal ou notebook. À medida que o treino avança, os valores de perda e as métricas de avaliação são atualizados após cada época, mostrando como o modelo está a melhorar ao longo do tempo.
Passo 5: avaliar o desempenho do modelo treinado de forma personalizada#
Quando o treino estiver concluído, podes analisar e validar as métricas de desempenho do modelo. No Google Colab, podes navegar até à pasta “runs”, depois à pasta “segment” e, por fim, à pasta “train”, onde encontrarás registos com os principais indicadores de desempenho.
Para quem trabalha num ambiente Python, os resultados do treino são guardados por predefinição no diretório “runs/train/”, dentro do diretório de trabalho atual. Cada execução de treino cria um novo subdiretório, como runs/train/exp ou runs/train/exp2, onde podes encontrar registos, pesos guardados e outros resultados relacionados com essa experiência.
Se estiveres a usar a CLI, podes aceder a estes resultados e geri-los com o comando “yolo settings”. Este comando permite-te ver ou modificar os caminhos e as configurações relacionados com os registos de treino e os detalhes das experiências.
Entre os resultados guardados, também encontrarás gráficos gerados durante o treino. Estes gráficos mostram como o modelo melhorou ao longo do tempo. Por exemplo, mostram como a perda diminuiu à medida que o modelo aprendia e como métricas de avaliação, como precisão, revocação e precisão média, aumentaram ao longo das épocas.
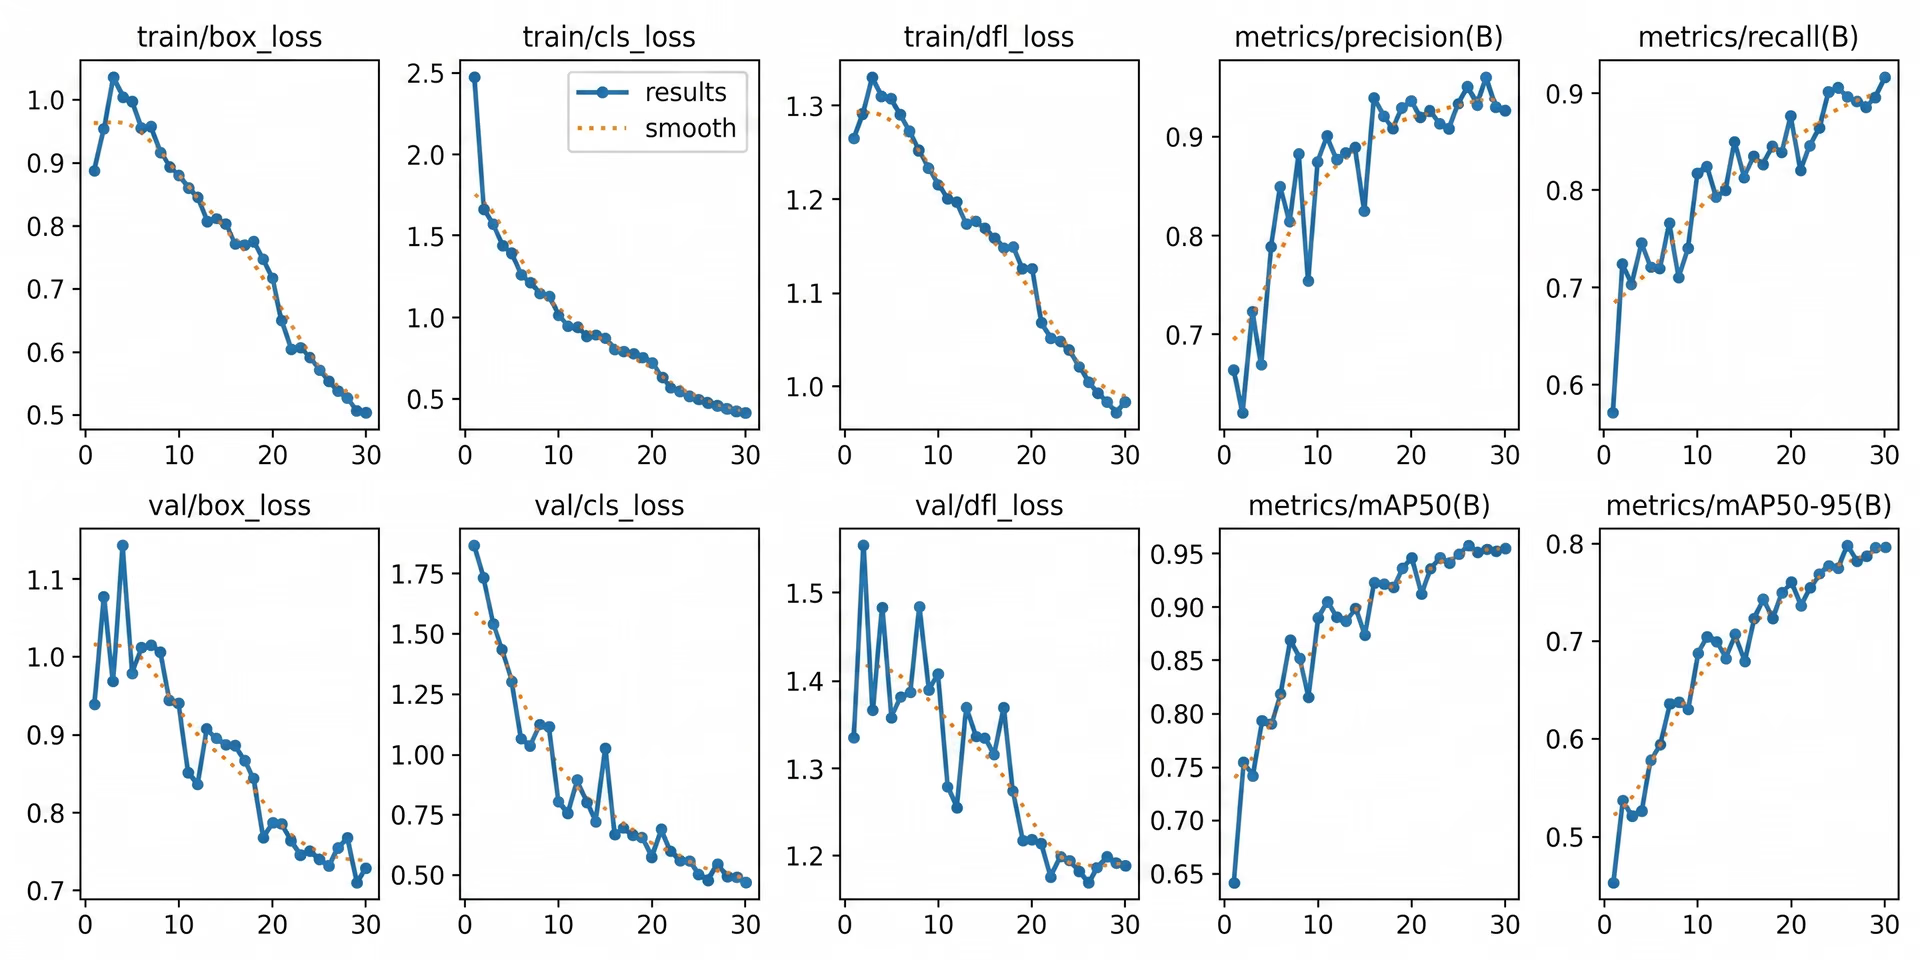
Fig. 4. O tipo de gráficos que podes analisar para avaliar o teu modelo (Fonte)
Estas tendências visuais podem ajudar-te a perceber se o modelo foi treinado com sucesso e quanto melhorou desde o início até ao fim do treino. Analisar tanto as métricas numéricas como os gráficos dá-te uma ideia mais clara do desempenho do modelo de segmentação de instâncias antes de começares a testá-lo com imagens novas.
Passo 6: testar o teu modelo e executar inferências#
Depois de validares o teu modelo, o passo final é testá-lo com imagens novas. Este processo chama-se inferência e consiste simplesmente em usar o modelo treinado para fazer previsões com dados que ainda não viu.
Podes executar inferências em Python da seguinte forma:
results = model.predict("path/to/image.jpg", save=True, conf=0.3)Neste exemplo, podes substituir "path/to/image.jpg" pelo caminho da imagem que queres testar.
A definição “save=True” indica ao modelo que deve gerar e guardar uma nova imagem com as máscaras de segmentação previstas sobrepostas à imagem original.
A definição “conf=0.3” controla o limiar de confiança, o que significa que o modelo só mostra previsões cuja probabilidade de estarem corretas seja de pelo menos 30%. Diminuir este valor pode mostrar mais deteções, enquanto aumentá-lo torna o modelo mais seletivo.
Depois de executares o comando, o modelo cria uma nova pasta dentro do diretório runs, onde guarda a imagem de saída. Podes abrir essa imagem guardada para verificar visualmente se as máscaras de segmentação acompanham os limites dos objetos e se os objetos sobrepostos estão separados corretamente.
Testar o modelo com diferentes imagens, fundos e condições de iluminação pode dar-te uma ideia mais clara do seu desempenho fora do conjunto de dados de treino. Quando os resultados forem consistentes e precisos, o modelo estará pronto para ser exportado e implementado.
Passo 7: exportar e implementar o teu modelo#
Depois de testares o teu modelo e confirmares que tem um bom desempenho, o passo final é exportá-lo e implementá-lo. A exportação converte o teu modelo Ultralytics YOLO26 treinado num formato que pode ser executado em diferentes ambientes, como servidores de produção, dispositivos de edge ou aplicações móveis.
A Ultralytics suporta vários formatos de exportação, permitindo-te escolher o que melhor se adapta à tua configuração de implementação. Por exemplo, podes exportar para ONNX para obter ampla compatibilidade entre plataformas, para TensorRT para otimizar o desempenho da GPU em hardware NVIDIA ou para OpenVINO para uma implementação eficiente baseada em CPU em dispositivos Intel. Estas integrações facilitam a execução do teu modelo fora do ambiente de treino e permitem obter um forte desempenho em tempo real.
Podes exportar o teu modelo em Python com o seguinte comando:
model.export(format="onnx")Este comando converte o teu modelo treinado para o formato ONNX. Podes substituir "onnx" por outros formatos suportados, consoante as tuas necessidades de implementação.
Depois de exportado, o teu modelo pode ser integrado em aplicações como serviços Web, sistemas de visão incorporados, plataformas robóticas ou sistemas de inspeção industrial. Nesta fase, o teu modelo Ultralytics YOLO26 personalizado para segmentação de instâncias pode passar da experimentação à implementação no mundo real.
Principais conclusões#
O treino personalizado do Ultralytics YOLO26 para segmentação de instâncias dá-te a flexibilidade para criar um modelo que se adapta verdadeiramente ao teu caso de uso específico. Ao preparares um conjunto de dados claro, configurares o teu ficheiro YAML, treinares com pesos de segmentação pré-treinados e analisares os resultados, podes ensinar o modelo a delinear cada objeto com precisão ao nível do píxel. Depois de testado e exportado, o teu modelo YOLO26 pode passar do desenvolvimento para aplicações reais em várias escalas.
Junta-te à nossa comunidade e visita o nosso repositório GitHub para descobrires mais sobre IA. Se queres criar o teu próprio projeto de IA para visão, consulta as nossas opções de licenciamento. Explora mais aplicações, como a IA na área da saúde e a IA para visão no retalho, visitando as nossas páginas de soluções.








