Como o Ultralytics YOLO26 treina de forma mais inteligente com ProgLoss, STAL e MuSGD
Descobre como o Ultralytics YOLO26 treina de forma mais confiável com o balanceamento progressivo de perdas, a atribuição de rótulos com consciência de alvos pequenos e o otimizador MuSGD.
 Abirami Vina11 min de leitura
Na semana passada, lançámos o Ultralytics YOLO26, um modelo de visão computacional em tempo real concebido para a periferia. Tal como os anteriores modelos Ultralytics YOLO, como o Ultralytics YOLO11, o YOLO26 é compatível com as principais tarefas de visão computacional que os utilizadores já conhecem, incluindo deteção de objetos, segmentação de instâncias e estimativa de pose.
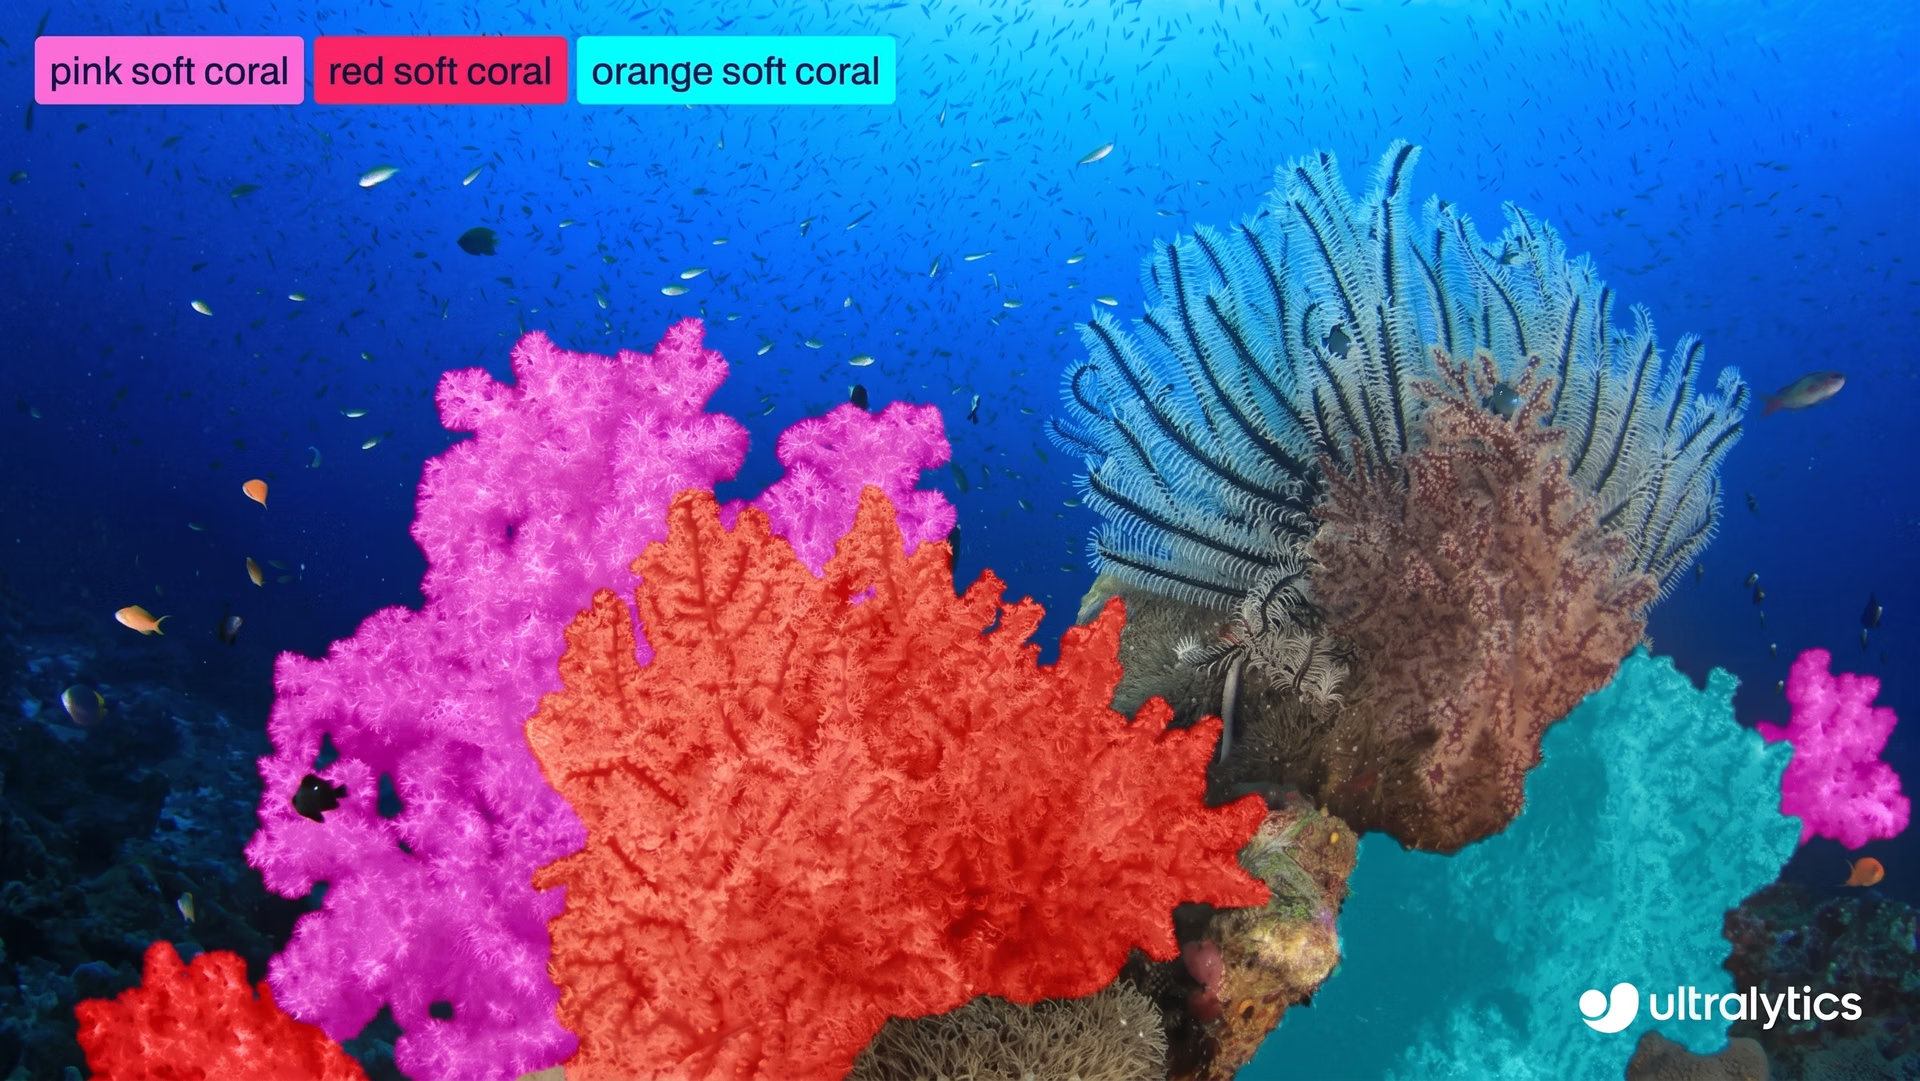
Fig. 1. Exemplo do uso do Ultralytics YOLO26 para segmentar objetos em uma imagem.
No entanto, o Ultralytics YOLO26 não é apenas uma atualização incremental. Embora as tarefas suportadas possam parecer familiares, este novo modelo representa um avanço na forma como os modelos de visão computacional são treinados. Com o YOLO26, o foco vai além da eficiência da inferência e passa também por tornar o treino mais estável.
O Ultralytics YOLO26 foi projetado tendo em mente todo o ciclo de vida do treinamento. Isso significa convergência mais rápida, execuções de treinamento mais confiáveis e comportamento consistente do modelo. Essas melhorias são especialmente importantes em fluxos de trabalho do mundo real, nos quais a confiabilidade do treinamento afeta diretamente a rapidez com que os modelos podem ser iterados e implantados.
Para possibilitar isso, o Ultralytics YOLO26 introduz várias inovações específicas para o treinamento, como Progressive Loss Balancing (ProgLoss), Small-Target-Aware Label Assignment (STAL) e o otimizador MuSGD. Em conjunto, essas mudanças melhoram o equilíbrio da perda de aprendizado, a atribuição de rótulos e o comportamento da otimização ao longo do tempo.
Neste artigo, vamos explorar como cada um desses mecanismos funciona e por que eles tornam o Ultralytics YOLO26 mais fácil de treinar e mais confiável em grande escala. Vamos começar!
Ultralytics YOLO26: desenvolvido para treinar de forma mais inteligente, não apenas executar mais rápido#
O Ultralytics YOLO26 simplifica nativamente todo o pipeline de inferência, eliminando a dependência de etapas de pós-processamento como a supressão não máxima (NMS). Em vez de gerar muitas previsões sobrepostas e filtrá-las posteriormente, o YOLO26 produz as deteções finais diretamente a partir da rede.
Isso torna o YOLO26 um modelo de ponta a ponta, no qual a previsão, a resolução de duplicatas e as saídas finais são aprendidas dentro da própria rede. Isso simplifica a implantação e melhora a eficiência da inferência, ao mesmo tempo que influencia a forma como o modelo aprende durante o treinamento.
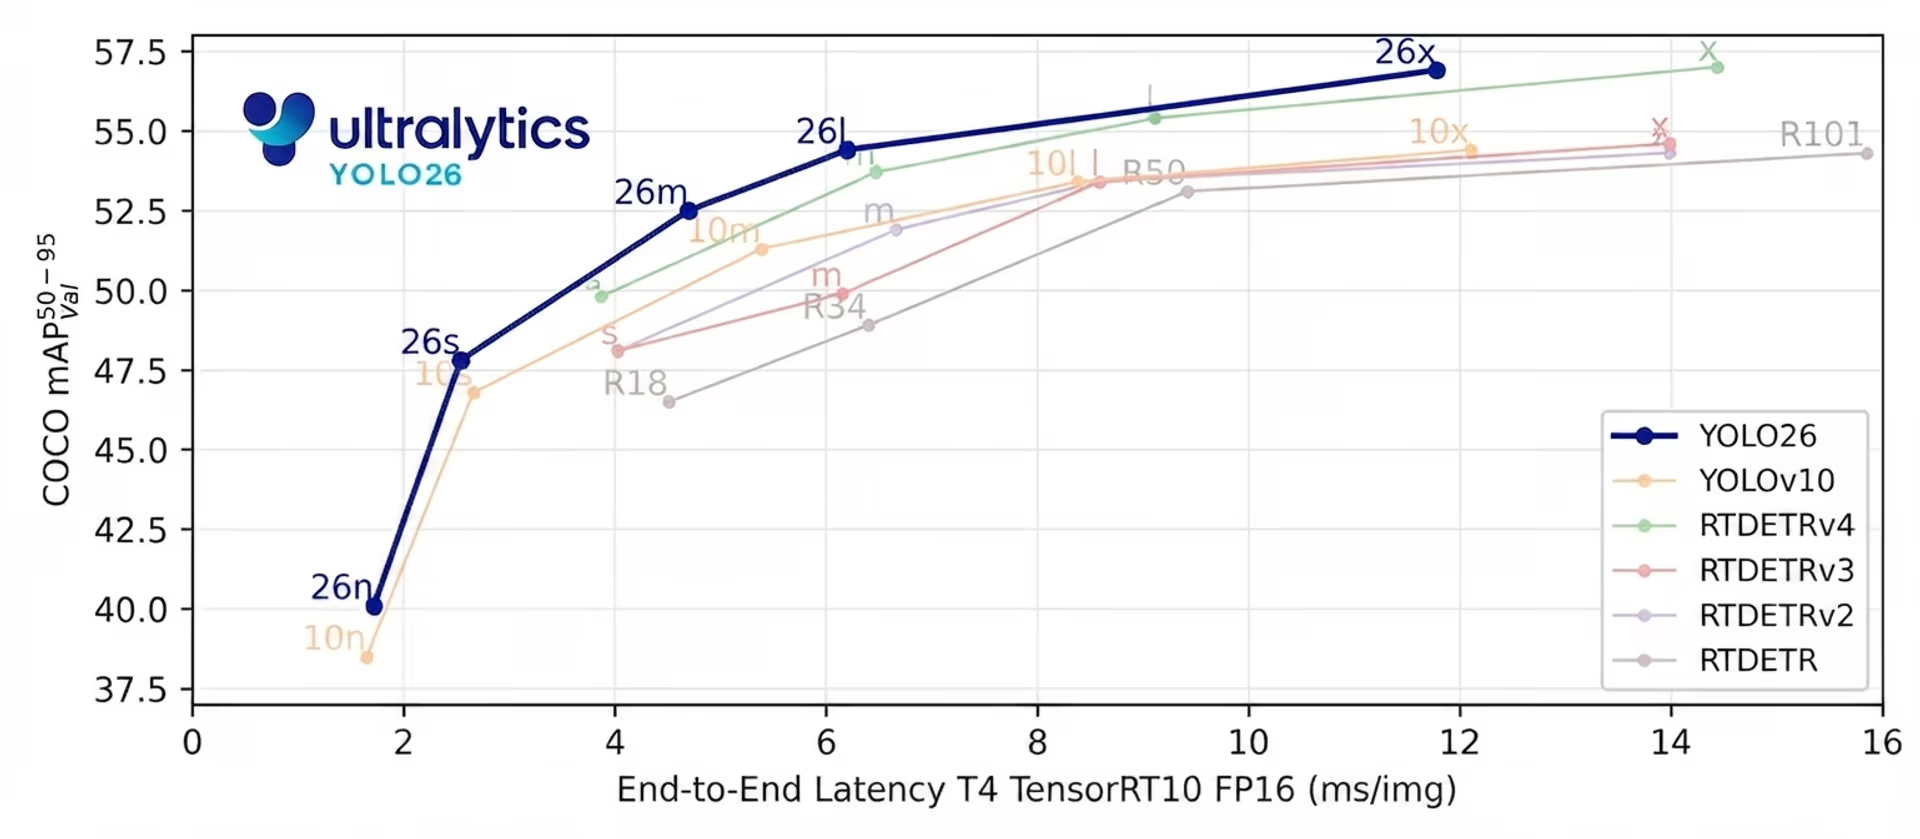
Fig. 2. YOLO26 oferece inferência de ponta a ponta, sem NMS e no estado da arte (Fonte)
Em um sistema de ponta a ponta como este, o treinamento e a inferência estão estreitamente conectados. Como não há uma etapa externa de pós-processamento para corrigir as previsões posteriormente, o próprio modelo precisa aprender a tomar decisões claras e confiantes durante o treinamento.
Isso torna especialmente importante alinhar os objetivos de treinamento ao comportamento da inferência. Qualquer incompatibilidade entre a forma como o modelo é treinado e a forma como é usado no momento da inferência pode levar a um aprendizado instável ou a uma convergência mais lenta.
O Ultralytics YOLO26 lida com isso projetando o processo de treinamento desde o início em torno do uso no mundo real. Em vez de se concentrar apenas na velocidade de inferência, o sistema de treinamento foi desenvolvido para permitir um aprendizado estável em execuções longas, convergência consistente em tamanhos de modelo que vão de Nano a Extra Large e desempenho robusto em conjuntos de dados diversos.
Como duas cabeças de treinamento melhoram o aprendizado no Ultralytics YOLO26#
Uma das principais inovações de treinamento do Ultralytics YOLO26 se baseia em uma abordagem de treinamento com duas cabeças, usada em modelos YOLO anteriores. Em modelos de detecção de objetos, uma cabeça é a parte da rede responsável por fazer previsões.
Em outras palavras, as cabeças de detecção aprendem a prever onde os objetos estão localizados em uma imagem e quais são esses objetos. Elas fazem isso regredindo as coordenadas das caixas delimitadoras, ou seja, aprendem a estimar a posição e o tamanho de cada objeto na imagem de entrada.
Durante o treinamento, o modelo aprende minimizando uma perda, que é uma medida numérica da distância entre suas previsões e as respostas corretas, ou verdade fundamental. Uma perda menor significa que as previsões do modelo estão mais próximas da verdade fundamental, enquanto uma perda maior indica erros maiores. O cálculo da perda orienta a forma como o modelo atualiza seus parâmetros durante o treinamento.
O Ultralytics YOLO26 usa duas cabeças de detecção durante o treinamento, que compartilham o mesmo modelo subjacente, mas têm finalidades diferentes. A cabeça one-to-one é a usada no momento da inferência. Ela aprende a associar cada objeto a uma única previsão confiável, o que é essencial para o design de ponta a ponta e sem NMS do YOLO26.
Já a cabeça one-to-many é usada apenas durante o treinamento. Ela permite associar várias previsões ao mesmo objeto, oferecendo uma supervisão mais densa. Esse sinal de aprendizado mais rico ajuda a estabilizar o treinamento e melhorar a precisão, especialmente nas etapas iniciais.
No Ultralytics YOLO26, as duas cabeças usam o mesmo cálculo de perda para regressão de caixas e classificação. Implementações anteriores aplicavam um equilíbrio fixo entre esses dois sinais de perda ao longo de todo o treinamento.
Na prática, porém, a importância de cada cabeça muda com o tempo. A supervisão densa é mais útil no início, enquanto o alinhamento com o comportamento da inferência se torna mais importante nas etapas posteriores do treinamento. O Ultralytics YOLO26 foi projetado com base nessa constatação, que leva diretamente à forma como ele reequilibra os sinais de aprendizado à medida que o treinamento avança.
O Ultralytics YOLO26 usa o balanceamento progressivo de perdas#
Então, como o Ultralytics YOLO26 lida com essas necessidades de aprendizado variáveis durante o treinamento? Ele usa o balanceamento progressivo de perdas para ajustar a ponderação dos sinais de aprendizado ao longo do tempo.
O ProgLoss funciona alterando dinamicamente a contribuição de cada cabeça para a perda total à medida que o treinamento avança. No início, a cabeça one-to-many recebe mais peso para estabilizar o aprendizado e melhorar o recall. Conforme o treinamento continua, o equilíbrio muda gradualmente para a cabeça one-to-one, alinhando melhor o treinamento ao comportamento da inferência.
Essa transição gradual permite que o Ultralytics YOLO26 aprenda na ordem certa. Em vez de forçar o modelo a otimizar objetivos concorrentes ao mesmo tempo, o balanceamento progressivo de perdas prioriza o sinal de aprendizado mais útil em cada etapa do treinamento. O resultado é uma convergência mais suave, menos execuções de treinamento instáveis e um desempenho final mais consistente.
Como o STAL ajuda o Ultralytics YOLO26 a aprender com objetos minúsculos#
Outra melhoria interessante no treinamento do Ultralytics YOLO26 está na forma como o modelo atribui alvos de treinamento às previsões, um processo conhecido como atribuição de rótulos. Ele é responsável por associar objetos da verdade fundamental às previsões candidatas, muitas vezes chamadas de âncoras.
Essas associações determinam quais previsões recebem supervisão e contribuem para a perda. O Ultralytics YOLO26 se baseia em um método existente de atribuição de rótulos chamado aprendizado de alinhamento de tarefas (TAL), desenvolvido para alinhar melhor a classificação e a localização durante o treinamento.
Embora o TAL funcione bem para a maioria dos objetos, o treinamento revelou uma limitação importante. Durante o processo de associação, objetos muito pequenos podiam ser totalmente descartados. Na prática, objetos menores que cerca de 8 pixels em uma imagem de entrada de 640 pixels muitas vezes não recebiam nenhuma atribuição de âncora. Quando isso acontece, o modelo recebe pouca ou nenhuma supervisão para esses objetos, dificultando o aprendizado para detectá-los de forma confiável.
Para resolver esse problema, o Ultralytics YOLO26 introduz a atribuição de rótulos com reconhecimento de alvos pequenos (STAL). A STAL modifica o processo de atribuição para garantir que objetos pequenos não sejam ignorados durante o treinamento. Mais especificamente, durante a seleção de candidatos, ela aumenta para 16 pixels qualquer largura ou altura de caixa inferior a 8 pixels, enquanto a caixa original continua sendo usada para correspondência e regressão. Isso garante que até mesmo objetos minúsculos contribuam consistentemente para a função de perda do treinamento.
Ao reforçar a supervisão de alvos pequenos, o STAL melhora a estabilidade do aprendizado e o desempenho da detecção em cenários com muitos objetos pequenos ou distantes. Essa melhoria é especialmente importante para aplicações de YOLO26 com foco na borda, como imagens aéreas, robótica e sistemas de Internet das Coisas (IoT), em que os objetos costumam ser pequenos, distantes ou parcialmente visíveis, e a detecção confiável é fundamental.
O Ultralytics YOLO26 apresenta o otimizador MuSGD#
Para proporcionar um treino mais estável e previsível, o Ultralytics YOLO26 também introduz um novo otimizador chamado MuSGD. Este otimizador foi concebido para melhorar a convergência e a fiabilidade do treino em modelos de deteção de ponta a ponta, sobretudo à medida que aumentam o tamanho do modelo e a complexidade do treino.
Para que uma rede neuronal aprenda e atualize os seus pesos durante o treino, calculamos um erro, também chamado perda. O modelo mede o erro das suas previsões através de um valor de perda, calcula gradientes que indicam como os parâmetros devem mudar e, em seguida, atualiza esses parâmetros para reduzir o erro. A descida do gradiente estocástico (SGD) é um otimizador amplamente utilizado que realiza estas atualizações, tornando o treino eficiente e escalável.
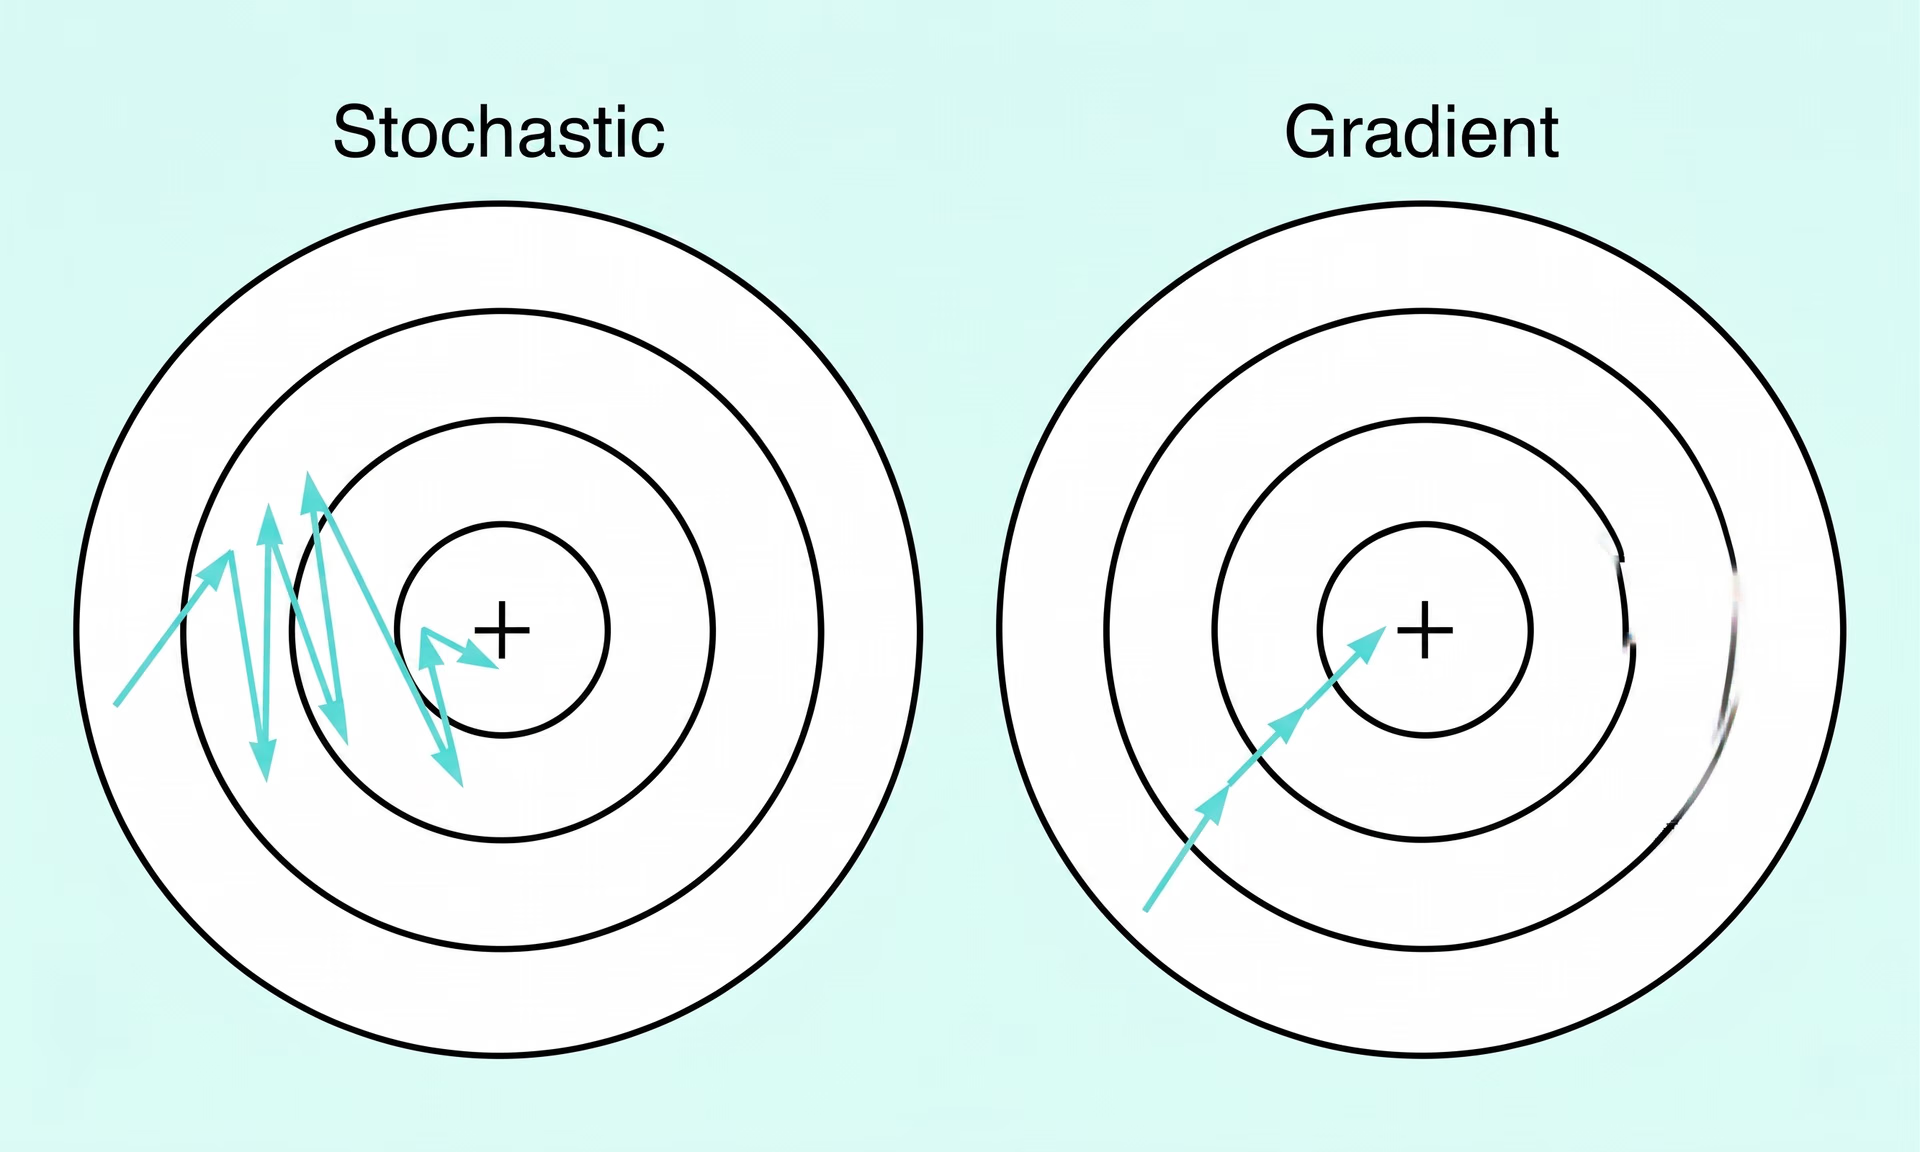
Fig. 3. Gradiente descendente estocástico vs. gradiente descendente (Fonte)
O MuSGD parte desta base conhecida, incorporando ideias de otimização inspiradas no Muon, um método usado no treino de modelos de linguagem de grande dimensão (LLM). Estas ideias foram influenciadas por avanços recentes, como o Kimi K2 da Moonshot AI, que demonstrou um comportamento de treino melhorado através de atualizações de parâmetros mais estruturadas.
O Ultralytics YOLO26 usa uma estratégia híbrida de atualização. Alguns parâmetros são atualizados com uma combinação de atualizações inspiradas no Muon e SGD, enquanto outros usam apenas SGD. Isso permite que o YOLO26 introduza mais estrutura no processo de otimização, mantendo a robustez e as propriedades de generalização que tornaram o SGD eficaz.
O resultado é uma otimização mais suave, convergência mais rápida e comportamento de treinamento mais previsível em diferentes tamanhos de modelo, tornando o MuSGD uma parte fundamental do que faz o Ultralytics YOLO26 ser mais fácil de treinar e mais confiável em escala.
A importância das inovações de treinamento do Ultralytics YOLO26#
As inovações de treinamento do Ultralytics YOLO26, combinadas com recursos importantes como seu design de ponta a ponta, sem NMS e com foco na borda, tornam o modelo mais fácil de treinar e mais confiável em escala. Talvez você esteja se perguntando o que isso realmente significa para as aplicações de visão computacional.
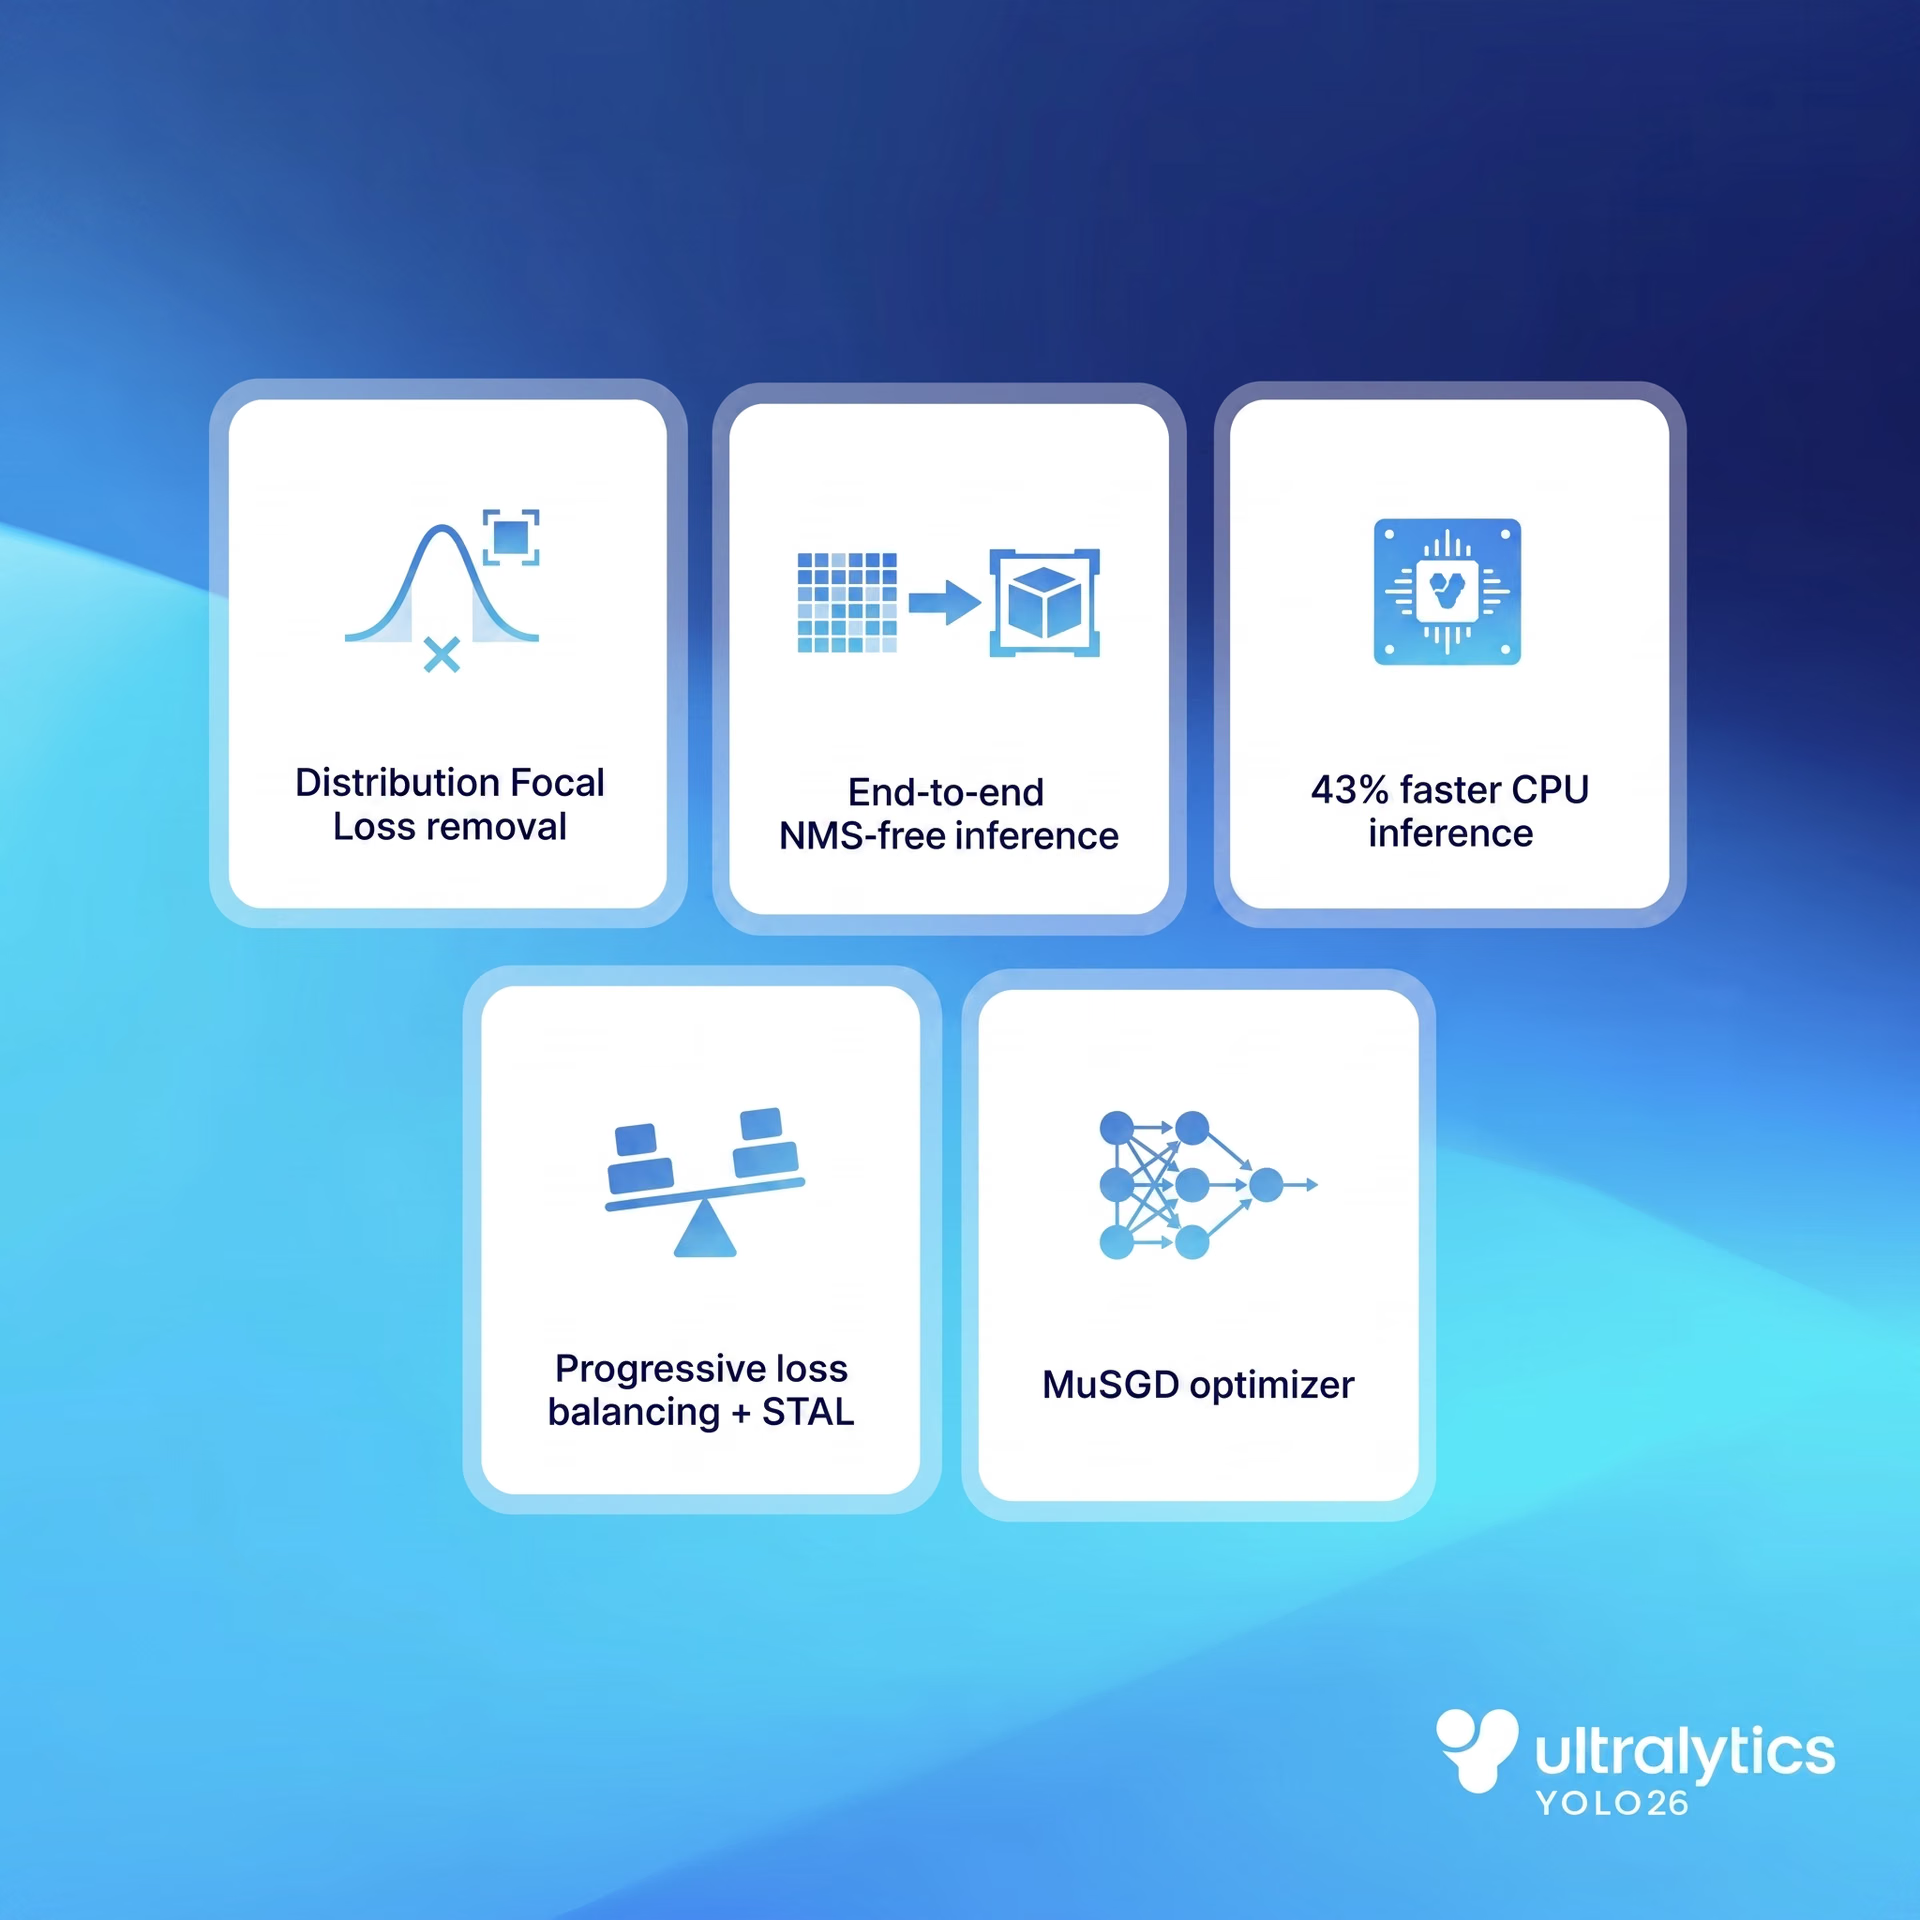
Fig. 4. Visão geral dos principais recursos do YOLO26 (Fonte)
Na prática, isso facilita muito levar a visão computacional para onde ela realmente é executada. Os modelos treinam de forma mais previsível, escalam com mais consistência entre diferentes tamanhos e são mais simples de adaptar a novos conjuntos de dados. Isso reduz o atrito entre a experimentação e a implantação, especialmente em ambientes onde a confiabilidade e a eficiência são tão importantes quanto o desempenho bruto.
Por exemplo, em aplicações de robótica e visão industrial, muitas vezes é necessário retreinar os modelos conforme mudam os ambientes, os sensores ou as tarefas. Com o Ultralytics YOLO26, as equipes podem iterar mais rapidamente sem se preocupar com execuções de treinamento instáveis ou comportamento inconsistente entre diferentes tamanhos de modelo.
Principais conclusões#
A fiabilidade dos sistemas de visão computacional depende tanto da forma como os modelos são treinados como do seu desempenho durante a inferência. Ao melhorar o equilíbrio dos sinais de aprendizagem, o tratamento de objetos pequenos e o progresso da otimização, o Ultralytics YOLO26 torna o treino mais estável e mais fácil de escalar. A receita de treino do YOLO26 documenta as configurações usadas para os pontos de controlo oficiais. Este foco num treino fiável ajuda as equipas a passar mais facilmente da experimentação à implementação no mundo real, sobretudo em aplicações concebidas para a periferia.
Quer aprender sobre IA? Acesse nosso repositório no GitHub para saber mais. Participe da nossa comunidade, sempre ativa, e conheça as inovações em setores como IA na logística e IA de visão no setor automotivo. Para começar hoje mesmo com visão computacional, confira nossas opções de licenciamento.
Escrito por
Criador de conteúdo · Ultralytics
Comentários
Faça uma pergunta, compartilhe seus resultados ou ajude alguém.









