O impacto do design mais rápido e voltado à borda do Ultralytics YOLO26
Vê como o Ultralytics YOLO26 é mais rápido na borda e por que isso é importante para aplicações de visão computacional de próxima geração que exigem baixa latência e eficiência.
No início desta semana, a Ultralytics lançou oficialmente o Ultralytics YOLO26, um modelo YOLO mais rápido, leve e compacto que pretende redefinir o desempenho dos sistemas de visão computacional na borda. O YOLO26 oferece suporte às mesmas tarefas centrais de visão que os modelos YOLO anteriores, incluindo detecção de objetos e segmentação de instâncias.
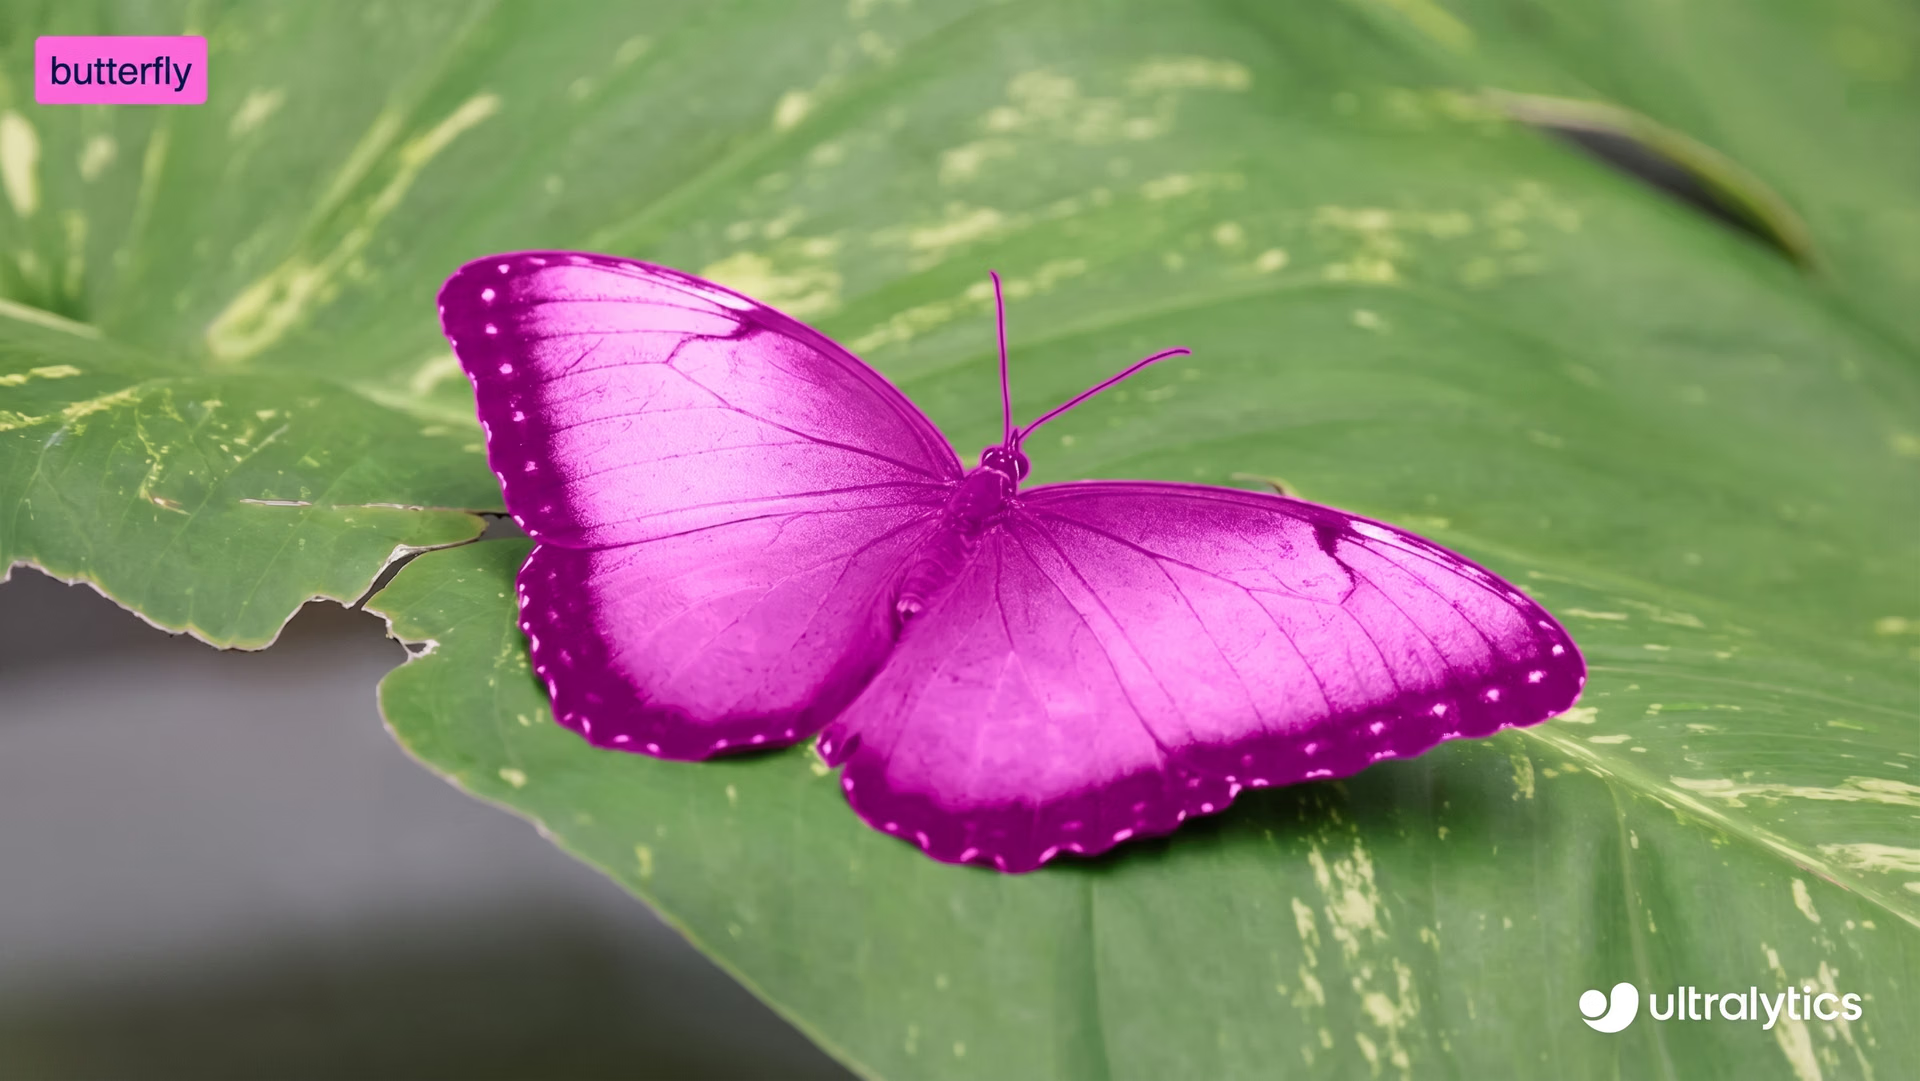
Fig. 1. Exemplo de uso do Ultralytics YOLO26 para segmentar um objeto.
A principal diferença entre o Ultralytics YOLO26 e os modelos anteriores está no ambiente para o qual ele foi projetado. Em vez de otimizar principalmente para unidades de processamento gráfico (GPU) na nuvem ou para o desempenho em benchmarks, o YOLO26 foi desenvolvido desde o início para implantação no mundo real em dispositivos de borda e hardware embarcado.
À medida que a visão computacional passa da pesquisa para a produção, fica mais clara a realidade das restrições de desempenho. Os ambientes de borda são condicionados por limites rigorosos de latência, memória, energia e temperatura, além da necessidade de comportamento previsível em diversas plataformas.
Nesses ambientes, o desempenho geral do sistema depende não apenas da velocidade bruta de inferência, mas também da eficiência de toda a linha de processamento. A sobrecarga do pós-processamento, a pressão sobre a memória e os caminhos de execução específicos de cada plataforma costumam ser gargalos.
O Ultralytics YOLO26 enfrenta esses desafios com uma abordagem mais rápida e focada na borda, que considera toda a linha de inferência, em vez de métricas isoladas do modelo. Ao priorizar a otimização para a borda, simplificar a linha de inferência e remover etapas desnecessárias de pós-processamento, o YOLO26 oferece ganhos de velocidade que resultam em menor latência e comportamento mais confiável em produção.
Neste artigo, vamos explorar como as escolhas arquiteturais do Ultralytics YOLO26 se traduzem em melhorias de desempenho no mundo real e por que ser mais rápido na borda muda fundamentalmente o que é possível nas aplicações de visão computacional de próxima geração.
A realidade da implantação na borda#
Executar modelos de visão computacional na borda é muito diferente de executá-los na nuvem. Em ambientes de nuvem, os sistemas normalmente têm acesso a GPUs potentes, grandes quantidades de memória e hardware estável. Na borda, essas mesmas condições não se aplicam.
A maioria das implantações na borda é executada em arquiteturas de hardware variadas, não em GPUs. Em geral, os dispositivos usam vários processadores especializados para tarefas diferentes, otimizados para eficiência e baixo consumo de energia, e não para a capacidade computacional bruta das GPUs na nuvem.
A latência é outra grande restrição. Os sistemas de borda costumam operar sob limites rigorosos de tempo real, em que até mesmo pequenos atrasos podem afetar a capacidade de resposta ou a segurança. Nesses casos, a latência de ponta a ponta é mais importante do que a velocidade bruta de inferência. Um modelo pode parecer rápido no papel, mas ainda assim não atender às necessidades quando se acrescentam o pós-processamento e a movimentação de dados.
A memória também tem um papel importante. Muitos dispositivos de borda têm memória limitada e caches compartilhados. Tensores intermediários grandes e o uso ineficiente da memória podem deixar os sistemas mais lentos, mesmo quando o próprio modelo é eficiente.
Os limites de energia e temperatura impõem outras restrições. Os dispositivos de borda muitas vezes funcionam sem refrigeração ativa e dentro de orçamentos fixos de energia. O desempenho precisa ser eficiente e sustentável, não apenas rápido em breves períodos.
Além de tudo isso, as implantações na borda exigem consistência. Os modelos precisam se comportar da mesma forma em diferentes dispositivos e ambientes de execução. Código específico de plataforma ou etapas complexas de pós-processamento podem introduzir diferenças sutis que dificultam a implantação e a manutenção dos sistemas.
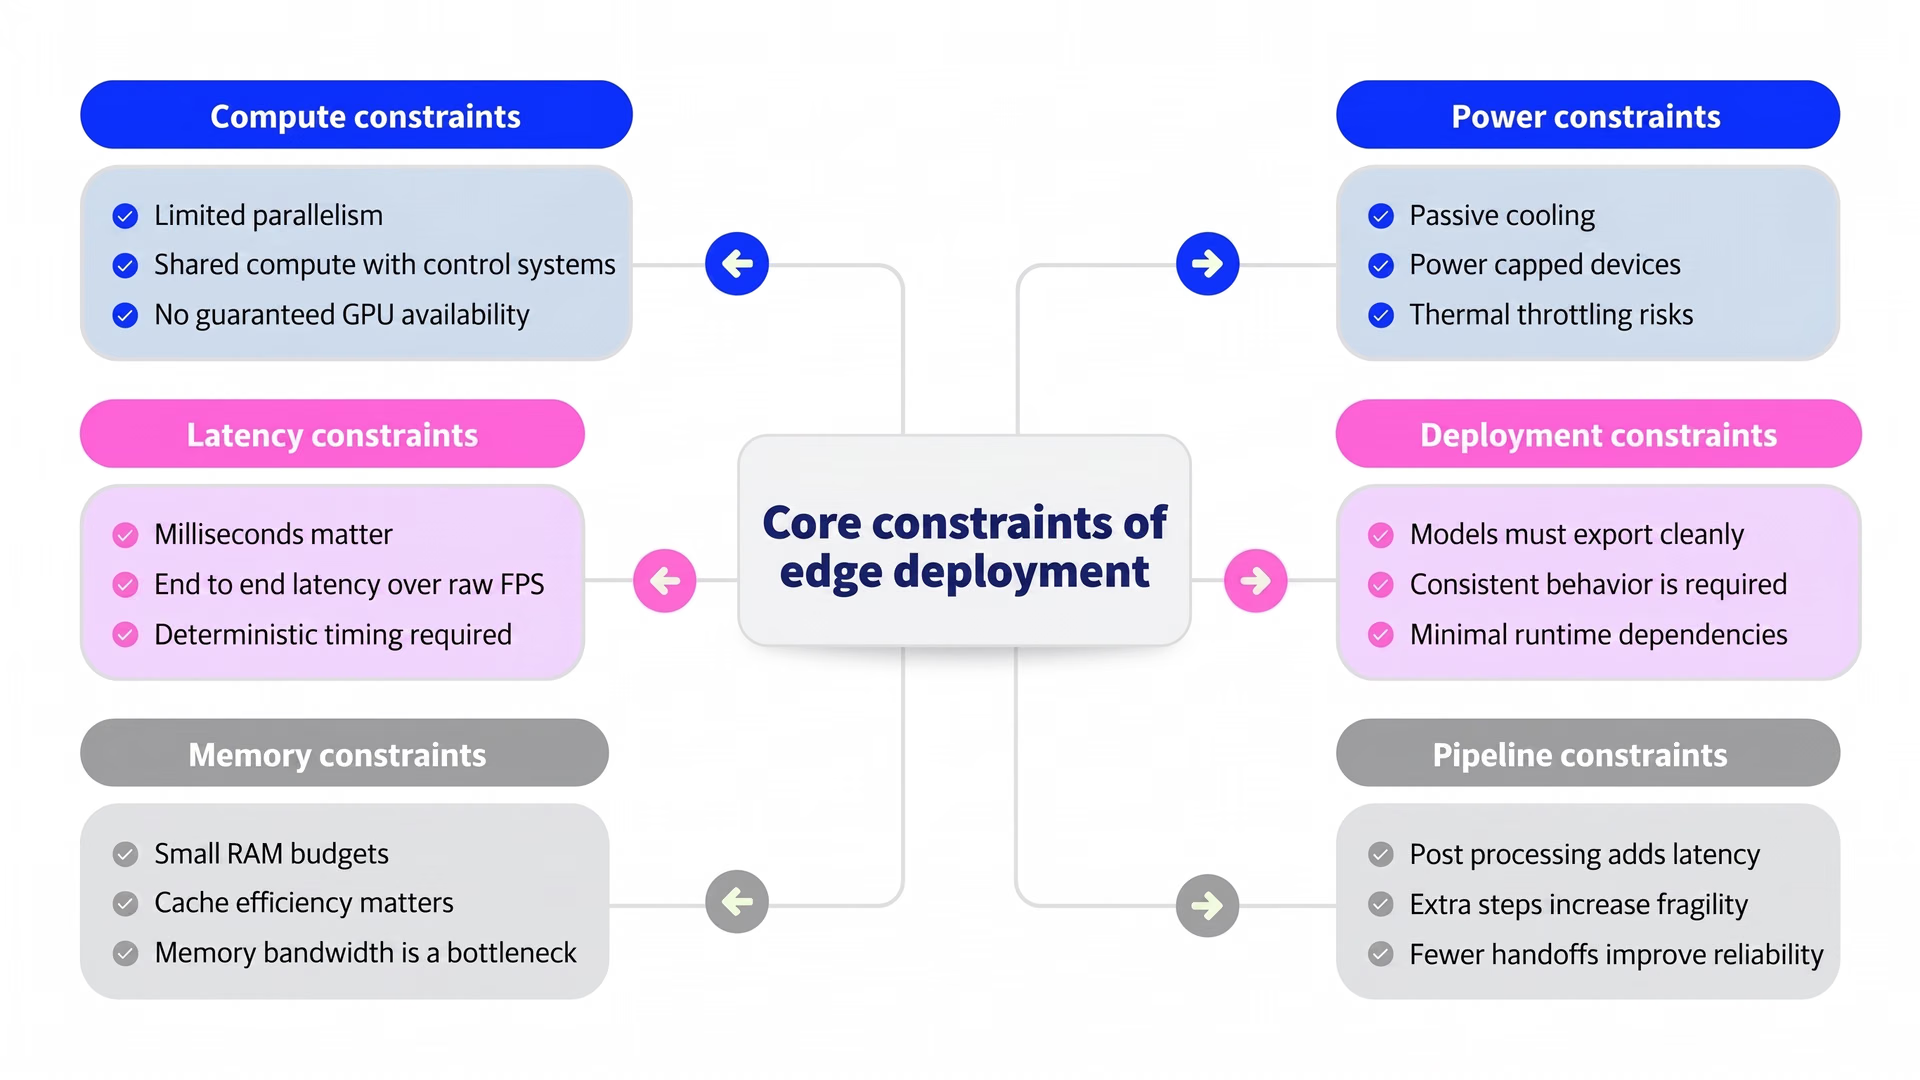
Fig. 2. Visão geral das restrições da implantação na borda. Imagem do autor.
Essas restrições definem o que o desempenho realmente significa na borda. Em outras palavras, o desempenho é determinado por toda a linha de processamento, não por uma única métrica.
Por que a visão computacional na borda exige um modelo de desempenho diferente#
Então, como as restrições da implantação na borda se relacionam com os requisitos de um modelo de visão computacional desenvolvido para a borda? A conexão fica clara quando os modelos passam da pesquisa para sistemas do mundo real.
Em ambientes de nuvem, o desempenho costuma ser medido com benchmarks, como velocidade e precisão de inferência. Na borda, essas métricas contam apenas parte da história. Os sistemas de visão geralmente são executados em hardware heterogêneo, no qual a inferência da rede neural é transferida para aceleradores especializados, enquanto outras partes da linha de processamento são executadas em processadores de uso geral.
Nesse contexto, a velocidade do modelo não basta. O essencial é o desempenho de todo o sistema depois que o modelo é implantado. Um modelo pode parecer rápido por si só, mas ainda assim não atender às necessidades se o pós-processamento, a movimentação de dados ou as etapas específicas da plataforma acrescentarem sobrecarga.
Por isso, a visão computacional na borda exige um modelo de desempenho focado na eficiência do sistema como um todo, e não em benchmarks isolados. O Ultralytics YOLO26 reflete essa mudança ao priorizar a otimização com foco na borda, a inferência simplificada e a execução de ponta a ponta desenvolvida para implantação no mundo real.
A base da velocidade: um design com foco na borda#
Na borda, o desempenho é definido pela forma como um modelo se adapta à arquitetura de hardware real do dispositivo. Projetar primeiro para a borda garante que os sistemas de visão funcionem de forma confiável em plataformas do mundo real, independentemente da combinação específica de unidades de processamento disponíveis.
Uma abordagem com foco na borda prioriza uma execução previsível e eficiente em hardware heterogêneo, em vez de adaptar posteriormente modelos otimizados para GPUs na nuvem. Em termos simples, isso significa favorecer operações que funcionem bem em aceleradores de redes neurais, minimizar o processamento não neural fora do modelo e reduzir a complexidade desnecessária que pode deixar a execução de ponta a ponta mais lenta.
O Ultralytics YOLO26 foi projetado considerando essas restrições. Sua arquitetura prioriza um desempenho consistente em vez de uma taxa de processamento máxima em condições ideais. Ao simplificar os caminhos de execução e eliminar cálculos desnecessários, o YOLO26 reduz a sobrecarga em toda a linha de inferência e aproveita melhor os recursos de aceleração e a hierarquia de memória disponíveis no dispositivo.
Essa abordagem também melhora a confiabilidade. A otimização com foco na borda proporciona tempos mais previsíveis e menos picos de desempenho, algo essencial para sistemas em tempo real. Em vez de depender de hardware especializado ou de um pós-processamento pesado para obter velocidade, o Ultralytics YOLO26 prioriza a eficiência em toda a linha de inferência.
Inferência de ponta a ponta e o custo do pós-processamento#
Talvez você esteja se perguntando o que significa eliminar etapas desnecessárias de pós-processamento. Para entender isso, vamos dar um passo atrás e analisar como funcionam os sistemas tradicionais de detecção de objetos.
Em muitas linhas de detecção de objetos, a inferência não termina quando o modelo gera suas previsões. Em vez disso, o modelo produz um grande número de caixas delimitadoras sobrepostas, que precisam ser filtradas e refinadas antes de poderem ser usadas. Essa limpeza é feita por etapas de pós-processamento executadas fora do próprio modelo.
Uma das etapas de pós-processamento mais comuns é a supressão não máxima, ou NMS. A NMS compara caixas delimitadoras sobrepostas e mantém apenas as detecções mais confiáveis, removendo as duplicadas que se referem ao mesmo objeto. Embora essa abordagem seja eficaz, ela exige cálculos adicionais após o fim da inferência.
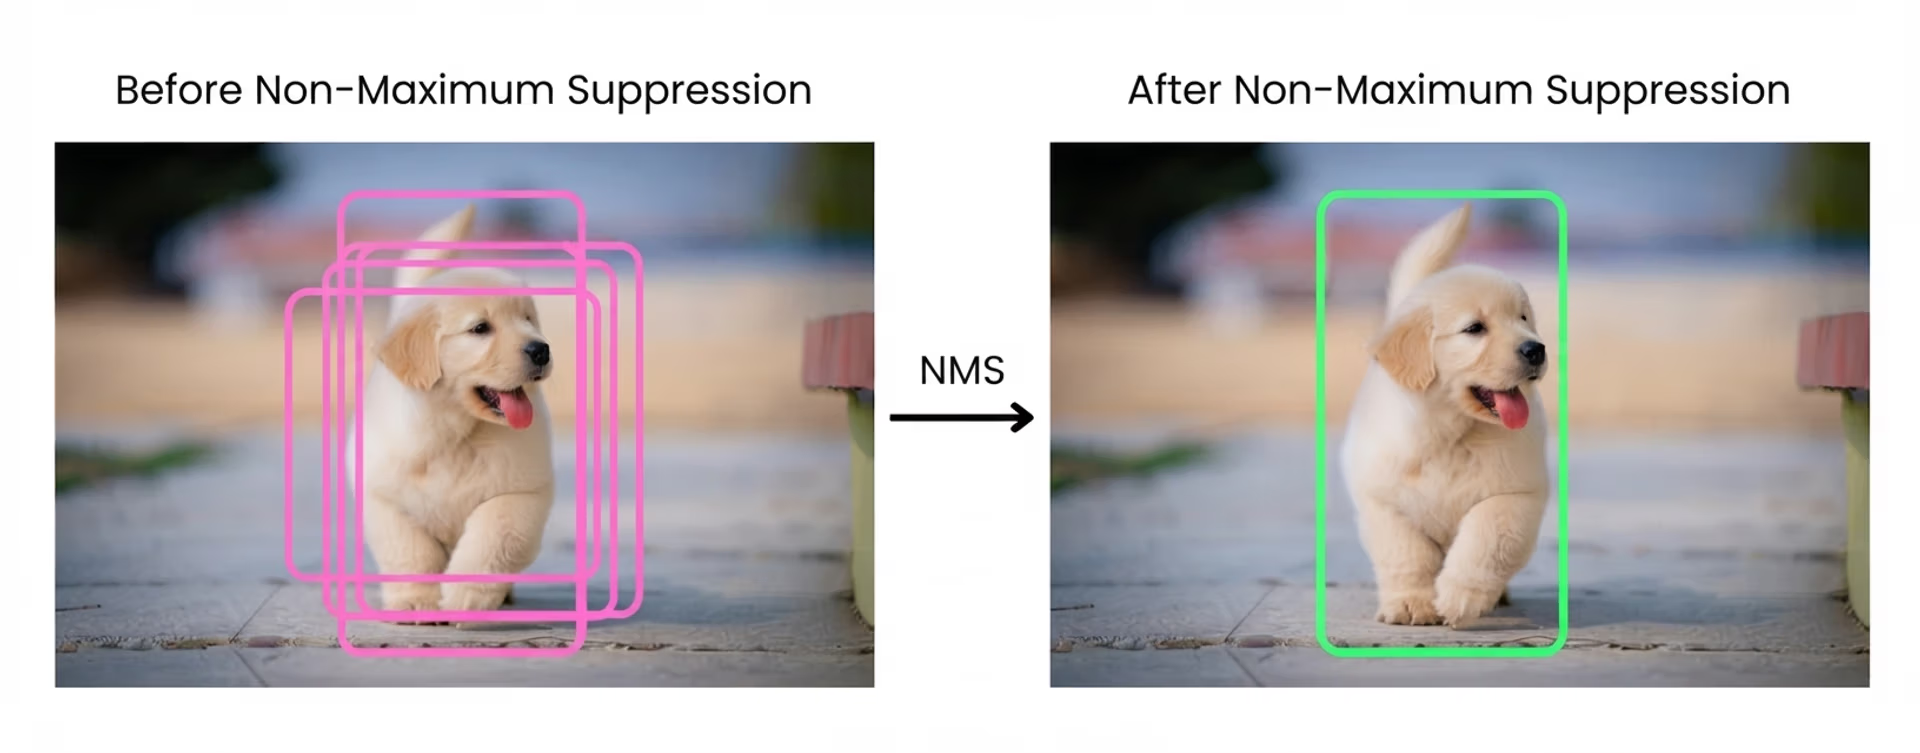
Fig. 3. Entenda a NMS. Imagem do autor.
Na borda, esse trabalho adicional tem um custo. Etapas de pós-processamento como a NMS não são adequadas aos aceleradores especializados usados para inferência de redes neurais, que são otimizados para cálculos neurais densos, e não para operações com muito controle ou uso intensivo de memória.
Como resultado, a NMS acrescenta latência e sobrecarga de memória, e seu custo aumenta conforme cresce o número de detecções. Mesmo quando o próprio modelo é rápido, a NMS ainda pode consumir uma parte significativa do tempo total de execução.
O pós-processamento também aumenta a complexidade do sistema. Como é executado fora do modelo, precisa ser implementado separadamente para diferentes ambientes de execução e alvos de hardware. Isso costuma levar a caminhos de código específicos de cada plataforma, comportamento inconsistente entre dispositivos e linhas de implantação mais frágeis.
Mais importante ainda, o pós-processamento contraria a ideia de desempenho realmente de ponta a ponta. Medir a velocidade de inferência do modelo não reflete o comportamento do sistema em produção. O que importa, no fim das contas, é o tempo total entre a entrada e a saída final, incluindo cada etapa da linha de processamento.
Nessas situações, o pós-processamento se torna um gargalo oculto na borda. Ele acrescenta latência, consome recursos da CPU e complica a implantação, tudo isso sendo executado fora do próprio modelo.
Como o Ultralytics YOLO26 elimina a NMS e por que isso o torna mais rápido#
O YOLO26 elimina a NMS ao tratar a causa raiz das detecções duplicadas, em vez de limpá-las após a inferência. Em vez de gerar muitas previsões sobrepostas que precisam ser filtradas, o modelo é treinado para gerar diretamente um conjunto menor de detecções finais e confiáveis.
Isso é possível ao mudar a forma como as detecções são aprendidas durante o treinamento. O Ultralytics YOLO26 promove uma relação one-to-one mais clara entre objetos e previsões, reduzindo a redundância desde a origem. Assim, as detecções duplicadas são resolvidas dentro da própria rede, e não por meio de pós-processamento externo.
A remoção da NMS tem um impacto imediato no desempenho na borda. Como a NMS não se adapta bem aos aceleradores de redes neurais, eliminá-la reduz a movimentação de memória e evita etapas dispendiosas de processamento não neural. Isso diminui a latência de ponta a ponta e torna o desempenho mais previsível, especialmente em dispositivos de borda, nos quais o pós-processamento poderia consumir uma parte considerável do tempo total de execução.
Isso também simplifica a linha de inferência. Com menos etapas fora do modelo, há menos movimentação de dados e menos transferências entre componentes. A saída do modelo já é o resultado final, o que torna a execução mais previsível.
Remoção da DFL para permitir um desempenho realmente de ponta a ponta#
Outra inovação do Ultralytics YOLO26 é a remoção da perda focal de distribuição, ou DFL, usada em modelos YOLO anteriores para regressão de caixas delimitadoras. Em vez de prever diretamente uma única coordenada, os modelos que usam DFL aprendiam uma distribuição de valores possíveis e, em seguida, derivavam dessa distribuição uma caixa delimitadora final. Essa abordagem ajudou a melhorar a precisão da localização e representou um avanço importante nas gerações anteriores.
Com o tempo, porém, a DFL também trouxe desvantagens. Prever distribuições aumenta os cálculos e acrescenta complexidade à arquitetura do modelo, o que pode tornar a inferência mais lenta em CPUs e dificultar a exportação dos modelos para diferentes formatos de implantação. A DFL também impunha intervalos fixos de regressão, o que podia limitar a flexibilidade na detecção de objetos muito grandes.
O Ultralytics YOLO26 remove a DFL como parte de sua transição para um design mais simples e de ponta a ponta. A regressão de caixas delimitadoras foi reprojetada para ser mais direta, reduzindo cálculos desnecessários sem comprometer a precisão. Essa mudança está alinhada à abordagem sem NMS do YOLO26.
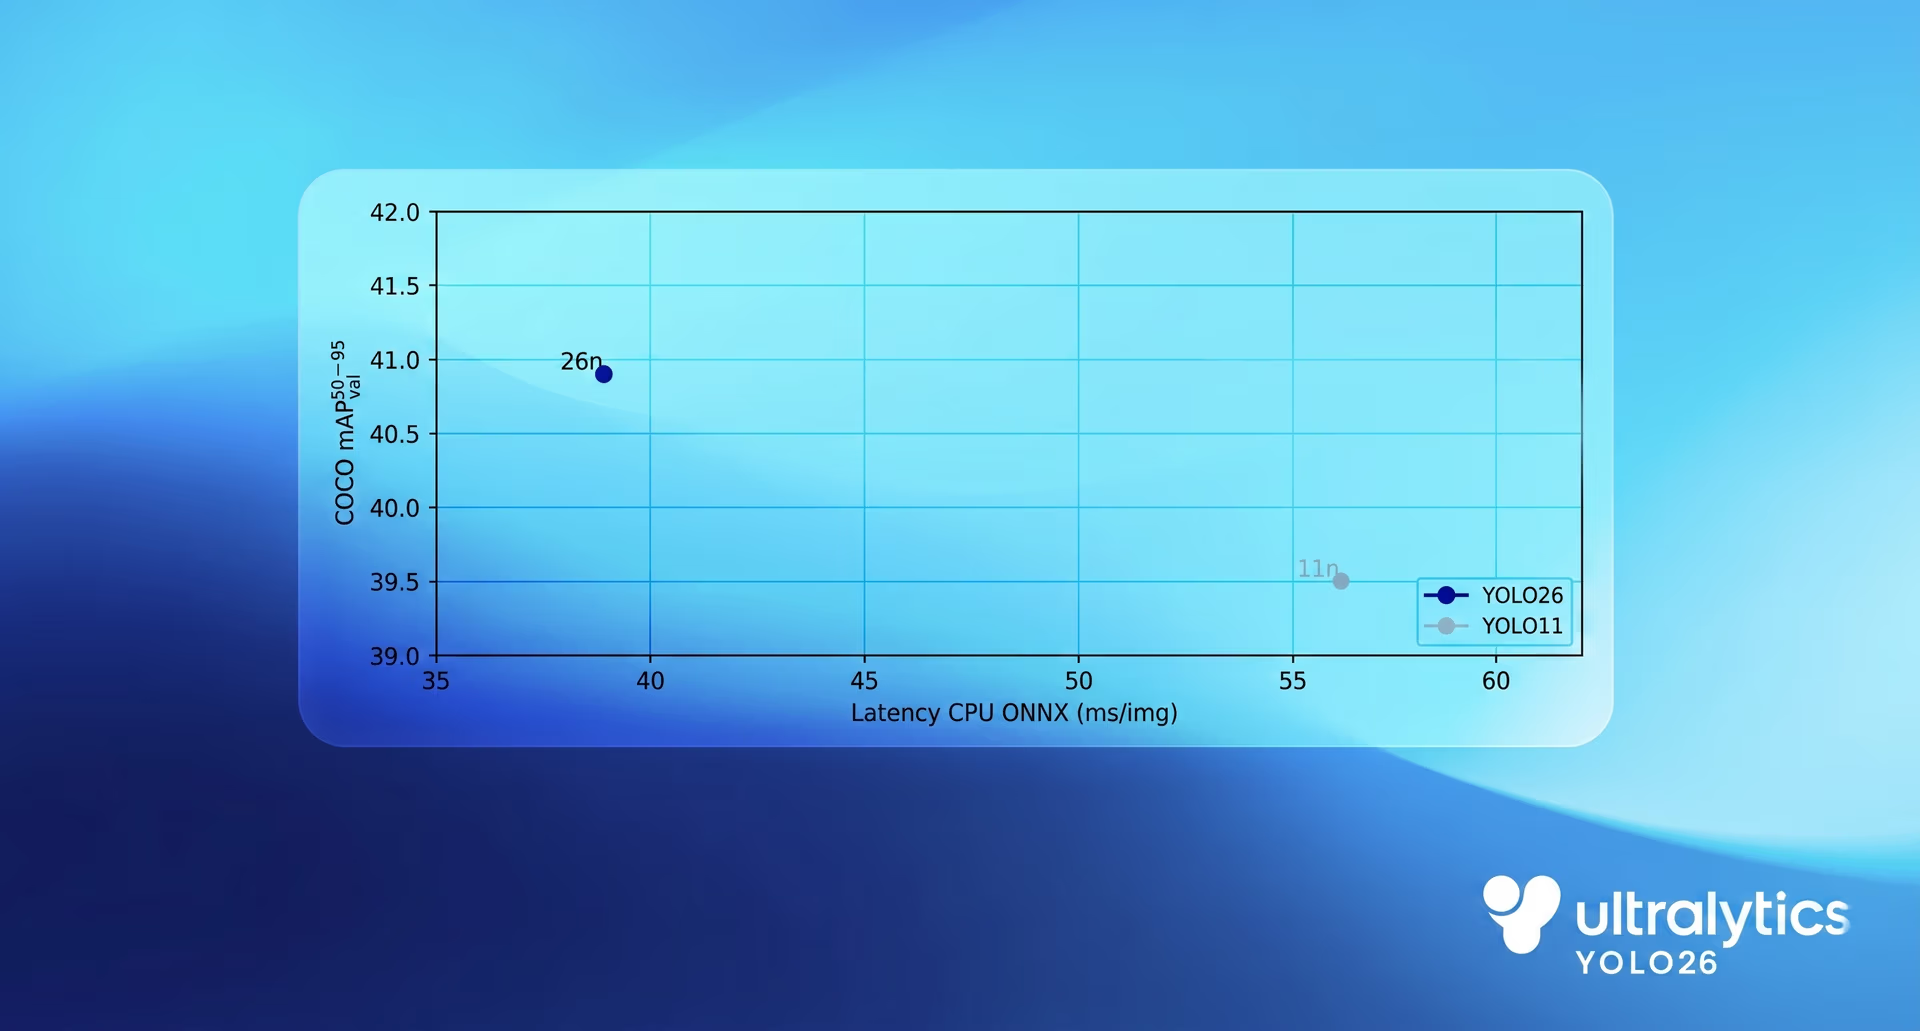
De onde vem a inferência 43% mais rápida na CPU#
Em benchmarks baseados em CPU, o YOLO26 apresenta uma melhoria clara de desempenho em relação aos modelos YOLO anteriores. Comparado ao Ultralytics YOLO11, o modelo nano do YOLO26 oferece inferência na CPU até 43% mais rápida, uma diferença que tem impacto significativo nas implantações de borda do mundo real.
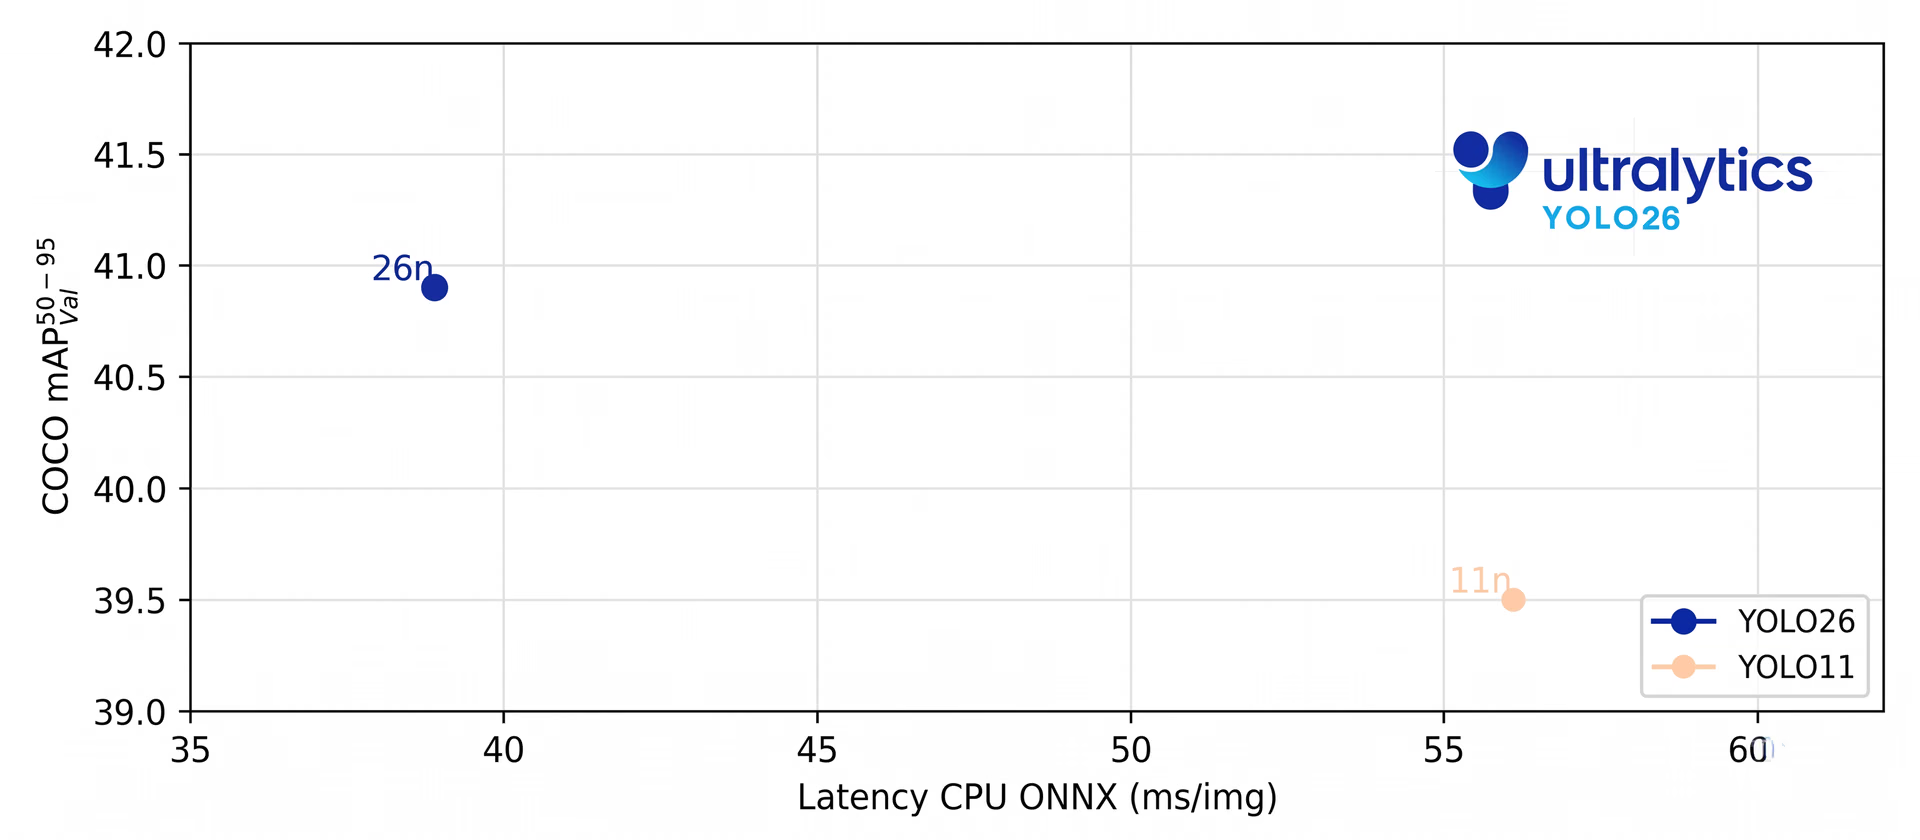
Fig. 4. Benchmark da velocidade do Ultralytics YOLO26 na CPU.
Esse ganho vem da simplificação de toda a linha de inferência, em vez da otimização de um único componente. A execução de ponta a ponta elimina a sobrecarga do pós-processamento, um método mais direto de regressão de caixas delimitadoras reduz os cálculos e as escolhas de design com foco na CPU melhoram a eficiência da execução em processadores de uso geral.
Em conjunto, essas mudanças reduzem a latência, diminuem a carga da CPU e resultam em um desempenho mais rápido e consistente no hardware de borda do mundo real.
O impacto do Ultralytics YOLO26 na implantação e nas exportações para a borda#
Os ganhos de desempenho do Ultralytics YOLO26 vão além de uma inferência mais rápida. Ao simplificar o modelo e reduzir a sobrecarga de memória, fica mais fácil implantá-lo e executá-lo de forma confiável em ambientes de borda.
O design de ponta a ponta do Ultralytics YOLO26 também simplifica a exportação. Com menos componentes auxiliares e sem etapas externas de pós-processamento, os modelos exportados são totalmente autossuficientes. Isso reduz as dependências específicas de cada plataforma e ajuda a garantir um comportamento consistente em diferentes ambientes de execução e alvos de hardware.
Na prática, isso significa que o Ultralytics YOLO26 pode ser implantado com mais facilidade em dispositivos de borda, como câmeras, robôs e sistemas embarcados, usando vários formatos de exportação. O que você exporta é o que executa, com menos etapas de integração e menor risco de divergências na implantação.
A inferência mais rápida na borda viabiliza a robótica e a IA de visão industrial#
Até aqui, vimos como o design do Ultralytics YOLO26 com foco na borda melhora o desempenho no nível do sistema. O impacto real, porém, está em como ele facilita a integração da IA de visão a aplicações do mundo real.
Por exemplo, em ambientes de robótica e industriais, os sistemas de visão costumam operar sob rigorosas restrições de tempo real. As decisões precisam ser tomadas com rapidez e consistência, usando recursos computacionais limitados e sem depender da conectividade com a nuvem. Com o Ultralytics YOLO26, atender a esses requisitos se torna viável.
Aplicações como navegação de robôs e manipulação de objetos se beneficiam de menor latência e inferência mais previsível, permitindo que os robôs respondam sem interrupções às mudanças no ambiente. Da mesma forma, em ambientes industriais, os modelos de visão podem ser executados diretamente nas linhas de produção para detectar defeitos, rastrear componentes e monitorar processos sem introduzir atrasos ou complexidade adicional.
Ao viabilizar inferências rápidas e confiáveis em hardware de borda, o Ultralytics YOLO26 ajuda a tornar a IA de visão uma parte natural da robótica e dos sistemas industriais, em vez de um desafio de implantação e manutenção.
Principais conclusões#
O Ultralytics YOLO26 foi desenvolvido para a borda, onde restrições do mundo real, como latência, memória e confiabilidade, definem o que é possível. Ao projetar o modelo em torno da execução com prioridade para CPU, da inferência de ponta a ponta e de uma implantação mais simples, o YOLO26 torna prática a integração da IA de visão em sistemas reais. Essa abordagem que prioriza a borda viabiliza uma ampla variedade de aplicações, da robótica e visão industrial à IA embarcada e executada no dispositivo, nas quais o desempenho e a previsibilidade são fundamentais.
Junta-te à nossa comunidade, que não para de crescer, e explora o nosso repositório no GitHub para encontrar recursos práticos sobre IA. Para desenvolver com IA de visão hoje mesmo, explora as nossas opções de licenciamento. Descobre como a IA na agricultura está transformando o setor agrícola e como a IA de visão na área da saúde está moldando o futuro visitando as nossas páginas de soluções.









