Melhore a robustez dos modelos de AI com aumento de dados
Descubra como adicionar variações realistas aos dados de treino através do aumento de dados ajuda a melhorar a robustez dos modelos de AI e o desempenho no mundo real.
Testar é uma parte crucial da criação de qualquer solução tecnológica. Isso mostra às equipas como um sistema funciona realmente antes de entrar em produção e permite corrigir problemas atempadamente. Isto aplica-se a muitas áreas, incluindo a IA, onde se espera que os modelos lidem com condições imprevisíveis do mundo real depois de implementados.
Por exemplo, a visão computacional é um ramo da IA que ensina as máquinas a compreender imagens e vídeos. Os modelos de visão computacional, como o Ultralytics YOLO26, suportam tarefas como deteção de objetos, segmentação de instâncias e classificação de imagens.
Podem ser utilizados em muitos setores para aplicações como monitorização de pacientes, análise de tráfego, pagamentos automatizados e inspeção de qualidade na indústria transformadora. No entanto, mesmo com modelos avançados e dados de treino de alta qualidade, as soluções de IA para visão podem continuar a ter dificuldades quando enfrentam variações do mundo real, como alterações na iluminação, movimento ou objetos parcialmente obstruídos.
Isto acontece porque os modelos aprendem com os exemplos que recebem durante o treino. Se nunca tiverem visto condições como reflexos intensos, desfocagem por movimento ou visibilidade parcial, terão menos probabilidade de reconhecer corretamente os objetos nesses cenários.
Uma forma de melhorar a robustez dos modelos é através do aumento de dados. Em vez de recolher grandes quantidades de dados novos, os engenheiros podem fazer pequenas alterações significativas às imagens existentes, como ajustar a iluminação, recortar ou combinar imagens. Isto ajuda o modelo a aprender a reconhecer os mesmos objetos numa maior variedade de situações.
Neste artigo, vamos explorar como o aumento de dados melhora a robustez dos modelos e a fiabilidade dos sistemas de IA para visão quando implementados fora de ambientes controlados. Vamos começar!
Como verificar a robustez de um modelo#
Antes de avançarmos para o aumento de dados, vamos explicar como determinar se um modelo de visão computacional está realmente preparado para utilização no mundo real.
Um modelo robusto continua a ter um bom desempenho mesmo quando as condições mudam, em vez de funcionar apenas com imagens nítidas e perfeitamente anotadas. Eis alguns fatores práticos a considerar ao avaliar a robustez de um modelo de IA:
- Alterações na iluminação: Os modelos podem comportar-se de forma diferente quando expostos a luz intensa, pouca luz, reflexos ou sombras, o que pode afetar a confiança com que os objetos são detetados.
- Oclusão parcial: Em cenas do dia a dia, os objetos são frequentemente bloqueados por outros itens ou ficam apenas parcialmente visíveis. Um modelo mais robusto consegue reconhecê-los mesmo com informação visual em falta.
- Cenas congestionadas: Os ambientes com muitos objetos sobrepostos podem tornar a deteção mais difícil. Os modelos que têm um bom desempenho nestes casos são normalmente mais fiáveis em contextos complexos.
Bons resultados em imagens nítidas e perfeitamente captadas nem sempre se traduzem num desempenho sólido no mundo real. Testes regulares em condições variadas ajudam a mostrar até que ponto um modelo se mantém eficaz depois de implementado.
O que é o aumento de dados?#
A forma como um objeto aparece numa fotografia pode mudar consoante a iluminação, o ângulo, a distância ou o fundo. Quando um modelo de visão computacional é treinado, o conjunto de dados com que aprende precisa de incluir este tipo de variação para que consiga ter um bom desempenho em ambientes imprevisíveis.
O aumento de dados amplia um conjunto de dados de treino ao criar exemplos adicionais a partir das imagens que já tens. Isto é feito através de alterações intencionais, como rodar ou inverter uma imagem, ajustar o brilho ou recortar uma parte da imagem.
Por exemplo, imagina que só tens uma fotografia de um gato. Se rodares a imagem ou alterares o seu brilho, podes criar várias versões novas a partir dessa única fotografia. Cada versão tem um aspeto ligeiramente diferente, mas continua a ser uma fotografia do mesmo gato. Estas variações ajudam a ensinar ao modelo que um objeto pode ter um aspeto diferente e continuar a ser a mesma coisa.
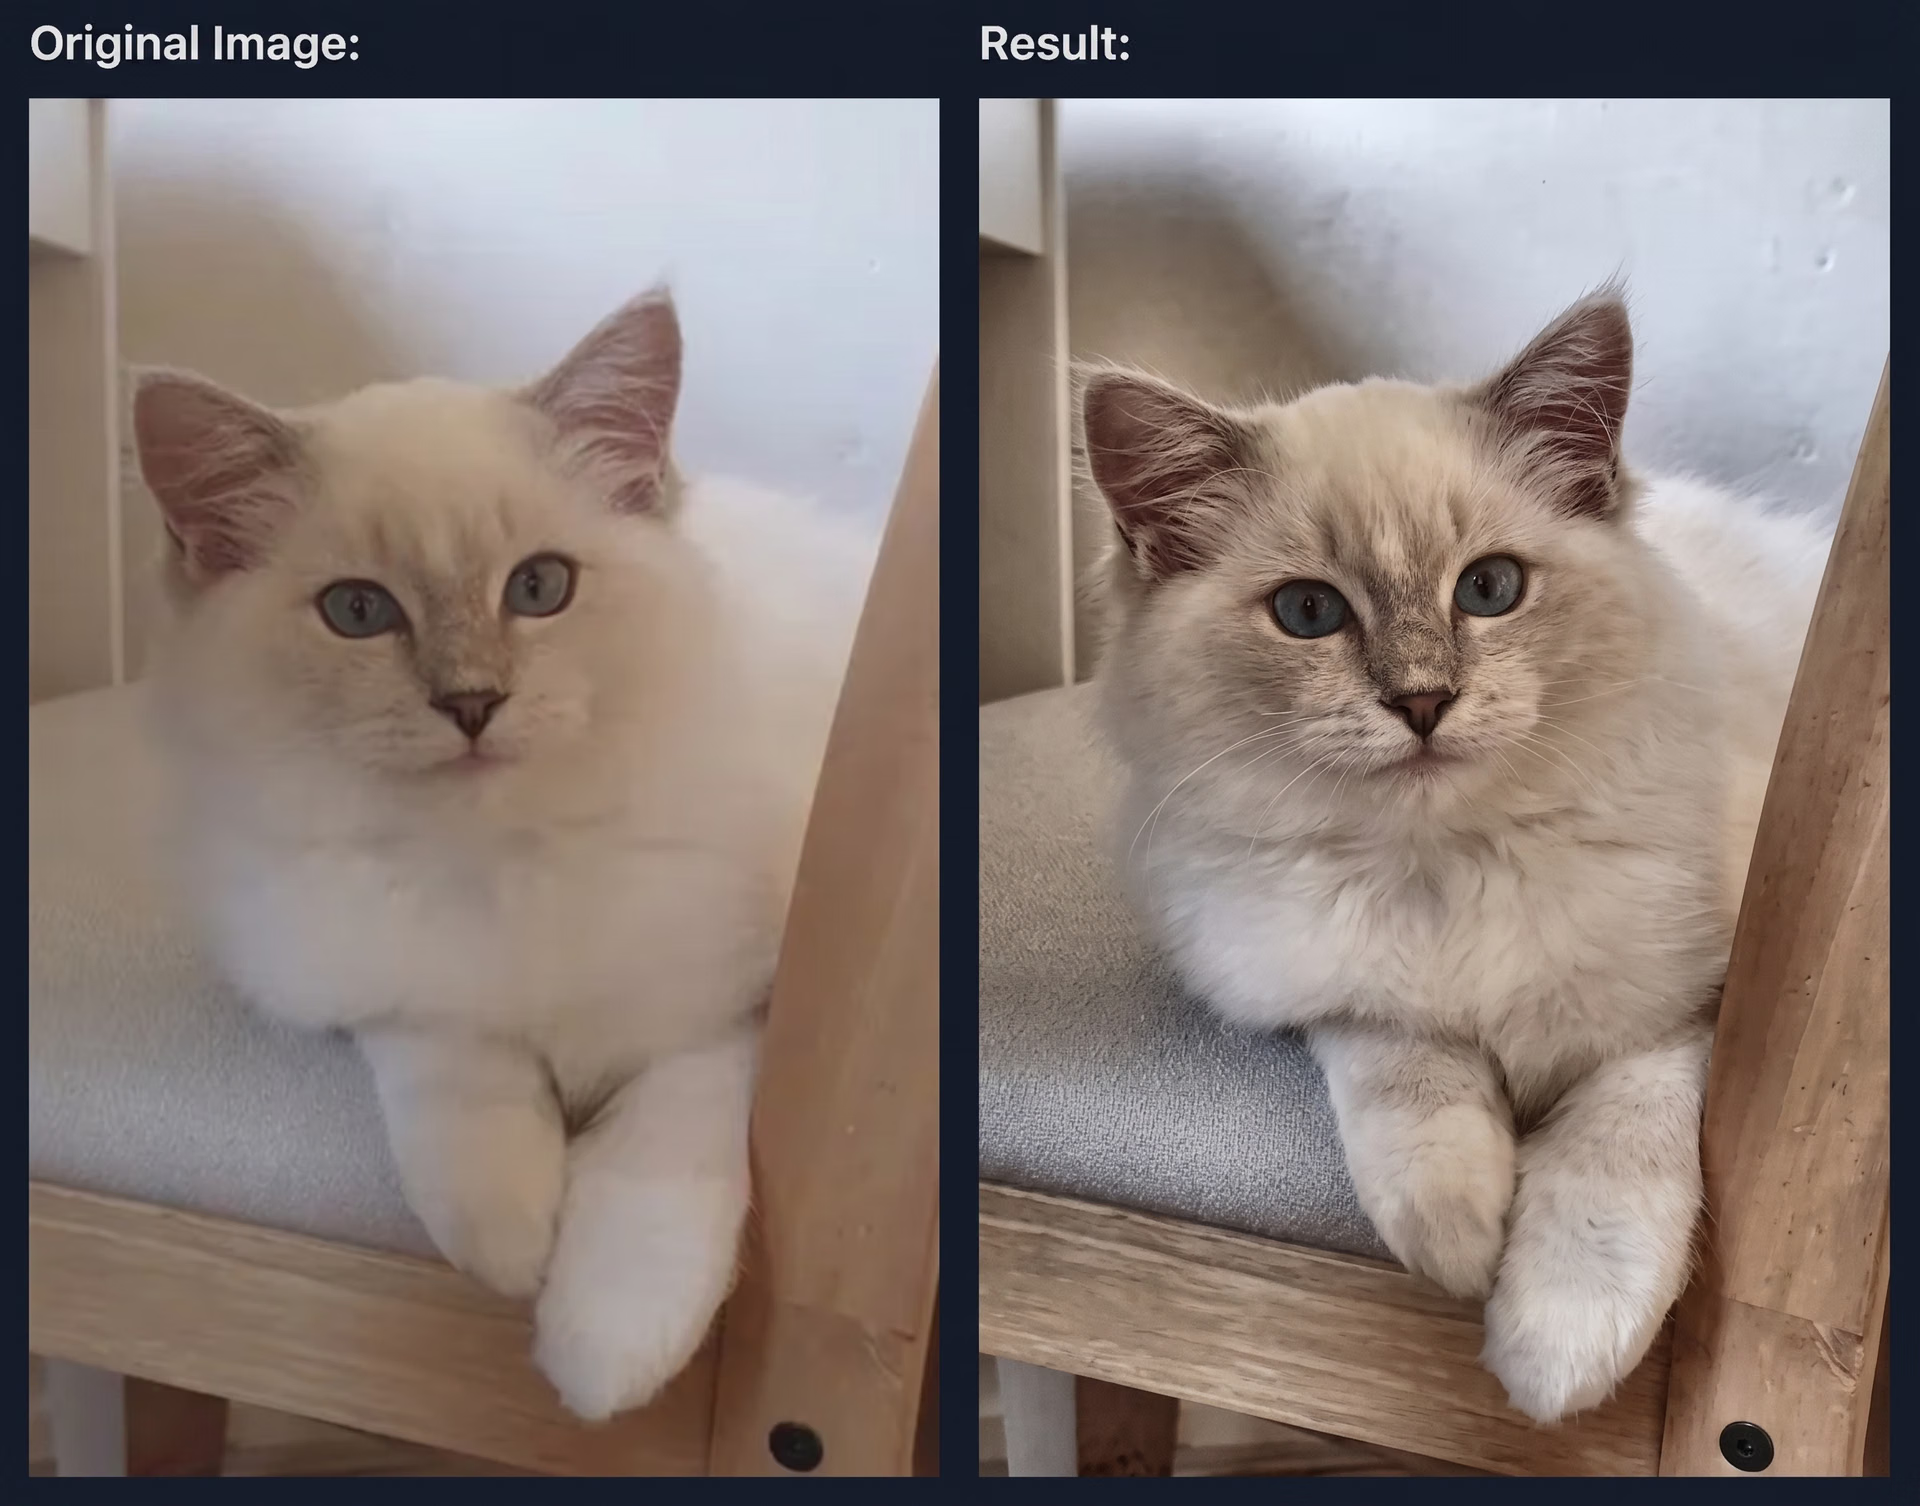
Fig. 1. Uma perspetiva do aumento de uma imagem de um gato (Fonte)
Como o aumento de dados melhora o desempenho dos modelos#
Durante o treino do modelo, o aumento de dados pode ser integrado diretamente no pipeline de treino. Em vez de criar e armazenar manualmente novas cópias das imagens, podem ser aplicadas transformações aleatórias à medida que cada imagem é carregada.
Isto significa que o modelo vê uma versão ligeiramente diferente da imagem de cada vez, quer esta apareça mais clara, invertida ou parcialmente oculta. Técnicas como a remoção aleatória podem até eliminar pequenas regiões da imagem para simular situações do mundo real em que um objeto está bloqueado ou apenas parcialmente visível.
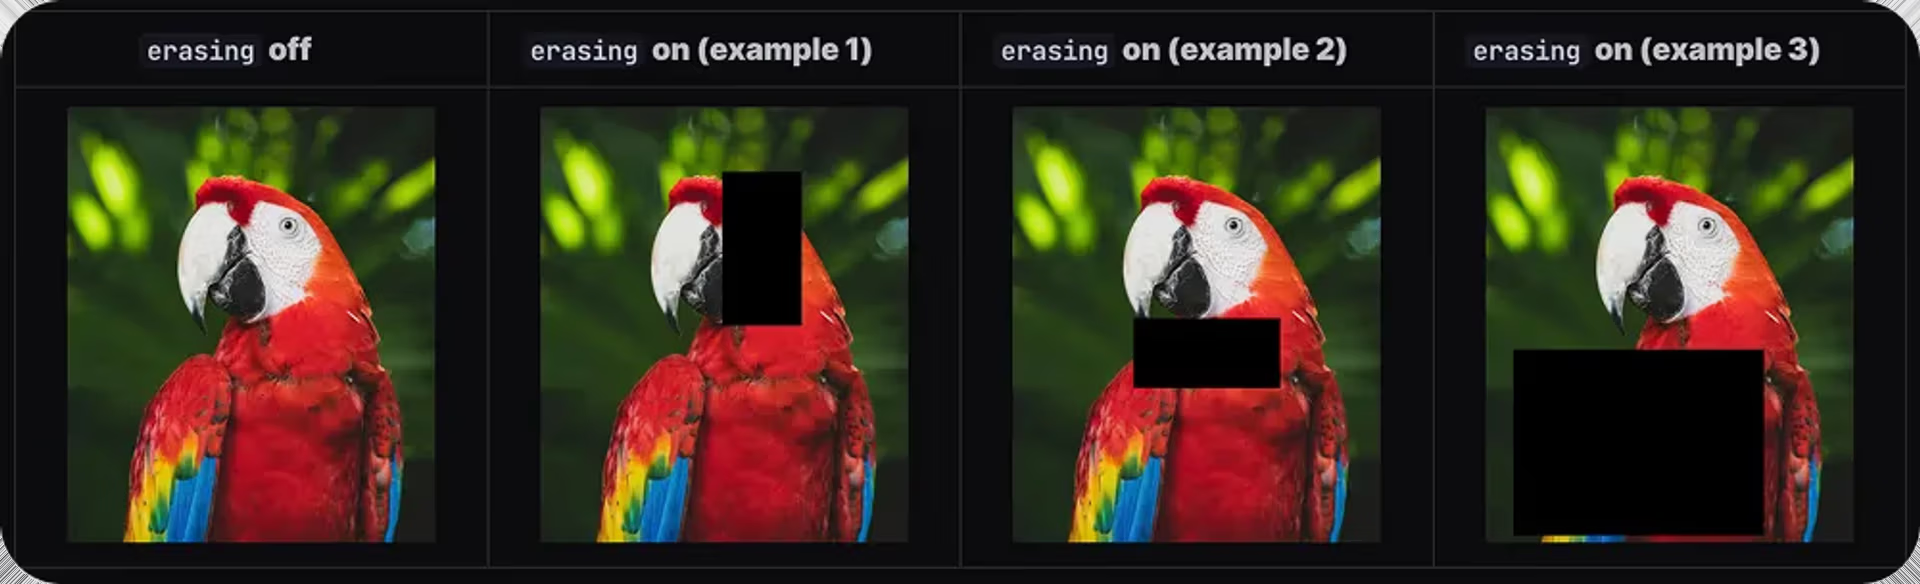
Fig. 2. Exemplos de aumento baseado na remoção aleatória (Fonte)
Observar muitas versões diferentes da mesma imagem permite ao modelo aprender quais são as características importantes, em vez de depender de um único exemplo perfeito. Esta variedade aumenta a robustez do modelo de IA, permitindo-lhe ter um desempenho mais fiável em condições do mundo real.
Técnicas comuns de aumento de dados#
Eis algumas técnicas de aumento de dados utilizadas para introduzir variação nas imagens de treino:
- Transformações geométricas: Estas técnicas alteram a forma como um objeto aparece espacialmente numa imagem. Rodar, inverter, redimensionar, recortar ou deslocar uma imagem permite ao modelo compreender como um objeto pode ser visto a partir de diferentes ângulos ou distâncias.
- Ajustes de cor e iluminação: A iluminação no mundo real raramente é consistente. As imagens podem estar demasiado claras, demasiado escuras ou apresentar ligeiras alterações de cor, dependendo do ambiente ou da câmara utilizada. Ajustar o brilho, o contraste, a tonalidade e a saturação permite aos modelos lidar com estas alterações visuais e ter um bom desempenho em diferentes cenas.
- Variações na qualidade da imagem: A desfocagem ou o ruído visual podem tornar as imagens pouco nítidas. Adicionar desfocagem ou ruído durante o treino ajuda o modelo a aprender a lidar com desfocagem por movimento, imagens com pouca luz ou resultados de câmaras de menor qualidade, tornando-o menos sensível a imagens imperfeitas.
- Aumentos baseados em oclusão: Em ambientes reais, os objetos são frequentemente bloqueados parcialmente por outros objetos. Isto é designado por oclusão de imagem. Ocultar ou mascarar pequenas áreas de uma imagem durante o treino ajuda o modelo a aprender a detetar objetos mesmo quando apenas parte deles está visível.
- Aumentos com várias imagens: Estas técnicas combinam partes de várias imagens num único exemplo de treino, o que pode aumentar o número de objetos visíveis e melhorar a capacidade do modelo para lidar com cenas complexas ou congestionadas.
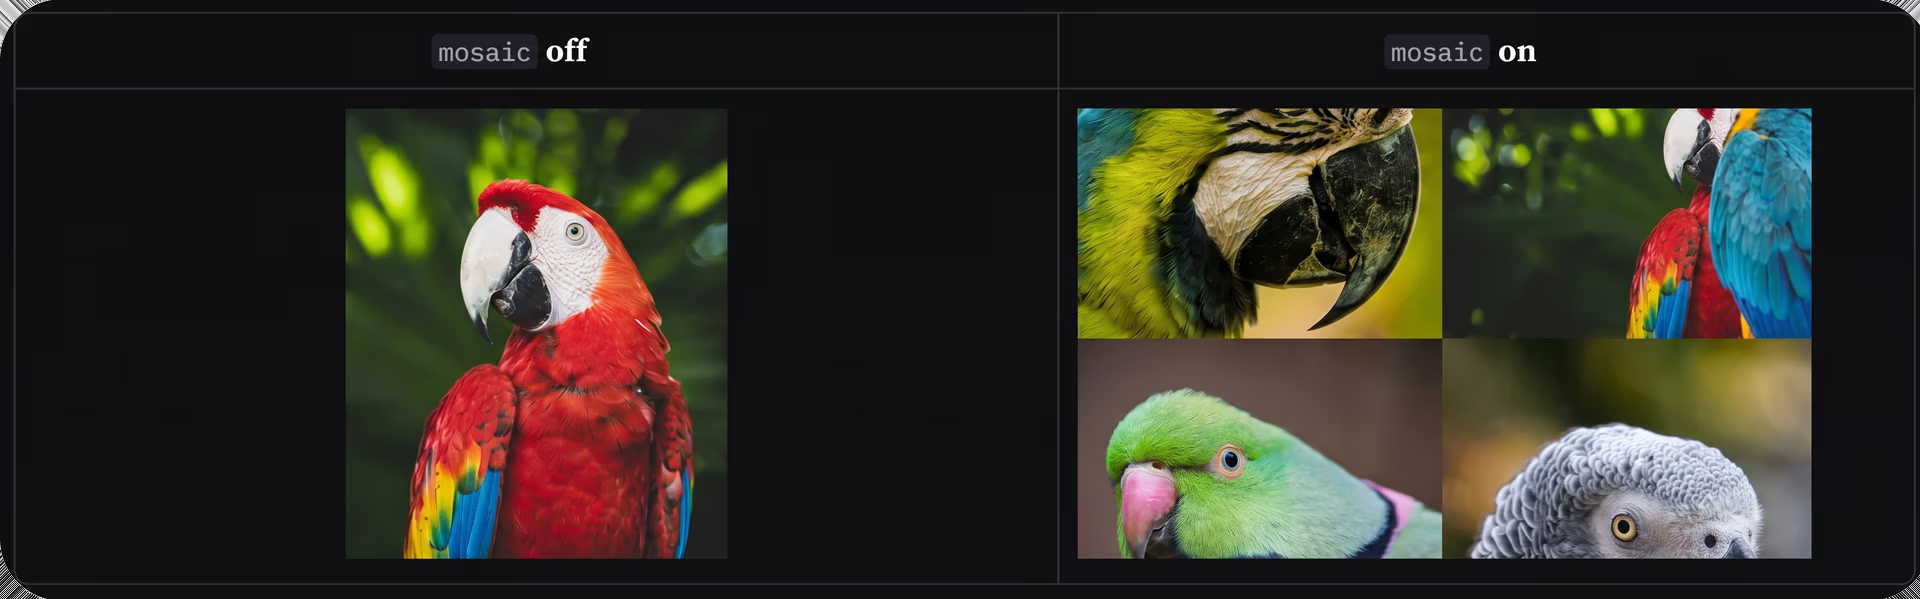
Fig. 3. Um exemplo de aumento com várias imagens (Fonte)
Aumento de dados simplificado com o pacote Python da Ultralytics#
Gerir conjuntos de dados, criar variações de imagens e escrever código de transformação pode acrescentar passos à criação de uma aplicação de visão computacional. O pacote Python da Ultralytics ajuda a simplificar este processo ao fornecer uma única interface para treinar, executar e implementar modelos Ultralytics YOLO, como o YOLO26. Como parte deste esforço para simplificar os fluxos de trabalho de treino, o pacote inclui aumento de dados integrado, testado pela Ultralytics e otimizado para modelos YOLO.
Também suporta integrações úteis que eliminam a necessidade de ferramentas separadas ou código personalizado. Especificamente para o aumento de dados, o pacote integra-se com a Albumentations, uma biblioteca de aumento de imagens amplamente utilizada. Esta integração permite aplicar aumentos automaticamente durante o treino, sem scripts adicionais ou código personalizado.
Gerir anotações e conjuntos de dados aumentados#
Outro fator que afeta a robustez dos modelos é a qualidade da anotação. Etiquetas limpas e precisas, criadas e geridas com ferramentas de anotação como a Roboflow, ajudam o modelo a compreender onde estão os objetos e qual é o seu aspeto.
Durante o treino, os aumentos de dados, como inversões, recortes e rotações, são aplicados dinamicamente, e as anotações são ajustadas automaticamente para corresponder a estas alterações. Quando as etiquetas são precisas, este processo decorre sem problemas e fornece ao modelo muitos exemplos realistas da mesma cena.
Se as anotações forem imprecisas ou inconsistentes, esses erros podem acabar por ser repetidos nas imagens aumentadas, o que pode tornar o treino menos eficaz. Começar com anotações precisas evita que esses erros se propaguem e contribui para uma maior robustez do modelo.
Melhorar aplicações de IA para visão com aumento de dados#
Em seguida, vamos analisar exemplos de como o aumento de dados contribui para a robustez dos modelos de IA em aplicações do mundo real.
Aumentar a precisão da deteção de objetos em ambientes reais#
As imagens sintéticas são frequentemente utilizadas para treinar sistemas de deteção de objetos quando os dados reais são limitados, sensíveis ou difíceis de recolher. Permitem às equipas gerar rapidamente exemplos de produtos, ambientes e ângulos de câmara sem terem de captar todas as situações na vida real.
No entanto, os conjuntos de dados sintéticos podem por vezes parecer demasiado limpos em comparação com imagens do mundo real, onde a iluminação varia, os objetos se sobrepõem e as cenas incluem desorganização no fundo. O aumento de dados ajuda a colmatar esta diferença ao introduzir variações realistas, como diferentes condições de iluminação, ruído ou posicionamento dos objetos, para que o modelo aprenda a lidar com os tipos de condições que encontrará depois de implementado.
Por exemplo, num estudo recente, um modelo Ultralytics YOLO11 foi treinado exclusivamente com imagens sintéticas, tendo sido adicionado aumento de dados para introduzir variação adicional. Isto contribuiu para que o modelo aprendesse a reconhecer objetos de forma mais abrangente. Teve um bom desempenho quando foi testado com imagens reais, apesar de nunca ter visto dados do mundo real durante o treino.
Tornar as soluções de imagiologia médica mais fiáveis#
Os conjuntos de dados de imagiologia médica são frequentemente limitados, e os próprios exames podem variar consoante o tipo de equipamento, as definições de aquisição ou o ambiente clínico. Diferenças na anatomia dos pacientes, nos ângulos, na iluminação ou no ruído visual podem dificultar a aprendizagem, por parte dos modelos de visão computacional, de padrões que generalizem bem entre pacientes e hospitais.
O aumento de dados ajuda a resolver este problema ao criar várias versões do mesmo exame durante o treino, como adicionar ruído, deslocar ligeiramente a imagem ou aplicar pequenas distorções. Estas alterações tornam os dados de treino mais representativos das condições clínicas reais.
Por exemplo, num estudo de imagiologia pediátrica, os investigadores utilizaram o Ultralytics YOLO11 para segmentação anatómica e treinaram-no com dados médicos aumentados. Introduziram variações como ruído adicional, ligeiros deslocamentos de posição e pequenas distorções para tornar as imagens mais realistas.
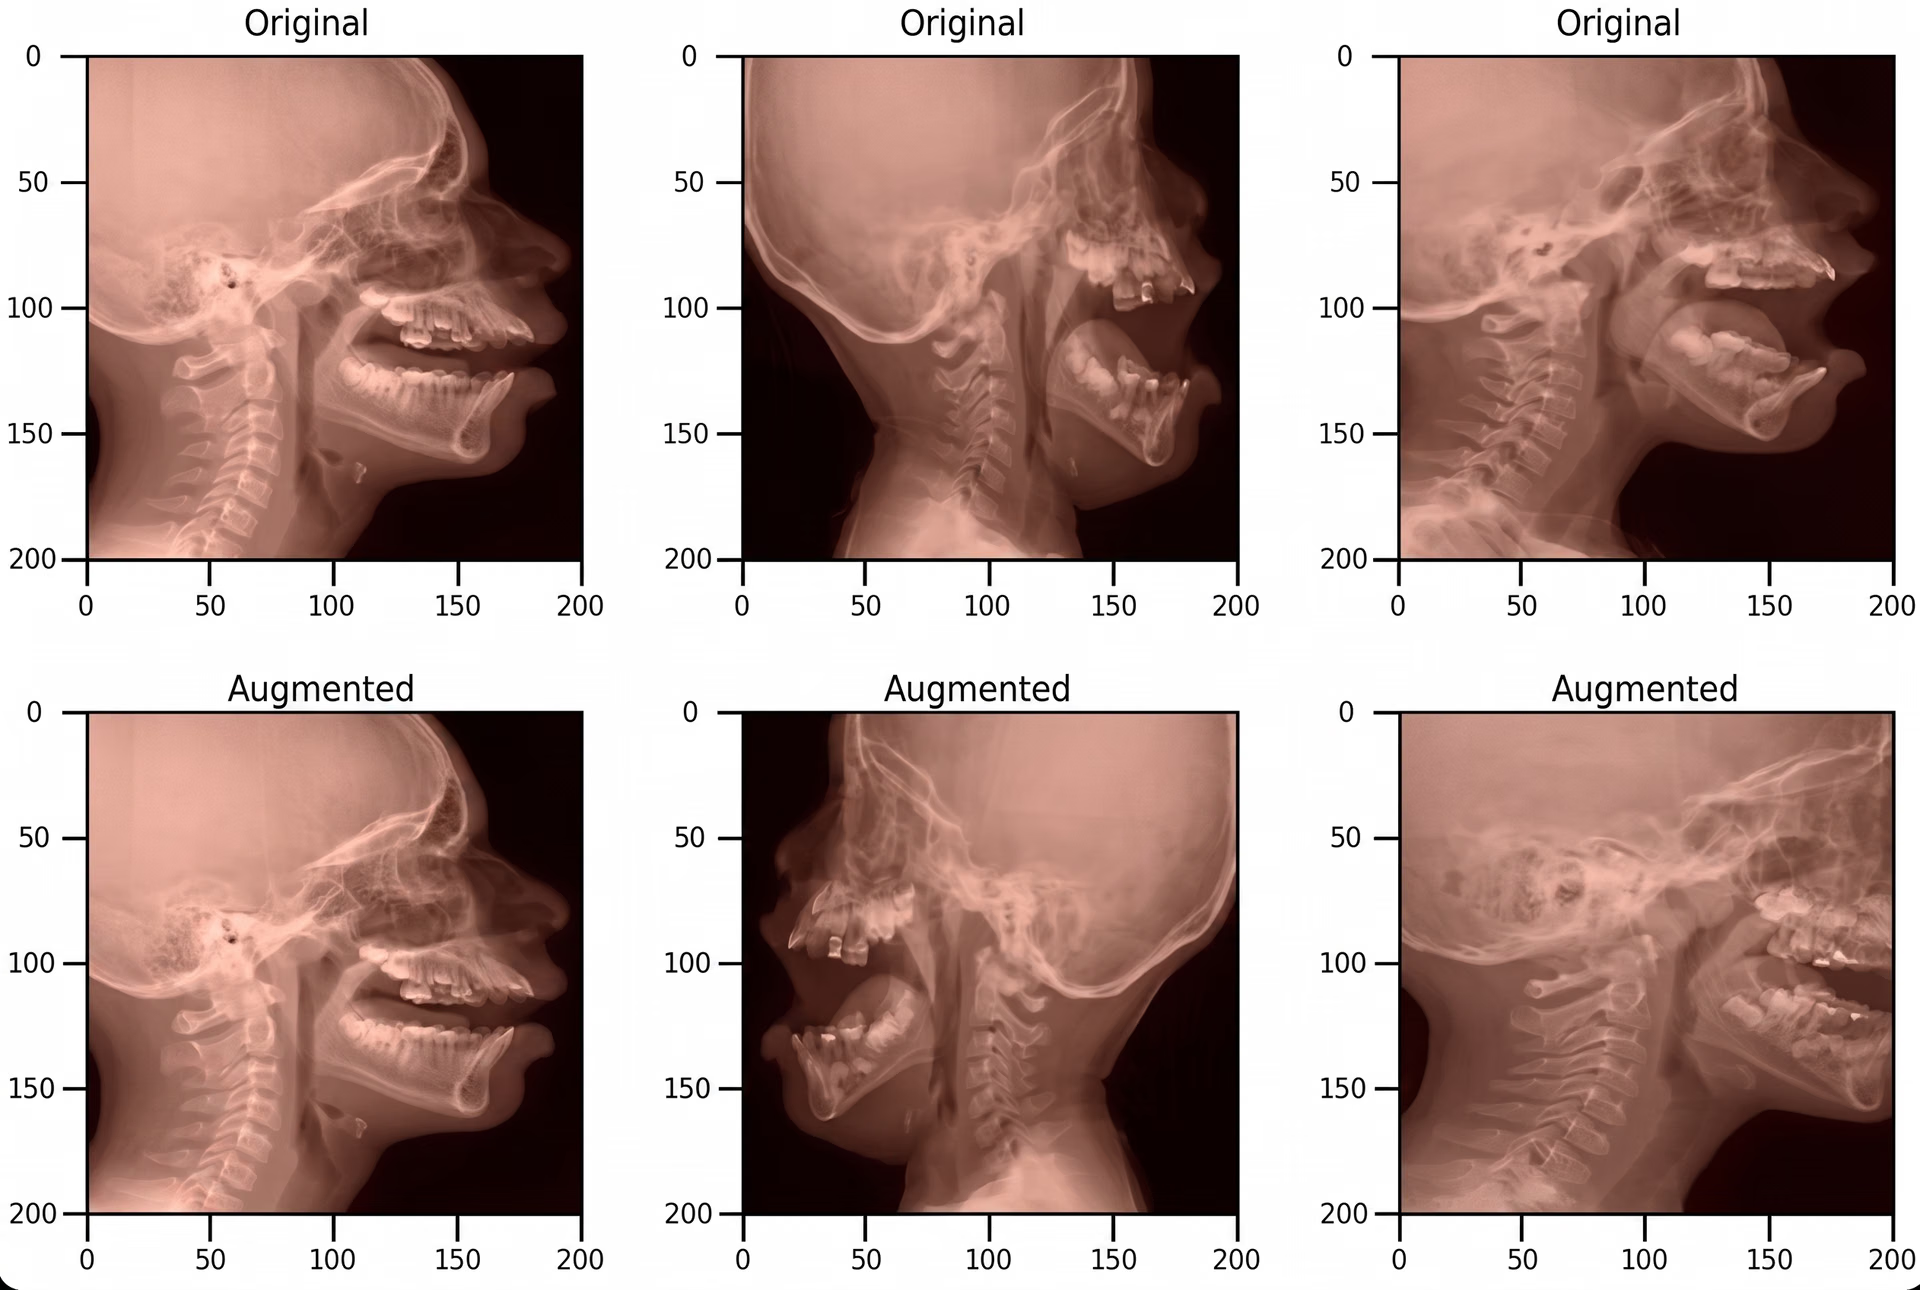
Fig. 4. Imagens médicas pediátricas originais e aumentadas (Fonte)
Ao aprender com estas variações, o modelo concentrou-se em características anatómicas relevantes, em vez de diferenças superficiais. Isto tornou os resultados da segmentação mais estáveis em diferentes exames e casos de pacientes.
Principais conclusões#
Recolher dados diversificados é difícil, mas o aumento de dados permite aos modelos aprender com uma gama mais ampla de condições visuais. Isto resulta numa maior robustez dos modelos ao lidar com oclusões, alterações na iluminação e cenas congestionadas. No geral, ajuda-os a ter um desempenho mais fiável fora dos ambientes de treino controlados.
Junta-te à nossa comunidade e explora as novidades em IA para visão no nosso repositório do GitHub. Visita as nossas páginas de soluções para saber como aplicações como a IA na indústria transformadora e a visão computacional na área da saúde estão a impulsionar o progresso, e consulta as nossas opções de licenciamento para impulsionar a tua próxima solução de IA.








