O que é estimativa monocular de profundidade? Uma visão geral
Saiba como funciona a estimativa monocular de profundidade, como ela se compara aos métodos de profundidade baseados em sensores e como possibilita percepção 3D escalável em sistemas de visão.
 Abirami Vina20 min de leitura
Os carros autónomos são concebidos para compreender o que se passa à sua volta, de modo a poderem conduzir em segurança. Isto significa ir além do simples reconhecimento de objetos, como peões ou outros veículos.
Também precisam de saber a que distância estão esses objetos para poderem reagir corretamente. No entanto, dar às máquinas esta noção de distância não é simples. Ao contrário dos humanos, não percecionam naturalmente a profundidade a partir de imagens e têm de ser explicitamente ensinadas a fazê-lo.
Uma das razões é que a maioria das câmaras capta o mundo como imagens planas e bidimensionais. Transformar essas imagens em algo que represente a profundidade e a estrutura 3D do mundo real é difícil, sobretudo quando os sistemas têm de funcionar de forma fiável nas condições do quotidiano.
Curiosamente, a visão computacional, um ramo da IA que se centra na interpretação e compreensão de dados visuais, permite que as máquinas compreendam melhor o mundo a partir de imagens. Por exemplo, a estimativa monocular de profundidade é uma técnica de visão computacional que estima a distância dos objetos usando apenas uma imagem captada por uma única câmara.
Ao aprenderem pistas visuais, como o tamanho dos objetos, a perspetiva, a textura e o sombreamento, estes modelos conseguem prever a profundidade sem depender de sensores adicionais, como LiDAR (deteção e telemetria por luz) ou câmaras estéreo. Neste artigo, vamos explorar o que é a estimativa de profundidade monocular, como funciona e algumas das suas aplicações no mundo real.
Uma breve introdução à estimativa monocular de profundidade.#
A estimativa monocular de profundidade permite que uma máquina compreenda a que distância estão os objetos usando apenas uma imagem. Como depende de uma única câmara, esta abordagem tem várias vantagens, incluindo um custo mais baixo e requisitos de hardware mais simples.
Por exemplo, pode ser usada em robôs domésticos acessíveis que funcionam com uma única câmara. Mesmo a partir de uma única imagem, o sistema robótico consegue identificar quais as paredes mais próximas e quais as portas mais distantes, além de inferir a profundidade geral do espaço.
Muitas vezes, uma única imagem não contém informação à escala correta, pelo que a estimativa monocular de profundidade se centra geralmente na profundidade relativa. Por outras palavras, consegue determinar quais os objetos mais próximos e quais os mais distantes, mesmo que não se conheçam as distâncias exatas.
Quando um modelo é treinado com dados que incluem distâncias de referência ou profundidade absoluta, como medições de profundidade de sensores como o LiDAR, pode aprender a prever distâncias em unidades do mundo real, como metros. Sem este tipo de dados de referência, o modelo ainda consegue inferir a profundidade relativa, mas não consegue estimar distâncias absolutas de forma fiável.
O resultado da estimativa monocular de profundidade é normalmente um mapa de profundidade, ou seja, uma imagem em que cada píxel representa a proximidade ou a distância dessa parte da cena. Um mapa de profundidade proporciona aos sistemas de visão uma compreensão básica da estrutura 3D do ambiente.
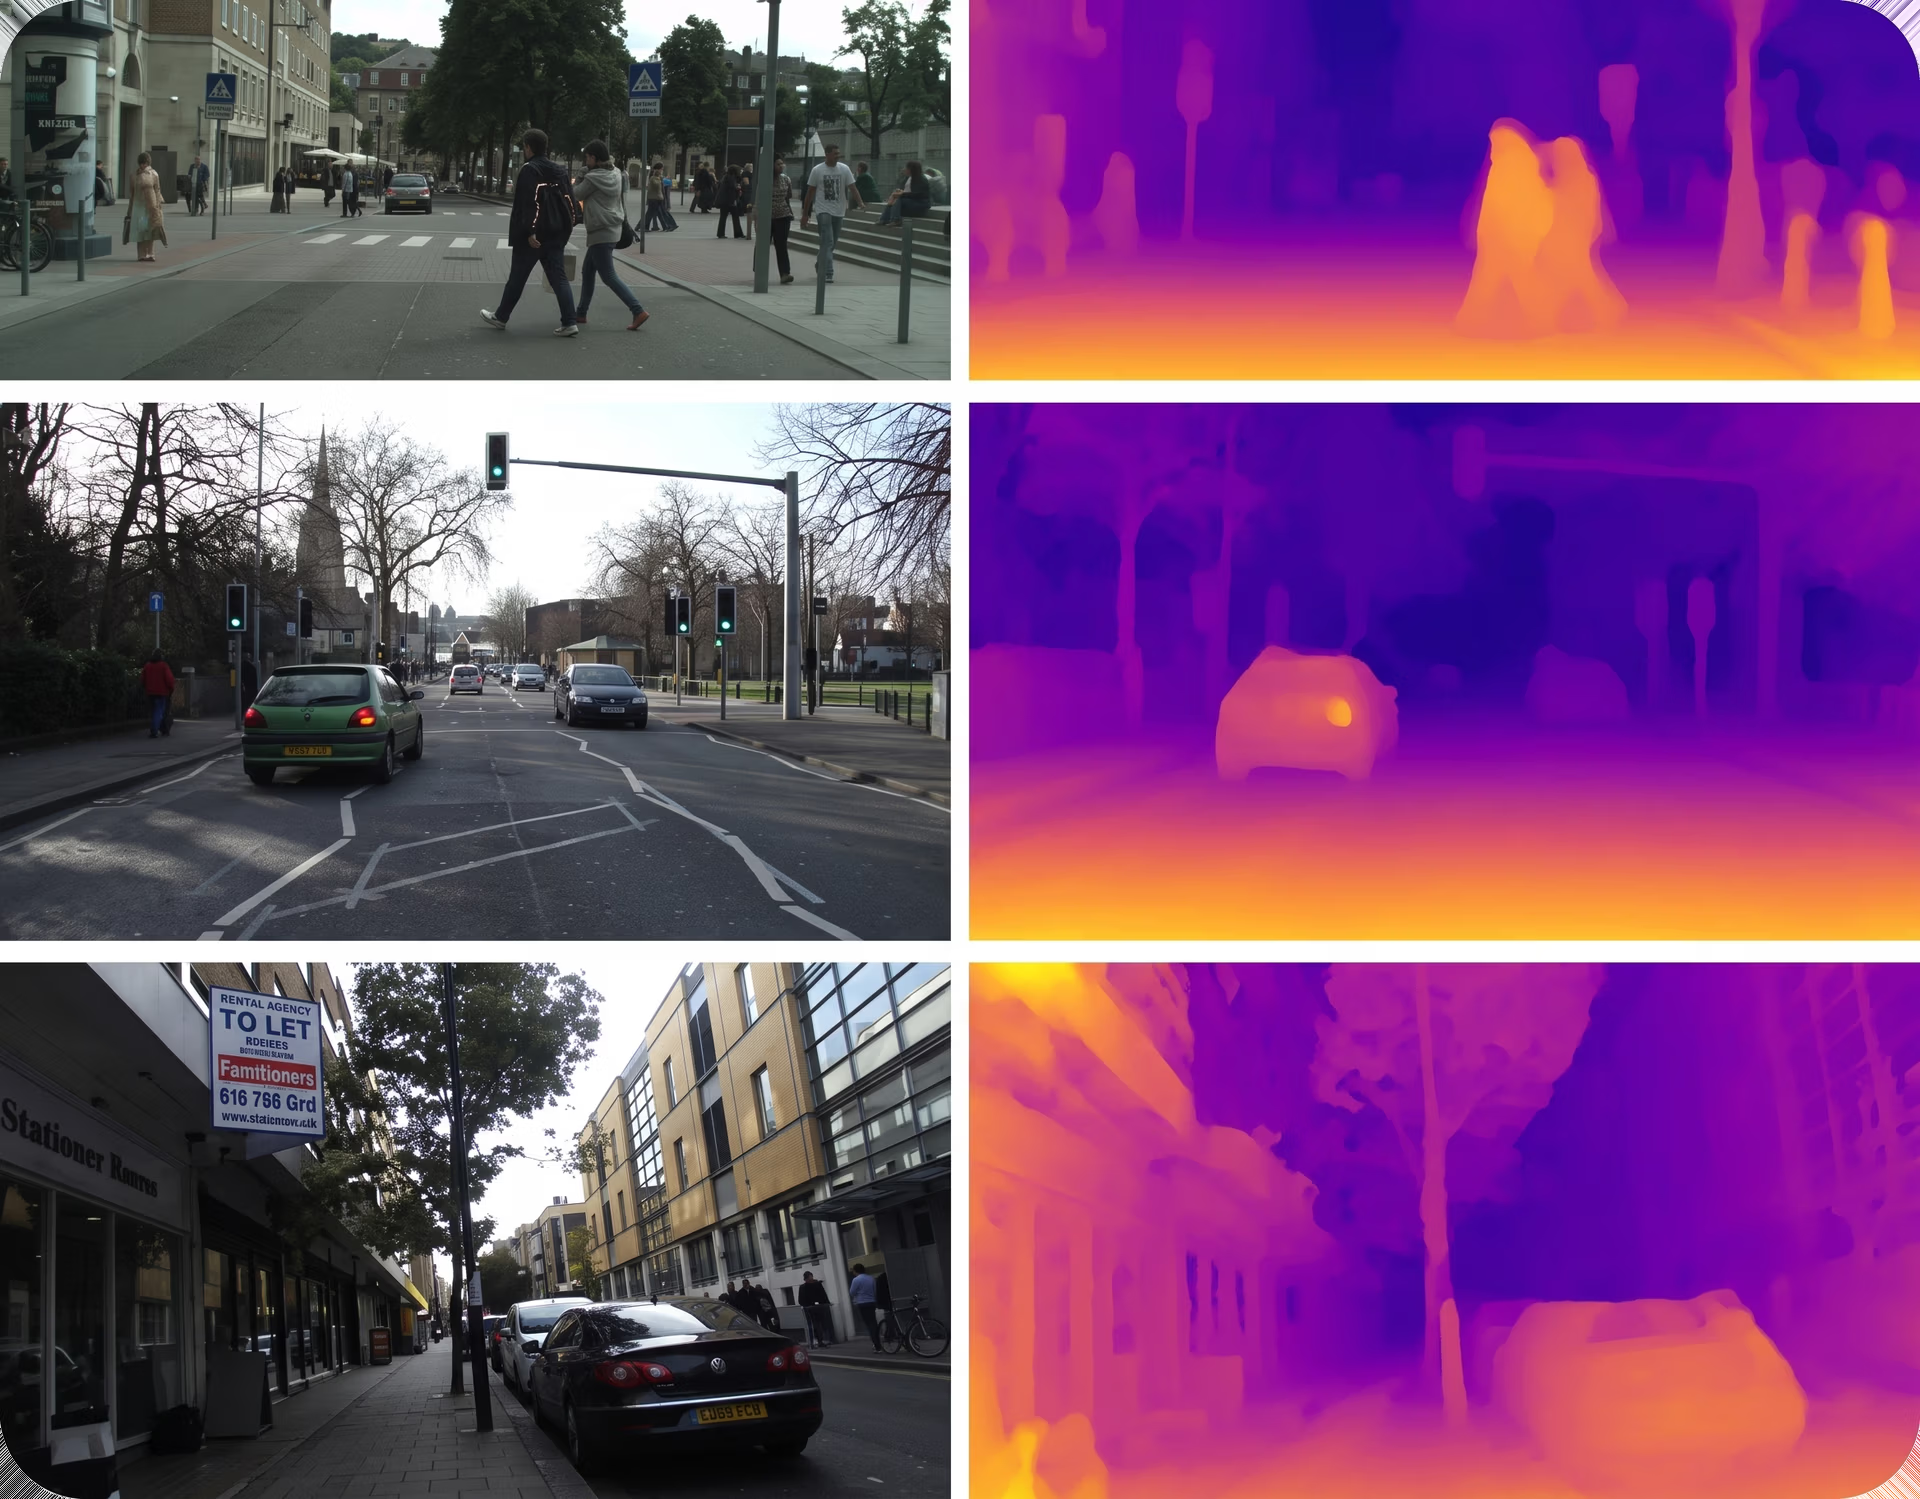
Fig. 1. Exemplo de um mapa de profundidade previsto, criado através de estimativa monocular de profundidade (Fonte)
Dos sensores às imagens: estimar a profundidade.#
A estimativa de profundidade pode ser abordada de várias formas, dependendo dos sensores disponíveis, das limitações de hardware e dos requisitos de precisão. Os métodos tradicionais recorrem frequentemente a vários pontos de vista ou a sensores especializados para medir diretamente a distância.
Uma abordagem comum é a visão estéreo, que estima a profundidade comparando duas imagens sincronizadas, captadas de pontos de vista ligeiramente diferentes. Ao medir a diferença entre pontos correspondentes nas duas imagens, o sistema consegue inferir a distância dos objetos em relação à câmara.
Outra abordagem são os sistemas RGB-D (vermelho, verde, azul e profundidade), que usam sensores de profundidade ativos para medir diretamente a distância em cada píxel. Estes sistemas podem fornecer informações precisas sobre a profundidade em ambientes controlados, mas exigem hardware adicional.
Por sua vez, os métodos baseados em LiDAR usam impulsos laser para gerar representações tridimensionais precisas de uma cena. Embora sejam muito precisos, os sensores LiDAR são frequentemente dispendiosos e aumentam significativamente a complexidade do hardware.
Em contrapartida, a estimativa monocular de profundidade infere a profundidade usando apenas uma imagem RGB. Como não depende de várias câmaras nem de sensores especializados, é mais fácil de implementar em grande escala e é uma boa opção quando os custos e os recursos de hardware são limitados.
Aprender a estimar a profundidade a partir de uma única imagem.#
Ao estimarem a profundidade a partir de uma única imagem, os modelos de profundidade monocular aprendem a reconhecer pistas visuais que os humanos usam instintivamente para avaliar distâncias. Estas pistas incluem linhas de perspetiva, o tamanho dos objetos, a densidade da textura, a sobreposição de objetos e o sombreamento, que fornecem indicações sobre a distância dos objetos em relação à câmara.
Estas pistas combinam-se para criar uma sensação de profundidade. Os objetos que parecem mais pequenos ou estão parcialmente ocultos estão frequentemente mais distantes, enquanto os detalhes mais nítidos e a maior dimensão visual costumam indicar que algo está mais próximo.
Para aprender estes padrões, os modelos de profundidade monocular são treinados com conjuntos de dados de imagens em grande escala, muitas vezes emparelhados com informações de profundidade obtidas de outras fontes, como LiDAR ou sistemas estéreo. Durante o treino, os modelos aprendem como as pistas visuais se relacionam com a profundidade, o que lhes permite inferir distâncias a partir de uma única imagem durante a inferência.
Com dados de treino diversificados, os modelos de visão modernos conseguem generalizar esta compreensão aprendida a uma vasta gama de ambientes, incluindo cenas interiores e exteriores, e lidar com pontos de vista desconhecidos.
Uma análise de várias técnicas de estimativa monocular de profundidade.#
Em seguida, vamos explorar as principais abordagens usadas para estimar a profundidade a partir de uma única imagem e a evolução destes métodos ao longo do tempo.
Abordagens clássicas e baseadas na geometria.#
Os primeiros métodos de estimativa de profundidade baseavam-se em regras visuais simples associadas à geometria da câmara. Usavam pistas como a perspetiva, o tamanho dos objetos e o facto de um objeto ocultar outro para estimar a distância.
Por exemplo, quando dois objetos semelhantes apareciam com tamanhos diferentes, assumia-se que o mais pequeno estava mais distante. Estas abordagens funcionavam razoavelmente bem em ambientes controlados, onde fatores como a iluminação, a posição da câmara e a disposição da cena se mantinham consistentes.
No entanto, em cenas do mundo real, estes pressupostos falham muitas vezes. As variações de iluminação, as mudanças de ponto de vista e o aumento da complexidade da cena podem levar a estimativas de profundidade pouco fiáveis, limitando a eficácia dos métodos clássicos em ambientes não controlados.
Primeiras abordagens de aprendizagem automática.#
Os primeiros métodos de aprendizagem automática trouxeram mais flexibilidade à estimativa de profundidade, ao aprenderem padrões diretamente a partir dos dados. Em vez de dependerem apenas de regras geométricas fixas, estes modelos procuravam aprender a relação entre a informação visual e a distância, tratando a previsão de profundidade como um problema de regressão baseado em pistas como contornos, texturas e alterações de cor.
A seleção destas características era uma parte fundamental do processo. Os engenheiros tinham de decidir quais os sinais visuais a extrair e como os representar, e o desempenho do modelo dependia muito dessas escolhas.
Embora esta abordagem funcionasse melhor do que os métodos anteriores, continuava a ter limitações. Se as características selecionadas não incluíssem contexto importante, as previsões de profundidade eram menos precisas. À medida que as cenas se tornavam mais complexas e variadas, estes modelos tinham muitas vezes dificuldade em produzir resultados fiáveis.
Algoritmos de aprendizagem profunda.#
A maioria dos sistemas modernos de estimativa monocular de profundidade usa aprendizagem profunda, que se refere a redes neuronais com muitas camadas capazes de aprender padrões complexos a partir dos dados. Estes modelos aprendem a prever diretamente a profundidade a partir de imagens e a produzir mapas de profundidade.
Muitas abordagens são construídas com redes neuronais convolucionais (CNNs), um tipo de rede neuronal concebido para processar imagens através da deteção de padrões, como contornos e formas. Estes modelos usam frequentemente uma estrutura codificador-descodificador: o codificador extrai características visuais da imagem e o descodificador converte essas características num mapa de profundidade. O processamento da imagem a várias escalas ajuda o modelo a captar a disposição geral da cena e, ao mesmo tempo, a identificar claramente os limites dos objetos.
Os modelos mais recentes centram-se na compreensão das relações entre diferentes partes de uma imagem. Os modelos baseados em Transformer e os Transformer de Visão (ViT) usam mecanismos de atenção, que permitem ao modelo identificar as regiões da imagem mais relevantes e relacionar entre si áreas distantes. Isto ajuda o modelo a construir uma compreensão mais consistente da profundidade em toda a cena.
Alguns sistemas combinam ambas as abordagens. Os modelos híbridos CNN–Transformer usam CNNs para captar detalhes locais finos e Transformers para modelar o contexto global da cena. Embora isso muitas vezes melhore a precisão, normalmente exige mais recursos computacionais, como memória adicional e capacidade de processamento.
Porque é importante compreender a profundidade nos sistemas de IA visual.#
Ao aprenderes sobre a estimativa monocular de profundidade, talvez te perguntes porque é que compreender a profundidade é uma parte tão importante dos sistemas de IA baseados em visão.
Quando um sistema consegue estimar a distância a que estão os objetos e as superfícies, passa a compreender melhor a disposição de uma cena e a relação entre os seus diferentes elementos. Este tipo de perceção espacial é essencial para tomar decisões fiáveis, sobretudo em aplicações do mundo real, como a condução autónoma.
A informação sobre a profundidade também acrescenta contexto valioso a outras tarefas de visão computacional. Por exemplo, a deteção de objetos, suportada por modelos como o Ultralytics YOLO26, pode indicar a um sistema o que está presente numa cena, mas a profundidade ajuda a determinar onde esses objetos se encontram em relação à câmara e entre si.
Em conjunto, estas capacidades permitem uma vasta gama de aplicações de IA visual, como construir mapas 3D, navegar em ambientes complexos e compreender uma cena como um todo.
Os robôs e os veículos autónomos dependem desta informação para se deslocarem em segurança, evitarem obstáculos e reagirem a alterações em tempo real. Por exemplo, a abordagem de condução da Tesla baseada apenas em visão recorre a imagens de câmaras combinadas com a estimativa de profundidade, em vez de LiDAR, para compreender a distância a que estão os objetos e a sua posição na estrada.
Como funcionam os modelos de estimativa monocular de profundidade.#
Embora as arquiteturas dos modelos variem, a maioria dos modelos de estimativa monocular de profundidade segue um processo semelhante para converter uma única imagem num mapa de profundidade. Segue-se uma breve visão geral das principais etapas:
- Entrada e pré-processamento: O fluxo de trabalho começa com uma imagem de entrada. Antes de ser introduzida no modelo, a imagem original é normalmente redimensionada, normalizada e convertida num tensor, um formato que as redes neuronais usam para processar dados de imagem com eficiência.
- Extração de características: Uma rede codificadora analisa a imagem para extrair características visuais relevantes. Estas características captam informações como texturas, limites dos objetos e a disposição geral da cena. A maioria dos modelos opera em várias escalas para compreender tanto os detalhes finos como a estrutura global.
- Raciocínio sobre a profundidade: Com as características extraídas, o modelo combina detalhes locais com o contexto global para raciocinar sobre as relações espaciais na cena. Nesta fase, aprende quais as regiões da imagem que estão mais próximas da câmara e quais estão mais distantes.
- Geração do mapa de profundidade: Em seguida, um descodificador converte esta informação num mapa de profundidade denso. É atribuído um valor de profundidade a cada píxel da imagem, muitas vezes combinando previsões de diferentes escalas para melhorar a precisão e a consistência.
Como são treinados os modelos de estimativa monocular de profundidade.#
O processo que acabámos de descrever pressupõe que já temos um modelo treinado ou pré-treinado. Mas como funciona, na prática, o treino de um modelo de estimativa monocular de profundidade?
O treino começa com a preparação dos dados de imagem para que a rede os possa processar com eficiência. As imagens de entrada são redimensionadas e normalizadas para uma escala consistente e, em seguida, são introduzidas no modelo, que gera um mapa de profundidade previsto que estima a distância em cada píxel.
O mapa de profundidade previsto é então comparado com dados de profundidade de referência através de uma função de perda, que mede a diferença entre a previsão do modelo e a profundidade real. Este valor de perda representa o erro atual do modelo e fornece um sinal para o melhorar.
Um otimizador usa este sinal para atualizar o modelo, ajustando os seus pesos internos. Para tal, calcula o gradiente, que descreve como a perda varia em relação a cada parâmetro do modelo, e aplica estas atualizações repetidamente ao longo de várias épocas, ou seja, passagens completas pelo conjunto de dados de treino.
Este processo iterativo de treino supervisionado é orientado por hiperparâmetros, como a taxa de aprendizagem, que controla a dimensão de cada passo de atualização, e o tamanho do lote, que determina quantas imagens são processadas de cada vez. Como o treino envolve um grande número de operações matemáticas, é normalmente acelerado com uma unidade de processamento gráfico (GPU), ideal para computação paralela.
Após a conclusão do treino, o modelo é avaliado com métricas de avaliação padrão num conjunto de validação, composto por imagens que não foram usadas durante o treino. Esta avaliação ajuda a medir a capacidade do modelo de generalizar para dados novos.
O modelo treinado pode então ser reutilizado ou ajustado para novos cenários. De um modo geral, este processo de treino permite que os modelos de estimativa monocular de profundidade produzam estimativas consistentes, essenciais para tarefas subsequentes, como a reconstrução 3D e a implementação no mundo real.
Explorar modelos de ponta e tendências de investigação.#
A estimativa monocular de profundidade evoluiu rapidamente à medida que os modelos se tornaram melhores a compreender cenas inteiras, em vez de apenas pequenos detalhes visuais. As abordagens anteriores produziam muitas vezes mapas de profundidade irregulares, sobretudo em ambientes complexos.
Os modelos mais recentes, como os apresentados em investigação publicada recentemente no arXiv, dão maior ênfase ao contexto global, o que resulta em previsões de profundidade mais estáveis e realistas. Modelos conhecidos, como MiDaS e DPT, ajudaram a impulsionar esta mudança ao aprenderem a estimar profundidade a partir de conjuntos de dados diversos e de alta resolução, generalizando bem para muitas cenas.
Modelos mais recentes, incluindo ZoeDepth e Depth Anything V2, desenvolvem este trabalho, melhorando a consistência da escala e mantendo um desempenho elevado numa vasta gama de cenários. Este tipo de progresso é frequentemente avaliado através de conjuntos de dados de benchmark comuns, como KITTI e NYU Depth V2, que abrangem cenas exteriores e interiores.
Uma tendência clara é encontrar o equilíbrio entre precisão e praticidade. Os modelos mais pequenos são otimizados para velocidade e podem funcionar em tempo real em dispositivos de edge ou móveis, enquanto os modelos maiores privilegiam uma resolução superior e maior precisão na estimativa de profundidade a longa distância. Por exemplo, os modelos de profundidade Ultralytics YOLO26 vão desde o leve YOLO26n-depth, destinado a utilização de edge em tempo real, até ao YOLO26x-depth, maior e mais preciso.
Aplicações da estimativa monocular de profundidade.#
Em seguida, vamos analisar alguns exemplos do mundo real que mostram como a estimativa monocular de profundidade é usada para inferir a estrutura 3D de uma cena a partir de uma única imagem.
Em todos estes casos, é importante ter em conta que a informação sobre a profundidade é uma estimativa inferida a partir de pistas visuais, não uma medição precisa. Isto torna a estimativa monocular de profundidade útil para compreender a disposição relativa e as relações espaciais, mas não substitui sensores concebidos para medir distâncias com precisão, como o LiDAR ou os sistemas estéreo.
Mapeamento do terreno e navegação com drones.#
Os drones operam frequentemente em ambientes onde os sinais de GPS não são fiáveis, como florestas, estaleiros de construção, zonas afetadas por catástrofes ou áreas urbanas densas. Para voarem em segurança nestas condições, têm de compreender o terreno circundante e saber a que distância estão os obstáculos. No passado, isso exigia normalmente a instalação de sensores como LiDAR ou câmaras estéreo, que aumentam o peso, o consumo de energia e o custo total.
A estimativa monocular de profundidade é uma alternativa mais simples. Usando apenas uma câmara RGB, os drones podem estimar a profundidade a partir de imagens e construir uma compreensão 3D básica do ambiente. Isto permite-lhes detetar obstáculos como edifícios, árvores ou mudanças súbitas no terreno e ajustar a trajetória de voo em tempo real.
Estas estimativas de profundidade apoiam tarefas essenciais de navegação, incluindo evitar obstáculos, controlar a altitude e aterrar em segurança. Como resultado, os drones leves podem realizar tarefas de mapeamento, inspeção e navegação sem depender de sensores de profundidade especializados.
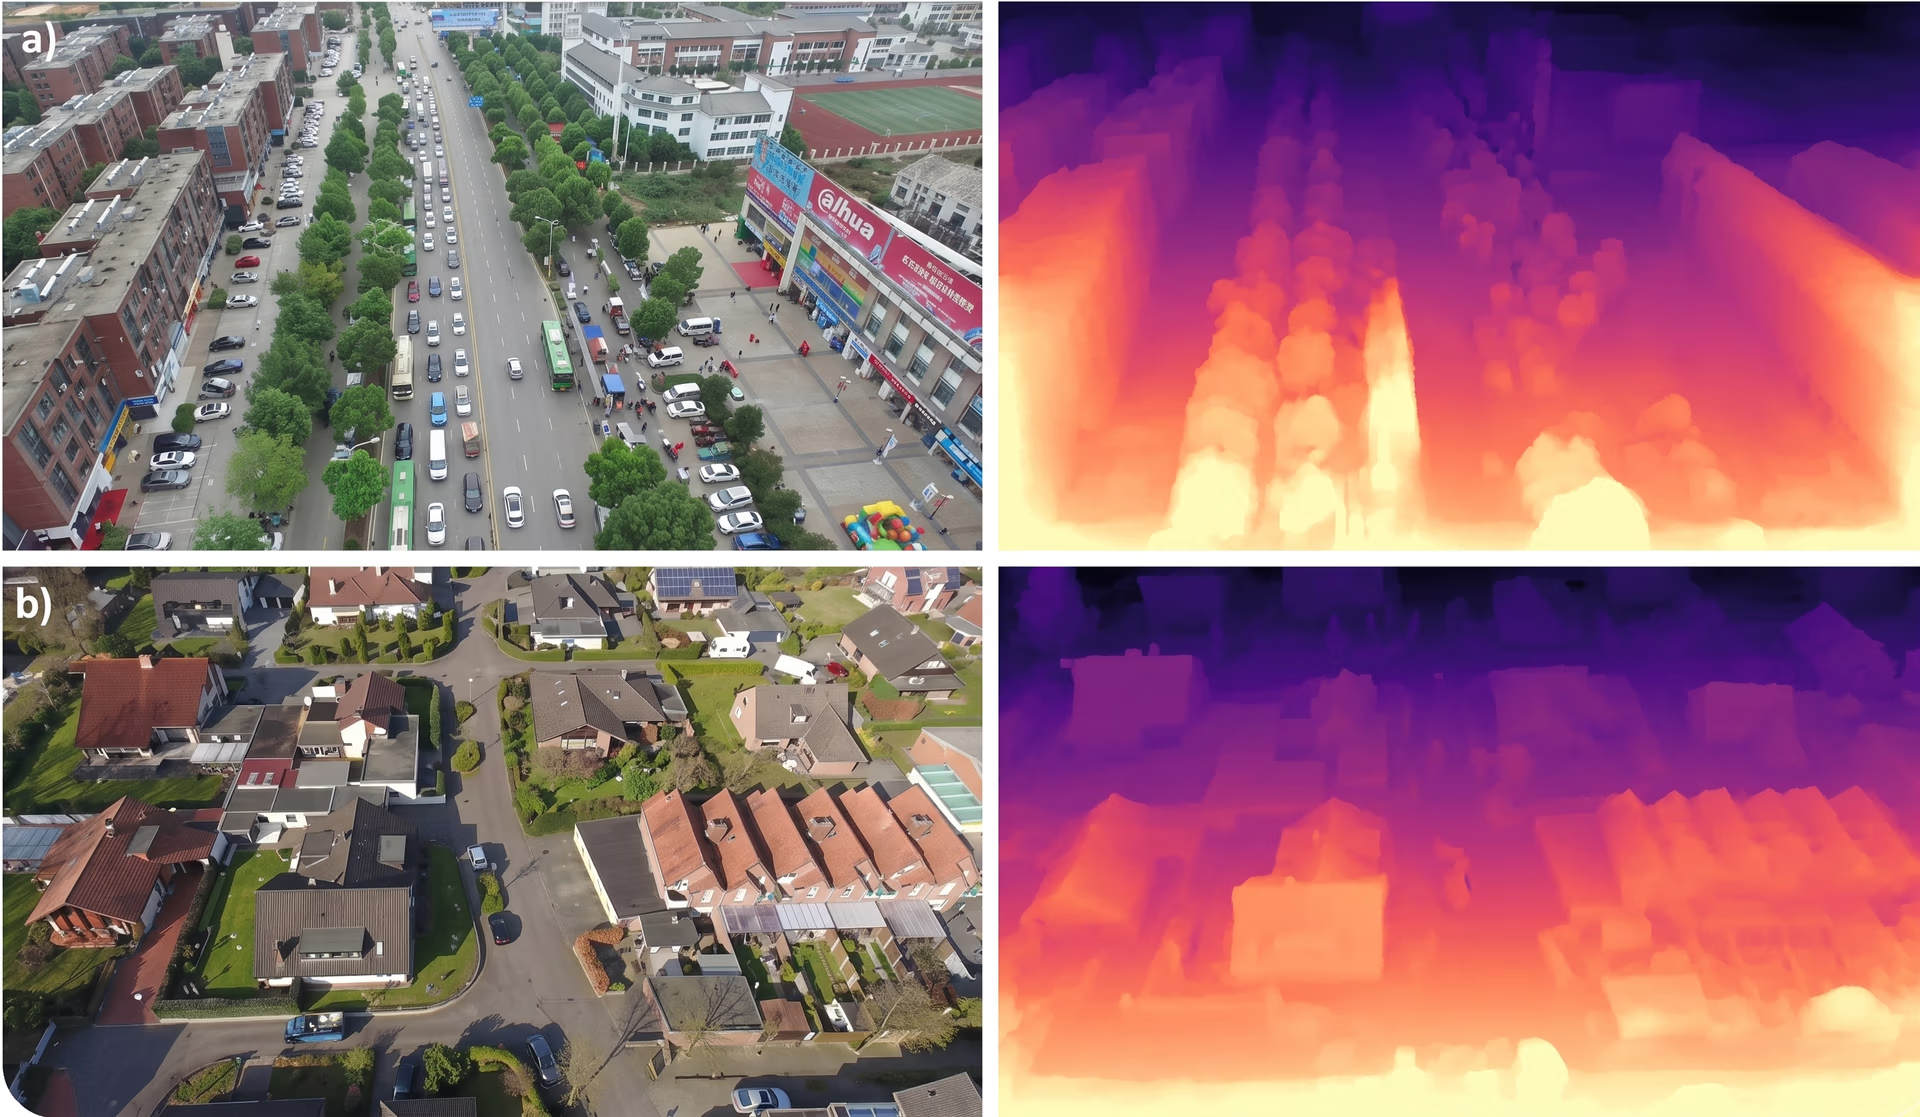
Fig. 2. A estimativa monocular de profundidade pode ser usada para analisar imagens captadas por drones (Fonte)
Preencher os pontos cegos dos veículos de competição autónomos.#
Os veículos autónomos dependem normalmente muito de sensores LiDAR, que usam impulsos laser para medir distâncias e construir uma visão 3D da estrada. Embora seja muito preciso, o LiDAR pode ter dificuldades com cristas acentuadas na estrada, declives íngremes, oclusões ou mudanças súbitas na inclinação do veículo, devolvendo por vezes dados de profundidade esparsos ou em falta.
A estimativa monocular de profundidade pode ajudar a preencher essas lacunas ao fornecer informações densas de profundidade a partir de uma única imagem RGB, mesmo quando os dados do LiDAR estão incompletos. Considere um cenário em que um carro autônomo se aproxima rapidamente do topo de uma colina. Os feixes do LiDAR podem ultrapassar a estrada além do topo, gerando incerteza sobre o que vem pela frente.
A estimativa de profundidade baseada em câmera, no entanto, ainda pode inferir o formato da estrada a partir de pistas visuais, como perspectiva e textura, ajudando o veículo a manter uma percepção confiável até que os dados do LiDAR se estabilizem. Juntos, o LiDAR e a estimativa monocular de profundidade permitem uma percepção mais estável e um controle mais seguro em condições de direção desafiadoras.
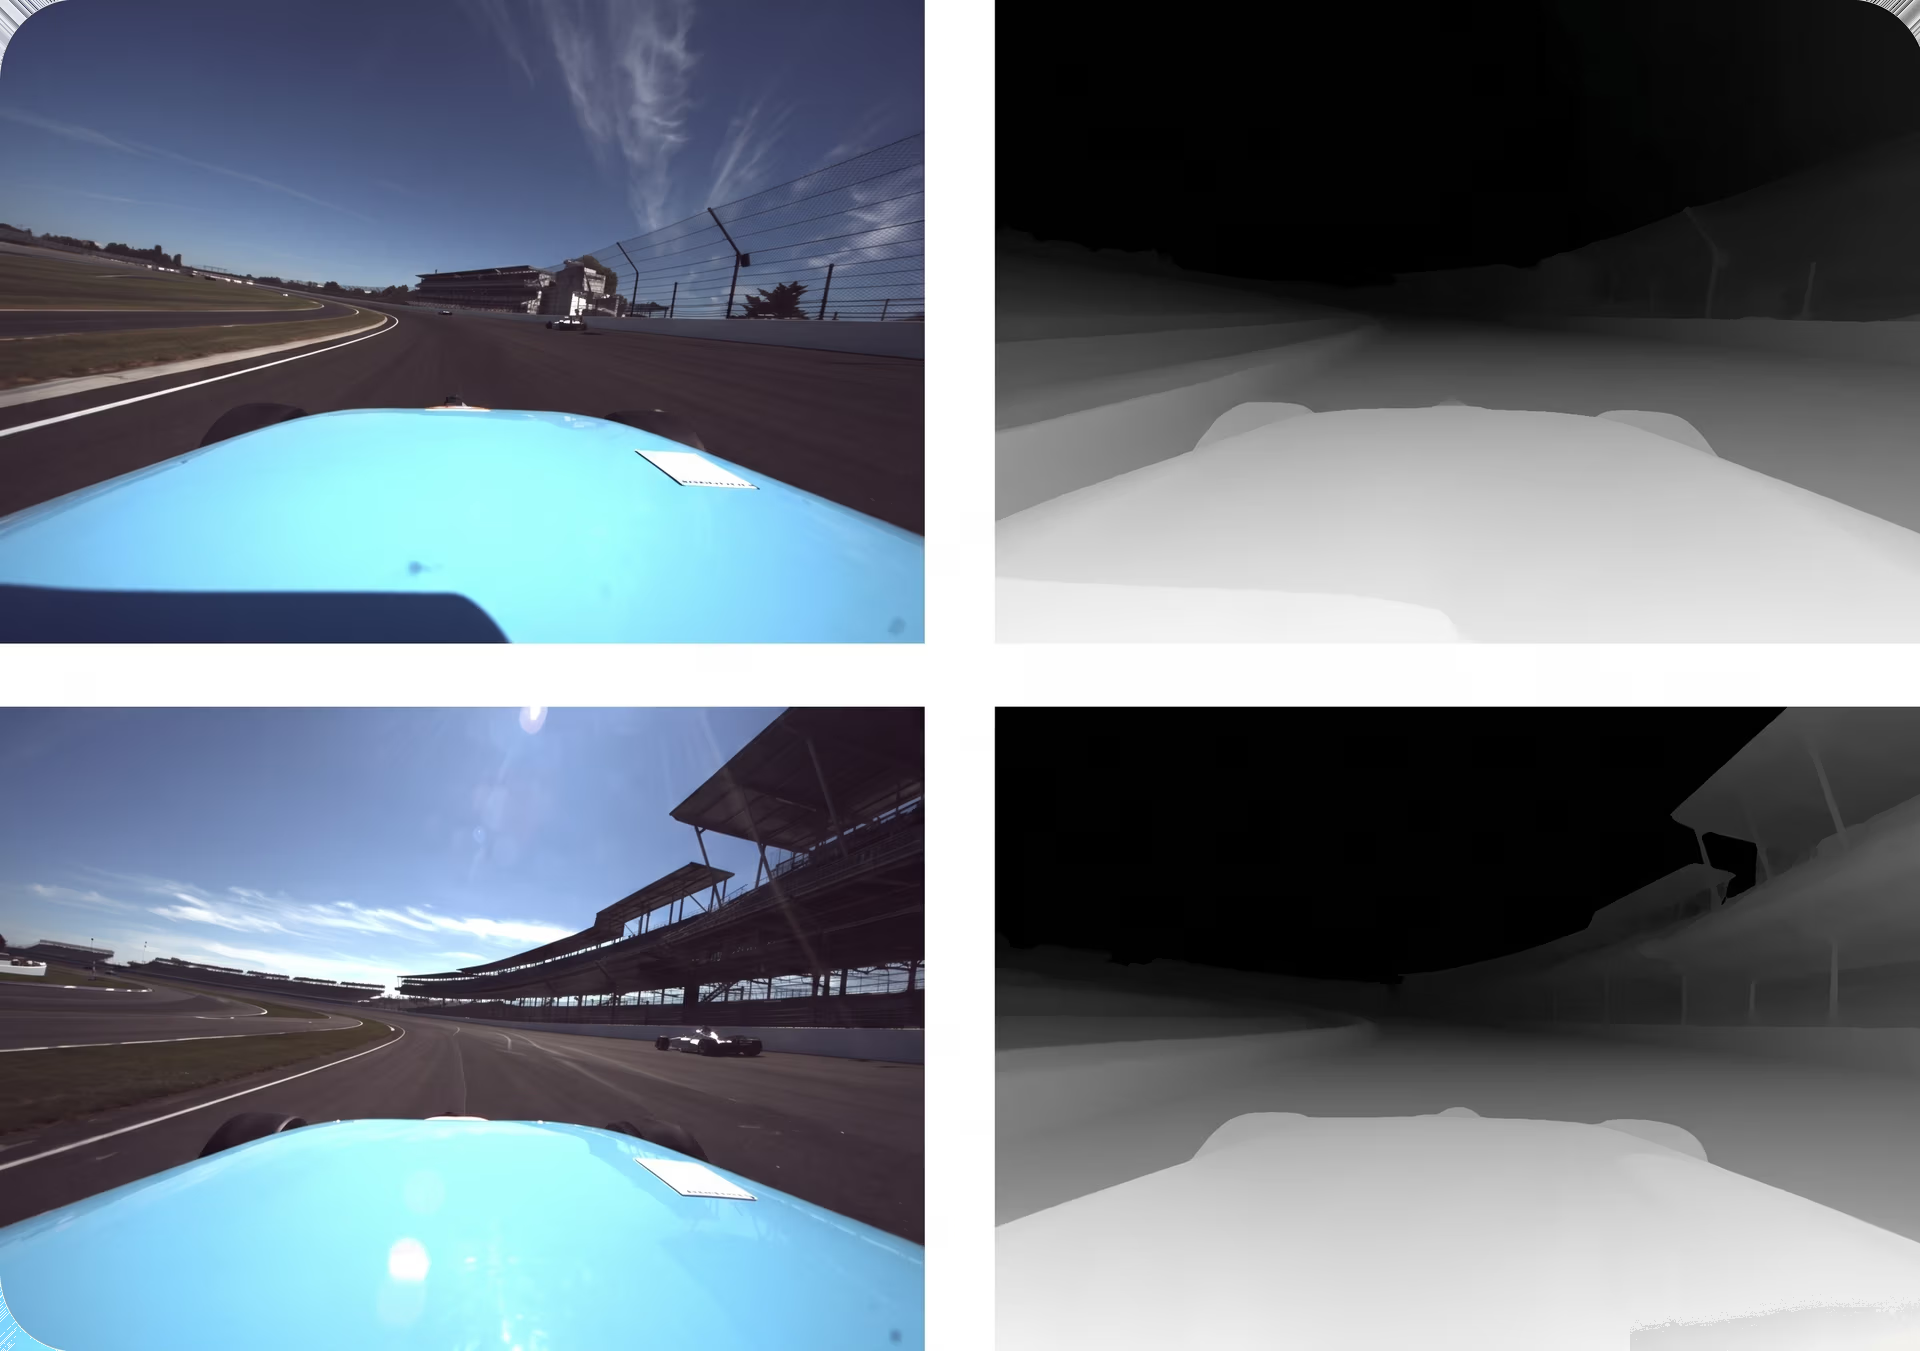
Fig. 3. Visualização do uso da estimativa monocular de profundidade em corridas autônomas (Fonte)
Navegação robótica e desvio de obstáculos#
Os robôs são frequentemente operados em locais onde não há mapas detalhados disponíveis e as condições mudam constantemente. Para se movimentarem com segurança, eles precisam ter uma noção confiável do espaço ao redor e da localização dos obstáculos.
A estimativa monocular de profundidade pode fornecer essa percepção espacial usando uma única câmera RGB, sem depender de hardware pesado ou caro. Ao aprender pistas visuais como escala e perspectiva, os modelos de estimativa de profundidade podem gerar mapas de profundidade densos do entorno. Isso oferece aos robôs uma visão clara da distância até superfícies e objetos.
Em particular, quando a informação de profundidade é combinada com tarefas de visão computacional, como a deteção de objetos e a segmentação semântica, os robôs conseguem obter uma visão mais completa do ambiente. Podem identificar objetos, compreender a que distância estão e decidir por onde é seguro deslocarem-se. Isto permite evitar obstáculos, detetar espaços livres e planear trajetos em tempo real.
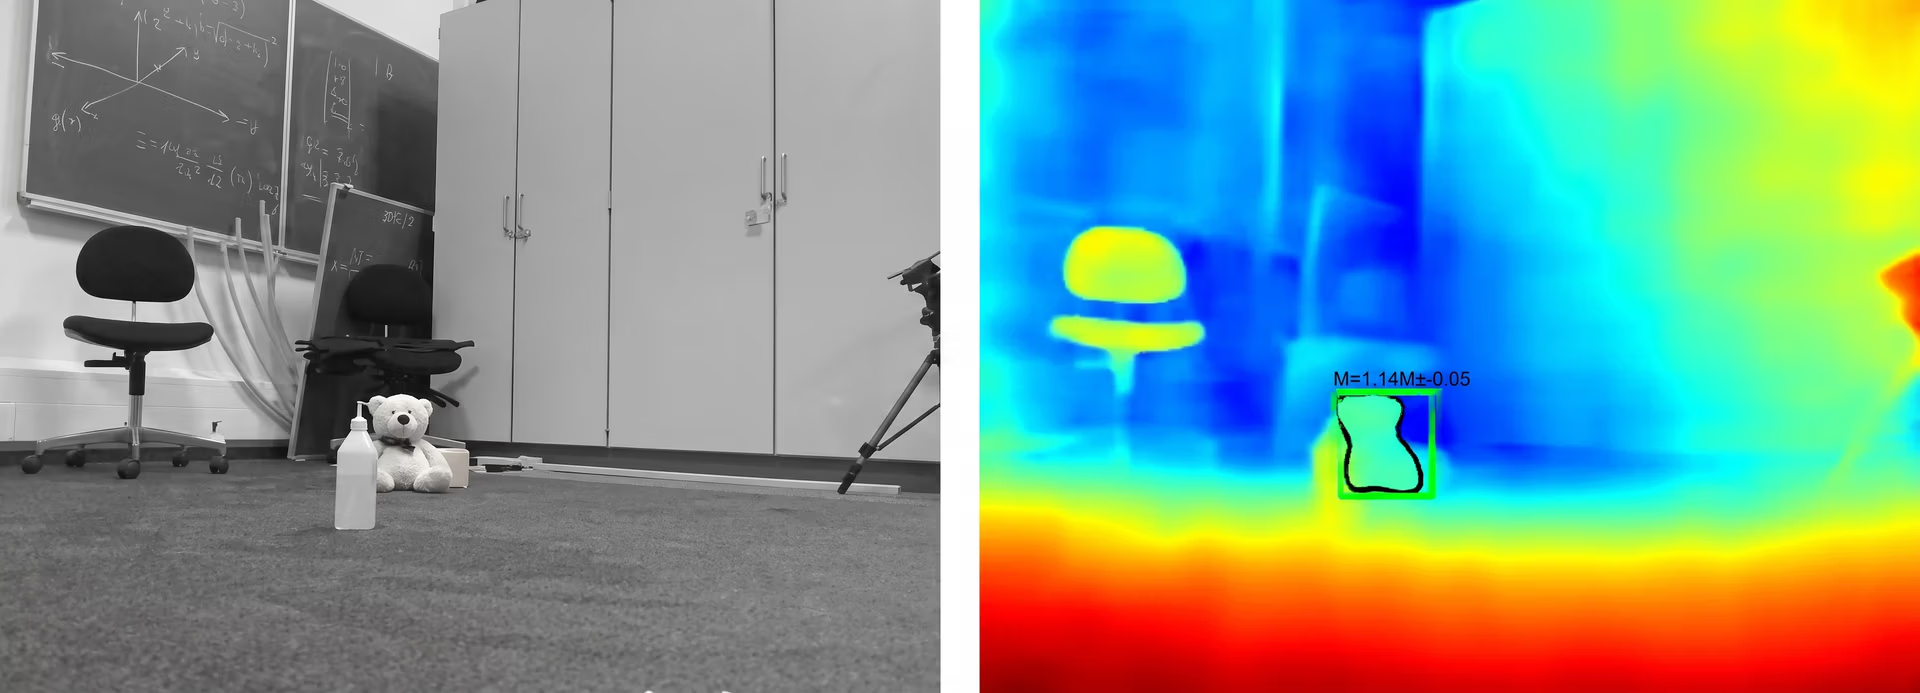
Fig. 4. Detecção de objetos usando estimativa monocular de profundidade e detecção de objetos (Fonte)
Vantagens e desvantagens da estimativa monocular de profundidade#
Estas são algumas das principais vantagens de usar a estimativa monocular de profundidade:
- Leve e eficiente em termos de energia: o uso de uma única câmera reduz o peso do sistema e o consumo de energia, o que é especialmente importante para robôs móveis, drones e sistemas embarcados.
- Compatível com fusão de sensores: a profundidade monocular pode complementar outros sensores, como LiDAR ou radar, preenchendo lacunas ou fornecendo redundância.
- Funciona em diversos ambientes: a mesma abordagem baseada em câmera pode ser usada em ambientes internos e externos e em diferentes plataformas, sem exigir alterações no hardware.
Embora a estimativa monocular de profundidade ofereça benefícios claros, estas são algumas limitações a considerar:
- Menor precisão do que sensores ativos: embora esteja evoluindo rapidamente, a estimativa monocular de profundidade geralmente não consegue igualar a precisão absoluta do LiDAR ou de sensores de luz estruturada em condições controladas.
- Sensibilidade às condições de iluminação: o desempenho pode diminuir em ambientes com pouca luz, sombras fortes, reflexos ou cenas com pouca textura.
- Desafios de generalização: um modelo treinado em um ambiente pode não se adaptar de forma confiável a domínios desconhecidos sem adaptação ou ajuste fino.
Quando não confiar na estimativa monocular de profundidade#
Embora a estimativa monocular de profundidade seja uma área de pesquisa interessante, é importante entender onde ela pode e onde não pode ser usada na prática. As distâncias que ela produz são estimativas baseadas no que o modelo vê em uma imagem, não medições exatas feitas no mundo real.
Por isso, a qualidade dos resultados pode variar conforme fatores como a iluminação, a complexidade da cena e o quanto ela se assemelha aos dados usados para treinar o modelo. A estimativa monocular de profundidade costuma ser boa para indicar o que está mais perto e o que está mais longe, mas não é confiável quando você precisa de distâncias exatas.
Em situações em que a precisão é realmente importante, como sistemas críticos para a segurança, inspeção industrial ou robôs que precisam interagir com objetos com muita precisão, a profundidade deve ser medida diretamente. Sensores como LiDAR, radar, câmeras estéreo ou sistemas de luz estruturada foram projetados para isso e fornecem informações de distância muito mais confiáveis.
A estimativa monocular de profundidade também pode ter dificuldades em condições visuais complexas. Pouca iluminação, sombras fortes, superfícies reflexivas ou transparentes, neblina, fumaça ou cenas com pouca textura visual podem tornar as estimativas de profundidade menos confiáveis. Estimar a profundidade a longas distâncias é outro caso em que sensores dedicados geralmente funcionam melhor.
Em soluções para o mundo real, a estimativa monocular de profundidade funciona melhor como ferramenta complementar do que como solução independente. Ela pode acrescentar contexto espacial útil, ajudar a preencher lacunas quando outros sensores são limitados e melhorar a compreensão geral da cena. No entanto, ela não deve ser a única fonte de informações de profundidade quando precisão, segurança ou requisitos rigorosos de confiabilidade são importantes.
Principais conclusões#
A estimativa monocular de profundidade é uma técnica de visão computacional que permite às máquinas estimar a distância dos objetos usando apenas uma imagem de uma única câmera. Ao aprender pistas visuais como perspectiva, tamanho dos objetos, textura e sombreamento, esses modelos de IA podem inferir a estrutura 3D de uma cena sem depender de sensores como LiDAR ou câmeras estéreo. Isso torna a estimativa monocular de profundidade uma abordagem econômica e escalável para aplicações como direção autônoma, robótica e compreensão de cenas 3D.
Para saber mais sobre IA visual, visite nosso repositório no GitHub e participe da nossa comunidade. Confira nossas páginas de soluções para saber mais sobre IA em robótica e visão computacional na manufatura. Conheça nossas opções de licenciamento para começar a trabalhar com visão computacional hoje mesmo!
Escrito por
Criador de conteúdo · Ultralytics
Comentários
Faça uma pergunta, compartilhe seus resultados ou ajude alguém.









