Aprendizado autossupervisionado para redução de ruído: explicação passo a passo
Vê como funciona o aprendizado autossupervisionado para redução de ruído, por que as imagens ficam ruidosas e quais são os principais métodos e etapas para recuperar detalhes visuais nítidos.
As câmeras nem sempre capturam o mundo da maneira como o vemos. Um retrato feito com pouca luz ou uma foto de um carro em alta velocidade pode parecer granulada, borrada ou distorcida.
Sensores lentos, ambientes escuros e movimento podem introduzir minúsculos pontos de ruído que suavizam as bordas e ocultam detalhes importantes. Quando essa nitidez se perde, até mesmo sistemas avançados de IA e aprendizado de máquina podem ter dificuldade para entender o conteúdo de uma imagem, porque muitos sistemas inteligentes dependem desses detalhes para funcionar bem.
Por exemplo, a visão computacional é um ramo da inteligência artificial que permite que máquinas interpretem imagens e vídeos. Mas, para fazer isso com precisão, os modelos de IA de visão precisam aprender com dados visuais nítidos e de alta qualidade.
Em particular, modelos como o Ultralytics YOLO11 e o futuro Ultralytics YOLO26 oferecem suporte a tarefas como deteção de objetos, segmentação de instâncias e estimativa de pose, e podem ser treinados de forma personalizada para diferentes casos de uso. Essas tarefas dependem de pistas visuais nítidas, como bordas, texturas, cores e detalhes estruturais minuciosos.
Quando o ruído obscurece essas características, o modelo recebe sinais de treinamento mais fracos, o que dificulta o aprendizado de padrões precisos. Como resultado, até mesmo pequenas quantidades de ruído podem reduzir o desempenho em aplicações reais.
Anteriormente, analisamos como o aprendizado autossupervisionado remove ruído de imagens. Neste artigo, vamos explorar mais a fundo como funcionam as técnicas de remoção autossupervisionada de ruído e como ajudam a recuperar informações visuais relevantes. Vamos começar!
Tipos comuns de ruído em imagens do mundo real#
Antes de explorar como o aprendizado autossupervisionado é usado para remover ruído de imagens, vamos relembrar primeiro por que as imagens ficam ruidosas.
Imagens de objetos e cenas do mundo real raramente são perfeitas. Pouca iluminação, qualidade limitada dos sensores e movimentos rápidos podem introduzir perturbações aleatórias em pixels individuais por toda a imagem. Essas perturbações em nível de pixel, conhecidas como ruído, reduzem a nitidez geral e dificultam a visualização de detalhes importantes.
Quando o ruído oculta bordas, texturas e padrões sutis, os sistemas de visão computacional têm dificuldade para reconhecer objetos ou interpretar cenas com precisão. Diferentes condições produzem diferentes tipos de ruído, cada um afetando a imagem à sua maneira.
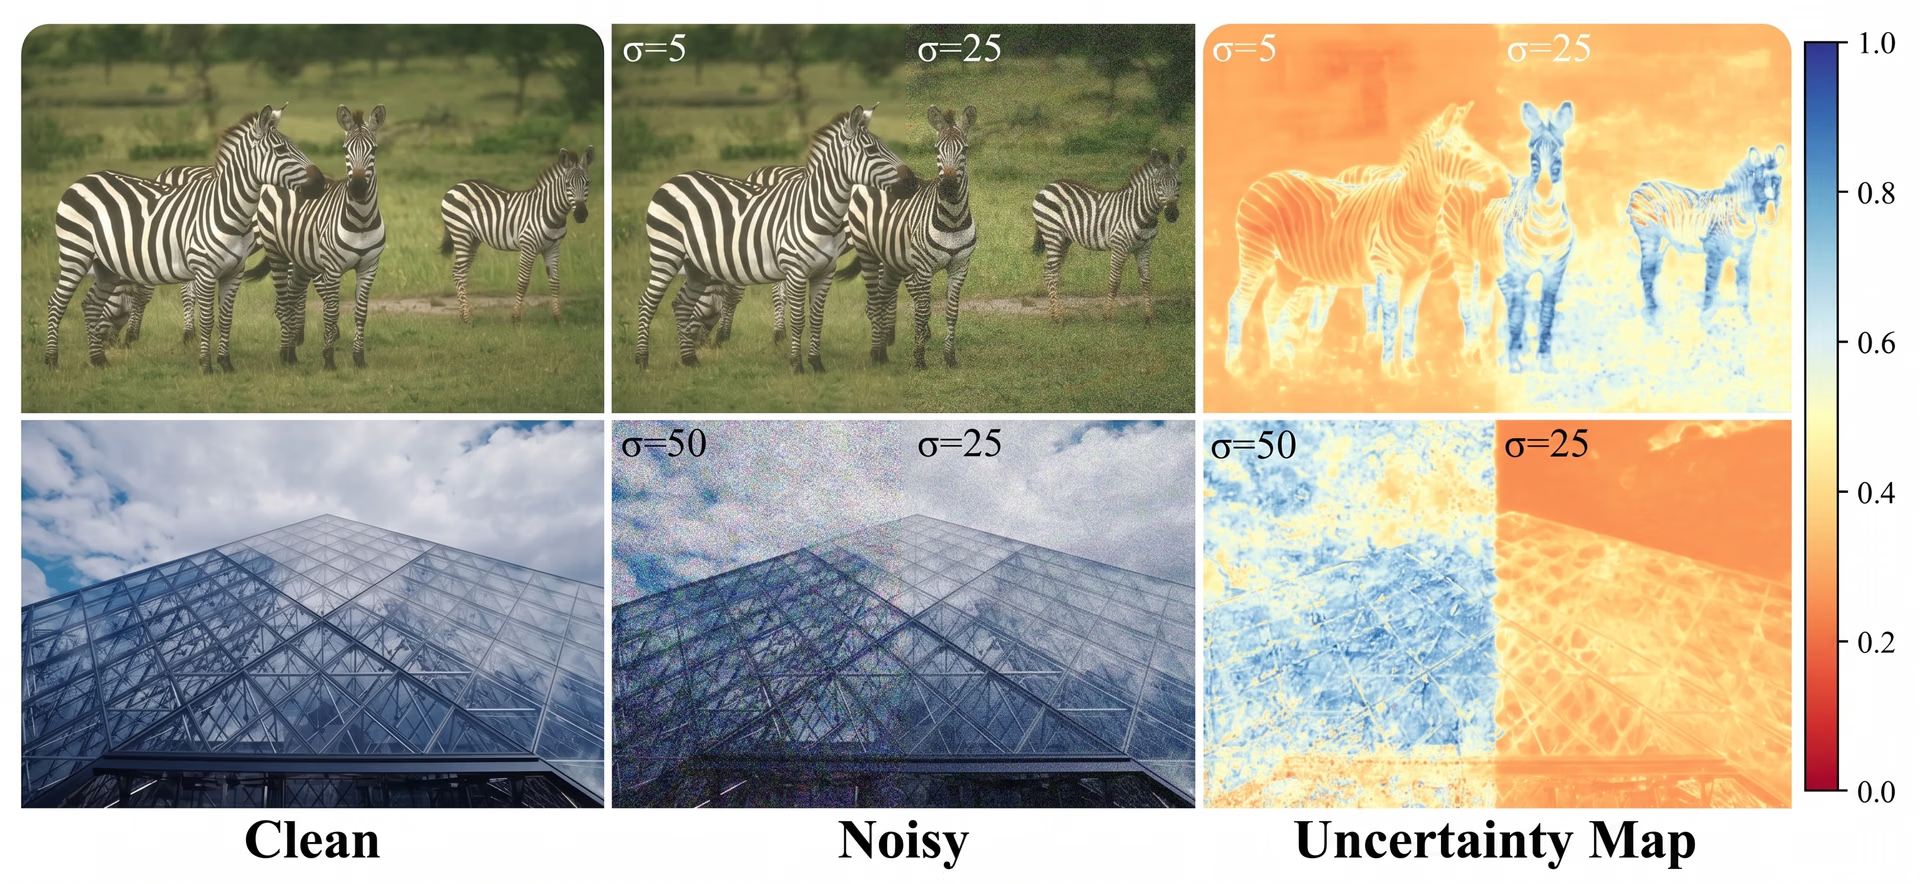
Fig. 1. Exemplo de como o ruído pode aumentar a incerteza em uma imagem. (Fonte)
Veja alguns dos tipos de ruído mais comuns encontrados em imagens:
- Ruído gaussiano: Esse tipo de ruído aparece como granulação suave e aleatória, causada por interferência eletrônica do sensor ou flutuações térmicas. Ele segue uma distribuição gaussiana (normal), na qual pequenas variações de pixel borram detalhes finos e reduzem a nitidez geral.
- Ruído de Poisson: Também chamado de ruído de disparo, esse tipo de ruído ocorre em condições de pouca luz ou com tempos de exposição curtos. Sua variância aumenta com o brilho, mas o ruído costuma ser mais perceptível nas regiões escuras porque são capturados menos fótons, resultando em uma relação sinal-ruído menor.
- Ruído sal e pimenta: Esse tipo de ruído aparece como picos nítidos de pixels pretos ou brancos. Normalmente, é causado por erros de transmissão, corrupção de bits ou sensores de câmera defeituosos e costuma resultar em valores de pixel ausentes ou corrompidos.
- Ruído speckle: Esse tipo de ruído aparece como padrões granulados e pontilhados, sendo comum em imagens médicas, de radar e de ultrassom. É causado por interferência e dispersão do sinal, que reduzem o contraste e dificultam a deteção de bordas.
Quando usar a remoção autossupervisionada de ruído?#
Então, o que torna especial a remoção autossupervisionada de ruído? Ela se destaca em situações nas quais imagens limpas de referência simplesmente não existem ou são difíceis demais de capturar.
Isso costuma acontecer em fotografias com pouca luz, imagens com ISO alto, imagens médicas e científicas ou em qualquer ambiente onde o ruído seja inevitável e seja inviável coletar dados de referência perfeitos. Em vez de precisar de exemplos limpos, o modelo aprende diretamente com as imagens ruidosas que você já tem, adaptando-se aos padrões de ruído específicos da sua câmera ou sensor.
A remoção autossupervisionada de ruído também é uma ótima opção quando você quer melhorar o desempenho de tarefas de visão computacional subsequentes, mas seu conjunto de dados está cheio de imagens inconsistentes ou ruidosas. Ao recuperar bordas, texturas e estruturas mais nítidas, esses métodos ajudam modelos como o YOLO a detetar, segmentar e entender cenas com mais confiabilidade. Em resumo, se você trabalha com dados ruidosos e não tem imagens de treinamento limpas, a remoção autossupervisionada de ruído costuma ser a solução mais prática e eficaz.
As principais técnicas por trás da remoção autossupervisionada de ruído#
Como vimos anteriormente, a remoção autossupervisionada de ruído é uma abordagem de IA baseada em aprendizado profundo que permite que os modelos aprendam diretamente com imagens ruidosas sem depender de rótulos limpos. Ela se baseia nos princípios do aprendizado autossupervisionado, no qual os modelos geram seus próprios sinais de treinamento a partir dos dados.
Em outras palavras, um modelo pode ensinar a si mesmo usando imagens ruidosas tanto como entrada quanto como fonte do sinal de aprendizado. Ao comparar diferentes versões corrompidas da mesma imagem ou prever pixels mascarados, o modelo aprende quais padrões representam estruturas reais e quais são apenas ruído. Por meio da otimização iterativa e do reconhecimento de padrões, a rede melhora gradualmente sua capacidade de distinguir conteúdo relevante da imagem de variações aleatórias.
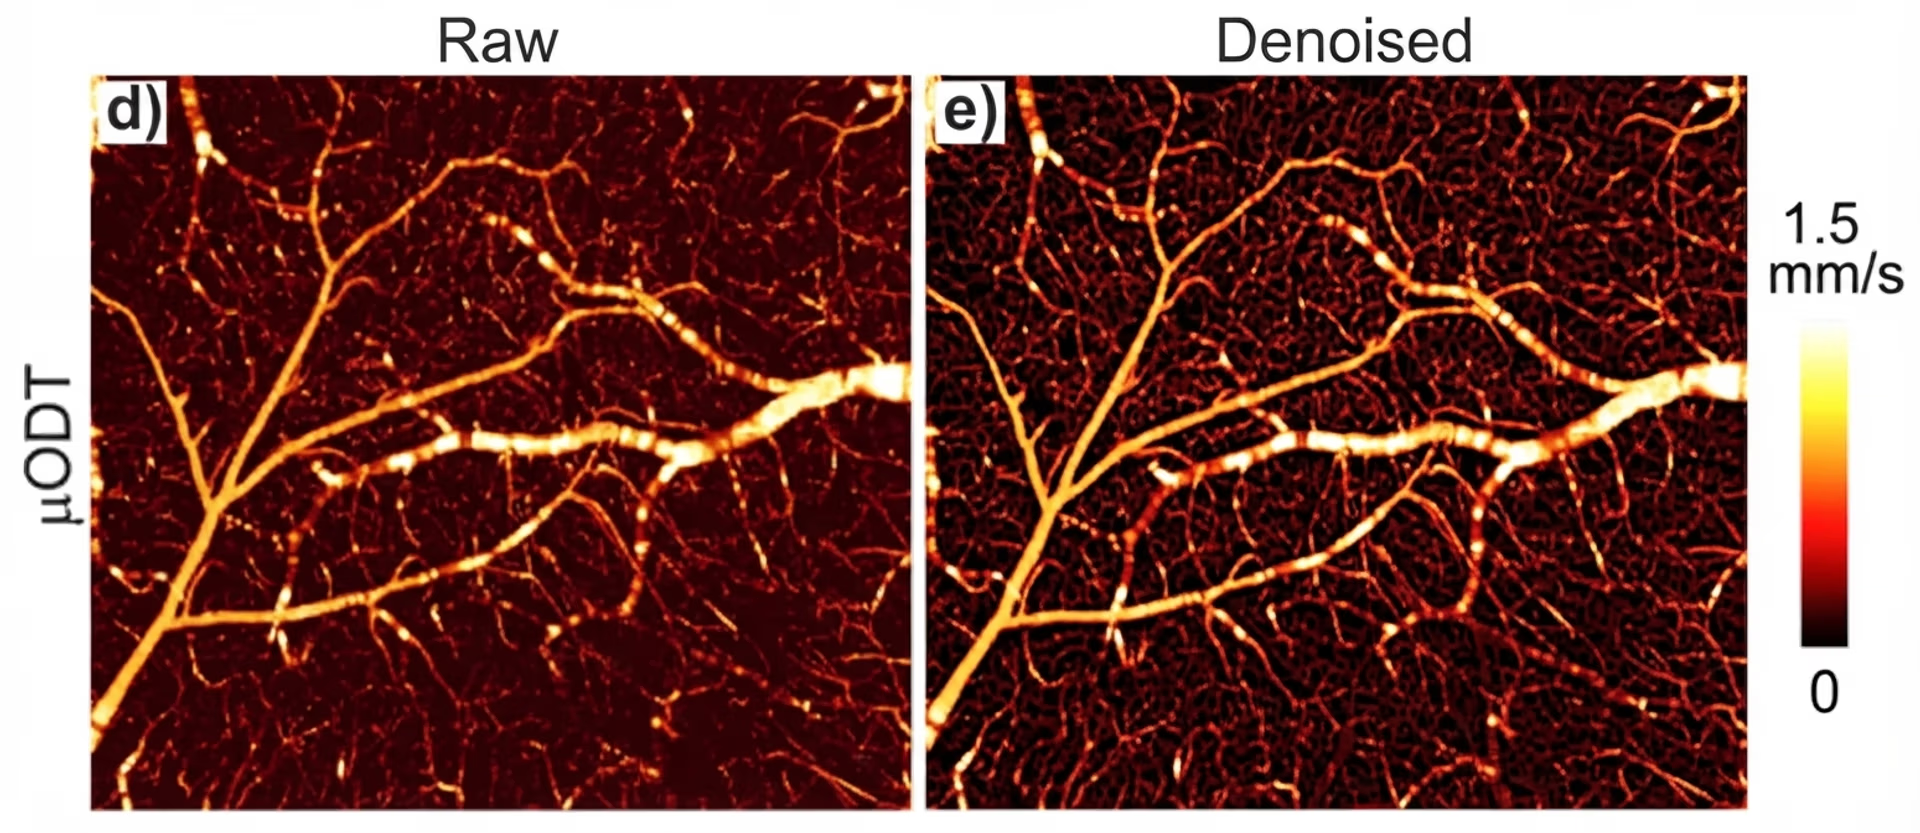
Fig. 2. Uma imagem original e uma imagem sem ruído. (Fonte)
Isso é possível graças a estratégias de aprendizado específicas que orientam o modelo a separar a estrutura estável da imagem do ruído aleatório. A seguir, vamos analisar mais de perto as principais técnicas e algoritmos que simplificam esse processo e como cada abordagem ajuda os modelos a reconstruir imagens mais nítidas e confiáveis.
Métodos de remoção de ruído com pares de imagens#
Muitos dos primeiros métodos de aprendizado autossupervisionado para remoção de ruído funcionavam comparando duas versões ruidosas da mesma imagem. Como o ruído muda aleatoriamente cada vez que uma imagem é capturada ou corrompida, mas a estrutura real permanece igual, essas diferenças podem ser usadas como sinal de aprendizado para um modelo.
Essas abordagens são comumente chamadas de métodos de remoção de ruído com pares de imagens, pois dependem do uso ou da geração de pares de imagens ruidosas durante o treinamento. Por exemplo, a abordagem Noise2Noise (proposta por Jaakko Lehtinen e sua equipe) treina um modelo com duas imagens, afetadas por ruído independente, da mesma cena. Como os padrões de ruído diferem entre as duas versões, o modelo aprende a identificar os detalhes consistentes que representam a imagem subjacente real.
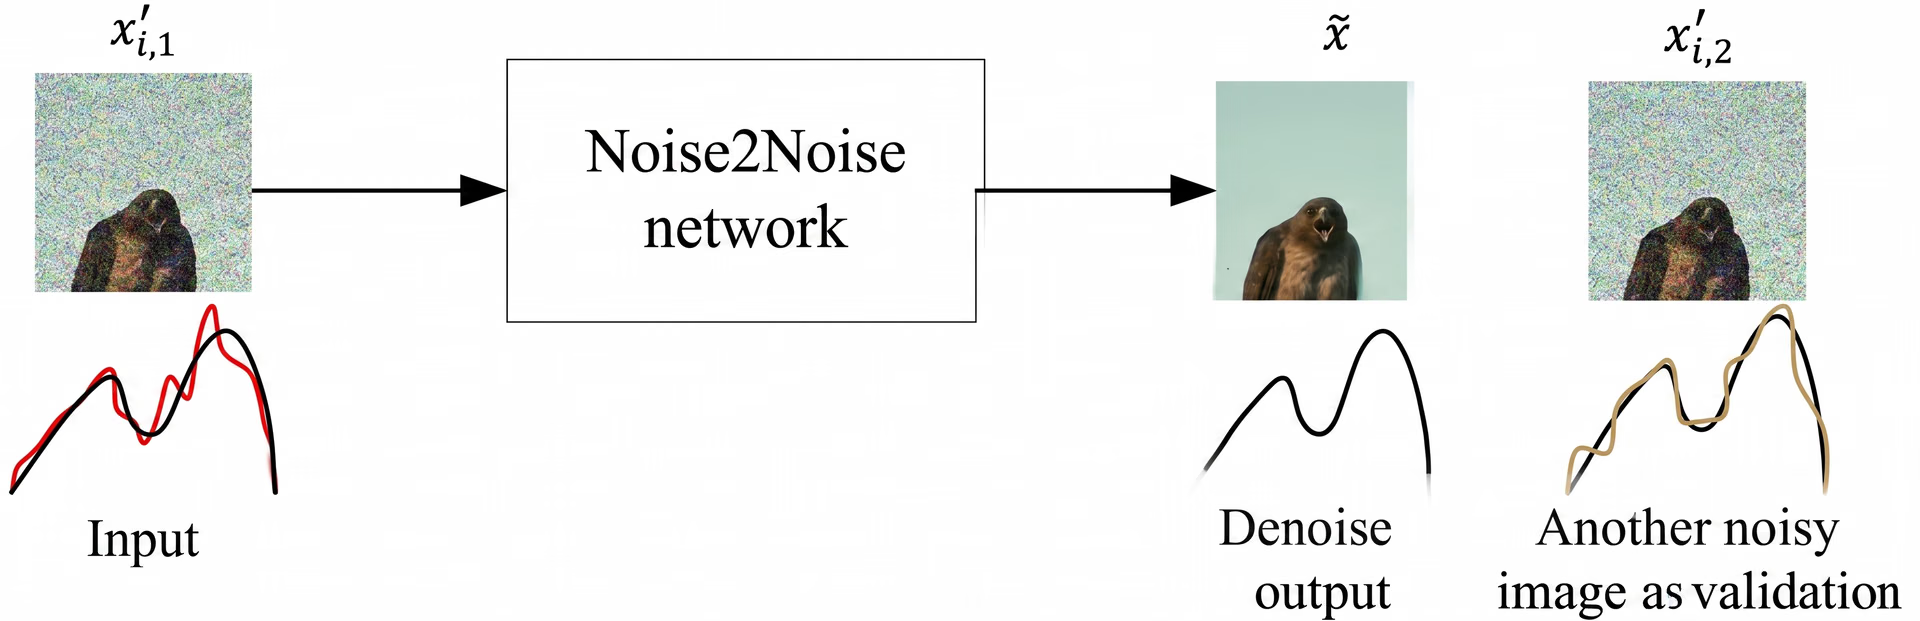
Fig. 3. Como funciona o Noise2Noise (Fonte)
Com o tempo, isso ensina a rede a suprimir o ruído aleatório e preservar a estrutura real, mesmo sem nunca ver uma imagem de referência limpa. Imagine uma situação simples em que você tira duas fotos de uma rua com pouca iluminação à noite.
Cada imagem contém os mesmos prédios, luzes e sombras, mas o ruído granulado aparece em lugares diferentes. Ao comparar essas duas fotos ruidosas durante o treinamento, um modelo autossupervisionado pode aprender quais padrões visuais são estáveis e quais são causados pelo ruído, melhorando sua capacidade de reconstruir imagens mais nítidas.
Métodos de aprendizado autossupervisionado para remoção de ruído com pontos cegos#
Enquanto os métodos com pares dependem da comparação de duas versões da mesma imagem corrompidas de maneiras diferentes, os métodos de pontos cegos adotam outra abordagem. Eles permitem que o modelo aprenda com uma única imagem ruidosa, ocultando pixels selecionados para que a rede não veja seus valores corrompidos.
Em seguida, o modelo precisa prever os pixels ocultos usando apenas o contexto ao redor. A ideia central é que o ruído é aleatório, mas a estrutura subjacente de uma imagem não é.
Ao impedir que o modelo copie o valor ruidoso de um pixel, os métodos de pontos cegos o incentivam a inferir qual deveria ser esse valor com base em padrões estáveis da imagem, como bordas, texturas ou gradientes de cor próximos. Técnicas como Noise2Void (apresentada por Alexander Krull e sua equipe) e Noise2Self (desenvolvida por Joshua Batson e Loïc Royer) implementam esse princípio mascarando pixels individuais ou pequenas regiões e treinando o modelo para reconstruí-los.
Abordagens mais avançadas, incluindo Noise2Same e PN2V, aumentam a robustez ao impor previsões consistentes em várias versões mascaradas ou ao modelar explicitamente a distribuição do ruído para estimar a incerteza. Como esses métodos precisam de apenas uma imagem ruidosa, são especialmente úteis em áreas nas quais é impraticável ou impossível capturar imagens limpas ou pareadas, como microscopia, astronomia, imagens biomédicas ou fotografia com pouca luz.
Métodos de remoção de ruído com suporte de Transformer#
A maioria dos métodos de remoção autossupervisionada de ruído com pares ou pontos cegos depende de redes neurais convolucionais (CNNs) ou de redes de remoção de ruído. As CNNs são uma ótima opção para essas abordagens porque se concentram em padrões locais, como bordas, texturas e pequenos detalhes.
Arquiteturas como a U-Net são amplamente usadas porque combinam características detalhadas com informações em várias escalas. No entanto, as CNNs operam principalmente em regiões limitadas, o que significa que podem deixar passar relações importantes que se estendem por áreas maiores da imagem.
Métodos de remoção de ruído de última geração com suporte de Transformer foram introduzidos para superar essa limitação. Em vez de observar apenas os pixels próximos, o método proposto usa mecanismos de atenção para entender como diferentes partes de uma imagem se relacionam.
Alguns modelos usam atenção global completa, enquanto outros usam atenção baseada em janelas ou hierárquica para reduzir a computação. Em geral, porém, foram projetados para capturar estruturas de longo alcance que as CNNs, por si só, não conseguem capturar. Essa visão mais abrangente ajuda o modelo a restaurar texturas repetidas, superfícies lisas ou objetos grandes que exigem informações de toda a imagem.
Outros métodos de remoção de ruído de imagens#
Além das técnicas autossupervisionadas, há também várias outras maneiras de limpar imagens ruidosas. Métodos tradicionais, como filtragem bilateral, remoção de ruído por wavelets e médias não locais, usam regras matemáticas simples para suavizar o ruído e, ao mesmo tempo, tentar preservar detalhes importantes.
Também existem abordagens de aprendizado profundo, incluindo modelos supervisionados que aprendem com pares de imagens limpas e ruidosas e redes adversariais generativas (GANs), que geram resultados mais nítidos e realistas. No entanto, esses métodos geralmente precisam de imagens de melhor qualidade para o treinamento.
Uma análise passo a passo de como funciona a remoção autossupervisionada de ruído em imagens#
Como acabamos de apresentar várias técnicas diferentes, você pode estar se perguntando se cada uma funciona de uma maneira completamente distinta, já que usam arquiteturas próprias. No entanto, todas seguem um fluxo de trabalho semelhante, que começa com a preparação dos dados e termina com a avaliação do modelo.
A seguir, vamos analisar mais de perto, passo a passo, como funciona o processo geral de remoção autossupervisionada de ruído em imagens.
Etapa 1: Pré-processamento e normalização#
Antes que o modelo possa começar a aprender com imagens ruidosas, o primeiro passo é garantir que todas as imagens tenham uma aparência consistente. Fotos reais podem variar bastante.
Algumas imagens podem estar claras demais, outras escuras demais, e algumas podem ter cores ligeiramente incorretas. Se fornecermos essas variações diretamente a um modelo, será mais difícil para ele se concentrar em aprender como é o ruído.
Para lidar com isso, cada imagem passa por normalização e pré-processamento básico. Isso pode incluir o redimensionamento dos valores dos pixels para uma faixa padrão, a correção de variações de intensidade ou o recorte e redimensionamento das imagens. O essencial é que o modelo receba dados limpos que possam ser usados como entradas estáveis e comparáveis.
Etapa 2: Criação de um sinal de treinamento autossupervisionado#
Depois que as imagens são normalizadas, a próxima etapa é criar um sinal de treinamento que permita ao modelo aprender sem nunca ver uma imagem limpa. Os métodos autossupervisionados de remoção de ruído fazem isso garantindo que o modelo não possa simplesmente copiar os valores dos pixels ruidosos que recebe.
Em vez disso, criam situações nas quais o modelo precisa se basear no contexto ao redor da imagem, que contém uma estrutura estável, e não no ruído imprevisível. Diferentes métodos fazem isso de maneiras ligeiramente distintas, mas a ideia central é a mesma.
Algumas abordagens ocultam ou mascaram temporariamente determinados pixels para que o modelo precise inferi-los a partir dos pixels vizinhos, enquanto outras geram uma versão corrompida separadamente da mesma imagem ruidosa, de modo que a entrada e o alvo contenham ruído independente. Nos dois casos, a imagem-alvo contém informações estruturais relevantes, mas impede que a rede acesse o valor ruidoso original do pixel que deveria prever.
Como o ruído muda aleatoriamente enquanto a imagem subjacente permanece consistente, essa configuração incentiva naturalmente o modelo a aprender a aparência da estrutura real e ignorar o ruído que varia de uma versão para outra.
Etapa 3: Aprendizado da remoção de ruído para recuperar a estrutura da imagem#
Com o sinal de treinamento estabelecido, o modelo pode começar a aprender a separar a estrutura relevante da imagem do ruído durante o treinamento. Cada vez que prevê um pixel mascarado ou novamente corrompido, precisa se basear no contexto ao redor, em vez do valor ruidoso que originalmente ocupava aquele ponto.
Ao longo de muitas iterações ou épocas, isso ensina a rede a reconhecer os tipos de padrões que permanecem estáveis em uma imagem, como bordas, texturas e superfícies lisas. Ela também aprende a ignorar as flutuações aleatórias que caracterizam o ruído.
Por exemplo, imagine uma foto com pouca luz em que uma superfície parece extremamente granulada. Embora o ruído varie de pixel para pixel, a superfície subjacente continua lisa. Ao inferir repetidamente os pixels ocultos nessas regiões, o modelo melhora gradualmente sua capacidade de identificar o padrão estável sob o ruído e reconstruí-lo com mais nitidez.
Durante o processo de treinamento, a rede aprende uma representação interna da estrutura da imagem. Isso permite que o modelo recupere detalhes coerentes mesmo quando a entrada está muito corrompida.
Etapa 4: Validação e resultados da redução de ruído#
Depois que o modelo aprende a prever pixels ocultos ou novamente corrompidos, a etapa final é avaliar seu desempenho em imagens completas. Durante os testes, o modelo recebe uma imagem ruidosa inteira e produz uma versão completa sem ruído com base no que aprendeu sobre a estrutura das imagens. Para medir a eficácia desse processo, a saída é comparada com imagens de referência limpas ou conjuntos de dados de benchmark padrão.
Duas métricas comumente usadas são PSNR (relação sinal-ruído de pico), que mede o quanto a reconstrução se aproxima da referência limpa, e SSIM (índice de similaridade estrutural), que avalia a preservação de características importantes, como bordas e texturas. Em geral, pontuações mais altas indicam uma remoção de ruído mais precisa e visualmente confiável.
Conjuntos de dados de imagens usados para treinamento e benchmarking#
A pesquisa sobre remoção autossupervisionada de ruído, publicada, entre outros locais, em periódicos da IEEE e em conferências da CVF, como CVPR, ICCV e ECCV, além de amplamente divulgada no arXiv, costuma usar uma combinação de conjuntos de dados sintéticos e do mundo real para avaliar o desempenho de modelos de métodos de aprendizado profundo em condições controladas e práticas. Por um lado, os conjuntos de dados sintéticos começam com imagens limpas e adicionam ruído artificial, facilitando a comparação de métodos com métricas como PSNR e SSIM.
Aqui estão alguns conjuntos de dados populares com ruído sintético adicionado, comumente usados para benchmarking:
- Kodak24: Este conjunto de dados fornece fotografias de cenas naturais de alta qualidade, comumente usadas para comparar visualmente os resultados da remoção de ruído.
- DIV2K: Este conjunto de dados de alta resolução contém imagens variadas e detalhadas, usadas para avaliar a fidelidade das texturas e a qualidade geral da restauração.
Por outro lado, conjuntos de dados com ruído do mundo real contêm imagens capturadas diretamente por sensores de câmera em condições de pouca luz, ISO alto ou outras situações desafiadoras. Esses conjuntos de dados testam se um modelo consegue lidar com ruídos complexos e não gaussianos que não podem ser simulados facilmente.
Aqui estão alguns conjuntos de dados populares com ruído do mundo real:
- SIDD: Este conjunto de dados fornece pares de imagens com ruído e sem ruído capturadas por sensores de smartphones em diversos ambientes de iluminação.
- DND: Inclui fotografias com ISO alto que capturam padrões realistas de ruído dos sensores encontrados em câmeras para consumidores.
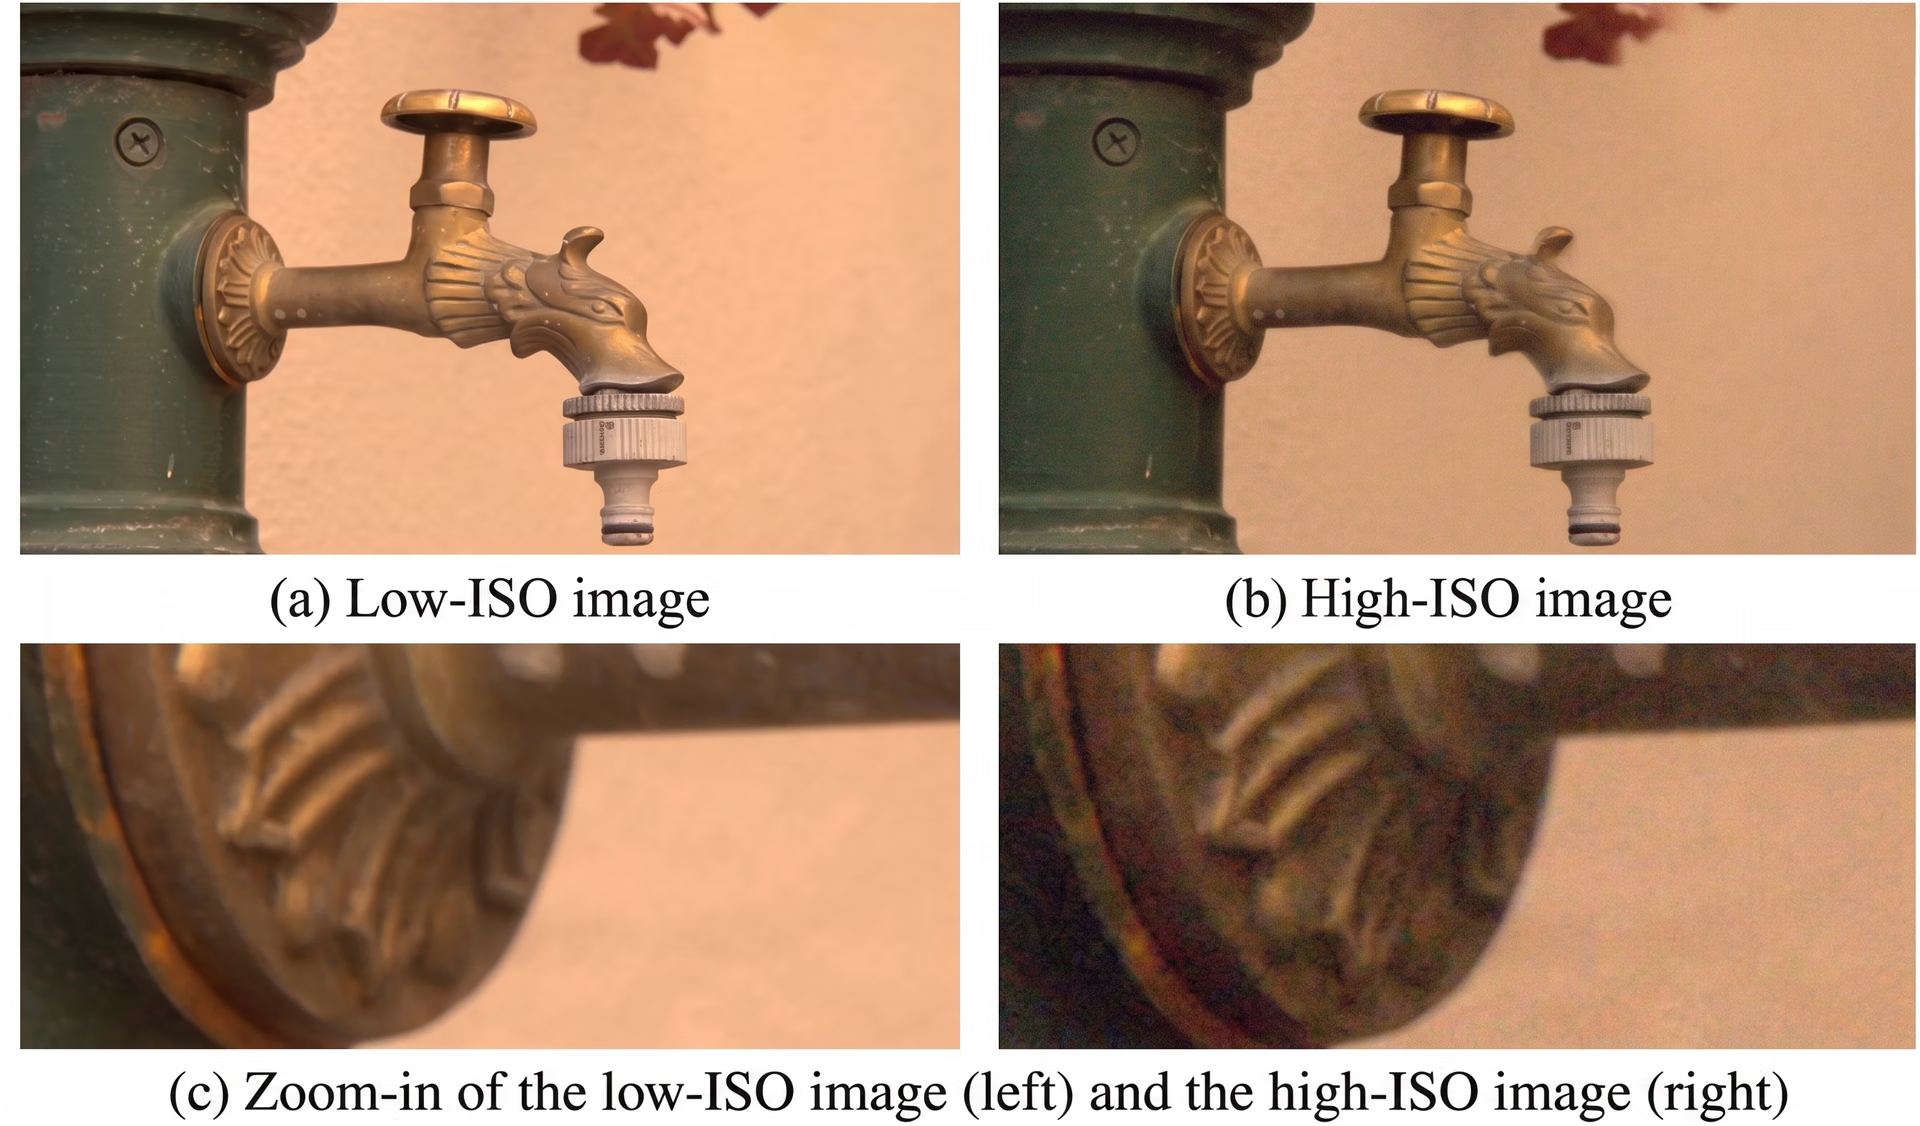
Fig. 4. Um exemplo do conjunto de dados DND. (Fonte)
Fatores a considerar ao treinar um modelo de remoção de ruído autossupervisionado#
Aqui estão alguns fatores e limitações a considerar se você pretende treinar um modelo de remoção de ruído autossupervisionado baseado em deep learning:
- Compatibilidade com a distribuição do ruído: As imagens com ruído usadas no treinamento devem refletir o mesmo ruído que o modelo encontrará no uso real; ruídos incompatíveis levam a uma generalização insatisfatória.
- Garanta a diversidade dos dados de treinamento: A variação limitada pode causar sobreajuste ou suavização excessiva em texturas complexas.
- Tenha em conta as limitações dos tipos de ruído: Os métodos autossupervisionados têm mais dificuldade com ruídos estruturados, correlacionados ou não aleatórios.
- Teste em diferentes dispositivos ou sensores: O desempenho da remoção de ruído pode variar bastante entre câmeras ou sistemas de imagem.
Principais conclusões#
A remoção de ruído autossupervisionada oferece aos entusiastas de IA uma forma prática de limpar imagens usando apenas os dados com ruído que já temos. Ao aprender a reconhecer a estrutura real por trás do ruído, esses métodos conseguem recuperar detalhes visuais importantes. À medida que a tecnologia de remoção de ruído continua avançando, é provável que ela torne mais confiáveis diversas tarefas de visão computacional no dia a dia.
Faça parte da nossa crescente comunidade! Acesse nosso repositório do GitHub para saber mais sobre IA. Se você quer criar soluções de visão computacional, confira nossas opções de licenciamento. Explore os benefícios da visão computacional no varejo e veja como a IA na manufatura está fazendo a diferença!








