Доля правильных ответов, точность и полнота в машинном обучении: в чём разница
Узнай о таких метриках машинного обучения, как доля правильных ответов, точность и полнота. Разберись с матрицей ошибок, F1-мерой и применением этих важных метрик оценки.
Машинное обучение (ML) — это область искусственного интеллекта (AI), посвященная созданию систем, которые учатся на данных. Оно играет центральную роль во многих других областях ИИ, включая компьютерное зрение, где машины интерпретируют изображения, и обработку естественного языка, где они понимают и генерируют человеческую речь.
Такие модели ИИ часто используют методы глубокого обучения, чтобы делать прогнозы на основе данных. Хотя подобные системы могут быть очень эффективными, они не всегда выдают правильные прогнозы. Одни результаты могут быть точными, а другие — ошибочными.
Понимание того, как возникают такие ошибки, — важная часть оценки производительности модели. Для измерения производительности можно использовать метрики оценки модели.
К распространенным метрикам оценки относятся точность (общая доля правильных ответов), прецизионность (надежность положительных прогнозов) и полнота (насколько хорошо модель выявляет фактически положительные случаи). На первый взгляд они могут показаться похожими, но каждая метрика оценивает отдельный аспект поведения модели.
В этой статье мы подробно рассмотрим каждую из этих метрик производительности моделей ИИ. Также мы изучим, как они связаны друг с другом и как выбрать подходящую метрику для твоего сценария использования. Начнем!
Метрики оценки важны в машинном обучении#
На первый взгляд может показаться, что модель машинного обучения работает хорошо. Но без подходящих метрик оценки трудно понять, насколько точны ее результаты. Эти метрики задают структуру оценки модели и помогают ответить на главный вопрос: полезны и надежны ли прогнозы модели для данной задачи?
Такие метрики, как точность, прецизионность и полнота, дают разработчикам ИИ понятный способ оценить, насколько хорошо работает модель. Например, при сравнении разных моделей эти метрики позволяют определить, какая из них лучше справляется с конкретной задачей. Они помогают оценить производительность и выбрать модель, которая лучше всего соответствует целям проекта в области ИИ.
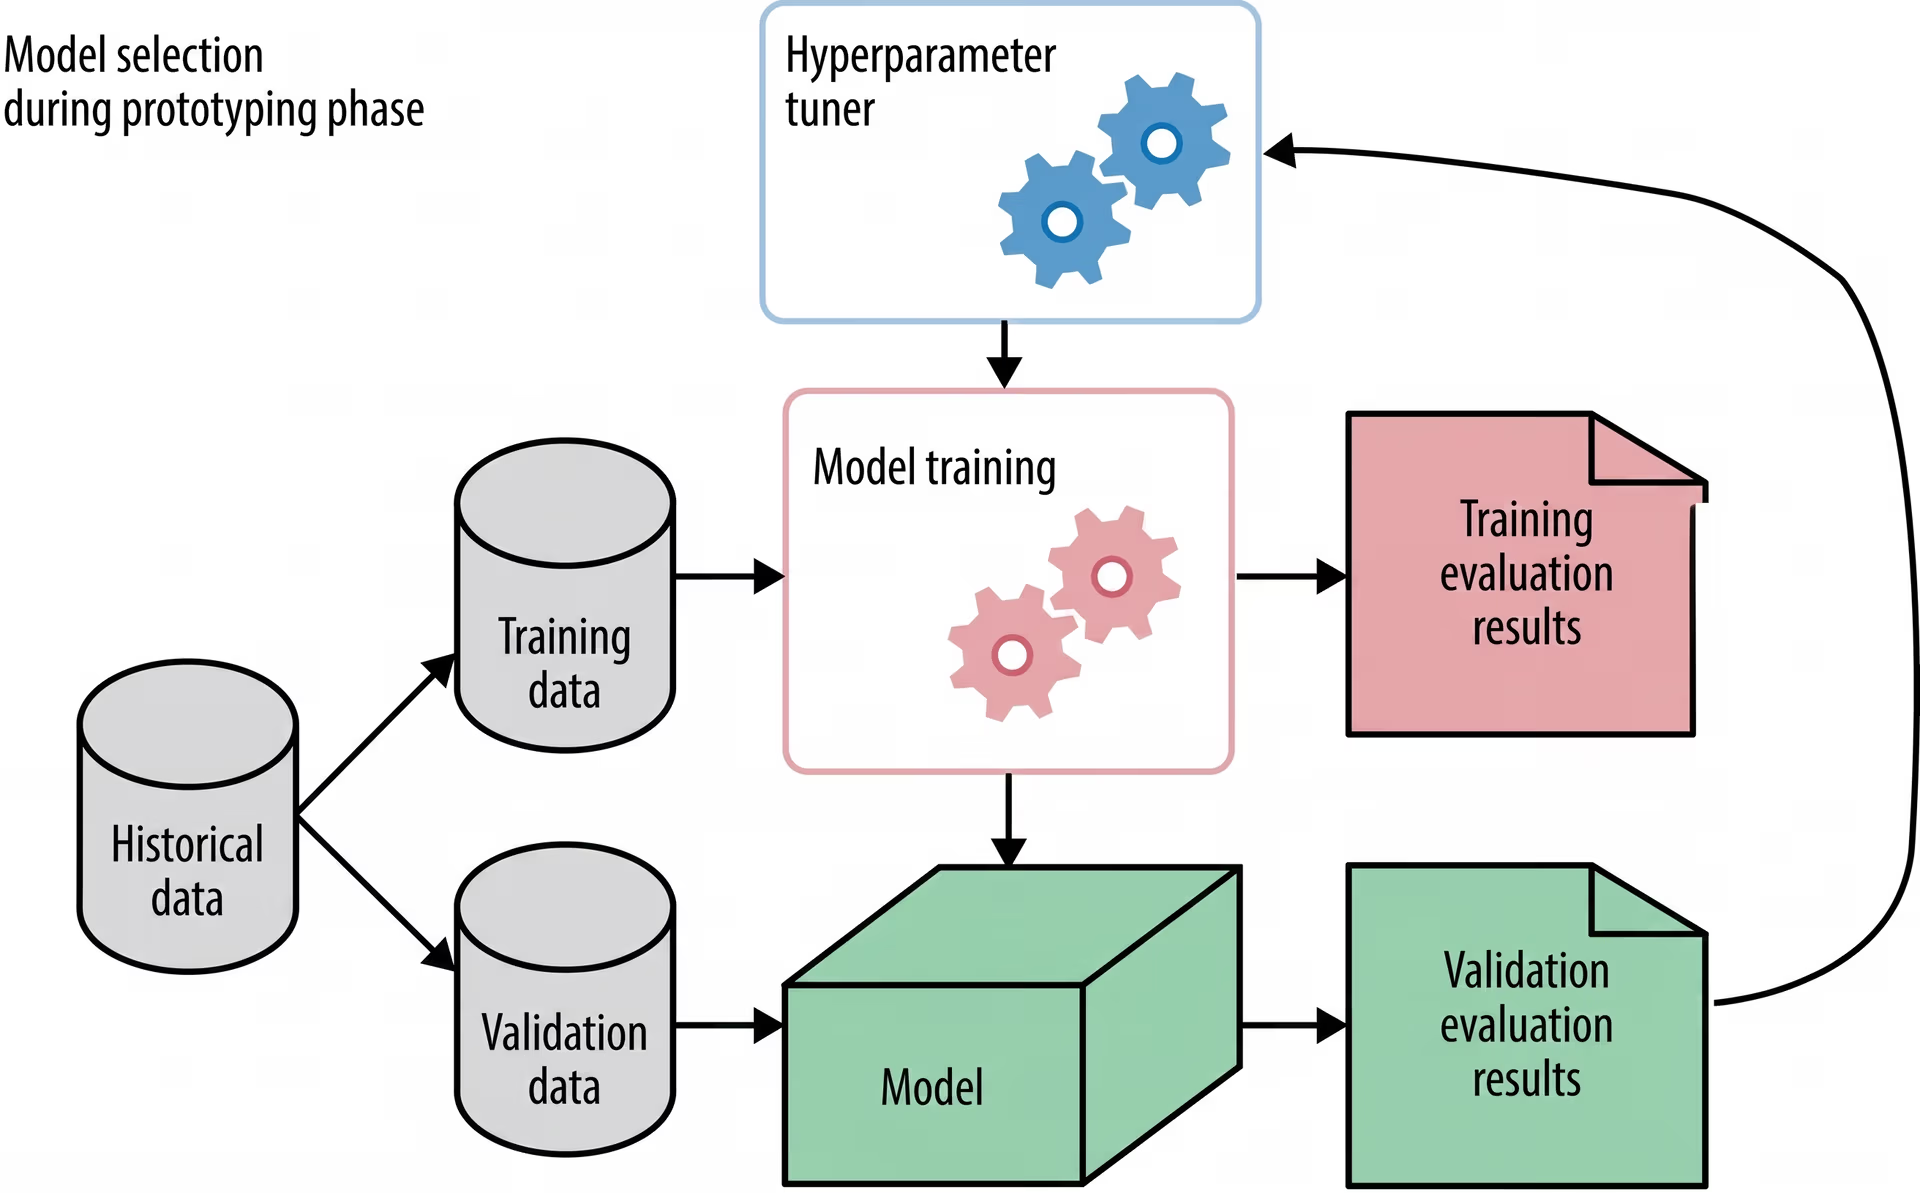
Рис. 1. Процесс обучения и оценки модели (Источник)
Эти метрики также делают сравнение производительности более объективным. Вместо догадок или неполных наблюдений они дают измеримые сведения о поведении модели в разных ситуациях. Это помогает понять, какие аспекты производительности наиболее важны в каждом контексте.
Например, выбор метрики часто зависит от приложения. В медицинских приложениях на базе ИИ важна полнота, поскольку цель — выявить как можно больше положительных случаев, даже если некоторые отрицательные случаи будут ошибочно отмечены как положительные. Напротив, спам-фильтр для электронной почты может отдавать приоритет прецизионности, чтобы не помечать обычные письма как спам.
Матрица ошибок: основа метрик классификации#
Матрица ошибок — это таблица размером два на два, которая служит основой для оценки моделей ИИ. Она распределяет прогнозы по четырем категориям, сравнивая фактические результаты с предсказанными (ответами модели).
Это сравнение дает подробное представление о производительности модели. Оно служит основой для ключевых метрик оценки, таких как прецизионность и полнота, которые рассчитываются непосредственно по значениям в матрице.
Строки таблицы соответствуют фактическим классам, а столбцы — предсказанным. В каждой ячейке указано количество результатов в соответствующей категории. Проще говоря, матрица показывает, сколько прогнозов были правильными и какие ошибки допустила модель.
Матрица ошибок особенно полезна при несбалансированных данных, когда одних категорий значительно больше, чем других. Она также пригодится, если разные типы ошибок имеют разные последствия.
Например, при обнаружении мошенничества важно выявлять мошеннические действия, но ошибочная блокировка реальных транзакций тоже может создать проблемы. Матрица наглядно показывает, как часто возникает каждый тип ошибки.
Элементы матрицы ошибок#
Вот обзор различных элементов матрицы ошибок:
- Истинно положительный результат (TP): Если модель правильно предсказывает положительный случай, он учитывается как истинно положительный. Например, модель компьютерного зрения правильно классифицирует транспортное средство на изображении.
- Истинно отрицательный результат (TN): Истинно отрицательный результат возникает, когда модель правильно определяет отрицательный случай. Например, классификатор электронной почты помечает обычное сообщение как не являющееся спамом.
- Ложноположительный результат (FP): Модель выдает ложноположительный результат, если ошибочно предсказывает положительный исход для фактически отрицательного случая. Это также называется ошибкой I рода; например, система обнаружения мошенничества может ошибочно пометить законную транзакцию как мошенническую.
- Ложноотрицательный результат (FN): Ложноотрицательный результат фиксируется, когда модель не выявляет положительный случай и ошибочно относит его к отрицательным. Это также называется ошибкой II рода; например, диагностический инструмент может не обнаружить заболевание у больного пациента.
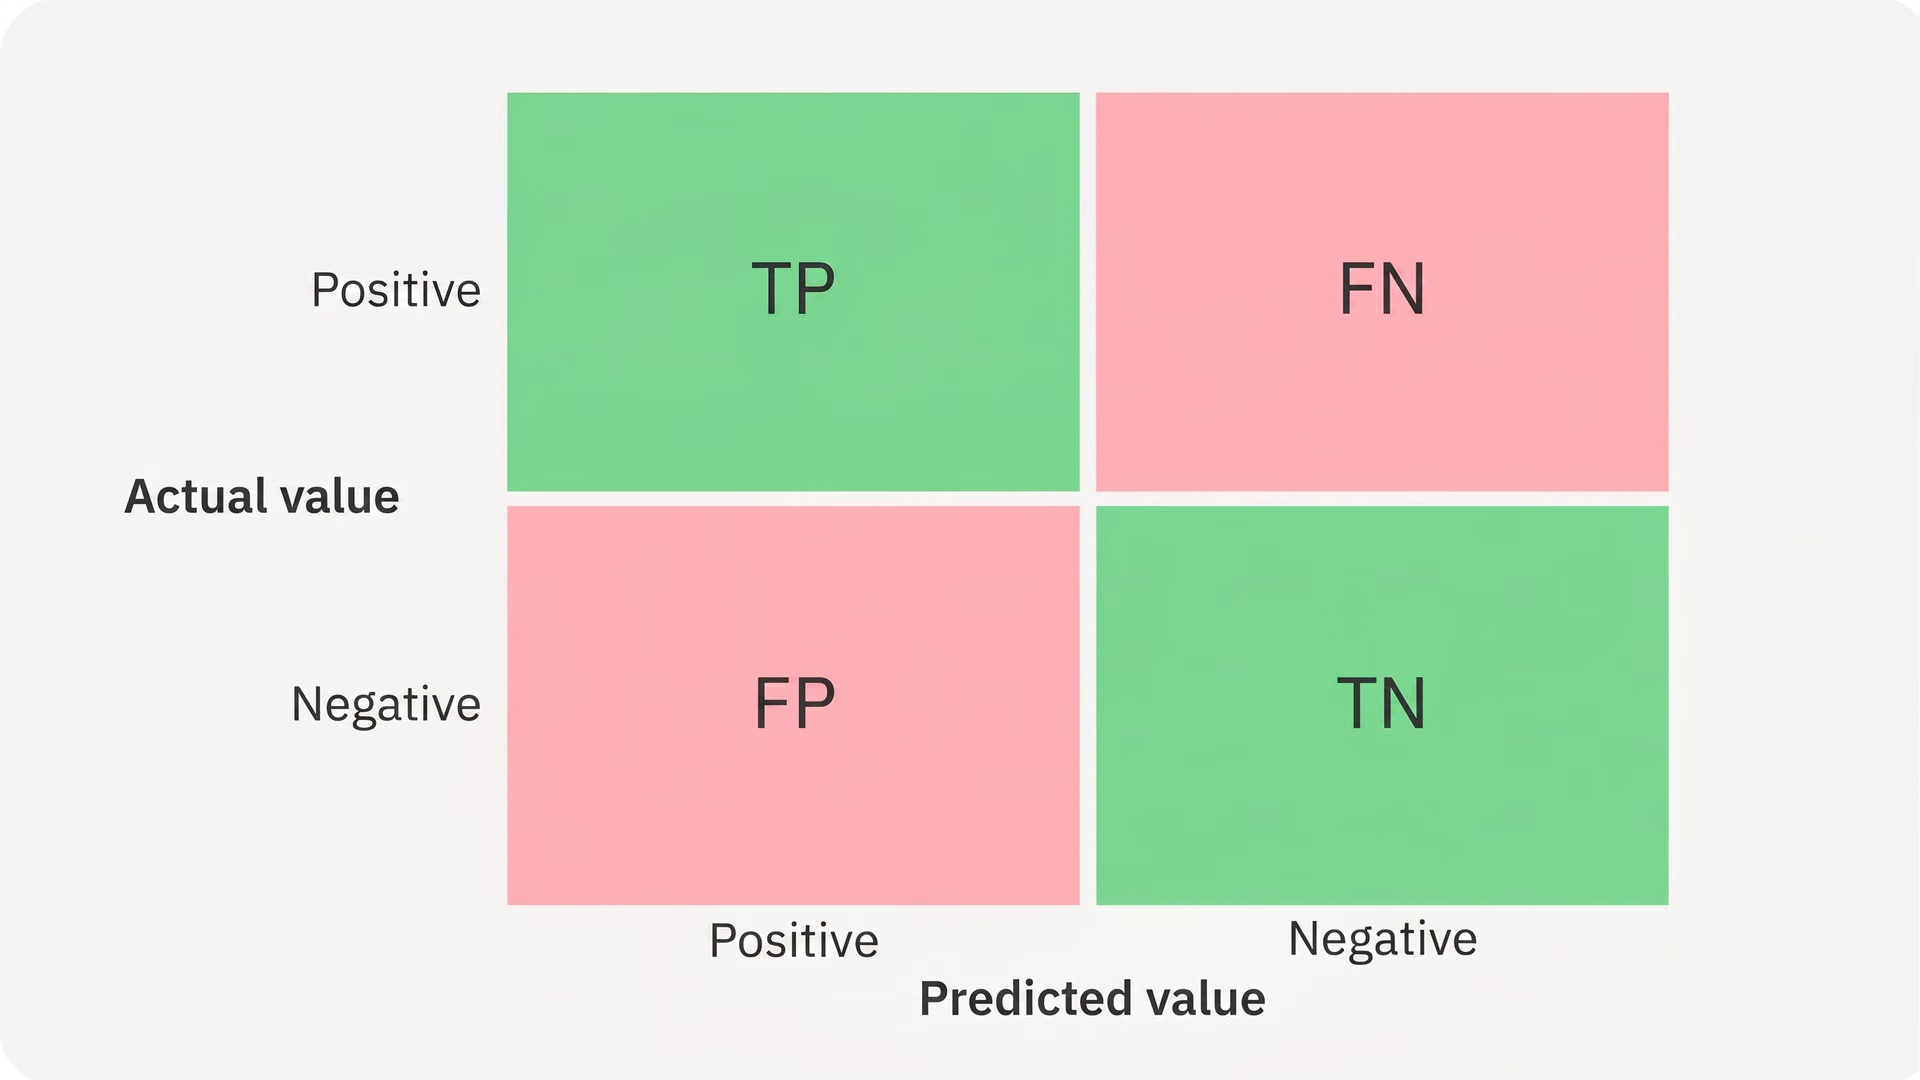
Рис. 2. Элементы матрицы ошибок (Источник)
Визуальное представление и интерпретация матрицы ошибок#
Матрица ошибок отображается в виде сетки. Вертикальная ось показывает фактические классы, а горизонтальная — предсказанные. Правильные прогнозы располагаются на диагонали и соответствуют истинно положительным и истинно отрицательным результатам.
Ошибки находятся вне диагонали: это ложноположительные и ложноотрицательные результаты. Такая структура упрощает выявление сильных и слабых сторон модели.
Что такое точность в машинном обучении?#
Точность — одна из самых распространенных метрик для оценки производительности модели машинного обучения. Она измеряет, насколько часто прогнозы правильны для всех классов. Иными словами, она отвечает на простой вопрос: сколько из всех прогнозов модели ИИ оказались правильными?
Точность рассчитывается как количество правильных прогнозов (то есть истинно положительных и истинно отрицательных результатов), деленное на общее количество прогнозов. Точность легко вычислить и понять, поэтому ее часто используют как отправную точку при оценке модели.
Как правило, точность надежна при работе со сбалансированными наборами данных. Однако в несбалансированных наборах, где один класс преобладает над другими, точность часто вводит в заблуждение. Модель, которая всегда предсказывает наиболее распространенный класс, может получить высокую оценку точности, но при этом не выявлять другие, менее распространенные классы.
Например, в наборе изображений, где лишь на немногих изображениях есть пешеходы, модель, которая для каждого изображения предсказывает «пешеходов нет», может показать высокую точность, но совершенно не распознавать самих пешеходов.
Это происходит потому, что сама по себе точность не показывает, какие ошибки допускает модель и как часто. Поэтому важно также учитывать такие метрики, как прецизионность и полнота, чтобы полностью понять, насколько хорошо работает модель ИИ.
Подробно о прецизионности: как свести к минимуму ложные срабатывания#
Прецизионность — ключевая метрика оценки, которая измеряет точность положительных прогнозов модели. Она отвечает на вопрос: сколько из всех случаев, предсказанных как положительные, действительно были положительными?
Прецизионность рассчитывается как количество истинно положительных результатов, деленное на сумму истинно положительных и ложноположительных результатов. Она особенно важна, когда ошибочный положительный прогноз может дорого обойтись.
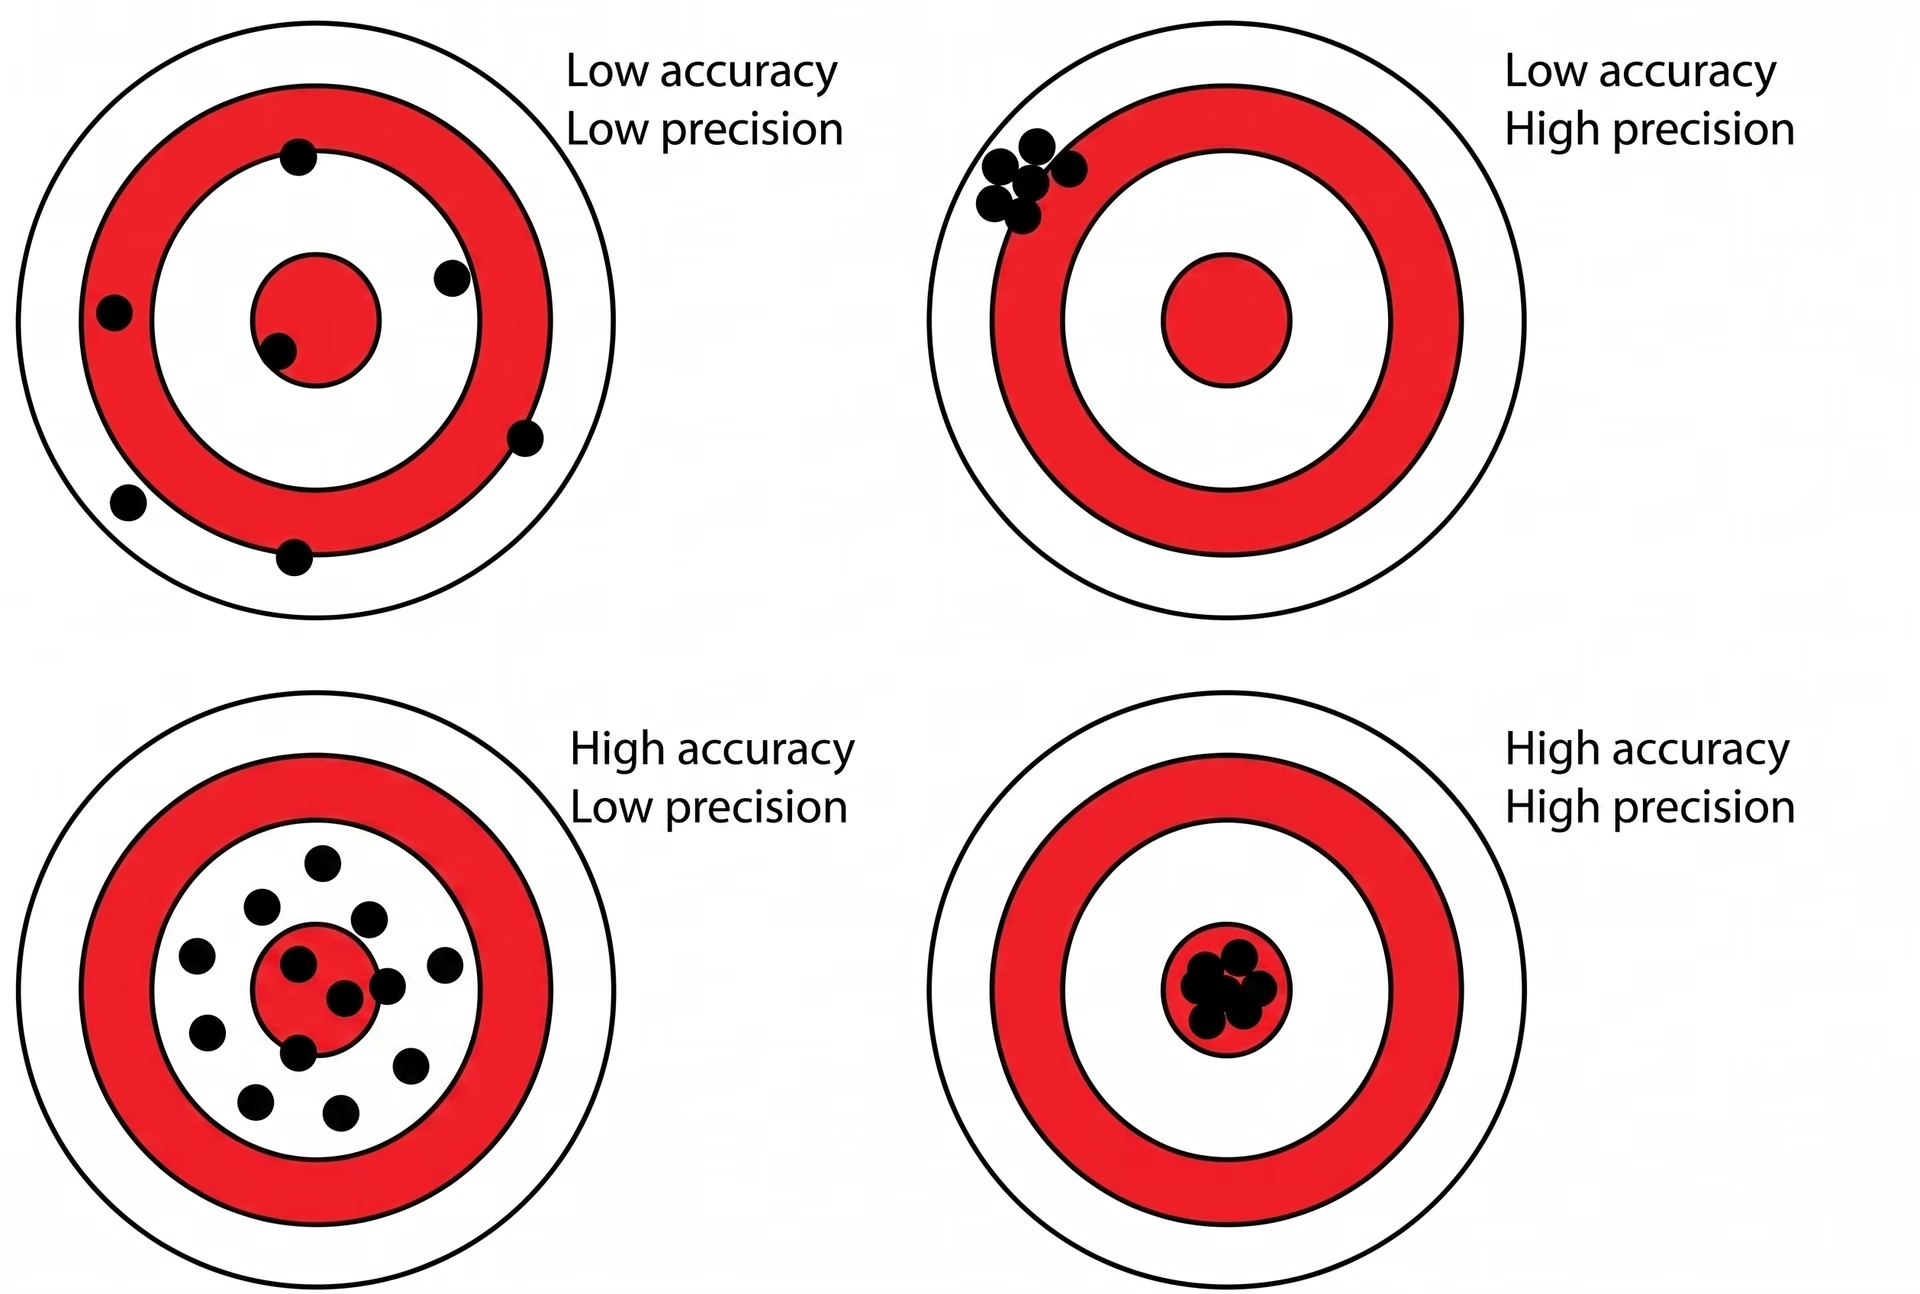
Рис. 3. Сравнение точности и прецизионности. (Источник)
Например, при обнаружении мошенничества модель с низкой прецизионностью может пометить множество законных транзакций как мошеннические, создавая ненужные проблемы пользователям и службам поддержки. Модель с высокой прецизионностью снижает этот риск, поскольку помеченные транзакции с большей вероятностью действительно являются мошенническими.
Высокая прецизионность полезна, но модели, которые уделяют ей слишком много внимания, могут стать чрезмерно избирательными и пропускать реальные положительные случаи. Поэтому прецизионность часто оценивают вместе с полнотой, чтобы поддерживать сбалансированную производительность.
Что такое полнота?#
Полнота — метрика, измеряющая, насколько хорошо модель выявляет фактически положительные случаи. Ее также называют чувствительностью или долей истинно положительных результатов. Она отвечает на вопрос: сколько из всех фактически положительных случаев модель правильно обнаружила?
Полнота рассчитывается как количество истинно положительных результатов, деленное на сумму истинно положительных и ложноотрицательных результатов. Высокая оценка полноты означает, что модель выявляет большинство реальных положительных случаев в данных.
Полнота крайне важна в таких отраслях, как здравоохранение, где пропуск заболевания может задержать лечение и подвергнуть пациентов риску. Даже если некоторые отрицательные случаи ошибочно отмечены как положительные, главным приоритетом остается выявление всех реальных случаев заболевания.
Однако модели, ориентированные только на полноту, могут выдавать слишком много ложноположительных результатов, снижая прецизионность и общую эффективность модели. Для надежной работы модели ИИ крайне важно сбалансировать полноту и прецизионность.
Баланс: компромисс между прецизионностью и полнотой#
Прецизионность и полнота часто изменяются в противоположных направлениях. Когда одна растет, другая может снижаться. Этот компромисс — распространенная проблема в задачах машинного обучения.
Модель с высокой прецизионностью относит случай к положительным только тогда, когда уверена в прогнозе. Это уменьшает количество ложных срабатываний, но может привести к пропуску реальных положительных случаев и снижению полноты. Модель, которая пытается выявить все положительные случаи, повышает полноту, но рискует увеличить число ложных срабатываний и снизить прецизионность.
Этот компромисс становится очевиднее, если изменить порог принятия решений модели. Порог — это граница, по которой система преобразует оценку или вероятность в действие или метку. Понижение порога заставляет систему чаще выдавать положительный результат: полнота может вырасти, но прецизионность — снизиться. Повышение порога дает обратный эффект: модель предсказывает меньше положительных случаев, прецизионность растет, а полнота обычно падает.
Представь, что ты работаешь над обнаружением спама. Модель должна балансировать между риском пропустить спам во входящие и риском заблокировать обычные письма. Строгий фильтр все равно может пропустить часть спама, а более мягкий — случайно заблокировать легитимные сообщения. Оптимальный баланс зависит от сценария использования и цены каждого типа ошибки.
Значение кривой «прецизионность — полнота»#
Кривая «прецизионность — полнота», или PR-кривая, показывает, как изменяются прецизионность и полнота при изменении порога принятия решений модели. Каждая точка соответствует отдельному компромиссу между этими метриками. PR-кривая особенно полезна для несбалансированных наборов данных, в которых один класс встречается гораздо реже.
Она также дает более содержательное представление, чем кривая рабочей характеристики приемника (ROC), которая тоже показывает, насколько хорошо модель различает положительные и отрицательные случаи при разных порогах принятия решений. Кривая «прецизионность — полнота» модели с высокими значениями обеих метрик будет проходить близко к верхнему правому углу, что обычно считается идеальным.
Знакомство с F1-мерой: комбинированная метрика для оценки баланса#
F1-мера сводит баланс между прецизионностью и полнотой к одному значению. F1-мера рассчитывается как удвоенное произведение прецизионности и полноты, деленное на их сумму. Она полезна, когда важны и ложноположительные, и ложноотрицательные результаты, а также при работе с несбалансированными наборами данных или необходимости получить сбалансированное представление о производительности модели.
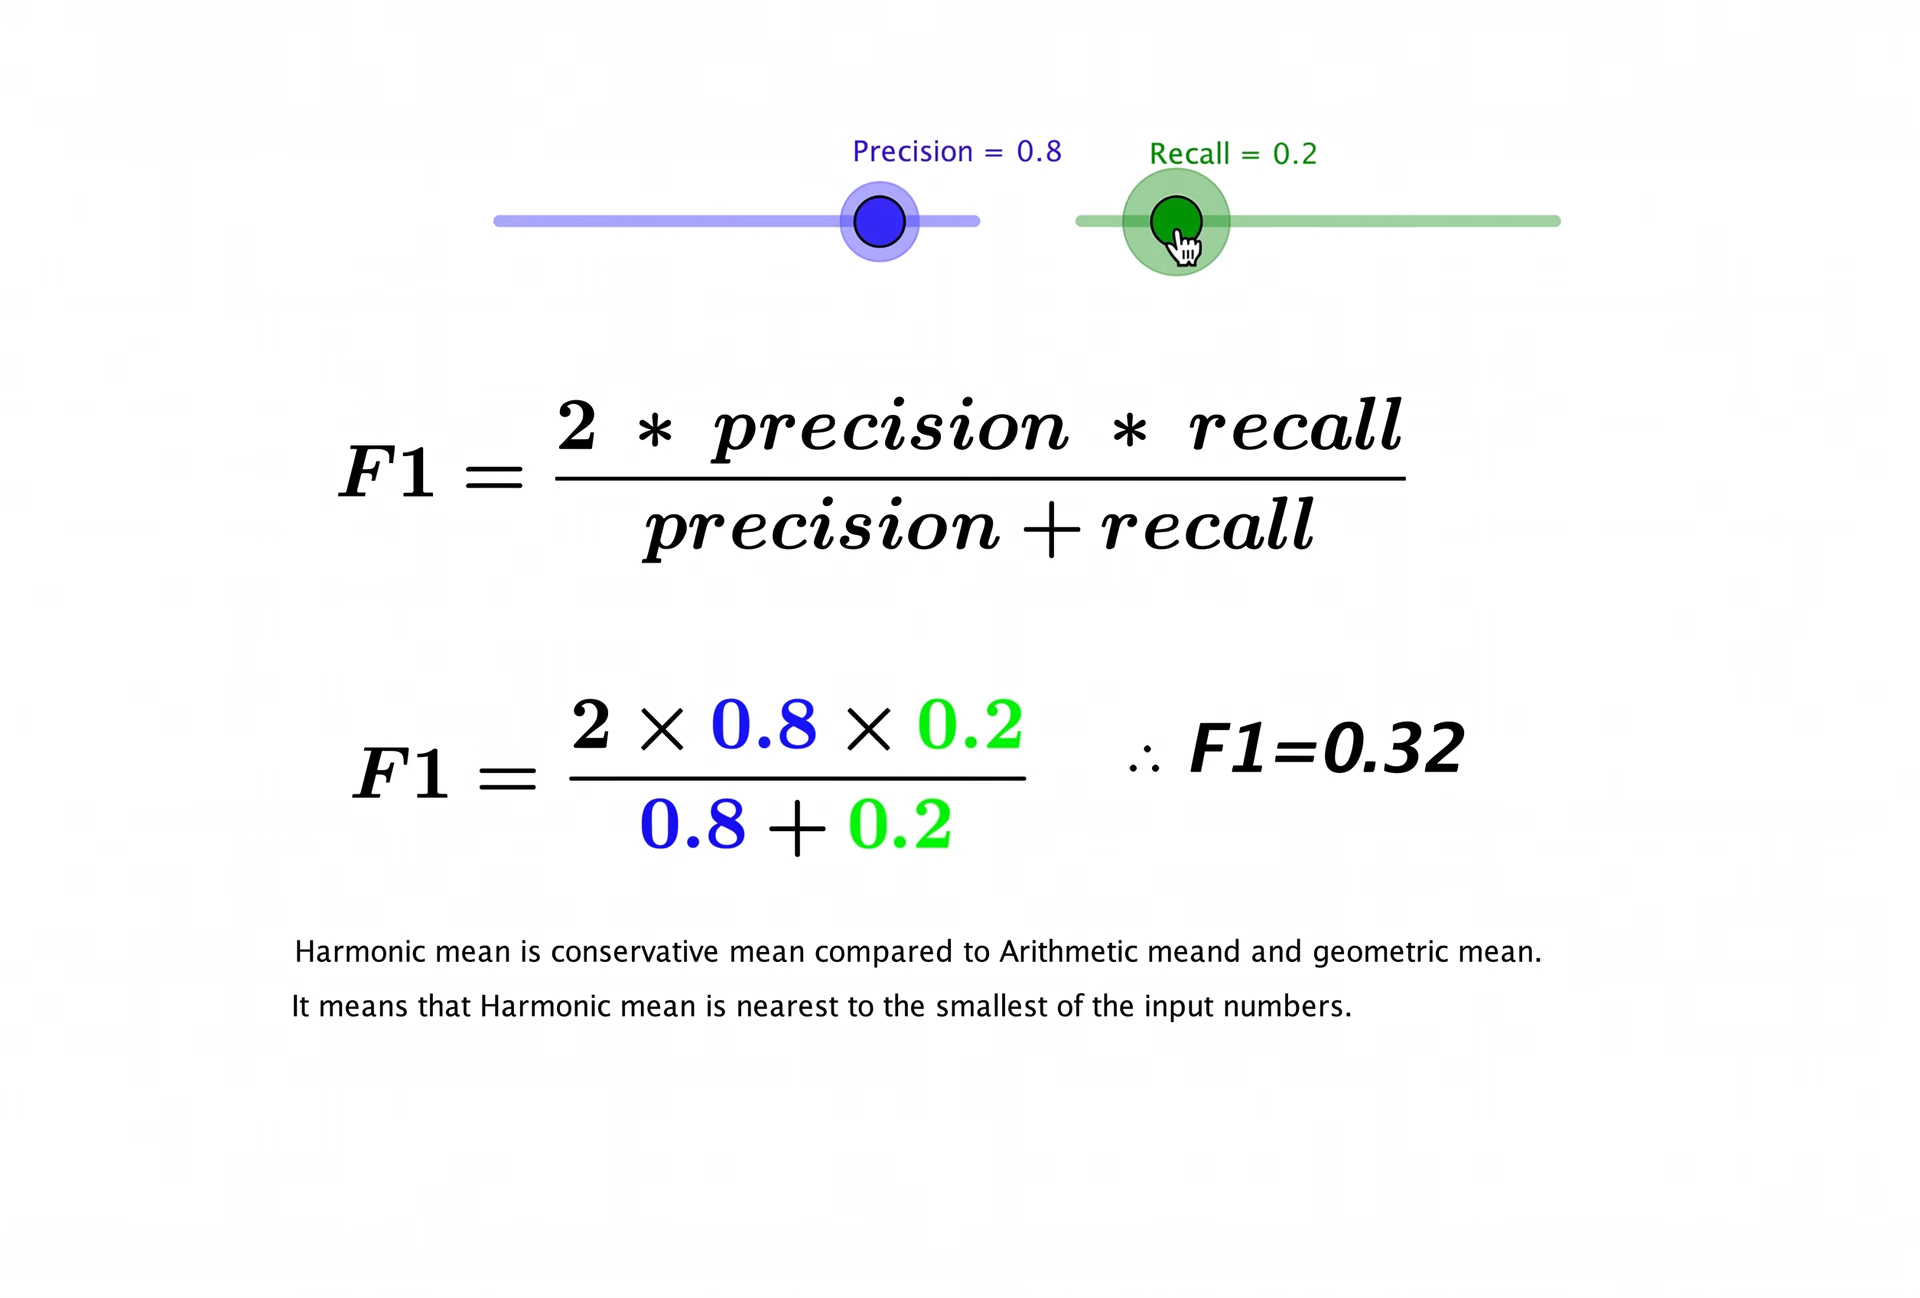
Рис. 4. Расчет F1-меры на основе прецизионности и полноты (Источник)
Помимо точности, прецизионности и полноты#
Хотя точность, прецизионность и полнота крайне важны, другие метрики дают дополнительное представление о модели с учетом ее типа и характеристик набора данных.
Вот несколько часто используемых метрик, которые помогают оценивать различные аспекты производительности:
- Специфичность: Эта метрика показывает, насколько хорошо модель распознает истинно отрицательные результаты. Она полезна, когда важно избегать ложноположительных результатов.
- AUC: AUC, или площадь под кривой, — это единая оценка, отражающая, насколько хорошо модель различает классы.
- Логарифмическая функция потерь: Ее используют, чтобы измерить, насколько уверенно модель делает предсказания; за ошибочные предсказания с высокой уверенностью она назначает более высокий штраф. Здесь уверенность означает, насколько модель уверена в своем предсказании.
- Оценка для многометочных задач: В многометочных задачах метрики усредняют по меткам, чтобы отразить общую производительность модели.
Применение точности, прецизионности и полноты в компьютерном зрении#
Теперь, когда мы лучше понимаем точность, прецизионность и полноту, давай разберемся, как эти метрики применяются в компьютерном зрении.
Модели компьютерного зрения, например Ultralytics YOLO11, поддерживают такие задачи, как обнаружение объектов: модель распознает присутствующие на изображении объекты и определяет их местоположение с помощью ограничивающих рамок. Каждое предсказание включает метку объекта и его положение, поэтому оценивать результат сложнее, чем просто проверять правильность метки.
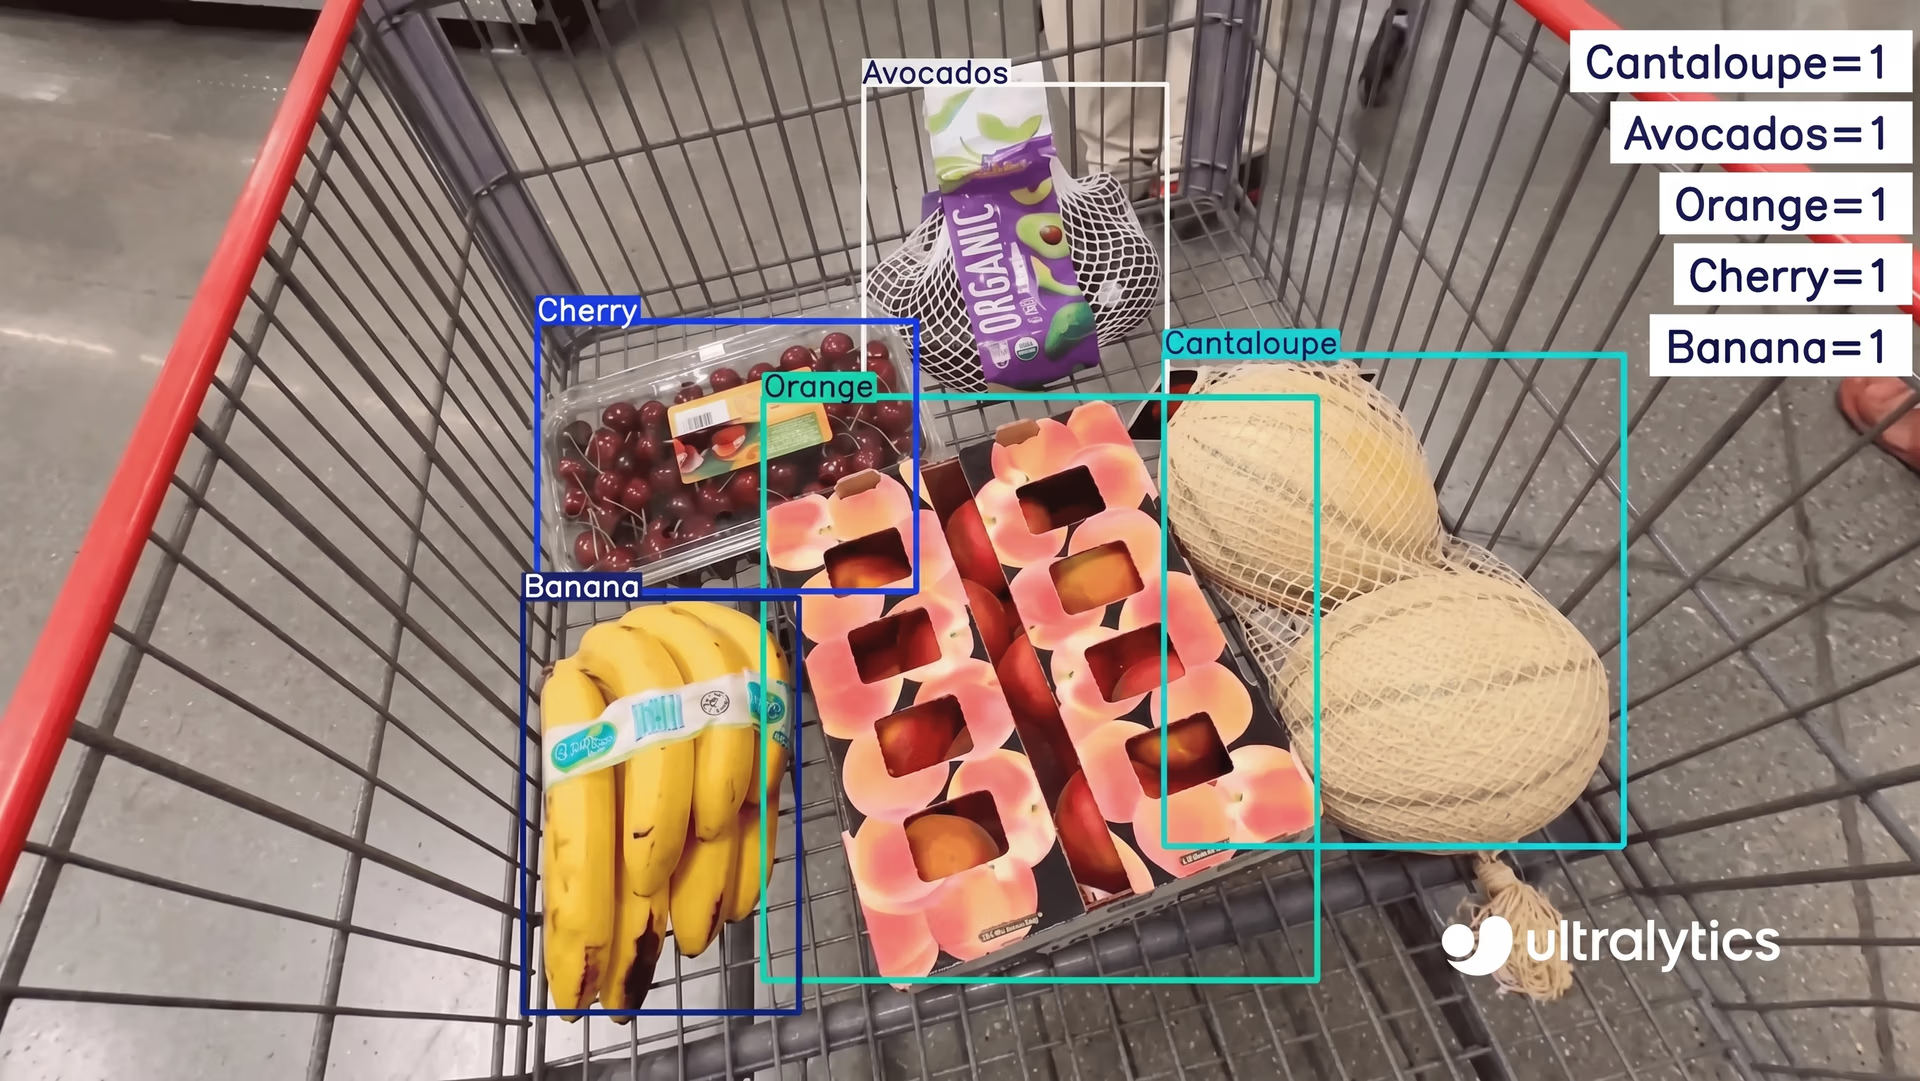
Рис. 5. Пример использования Ultralytics YOLO11 для обнаружения объектов. (Источник)
Рассмотрим применение в розничной торговле, где камеры автоматически отслеживают товары на полках. Модель обнаружения объектов может распознавать такие товары, как коробки с хлопьями, банки с газировкой или бутылки с водой, и отмечать их местоположение.
В этом случае прецизионность показывает, сколько обнаруженных объектов действительно распознаны правильно. Высокая прецизионность означает, что система избегает ложноположительных результатов, например не принимает тень или объект на фоне за товар. Полнота показывает, сколько реальных товаров на полке модель смогла обнаружить. Высокая полнота означает, что модель пропускает меньше товаров, что крайне важно для точного подсчета запасов.
Точность по-прежнему дает общее представление о правильности результатов, но в такой ситуации даже пропуск нескольких товаров или обнаружение отсутствующих объектов может существенно повлиять на управление запасами. Поэтому разработчики совместно оценивают прецизионность, полноту и точность, чтобы убедиться, что система надежна и пригодна для практического применения.
Точность, прецизионность и полнота: основные выводы#
Точность, прецизионность и полнота отражают разные аспекты производительности модели машинного обучения. Опора лишь на одну метрику может ввести в заблуждение.
Такие инструменты и метрики, как матрица ошибок, кривые «прецизионность–полнота» и F1-мера, помогают выявить компромиссы и принять решение об улучшениях модели машинного обучения. Подобрав подходящее сочетание метрик для конкретного решения на основе ИИ, ты сможешь обеспечить точность, надежность и эффективность моделей в реальных приложениях.
Загляни в наше растущее сообщество! Посети наш репозиторий GitHub, чтобы узнать больше об ИИ. Готов начать проекты в области компьютерного зрения? Ознакомься с нашими вариантами лицензирования. Изучи применение ИИ в сельском хозяйстве и компьютерного зрения в робототехнике на страницах наших решений!









