Как Ultralytics YOLO26 обучается эффективнее с ProgLoss, STAL и MuSGD
Узнай, как Ultralytics YOLO26 обучается надёжнее благодаря прогрессивной балансировке функции потерь, назначению меток с учётом небольших объектов и оптимизатору MuSGD.
 Abirami Vina8 мин. чтения
На прошлой неделе мы выпустили Ultralytics YOLO26 — модель компьютерного зрения для периферийных устройств с поддержкой работы в реальном времени. Как и предыдущие модели Ultralytics YOLO, например Ultralytics YOLO11, YOLO26 поддерживает основные задачи компьютерного зрения, знакомые пользователям: обнаружение объектов, сегментацию экземпляров и оценку позы.
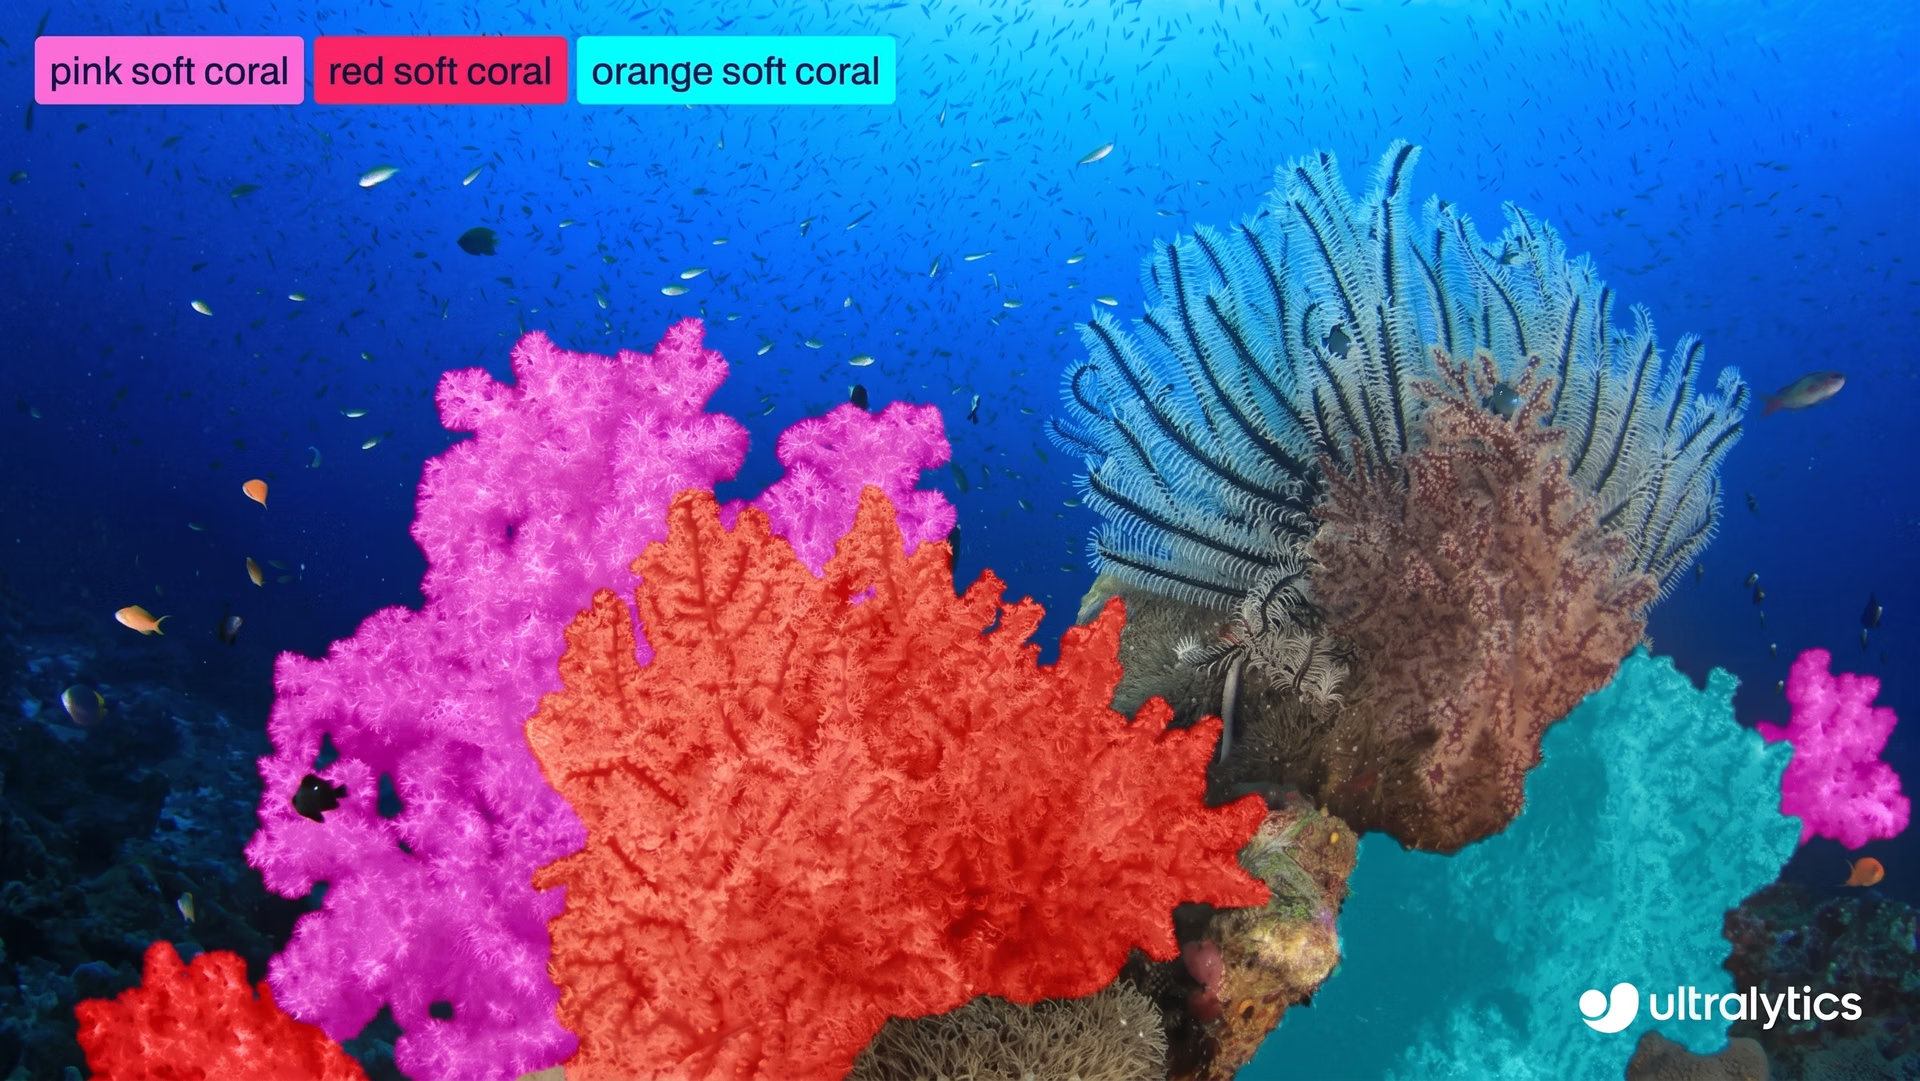
Рис. 1. Пример использования Ultralytics YOLO26 для сегментации объектов на изображении.
Однако Ultralytics YOLO26 — не просто очередное обновление. Поддерживаемые задачи могут показаться знакомыми, но эта новая модель знаменует собой шаг вперёд в обучении моделей компьютерного зрения. В YOLO26 особое внимание уделяется не только эффективности инференса, но и повышению стабильности обучения.
Ultralytics YOLO26 разработана с учетом всего цикла обучения. Это обеспечивает более быструю сходимость, более надежные запуски обучения и стабильное поведение модели. Эти улучшения особенно важны в реальных рабочих процессах, где надежность обучения напрямую влияет на скорость итераций и развертывания моделей.
Для этого в Ultralytics YOLO26 реализован ряд целевых инноваций в обучении, включая прогрессивное балансирование функции потерь (ProgLoss), назначение меток с учетом небольших объектов (STAL) и оптимизатор MuSGD. В совокупности эти изменения улучшают балансирование потерь обучения, назначение меток и динамику оптимизации.
В этой статье мы рассмотрим, как работает каждый из этих механизмов и почему благодаря им Ultralytics YOLO26 проще обучать и надежнее масштабировать. Начнем!
Ultralytics YOLO26: более разумное обучение, а не просто высокая скорость работы#
Ultralytics YOLO26 оптимизирует весь процесс инференса непосредственно в модели, устраняя необходимость в таких этапах постобработки, как подавление немаксимумов (NMS). Вместо того чтобы генерировать множество перекрывающихся предсказаний, а затем отфильтровывать их, YOLO26 сразу формирует итоговые обнаружения на выходе сети.
Так YOLO26 становится сквозной моделью, в которой прогнозирование, устранение дубликатов и формирование итоговых результатов полностью реализованы внутри самой сети. Это упрощает развертывание и повышает эффективность инференса, а также влияет на то, как модель обучается.
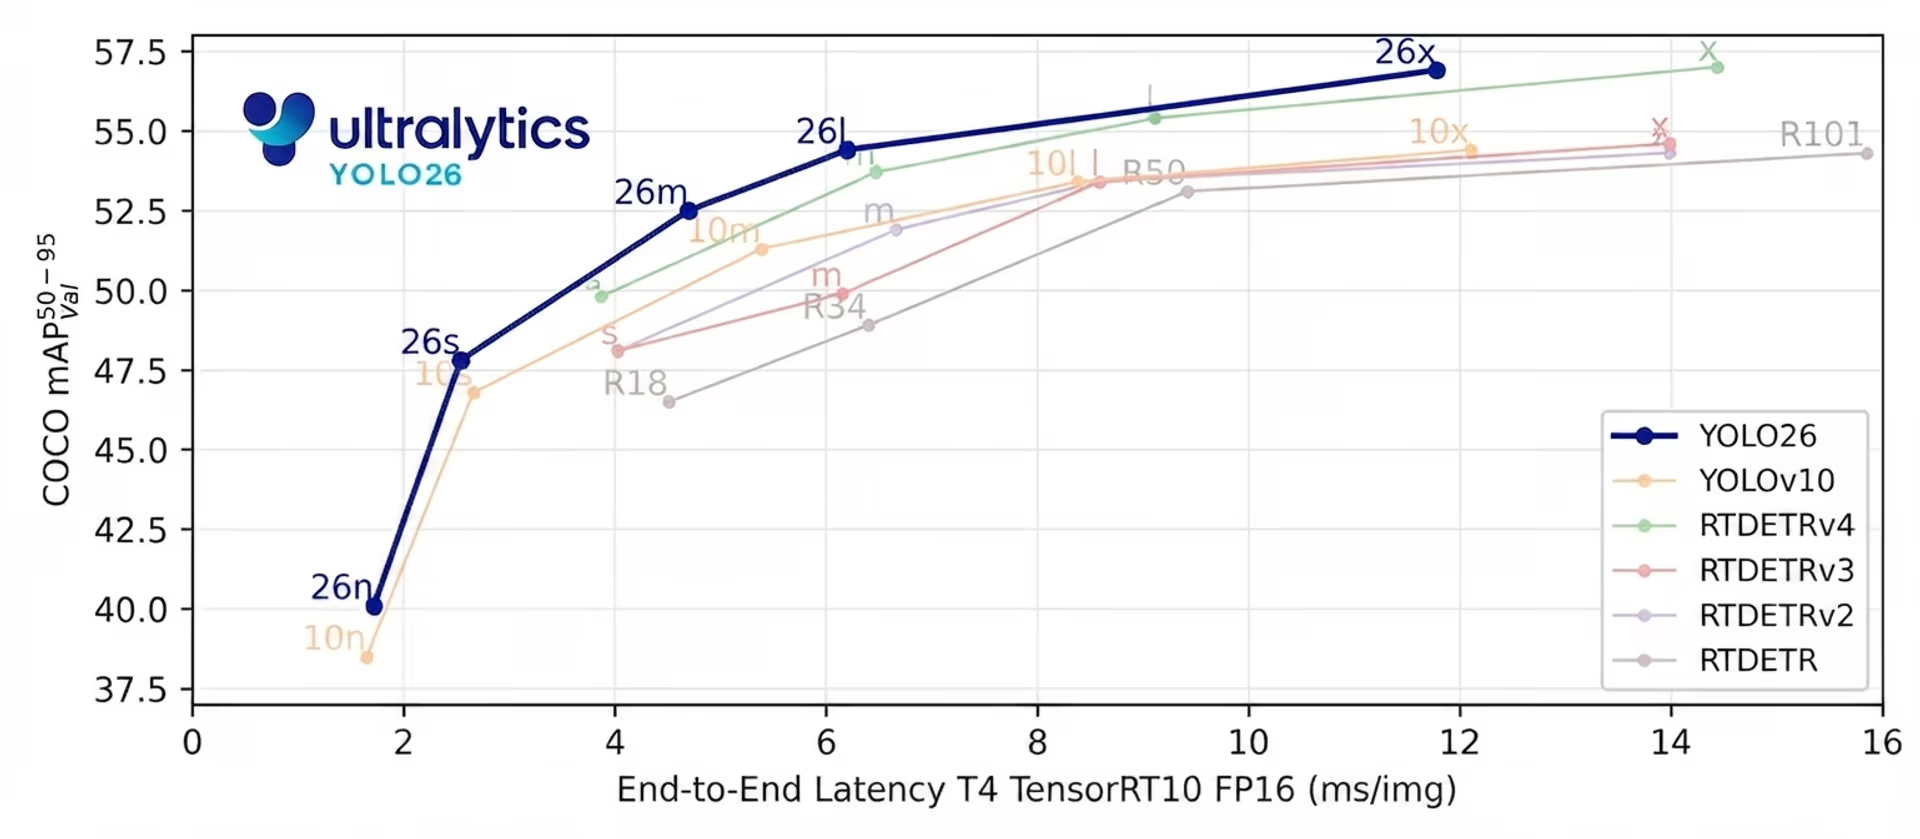
Рис. 2. YOLO26 обеспечивает передовой сквозной инференс без NMS (Источник)
В такой сквозной системе обучение и инференс тесно связаны. Поскольку внешнего этапа постобработки, который мог бы впоследствии исправить предсказания, нет, модель должна учиться принимать чёткие и уверенные решения непосредственно во время обучения.
Поэтому согласование целей обучения с поведением при инференсе особенно важно. Любое несоответствие между тем, как обучается модель, и тем, как она используется при инференсе, может привести к нестабильному обучению или замедлению сходимости.
Ultralytics YOLO26 решает эту задачу, с самого начала выстраивая процесс обучения с учётом реальных условий использования. Система обучения нацелена не только на скорость инференса: она обеспечивает стабильное обучение на протяжении длительных запусков, устойчивую сходимость моделей разных размеров — от Nano до Extra Large — и надёжную работу на разнообразных наборах данных.
Как две обучающие головы улучшают обучение Ultralytics YOLO26#
Одно из ключевых нововведений в обучении Ultralytics YOLO26 основано на подходе с двумя головами, применявшемся в предыдущих моделях YOLO. В моделях обнаружения объектов голова — это часть сети, отвечающая за предсказания.
Иными словами, головы обнаружения учатся предсказывать, где на изображении расположены объекты и что это за объекты. Для этого они регрессируют координаты ограничивающих рамок, то есть учатся оценивать положение и размер каждого объекта на входном изображении.
Во время обучения модель минимизирует функцию потерь — численную меру того, насколько её предсказания отличаются от правильных ответов, или эталонной разметки. Чем меньше значение функции потерь, тем ближе предсказания модели к эталонной разметке; большее значение указывает на более крупные ошибки. Расчёт функции потерь определяет, как модель обновляет свои параметры во время обучения.
Во время обучения Ultralytics YOLO26 использует две головы обнаружения, которые опираются на одну и ту же базовую модель, но выполняют разные задачи. Голова one-to-one используется при инференсе. Она учится сопоставлять каждому объекту одно уверенное предсказание, что необходимо для сквозной архитектуры Ultralytics YOLO26 без NMS.
Голова one-to-many, в свою очередь, используется только во время обучения. Она позволяет сопоставлять одному объекту несколько предсказаний, обеспечивая более плотное обучение с учителем. Такой более насыщенный обучающий сигнал помогает стабилизировать обучение и повысить точность, особенно на ранних этапах.
В Ultralytics YOLO26 обе головы используют один и тот же расчёт функции потерь для регрессии рамок и классификации. В более ранних реализациях баланс между этими двумя сигналами потерь оставался фиксированным на протяжении всего обучения.
Однако на практике важность каждой головы со временем меняется. Плотное обучение с учителем полезнее всего на ранних этапах, тогда как позднее обучения становится важнее согласование с поведением при инференсе. Ultralytics YOLO26 спроектирована с учётом этого наблюдения, что напрямую определяет, как она перераспределяет обучающие сигналы по мере продвижения обучения.
Ultralytics YOLO26 использует прогрессивное балансирование функции потерь#
Как Ultralytics YOLO26 справляется с меняющимися потребностями обучения? Для регулировки весов обучающих сигналов с течением времени она использует прогрессивное балансирование функции потерь.
ProgLoss динамически меняет вклад каждой головы в общую функцию потерь по мере продвижения обучения. На раннем этапе больший вес получает голова one-to-many, что стабилизирует обучение и повышает полноту обнаружения. По мере продолжения обучения баланс постепенно смещается в сторону головы one-to-one, благодаря чему обучение лучше согласуется с поведением при инференсе.
Такой постепенный переход позволяет Ultralytics YOLO26 учиться в правильной последовательности. Вместо того чтобы заставлять модель одновременно оптимизировать конкурирующие цели, прогрессивное балансирование функции потерь отдаёт приоритет наиболее полезному обучающему сигналу на каждом этапе обучения. В результате сходимость становится плавнее, нестабильных запусков обучения становится меньше, а итоговая производительность — стабильнее.
Как STAL помогает Ultralytics YOLO26 учиться на крошечных объектах#
Ещё одно интересное улучшение обучения в Ultralytics YOLO26 связано с тем, как модель назначает обучающие цели предсказаниям; этот процесс называется назначением меток. Он отвечает за сопоставление объектов эталонной разметки с кандидатами на предсказания, часто называемыми якорями.
Эти сопоставления определяют, какие предсказания получают обучающий сигнал и участвуют в расчёте функции потерь. Ultralytics YOLO26 развивает существующий метод назначения меток под названием Task Alignment Learning (TAL), созданный для более точного согласования классификации и локализации во время обучения.
Хотя TAL хорошо работает с большинством объектов, обучение выявило важное ограничение. Во время сопоставления очень маленькие объекты могли полностью отсеиваться. На практике объекты размером менее примерно 8 пикселей на входном изображении размером 640 пикселей часто не получали назначений якорей. В таких случаях модель получает мало обучающего сигнала для этих объектов или не получает его вовсе, поэтому ей трудно научиться надёжно их обнаруживать.
Для решения этой проблемы в Ultralytics YOLO26 внедрен метод назначения меток с учетом малых объектов (STAL). STAL изменяет процесс назначения, чтобы мелкие объекты не игнорировались при обучении. В частности, при выборе кандидатов ширина или высота любой рамки менее 8 пикселей увеличивается до 16 пикселей, тогда как исходная рамка по-прежнему используется для сопоставления и регрессии. Это гарантирует, что даже крошечные объекты стабильно учитываются в функции потерь при обучении.
Усиливая обучение с учителем для малых объектов, STAL повышает стабильность обучения и качество обнаружения в сценариях, где часто встречаются маленькие или удалённые объекты. Это улучшение особенно важно для приложений YOLO26 с приоритетом периферийных устройств, таких как аэрофотосъёмка, робототехника и системы Интернета вещей (IoT), где объекты часто малы, удалены или видны лишь частично, а надёжное обнаружение критически важно.
В Ultralytics YOLO26 появился оптимизатор MuSGD#
Для более стабильного и предсказуемого обучения в Ultralytics YOLO26 также появился новый оптимизатор MuSGD. Он предназначен для улучшения сходимости и надёжности обучения сквозных моделей обнаружения, особенно по мере увеличения размера модели и сложности обучения.
Чтобы нейронная сеть училась и обновляла веса во время обучения, мы вычисляем ошибку, также называемую функцией потерь. Модель определяет величину ошибки предсказаний с помощью значения функции потерь, вычисляет градиенты, показывающие, как нужно изменить параметры, а затем обновляет параметры, чтобы уменьшить ошибку. Стохастический градиентный спуск (SGD) — широко используемый оптимизатор, который выполняет такие обновления, делая обучение эффективным и масштабируемым.
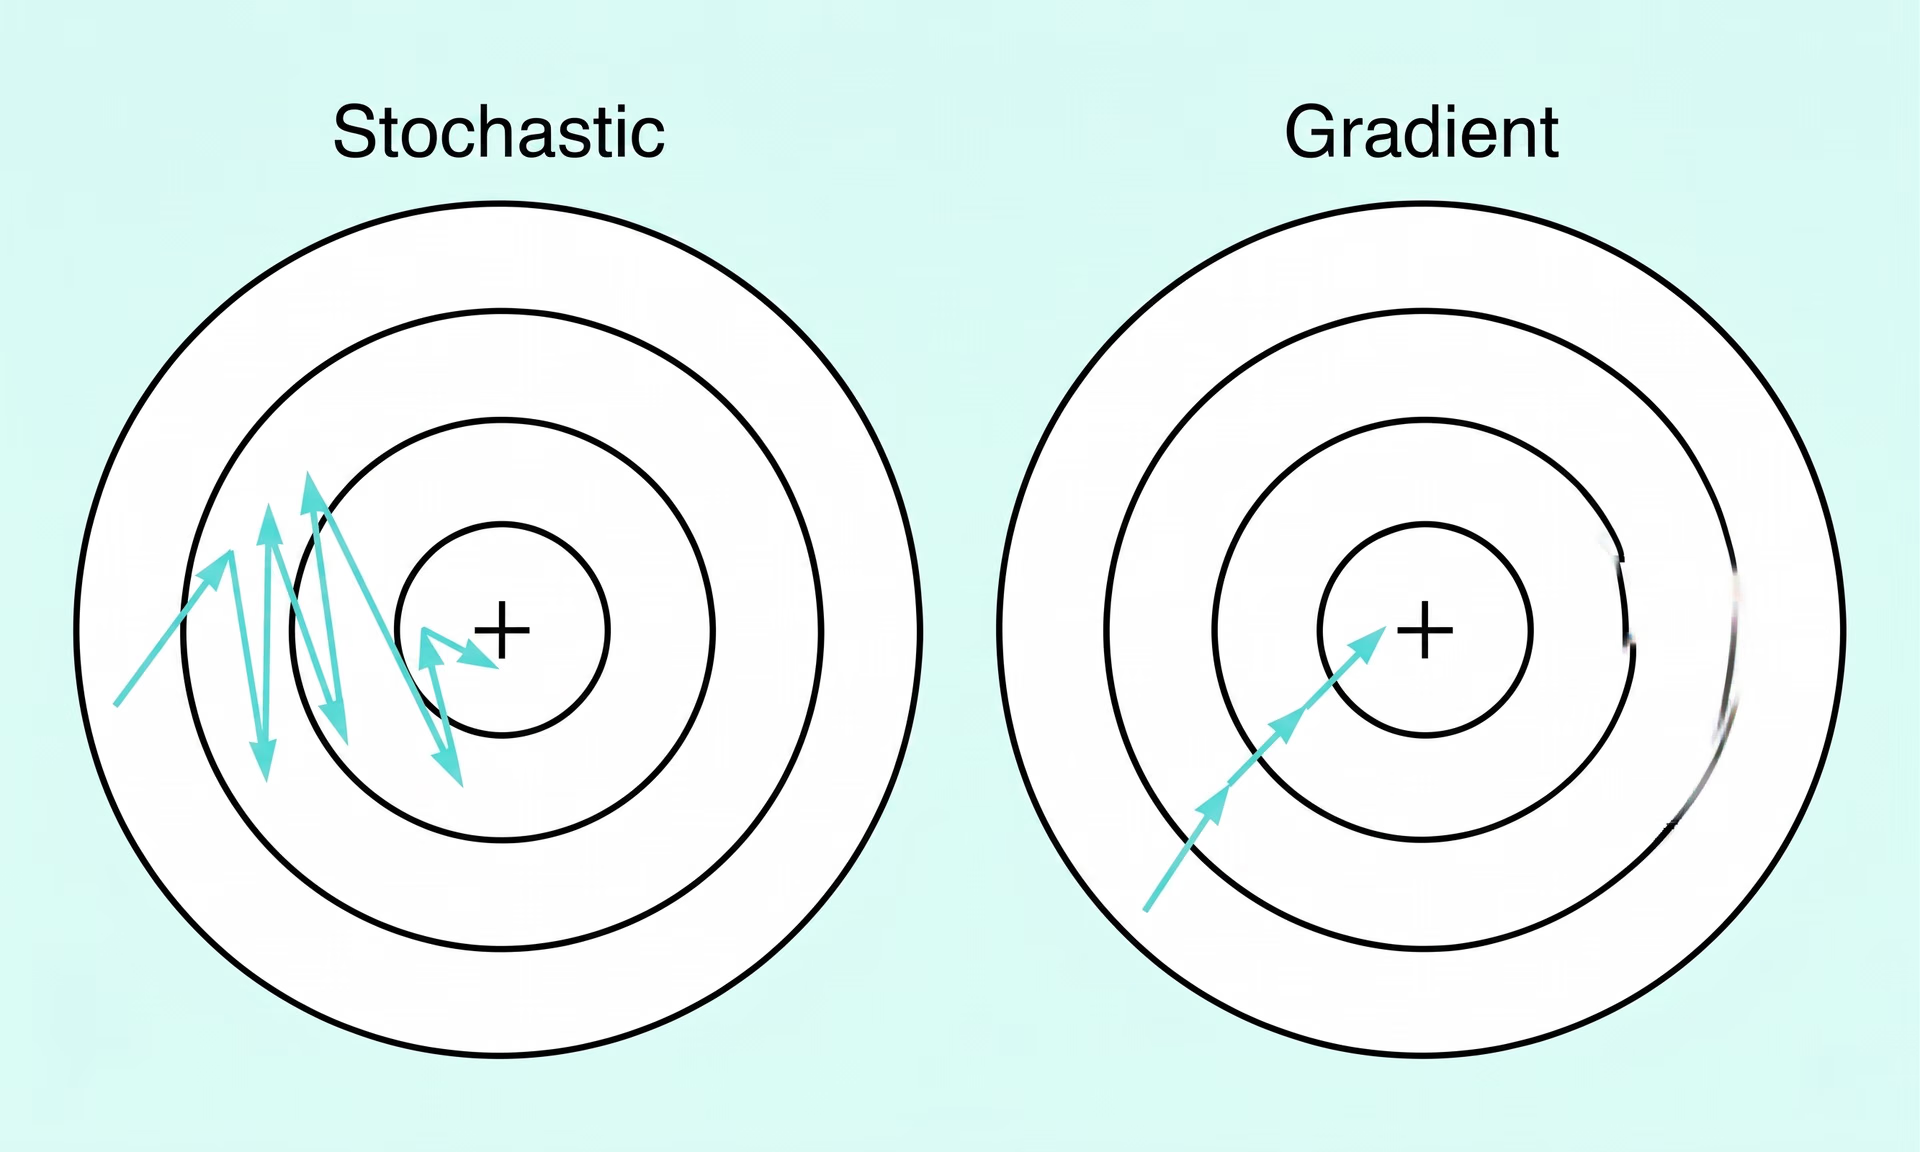
Рис. 3. Стохастический градиентный спуск и градиентный спуск (Источник)
MuSGD использует эту проверенную основу и дополняет её идеями оптимизации, вдохновлёнными Muon — методом, который применяют при обучении больших языковых моделей (LLM). На эти идеи повлияли недавние достижения, например Kimi K2 от Moonshot AI, продемонстрировавшая улучшение обучения благодаря более структурированному обновлению параметров.
Ultralytics YOLO26 использует гибридную стратегию обновления. Некоторые параметры обновляются сочетанием методов, вдохновлённых Muon, и SGD, тогда как для остальных используется только SGD. Благодаря этому YOLO26 может добавить структуру в процесс оптимизации, сохранив устойчивость и способность к обобщению, благодаря которым SGD доказал свою эффективность.
В результате оптимизация становится плавнее, сходимость — быстрее, а процесс обучения — предсказуемее для моделей разных размеров. Поэтому MuSGD играет ключевую роль в том, что Ultralytics YOLO26 проще обучать и надёжнее масштабировать.
Значение нововведений в обучении Ultralytics YOLO26#
Нововведения в обучении Ultralytics YOLO26 в сочетании с такими ключевыми особенностями, как сквозная архитектура без NMS и с приоритетом периферийных устройств, упрощают обучение модели и повышают надёжность при масштабировании. Возможно, ты задаёшься вопросом, что это означает на практике для приложений компьютерного зрения.
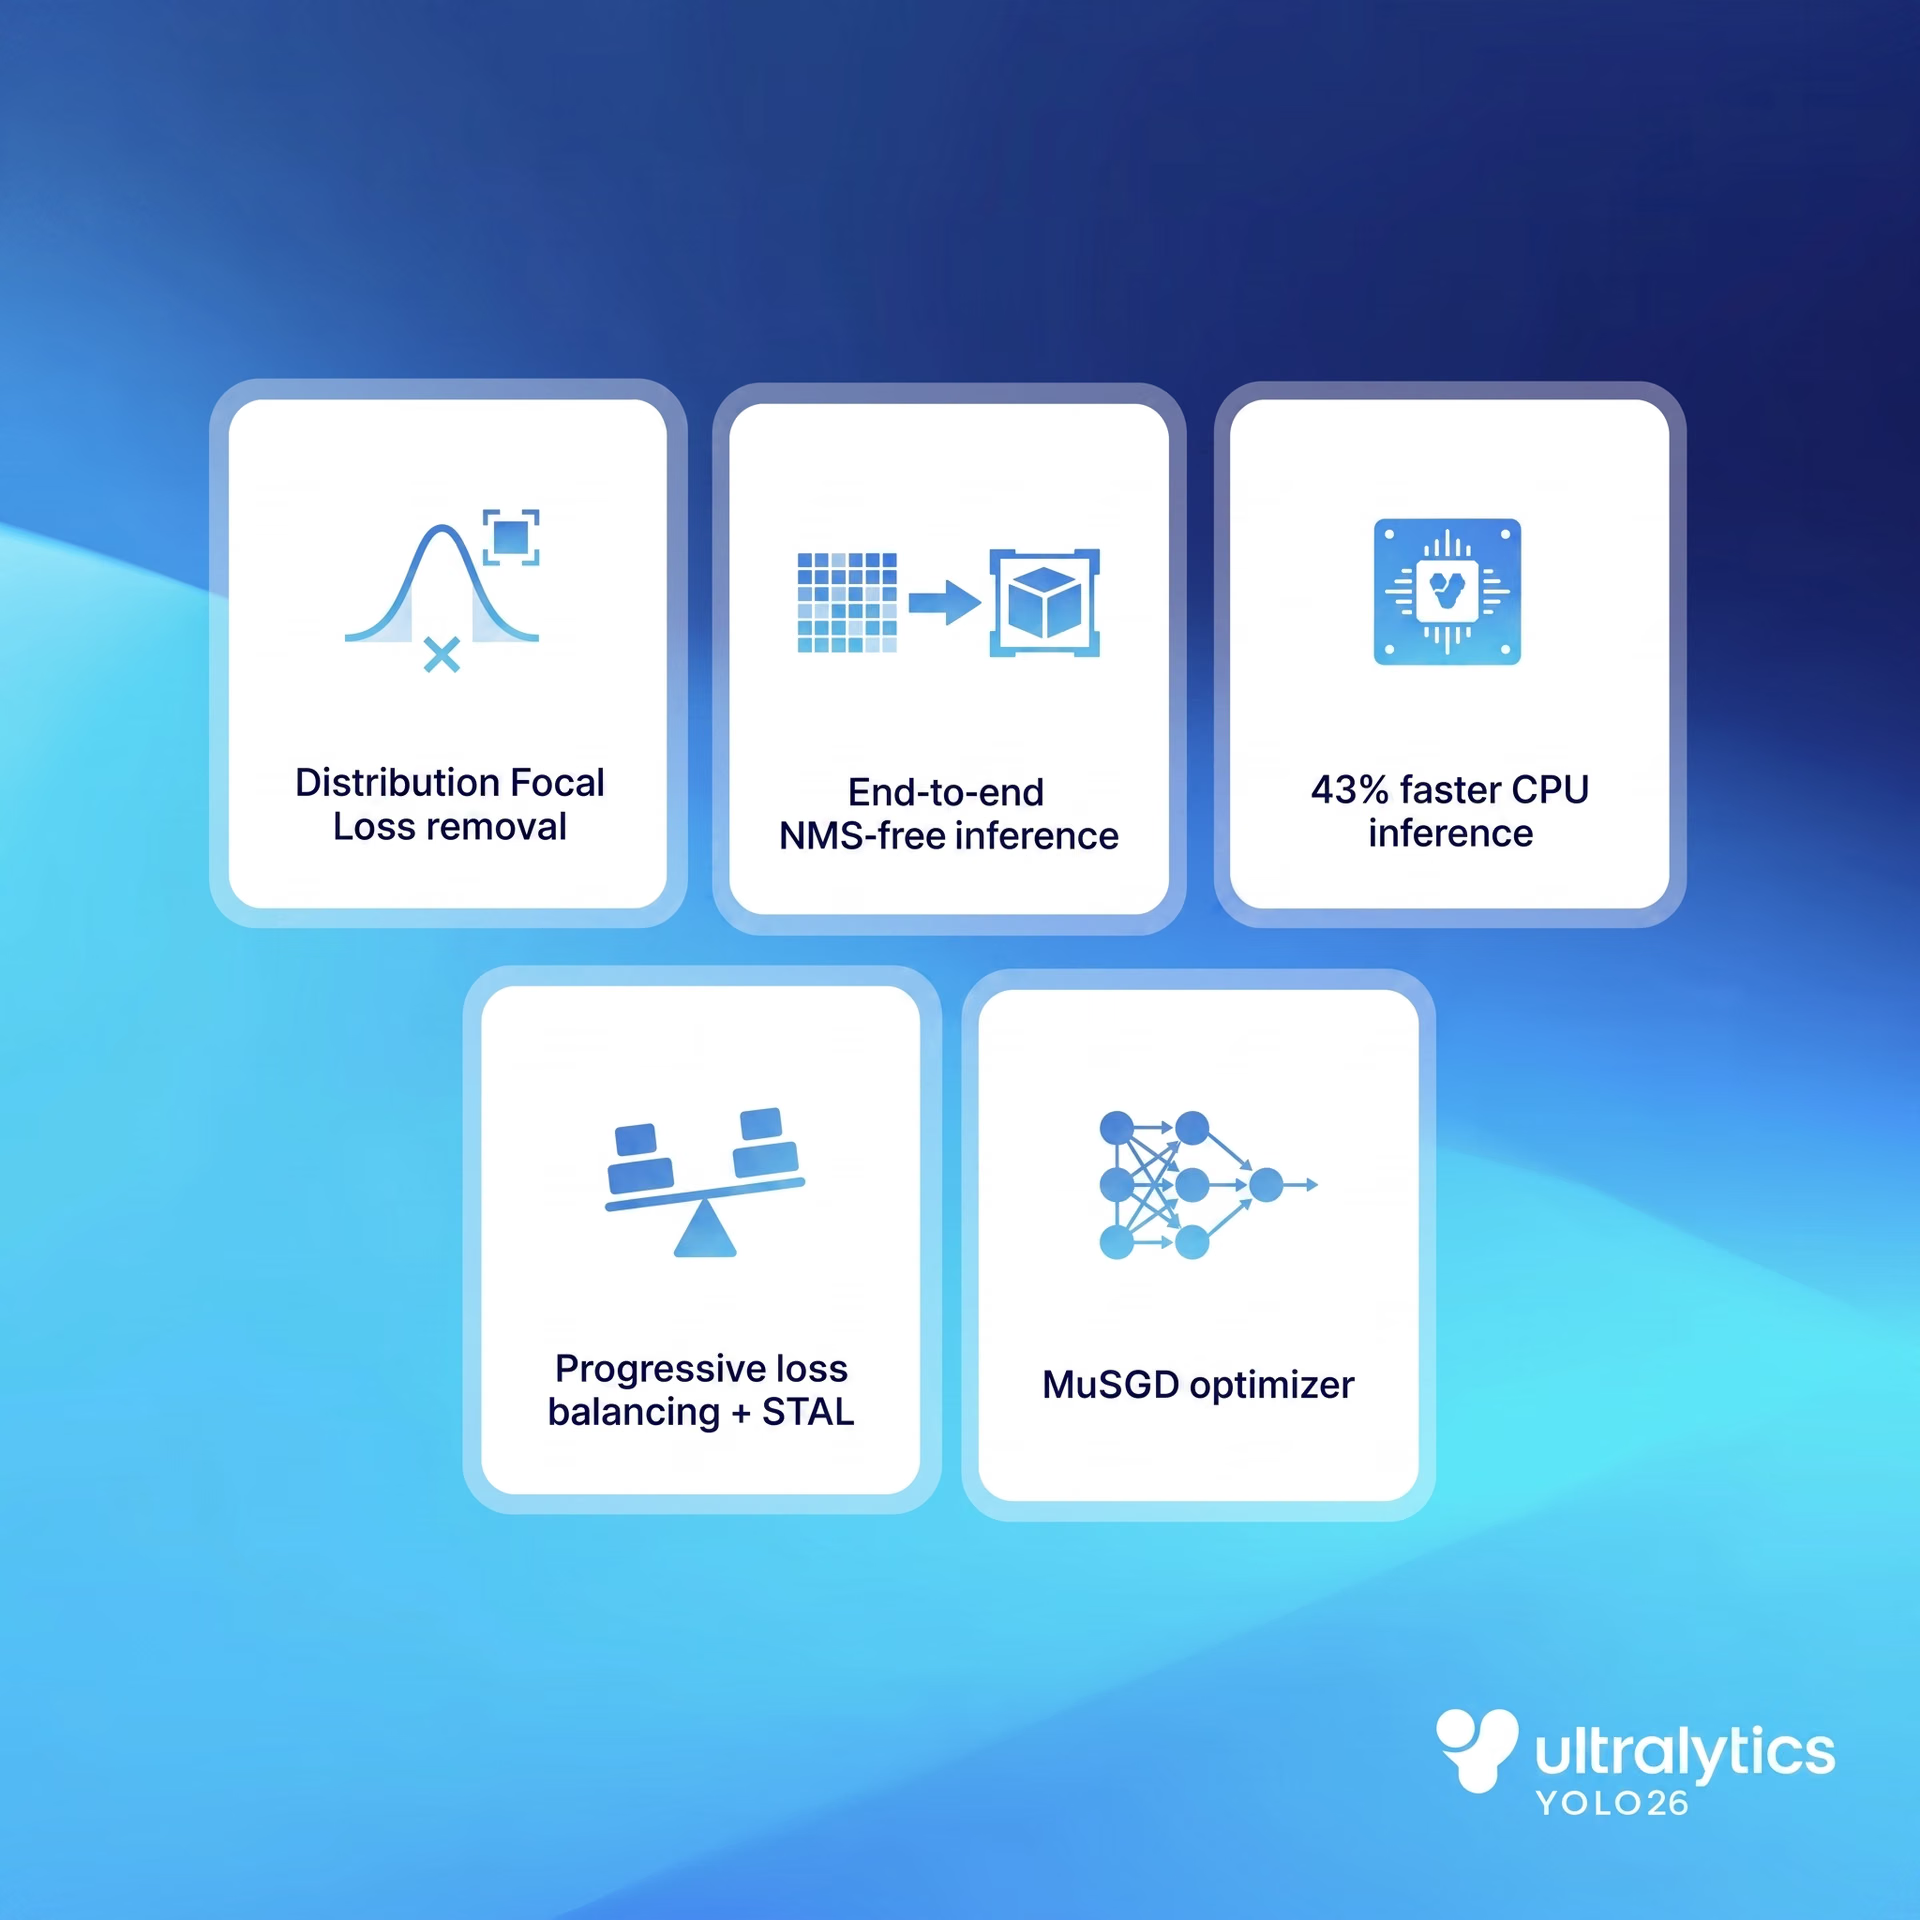
Рис. 4. Основные особенности YOLO26 (Источник)
На практике это значительно упрощает внедрение компьютерного зрения непосредственно там, где оно используется. Обучение моделей становится предсказуемее, масштабирование для разных размеров — стабильнее, а адаптация к новым наборам данных — проще. Это уменьшает разрыв между экспериментами и развёртыванием, особенно в условиях, где надёжность и эффективность не менее важны, чем максимальная производительность.
Например, в робототехнике и промышленных системах технического зрения модели часто приходится переобучать при изменении условий среды, датчиков или задач. С Ultralytics YOLO26 команды могут быстрее выполнять итерации, не беспокоясь о нестабильных запусках обучения или неодинаковом поведении моделей разных размеров.
Главные выводы#
Надёжность систем компьютерного зрения зависит не только от их работы во время инференса, но и от способа обучения моделей. Улучшая балансировку обучающих сигналов, обработку небольших объектов и ход оптимизации, Ultralytics YOLO26 делает обучение стабильнее и упрощает масштабирование. В рецепте обучения YOLO26 описаны настройки официальных контрольных точек. Такой акцент на надёжном обучении помогает командам увереннее переходить от экспериментов к развёртыванию в реальных условиях, особенно в приложениях для периферийных устройств.
Хочешь узнать больше об ИИ? Загляни в наш репозиторий GitHub, чтобы узнать больше. Присоединяйся к нашему активному сообществу и узнай об инновациях в таких сферах, как ИИ в логистике и ИИ для технического зрения в автомобильной промышленности. Чтобы начать работу с компьютерным зрением уже сегодня, ознакомься с нашими вариантами лицензирования.
Автор
Создатель контента · Ultralytics
Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.









