Разбираемся в сегментации объектов по текстовым запросам
Узнай о сегментации объектов по текстовым запросам, ее отличиях от традиционных методов и возможностях моделей, таких как YOLOE-26, для работы с открытым словарем.
 Abirami Vina12 мин. чтения
ИИ для анализа изображений стремительно развивается и широко применяется для анализа изображений и видео в реальных условиях. Например, модели компьютерного зрения интегрируют в самые разные приложения: от систем управления дорожным движением до аналитики в розничной торговле.
Во многих таких приложениях модели компьютерного зрения, например модели обнаружения объектов, обучают распознавать заранее заданный набор объектов, в том числе автомобили, людей и оборудование. Во время обучения моделям показывают множество размеченных примеров, чтобы они научились распознавать внешний вид каждого объекта и отличать его от других объектов в сцене.
В задачах сегментации модели идут дальше и строят точные контуры этих объектов на уровне пикселей. Благодаря этому системы могут точно определять расположение каждого объекта на изображении.
Этот подход хорошо работает, пока системе нужно распознавать только те объекты, на которых она обучалась. Однако в реальных условиях такое случается редко.
Визуальные сцены обычно динамичны. Появляются новые объекты и визуальные понятия, условия меняются, а пользователи часто хотят сегментировать объекты, которых не было в исходных данных для обучения.
Эти ограничения особенно заметны в задачах сегментации. По мере развития ИИ для анализа изображений растет потребность в более гибких моделях сегментации, способных адаптироваться к новым понятиям без постоянного переобучения. Поэтому все больше внимания привлекает сегментация понятий с управлением через запросы (PCS).
Вместо того чтобы полагаться на фиксированный список категорий объектов, пользователи могут описать, что нужно сегментировать, с помощью текста, визуальных подсказок или примеров изображений. Затем такие модели могут находить и сегментировать все области, соответствующие описанному понятию, даже если оно явно не было представлено при обучении.
В этой статье мы расскажем, как работает сегментация понятий с управлением через запросы, чем она отличается от традиционных подходов и где применяется сегодня.
Что такое сегментация понятий с управлением через запросы?#
В большинстве случаев модели сегментации обучают распознавать небольшой список типов объектов. Это хорошо работает, когда системе ИИ для анализа изображений нужно находить и сегментировать только определенный набор объектов.
Однако в реальных приложениях визуальные сцены динамичны. Появляются новые объекты, меняются требования к задачам, и пользователям часто нужно сегментировать понятия, которых не было в исходном наборе меток. Для этого обычно приходится собирать новые высококачественные данные и разметку, а затем переобучать модель, что увеличивает затраты и замедляет развертывание.
Сегментация понятий с управлением через запросы решает эту проблему: вместо выбора из фиксированного списка меток пользователи сообщают модели, что нужно найти. Они описывают нужный объект или идею, а модель выделяет на изображении все соответствующие области. Так намерение пользователя гораздо проще связать с конкретными пикселями изображения.
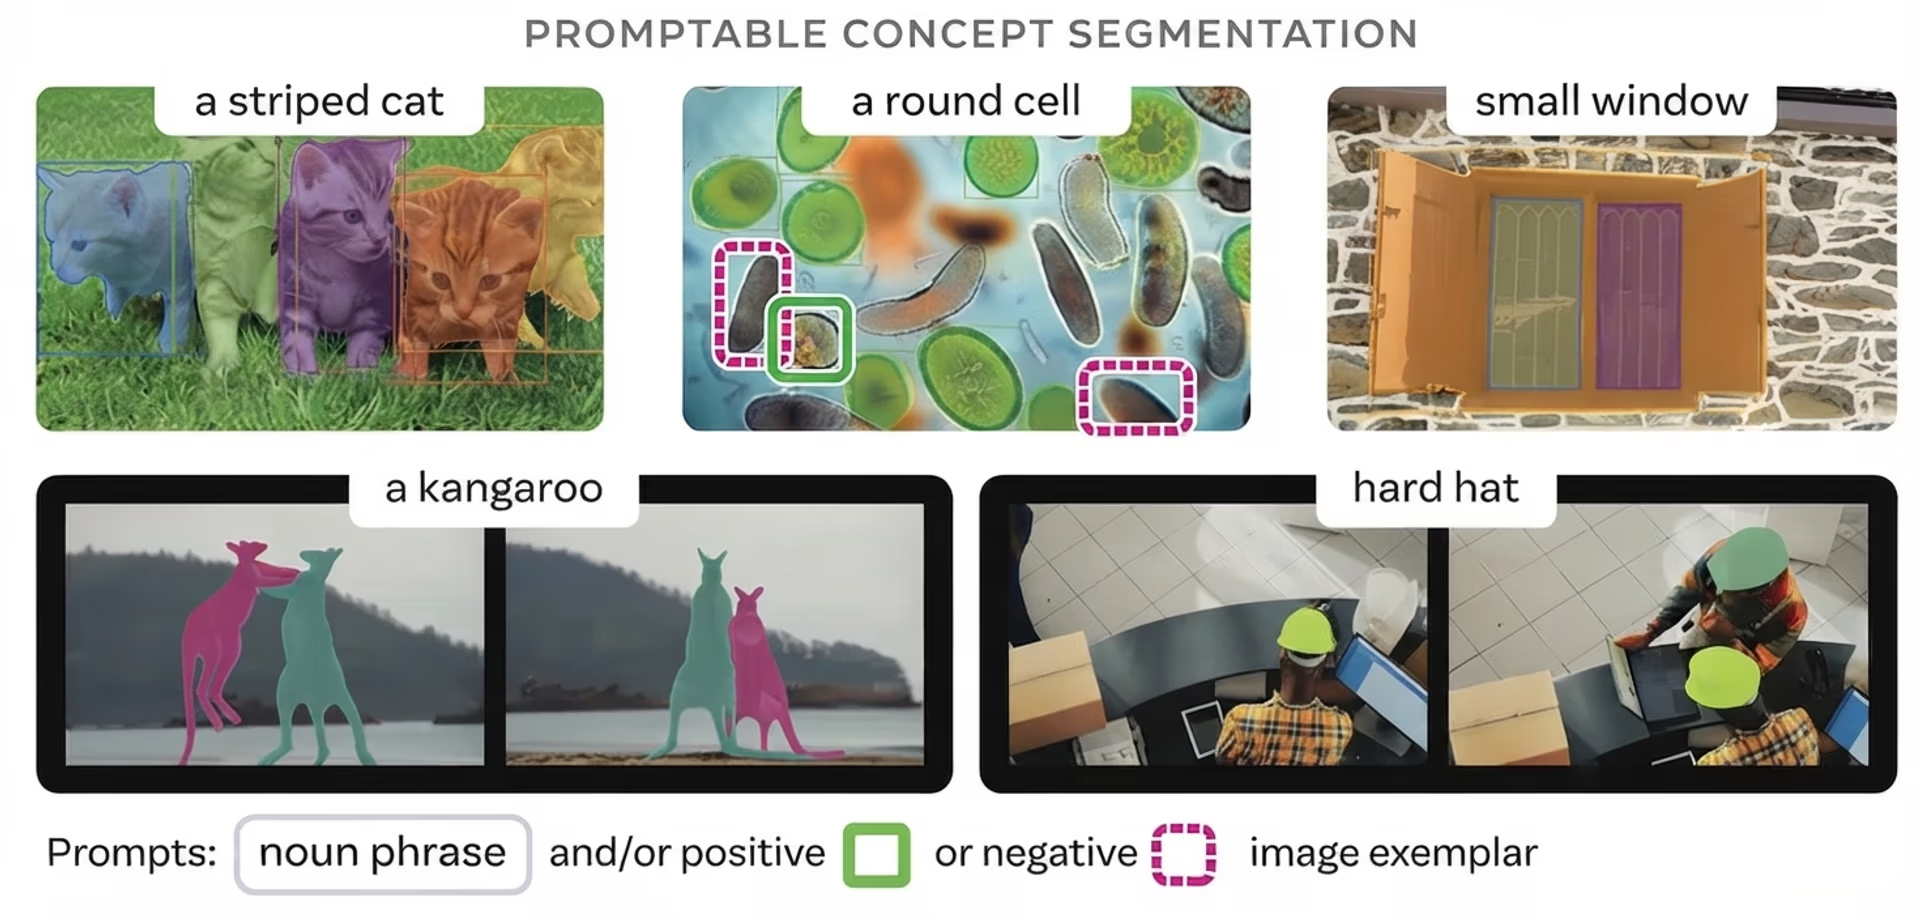
Рис. 1. Пример использования запросов по понятиям для сегментации (Источник)
Управление сегментацией с помощью запросов разных типов#
Модели, поддерживающие сегментацию понятий с управлением через запросы, гибкие, поскольку принимают разные типы входных данных. Иными словами, есть несколько способов указать модели, что искать: например, с помощью текстового описания, визуальной подсказки или примера изображения.
Рассмотрим подробнее каждый подход:
- Текстовые запросы: Для описания понятия, которое нужно сегментировать, можно использовать короткие фразы, например «школьный автобус» или «область опухоли». Модель интерпретирует смысл слов и находит соответствующие области.
- Визуальные запросы: В качестве подсказок используются точки, рамки или приблизительные наброски на изображении. Они указывают, где искать, и помогают сформировать итоговую границу.
- Примеры изображений: Эталонные изображения или небольшие фрагменты представляют интересующее понятие. Модель ищет визуально похожие области и сегментирует их по внешнему виду.
Чем PCS отличается от традиционной сегментации#
Прежде чем разбираться, как работает сегментация понятий с управлением через запросы, сравним ее с различными традиционными методами сегментации объектов.
PCS позволяет создавать модели с открытым словарем и управлением через запросы. Такие модели могут работать с новыми понятиями, описанными в запросах, а традиционная сегментация — нет. Существует несколько типов традиционных подходов к сегментации, и у каждого свои предположения и ограничения.
Кратко рассмотрим несколько основных типов традиционной сегментации:
- Семантическая сегментация: Каждый пиксель изображения относится к категории, например «дорога», «здание» или «человек». Все пиксели с одинаковой меткой объединяются, поэтому модель не разделяет отдельные экземпляры объектов.
- Сегментация экземпляров: Модель обнаруживает и сегментирует отдельные объекты, поэтому два человека или две машины считаются разными объектами.
- Паноптическая сегментация: Этот метод объединяет семантическую сегментацию и сегментацию экземпляров, создавая полное представление сцены с фоновыми областями и отдельными объектами.
Все эти подходы опираются на заранее заданный список категорий объектов. В его рамках они работают хорошо, но с понятиями за пределами этого списка справляются плохо. Чтобы сегментировать новый конкретный объект, обычно требуются дополнительные обучающие данные и тонкая настройка модели.
PCS призвана изменить эту ситуацию. Вместо жесткой привязки к заранее заданным категориям она позволяет описать во время инференса, что именно нужно сегментировать на изображении.
Эволюция моделей PCS#
Далее рассмотрим, как развивались модели сегментации и пришли к сегментации понятий с управлением через запросы.
Популярной фундаментальной моделью, ознаменовавшей новый этап в сегментации, стала SAM, или модель сегментации любых объектов. Ее представили в 2023 году. Вместо того чтобы опираться на заранее заданные категории объектов, SAM позволяла пользователям управлять сегментацией с помощью простых визуальных запросов, например точек или ограничивающих рамок.
С SAM пользователям больше не нужно было выбирать метку. Достаточно было указать местоположение объекта, и модель создавала для него маску. Сегментация стала гибче, но пользователям по-прежнему нужно было показывать модели, где искать.
Выпущенная в 2024 году SAM 2 развила эту идею: модель научилась работать с более сложными сценами, а сегментация с управлением через запросы стала доступна для видео. SAM 2 повысила устойчивость к разным условиям освещения, формам объектов и движениям, по-прежнему в основном опираясь на визуальные запросы для управления сегментацией.
Модель SAM 3 — последний этап этой эволюции. Она вышла в прошлом году и представляет собой унифицированную модель, объединяющую визуальное понимание с языковыми инструкциями. Благодаря этому модель работает согласованно при сегментации изображений и видео.
С помощью SAM 3 пользователям не нужно ограничиваться точечными или нарисованными запросами. Вместо этого они могут описать текстом, что нужно сегментировать, а модель найдёт на изображении или кадрах видео области, соответствующие этому описанию.
Сегментация определяется концептами, а не фиксированными категориями объектов, что позволяет использовать открытый словарь в разных сценах и с течением времени. SAM 3 работает с большим пространством изученных концептов, основанным на онтологии, сформированной по таким источникам, как Wikidata, и расширенным за счёт масштабных обучающих данных.
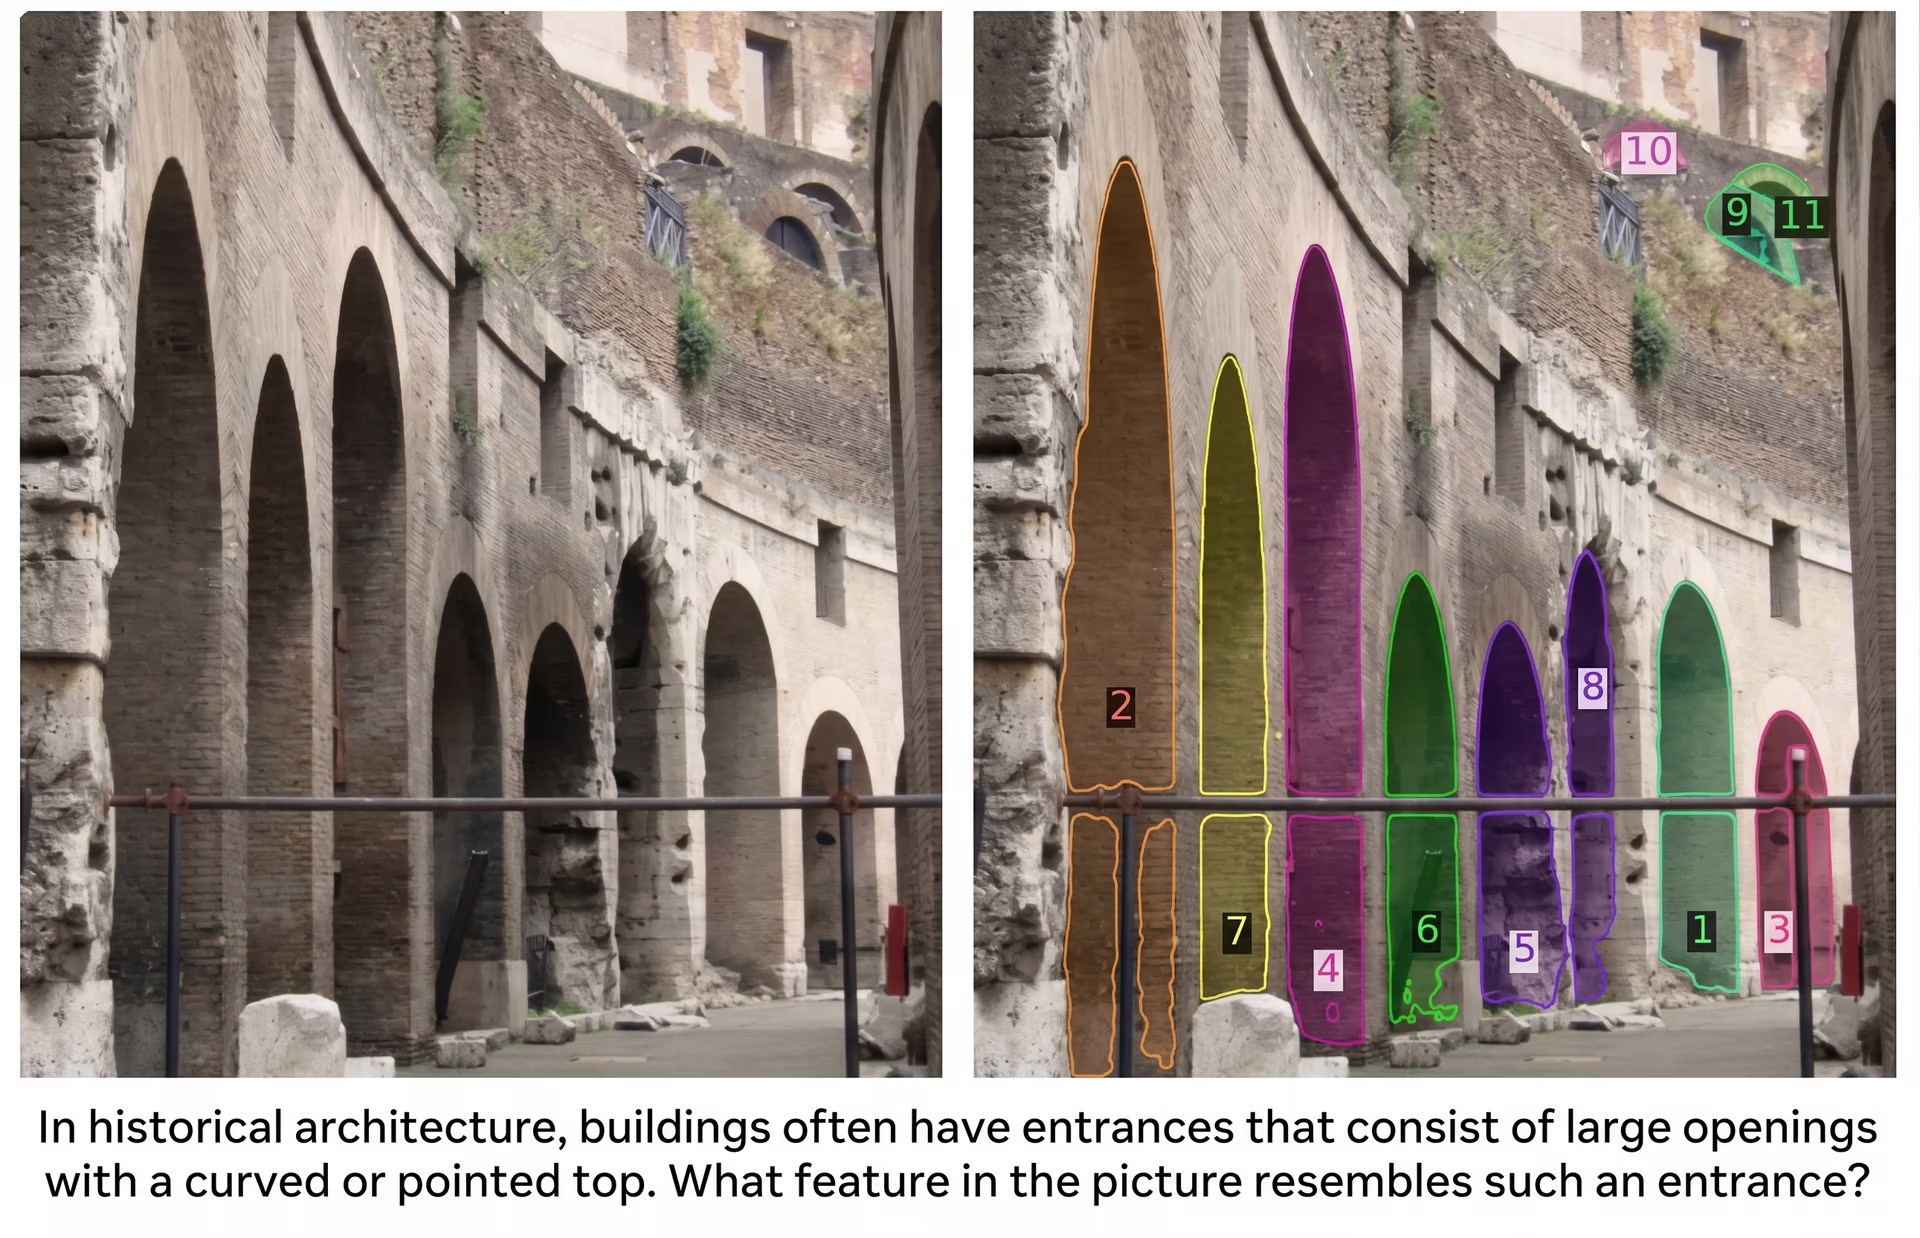
Рис. 2. Пример запроса к SAM 3 и сегментации одного изображения (Источник)
В отличие от предыдущих версий, которые полагались преимущественно на геометрические подсказки, SAM 3 делает шаг к более гибкой сегментации на основе концептов. Благодаря этому он лучше подходит для реальных задач, где интересующие объекты или идеи могут меняться и не всегда могут быть определены заранее.
Как работает сегментация концептов с поддержкой промптов#
Итак, как работает сегментация концептов по запросу? В её основе — предварительно обученные модели компьютерного зрения и визуально-языковые модели, обученные на огромных наборах изображений и во многих случаях связанных с ними текстов. Такое обучение позволяет моделям усваивать общие визуальные закономерности и семантическое значение.
Большинство моделей PCS используют архитектуры на основе Transformer, которые обрабатывают изображение целиком, чтобы понять взаимосвязи между его областями. Визуальный Transformer извлекает из изображения визуальные признаки, а текстовый энкодер преобразует слова в числовые представления, с которыми модель может работать.
Во время обучения модели могут использовать разные типы разметки: маски на уровне пикселей, точно задающие границы объектов, ограничивающие рамки, приблизительно указывающие расположение объектов, и метки на уровне изображения, описывающие, что на нём изображено. Обучение на различных типах размеченных данных помогает модели улавливать и мелкие детали, и более общие визуальные концепты.
Во время инференса, то есть при использовании модели для получения предсказаний, PCS работает по промптам. Пользователь задаёт подсказки в виде текстовых описаний, визуальных ориентиров, например точек или рамок, либо примеров изображений. Модель кодирует и промпт, и изображение в общее внутреннее представление, или эмбеддинги, а затем находит области, соответствующие описанному концепту.
Затем декодер масок преобразует это общее представление в точные маски сегментации на уровне пикселей. Поскольку модель связывает визуальные признаки с семантическим значением, она может сегментировать новые концепты, даже если они явно не встречались при обучении.
Кроме того, часто результат можно уточнить, изменив запрос или добавив дополнительные подсказки, что помогает модели обрабатывать сложные или неоднозначные сцены. Такой итеративный процесс позволяет эффективно оптимизировать модель при развёртывании.
Модели сегментации концептов по запросу обычно оценивают по тому, насколько хорошо они сегментируют ранее невиданные концепты и насколько стабильно работают в разных сценах. Тесты часто учитывают качество масок, способность к обобщению и вычислительную эффективность, отражая требования реального развёртывания.
Практические сценарии применения PCS#
Далее посмотрим, где сегментацию концептов по запросу уже применяют и как она начинает менять практику.
Гибкая сегментация в медицинской визуализации#
Медицинская визуализация охватывает множество биологических структур, заболеваний и типов сканирования, а новые случаи возникают каждый день. Традиционным моделям сегментации трудно справляться с таким разнообразием.
PCS хорошо подходит для этой области, поскольку позволяет клиницистам описывать, что именно нужно найти, вместо выбора из короткого фиксированного списка. С помощью текстовых фраз или визуальных запросов PCS позволяет напрямую сегментировать органы или подозрительные области без переобучения модели для каждой новой задачи. Это упрощает решение разнообразных клинических задач, снижает потребность в ручной отрисовке масок и позволяет работать со многими типами изображений.
Отличный пример — MedSAM-3, адаптирующая архитектуру SAM 3 для PCS в медицинской визуализации с текстовыми запросами. Эту модель можно задавать с помощью конкретных анатомических и патологических терминов, например названий органов — печени или почки — и понятий, связанных с поражениями, таких как опухоль или очаг поражения. Получив запрос, модель напрямую сегментирует соответствующую область на медицинском изображении.
MedSAM-3 также интегрирует мультимодальные большие языковые модели (MLLM или мультимодальные LLM), способные анализировать и текст, и изображения. Эти модели работают в режиме с участием агента: результаты итеративно уточняются, чтобы повысить точность в более сложных случаях.
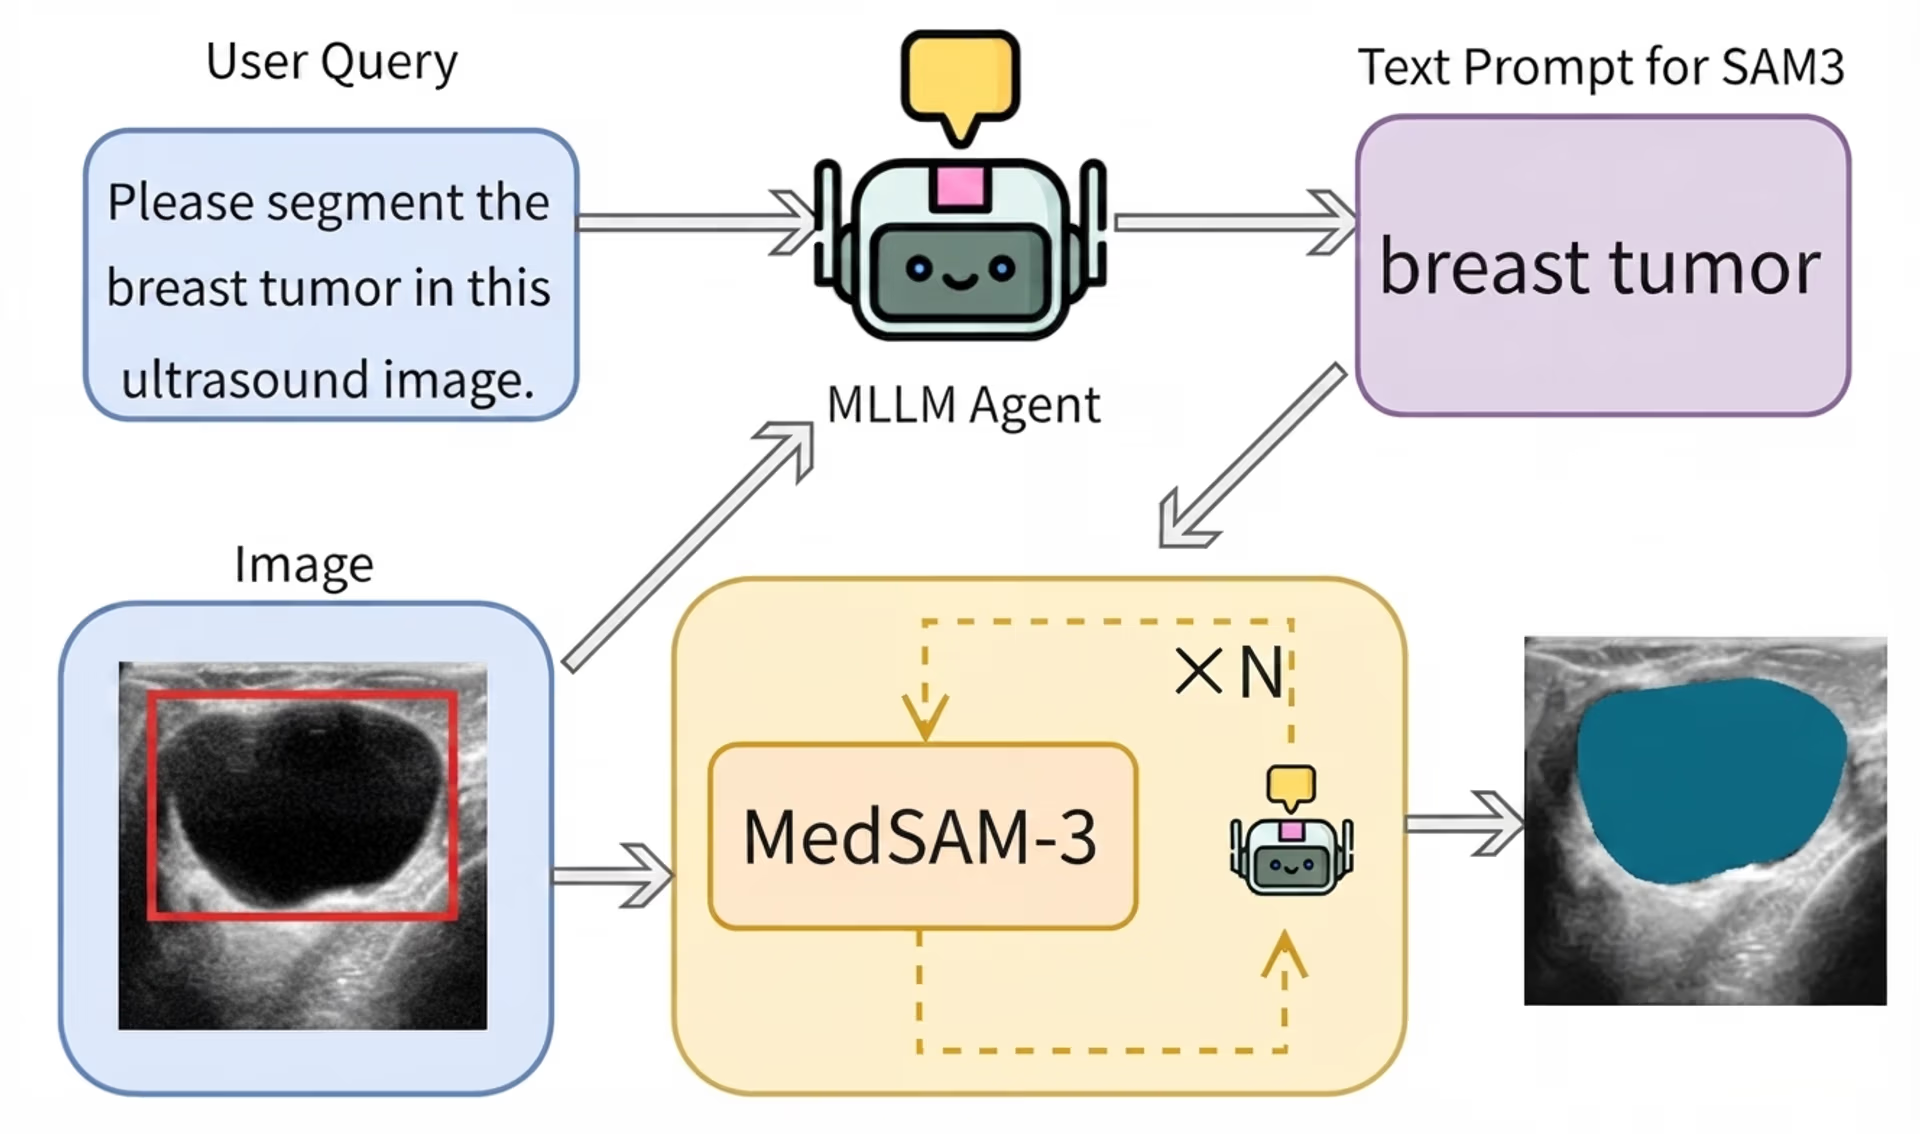
Рис. 3. Конвейер MedSAM-3 для сегментации опухолей на медицинских изображениях по текстовому запросу (Источник)
MedSAM-3 хорошо работает с рентгеновскими снимками, MRI, CT, ультразвуковыми и видеоданными, показывая, как PCS помогает сделать рабочие процессы медицинской визуализации более гибкими и эффективными в реальных клинических условиях.
Адаптивная сегментация для роботизированной хирургии и автоматизации#
Роботизированная хирургия опирается на системы компьютерного зрения для отслеживания инструментов и понимания быстро меняющейся операционной обстановки. Инструменты быстро перемещаются, освещение меняется, а новые инструменты могут появиться в любой момент, поэтому поддерживать заранее заданные системы меток сложно.
С помощью PCS роботы могут отслеживать инструменты, направлять камеры и в реальном времени следовать этапам операции. Это сокращает объём ручной разметки и упрощает адаптацию систем к разным процедурам. Хирурги или автоматизированные системы могут использовать текстовые запросы, например «зажим», «скальпель» или «инструмент камеры», чтобы указать, что нужно сегментировать на изображении.
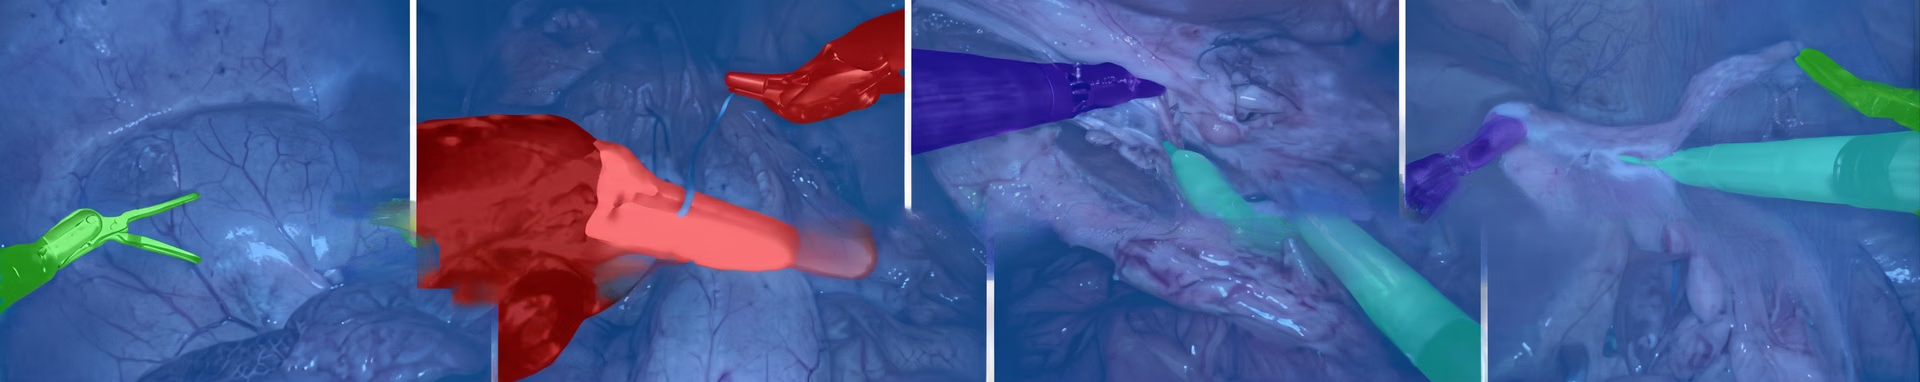
Рис. 4. Сегментация хирургических инструментов, используемых во время роботизированной операции (Источник)
Сегментация с открытым словарём с помощью Ultralytics YOLOE-26#
Ещё одна интересная передовая модель, связанная с сегментацией концептов с поддержкой промптов, — Ultralytics YOLOE-26. Она добавляет сегментацию с открытым словарём и управлением через промпты в семейство моделей Ultralytics YOLO.
YOLOE-26 построена на архитектуре Ultralytics YOLO26 и поддерживает сегментацию экземпляров с открытым словарём. YOLOE-26 позволяет задавать сегментацию несколькими способами.
Модель поддерживает текстовые запросы, в которых краткие фразы, связанные с визуальным содержимым, задают целевой объект, а также визуальные запросы, предоставляющие дополнительные указания на основе изображения. Кроме того, в YOLOE-26 есть режим без запросов для zero-shot-инференса: модель обнаруживает и сегментирует объекты из встроенного словаря без запросов пользователя.
YOLOE-26 отлично подходит для видеоаналитики, робототехнического восприятия и периферийных систем, где категории объектов могут меняться, но низкая задержка и стабильная пропускная способность остаются необходимыми. Модель также особенно полезна для разметки данных и подготовки наборов данных: она упрощает рабочие процессы, автоматизируя часть процесса аннотирования.
Преимущества и недостатки сегментации концептов по запросу#
Вот некоторые основные преимущества сегментации концептов по запросу:
- Быстрые итерации и прототипирование: новые задачи сегментации можно быстро проверять, меняя запросы, а не перестраивая наборы данных или переобучая модели. Это ускоряет эксперименты и разработку.
- Адаптация к разным областям: одну и ту же модель PCS часто можно применять в разных областях, например в медицинской визуализации, робототехнике или видеоаналитике, почти не меняя рабочий процесс.
- Интерактивное уточнение: пользователи могут итеративно менять запросы или добавлять подсказки, чтобы улучшать результаты. Это упрощает обработку неоднозначных сцен и крайних случаев без переобучения.
Несмотря на очевидные преимущества PCS, стоит учитывать и некоторые ограничения:
- Чувствительность к формулировке запроса: небольшие изменения в формулировке или способе подачи запроса могут повлиять на результат. Слишком расплывчатые или слишком конкретные запросы могут привести к неполной или неверной сегментации.
- Менее предсказуемое поведение: поскольку модель интерпретирует запросы, а не выбирает из фиксированного набора меток, результаты могут сильнее различаться в зависимости от сцены и входных данных, что может стать проблемой для строго контролируемых конвейеров.
- Неоднозначная интерпретация концептов: некоторые концепты субъективны или определены расплывчато, что может приводить к несогласованным результатам сегментации у разных пользователей или на разных изображениях.
- Низкая надёжность для очень конкретных целей: модели на основе запросов обычно менее надёжны в узкоспециализированных задачах, связанных с конкретными экземплярами, например при обнаружении дефектов, где требуется точно и стабильно выявлять малозаметные признаки.
Как выбрать между сегментацией по запросу и традиционной сегментацией#
Изучая сегментацию по запросу, ты можешь задуматься, для каких задач она подходит лучше всего и когда традиционная модель компьютерного зрения, например Ultralytics YOLO26, лучше решит твою задачу. Сегментация по запросу хорошо работает с обычными объектами, но не подходит для задач, где нужны очень точные и стабильные результаты.
Обнаружение дефектов — хороший пример. На производстве дефекты часто бывают крошечными и малозаметными: это могут быть небольшие царапины, вмятины, смещения или неровности поверхности. Кроме того, их вид сильно зависит от материалов, освещения и условий производства.
Такие особенности трудно описать простым запросом, а универсальной модели ещё сложнее надёжно их обнаружить. В целом модели на основе запросов часто пропускают дефекты или дают нестабильные результаты, тогда как модели, обученные специально на данных о дефектах, гораздо надёжнее подходят для реальных систем контроля.
Главные выводы#
Сегментация концептов по запросу упрощает адаптацию систем компьютерного зрения к реальному миру, где постоянно появляются новые объекты и идеи. Вместо ограниченного набора фиксированных меток пользователям достаточно описать, что нужно сегментировать, а остальное модель сделает сама. Это экономит время и сокращает объём ручной работы. Несмотря на существующие ограничения, PCS уже меняет практическое применение сегментации и, вероятно, станет ключевой частью будущих систем компьютерного зрения.
Узнай больше об ИИ: загляни в наш репозиторий GitHub и присоединяйся к нашему сообществу. Посети страницы наших решений, чтобы узнать об ИИ в робототехнике и компьютерном зрении в производстве. Ознакомься с вариантами лицензирования, чтобы уже сегодня начать работать с ИИ для компьютерного зрения!
Автор
Создатель контента · Ultralytics
Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.









