Veri kümesi damıtma nedir? Kısa bir genel bakış
Veri kümesi damıtmanın büyük veri kümelerini küçük, optimize edilmiş sentetik örnek kümeleriyle değiştirerek model eğitimini nasıl hızlandırdığını ve hesaplama maliyetlerini nasıl düşürdüğünü öğren.
 Abirami Vina13 dakikalık okuma
Model eğitimi, bir veri bilimcisinin işinin en çok zaman alan kısmı gibi görünebilir. Ancak zamanlarının büyük bölümü, genellikle %60 ila %80'i, aslında verileri hazırlamaya gider: verileri toplamak, temizlemek ve modelleme için düzenlemek. Veri kümeleri büyüdükçe hazırlık süresi de uzar; bu da deneyleri yavaşlatır ve yineleme yapmayı zorlaştırır.
Bu sorunu çözmek için araştırmacılar, eğitimi kolaylaştırmanın yollarını yıllardır arıyor. Sentetik veriler, veri kümesi sıkıştırma ve daha iyi optimizasyon yöntemleri gibi yaklaşımların tümü, büyük ölçekli veri kümeleriyle çalışmanın maliyetini ve zorluğunu azaltmayı ve makine öğrenimi iş akışlarını hızlandırmayı amaçlıyor.
Bunun ortaya çıkardığı temel sorulardan biri, bir veri kümesini ciddi ölçüde küçültürken modelin tüm verilerle eğitilmesiyle aynı performansı elde edip edemeyeceğimiz. Veri kümesi damıtma, umut vadeden yanıtlardan biri.
Bu yöntem, modelin etkili biçimde öğrenmesi için gereken temel örüntüleri korurken büyük bir eğitim veri kümesinin kompakt bir sürümünü oluşturur. Daha hızlı eğitim, daha düşük hesaplama gereksinimleri ve daha verimli deneyler için bir yol sunar. Bunu, tam veri kümesindeki temel örüntüleri öğretmek üzere tasarlanmış küçük bir sentetik veri örnekleri kümesi olarak, model için hazırlanmış bir çalışma özeti gibi düşünebilirsin.
Bu yazıda, veri kümesi damıtmanın nasıl çalıştığını ve gerçek dünya uygulamalarında ölçeklenebilir makine öğrenimini ve derin öğrenimi nasıl desteklediğini inceleyeceğiz.
Veri kümesi damıtmayı anlama#
Veri kümesi damıtma, büyük bir eğitim veri kümesinin, modele orijinal veri kümesiyle neredeyse aynı bilgileri öğreten çok daha küçük bir veri kümesine dönüştürüldüğü bir süreçtir. Amaç, tüm veri kümesinde görülen temel örüntüleri yakalamak olduğu için birçok araştırmacı bu sürece veri kümesi yoğunlaştırma da der.
Damıtılmış veri kümesi, rastgele oluşturulmuş sentetik verilerden veya gerçek görüntülerden daha küçük bir alt kümeyi seçmekten farklıdır. Rastgele oluşturulmuş sahte bir veri kümesi ya da orijinalin kırpılmış bir kopyası değildir.
Bunun yerine, en önemli örüntüleri yakalamak üzere bilinçli olarak optimize edilir. Bu süreçte her piksel ve özellik ayarlanıp optimize edilir; böylece damıtılmış verilerle eğitilen bir sinir ağı, tüm veri kümesiyle eğitilmiş gibi öğrenir.
Bu fikir ilk kez 2018'de Tongzhou Wang, Jun-Yan Zhu, Antonio Torralba ve Alexei A. Efros tarafından yayımlanan bir arXiv makalesinde ortaya çıktı. İlk testlerde MNIST ve CIFAR-10 gibi basit veri kümeleri kullanıldı; bu sayede birkaç damıtılmış örneğin binlerce gerçek görüntünün yerini alabildiğini göstermek kolaylaştı.
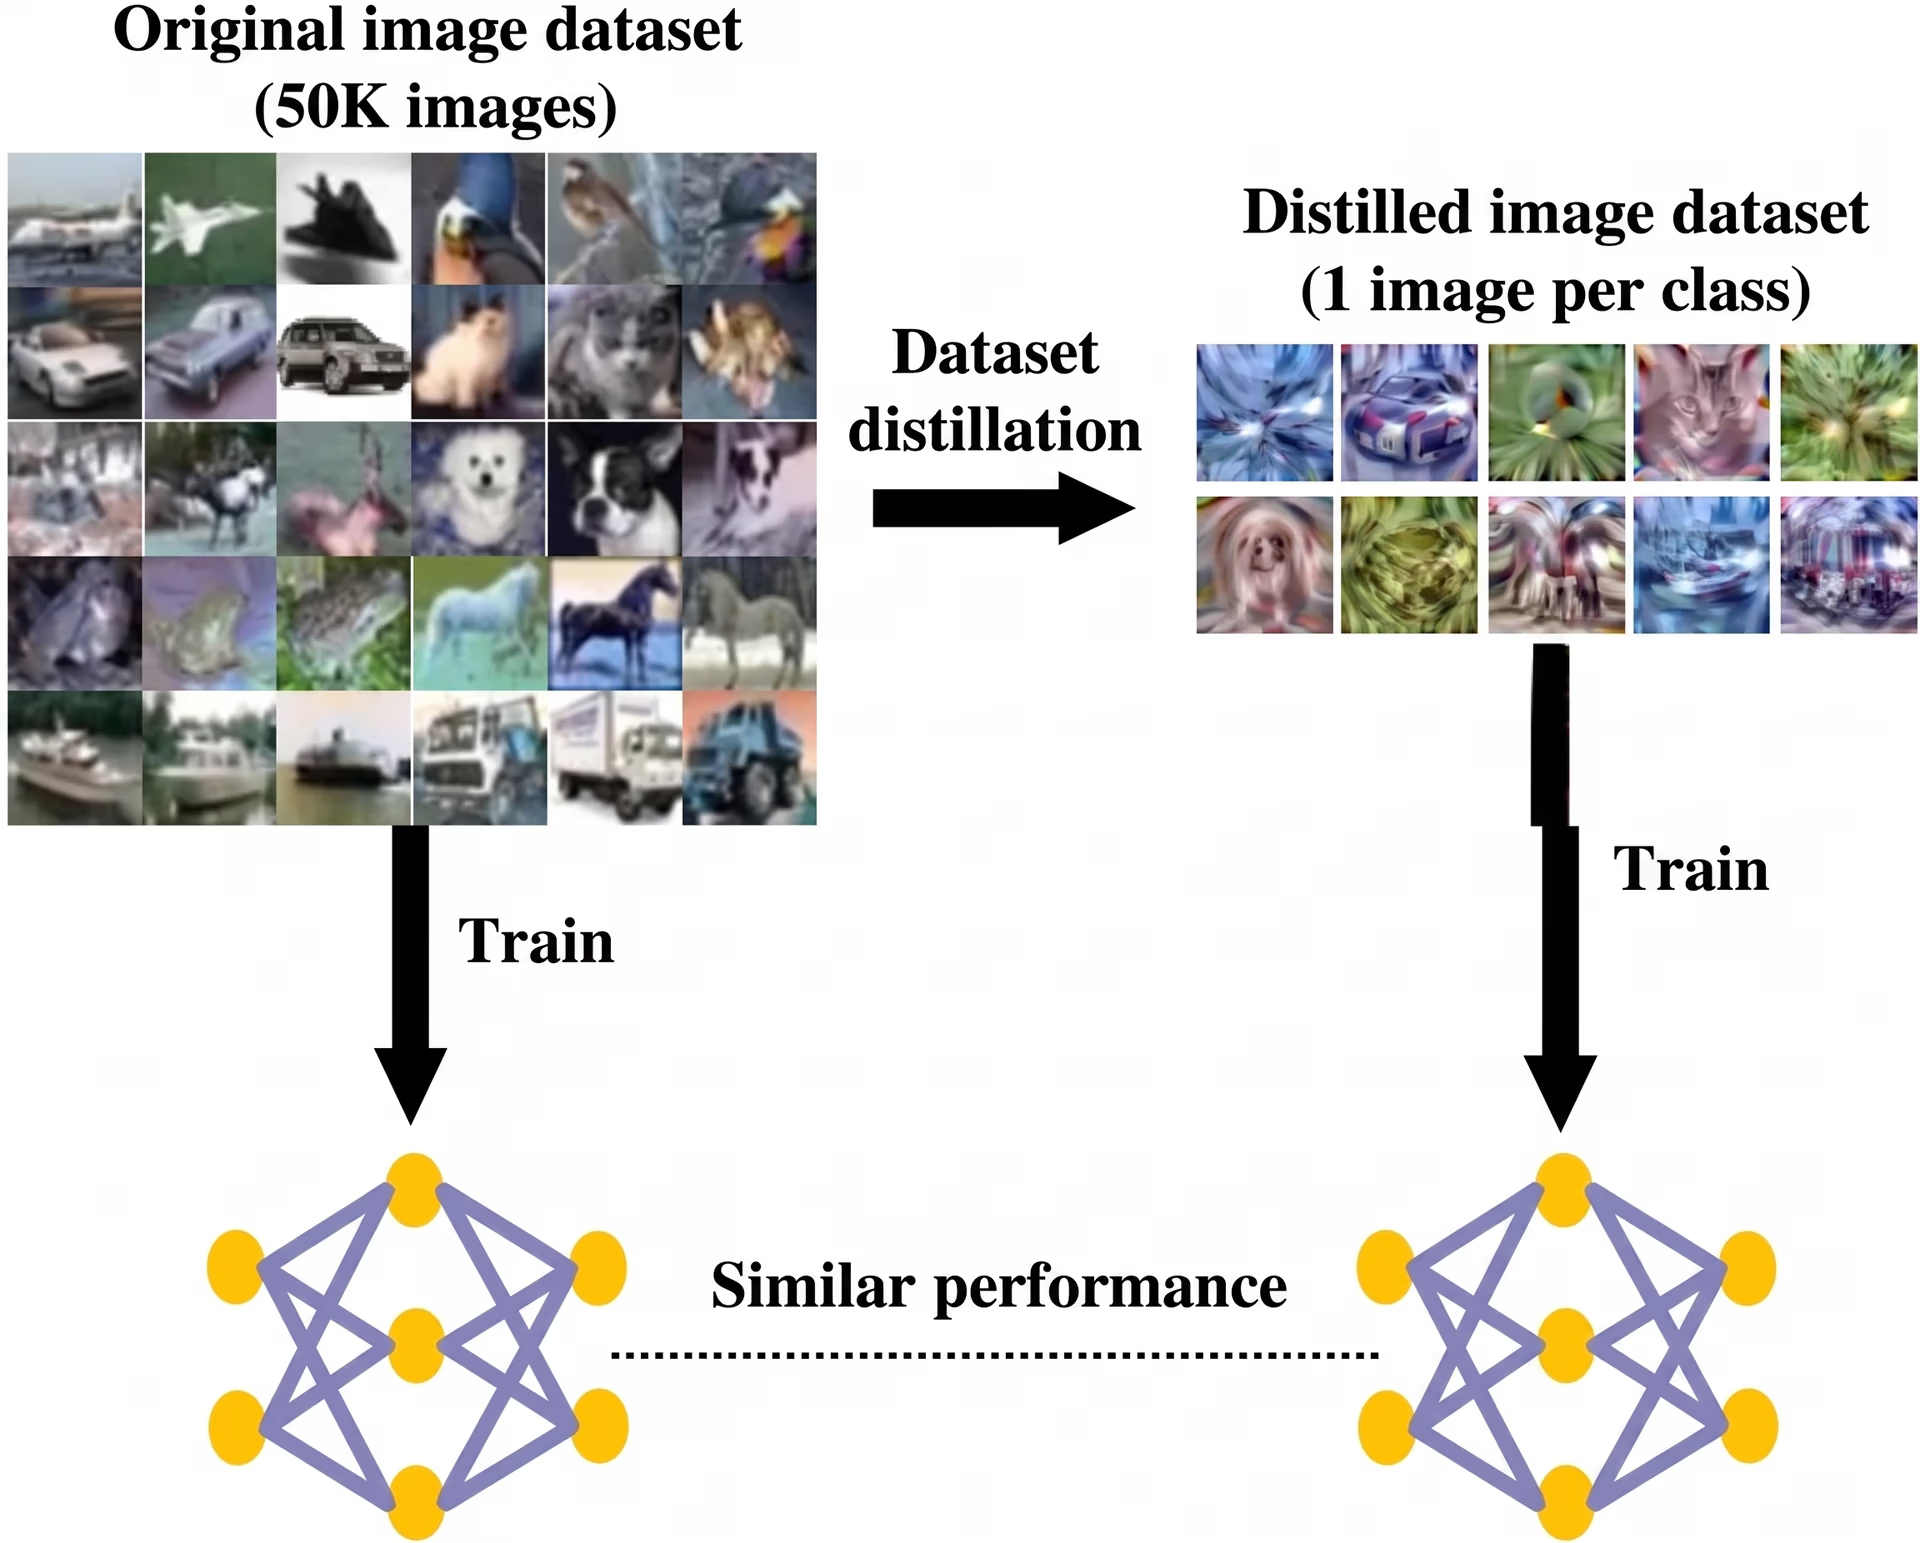
Şekil 1. Görüntü verileri için veri kümesi damıtma kullanımı (Kaynak)
O tarihten bu yana ICML ve ICLR'da yayımlanan yöntemler de dâhil olmak üzere sonraki çalışmalar, yoğunlaştırmayı daha verimli ve ölçeklenebilir hâle getirerek veri kümesi damıtma yöntemlerini daha ileriye taşıdı.
Veri kümesi damıtmanın önemi#
Veri kümesi damıtma, eğitim verimliliğini artırır ve geliştirme döngülerini hızlandırır. Bir modelin öğrenmesi gereken veri miktarını azaltarak hesaplama gereksinimlerini düşürür.
Bu yaklaşım, modellerin zaman içinde güncellendiği sürekli öğrenme, çok sayıda model tasarımının denendiği sinir ağı mimarisi araması ve modellerin bellek ve güç kaynakları kısıtlı küçük cihazlarda çalıştığı uçta eğitim için özellikle kullanışlıdır. Genel olarak bu avantajlar, veri kümesi damıtmayı birçok makine öğrenimi iş akışında hızlı başlangıç, çabuk ince ayar ve erken prototipler oluşturmak için harika bir seçenek hâline getirir.
Veri kümesi damıtmanın nasıl çalıştığına genel bakış#
Veri kümesi damıtma, sentetik veya yapay olarak oluşturulmuş eğitim örnekleri üretir. Bu örnekler, modelin gerçek veriler üzerinde eğitilmesine çok benzeyen bir şekilde öğrenmesine yardımcı olur. Yöntem, normal eğitim sırasında üç temel etkeni izleyerek çalışır.
İlki, modelin tahminlerinin ne kadar hatalı olduğunu gösteren hata puanı olan kayıp fonksiyonudur. İkincisi, model parametreleridir; bunlar, model öğrenirken güncellenen ağın dahili ağırlıklarıdır.
Üçüncüsü ise hata ve ağırlıkların zaman içinde adım adım nasıl değiştiğini açıklayan eğitim yörüngesidir. Ardından sentetik örnekler, model bunlarla eğitildiğinde hatası düşecek ve ağırlıkları tam veri kümesiyle eğitimdekiyle aynı biçimde güncellenecek şekilde optimize edilir.
Veri kümesi damıtma sürecine adım adım bakış#
Veri kümesi damıtma sürecinin nasıl işlediğine daha yakından bakalım:
- 1. Adım - Sentetik pikselleri başlatma: Süreç, öğrenilebilir girdiler işlevi gören sentetik görüntülerle başlar. Başlangıçta bu görüntüler çok az yapısal özellik taşır ve boş sayfalar gibi görünür. Zamanla bilgilendirici örneklere dönüştürülecek şekilde optimize edilirler.
- 2. Adım - Gradyan eşleştirme ve geri yayılımla optimizasyon: Model bu sentetik görüntüler üzerinde eğitilirken gerçek verilerin eğitim davranışına daha iyi uyum sağlamak için her pikselin nasıl değişmesi gerektiğini gösteren gradyanlar üretir. Geri yayılım, ağın hatalardan öğrenmek için kullandığı yöntemdir. Hataya hangi piksellerin ve ağırlıkların yol açtığını belirlemek için hatayı model boyunca geriye doğru iletir, ardından bunları küçük miktarlarda günceller. Geri yayılım, bu gradyanları kullanarak sentetik görüntüleri adım adım ayarlar ve eğitim için daha bilgilendirici hâle getirir.
- 3. Adım - Eğitim adımlarındaki davranışı eşleştirme: Yöntem, modelin öğrenirken geçirdiği adım adım değişiklikler anlamına gelen eğitim yörüngelerini de eşleştirir. Böylece damıtılmış veri kümesinin, modele tam veri kümesiyle izlenecek öğrenme yoluna benzer bir yol göstermesi sağlanır.
- 4. Adım - Doğrulama ve genelleme: Son olarak, eğitilen modelin yeni örneklerde ne kadar iyi performans gösterdiğini görmek için damıtılmış veri kümesi gerçek doğrulama verileri üzerinde değerlendirilir. Bu işlem, sentetik verilerin modele belirli örnekleri ezberletmek yerine genel ve işlevsel örüntüleri öğrettiğini doğrular.
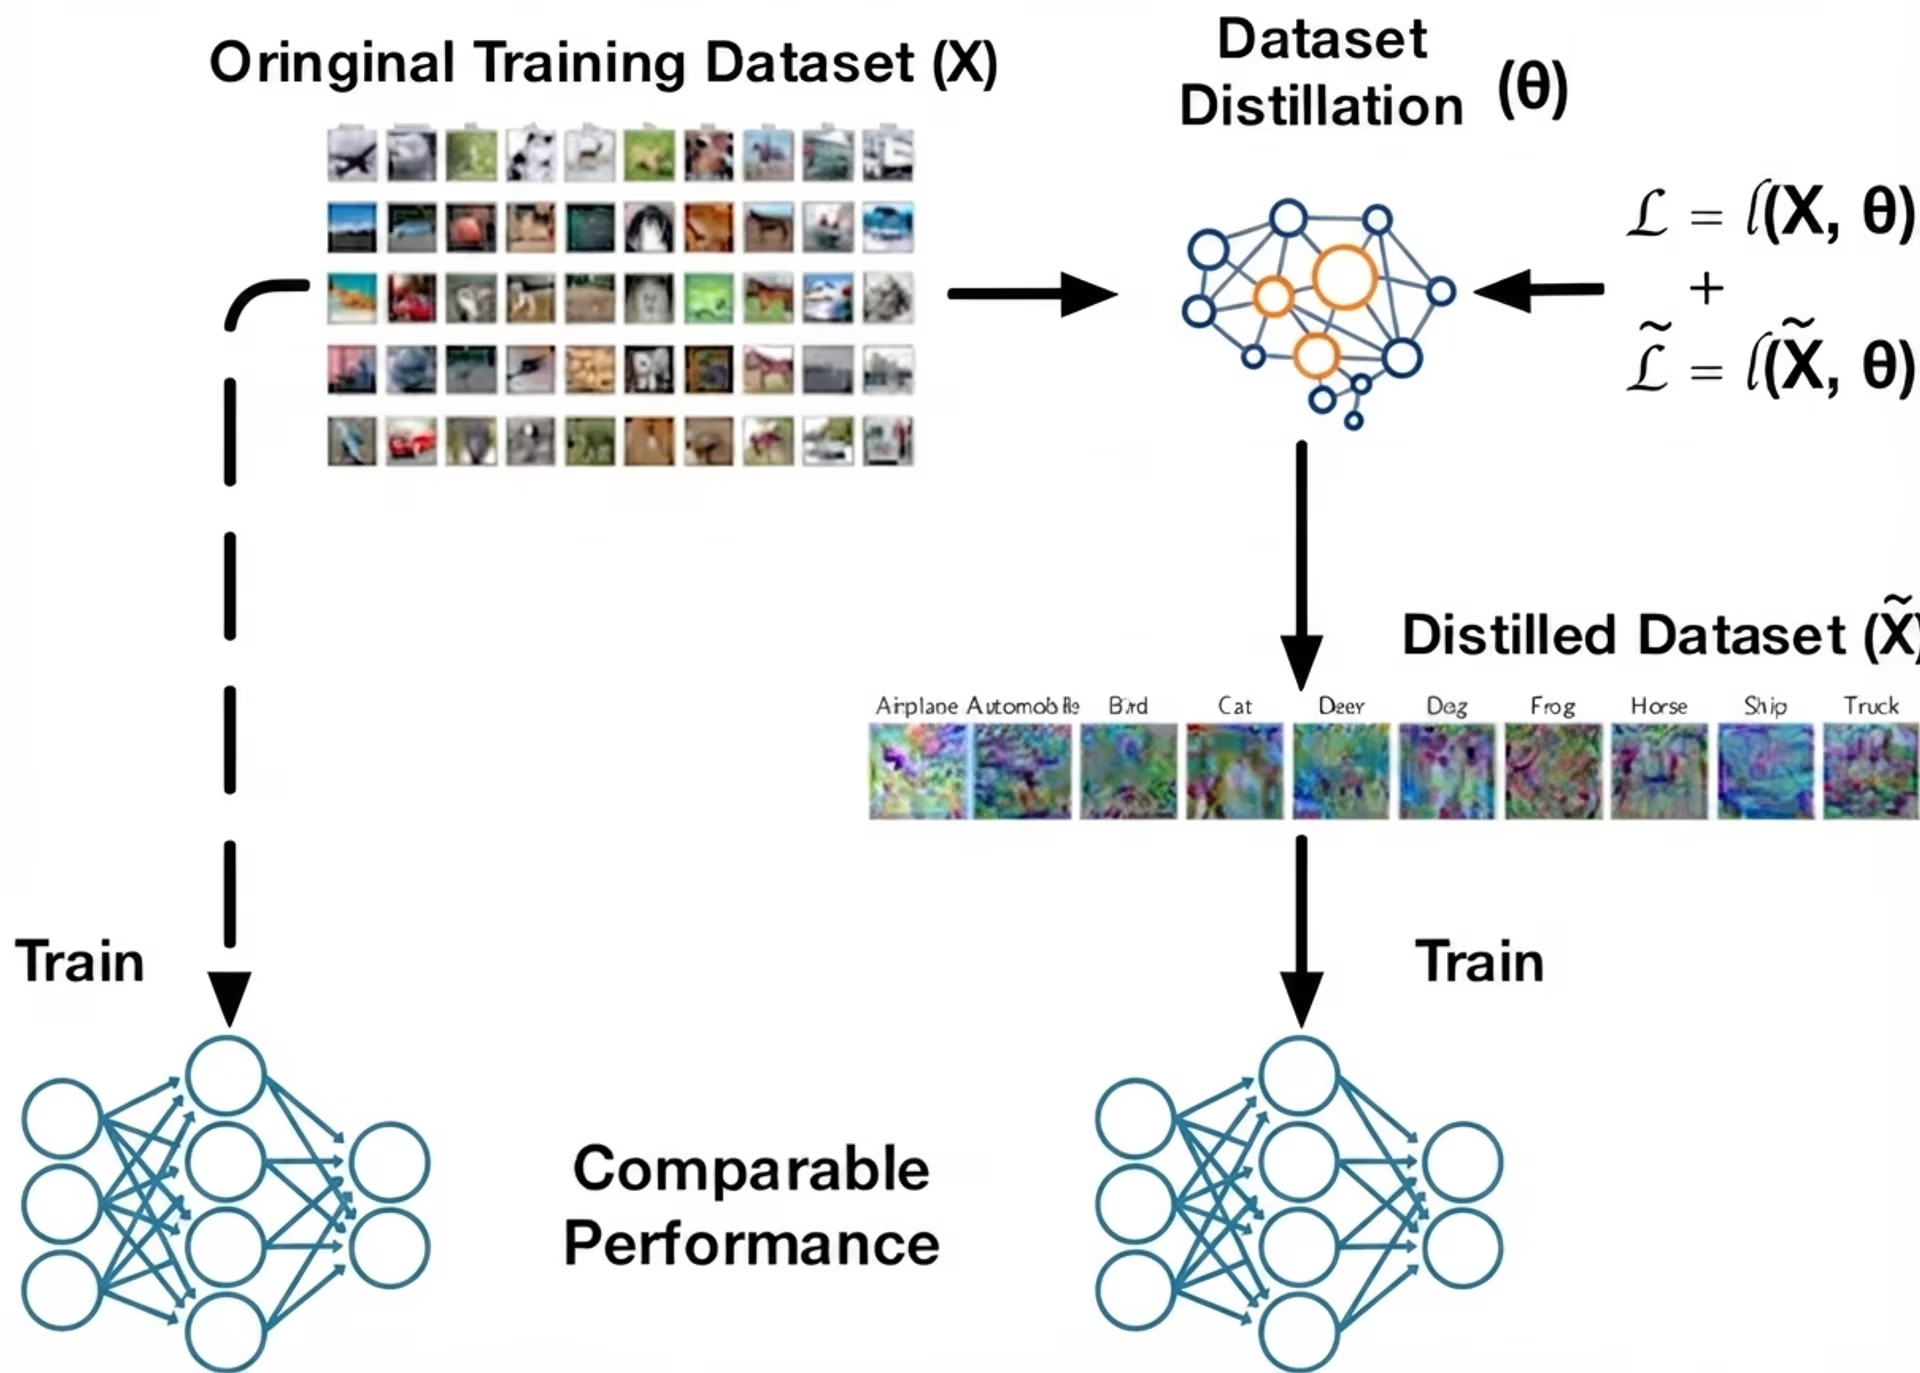
Şekil 2. Veri kümesi damıtma sürecine bakış (Kaynak)
Temel veri kümesi damıtma yöntemleri#
Veri kümesi damıtma yöntemlerinin tümü, farklı algoritmalar kullansalar bile aynı temel fikre dayanır. Yaklaşımların çoğu üç kategoriye ayrılır: performans eşleştirme, dağılım eşleştirme ve parametre eşleştirme.
Şimdi her birine göz atalım ve nasıl çalıştıklarını görelim.
Performans eşleştirme#
Veri kümesi damıtmada performans eşleştirme, modelin tam ve orijinal veri kümesiyle eğitilmiş gibi neredeyse aynı doğruluğa ulaşmasını sağlayan küçük ve optimize edilmiş bir eğitim kümesi oluşturmaya odaklanır. Damıtılmış örnekler rastgele bir alt kümeden seçilmek yerine, bunlarla eğitilen modelin tahminlerinin, eğitim sırasındaki kayıp davranışının veya nihai doğruluğunun orijinal veri kümesiyle eğitilen bir modelinkine benzemesi için optimize edilir.
Meta öğrenme, bu süreci iyileştirmek için kullanılan yaygın bir yöntemdir. Damıtılmış veri kümesi, tekrarlanan eğitim oturumları boyunca güncellenir ve böylece olası birçok durumda etkili hâle gelir.
Bu oturumlar sırasında yöntem, öğrenci modelin mevcut damıtılmış örneklerden nasıl öğrendiğini simüle eder, öğrencinin gerçek veriler üzerindeki performansını denetler ve ardından damıtılmış örnekleri daha iyi öğretmenler olacak şekilde ayarlar. Zaman içinde damıtılmış küme, öğrenci modeli farklı başlangıç ağırlıklarından başlasa veya farklı bir mimari kullansa bile hızlı öğrenmeyi ve güçlü genellemeyi desteklemeyi öğrenir. Böylece damıtılmış veri kümesi daha güvenilir olur ve tek bir eğitim çalışmasına bağlı kalmaz.
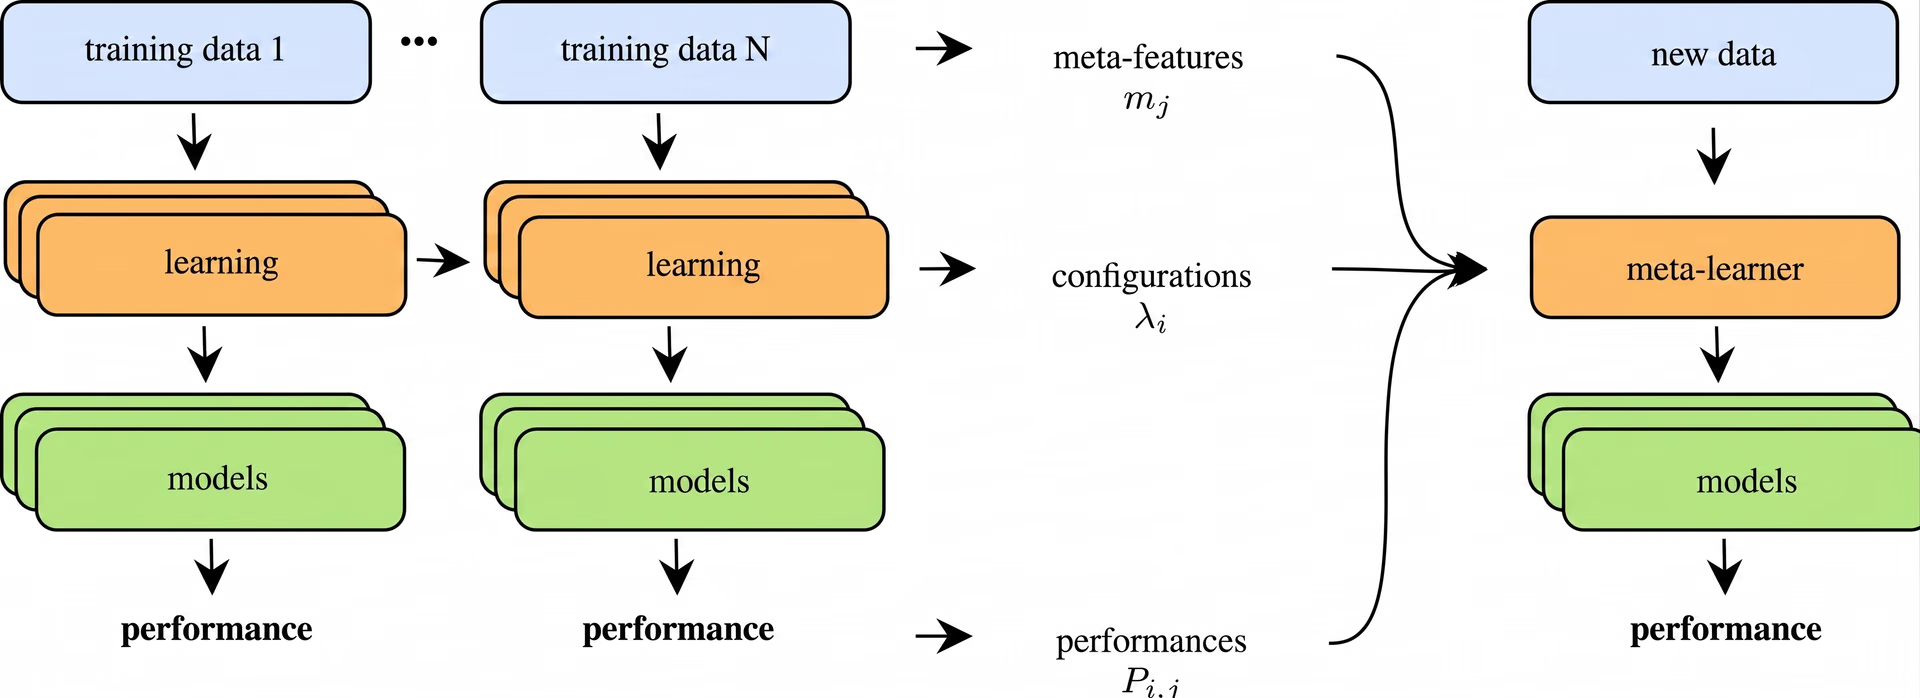
Şekil 3. Meta öğrenme süreci (Kaynak)
Dağılım eşleştirme teknikleri#
Dağılım eşleştirme, gerçek veri kümesinin istatistiksel örüntülerini yansıtan sentetik veriler üretir. Bu yaklaşım, yalnızca modelin nihai doğruluğuna odaklanmak yerine öğrenme sırasında bir sinir ağının ürettiği dahili özelliklere odaklanır.
Şimdi dağılım eşleştirmeyi sağlayan iki tekniğe göz atalım.
Tek katmanlı dağılım eşleştirme#
Tek katmanlı dağılım eşleştirme, bir sinir ağının tek bir katmanına odaklanır ve gerçek verilerle sentetik veriler için ürettiği özellikleri karşılaştırır. Aktivasyonlar olarak da adlandırılan bu özellikler, modelin ağın o noktasına kadar neler öğrendiğini yansıtır.
Sentetik verilerin benzer aktivasyonlar üretmesini sağlayan bu yöntem, damıtılmış veri kümesinin orijinal veri kümesindeki önemli örüntüleri yansıtmasına yardımcı olur. Uygulamada sentetik örnekler, seçilen katmandaki aktivasyonlar gerçek görüntülerden elde edilenlerle yakından eşleşene kadar tekrar tekrar güncellenir.
Bu yaklaşım görece basittir, çünkü her seferinde yalnızca tek bir temsil düzeyini hizalar. Derin ve çok aşamalı özellik hiyerarşilerini eşleştirmenin gerekmediği daha küçük veri kümelerinde veya görevlerde özellikle iyi sonuç verebilir. Tek bir özellik uzayını net biçimde hizalayan tek katmanlı eşleştirme, damıtılmış veri kümesiyle öğrenme için kararlı ve anlamlı bir sinyal sağlar.
Çok katmanlı dağılım eşleştirme#
Çok katmanlı dağılım eşleştirme, gerçek ve sentetik verileri karşılaştırma fikrini temel alır; ancak bunu tek bir katman yerine sinir ağının birden fazla katmanında yapar. Farklı katmanlar, erken katmanlardaki basit kenarlardan ve dokulardan derin katmanlardaki şekillere ve daha karmaşık örüntülere kadar farklı türde bilgiler yakalar.
Bu katmanlardaki özellikleri eşleştirerek damıtılmış veri kümesinin, modelin birden fazla düzeyde öğrendiklerini yansıtması sağlanır. Ağ boyunca özellikleri hizaladığı için bu yaklaşım, sentetik verilerin modelin sınıfları ayırt etmek için kullandığı daha zengin sinyalleri korumasına yardımcı olur.
Bu, modellerin görüntüleri ve videoları anlamayı öğrendiği görevler anlamına gelen bilgisayarlı görü alanında özellikle yararlıdır; çünkü faydalı örüntüler çok sayıda katmana yayılır. Özellik dağılımları farklı derinliklerde iyi eşleştiğinde damıtılmış veri kümesi, orijinal eğitim verilerinin daha güçlü ve güvenilir bir alternatifi hâline gelir.
Parametre eşleştirme yöntemleri#
Veri kümesi damıtmanın bir diğer önemli kategorisi parametre eşleştirmedir. Doğruluğu veya özellik dağılımlarını eşleştirmek yerine, eğitim sırasında model ağırlıklarının nasıl değiştiğini eşleştirir. Damıtılmış veri kümesiyle eğitimin, gerçek verilerle eğitimdekine benzer parametre güncellemeleri üretmesi sağlanarak modelin neredeyse aynı öğrenme yolunu izlemesi hedeflenir.
Şimdi iki temel parametre eşleştirme yöntemini ele alacağız.
Tek adımlı eşleştirme#
Tek adımlı eşleştirme, gerçek veriler üzerinde yalnızca bir eğitim adımından sonra model ağırlıklarında neler olduğunu karşılaştırır. Ardından damıtılmış veri kümesi, bu veri kümesiyle bir adım eğitilen modelin çok benzer bir ağırlık güncellemesi üretmesi için ayarlanır. Yalnızca bu tek güncellemeye odaklandığından yöntemin uygulanması kolay ve hızlıdır.
Dezavantajı, tek bir adımın tüm öğrenme sürecini yansıtmamasıdır; özellikle modelin daha zengin özellikler oluşturmak için çok sayıda güncellemeye ihtiyaç duyduğu zor görevlerde bu durum belirgindir. Bu nedenle tek adımlı eşleştirme, faydalı örüntülerin hızla öğrenilebildiği daha basit problemlerde veya daha küçük veri kümelerinde en iyi sonucu verme eğilimindedir.
Çok adımlı parametre eşleştirme#
Buna karşılık çok adımlı parametre eşleştirme, model ağırlıklarının yalnızca tek bir adımda değil, birkaç eğitim adımı boyunca nasıl değiştiğine bakar. Bu güncellemeler dizisi, modelin eğitim yörüngesidir.
Damıtılmış veri kümesi, model sentetik örnekler üzerinde eğitildiğinde yörüngesinin gerçek verilerle izleyeceği yörüngeyi yakından takip etmesini sağlayacak şekilde oluşturulur. Daha uzun bir öğrenme sürecini eşleştiren damıtılmış küme, orijinal eğitim sürecindeki yapının daha fazlasını yakalar.
Öğrenmenin zaman içindeki gelişimini yansıttığından çok adımlı eşleştirme, faydalı örüntüleri öğrenmek için modellerin çok sayıda güncellemeye ihtiyaç duyduğu daha büyük veya karmaşık veri kümelerinde genellikle daha iyi çalışır. Birden fazla adımı takip etmesi gerektiği için daha fazla hesaplama gerektirir; ancak çoğu zaman tek adımlı eşleştirmeye kıyasla daha iyi genelleme yapan ve daha yüksek performans sağlayan damıtılmış veri kümeleri üretir.
Sentetik veri kümesi oluşturma ve optimizasyon nasıl çalışır?#
Temel damıtma yaklaşımlarını daha iyi anladığımıza göre, şimdi sentetik verilerin nasıl oluşturulduğuna bakabiliriz. Veri kümesi damıtmada sentetik örnekler, en önemli öğrenme sinyalini yakalayacak şekilde optimize edilir; böylece küçük bir küme çok daha büyük bir veri kümesinin yerini alabilir.
Şimdi bu damıtılmış verilerin nasıl oluşturulduğunu ve değerlendirildiğini göreceğiz.
Damıtılmış görüntüleri oluşturma ve değerlendirme#
Veri kümesi damıtma sırasında sentetik pikseller birçok eğitim adımı boyunca güncellenir. Sinir ağı mevcut sentetik görüntülerden öğrenir ve gradyan tabanlı geri bildirim göndererek gerçek veri kümesindeki örüntülerle daha iyi eşleşmesi için her pikselin nasıl değiştirilmesi gerektiğini gösterir.
Bu süreç, türevlenebilir olduğu için işe yarar (yani her adım düzgündür ve iyi tanımlanmış gradyanlara sahiptir; bu nedenle pikseldeki küçük değişiklikler kayıpta öngörülebilir değişikliklere yol açar) ve modelin gradyan inişi sırasında sentetik verileri sorunsuz biçimde ayarlamasını sağlar.
Optimizasyon sürdükçe sentetik görüntüler, modelin tanıdığı şekiller ve dokular dâhil olmak üzere anlamlı bir yapı kazanmaya başlar. İyileştirilmiş bu sentetik görüntüler, bir sınıflandırıcının öğrenmek için ihtiyaç duyduğu temel görsel ipuçlarını yakaladıkları için sıklıkla görüntü sınıflandırma görevlerinde kullanılır.
Damıtılmış veri kümeleri, üzerlerinde modeller eğitilerek ve sonuçlar gerçek verilerle eğitilmiş modellerin sonuçlarıyla karşılaştırılarak değerlendirilir. Araştırmacılar doğrulama doğruluğunu ölçer ve sentetik kümenin, sınıfları birbirinden ayırmak için gereken ayırt edici özellikleri (modelin bir sınıfı diğerinden ayırırken kullandığı örüntü veya sinyalleri) koruyup korumadığını kontrol eder. Ayrıca damıtılmış verilerin aşırı öğrenmeye yol açmadığından emin olmak için farklı çalıştırmalar veya model yapılandırmaları arasındaki kararlılığı ve genellemeyi de sınarlar.
Veri damıtmanın gerçek dünyadaki uygulamaları#
Şimdi, veri sınırlı veya son derece özelleşmiş olsa bile yüksek performansı korurken damıtılmış veri kümelerinin eğitimi nasıl hızlandırdığını ve hesaplama maliyetlerini nasıl düşürdüğünü gösteren örneklere yakından bakacağız.
Bilgisayarlı görü uygulamalarında veri kümesi damıtmayı kullanma#
Bilgisayarlı görüde amaç, modelleri görüntüler ve videolar gibi görsel verileri anlayacak şekilde eğitmektir. Bu modeller kenarlar, dokular, şekiller ve nesneler gibi örüntüleri öğrenir, ardından bunları görüntü sınıflandırma, nesne algılama veya segmentasyon gibi görevlerde kullanır. Görüntü işleme sorunlarında ışıklandırma, arka plan ve bakış açısı bakımından çoğu zaman büyük çeşitlilik bulunduğundan bilgisayarlı görü sistemlerinin iyi genelleme yapabilmek için genellikle büyük veri kümelerine ihtiyacı vardır; bu da eğitimi pahalı ve yavaş hâle getirir.
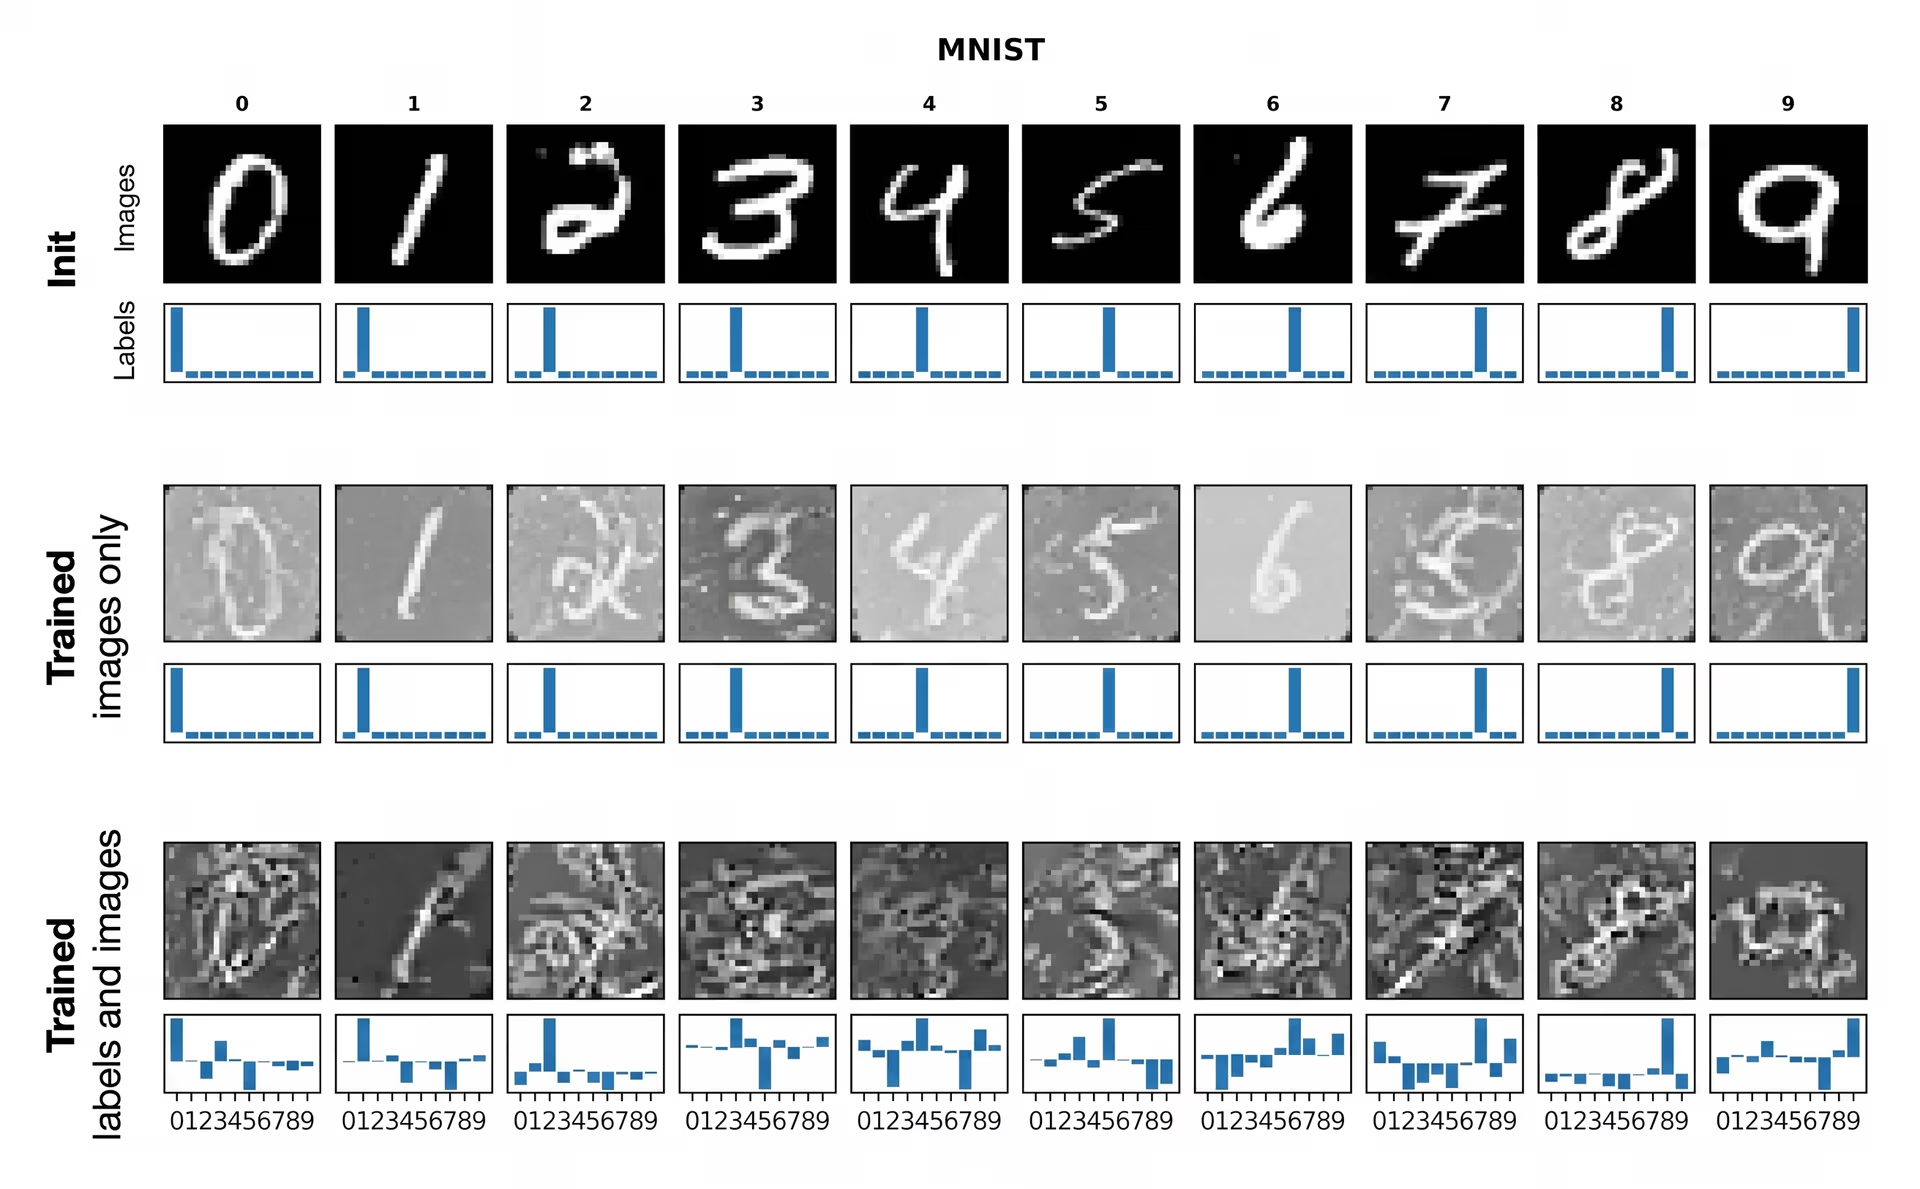
Şekil 4. Veri kümesi damıtmaya bir örnek (Kaynak)
Tıbbi taramalar, yaban hayatı izleme veya fabrikalarda kusur tespiti gibi görüntü sınıflandırma kullanım alanlarında modeller çoğu zaman doğruluk ile eğitim maliyeti arasında zor bir tercih yapmak zorunda kalır. Bu görevler genellikle çok büyük veri kümeleri içerir.
Veri kümesi damıtma, orijinal eğitim kümesini sınıflandırıcı için en önemli görsel ipuçlarını hâlâ içeren az sayıda sentetik görüntüye sıkıştırabilir. ImageNet gibi büyük kıyaslama veri kümelerinde, orijinal görüntülerin yalnızca yaklaşık %4,2'sini kullanan damıtılmış kümelerin yüksek sınıflandırma doğruluğunu koruduğu gösterilmiştir. Böylece çok küçük bir sentetik vekil küme, çok daha az hesaplama gücüyle milyonlarca gerçek örneğin yerini alabilir.
Sinir ağı mimarisi araması#
Sinir ağı mimarisi araması (NAS), bir görev için en uygun ağı bulmak amacıyla çok sayıda olası sinir ağı tasarımını otomatik olarak inceleyen bir tekniktir. NAS'in çok sayıda aday modeli eğitip değerlendirmesi gerektiğinden, tam veri kümeleri üzerinde çalıştırılması yavaş ve hesaplama açısından çok yoğun olabilir.
Veri kümesi damıtma, orijinal verilerin temel öğrenme sinyalini hâlâ içeren küçük bir sentetik eğitim kümesi oluşturarak yardımcı olur; böylece her aday mimari çok daha hızlı sınanabilir. Bu sayede NAS, iyi ve kötü mimarilere ilişkin sıralamaları makul ölçüde güvenilir tutarken tasarımları verimli biçimde karşılaştırabilir ve nihai model kalitesinden fazla ödün vermeden arama maliyetini azaltabilir.
Sürekli öğrenme ve uç dağıtımı#
Yeni veriler geldikçe bir kez eğitilmek yerine güncellenmeye devam eden modellerden oluşan sürekli öğrenme sistemlerinin hızlı ve bellek açısından verimli güncellemelere ihtiyacı vardır. Kamera, telefon ve sensör gibi uç cihazlar da hesaplama ve depolama bütçeleri kısıtlı olduğu için benzer sınırlamalarla karşılaşır.
Veri kümesi damıtma, her iki durumda da büyük bir eğitim kümesini çok küçük, sentetik bir kümeye sıkıştırarak yardımcı olur; böylece modeller tüm veri kümesi yerine küçük bir tekrar oynatma kümesini kullanarak uyum sağlayabilir veya yeniden eğitilebilir. Örneğin, çekirdek tabanlı meta öğrenme çalışması, standart bir görüntü sınıflandırma kıyaslama veri kümesi olan CIFAR-10'da yalnızca 10 damıtılmış örneğin %64'ün üzerinde doğruluk sağlayabildiğini gösterdi. Tekrar oynatma kümesi bu kadar küçük olduğundan, özellikle modellerin sık sık yenilenmesi gerektiğinde güncellemeler çok daha hızlı ve pratik hâle gelir.
Veri kümesi damıtma, büyük dil modelleri için bilgi damıtmayla birlikte de kullanılabilir. Küçük bir damıtılmış veri kümesi, öğretmen modelden gelen en önemli görev sinyallerini koruyabilir; böylece sıkıştırılmış öğrenci modeli, performansından fazla ödün vermeden daha verimli eğitilebilir veya güncellenebilir. Bu veri kümeleri çok küçük olduğundan, depolama ve hesaplama kaynaklarının kısıtlı olduğu ancak güncellemelerden sonra modelin doğruluğunu korumasının istendiği uç veya cihaz üstü kullanım senaryolarında özellikle yararlıdır.
Veri damıtmanın artıları ve eksileri#
Veri kümesi damıtmanın bazı faydaları şunlardır:
- Hızlı denemeler için ideal. Her seferinde büyük bir veri kümesi üzerinde yeniden eğitim yapmadan yeni mimarileri, kayıp fonksiyonlarını veya hiperparametreleri sınayabilirsin.
- Olası gizlilik avantajı. Damıtılmış sentetik örnekleri paylaşmak, ham örnekler doğrudan açığa çıkmadığından gerçek kullanıcı verilerini paylaşmaktan daha güvenli olabilir.
- Basit alt küme seçimine kıyasla genellikle daha etkili. Damıtma, yalnızca örnekleri seçmek yerine onları olabildiğince bilgilendirici olacak şekilde etkin biçimde optimize eder.
Veri kümesi damıtma çeşitli avantajlar sunsa da aklında bulundurman gereken bazı sınırlamalar şunlardır:
- Aşırı öğrenme. Damıtılmış veriler genellikle damıtma sırasında kullanılan mimaride en iyi sonucu verir ve çok farklı modellere iyi aktarılmayabilir.
- Hiperparametrelere duyarlılık. Sonuçlar öğrenme oranı, başlatma veya damıtma adımlarının sayısı gibi etkenlere büyük ölçüde bağlı olabilir.
- Gerçek dünyanın karmaşıklığına ölçeklendirmek daha zor. Kıyaslama veri kümelerinde iyi çalışan yöntemler; büyük, düzensiz veya yüksek çözünürlüklü veri kümelerinde doğruluk kaybedebilir.
Önemli çıkarımlar#
Veri kümesi damıtma, küçük bir sentetik örnek kümesinin modele neredeyse tam bir veri kümesi kadar etkili biçimde öğretmesini mümkün kılar. Bu da makine öğrenimini daha hızlı, verimli ve ölçeklenebilir hâle getirir. Modeller büyüyüp daha fazla veriye ihtiyaç duydukça damıtılmış veri kümeleri, doğruluktan ödün vermeden hesaplama maliyetlerini azaltmak için pratik bir yol sunar.
Yapay zekâ hakkında daha fazla bilgi edinmek için topluluğumuza katıl ve GitHub depomuza göz at. Kendi görsel yapay zekâ projenizi geliştirmek istiyorsan lisanslama seçeneklerimize göz at. Çözümler sayfalarımızı ziyaret ederek sağlık hizmetlerinde yapay zekâ ve perakendede görsel yapay zekâ gibi uygulamalar hakkında daha fazla bilgi edin.
Yazan
İçerik Üreticisi · Ultralytics
Yorumlar
Soru sor, sonuçlarını paylaş veya başka birine yardım et.









